Nahezu jedes Data-Science-Projekt befasst sich mit Korrelationen zwischen Variablen. Eine Korrelation ist die statistische Zusammenfassung der Beziehung zwischen zwei Variablensätzen. Sie ist ein zentraler Bestandteil der explorativen Datenanalyse und spielt in vielen fortgeschrittenen Machine-Learning-Verfahren eine wichtige Rolle. Wenn du in Data Science einsteigen willst, wirst du dich früher oder später mit Korrelation beschäftigen müssen.
In diesem Tutorial erklären wir, was Korrelation ist und warum sie in Data-Science-Projekten relevant ist. Außerdem schauen wir uns verschiedene Korrelationskoeffizienten an, mit denen sich Stärke und Richtung der Beziehung zwischen Variablen messen lassen. Mit Python-Code zeigen wir praktische Beispiele, wie sich Korrelationen einfach messen und visualisieren.
- Was ist Korrelation?
- Korrelationskoeffizienten
- Korrelation in Python berechnen
- Korrelation bedeutet nicht Kausalität
- Fazit
Was ist Korrelation?
Korrelation ist die statistische Analyse der Beziehung bzw. Abhängigkeit zwischen zwei Variablen. Sie ermöglicht es, sowohl die Stärke als auch die Richtung der Beziehung zwischen zwei Variablensätzen zu untersuchen.
Die Untersuchung von Korrelationen ist in vielen Data-Science-Aufgaben äußerst hilfreich. Erstens ist sie ein Kernelement der explorativen Datenanalyse: der ersten Bestandsaufnahme unserer Daten, um einen Eindruck zu gewinnen, zentrale Merkmale zusammenzufassen und Muster sowie Ausreißer zu entdecken.
Zweitens haben Korrelationen viele Anwendungen in der realen Welt. Sie helfen uns etwa zu beantworten, ob es einen Zusammenhang zwischen Demokratie und Wirtschaftswachstum gibt oder ob die Autonutzung mit dem Grad der Luftverschmutzung zusammenhängt.
Drittens ist das Studium von Korrelationen im Machine Learning entscheidend. Manche Algorithmen arbeiten nicht zuverlässig, wenn zwei oder mehr Variablen stark zusammenhängen, was meist als Multikollinearität bezeichnet wird. Korrelation bildet auch die Grundlage der Principal Component Analysis, einer linearen Technik zur Dimensionsreduktion, die in ML-Projekten sehr nützlich ist.
Es gibt verschiedene Arten von Korrelation:
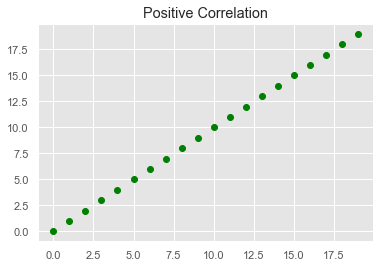
- Positive Korrelation: Zwei Variablen sind positiv korreliert, wenn sich ihre Werte in die gleiche Richtung bewegen. Im folgenden Bild steigt beispielsweise der Y-Wert in konstantem Tempo, wenn der X-Wert zunimmt:
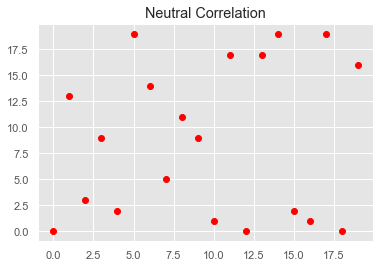
- Keine Korrelation: Zwischen den Variablen X und Y besteht kein Zusammenhang in ihren Änderungen. Die Werte sind zufällig verteilt und zeigen keine Anzeichen einer Korrelation, wie im folgenden Bild:
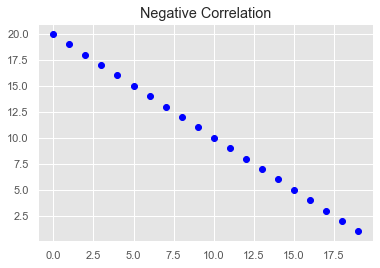
- Negative Korrelation: X und Y sind negativ korreliert, wenn sich ihre Werte entgegengesetzt verändern. Steigt also X, sinkt Y in konstantem Tempo:
Das Plotten der Daten ist der schnellste und effektivste Weg, die Art der Korrelation zwischen Variablen zu erkennen. Üblicherweise visualisieren wir Abhängigkeiten zwischen zwei Variablen mit einem Streudiagramm. Dabei steht die x-Achse für die Werte der ersten Variable, die y-Achse für die der zweiten. Die letzten drei Bilder sind Beispiele für Streudiagramme. Schau dir dieses Video-Tutorial an, um zu sehen, wie du in Python ein Streudiagramm erstellst.
Manchmal reicht die Visualisierung nicht aus, und wir müssen messen, wie stark die Korrelation ist. Hier kommen Korrelationskoeffizienten ins Spiel.
Korrelationskoeffizienten
Ein Korrelationskoeffizient fasst statistisch zusammen, wie stark und in welche Richtung zwei Variablen miteinander zusammenhängen.
Ein Vorteil von Korrelationskoeffizienten ist, dass sie die Korrelation standardisiert schätzen. Der Wert liegt immer auf derselben Skala von -1,0 bis 1,0.
Es gibt mehrere Korrelationskoeffizienten. Die Wahl hängt davon ab, was wir über die Struktur der Beziehung zwischen den Variablen wissen. In der Praxis verwenden Data Scientists jedoch meist den bekanntesten: Pearsons Korrelationskoeffizienten.
Pearsons Korrelationskoeffizient
Der Pearson-Korrelationskoeffizient (r) misst die Stärke eines linearen Zusammenhangs zwischen zwei Variablen. Er wird berechnet, indem die Kovarianz von X und Y durch das Produkt ihrer Standardabweichungen geteilt wird, wie in der folgenden Formel gezeigt:
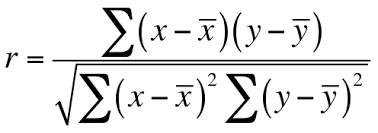
Der Koeffizient basiert auf zwei Annahmen. Erstens wird angenommen, dass die Variablen einer Normal- bzw. Gaußverteilung folgen. Sind die Daten nicht normalverteilt, können andere Koeffizienten verlässlicher sein.
Zweitens wird eine lineare Beziehung zwischen den Variablen vorausgesetzt, das heißt, die Änderungen lassen sich durch eine lineare Funktion modellieren (ihre Werte steigen oder fallen gleichzeitig in konstantem Tempo). Je näher die Punkte an einer Geraden liegen, desto stärker ist die (lineare) Korrelation und desto größer ist der Betrag von r. Im nächsten Bild lassen sich alle Datenpunkte perfekt mit einer Geraden modellieren, was zu einem Korrelationskoeffizienten von 1,0 führt.
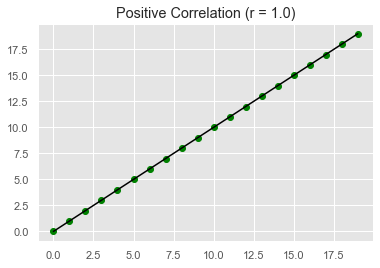
Ein Wert von -1,0 zeigt eine perfekte negative, 1,0 eine perfekte positive Korrelation. Ein Wert von 0,0 bedeutet, dass kein linearer Zusammenhang zwischen den Variablen besteht.
Die Interpretation wird schwieriger, je näher der Wert an 0 liegt. Es gibt verschiedene Faustregeln zur Einordnung. Eine der bekanntesten stammt von Dennis E. Hinkle und Co-Autoren in ihrem Buch Applied Statistics for the Behavioral Sciences:
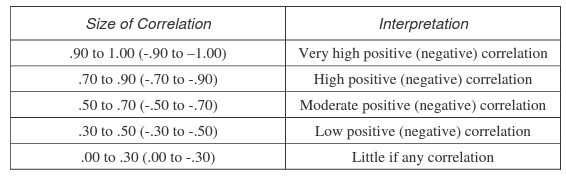 Faustregel zur Interpretation von Korrelationskoeffizienten. Hinkle, Wiersma, & Jurs.
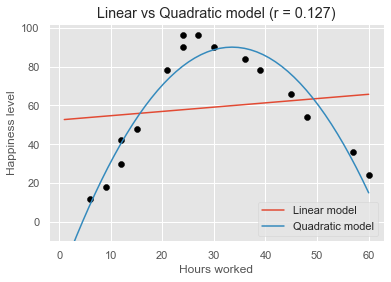
Wichtig ist: Ein Pearson-Korrelationskoeffizient nahe 0,0 zeigt nur, dass kein linearer Zusammenhang besteht. Es kann trotzdem eine starke nichtlineare Beziehung vorliegen. Bei nichtlinearen Beziehungen ändert sich die Steigung mit dem Wert einer Variablen, sodass ein kurviges Muster entsteht. Solche Trends lassen sich besser mit nichtlinearen Funktionen wie quadratischen oder kubischen Modellen abbilden.
Im folgenden Beispiel variiert die Zufriedenheit von Mitarbeitenden je nach Wochenarbeitszeit. Bis etwa 35 Stunden steigt die Zufriedenheit, danach sinkt sie. Das lineare Modell (rote Linie) passt nicht gut, ein quadratisches Modell (blaue Linie), also ein Polynom 2. Grades, bildet die Kurve deutlich besser ab. Bei nichtlinearen Beziehungen unterschätzt die Korrelation in der Regel die Stärke. In unserem Beispiel beträgt der Koeffizient 0,127 und sagt wenig über die nichtlineare Beziehung zwischen Zufriedenheit und Arbeitszeit aus.
Weitere Korrelationskoeffizienten
Die größte Einschränkung des Pearson-Koeffizienten ist die Annahme einer linearen Beziehung. Häufig sind Beziehungen jedoch nichtlinear, und die Daten können zudem nicht gaußverteilt sein. Um diese Schwäche zu adressieren, wurden alternative Schätzer entwickelt: Spearmans Rho und Kendalls Tau.
Während Pearson lineare Beziehungen annimmt, setzen Spearman und Kendall lediglich eine monotone Beziehung voraus. In einer monotonen Beziehung bewegen sich die Variablen in die gleiche relative Richtung, jedoch nicht zwingend mit konstanter Rate. Anders gesagt: Jede lineare Beziehung ist monoton, aber nicht jede monotone ist linear.
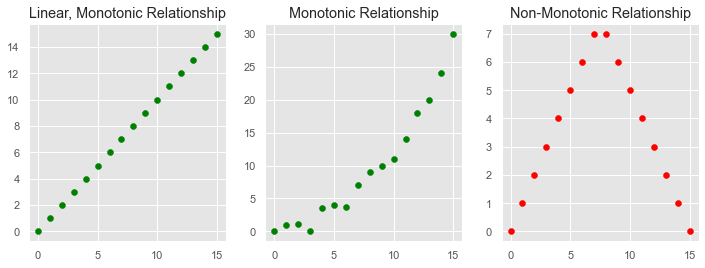
Statt Kovarianz und Standardabweichungen zu nutzen, basieren diese Koeffizienten auf den Rangplätzen der Werte. Dadurch sind sie robuster gegenüber Ausreißern und eignen sich besser für bestimmte Arten von Nichtlinearitäten.
Wie beim Pearson-Koeffizienten liegen die Werte von Spearman und Kendall zwischen -1 und 1 für perfekt negativ bzw. perfekt positiv korrelierte Variablen.
In der Praxis reicht für viele Anwendungsfälle dennoch Pearsons Korrelationskoeffizient. Rangbasierte Schätzer sind vor allem bei kleinen Datensätzen und spezifischen Hypothesentests interessant.
Korrelation in Python berechnen
Es gibt verschiedene Python-Pakete, mit denen wir Korrelationen messen können. In diesem Abschnitt konzentrieren wir uns auf die Funktionen in drei bekannten Paketen: SciPy, NumPy und pandas.
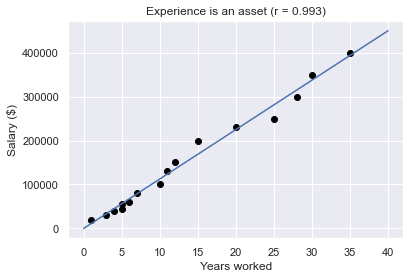
Nehmen wir an, wir wollen den Zusammenhang zwischen Berufserfahrung (in Jahren) und Gehalt (in Dollar) in einem kleinen, erfolgreichen Startup mit 16 Mitarbeitenden untersuchen.
experience = [1, 3, 4, 5, 5, 6, 7, 10, 11, 12, 15, 20, 25, 28, 30,35]

salary = [20000, 30000, 40000, 45000, 55000, 60000, 80000, 100000, 130000, 150000, 200000, 230000, 250000, 300000, 350000, 400000]
Im folgenden Diagramm siehst du eine starke positive Korrelation zwischen beiden Variablen: Mitarbeitende mit mehr Erfahrung verdienen tendenziell mehr.
SciPy ist eine hervorragende Bibliothek für statistische Operationen. Das Modul scipy.stats enthält die Funktion pearsonr(x, y), um Pearsons Korrelationskoeffizienten zwischen zwei Stichproben zu berechnen.
import scipy.stats as stats

corr, _ = stats.pearsonr (experience, salary)
corr
0.9929845761480398
Analog lassen sich Spearmans und Kendalls Koeffizienten berechnen:
spearman_corr, _ = stats.spearmanr(experience, salary)
spearman_corr
0.9992644353546791

kendall_corr, _ = stats.kendalltau(experience, salary)
kendall_corr
0.9958246164193105
NumPy ist ein populäres Paket mit vielen mathematischen Funktionen, darunter np.corrcoef(), das eine Matrix der Pearson-Korrelationskoeffizienten zurückgibt:
import numpy as np

np.corrcoef(experience, salary)
array([[1.        , 0.99298458],
       [0.99298458, 1.        ]])
Eine Korrelationsmatrix ist eine Tabelle, die die Korrelationskoeffizienten zwischen Variablen zeigt. Jede Zelle zeigt die Korrelation eines Variablenpaars. Die Diagonale enthält die Korrelation einer Variablen mit sich selbst (immer 1,0). Die anderen Werte repräsentieren hier die Korrelation zwischen Erfahrung und Gehalt. Da wir nur zwei Variablen betrachten, sind die Werte symmetrisch identisch.
Häufig liegen unsere Variablen in pandas DataFrames vor. Angenommen, wir haben einen DataFrame mit Informationen über die Mitarbeitenden des Startups:
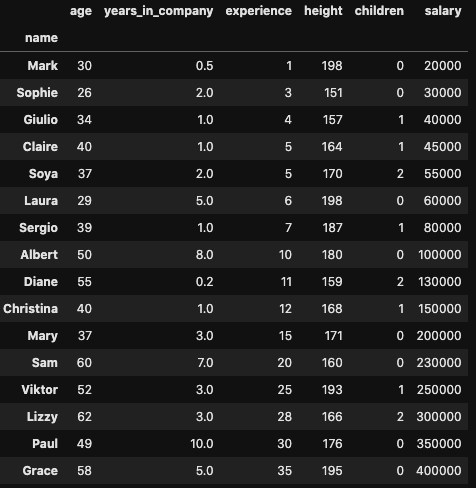
Um die Korrelation zwischen zwei Spalten zu berechnen, nutzen wir die pandas-Methode .corr() wie folgt:
import pandas as pd

df['experience'].corr(df['salary'])
0.9929845761480398
.corr() besitzt den Parameter "method", mit dem sich alle drei Korrelationskoeffizienten berechnen lassen. Standardmäßig wird Pearson verwendet.
print(df['experience'].corr(df['salary'], method='spearman'))
print(df['experience'].corr(df['salary'], method='kendall'))
0.9992644353546791
0.9958246164193105
Wenn wir die Korrelation aller Variablenpaare untersuchen wollen, wenden wir .corr() direkt auf den DataFrame an und erhalten wieder eine Korrelationsmatrix mit allen Koeffizienten:
df.corr()
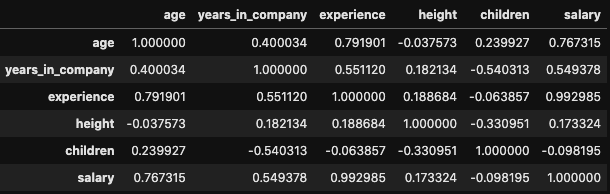
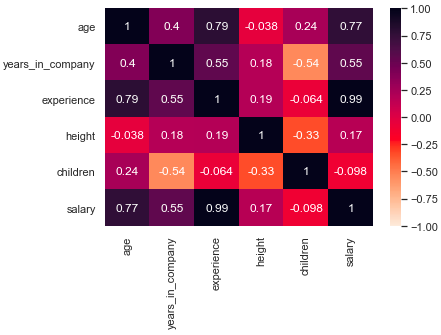
Bei vielen Spalten kann die Korrelationsmatrix sehr groß und unübersichtlich werden. Für bessere Insights bietet sich eine Heatmap an: eine Visualisierung, bei der jeder Wert entsprechend seiner Stärke auf einer Skala eingefärbt wird. Am schnellsten erzeugst du eine Heatmap mit der Funktion heatmap() aus der Bibliothek seaborn:
import seaborn as sns

sns.heatmap(df.corr(), vmin=-1, vmax=1,
annot=True,cmap="rocket_r")
plt.show()
Korrelation bedeutet nicht Kausalität
Zum Schluss noch ein wichtiger Hinweis: Korrelation bedeutet nicht Kausalität.
Die Korrelation quantifiziert nur Stärke und Richtung des Zusammenhangs zwischen zwei Variablen. Es kann eine starke Korrelation bestehen, ohne dass die eine Variable die andere verursacht. Solche scheinbaren Zusammenhänge nennen wir Scheinkorrelationen.
Zwei Szenarien führen typischerweise zu Scheinkorrelationen:
- Erstens kann es eine dritte, „konfundierende“ Variable geben, die beide Variablen beeinflusst. Stell dir vor, der Eiskonsum und die Zahl der Hitzschläge in einer Bevölkerung sind stark positiv korreliert. Daraus zu schließen, Eis essen verursache Hitzschläge, wäre absurd. Vielmehr hängen beide Größen vermutlich von der Temperatur ab: Je höher sie ist, desto mehr Menschen essen Eis und desto häufiger treten Hitzschläge auf.
- Zweitens können Abhängigkeiten zwischen Variablen einfach zufällig entstehen – das passiert häufig, besonders bei kleinen Stichproben.
Außerdem ist die Welt komplex. Eine starke Korrelation kann uns vorschnell zur Annahme verleiten, eine einzelne Ursache sei verantwortlich. Der Glaube an Monokausalität ist jedoch selten zutreffend. Häufig wirken mehrere Variablen zusammen. Um Kausalität zu prüfen, müssen wir das System möglichst vollständig erfassen und es nicht nur quantitativ (statistisch), sondern auch qualitativ bewerten.
Daher gilt: Bevor du Schlussfolgerungen über Zusammenhänge in deinen Daten triffst, führe eine gründliche Analyse durch, um mögliche Scheinkorrelationen zu identifizieren.
Fazit
Wir hoffen, dir hat dieses Tutorial gefallen. Korrelation ist ein zentrales Thema, das jede angehende Data Scientist beherrschen sollte. Bei DataCamp findest du zahlreiche Statistik-Kurse, in denen wir Korrelation, Kausalität und weitere Schlüsselkonzepte behandeln – sowohl mit Python als auch mit R.
Wenn die Grundlagen sitzen, probiere DataLab aus – das KI-gestützte Datennotizbuch von DataCamp, mit dem du ohne Installation Code schreiben und Gelerntes anwenden kannst.


