Praticamente todo projeto de ciência de dados envolve estudar correlações entre variáveis. Correlação é o resumo estatístico do relacionamento entre dois conjuntos de variáveis. É parte essencial da análise exploratória de dados e um aspecto crítico de diversas técnicas avançadas de machine learning. Se você está pensando em entrar na área de ciência de dados, mais cedo ou mais tarde na sua jornada vai precisar aprender correlação.
Neste tutorial, vamos explicar o que é correlação e sua relevância na condução de projetos de ciência de dados. Também vamos ver os diferentes coeficientes de correlação que podemos usar para medir a força e a direção do relacionamento entre variáveis. Usaremos código em Python para mostrar exemplos práticos de como medir e visualizar correlações de forma simples.
- O que é correlação?
- Coeficientes de correlação
- Calculando correlação em Python
- Correlação não implica causalidade
- Conclusão
O que é correlação?
Correlação é a análise estatística do relacionamento ou dependência entre duas variáveis. Ela permite estudar tanto a força quanto a direção do relacionamento entre dois conjuntos de variáveis.
Estudar correlação pode ser muito útil em várias tarefas de ciência de dados. Primeiro, é um componente-chave da análise exploratória de dados: o estudo inicial que fazemos nos dados para ver como eles se apresentam, resumir suas principais características e descobrir padrões e anomalias.
Segundo, correlações têm muitas aplicações no mundo real. Elas podem ajudar a responder perguntas como se existe ligação entre democracia e crescimento econômico, ou se o uso de carros se correlaciona com o nível de poluição do ar.
Por fim, o estudo de correlação é fundamental em machine learning. Por exemplo, alguns algoritmos não funcionam bem se duas ou mais variáveis estiverem fortemente relacionadas, fenômeno conhecido como multicolinearidade. Correlação também é a base da análise de componentes principais (PCA), uma técnica linear de redução de dimensionalidade muito útil em projetos de machine learning.
Existem diferentes tipos de correlação:
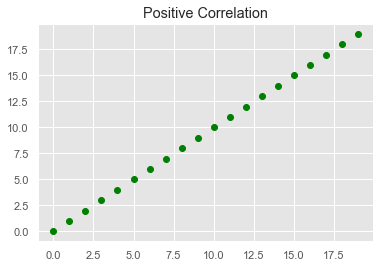
- Correlação positiva: duas variáveis são positivamente correlacionadas quando seus valores se movem na mesma direção. Por exemplo, na imagem abaixo, conforme X aumenta, Y também aumenta a uma taxa constante:
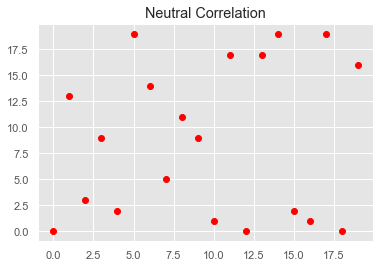
- Correlação nula: não há relacionamento na variação das variáveis X e Y. Nesse caso, os valores são completamente aleatórios e não mostram qualquer sinal de correlação, como na imagem a seguir:
- Correlação negativa: por fim, X e Y serão negativamente correlacionadas quando seus valores mudam em direções opostas; aqui, conforme X aumenta, Y diminui a uma taxa constante:
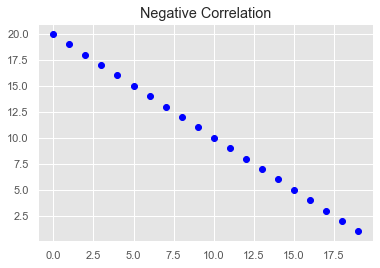
Plotar os dados é a forma mais rápida e eficaz de descobrir o tipo de correlação entre variáveis. A maneira típica de visualizar a dependência entre duas variáveis é com um gráfico de dispersão (scatterplot). Nele, o eixo x traz os valores da primeira variável e o eixo y, da segunda. As três últimas imagens são exemplos de scatterplots. Confira este tutorial em vídeo para ver como criar um scatterplot em Python.
No entanto, às vezes não basta visualizar a correlação — também precisamos medir quão forte ela é. É aí que entram os coeficientes de correlação.
Coeficientes de correlação
Um coeficiente de correlação é um resumo estatístico que mede a força e a direção com que duas variáveis estão associadas.
Uma das vantagens dos coeficientes de correlação é estimar a correlação entre duas variáveis de forma padronizada, isto é, o valor do coeficiente sempre estará na mesma escala, variando de -1,0 a 1,0.
Existem vários coeficientes de correlação. A escolha depende do que sabemos sobre a estrutura do relacionamento entre as variáveis. Porém, cientistas de dados normalmente recorrem ao mais famoso: o coeficiente de correlação de Pearson.
Coeficiente de correlação de Pearson
O coeficiente de correlação de Pearson (r) é uma pontuação que mede a força de um relacionamento linear entre duas variáveis. Ele é calculado dividindo a covariância das variáveis X e Y pelo produto do desvio padrão de cada uma, como mostra a fórmula a seguir:
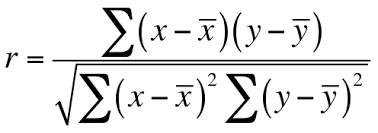
O coeficiente parte de duas premissas. Primeiro, assume que as variáveis seguem uma distribuição normal ou gaussiana. Se os dados não forem normalmente distribuídos, outros coeficientes podem ser mais confiáveis.
Segundo, assume que há um relacionamento linear entre as duas variáveis, ou seja, as mudanças nos dados podem ser modeladas por uma função linear (isto é, seus valores aumentam ou diminuem simultaneamente a uma taxa constante). Quanto mais o relacionamento entre as duas variáveis se aproxima de uma reta, mais forte é a correlação (linear) e maior é o valor absoluto do coeficiente de Pearson. Por exemplo, na próxima imagem, todos os pontos podem ser perfeitamente modelados por uma linha reta, resultando em coeficiente de correlação igual a 1,0.
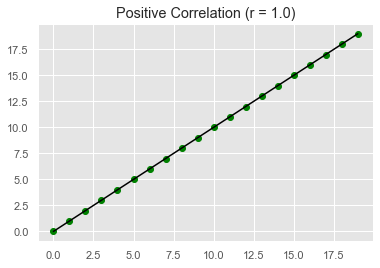
Um coeficiente de -1,0 indica correlação negativa perfeita, enquanto um coeficiente de 1,0 indica correlação positiva perfeita. Já um coeficiente de 0,0 indica que não há correlação linear entre as variáveis.
A interpretação fica mais difícil quando o valor se aproxima de zero. Várias regras práticas foram propostas para interpretar os valores do coeficiente. Uma das mais conhecidas foi formulada por Dennis E. Hinkle e coautores no livro Applied Statistics for the Behavioral Sciences:
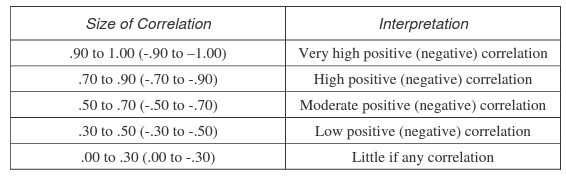 Regra prática para interpretar coeficientes de correlação. Hinkle, Wiersma & Jurs.
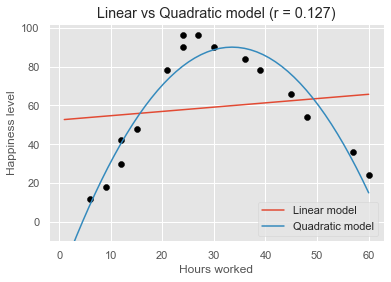
É importante destacar que um coeficiente de Pearson próximo de 0,0 apenas indica que não há relacionamento linear entre as variáveis. Pode acontecer de existir um relacionamento forte, porém não linear. Se o relacionamento entre duas variáveis for não linear, a taxa de aumento ou diminuição pode mudar conforme uma variável varia, formando um padrão curvo nos dados. Essa tendência pode ser melhor modelada por uma função não linear, como uma função quadrática ou cúbica.
Por exemplo, a imagem a seguir mostra como o nível de felicidade de trabalhadores varia de acordo com as horas trabalhadas por semana. Vemos que, à medida que o número de horas aumenta, a felicidade também sobe, mas começa a cair depois de cerca de 35 horas. O modelo linear (linha vermelha) não se ajusta bem aos dados. Em vez disso, um modelo quadrático (linha azul), também conhecido como modelo polinomial de grau 2, parece ser um candidato muito melhor para capturar o formato curvo dos dados. Quando o relacionamento é não linear, a correlação geralmente subestima sua força. É o caso do nosso exemplo, em que o coeficiente é 0,127, dizendo pouco sobre o relacionamento não linear entre felicidade e horas trabalhadas.
Outros coeficientes de correlação
A maior limitação do coeficiente de Pearson é assumir um relacionamento linear entre as duas variáveis. No entanto, muitas vezes as variáveis se relacionam de forma não linear. Além disso, os dados podem ter distribuição não gaussiana. Para lidar com essas limitações, estatísticos propuseram outros tipos de estimativas, como os coeficientes de correlação rho de Spearman e tau de Kendall.
Enquanto o coeficiente de Pearson assume relacionamentos lineares, os coeficientes de Spearman e Kendall assumem que o relacionamento entre as variáveis é apenas monotônico. Em um relacionamento monotônico, as variáveis tendem a se mover na mesma direção relativa, mas não necessariamente a uma taxa constante. Em outras palavras, todo relacionamento linear é monotônico, mas nem todo relacionamento monotônico é linear.
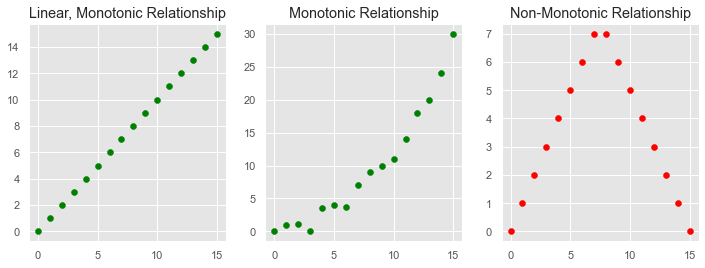
Em vez de calcular os coeficientes usando covariância e desvios padrão, eles se baseiam no posto (rank) relativo dos valores das variáveis. Essa característica os torna estimativas robustas a valores extremos e adequadas para lidar com certos tipos de não linearidades.
Assim como no coeficiente de Pearson, as pontuações de Spearman e Kendall variam entre -1 e 1 para variáveis perfeitamente negativamente e positivamente correlacionadas, respectivamente.
Ainda assim, em geral, cientistas de dados podem ficar com o coeficiente de Pearson. As estimativas baseadas em postos são mais atraentes para conjuntos de dados menores e testes de hipóteses específicos.
Calculando correlação em Python
Há vários pacotes Python que ajudam a medir correlação. Nesta seção, vamos focar nas funções de correlação disponíveis em três pacotes bem conhecidos: SciPy, NumPy e pandas.
Para testar as funções, imagine que queremos estudar o relacionamento entre experiência de trabalho (em anos) e salário (em dólares) em uma startup pequena, porém bem-sucedida, com 16 funcionários.
experience = [1, 3, 4, 5, 5, 6, 7, 10, 11, 12, 15, 20, 25, 28, 30,35]

salary = [20000, 30000, 40000, 45000, 55000, 60000, 80000, 100000, 130000, 150000, 200000, 230000, 250000, 300000, 350000, 400000]
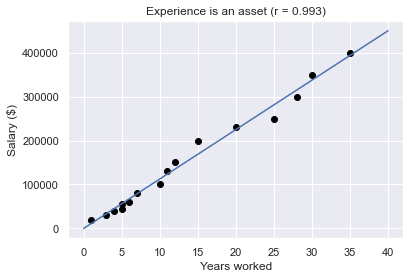
Como podemos ver no próximo gráfico, há uma forte correlação positiva entre as duas variáveis, indicando que funcionários com mais experiência tendem a ter salários mais altos.
SciPy é uma ótima biblioteca para operações estatísticas. O módulo scipy.stats inclui a função pearsonr(x, y) para calcular o coeficiente de correlação de Pearson entre duas amostras.
import scipy.stats as stats

corr, _ = stats.pearsonr (experience, salary)
corr
0.9929845761480398
Podemos calcular os coeficientes de Spearman e Kendall da mesma forma:
spearman_corr, _ = stats.spearmanr(experience, salary)
spearman_corr
0.9992644353546791

kendall_corr, _ = stats.kendalltau(experience, salary)
kendall_corr
0.9958246164193105
NumPy é um pacote popular que oferece uma coleção extensa de funções matemáticas avançadas, incluindo np.corrcoef(), que retorna uma matriz de coeficientes de correlação de Pearson:
import numpy as np

np.corrcoef(experience, salary)
array([[1.        , 0.99298458],
       [0.99298458, 1.        ]])
Uma matriz de correlação é uma tabela que mostra os coeficientes de correlação entre variáveis. Cada célula mostra a correlação entre duas variáveis. A diagonal da matriz inclui os coeficientes entre cada variável e ela mesma, sempre iguais a 1,0. Os outros valores representam a correlação entre experiência e salário. Neste caso, como estamos calculando a correlação de apenas duas variáveis, os valores se repetem.
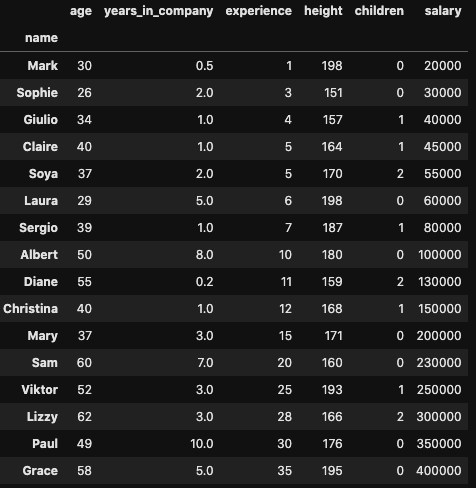
Por fim, geralmente precisamos calcular correlação para variáveis armazenadas em DataFrames do pandas. Imagine que temos um DataFrame com informações sobre os funcionários da startup:
Se quisermos calcular a correlação entre duas colunas, podemos usar o método .corr() do pandas, assim:
import pandas as pd

df['experience'].corr(df['salary'])
0.9929845761480398
O .corr() inclui o parâmetro "method", que pode ser usado para calcular os três coeficientes de correlação. Por padrão, ele calcula o de Pearson.
print(df['experience'].corr(df['salary'], method='spearman'))
print(df['experience'].corr(df['salary'], method='kendall'))
0.9992644353546791
0.9958246164193105
Caso queiramos explorar a correlação entre todos os pares de variáveis, podemos aplicar o método .corr() diretamente ao DataFrame, o que resulta novamente em uma matriz de correlação com o coeficiente de todos os pares de variáveis:
df.corr()
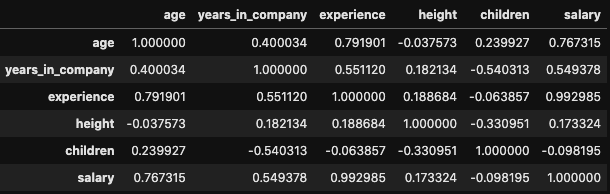
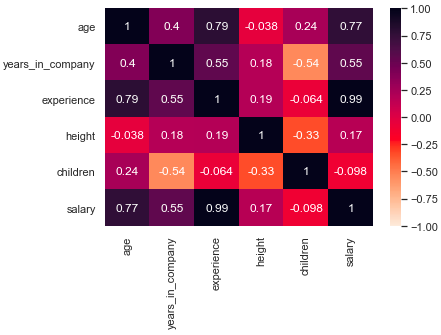
A matriz de correlação pode ser muito grande e difícil de interpretar se o DataFrame tiver muitas colunas. Para extrair insights de forma mais eficaz, podemos usar um heatmap: uma técnica de visualização em que cada valor é representado por uma cor, de acordo com sua intensidade em uma escala. A forma mais rápida de criar um heatmap é usando a função heatmap(), disponível na biblioteca seaborn:
import seaborn as sns

sns.heatmap(df.corr(), vmin=-1, vmax=1,
annot=True,cmap="rocket_r")
plt.show()
Correlação não implica causalidade
Não poderíamos terminar este tutorial sem mencionar um ponto importante: correlação não implica causalidade.
A correlação apenas quantifica a força e a direção do relacionamento entre duas variáveis. Pode haver uma correlação forte entre duas variáveis, mas isso não permite concluir que uma causa a outra. Quando correlações fortes não são causais, chamamos de correlações espúrias.
Dois cenários podem levar a correlações espúrias:
- Primeiro, pode haver uma terceira variável "confundidora" causando as duas variáveis. Imagine uma forte correlação positiva entre consumo de sorvete e número de insolação em uma população. Alguém poderia concluir, absurdamente, que comer sorvete causa insolação. Porém, o que ocorre é que ambas as variáveis dependem de uma terceira, muito provavelmente a temperatura. Quanto maior a temperatura, mais gente vai querer sorvete — e também maior a probabilidade de ocorrer insolação.
- Um segundo motivo para ter cautela é que dependências entre variáveis podem acontecer simplesmente ao acaso. Isso é comum, especialmente quando lidamos com amostras pequenas.
Por fim, outro motivo para cautela é que o mundo em que vivemos é complexo. Uma correlação mais forte entre duas variáveis pode facilmente nos levar a concluir que uma causou a outra. A crença de que um efeito tem apenas uma causa é chamada de monocausalidade, mas isso raramente é verdade. Diversas variáveis podem estar por trás de um certo efeito. Assim, para considerar causalidade, primeiro precisamos mapear os elementos do sistema e avaliá-los não só quantitativamente (isto é, por métodos estatísticos), mas também qualitativamente.
Por essas razões, antes de tirar conclusões sobre relacionamentos nos dados, é importante conduzir uma análise mais profunda e detalhada para identificar possíveis correlações espúrias.
Conclusão
Esperamos que você tenha gostado deste tutorial. Correlação é um tema importante que todo aspirante a cientista de dados deve aprender. Na DataCamp, temos uma ampla variedade de cursos de estatística em que tratamos de correlação, causalidade e outros conceitos essenciais, tanto com Python quanto com R.
Depois que você tiver uma base sólida, recomendamos experimentar o DataLab, o notebook de dados com IA da DataCamp para você escrever código e aplicar o que aprendeu sem dor de cabeça com instalações.



