लगभग हर डेटा साइंस प्रोजेक्ट में वेरिएबल्स के बीच सहसंबंधों का अध्ययन शामिल होता है। सहसंबंध दो सेटों के वेरिएबल्स के बीच संबंध का सांख्यिकीय सार है। यह अन्वेषणात्मक डेटा विश्लेषण का एक मुख्य भाग है और कई उन्नत मशीन लर्निंग तकनीकों का महत्वपूर्ण पहलू भी है। यदि आप डेटा साइंस में करियर बनाने की सोच रहे हैं, तो अपने सफर में आपको सहसंबंध सीखना ही पड़ेगा।
इस ट्यूटोरियल में, हम समझाएँगे कि सहसंबंध क्या है और डेटा साइंस प्रोजेक्ट्स करते समय इसकी प्रासंगिकता क्यों है। हम यह भी देखेंगे कि वेरिएबल्स के बीच संबंध की ताकत और दिशा मापने के लिए किन-किन सहसंबंध गुणांकों का उपयोग किया जा सकता है। हम Python कोड के जरिए सरल तरीक़े से सहसंबंधों को मापने और विज़ुअलाइज़ करने के व्यावहारिक उदाहरण देंगे।
सहसंबंध क्या है?
सहसंबंध दो वेरिएबल्स के बीच संबंध या निर्भरता का सांख्यिकीय विश्लेषण है। सहसंबंध हमें दो सेटों के वेरिएबल्स के बीच संबंध की ताकत और दिशा—दोनों का अध्ययन करने देता है।
सहसंबंध का अध्ययन कई डेटा साइंस कार्यों में बहुत उपयोगी हो सकता है। पहला, यह अन्वेषणात्मक डेटा विश्लेषण का एक अहम घटक है; यानी डेटा का शुरुआती अध्ययन, जिससे हम उसका स्वरूप देखें, उसकी मुख्य विशेषताओं का सार लें, और पैटर्न व विसंगतियाँ खोजें।
दूसरा, सहसंबंधों के कई वास्तविक जीवन अनुप्रयोग हैं। वे हमें ऐसे प्रश्नों के उत्तर देने में मदद कर सकते हैं, जैसे क्या लोकतंत्र और आर्थिक विकास के बीच कोई संबंध है, या कारों का उपयोग वायु प्रदूषण के स्तर से सहसंबद्ध है या नहीं।
अंत में, मशीन लर्निंग के क्षेत्र में सहसंबंध का अध्ययन अत्यंत महत्वपूर्ण है। उदाहरण के लिए, कुछ एल्गोरिद्म तब ठीक तरह काम नहीं करते जब दो या अधिक वेरिएबल्स आपस में बहुत निकटता से संबंधित हों, जिसे आमतौर पर मल्टीकोलिनियरिटी कहा जाता है। सहसंबंध प्रिंसिपल कॉम्पोनेंट एनालिसिस का भी आधार है, जो एक रैखिक आयामीयता-घटाव तकनीक है और मशीन लर्निंग प्रोजेक्ट्स में बहुत उपयोगी होती है।
सहसंबंध के अलग-अलग प्रकार होते हैं:
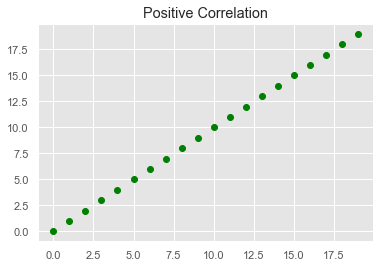
- सकारात्मक सहसंबंध: दो वेरिएबल्स को सकारात्मक रूप से सहसंबद्ध कहा जाता है जब उनके मान एक ही दिशा में बदलते हैं। उदाहरण के लिए, नीचे की छवि में जैसे-जैसे X का मान बढ़ता है, उसी स्थिर दर से Y का मान भी बढ़ता है:
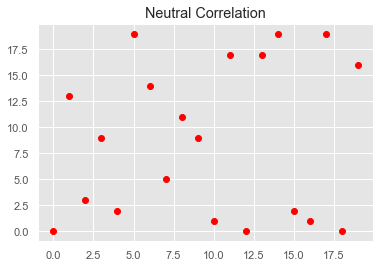
- तटस्थ सहसंबंध: X और Y वेरिएबल्स के बदलाव में कोई संबंध नहीं। इस स्थिति में मान पूरी तरह यादृच्छिक होते हैं और किसी सहसंबंध का संकेत नहीं देते, जैसा कि निम्न छवि में दिखाया गया है:
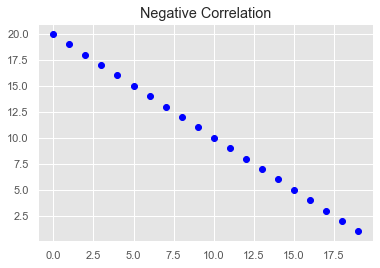
- नकारात्मक सहसंबंध: अंततः, X और Y वेरिएबल्स नकारात्मक रूप से सहसंबद्ध होंगे जब उनके मान विपरीत दिशाओं में बदलते हैं; यानी यहाँ जैसे-जैसे X का मान बढ़ता है, Y का मान एक स्थिर दर से घटता है:
हमारे डेटा का प्लॉट बनाना वेरिएबल्स के बीच सहसंबंध के प्रकार को खोजने का सबसे तेज़ और प्रभावी तरीका है। दो वेरिएबल्स के बीच निर्भरता को विज़ुअलाइज़ करने का सामान्य तरीका स्कैटरप्लॉट है। स्कैटरप्लॉट में x-अक्ष पहले वेरिएबल का मान होता है और y-अक्ष दूसरे वेरिएबल का मान। पिछली तीनों छवियाँ स्कैटरप्लॉट के प्रकार थीं। Python में स्कैटरप्लॉट बनाना देखने के लिए यह वीडियो ट्यूटोरियल देखें।
हालाँकि, कभी-कभी हमें सहसंबंध को केवल विज़ुअलाइज़ ही नहीं, बल्कि यह भी मापना होता है कि सहसंबंध कितना मज़बूत है। यहीं सहसंबंध गुणांकों की आवश्यकता पड़ती है।
सहसंबंध गुणांक
सहसंबंध गुणांक एक सांख्यिकीय सार है जो दो वेरिएबल्स के बीच संबंध की ताकत और दिशा को मापता है।
सहसंबंध गुणांकों के लाभों में से एक यह है कि वे मानकीकृत तरीक़े से दो वेरिएबल्स के बीच सहसंबंध का अनुमान लगाते हैं, यानी गुणांक का मान हमेशा एक ही स्केल पर होता है, जो -1.0 से 1.0 तक होता है।
कई प्रकार के सहसंबंध गुणांक होते हैं। किसे चुनना है यह इस पर निर्भर करता है कि हमें वेरिएबल्स के बीच संबंध की संरचना के बारे में क्या पता है। फिर भी, डेटा साइंटिस्ट सामान्यतः सबसे प्रसिद्ध—पीयरसन का सहसंबंध गुणांक—का ही उपयोग करते हैं।
पीयरसन का सहसंबंध गुणांक
पीयरसन का सहसंबंध गुणांक (r) दो वेरिएबल्स के बीच रैखिक संबंध की ताकत को मापने वाला एक स्कोर है। इसे वेरिएबल्स X और Y के सहप्रसरण को प्रत्येक वेरिएबल के मानक विचलन के गुणनफल से भाग देकर निकाला जाता है, जैसा कि निम्न सूत्र में दिखाया गया है:
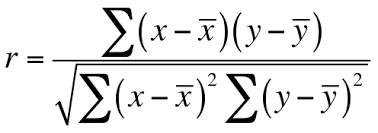
यह गुणांक दो मान्यताओं पर आधारित है। पहली, यह मानता है कि वेरिएबल्स एक सामान्य या गॉसियन वितरण का पालन करते हैं। यदि डेटा सामान्य रूप से वितरित नहीं है, तो अन्य गुणांक अधिक भरोसेमंद हो सकते हैं।
दूसरी, यह मानता है कि दोनों वेरिएबल्स के बीच एक रैखिक संबंध है, यानी डेटा में बदलावों को एक रैखिक फलन से मॉडल किया जा सकता है (अर्थात उनके मान एक स्थिर दर से साथ-साथ बढ़ते या घटते हैं)। यदि दोनों वेरिएबल्स के बीच संबंध किसी सीधी रेखा के अधिक निकट है, तो उनका (रैखिक) सहसंबंध उतना ही मजबूत होगा और पीयरसन के सहसंबंध गुणांक का परिमाण उतना ही अधिक होगा। उदाहरण के लिए, अगली छवि में सभी डेटा बिंदुओं को पूरी तरह एक सीधी रेखा से मॉडल किया जा सकता है, जिससे सहसंबंध गुणांक 1.0 के बराबर आता है।
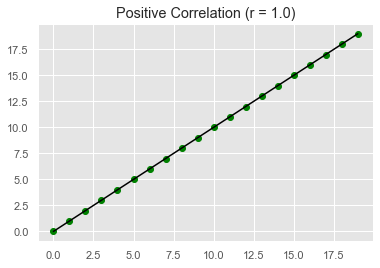
-1.0 का गुणांक एक पूर्ण नकारात्मक सहसंबंध को दर्शाता है, जबकि 1.0 का गुणांक एक पूर्ण सकारात्मक सहसंबंध दर्शाता है। इसके विपरीत, 0.0 का गुणांक यह दर्शाता है कि वेरिएबल्स के बीच कोई रैखिक सहसंबंध नहीं है।
जब गुणांक का मान शून्य के पास होता है तो उसकी व्याख्या करना अधिक कठिन हो जाता है। गुणांक के मानों की व्याख्या के लिए कई सामान्य नियम प्रस्तावित किए गए हैं। सबसे लोकप्रिय में से एक डेनिस ई. हिन्कल और उनके सह-लेखकों द्वारा उनकी पुस्तक Applied Statistics for the Behavioral Sciences में दिया गया था:
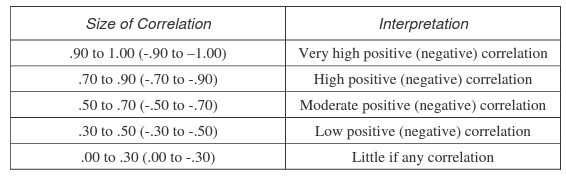 सहसंबंध गुणांक की व्याख्या के लिए सामान्य नियम। हिन्कल, वियर्स्मा, और जर्स।
यह रेखांकित करना महत्वपूर्ण है कि 0.0 के क़रीब पीयरसन का सहसंबंध गुणांक केवल यह दर्शाता है कि वेरिएबल्स के बीच कोई रैखिक संबंध नहीं है। लेकिन ऐसा हो सकता है कि इसके बजाय एक मजबूत, अ-रैखिक संबंध मौजूद हो। यदि दो वेरिएबल्स के बीच संबंध गैर-रैखिक है, तो जैसे-जैसे एक वेरिएबल बदलता है, बढ़ने-घटने की दर बदल सकती है, जिससे डेटा में वक्र जैसी आकृति बनती है। ऐसी प्रवृत्ति को किसी गैर-रैखिक फलन, जैसे द्विघात या घन फलन, से बेहतर मॉडल किया जा सकता है।
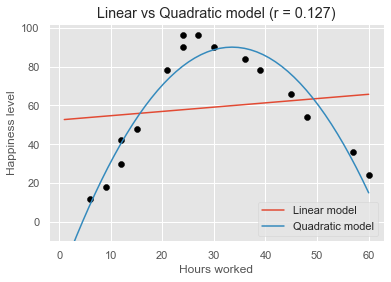
उदाहरण के लिए, निम्न छवि दिखाती है कि सप्ताह में काम के घंटों के आधार पर कर्मचारियों का खुशी स्तर कैसे बदलता है। हम देखते हैं कि जैसे-जैसे घंटों की संख्या बढ़ती है, खुशी भी बढ़ती है, लेकिन लगभग 35 घंटे के बाद घटने लगती है। रैखिक मॉडल (लाल रेखा) डेटा को अच्छी तरह फिट नहीं करता। इसके बजाय, द्विघात मॉडल (नीली रेखा), जिसे डिग्री 2 का बहुपद मॉडल भी कहते हैं, डेटा की वक्राकार आकृति को फिट करने के लिए बेहतर उम्मीदवार प्रतीत होता है। जब संबंध गैर-रैखिक होता है, तो सहसंबंध आम तौर पर उसकी ताकत को कम करके आँकता है। हमारे उदाहरण में भी ऐसा ही है, जहाँ गुणांक 0.127 के बराबर है, जो खुशी और काम के घंटों के बीच गैर-रैखिक संबंध के बारे में बहुत कम बताता है।
अन्य सहसंबंध गुणांक
पीयरसन के सहसंबंध गुणांक की सबसे बड़ी सीमा यह है कि यह दोनों वेरिएबल्स के बीच रैखिक संबंध मानकर चलता है। जबकि अक्सर वेरिएबल्स गैर-रैखिक संबंध से जुड़े होते हैं। साथ ही, उपलब्ध डेटा का वितरण गैर-गॉसियन हो सकता है। इस कमी को दूर करने के लिए सांख्यिकीविदों ने अन्य प्रकार के अनुमान प्रस्तावित किए हैं—यथा स्पीयरमैन का rho और केंडल का tau सहसंबंध गुणांक।
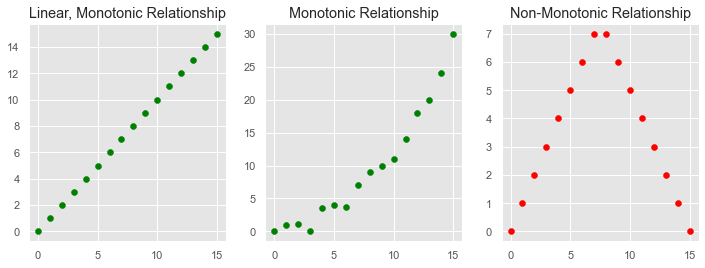
जहाँ पीयरसन का गुणांक रैखिक संबंध मानता है, वहीं स्पीयरमैन और केंडल के गुणांक मानते हैं कि वेरिएबल्स के बीच संबंध मात्र एकरस (monotonic) है। एक एकरस संबंध में वेरिएबल्स एक ही सापेक्ष दिशा में बढ़ते-घटते हैं, पर अनिवार्य रूप से स्थिर दर से नहीं। दूसरे शब्दों में, हर रैखिक संबंध एकरस होता है, लेकिन हर एकरस संबंध रैखिक नहीं होता।
गुणांकों की गणना वेरिएबल्स के सहप्रसरण और मानक विचलन से करने के बजाय, ये वेरिएबल्स के मानों की सापेक्ष रैंक पर आधारित होते हैं। यह विशिष्टता इन्हें चरम मानों के प्रति मज़बूत बनाती है और कुछ प्रकार की गैर-रैखिकताओं को संभालने के लिए उपयुक्त भी।
पीयरसन के सहसंबंध गुणांक की तरह ही, स्पीयरमैन और केंडल के गुणांकों के स्कोर भी -1 और 1 के बीच होते हैं, जो क्रमशः पूर्ण नकारात्मक और पूर्ण सकारात्मक सहसंबंध दर्शाते हैं।
फिर भी, डेटा साइंटिस्ट सामान्यतः पीयरसन के सहसंबंध गुणांक पर ही टिके रह सकते हैं। रैंक-आधारित अनुमानों का आकर्षण प्रायः छोटे डाटासेट और विशिष्ट परिकल्पना-परीक्षणों में अधिक होता है।
Python में सहसंबंध की गणना
कई Python पैकेज हमें सहसंबंध मापने में मदद कर सकते हैं। इस खंड में, हम तीन प्रसिद्ध पैकेज—SciPy, NumPy, और pandas—में उपलब्ध सहसंबंध फ़ंक्शंस पर ध्यान देंगे।
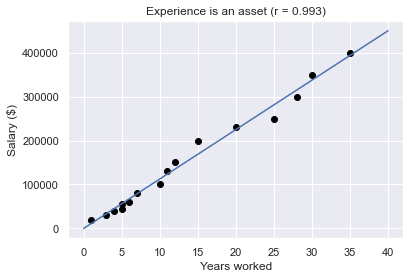
इन फ़ंक्शंस को आज़माने के लिए मान लीजिए कि हम एक छोटी किंतु सफल स्टार्टअप (16 कर्मचारियों वाली) में कार्य-अनुभव (वर्षों में) और वेतन (डॉलर में) के बीच संबंध का अध्ययन करना चाहते हैं।
experience = [1, 3, 4, 5, 5, 6, 7, 10, 11, 12, 15, 20, 25, 28, 30,35]

salary = [20000, 30000, 40000, 45000, 55000, 60000, 80000, 100000, 130000, 150000, 200000, 230000, 250000, 300000, 350000, 400000]
जैसा कि अगले ग्राफ़ में दिखता है, दोनों वेरिएबल्स के बीच एक मजबूत सकारात्मक सहसंबंध है, यानी अधिक अनुभव वाले कर्मचारी आमतौर पर अधिक वेतन पाते हैं।
SciPy सांख्यिकीय कार्यों के लिए एक बढ़िया लाइब्रेरी है। scipy.stats मॉड्यूल में pearsonr(x, y) फ़ंक्शन शामिल है, जो दो डेटा सैंपल्स के बीच पीयरसन का सहसंबंध गुणांक निकालता है।
import scipy.stats as stats

corr, _ = stats.pearsonr (experience, salary)
corr
0.9929845761480398
हम स्पीयरमैन और केंडल के गुणांक भी इसी तरह निकाल सकते हैं:
spearman_corr, _ = stats.spearmanr(experience, salary)
spearman_corr
0.9992644353546791

kendall_corr, _ = stats.kendalltau(experience, salary)
kendall_corr
0.9958246164193105
NumPy एक लोकप्रिय पैकेज है जो उन्नत गणितीय फ़ंक्शंस का व्यापक संग्रह प्रदान करता है, जिनमें np.corrcoef() भी शामिल है, जो पीयरसन के सहसंबंध गुणांकों का एक मैट्रिक्स लौटाता है:
import numpy as np

np.corrcoef(experience, salary)
array([[1.        , 0.99298458],
       [0.99298458, 1.        ]])
सहसंबंध मैट्रिक्स एक तालिका है जो वेरिएबल्स के बीच सहसंबंध गुणांक दिखाती है। तालिका की प्रत्येक कोशिका दो वेरिएबल्स के बीच सहसंबंध दर्शाती है। मैट्रिक्स का विकर्ण प्रत्येक वेरिएबल और स्वयं के बीच गुणांक शामिल करता है, जो हमेशा 1.0 होता है। मैट्रिक्स के अन्य मान अनुभव और वेतन के बीच सहसंबंध दर्शाते हैं। इस मामले में, क्योंकि हम केवल दो वेरिएबल्स के लिए सहसंबंध निकाल रहे हैं, मान समान हैं।
अंततः, हमें अक्सर pandas DataFrames में संग्रहीत वेरिएबल्स के लिए सहसंबंध निकालने की आवश्यकता होगी। मान लीजिए हमारे पास स्टार्टअप के कर्मचारियों की जानकारी वाला DataFrame है:
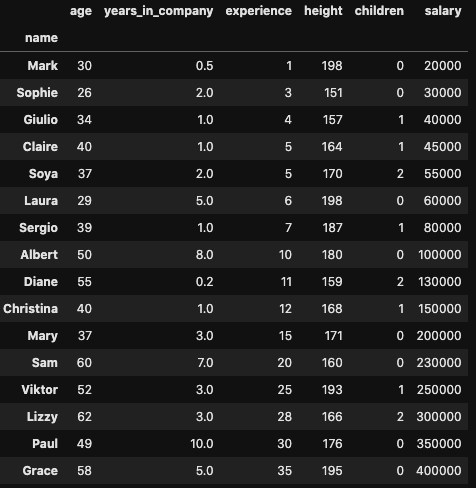
यदि हम दो कॉलम्स के बीच सहसंबंध निकालना चाहें, तो हम pandas की .corr() विधि का इस प्रकार उपयोग कर सकते हैं:
import pandas as pd

df['experience'].corr(df['salary'])
0.9929845761480398
.corr() में "method" पैरामीटर शामिल है, जिसका उपयोग तीनों सहसंबंध गुणांकों की गणना के लिए किया जा सकता है। डिफ़ॉल्ट रूप से यह पीयरसन का गुणांक निकालता है।
print(df['experience'].corr(df['salary'], method='spearman'))
print(df['experience'].corr(df['salary'], method='kendall'))
0.9992644353546791
0.9958246164193105
यदि हम सभी युग्मों के बीच सहसंबंध का पता लगाना चाहें, तो हम सीधे अपने DataFrame पर .corr() विधि का उपयोग कर सकते हैं, जो फिर से सभी युग्मों के गुणांकों वाला सहसंबंध मैट्रिक्स देता है:
df.corr()
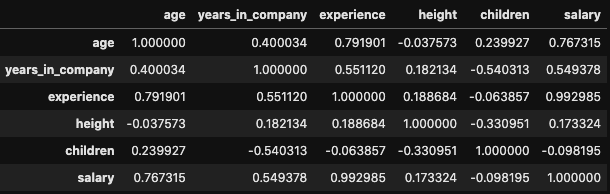
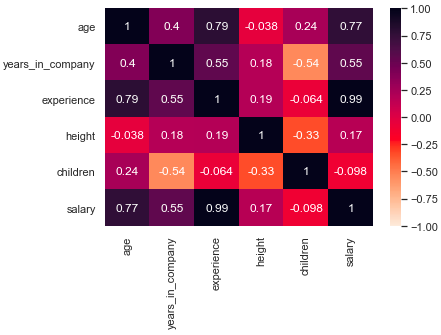
यदि हमारे DataFrame में कई कॉलम हों, तो सहसंबंध मैट्रिक्स बहुत बड़ा और समझने में कठिन हो सकता है। अपनी मैट्रिक्स से अंतर्दृष्टियाँ अधिक प्रभावी रूप से निकालने के लिए हम हीटमैप का उपयोग कर सकते हैं; यह एक डेटा विज़ुअलाइज़ेशन तकनीक है जहाँ प्रत्येक मान को उसकी तीव्रता के अनुसार एक दिए गए स्केल पर रंग द्वारा दर्शाया जाता है। हीटमैप बनाने का सबसे तेज़ तरीका seaborn लाइब्रेरी में उपलब्ध heatmap() फ़ंक्शन का उपयोग करना है:
import seaborn as sns

sns.heatmap(df.corr(), vmin=-1, vmax=1,
annot=True,cmap="rocket_r")
plt.show()
सहसंबंध कारणता का संकेत नहीं है
हम इस ट्यूटोरियल को एक महत्वपूर्ण टिप्पणी के बिना समाप्त नहीं कर सकते: सहसंबंध कारणता का संकेत नहीं है।
सहसंबंध केवल दो वेरिएबल्स के बीच संबंध की ताकत और दिशा को मात्रात्मक करता है। दो वेरिएबल्स के बीच मजबूत सहसंबंध हो सकता है, लेकिन इससे यह निष्कर्ष नहीं निकाला जा सकता कि एक दूसरे का कारण है। जब मजबूत सहसंबंध कारणात्मक नहीं होते, तो हम उन्हें मिथ्या (spurious) सहसंबंध कहते हैं।
दो स्थितियाँ मिथ्या सहसंबंधों की ओर ले जा सकती हैं:
- पहली, ऐसा हो सकता है कि कोई तीसरा, "गुमराह करने वाला" (confounding) वेरिएबल हो जो दोनों वेरिएबल्स को प्रभावित कर रहा हो। मान लीजिए किसी आबादी में आइसक्रीम की खपत और हीटस्ट्रोक की संख्या के बीच एक मजबूत सकारात्मक सहसंबंध है। कोई यह अब्सर्ड निष्कर्ष निकाल सकता है कि आइसक्रीम खाना हीटस्ट्रोक का कारण है। जबकि दरअसल दोनों वेरिएबल्स किसी तीसरे, सबसे अधिक संभावना—तापमान—पर निर्भर करते हैं। तापमान जितना अधिक होगा, उतने अधिक लोग आइसक्रीम खाना पसंद करेंगे और हीटस्ट्रोक होने की संभावना भी उतनी ही अधिक होगी।
- सहसंबंध के प्रति सावधान रहने का दूसरा कारण यह है कि वेरिएबल्स के बीच निर्भरताएँ सिर्फ संयोगवश भी हो सकती हैं। ऐसा अक्सर होता है, और छोटे सैंपल्स में इसकी संभावना अधिक होती है।
अंत में, सहसंबंध को सावधानी से लेने का एक और कारण यह है कि हमारी दुनिया जटिल है। दो वेरिएबल्स के बीच मजबूत सहसंबंध हमें आसानी से यह निष्कर्ष देने पर उकसा सकता है कि एक ने दूसरे को कारण किया। यह विश्वास कि किसी प्रभाव का सिर्फ एक ही कारण है, एक-कारणवाद (monocausality) कहलाता है, पर ऐसा शायद ही होता है। किसी प्रभाव के पीछे कई वेरिएबल्स हो सकते हैं। इसलिए कारणता पर विचार करने के लिए, पहले हमें किसी प्रणाली के सभी तत्वों को मान में लेकर उनका मूल्यांकन न केवल मात्रात्मक रूप से (जैसे सांख्यिकीय तरीकों से) बल्कि गुणात्मक रूप से भी करना चाहिए।
इन्हीं कारणों से, अपने डेटा में संबंधों के बारे में कोई निष्कर्ष निकालने से पहले, संभावित मिथ्या सहसंबंधों की पहचान के लिए अधिक गहन और विस्तृत विश्लेषण करना महत्वपूर्ण है।
निष्कर्ष
हमें आशा है कि आपको यह ट्यूटोरियल पसंद आया होगा। सहसंबंध एक महत्वपूर्ण विषय है जिसे हर उभरते डेटा साइंटिस्ट को अवश्य सीखना चाहिए। DataCamp में हमारे पास सांख्यिकी के कई पाठ्यक्रम हैं जहाँ हम सहसंबंध, कारणता और अन्य प्रमुख सांख्यिकीय अवधारणाओं से निपटते हैं, दोनों Python और R के साथ।
एक बार जब आपकी समझ मजबूत हो जाए, तो हम आपको DataLab—DataCamp की AI-सक्षम डेटा नोटबुक—आज़माने की सलाह देते हैं, ताकि आप बिना किसी इंस्टॉलेशन झंझट के कोड लिख सकें और जो सीखा है उसे लागू कर सकें।