Hampir setiap proyek data science melibatkan studi korelasi antar variabel. Korelasi adalah ringkasan statistik dari hubungan antara dua himpunan variabel. Ini merupakan bagian inti dari analisis data eksploratori, dan merupakan aspek krusial dalam berbagai teknik machine learning tingkat lanjut. Jika Anda berencana terjun ke dunia data science, cepat atau lambat Anda perlu mempelajari korelasi.
Dalam tutorial ini, kami akan menjelaskan apa itu korelasi dan relevansinya saat menjalankan proyek data science. Kami juga akan melihat berbagai koefisien korelasi yang dapat digunakan untuk mengukur kekuatan dan arah hubungan antar variabel. Kami akan menggunakan kode Python untuk memberikan contoh praktis cara mengukur dan memvisualisasikan korelasi dengan sederhana.
- Apa itu Korelasi?
- Koefisien korelasi
- Menghitung korelasi di Python
- Korelasi tidak menyiratkan kausalitas
- Kesimpulan
Apa itu Korelasi?
Korelasi adalah analisis statistik atas hubungan atau ketergantungan antara dua variabel. Korelasi memungkinkan kita mempelajari baik kekuatan maupun arah hubungan antara dua himpunan variabel.
Mempelajari korelasi sangat berguna dalam banyak tugas data science. Pertama, ini adalah komponen kunci dalam analisis data eksploratori; studi awal yang kita lakukan pada data untuk melihat seperti apa bentuknya, merangkum karakteristik utamanya, serta menemukan pola dan anomali.
Kedua, korelasi memiliki banyak aplikasi di dunia nyata. Korelasi dapat membantu kita menjawab pertanyaan, seperti apakah ada kaitan antara demokrasi dan pertumbuhan ekonomi, atau apakah penggunaan mobil berkorelasi dengan tingkat polusi udara.
Terakhir, studi korelasi krusial dalam bidang machine learning. Misalnya, beberapa algoritme tidak akan bekerja dengan baik jika dua atau lebih variabel sangat berkaitan, yang biasanya dikenal sebagai multikolinearitas. Korelasi juga menjadi dasar dari Principal Component Analysis, teknik reduksi dimensi linear yang sangat berguna dalam proyek machine learning.
Ada berbagai jenis korelasi:
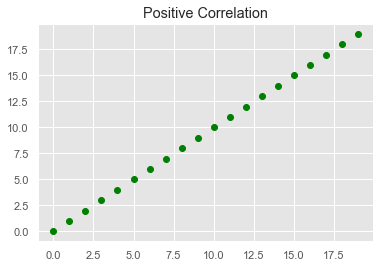
- Korelasi Positif: Dua variabel dikatakan berkorelasi positif ketika nilainya bergerak ke arah yang sama. Misalnya, pada gambar di bawah, saat nilai X meningkat, nilai Y juga meningkat pada laju yang konstan:
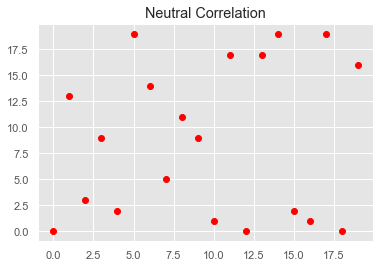
- Korelasi Netral: Tidak ada hubungan dalam perubahan variabel X dan Y. Dalam kasus ini, nilainya sepenuhnya acak dan tidak menunjukkan tanda korelasi, seperti terlihat pada gambar berikut:
- Korelasi Negatif: Terakhir, variabel X dan Y akan berkorelasi negatif ketika nilainya berubah ke arah yang berlawanan; di sini saat nilai X meningkat, nilai Y menurun pada laju yang konstan:
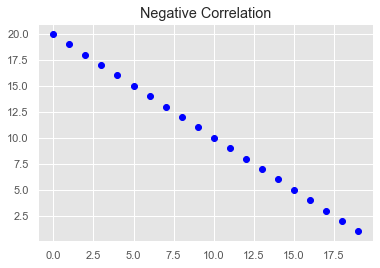
Memplot data adalah cara tercepat dan paling efektif untuk menemukan jenis korelasi antar variabel. Cara umum memvisualisasikan ketergantungan antara dua variabel adalah dengan scatterplot. Scatterplot adalah grafik di mana sumbu x berisi nilai variabel pertama, dan sumbu y berisi nilai variabel kedua. Tiga gambar terakhir adalah jenis-jenis scatterplot. Lihat video tutorial ini untuk melihat cara membuat scatterplot di Python.
Namun, terkadang kita tidak hanya perlu memvisualisasikan korelasi, tetapi juga mengukur seberapa kuat korelasi tersebut. Di sinilah koefisien korelasi berperan.
Koefisien korelasi
Koefisien korelasi adalah ringkasan statistik yang mengukur kekuatan dan arah keterkaitan antara dua variabel.
Salah satu keunggulan koefisien korelasi adalah mengestimasi korelasi antara dua variabel secara terstandarisasi, artinya nilai koefisien selalu berada pada skala yang sama, dari -1,0 hingga 1,0.
Ada beberapa koefisien korelasi. Memilih salah satunya bergantung pada apa yang kita ketahui tentang struktur hubungan antar variabel. Namun, data scientist biasanya berpegang pada yang paling terkenal: koefisien korelasi Pearson.
Koefisien korelasi Pearson
Koefisien korelasi Pearson (r) adalah skor yang mengukur kekuatan hubungan linear antara dua variabel. Nilainya dihitung dengan membagi kovarians variabel X dan Y dengan hasil kali simpangan baku masing-masing variabel, seperti ditunjukkan pada rumus berikut:
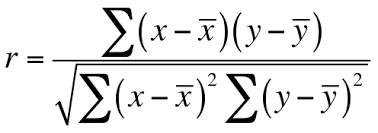
Koefisien ini didasarkan pada dua asumsi. Pertama, diasumsikan bahwa variabel mengikuti distribusi normal atau gaussian. Jika data tidak berdistribusi normal, maka koefisien lain mungkin lebih andal.
Kedua, diasumsikan bahwa terdapat hubungan linear antara kedua variabel, artinya perubahan pada data dapat dimodelkan menggunakan fungsi linear (yakni nilainya meningkat atau menurun secara bersamaan pada laju konstan). Jika hubungan antara dua variabel semakin mendekati garis lurus, maka korelasi (linear) keduanya semakin kuat dan nilai absolut koefisien korelasi Pearson semakin tinggi. Misalnya, pada gambar berikut, semua titik data dapat dimodelkan dengan sempurna menggunakan garis lurus, menghasilkan koefisien korelasi sebesar 1,0.
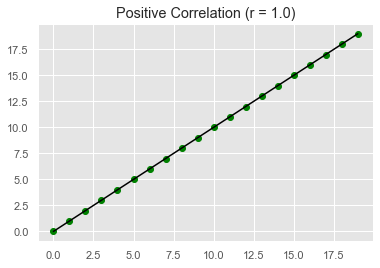
Koefisien -1,0 menunjukkan korelasi negatif sempurna, sedangkan koefisien 1,0 menunjukkan korelasi positif sempurna. Sebaliknya, koefisien 0,0 menunjukkan tidak ada korelasi linear antar variabel.
Menafsirkan koefisien menjadi lebih sulit saat nilainya mendekati nol. Beberapa aturan praktis telah diusulkan untuk menafsirkan nilai koefisien. Salah satu yang paling populer dirumuskan oleh Dennis E. Hinkle dan rekan penulisnya dalam buku Applied Statistics for the Behavioral Sciences:
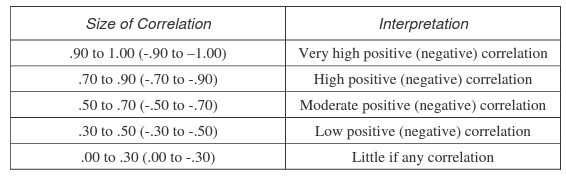 Aturan Praktis untuk Menafsirkan Koefisien Korelasi. Hinkle, Wiersma, & Jurs.
Penting untuk digarisbawahi bahwa koefisien korelasi Pearson yang mendekati 0,0 hanya menunjukkan tidak adanya hubungan linear antar variabel. Namun bisa saja terdapat hubungan kuat yang non-linear. Jika hubungan antara dua variabel bersifat non-linear, laju kenaikan atau penurunan dapat berubah seiring perubahan salah satu variabel, membentuk pola seperti kurva pada data. Tren semacam ini dapat lebih baik dimodelkan oleh fungsi non-linear, seperti fungsi kuadratik atau kubik.
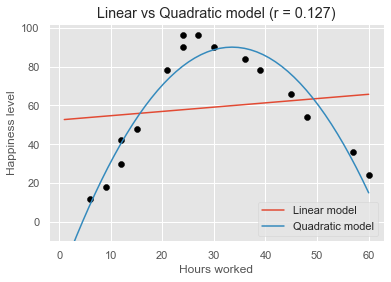
Misalnya, gambar berikut menunjukkan bagaimana tingkat kebahagiaan pekerja bervariasi tergantung pada jam kerja per minggu. Terlihat bahwa saat jumlah jam meningkat, kebahagiaan juga naik, tetapi mulai menurun setelah sekitar 35 jam. Model linear (garis merah) tidak cocok untuk memuat data. Sebaliknya, model kuadratik (garis biru), juga dikenal sebagai model polinomial berderajat 2, tampak jauh lebih tepat untuk mengikuti bentuk kurva data. Ketika hubungan bersifat non-linear, korelasi umumnya meremehkan seberapa kuat hubungan tersebut. Ini terjadi pada contoh kita, di mana koefisiennya sebesar 0,127, yang kurang menggambarkan hubungan non-linear antara kebahagiaan dan jam kerja.
Koefisien korelasi lainnya
Keterbatasan terbesar koefisien korelasi Pearson adalah asumsi adanya hubungan linear antara kedua variabel. Namun, sering kali variabel-variabel berhubungan secara non-linear. Selain itu, data yang kita miliki mungkin memiliki distribusi non-Gaussian. Untuk mengatasi kekurangan ini, ahli statistik mengusulkan jenis estimasi lain, yaitu koefisien korelasi Spearman's rho dan Kendall's tau.
Jika koefisien Pearson mengasumsikan hubungan linear, koefisien Spearman dan Kendall mengasumsikan bahwa hubungan antar variabel sekadar monoton. Dalam hubungan monoton, variabel cenderung bergerak ke arah relatif yang sama, tetapi tidak harus pada laju konstan. Dengan kata lain, setiap hubungan linear bersifat monoton, tetapi tidak setiap hubungan monoton bersifat linear.
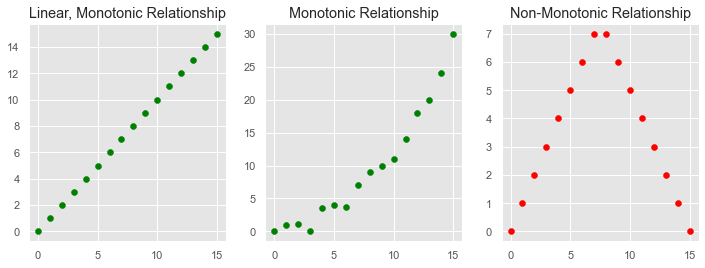
Alih-alih menghitung koefisien menggunakan kovarians dan simpangan baku variabel, koefisien ini didasarkan pada peringkat relatif nilai variabel. Kekhasan ini membuatnya tahan terhadap nilai ekstrem, dan cocok untuk menangani jenis-jenis non-linearitas tertentu.
Seperti halnya koefisien korelasi Pearson, skor koefisien Spearman dan Kendall berada antara -1 dan 1 untuk variabel yang berkorelasi negatif sempurna dan berkorelasi positif sempurna, masing-masing.
Namun, secara umum data scientist dapat tetap menggunakan koefisien korelasi Pearson. Daya tarik estimasi berbasis peringkat terutama untuk himpunan data kecil dan uji hipotesis tertentu.
Menghitung korelasi di Python
Ada berbagai paket Python yang dapat membantu kita mengukur korelasi. Pada bagian ini, kita akan berfokus pada fungsi korelasi yang tersedia di tiga paket terkenal: SciPy, NumPy, dan pandas.
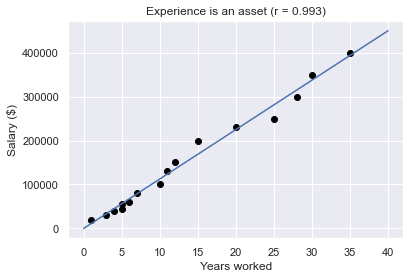
Untuk mencoba fungsinya, bayangkan kita ingin mempelajari hubungan antara pengalaman kerja (diukur dalam tahun) dan gaji (diukur dalam dolar) di sebuah startup kecil namun sukses yang terdiri dari 16 pekerja.
experience = [1, 3, 4, 5, 5, 6, 7, 10, 11, 12, 15, 20, 25, 28, 30,35]

salary = [20000, 30000, 40000, 45000, 55000, 60000, 80000, 100000, 130000, 150000, 200000, 230000, 250000, 300000, 350000, 400000]
Seperti terlihat pada grafik berikut, terdapat korelasi positif yang kuat antara kedua variabel, yang berarti karyawan dengan pengalaman lebih cenderung memiliki gaji lebih tinggi.
SciPy adalah pustaka yang sangat baik untuk melakukan operasi statistik. Modul scipy.stats menyertakan fungsi pearsonr(x, y) untuk menghitung koefisien korelasi Pearson antara dua sampel data.
import scipy.stats as stats

corr, _ = stats.pearsonr (experience, salary)
corr
0.9929845761480398
Kita dapat menghitung koefisien Spearman dan Kendall dengan cara yang sama:
spearman_corr, _ = stats.spearmanr(experience, salary)
spearman_corr
0.9992644353546791

kendall_corr, _ = stats.kendalltau(experience, salary)
kendall_corr
0.9958246164193105
NumPy adalah paket populer yang menawarkan kumpulan fungsi matematika tingkat lanjut, termasuk np.corrcoef() yang mengembalikan matriks koefisien korelasi Pearson:
import numpy as np

np.corrcoef(experience, salary)
array([[1.        , 0.99298458],
       [0.99298458, 1.        ]])
Matriks korelasi adalah tabel yang menampilkan koefisien korelasi antar variabel. Setiap sel dalam tabel menunjukkan korelasi antara dua variabel. Diagonal matriks memuat koefisien antara setiap variabel dengan dirinya sendiri, yang selalu bernilai 1,0. Nilai lainnya dalam matriks merepresentasikan korelasi antara pengalaman dan gaji. Dalam kasus ini, karena kita hanya menghitung korelasi untuk dua variabel, nilainya sama.
Terakhir, kita biasanya perlu menghitung korelasi untuk variabel yang disimpan dalam pandas DataFrame. Bayangkan kita memiliki DataFrame dengan informasi tentang para pekerja di startup tersebut:
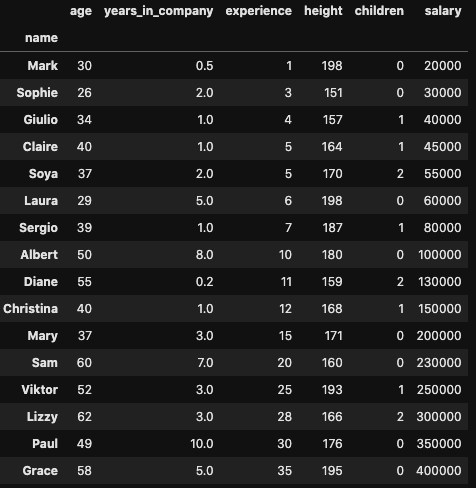
Jika kita ingin menghitung korelasi antara dua kolom, kita dapat menggunakan metode pandas .corr(), seperti berikut:
import pandas as pd

df['experience'].corr(df['salary'])
0.9929845761480398
Metode .corr() menyertakan parameter "method", yang dapat digunakan untuk menghitung ketiga koefisien korelasi. Secara bawaan, yang dihitung adalah Pearson.
print(df['experience'].corr(df['salary'], method='spearman'))
print(df['experience'].corr(df['salary'], method='kendall'))
0.9992644353546791
0.9958246164193105
Jika kita ingin mengeksplorasi korelasi antara semua pasangan variabel, kita cukup menggunakan metode .corr() langsung pada DataFrame, yang kembali menghasilkan matriks korelasi dengan koefisien untuk semua pasangan variabel:
df.corr()
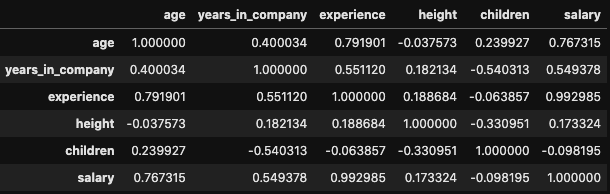
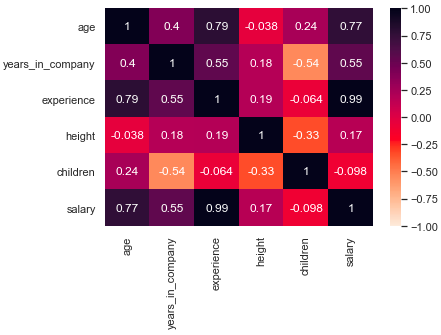
Matriks korelasi bisa sangat besar dan sulit ditafsirkan jika DataFrame memiliki banyak kolom. Untuk mengekstrak insight dari matriks secara lebih efektif, kita dapat menggunakan heatmap; teknik visualisasi data di mana setiap nilai direpresentasikan oleh warna sesuai intensitasnya pada skala tertentu. Cara tercepat untuk membuat heatmap adalah menggunakan fungsi heatmap(), yang tersedia di pustaka seaborn:
import seaborn as sns

sns.heatmap(df.corr(), vmin=-1, vmax=1,
annot=True,cmap="rocket_r")
plt.show()
Korelasi tidak menyiratkan kausalitas
Kami tidak dapat menutup tutorial ini tanpa menyebutkan catatan penting: korelasi tidak menyiratkan kausalitas.
Korelasi hanya mengukur kekuatan dan arah hubungan antara dua variabel. Mungkin ada korelasi kuat antara dua variabel, tetapi ini tidak memungkinkan kita menyimpulkan bahwa yang satu menyebabkan yang lain. Ketika korelasi kuat tidak bersifat kausal, kita menyebutnya korelasi semu (spurious).
Ada dua skenario yang dapat menimbulkan korelasi semu:
- Pertama, bisa jadi ada variabel ketiga, "perancu" (confounding), yang menyebabkan kedua variabel tersebut. Bayangkan ada korelasi positif yang kuat antara konsumsi es krim dan jumlah kasus heatstroke pada suatu populasi. Seseorang bisa saja sampai pada kesimpulan absurd bahwa makan es krim menyebabkan heatstroke. Namun, yang terjadi adalah kedua variabel bergantung pada variabel ketiga, kemungkinan besar suhu. Semakin tinggi suhu, semakin banyak orang ingin makan es krim, dan semakin besar pula kemungkinan orang mengalami heatstroke.
- Alasan kedua untuk berhati-hati terhadap korelasi adalah ketergantungan antar variabel bisa jadi hanya kebetulan. Ini sering terjadi, dan lebih mungkin saat kita berurusan dengan sampel kecil.
Terakhir, alasan lain untuk berhati-hati terhadap korelasi adalah dunia tempat kita hidup itu kompleks. Korelasi yang lebih kuat antara dua variabel dapat dengan mudah membuat kita menyimpulkan bahwa satu menyebabkan yang lain. Keyakinan bahwa suatu efek hanya memiliki satu penyebab disebut monokausalitas, tetapi ini jarang terjadi. Beberapa variabel bisa berada di balik suatu efek. Maka, untuk mempertimbangkan kausalitas, pertama-tama kita perlu mengasumsikan seluruh elemen sistem dan mengevaluasinya tidak hanya secara kuantitatif (melalui metode statistik) tetapi juga secara kualitatif.
Karena alasan-alasan tersebut, sebelum membuat kesimpulan apa pun tentang hubungan dalam data, penting untuk melakukan analisis yang lebih menyeluruh dan mendetail untuk mengidentifikasi kemungkinan korelasi semu.
Kesimpulan
Semoga Anda menikmati tutorial ini. Korelasi adalah topik penting yang harus dipelajari setiap calon data scientist. Di DataCamp, kami memiliki banyak kursus statistik yang membahas korelasi, kausalitas, dan konsep statistik kunci lainnya, baik dengan Python maupun R.
Setelah Anda memiliki pemahaman yang solid, kami sarankan Anda mencoba DataLab, notebook data bertenaga AI dari DataCamp untuk menulis kode dan menerapkan apa yang telah Anda pelajari tanpa repot instalasi.



