
Presque tous les projets de data science impliquent l’étude des corrélations entre variables. Une corrélation est un résumé statistique de la relation entre deux ensembles de variables. C’est un élément clé de l’analyse exploratoire des données et un pilier de nombreuses techniques avancées d’apprentissage automatique. Si vous envisagez de vous lancer en data science, vous devrez tôt ou tard apprendre la corrélation.
Dans ce tutoriel, nous expliquons ce qu’est la corrélation et pourquoi elle est importante dans les projets de data science. Nous verrons aussi les différents coefficients de corrélation qui permettent de mesurer l’intensité et le sens de la relation entre variables. Nous utiliserons du code Python pour illustrer concrètement comment mesurer et visualiser des corrélations simplement.
- Qu’est-ce que la corrélation ?
- Coefficients de corrélation
- Calculer une corrélation en Python
- Corrélation ne vaut pas causalité
- Conclusion
Qu’est-ce que la corrélation ?
La corrélation est l’analyse statistique de la relation ou de la dépendance entre deux variables. Elle permet d’étudier à la fois l’intensité et la direction de la relation entre deux ensembles de variables.
Étudier la corrélation est très utile dans de nombreuses tâches de data science. D’abord, c’est un composant essentiel de l’analyse exploratoire des données : l’examen initial de nos données pour voir à quoi elles ressemblent, en résumer les principales caractéristiques et repérer structures et anomalies.
Ensuite, les corrélations ont de nombreuses applications concrètes. Elles aident par exemple à répondre à des questions comme l’existence d’un lien entre démocratie et croissance économique, ou entre usage de la voiture et niveau de pollution de l’air.
Enfin, l’étude des corrélations est cruciale en apprentissage automatique. Par exemple, certains algorithmes fonctionnent mal si deux ou plusieurs variables sont fortement liées, un phénomène connu sous le nom de multicolinéarité. La corrélation est également à la base de l’analyse en composantes principales, une technique linéaire de réduction de dimension très utile dans les projets de machine learning.
Il existe différents types de corrélation :
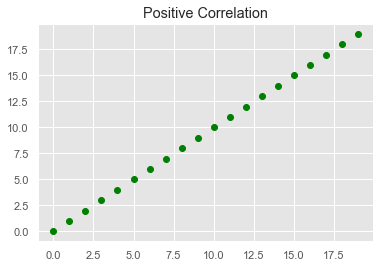
- Corrélation positive : deux variables sont dites positivement corrélées lorsque leurs valeurs évoluent dans le même sens. Par exemple, dans l’image ci-dessous, à mesure que la valeur de X augmente, celle de Y augmente aussi à un rythme constant :
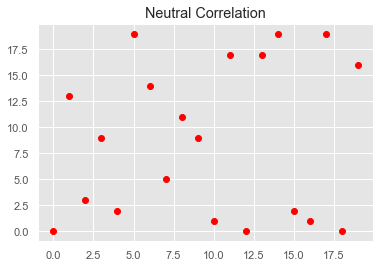
- Corrélation nulle : aucune relation dans l’évolution des variables X et Y. Les valeurs sont alors complètement aléatoires et ne montrent aucun signe de corrélation, comme dans l’image suivante :
- Corrélation négative : les variables X et Y sont négativement corrélées lorsque leurs valeurs évoluent en sens opposés ; ici, quand X augmente, Y diminue à un rythme constant :
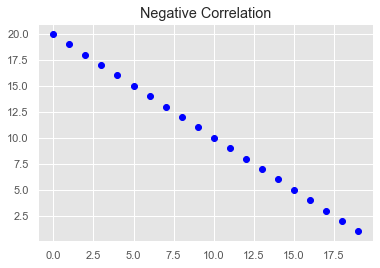
Représenter les données est le moyen le plus rapide et efficace pour identifier le type de corrélation entre variables. La méthode classique consiste à utiliser un nuage de points. Dans un nuage de points, l’axe des x porte la première variable et l’axe des y la seconde. Les trois images précédentes sont des variantes de nuages de points. Consultez ce tutoriel vidéo pour apprendre à créer un nuage de points en Python.
Cependant, il ne suffit pas toujours de visualiser : il faut parfois aussi mesurer la force de la corrélation. C’est là qu’interviennent les coefficients de corrélation.
Coefficients de corrélation
Un coefficient de corrélation est un indicateur statistique qui mesure la force et la direction de l’association entre deux variables.
L’un des avantages des coefficients de corrélation est qu’ils estiment la relation entre deux variables de manière standardisée : leur valeur est toujours sur la même échelle, de -1,0 à 1,0.
Il existe plusieurs coefficients de corrélation. Le choix dépend de ce que l’on sait de la structure de la relation entre les variables. Néanmoins, en pratique, les data scientists utilisent le plus souvent le coefficient de Pearson.
Le coefficient de corrélation de Pearson
Le coefficient de corrélation de Pearson (r) mesure l’intensité d’une relation linéaire entre deux variables. Il se calcule en divisant la covariance des variables X et Y par le produit de leurs écarts types, comme dans la formule suivante :
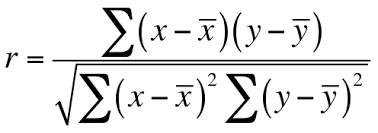
Ce coefficient repose sur deux hypothèses. Premièrement, il suppose que les variables suivent une distribution normale (gaussienne). Si les données ne sont pas normales, d’autres coefficients peuvent être plus fiables.
Deuxièmement, il suppose une relation linéaire entre les deux variables, c’est-à-dire que les variations peuvent être modélisées par une fonction linéaire (les valeurs augmentent ou diminuent simultanément à un rythme constant). Plus la relation est proche d’une droite, plus la corrélation (linéaire) est forte et plus la valeur absolue du coefficient de Pearson est élevée. Par exemple, dans l’image suivante, tous les points s’alignent parfaitement sur une droite, ce qui donne un coefficient égal à 1,0.
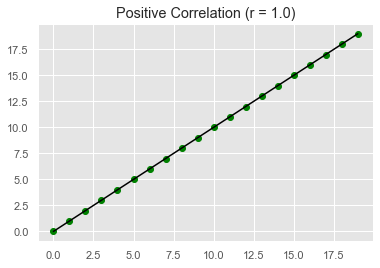
Un coefficient de -1,0 indique une corrélation négative parfaite, tandis qu’un coefficient de 1,0 signale une corrélation positive parfaite. À l’inverse, un coefficient de 0,0 indique l’absence de corrélation linéaire entre les variables.
L’interprétation devient plus délicate lorsque la valeur se rapproche de zéro. Plusieurs règles empiriques ont été proposées pour interpréter ces valeurs. L’une des plus connues a été formulée par Dennis E. Hinkle et ses co-auteurs dans leur ouvrage Applied Statistics for the Behavioral Sciences :
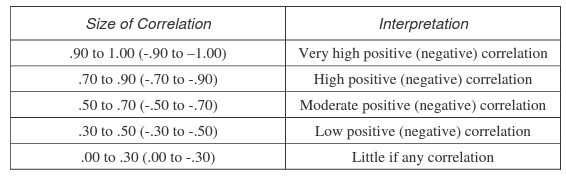 Règle empirique d’interprétation du coefficient de corrélation. Hinkle, Wiersma, & Jurs.
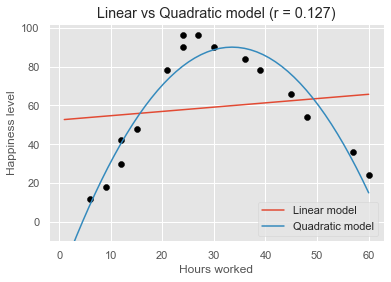
Il est important de rappeler qu’un coefficient de Pearson proche de 0,0 indique seulement l’absence de relation linéaire. Il peut néanmoins exister une relation non linéaire forte. Si la relation est non linéaire, le rythme d’augmentation ou de diminution peut varier avec la valeur d’une variable, dessinant une courbe dans les données. Une telle tendance sera mieux modélisée par une fonction non linéaire, par exemple quadratique ou cubique.
Par exemple, l’image suivante illustre l’évolution du niveau de bonheur des salarié·e·s en fonction du nombre d’heures travaillées par semaine. On observe qu’au-delà d’environ 35 heures, le bonheur commence à décroître. Le modèle linéaire (ligne rouge) s’ajuste mal aux données. Un modèle quadratique (ligne bleue), c’est-à-dire un polynôme de degré 2, convient bien mieux à la courbure observée. Quand la relation est non linéaire, la corrélation sous-estime généralement sa force. C’est le cas ici, avec un coefficient égal à 0,127, qui renseigne peu sur la relation non linéaire entre bonheur et heures travaillées.
Autres coefficients de corrélation
La principale limite du coefficient de Pearson est qu’il suppose une relation linéaire entre les deux variables. Or, bien souvent, les variables sont liées par une relation non linéaire. De plus, les données peuvent ne pas suivre une distribution gaussienne. Pour répondre à ces limites, d’autres estimateurs ont été proposés : les coefficients de corrélation de Spearman (rho) et de Kendall (tau).
Alors que Pearson suppose la linéarité, Spearman et Kendall supposent seulement une relation monotone. Dans une relation monotone, les variables évoluent dans le même sens relatif, mais pas forcément à rythme constant. Autrement dit, toute relation linéaire est monotone, mais l’inverse n’est pas vrai.
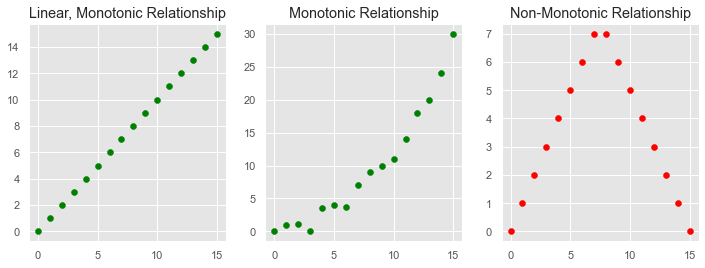
Au lieu d’utiliser la covariance et les écarts types, ces coefficients se basent sur le rang des valeurs. Cette particularité les rend robustes aux valeurs extrêmes et adaptés à certains types de non-linéarités.
Comme pour Pearson, les scores de Spearman et de Kendall varient entre -1 et 1 selon que les variables sont parfaitement négativement ou positivement corrélées.
Cependant, dans la plupart des cas, le coefficient de Pearson suffit. Les estimateurs fondés sur les rangs sont surtout utiles pour de petits jeux de données et des tests d’hypothèses spécifiques.
Calculer une corrélation en Python
Plusieurs bibliothèques Python permettent de mesurer des corrélations. Dans cette section, nous nous concentrons sur les fonctions disponibles dans trois packages bien connus : SciPy, NumPy et pandas.
Pour tester ces fonctions, imaginons que nous voulons étudier la relation entre l’expérience (en années) et le salaire (en dollars) dans une petite start-up performante de 16 salarié·e·s.
experience = [1, 3, 4, 5, 5, 6, 7, 10, 11, 12, 15, 20, 25, 28, 30,35]

salary = [20000, 30000, 40000, 45000, 55000, 60000, 80000, 100000, 130000, 150000, 200000, 230000, 250000, 300000, 350000, 400000]
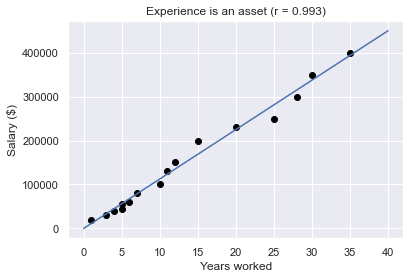
Comme on le voit sur le graphique suivant, il existe une forte corrélation positive entre les deux variables : les employé·e·s plus expérimenté·e·s tendent à avoir des salaires plus élevés.
SciPy est une excellente bibliothèque pour les opérations statistiques. Le module scipy.stats propose la fonction pearsonr(x, y) pour calculer le coefficient de corrélation de Pearson entre deux échantillons.
import scipy.stats as stats

corr, _ = stats.pearsonr (experience, salary)
corr
0.9929845761480398
Nous pouvons calculer de la même manière les coefficients de Spearman et de Kendall :
spearman_corr, _ = stats.spearmanr(experience, salary)
spearman_corr
0.9992644353546791

kendall_corr, _ = stats.kendalltau(experience, salary)
kendall_corr
0.9958246164193105
NumPy est une bibliothèque populaire offrant de nombreuses fonctions mathématiques avancées, dont np.corrcoef() qui retourne une matrice de coefficients de corrélation de Pearson :
import numpy as np

np.corrcoef(experience, salary)
array([[1.        , 0.99298458],
       [0.99298458, 1.        ]])
Une matrice de corrélation est un tableau qui regroupe les coefficients entre variables. Chaque cellule montre la corrélation entre une paire de variables. La diagonale contient les coefficients d’une variable avec elle-même, toujours égaux à 1,0. Les autres valeurs représentent ici la corrélation entre l’expérience et le salaire. Comme nous n’avons que deux variables, les valeurs se répètent.
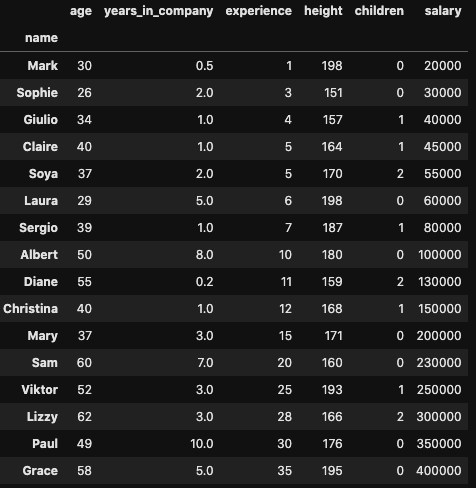
Enfin, il est courant de calculer des corrélations pour des variables stockées dans des DataFrames pandas. Imaginons que nous disposions d’un DataFrame avec des informations sur les salarié·e·s de la start-up :
Pour calculer la corrélation entre deux colonnes, nous pouvons utiliser la méthode .corr() de pandas :
import pandas as pd

df['experience'].corr(df['salary'])
0.9929845761480398
La méthode .corr() accepte le paramètre "method" pour choisir parmi les trois coefficients. Par défaut, elle calcule celui de Pearson.
print(df['experience'].corr(df['salary'], method='spearman'))
print(df['experience'].corr(df['salary'], method='kendall'))
0.9992644353546791
0.9958246164193105
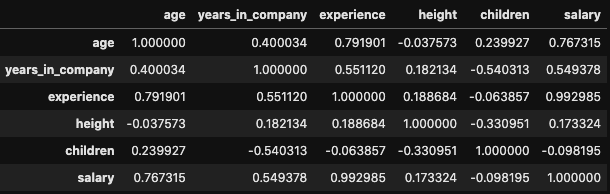
Si l’on souhaite explorer la corrélation entre toutes les paires de variables, on peut appliquer directement .corr() au DataFrame, ce qui renvoie une matrice de corrélation avec les coefficients de toutes les paires :
df.corr()
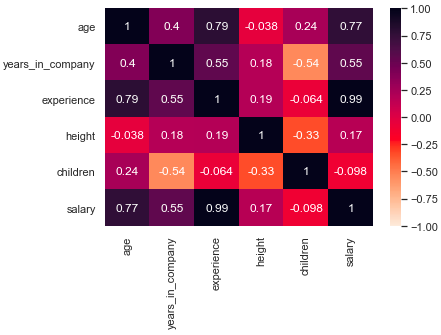
La matrice de corrélation peut devenir très grande et difficile à lire si le DataFrame comporte de nombreuses colonnes. Pour en extraire plus facilement des enseignements, on peut recourir à une heatmap : une représentation où chaque valeur est codée par une couleur en fonction de son intensité. Le moyen le plus rapide de créer une heatmap est d’utiliser la fonction heatmap(), disponible dans la bibliothèque seaborn :
import seaborn as sns

sns.heatmap(df.corr(), vmin=-1, vmax=1,
annot=True,cmap="rocket_r")
plt.show()
Corrélation ne vaut pas causalité
Impossible de conclure ce tutoriel sans rappeler un point essentiel : corrélation ne vaut pas causalité.
La corrélation ne fait que quantifier la force et la direction de la relation entre deux variables. Deux variables peuvent être fortement corrélées sans que l’une cause l’autre. Lorsqu’une corrélation forte n’est pas causale, on parle de corrélation fallacieuse.
Deux cas de figure mènent souvent à des corrélations fallacieuses :
- D’abord, il peut exister une troisième variable « confondante » qui explique les deux. Imaginons une forte corrélation positive entre la consommation de glace et le nombre d’insolations dans une population. On pourrait en conclure à tort que manger des glaces provoque des insolations. En réalité, ces deux variables dépendent de la température : plus il fait chaud, plus on mange de glaces, et plus les insolations sont fréquentes.
- Ensuite, des dépendances peuvent simplement être dues au hasard, ce qui arrive fréquemment, en particulier sur de petits échantillons.
Enfin, gardons à l’esprit que le monde est complexe. Une forte corrélation entre deux variables peut conduire hâtivement à une conclusion causale. Croire qu’un effet n’a qu’une seule cause (monocausalité) est rarement justifié. Plusieurs variables peuvent concourir à un même effet. Pour envisager la causalité, il faut considérer l’ensemble des éléments du système et les évaluer tant quantitativement (méthodes statistiques) que qualitativement.
Pour toutes ces raisons, avant de tirer des conclusions sur les relations dans nos données, il est important de mener une analyse plus approfondie afin d’identifier d’éventuelles corrélations fallacieuses.
Conclusion
Nous espérons que ce tutoriel vous a plu. La corrélation est un sujet incontournable que tout aspirant data scientist doit connaître. Sur DataCamp, nous proposons de nombreux cours de statistiques où nous traitons corrélation, causalité et autres notions clés, aussi bien avec Python qu’avec R.
Une fois les bases solides acquises, nous vous recommandons d’essayer DataLab, le notebook de données de DataCamp, dopé à l’IA, pour coder et mettre en pratique vos apprentissages sans aucune installation.


