
Last chance! 50% off DataCamp Premium
Sale ends in
Quasi ogni progetto di data science prevede lo studio delle correlazioni tra variabili. Una correlazione è il riepilogo statistico della relazione tra due insiemi di variabili. È una parte fondamentale dell’analisi esplorativa dei dati ed è un aspetto critico di numerose tecniche avanzate di machine learning. Se stai pensando di entrare nella data science, prima o poi nel tuo percorso dovrai imparare la correlazione.
In questo tutorial spiegheremo che cos’è la correlazione e la sua rilevanza nei progetti di data science. Vedremo anche i diversi coefficienti di correlazione che possiamo usare per misurare l’intensità e la direzione della relazione tra variabili. Useremo codice Python per fornire esempi pratici su come misurare e visualizzare le correlazioni in modo semplice.
La correlazione è l’analisi statistica della relazione o dipendenza tra due variabili. La correlazione consente di studiare sia l’intensità sia la direzione della relazione tra due insiemi di variabili.
Studiare la correlazione può essere molto utile in molte attività di data science. Per cominciare, è un componente chiave dell’analisi esplorativa dei dati; lo studio iniziale che conduciamo sui nostri dati per vedere come si presentano, riassumerne le principali caratteristiche e scoprire pattern e anomalie.
Inoltre, le correlazioni hanno molte applicazioni nel mondo reale. Possono aiutarci a rispondere a domande come se esista un legame tra democrazia e crescita economica, o se l’uso dell’auto sia correlato al livello di inquinamento atmosferico.
Infine, lo studio della correlazione è fondamentale nel campo del machine learning. Per esempio, alcuni algoritmi non funzionano correttamente se due o più variabili sono strettamente correlate, fenomeno solitamente noto come multicollinearità. La correlazione è anche alla base dell’Analisi delle Componenti Principali, una tecnica lineare di riduzione della dimensionalità molto utile nei progetti di machine learning.
Esistono diversi tipi di correlazione:
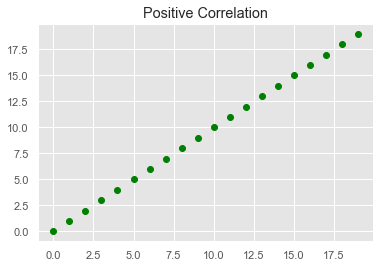
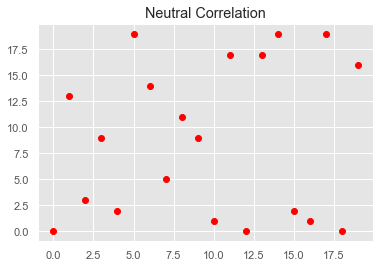
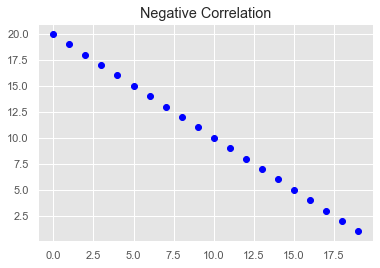
Rappresentare i dati in un grafico è il modo più rapido ed efficace per scoprire il tipo di correlazione tra variabili. Il modo tipico per visualizzare le dipendenze tra due variabili è con uno scatter plot. Uno scatter plot è un grafico in cui l’asse x rappresenta il valore della prima variabile e l’asse y il valore della seconda. Le ultime tre immagini erano tipi di scatter plot. Dai un’occhiata a questo video tutorial per vedere come creare uno scatter plot in Python.
Tuttavia, a volte non avremo solo bisogno di visualizzare la correlazione, ma anche di misurare quanto sia forte. È qui che entrano in gioco i coefficienti di correlazione.
Un coefficiente di correlazione è un riepilogo statistico che misura l’intensità e la direzione con cui due variabili sono associate tra loro.
Uno dei vantaggi dei coefficienti di correlazione è che stimano la correlazione tra due variabili in modo standardizzato, il che significa che il valore del coefficiente sarà sempre sulla stessa scala, compresa tra -1,0 e 1,0.
Esistono diversi coefficienti di correlazione. La scelta dipende da ciò che sappiamo sulla struttura della relazione tra le variabili. Tuttavia, i data scientist in genere si affidano al più famoso: il coefficiente di correlazione di Pearson.
Il coefficiente di correlazione di Pearson (r) è un punteggio che misura l’intensità di una relazione lineare tra due variabili. Si calcola dividendo la covarianza delle variabili X e Y per il prodotto delle deviazioni standard di ciascuna variabile, come mostrato nella seguente formula:
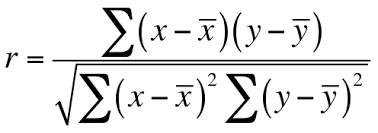
Il coefficiente si basa su due assunzioni. Primo, presume che le variabili seguano una distribuzione normale o gaussiana. Se i dati non sono normalmente distribuiti, altri coefficienti possono essere più affidabili.
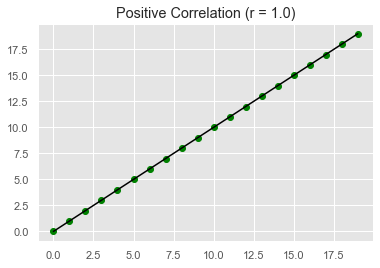
Secondo, presume che ci sia una relazione lineare tra le due variabili, cioè che i cambiamenti nei dati possano essere modellati con una funzione lineare (ovvero i loro valori aumentano o diminuiscono simultaneamente a un tasso costante). Se la relazione tra le due variabili è più vicina a una linea retta, allora la loro correlazione (lineare) è più forte e il valore assoluto del coefficiente di Pearson è più alto. Per esempio, nella prossima immagine, tutti i punti dati possono essere modellati perfettamente con una linea retta, risultando in un coefficiente di correlazione pari a 1,0.
Un coefficiente di -1,0 indica una correlazione negativa perfetta, mentre un coefficiente di 1,0 indica una correlazione positiva perfetta. Al contrario, un coefficiente di 0,0 indica che non c’è correlazione lineare tra le variabili.
L’interpretazione del coefficiente diventa più difficile quando il suo valore si avvicina a zero. Sono state proposte varie regole pratiche per interpretarne i valori. Una delle più popolari è stata formulata da Dennis E. Hinkle e coautori nel libro Applied Statistics for the Behavioral Sciences:
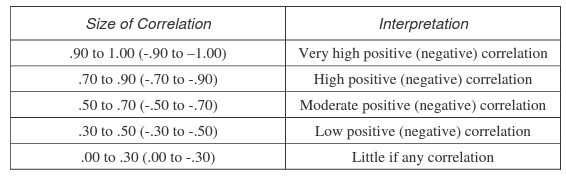 Regola pratica per interpretare il coefficiente di correlazione. Hinkle, Wiersma e Jurs.
È importante sottolineare che un coefficiente di Pearson vicino a 0,0 indica solo che non esiste una relazione lineare tra le variabili. Ma potrebbe comunque esserci una forte relazione non lineare. Se la relazione tra due variabili è non lineare, il tasso di aumento o diminuzione può cambiare al variare di una variabile, tracciando nei dati un andamento a forma di curva. Una tale tendenza potrebbe essere meglio modellata da una funzione non lineare, come una funzione quadratica o cubica.
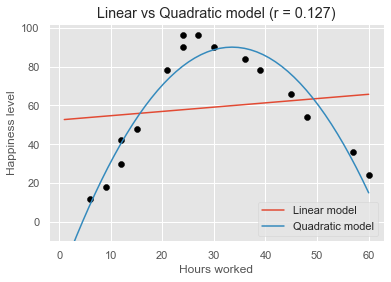
Per esempio, la seguente immagine mostra come varia il livello di felicità dei lavoratori in base alle ore lavorate a settimana. Si vede che, all’aumentare del numero di ore, la felicità cresce, ma inizia a diminuire oltre circa 35 ore. Il modello lineare (linea rossa) non è adatto a descrivere i dati. Invece, un modello quadratico (linea blu), noto anche come modello polinomiale di grado 2, sembra un candidato molto migliore per adattare l’andamento curvilineo dei dati. Quando la relazione è non lineare, la correlazione in genere sottostima quanto sia forte. È il caso del nostro esempio, in cui il coefficiente è pari a 0,127 e dice poco della relazione non lineare tra felicità e ore lavorate.
La principale limitazione del coefficiente di Pearson è che presume una relazione lineare tra le due variabili. Tuttavia, spesso le variabili sono associate da una relazione non lineare. Inoltre, i dati a disposizione potrebbero avere una distribuzione non gaussiana. Per ovviare a questa limitazione, gli statistici hanno proposto altri tipi di stime, ovvero i coefficienti di correlazione rho di Spearman e tau di Kendall.
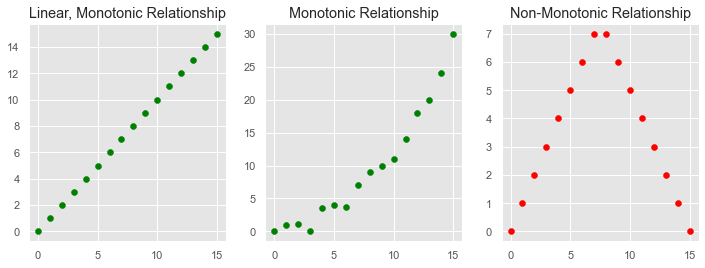
Mentre il coefficiente di Pearson presume relazioni lineari, i coefficienti di Spearman e Kendall assumono che la relazione tra le variabili sia semplicemente monotona. In una relazione monotona, le variabili tendono a muoversi nella stessa direzione relativa, ma non necessariamente a un tasso costante. In altre parole, ogni relazione lineare è monotona, ma non ogni relazione monotona è lineare.
Invece di calcolare i coefficienti usando covarianza e deviazioni standard delle variabili, essi si basano sul rango relativo dei valori delle variabili. Questa particolarità li rende stime robuste rispetto ai valori estremi e adatte a gestire certi tipi di non linearità.
Come per il coefficiente di Pearson, anche i punteggi dei coefficienti di Spearman e Kendall sono compresi tra -1 e 1 per variabili perfettamente correlate negativamente e positivamente, rispettivamente.
Tuttavia, in generale i data scientist possono attenersi al coefficiente di Pearson. L’attrattiva delle stime basate sui ranghi riguarda soprattutto dataset piccoli e test di ipotesi specifici.
Esistono vari pacchetti Python che possono aiutarci a misurare la correlazione. In questa sezione ci concentreremo sulle funzioni di correlazione disponibili in tre pacchetti ben noti: SciPy, NumPy e pandas.
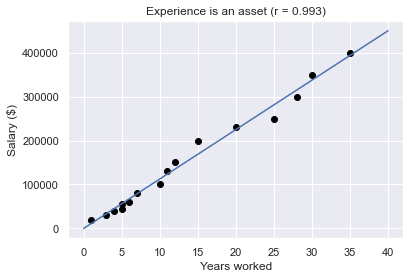
Per provare le funzioni, immagina di voler studiare la relazione tra esperienza lavorativa (misurata in anni) e stipendio (misurato in dollari) in una piccola ma di successo startup composta da 16 lavoratori.
experience = [1, 3, 4, 5, 5, 6, 7, 10, 11, 12, 15, 20, 25, 28, 30,35]

salary = [20000, 30000, 40000, 45000, 55000, 60000, 80000, 100000, 130000, 150000, 200000, 230000, 250000, 300000, 350000, 400000]
Come possiamo vedere nel prossimo grafico, c’è una forte correlazione positiva tra le due variabili, il che significa che i dipendenti con più esperienza tendono ad avere stipendi più alti.
SciPy è un’ottima libreria per eseguire operazioni statistiche. Il modulo scipy.stats include la funzione pearsonr(x, y) per calcolare il coefficiente di correlazione di Pearson tra due campioni di dati.
import scipy.stats as stats

corr, _ = stats.pearsonr (experience, salary)
corr
0.9929845761480398
Possiamo calcolare allo stesso modo i coefficienti di Spearman e Kendall:
spearman_corr, _ = stats.spearmanr(experience, salary)
spearman_corr
0.9992644353546791

kendall_corr, _ = stats.kendalltau(experience, salary)
kendall_corr
0.9958246164193105
NumPy è un pacchetto molto diffuso che offre un’ampia collezione di funzioni matematiche avanzate, tra cui np.corrcoef() che restituisce una matrice di coefficienti di correlazione di Pearson:
import numpy as np

np.corrcoef(experience, salary)
array([[1.        , 0.99298458],
       [0.99298458, 1.        ]])
Una matrice di correlazione è una tabella che mostra i coefficienti di correlazione tra variabili. Ogni cella della tabella mostra la correlazione tra due variabili. La diagonale della matrice include i coefficienti tra ciascuna variabile e sé stessa, che è sempre pari a 1,0. Gli altri valori della matrice rappresentano la correlazione tra esperienza e stipendio. In questo caso, dato che stiamo calcolando la correlazione solo per due variabili, i valori sono gli stessi.
Infine, di solito avremo bisogno di calcolare la correlazione per le nostre variabili archiviate in DataFrame di pandas. Immagina di avere il nostro DataFrame con le informazioni sui lavoratori della startup:
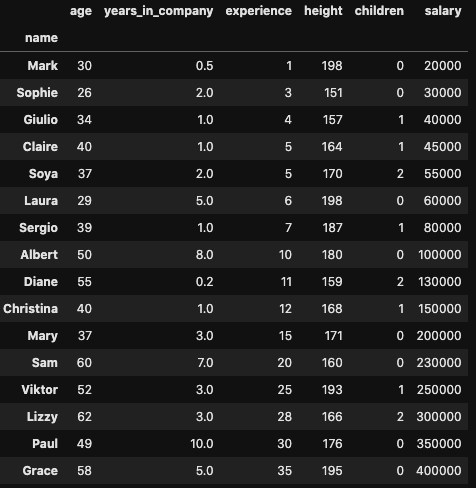
Se volessimo calcolare la correlazione tra due colonne, potremmo usare il metodo .corr() di pandas, come segue:
import pandas as pd

df['experience'].corr(df['salary'])
0.9929845761480398
.corr() include il parametro "method", che può essere usato per calcolare i tre coefficienti di correlazione. Per impostazione predefinita, calcola quello di Pearson.
print(df['experience'].corr(df['salary'], method='spearman'))
print(df['experience'].corr(df['salary'], method='kendall'))
0.9992644353546791
0.9958246164193105
Se volessimo esplorare la correlazione tra tutte le coppie di variabili, potremmo semplicemente usare il metodo .corr() direttamente sul nostro DataFrame, che restituisce nuovamente una matrice di correlazione con il coefficiente di tutte le coppie di variabili:
df.corr()
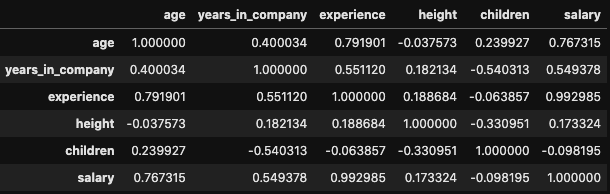
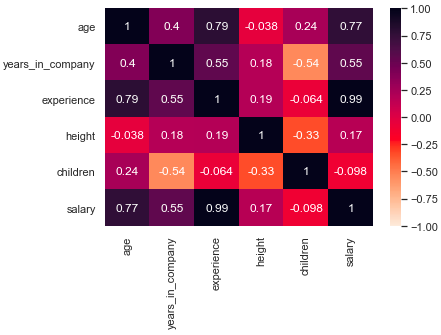
La matrice di correlazione può essere molto grande e difficile da interpretare se il nostro DataFrame ha molte colonne. Per estrarre gli insight dalla matrice in modo più efficace, possiamo usare una heatmap; una tecnica di visualizzazione dei dati in cui ogni valore è rappresentato da un colore, in base alla sua intensità su una scala data. Il modo più rapido per creare una heatmap è usare la funzione heatmap(), disponibile nella libreria seaborn:
import seaborn as sns

sns.heatmap(df.corr(), vmin=-1, vmax=1,
annot=True,cmap="rocket_r")
plt.show()
Non potevamo concludere questo tutorial senza menzionare un punto importante: la correlazione non implica causalità.
La correlazione quantifica solo l’intensità e la direzione della relazione tra due variabili. Potrebbe esserci una forte correlazione tra due variabili, ma questo non ci permette di concludere che una causi l’altra. Quando forti correlazioni non sono causali, le definiamo correlazioni spurie.
Due scenari possono portare a correlazioni spurie:
Infine, un’altra ragione per trattare la correlazione con cautela è la complessità del mondo in cui viviamo. Una correlazione più forte tra due variabili può facilmente portarci a concludere che una abbia causato l’altra. La convinzione che un dato effetto abbia una sola causa è detta monocausalità, ma questo avviene raramente. Più variabili possono essere alla base di un certo effetto. Pertanto, per considerare la causalità, dobbiamo prima prendere in esame tutti gli elementi di un sistema e valutarli non solo quantitativamente (cioè con metodi statistici) ma anche qualitativamente.
Per questi motivi, prima di trarre qualsiasi conclusione sulle relazioni nei nostri dati, è importante condurre un’analisi più approfondita e dettagliata per individuare possibili correlazioni spurie.
Speriamo che questo tutorial ti sia piaciuto. La correlazione è un argomento importante che ogni aspirante data scientist dovrebbe conoscere. Su DataCamp abbiamo un’ampia offerta di corsi di statistica in cui trattiamo correlazione, causalità e altri concetti statistici chiave, sia con Python sia con R.
Una volta che avrai una comprensione solida, ti consigliamo di provare DataLab, il notebook per dati di DataCamp con funzionalità AI per scrivere codice e applicare ciò che hai imparato senza alcuna seccatura d’installazione.
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



