Bijna elk data science-project omvat het bestuderen van correlaties tussen variabelen. Een correlatie is de statistische samenvatting van de relatie tussen twee verzamelingen variabelen. Het is een kernonderdeel van exploratieve data-analyse en een cruciaal aspect van tal van geavanceerde machinelearningtechnieken. Als je overweegt om in data science te stappen, zul je vroeg of laat correlatie moeten leren.
In deze tutorial leggen we uit wat correlatie is en waarom het relevant is bij data science-projecten. We bekijken ook de verschillende correlatiecoëfficiënten die we kunnen gebruiken om de sterkte en richting van de relatie tussen variabelen te meten. We gebruiken Python-code om praktische voorbeelden te geven van hoe je correlaties eenvoudig kunt meten en visualiseren.
- Wat is correlatie?
- Correlatiecoëfficiënten
- Correlatie berekenen in Python
- Correlatie impliceert geen causaliteit
- Conclusie
Wat is correlatie?
Correlatie is de statistische analyse van de relatie of afhankelijkheid tussen twee variabelen. Correlatie stelt ons in staat zowel de sterkte als de richting van de relatie tussen twee verzamelingen variabelen te bestuderen.
Het bestuderen van correlatie kan bij veel data science-taken erg nuttig zijn. Ten eerste is het een sleutelelement in exploratieve data-analyse: de eerste verkenning van onze data om te zien hoe deze eruitziet, de belangrijkste kenmerken samen te vatten en patronen en anomalieën te ontdekken.
Ten tweede hebben correlaties veel toepassingen in de echte wereld. Ze kunnen ons helpen vragen te beantwoorden, zoals of er een verband is tussen democratie en economische groei, of dat autogebruik correleert met de mate van luchtvervuiling.
Tot slot is het bestuderen van correlatie essentieel binnen machine learning. Sommige algoritmen werken bijvoorbeeld niet goed als twee of meer variabelen sterk samenhangen, doorgaans bekend als multicollineariteit. Correlatie vormt ook de basis van Principal Component Analysis, een lineaire dimensionaliteitsreductietechniek die erg nuttig is in machinelearningprojecten.
Er zijn verschillende soorten correlatie:
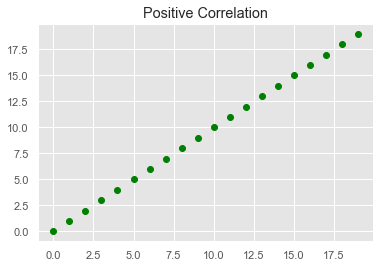
- Positieve correlatie: Twee variabelen zijn positief gecorreleerd wanneer hun waarden in dezelfde richting bewegen. In de onderstaande afbeelding neemt bijvoorbeeld, naarmate de waarde voor X toeneemt, ook de waarde voor Y toe met een constant tempo:
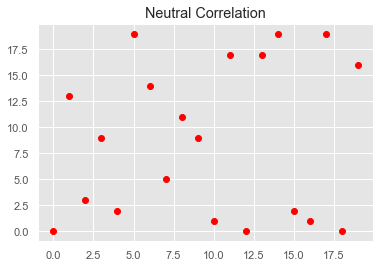
- Geen correlatie: Er is geen relatie in de verandering van variabelen X en Y. In dit geval zijn de waarden volledig willekeurig en vertonen ze geen enkel teken van correlatie, zoals te zien is in de volgende afbeelding:
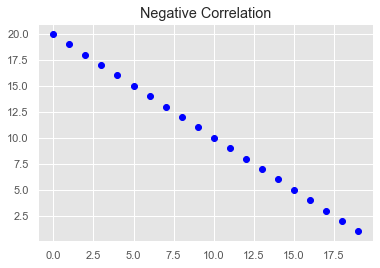
- Negatieve correlatie: Tot slot zijn de variabelen X en Y negatief gecorreleerd wanneer hun waarden in tegenovergestelde richtingen veranderen; hier geldt dus dat naarmate de waarde voor X toeneemt, de waarde voor Y afneemt met een constant tempo:
Het plotten van onze data is de snelste en meest effectieve manier om het type correlatie tussen variabelen te ontdekken. De gebruikelijke manier om de afhankelijkheid tussen twee variabelen te visualiseren is met een scatterplot. Een scatterplot is een grafiek waarin de x-as de waarde van de eerste variabele is en de y-as de waarde van de tweede variabele. De laatste drie afbeeldingen waren vormen van scatterplots. Bekijk deze videotutorial om te zien hoe je in Python een scatterplot maakt.
Toch zullen we soms niet alleen de correlatie willen visualiseren, maar ook willen meten hoe sterk die correlatie is. Daar komen correlatiecoëfficiënten om de hoek kijken.
Correlatiecoëfficiënten
Een correlatiecoëfficiënt is een statistische samenvatting die de sterkte en richting meet waarin twee variabelen met elkaar samenhangen.
Een van de voordelen van correlatiecoëfficiënten is dat ze de correlatie tussen twee variabelen op een gestandaardiseerde manier schatten, wat betekent dat de waarde van de coëfficiënt altijd op dezelfde schaal ligt, variërend van -1,0 tot 1,0.
Er zijn meerdere correlatiecoëfficiënten. Welke je kiest, hangt af van wat we weten over de structuur van de relatie tussen de variabelen. Data scientists gebruiken echter meestal de bekendste: Pearsons correlatiecoëfficiënt.
Pearsons correlatiecoëfficiënt
De correlatiecoëfficiënt van Pearson (r) is een score die de sterkte van een lineaire relatie tussen twee variabelen meet. Hij wordt berekend door de covariantie van variabelen X en Y te delen door het product van de standaarddeviatie van elke variabele, zoals getoond in de volgende formule:
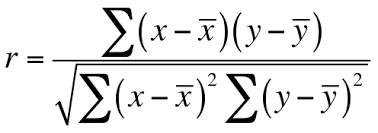
De coëfficiënt berust op twee aannames. Ten eerste gaat hij ervan uit dat de variabelen een normale of Gaussische verdeling volgen. Als de data niet normaal verdeeld is, kunnen andere coëfficiënten betrouwbaarder zijn.
Ten tweede gaat hij ervan uit dat er een lineaire relatie is tussen de twee variabelen, wat betekent dat de veranderingen in de data gemodelleerd kunnen worden met een lineaire functie (dus hun waarden stijgen of dalen gelijktijdig met een constant tempo). Hoe dichter de relatie tussen de twee variabelen bij een rechte lijn ligt, hoe sterker hun (lineaire) correlatie is en hoe hoger de absolute waarde van Pearsons correlatiecoëfficiënt. In de volgende afbeelding kunnen alle datapunten perfect worden gemodelleerd met een rechte lijn, wat resulteert in een correlatiecoëfficiënt van 1,0.
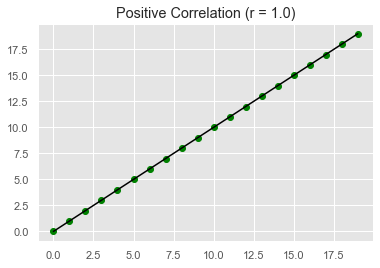
Een coëfficiënt van -1,0 geeft een perfecte negatieve correlatie aan, terwijl een coëfficiënt van 1,0 een perfecte positieve correlatie laat zien. Omgekeerd geeft een coëfficiënt van 0,0 aan dat er geen lineaire correlatie is tussen de variabelen.
Het interpreteren van de coëfficiënt wordt lastiger naarmate de waarde richting nul gaat. Er zijn verschillende vuistregels voorgesteld om de waarden van de coëfficiënt te interpreteren. Een van de bekendste is geformuleerd door Dennis E. Hinkle en zijn co-auteurs in hun boek Applied Statistics for the Behavioral Sciences:
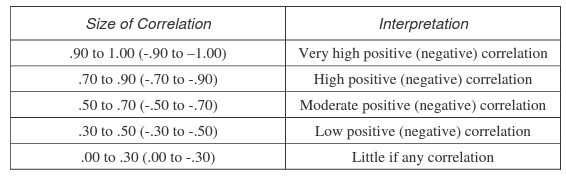 Vuistregel voor het interpreteren van de correlatiecoëfficiënt. Hinkle, Wiersma & Jurs.
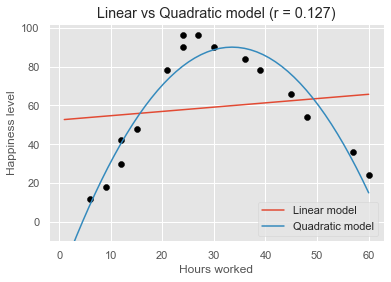
Belangrijk om te benadrukken is dat een Pearsons correlatiecoëfficiënt dicht bij 0,0 alleen aangeeft dat er geen lineaire relatie is tussen de variabelen. Het kan echter zo zijn dat er juist een sterke niet-lineaire relatie is. Als de relatie tussen twee variabelen niet-lineair is, kan de snelheid van toenemen of afnemen veranderen naarmate één variabele verandert, wat een kromme in de data oplevert. Zo’n trend kan beter worden gemodelleerd met een niet-lineaire functie, zoals een kwadratische of kubische functie.
In de volgende afbeelding zie je bijvoorbeeld hoe het geluksniveau van werknemers varieert afhankelijk van het aantal gewerkte uren per week. We zien dat naarmate het aantal uren toeneemt, het geluk ook stijgt, maar het begint af te nemen voorbij ongeveer 35 uur. Het lineaire model (rode lijn) past niet goed bij de data. In plaats daarvan lijkt een kwadratisch model (blauwe lijn), ook wel een polynomiaal model met graad 2, een veel betere kandidaat om de kromme vorm van de data te vangen. Wanneer de relatie niet-lineair is, onderschat correlatie doorgaans hoe sterk deze is. Dat is hier het geval: de coëfficiënt is gelijk aan 0,127 en zegt weinig over de niet-lineaire relatie tussen geluk en gewerkte uren.
Andere correlatiecoëfficiënten
De grootste beperking van Pearsons correlatiecoëfficiënt is dat deze een lineaire relatie tussen de twee variabelen veronderstelt. Vaker wel dan niet is de relatie echter niet-lineair. Ook kan de beschikbare data een niet-Gaussische verdeling hebben. Om dit te ondervangen hebben statistici andere soorten schattingen voorgesteld, namelijk de Spearmans rho- en Kendalls tau-correlatiecoëfficiënten.
Waar de coëfficiënt van Pearson lineaire relaties veronderstelt, gaan de coëfficiënten van Spearman en Kendall uit van een puur monotone relatie. In een monotone relatie bewegen de variabelen in dezelfde relatieve richting, maar niet noodzakelijkerwijs met een constant tempo. Met andere woorden: iedere lineaire relatie is monotoon, maar niet elke monotone relatie is lineair.
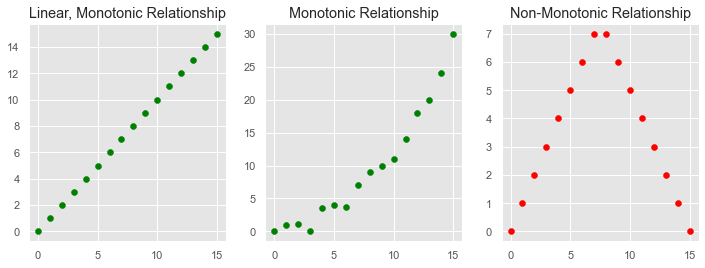
In plaats van de coëfficiënten te berekenen met de covariantie en standaarddeviaties van de variabelen, zijn ze gebaseerd op de relatieve rangorde van de waarden van de variabelen. Deze eigenschap maakt ze robuust tegen extreme waarden en geschikt om bepaalde soorten niet-lineariteiten aan te kunnen.
Net als bij Pearsons correlatiecoëfficiënt liggen de scores van Spearmans en Kendalls coëfficiënten tussen -1 en 1 voor respectievelijk perfect negatief en perfect positief gecorreleerde variabelen.
Toch kunnen data scientists over het algemeen vasthouden aan Pearsons correlatiecoëfficiënt. De aantrekkingskracht van ranggebaseerde schattingen zit vooral bij kleinere datasets en specifieke hypothesetoetsen.
Correlatie berekenen in Python
Er zijn verschillende Python-pakketten die ons helpen correlatie te meten. In deze sectie focussen we op de correlatiefuncties in drie bekende pakketten: SciPy, NumPy en pandas.
Om de functies te proberen, stel dat we de relatie willen bestuderen tussen werkervaring (in jaren) en salaris (in dollars) in een kleine maar succesvolle startup met 16 werknemers.
experience = [1, 3, 4, 5, 5, 6, 7, 10, 11, 12, 15, 20, 25, 28, 30,35]

salary = [20000, 30000, 40000, 45000, 55000, 60000, 80000, 100000, 130000, 150000, 200000, 230000, 250000, 300000, 350000, 400000]
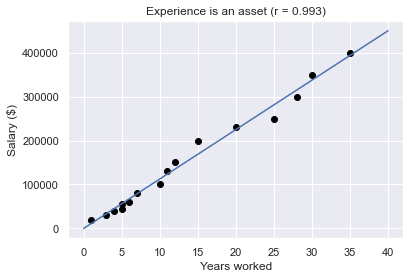
Zoals we in de volgende grafiek zien, is er een sterke positieve correlatie tussen de twee variabelen, wat betekent dat werknemers met meer ervaring de neiging hebben hogere salarissen te ontvangen.
SciPy is een uitstekende bibliotheek voor statistische bewerkingen. De module scipy.stats bevat de functie pearsonr(x, y) om Pearsons correlatiecoëfficiënt tussen twee steekproeven te berekenen.
import scipy.stats as stats

corr, _ = stats.pearsonr (experience, salary)
corr
0.9929845761480398
We kunnen op dezelfde manier Spearmans en Kendalls coëfficiënt berekenen:
spearman_corr, _ = stats.spearmanr(experience, salary)
spearman_corr
0.9992644353546791

kendall_corr, _ = stats.kendalltau(experience, salary)
kendall_corr
0.9958246164193105
NumPy is een populair pakket met een uitgebreide verzameling geavanceerde wiskundige functies, waaronder np.corrcoef(), dat een matrix met Pearsons correlatiecoëfficiënten teruggeeft:
import numpy as np

np.corrcoef(experience, salary)
array([[1.        , 0.99298458],
       [0.99298458, 1.        ]])
Een correlatiematrix is een tabel met correlatiecoëfficiënten tussen variabelen. Elke cel in de tabel toont de correlatie tussen twee variabelen. De diagonaal van de matrix bevat de coëfficiënten tussen elke variabele en zichzelf, die altijd gelijk is aan 1,0. De andere waarden in de matrix vertegenwoordigen de correlatie tussen ervaring en salaris. In dit geval, omdat we de correlatie slechts voor twee variabelen berekenen, zijn de waarden hetzelfde.
Tot slot moeten we vaak de correlatie berekenen voor onze variabelen die zijn opgeslagen in pandas DataFrames. Stel dat we een DataFrame hebben met informatie over de werknemers van de startup:
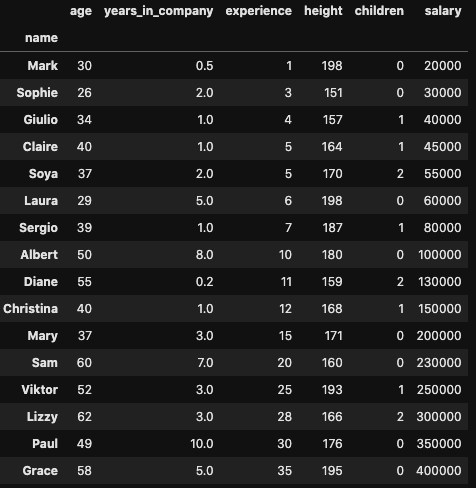
Als we de correlatie tussen twee kolommen willen berekenen, kunnen we de pandas-methode .corr() gebruiken, als volgt:
import pandas as pd

df['experience'].corr(df['salary'])
0.9929845761480398
.corr() bevat de parameter "method", die kan worden gebruikt om de drie correlatiecoëfficiënten te berekenen. Standaard wordt Pearson berekend.
print(df['experience'].corr(df['salary'], method='spearman'))
print(df['experience'].corr(df['salary'], method='kendall'))
0.9992644353546791
0.9958246164193105
Als we de correlatie tussen alle paren variabelen willen verkennen, kunnen we simpelweg de .corr()-methode rechtstreeks op ons DataFrame toepassen, wat opnieuw resulteert in een correlatiematrix met de coëfficiënt van alle paren variabelen:
df.corr()
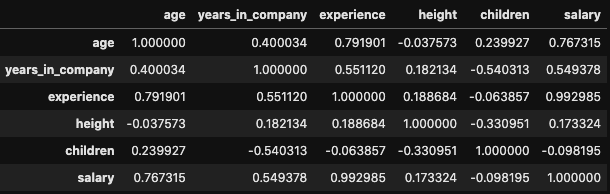
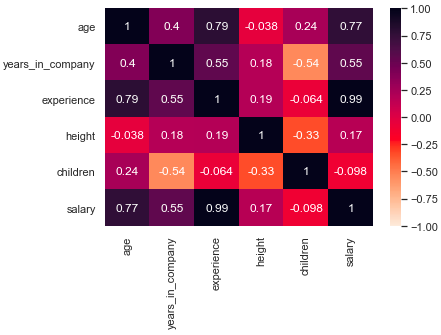
De correlatiematrix kan erg groot en lastig te interpreteren zijn als ons DataFrame veel kolommen heeft. Om de inzichten uit onze matrix effectiever te halen, kunnen we een heatmap gebruiken: een datavisualisatietechniek waarbij elke waarde wordt weergegeven door een kleur, afhankelijk van de intensiteit op een bepaalde schaal. De snelste manier om een heatmap te maken is met de functie heatmap(), beschikbaar in de seaborn-bibliotheek:
import seaborn as sns

sns.heatmap(df.corr(), vmin=-1, vmax=1,
annot=True,cmap="rocket_r")
plt.show()
Correlatie impliceert geen causaliteit
We kunnen deze tutorial niet afsluiten zonder een belangrijke kanttekening: correlatie impliceert geen causaliteit.
De correlatie kwantificeert alleen de sterkte en richting van de relatie tussen twee variabelen. Er kan een sterke correlatie tussen twee variabelen zijn, maar dat betekent nog niet dat de ene de andere veroorzaakt. Wanneer sterke correlaties niet causaal zijn, noemen we dat schijncorrelaties.
Twee scenario’s kunnen tot schijncorrelaties leiden:
- Ten eerste kan het zo zijn dat er een derde, "confounder"-variabele is die de twee variabelen veroorzaakt. Stel dat er een sterke positieve correlatie is tussen ijsconsumptie en het aantal zonnesteekgevallen in een bepaalde populatie. Je zou tot de absurde conclusie kunnen komen dat ijs eten zonnesteek veroorzaakt. In werkelijkheid hangen beide variabelen af van een derde: hoogstwaarschijnlijk de temperatuur. Hoe hoger de temperatuur, hoe meer mensen zin hebben in ijs, en hoe groter ook de kans op een zonnesteek.
- Een tweede reden om voorzichtig te zijn met correlatie is dat afhankelijkheden tussen variabelen gewoon toeval kunnen zijn. Dit gebeurt geregeld, maar vooral wanneer we met kleine steekproeven werken.
Een andere reden om correlatie met voorzichtigheid te benaderen is dat de wereld waarin we leven complex is. Een sterkere correlatie tussen twee variabelen kan ons gemakkelijk doen concluderen dat de ene de andere heeft veroorzaakt. De overtuiging dat een bepaald effect slechts één oorzaak heeft, heet monocausaliteit, maar dat is zelden het geval. Meerdere variabelen kunnen achter een bepaald effect schuilgaan. Om causaliteit te overwegen, moeten we dus eerst alle elementen van een systeem meenemen en die niet alleen kwantitatief (dus via statistische methoden) maar ook kwalitatief evalueren.
Om deze redenen is het belangrijk om, voordat we conclusies trekken over relaties in onze data, een grondigere en gedetailleerdere analyse uit te voeren om mogelijke schijncorrelaties te identificeren.
Conclusie
We hopen dat je deze tutorial nuttig vond. Correlatie is een belangrijk onderwerp dat elke beginnende data scientist zou moeten leren. Bij DataCamp hebben we een groot aantal statistiekcursussen waarin we omgaan met correlatie, causaliteit en andere belangrijke statistische concepten, zowel met Python als R.
Als je de basis onder de knie hebt, raden we je aan DataLab te proberen, DataCamps AI-aangedreven datanotebook om code te schrijven en toe te passen wat je hebt geleerd, zonder installatiegedoe.

