Neredeyse her veri bilimi projesi, değişkenler arasındaki korelasyonların incelenmesini içerir. Korelasyon, iki değişken kümesi arasındaki ilişkinin istatistiksel özetidir. keşifsel veri analizinin temel bir parçasıdır ve birçok gelişmiş makine öğrenimi tekniğinin kritik bir yönüdür. Veri bilimine adım atmayı düşünüyorsanız, veri bilimi yolculuğunuzda er ya da geç korelasyonu öğrenmeniz gerekecektir.
Bu eğitimde, korelasyonun ne olduğunu ve veri bilimi projeleri yürütürken neden önemli olduğunu açıklayacağız. Ayrıca, değişkenler arasındaki ilişkinin gücünü ve yönünü ölçmek için kullanabileceğimiz farklı korelasyon katsayılarına bakacağız. Korelasyonları basit bir şekilde ölçmenin ve görselleştirmenin pratik örneklerini sunmak için Python kodu kullanacağız.
- Korelasyon nedir?
- Korelasyon katsayıları
- Python’da korelasyon hesaplama
- Korelasyon nedensellik anlamına gelmez
- Sonuç
Korelasyon nedir?
Korelasyon, iki değişken arasındaki ilişki ya da bağımlılığın istatistiksel analizidir. Korelasyon, iki değişken kümesi arasındaki ilişkinin hem gücünü hem de yönünü incelememize olanak tanır.
Korelasyonu incelemek birçok veri bilimi görevinde çok faydalı olabilir. İlk olarak, keşifsel veri analizinin kilit bir bileşenidir; verimizin nasıl göründüğünü görmek, temel özelliklerini özetlemek ve örüntüleri ile aykırı değerleri keşfetmek için yaptığımız ilk çalışmadır.
İkinci olarak, korelasyonların birçok gerçek dünya uygulaması vardır. Demokrasi ile ekonomik büyüme arasında bir bağ olup olmadığı ya da araba kullanımının hava kirliliği düzeyiyle ilişkili olup olmadığı gibi soruları yanıtlamamıza yardımcı olabilirler.
Son olarak, korelasyon çalışması makine öğrenimi alanında kritik öneme sahiptir. Örneğin, bazı algoritmalar, genellikle çoklu bağlantı olarak bilinen, iki veya daha fazla değişken yakından ilişkiliyse düzgün çalışmaz. Korelasyon ayrıca, makine öğrenimi projelerinde çok faydalı olan doğrusal bir boyut indirgeme tekniği olan Temel Bileşen Analizinin de temelidir.
Farklı türde korelasyonlar vardır:
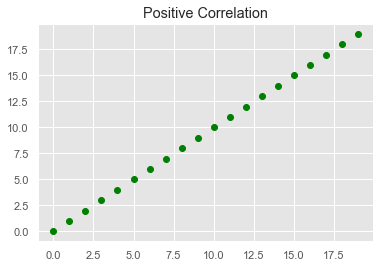
- Pozitif Korelasyon: İki değişkenin değerleri aynı yönde hareket ettiğinde pozitif korelasyonlu oldukları söylenir. Örneğin, aşağıdaki görselde X değeri arttıkça Y değeri de sabit bir oranda artar:
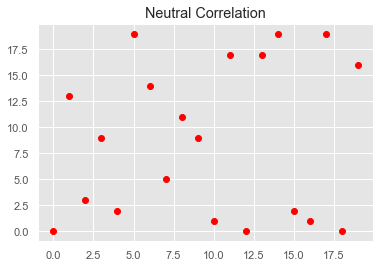
- Yansız Korelasyon: X ve Y değişkenlerinin değişiminde bir ilişki yoktur. Bu durumda, değerler tamamen rastgeledir ve aşağıdaki görselde gösterildiği gibi herhangi bir korelasyon belirtisi göstermez:
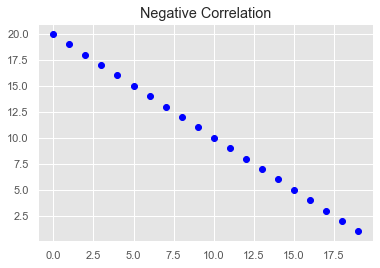
- Negatif Korelasyon: Son olarak, X ve Y değişkenleri değerleri zıt yönlerde değiştiğinde negatif korelasyonlu olacaktır; burada X değeri artarken Y değeri sabit bir oranda azalır:
Verimizi çizmek, değişkenler arasındaki korelasyon türünü keşfetmenin en hızlı ve en etkili yoludur. İki değişken arasındaki bağımlılıkları görselleştirmenin tipik yolu saçılım grafiğidir. Saçılım grafiğinde x ekseni birinci değişkenin, y ekseni ise ikinci değişkenin değeridir. Son üç görsel, saçılım grafiği türleriydi. Python’da saçılım grafiği oluşturmayı görmek için bu video eğitimine göz atın.
Ancak bazen yalnızca görselleştirmek yetmez; korelasyonun ne kadar güçlü olduğunu ölçmemiz de gerekir. İşte burada korelasyon katsayıları devreye girer.
Korelasyon katsayıları
Korelasyon katsayısı, iki değişkenin birbirleriyle ne ölçüde ve hangi yönde ilişkili olduğunu ölçen istatistiksel bir özettir.
Korelasyon katsayılarının avantajlarından biri, iki değişken arasındaki korelasyonu standartlaştırılmış bir şekilde tahmin etmeleridir; yani katsayının değeri her zaman -1,0 ile 1,0 arasında aynı ölçekte olur.
Birden fazla korelasyon katsayısı vardır. Hangisinin seçileceği, değişkenler arasındaki ilişkinin yapısı hakkında ne bildiğimize bağlıdır. Bununla birlikte, veri bilimciler genellikle en ünlü olanına, yani Pearson korelasyon katsayısına bağlı kalırlar.
Pearson korelasyon katsayısı
Pearson korelasyon katsayısı (r), iki değişken arasındaki doğrusal ilişkinin gücünü ölçen bir skordur. Aşağıdaki formülde gösterildiği gibi, X ve Y değişkenlerinin kovaryansının, her bir değişkenin standart sapmalarının çarpımına bölünmesiyle hesaplanır:
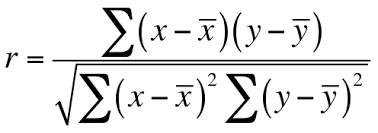
Katsayı iki varsayıma dayanır. İlk olarak, değişkenlerin normal ya da Gauss dağılımını izlediğini varsayar. Veri normal dağılmıyorsa, diğer katsayılar daha güvenilir olabilir.
İkincisi, iki değişken arasında doğrusal bir ilişki olduğunu varsayar; yani verideki değişimler doğrusal bir fonksiyonla modellenebilir (ör. değerleri sabit bir oranda eşzamanlı olarak artar veya azalır). İki değişken arasındaki ilişki bir doğruya ne kadar yakınsa, (doğrusal) korelasyonları o kadar güçlüdür ve Pearson korelasyon katsayısının mutlak değeri o kadar yüksektir. Örneğin, sonraki görselde tüm veri noktaları mükemmel şekilde bir doğru ile modellenebilir ve bu da 1,0’a eşit bir korelasyon katsayısı verir.
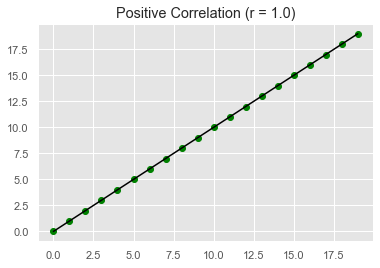
-1,0’lık bir katsayı mükemmel negatif korelasyonu, 1,0’lık bir katsayı ise mükemmel pozitif korelasyonu gösterir. Buna karşılık, 0,0’lık bir katsayı, değişkenler arasında doğrusal bir korelasyon olmadığını belirtir.
Katsayının yorumlanması, değeri sıfıra yaklaştıkça zorlaşır. Katsayı değerlerini yorumlamak için çeşitli pratik kurallar önerilmiştir. En popüler olanlardan biri Dennis E. Hinkle ve yazar arkadaşlarının Applied Statistics for the Behavioral Sciences adlı kitaplarında formüle edilmiştir:
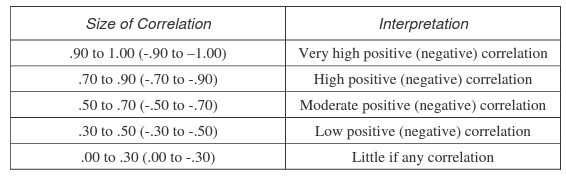 Korelasyon Katsayısını Yorumlamak İçin Pratik Kural. Hinkle, Wiersma & Jurs.
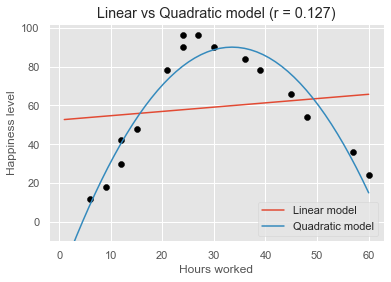
Vurgulamak önemlidir ki, 0,0’a yakın bir Pearson korelasyon katsayısı yalnızca değişkenler arasında doğrusal bir ilişki olmadığını gösterir. Ancak bunun yerine güçlü, doğrusal olmayan bir ilişki olabilir. İki değişken arasındaki ilişki doğrusal değilse, artış veya azalış hızı, değişkenlerden biri değiştikçe değişebilir ve veride eğri benzeri bir desen çizebilir. Böyle bir eğilim, ikinci veya üçüncü dereceden gibi doğrusal olmayan bir fonksiyonla daha iyi modellenebilir.
Örneğin, aşağıdaki görsel, çalışanların mutluluk düzeyinin haftalık çalışma saatlerine bağlı olarak nasıl değiştiğini gösterir. Saat sayısı arttıkça mutluluğun da arttığını, ancak yaklaşık 35 saatten sonra azalmaya başladığını görebiliriz. Doğrusal model (kırmızı çizgi) veriyi iyi uydurmaz. Bunun yerine, 2. dereceden bir polinom model olarak da bilinen ikinci dereceden (mavi çizgi) bir model, verinin kıvrımlı yapısına çok daha iyi uyuyor gibi görünmektedir. İlişki doğrusal olmadığında, korelasyon genellikle gücünü olduğundan düşük tahmin eder. Bizim örneğimizde de katsayı 0,127’ye eşittir ve mutluluk ile çalışma saatleri arasındaki doğrusal olmayan ilişki hakkında çok az şey söyler.
Diğer korelasyon katsayıları
Pearson korelasyon katsayısının en büyük sınırlaması, iki değişken arasında doğrusal bir ilişki varsaymasıdır. Oysa çoğu zaman, değişkenler doğrusal olmayan bir ilişkiyle bağlantılıdır. Ayrıca, eldeki veriler Gauss dışı bir dağılıma sahip olabilir. Bu eksikliği gidermek için istatistikçiler, Spearman rho ve Kendall tau korelasyon katsayıları gibi başka tahmin türleri önermiştir.
Pearson katsayısı doğrusal ilişkileri varsayarken, Spearman ve Kendall katsayıları değişkenler arasındaki ilişkinin yalnızca monotonik olduğunu varsayar. Monotonik bir ilişkide değişkenler aynı göreli yönde hareket etme eğilimindedir, ancak mutlaka sabit bir oranda değil. Başka bir deyişle, her doğrusal ilişki monotoniktir, ancak her monotonik ilişki doğrusal değildir.
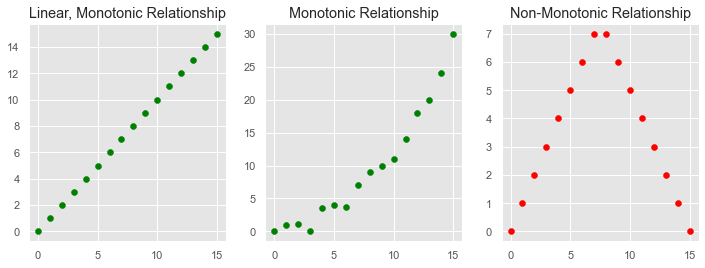
Katsayıları, değişkenlerin kovaryansı ve standart sapmalarıyla hesaplamak yerine, değişken değerlerinin göreli sıralarına dayanırlar. Bu özellik, onları uç değerlere karşı dayanıklı kılar ve belirli türde doğrusal olmayanlıkları ele almak için uygun hale getirir.
Pearson korelasyon katsayısında olduğu gibi, Spearman ve Kendall katsayılarının skorları da mükemmel negatif korelasyon ve mükemmel pozitif korelasyon için sırasıyla -1 ile 1 arasındadır.
Yine de, veri bilimciler genellikle Pearson korelasyon katsayısına bağlı kalabilir. Sıra temelli tahminlerin cazibesi daha çok küçük veri setleri ve belirli hipotez testleri içindir.
Python’da korelasyon hesaplama
Korelasyonu ölçmemize yardımcı olabilecek çeşitli Python paketleri vardır. Bu bölümde, üç bilinen paketteki korelasyon fonksiyonlarına odaklanacağız: SciPy, NumPy ve pandas.
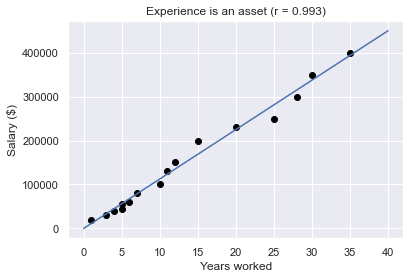
Fonksiyonları denemek için, 16 çalışandan oluşan küçük ama başarılı bir startupta iş deneyimi (yıl cinsinden) ile maaş (dolar cinsinden) arasındaki ilişkiyi incelemek istediğimizi hayal edelim.
experience = [1, 3, 4, 5, 5, 6, 7, 10, 11, 12, 15, 20, 25, 28, 30,35]

salary = [20000, 30000, 40000, 45000, 55000, 60000, 80000, 100000, 130000, 150000, 200000, 230000, 250000, 300000, 350000, 400000]
Bir sonraki grafikte de görebileceğimiz gibi, iki değişken arasında güçlü bir pozitif korelasyon vardır; bu da daha fazla deneyime sahip çalışanların daha yüksek maaş alma eğiliminde olduğu anlamına gelir.
SciPy, istatistiksel işlemler yapmak için harika bir kütüphanedir. scipy.stats modülü, iki veri örneği arasındaki Pearson korelasyon katsayısını hesaplamak için pearsonr(x, y) fonksiyonunu içerir.
import scipy.stats as stats

corr, _ = stats.pearsonr (experience, salary)
corr
0.9929845761480398
Spearman ve Kendall katsayılarını da benzer şekilde hesaplayabiliriz:
spearman_corr, _ = stats.spearmanr(experience, salary)
spearman_corr
0.9992644353546791

kendall_corr, _ = stats.kendalltau(experience, salary)
kendall_corr
0.9958246164193105
NumPy, gelişmiş matematiksel fonksiyonların geniş bir koleksiyonunu sunan popüler bir pakettir; np.corrcoef() dahil. Bu fonksiyon, Pearson korelasyon katsayılarından oluşan bir matris döndürür:
import numpy as np

np.corrcoef(experience, salary)
array([[1.        , 0.99298458],
       [0.99298458, 1.        ]])
Korelasyon matrisi, değişkenler arasındaki korelasyon katsayılarını gösteren bir tablodur. Tablodaki her hücre iki değişken arasındaki korelasyonu gösterir. Matrisin köşegeni, her değişkenin kendisiyle olan katsayılarını içerir ve bu değer her zaman 1,0’a eşittir. Matrisin diğer değerleri, deneyim ile maaş arasındaki korelasyonu temsil eder. Bu durumda yalnızca iki değişken için korelasyon hesapladığımızdan, değerler aynıdır.
Son olarak, genellikle pandas DataFrame’lerinde sakladığımız değişkenler için korelasyon hesaplamamız gerekecektir. Startuptaki çalışanlara ilişkin bilgilerimizin yer aldığı bir DataFrame’imiz olduğunu hayal edin:
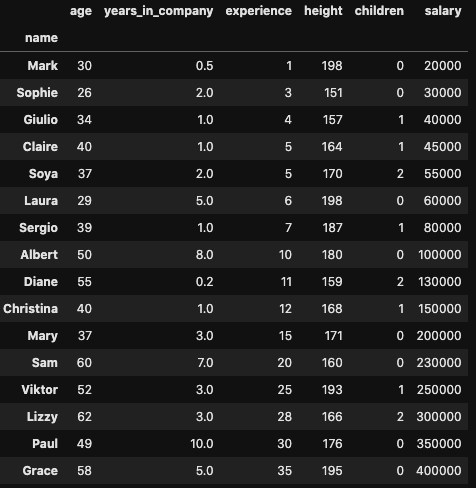
İki sütun arasındaki korelasyonu hesaplamak isteseydik, aşağıdaki gibi pandas’ın .corr() metodunu kullanabilirdik:
import pandas as pd

df['experience'].corr(df['salary'])
0.9929845761480398
.corr() metodu, üç korelasyon katsayısını da hesaplamak için kullanılabilecek "method" parametresini içerir. Varsayılan olarak Pearson’ı hesaplar.
print(df['experience'].corr(df['salary'], method='spearman'))
print(df['experience'].corr(df['salary'], method='kendall'))
0.9992644353546791
0.9958246164193105
Tüm değişken çiftleri arasındaki korelasyonu keşfetmek istersek, .corr() metodunu doğrudan DataFrame’imize uygulayabiliriz; bu da tüm değişken çiftlerinin katsayılarının yer aldığı bir korelasyon matrisiyle sonuçlanır:
df.corr()
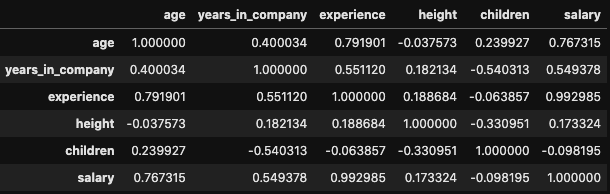
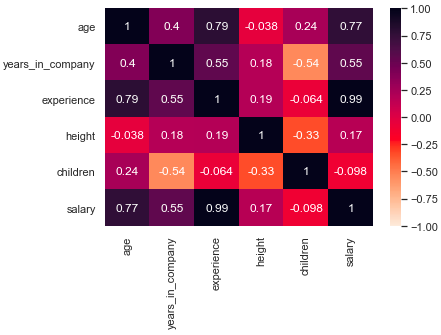
DataFrame’imiz çok fazla sütuna sahipse korelasyon matrisi çok büyük ve yorumlanması zor olabilir. Matrisimizden içgörüleri daha etkili bir şekilde çıkarmak için ısı haritası kullanabiliriz; her değerin, belirli bir ölçekteki yoğunluğuna göre bir renkle temsil edildiği bir veri görselleştirme tekniği. En hızlı şekilde ısı haritası oluşturmak için seaborn kütüphanesinde bulunan heatmap() fonksiyonunu kullanabiliriz:
import seaborn as sns

sns.heatmap(df.corr(), vmin=-1, vmax=1,
annot=True,cmap="rocket_r")
plt.show()
Korelasyon nedensellik anlamına gelmez
Bu eğitimi, önemli bir notu anmadan bitiremeyiz: korelasyon nedensellik anlamına gelmez.
Korelasyon, iki değişken arasındaki ilişkinin yalnızca gücünü ve yönünü nicelleştirir. İki değişken arasında güçlü bir korelasyon olabilir, ancak bu birinin diğerine neden olduğunu çıkarsamamıza izin vermez. Güçlü korelasyonlar nedensel olmadığında, bunlara sahte korelasyonlar denir.
İki senaryo sahte korelasyonlara yol açabilir:
- İlk olarak, iki değişkene de neden olan üçüncü bir “karıştırıcı” değişken olabilir. Belirli bir popülasyonda dondurma tüketimi ile güneş çarpması sayısı arasında güçlü bir pozitif korelasyon olduğunu hayal edin. Bir kişi, dondurma yemenin güneş çarpmasına neden olduğu gibi anlamsız bir sonuca varabilir. Oysa olan, her iki değişkenin de büyük olasılıkla sıcaklık gibi üçüncü bir değişkene bağlı olmasıdır. Sıcaklık arttıkça, daha fazla insan dondurma yemek ister ve yine daha fazla insanın güneş çarpması yaşaması olası hale gelir.
- Korelasyon konusunda temkinli olmak için ikinci bir neden, değişkenler arasındaki bağımlılıkların basitçe şans eseri ortaya çıkabilmesidir. Bu her zaman olabilir; ancak küçük örneklemlerle çalıştığımızda daha olasıdır.
Son olarak, korelasyona temkinli yaklaşmak için bir başka neden de yaşadığımız dünyanın karmaşık olmasıdır. İki değişken arasındaki daha güçlü bir korelasyon, birinin diğerine neden olduğu sonucuna kolayca götürebilir. Belirli bir etkinin tek bir nedeni olduğu inancına mononedenlilik denir, ancak bu nadiren geçerlidir. Belirli bir etkinin arkasında birden fazla değişken olabilir. Bu nedenle nedenselliği değerlendirmek için önce bir sistemin tüm unsurlarını varsaymalı ve bunları yalnızca nicel olarak (istatistiksel yöntemlerle) değil, nitel olarak da değerlendirmeliyiz.
Bu nedenlerle, verilerimizdeki ilişkiler hakkında herhangi bir sonuca varmadan önce, olası sahte korelasyonları belirlemek için daha kapsamlı ve ayrıntılı bir analiz yapmak önemlidir.
Sonuç
Umarız bu eğitimden keyif almışsınızdır. Korelasyon, her hevesli veri bilimcisinin öğrenmesi gereken önemli bir konudur. DataCamp’te, korelasyon, nedensellik ve diğer temel istatistiksel kavramları hem Python hem de R ile ele aldığımız çok sayıda istatistik kursumuz bulunuyor.
Sağlam bir anlayışa sahip olduğunuzda, herhangi bir kurulum zahmeti olmadan kod yazmak ve öğrendiklerinizi uygulamak için DataCamp’in yapay zeka destekli veri not defteri DataLab’i denemenizi öneririz.




