

Scikit-learn में मॉडल बनाना
आइए logistic regression classifier का उपयोग करके diabetes prediction मॉडल बनाते हैं।
पहले, pandas की read CSV फ़ंक्शन का उपयोग करके आवश्यक Pima Indian Diabetes डेटासेट लोड करते हैं। आप डेटा निम्न लिंक से डाउनलोड कर सकते हैं: https://www.kaggle.com/uciml/pima-indians-diabetes-database या DataCamp से कोई डेटासेट चुनें: https://www.datacamp.com/datalab/datasets। तैयार-उपयोग डेटासेट आपको DataLab, DataCamp का क्लाउड पर निःशुल्क Jupyter नोटबुक, पर मॉडल ट्रेन करने का विकल्प देता है।
डेटा लोड करना
हम pandas के read_csv() फ़ंक्शन को col_names देकर कॉलम को सरल बनाएँगे।
#import pandas
import pandas as pd
col_names = ['pregnant', 'glucose', 'bp', 'skin', 'insulin', 'bmi', 'pedigree', 'age', 'label']
# load dataset
pima = pd.read_csv("pima-indians-diabetes.csv", header=None, names=col_names)pima.head()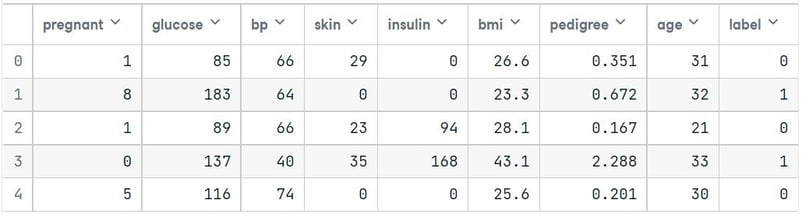
फ़ीचर चुनना
यहाँ, आपको दिए गए कॉलमों को दो प्रकार के चरों में बाँटना है: आश्रित (या लक्ष्य चर) और स्वतंत्र चर (या फ़ीचर चर)।
#split dataset in features and target variable
feature_cols = ['pregnant', 'insulin', 'bmi', 'age','glucose','bp','pedigree']
X = pima[feature_cols] # Features
y = pima.label # Target variableडेटा विभाजित करना
मॉडल के प्रदर्शन को समझने के लिए, डेटासेट को training सेट और test सेट में बाँटना एक अच्छा तरीका है।
आइए train_test_split() फ़ंक्शन का उपयोग करके डेटासेट को विभाजित करें। आपको 3 पैरामीटर पास करने हैं: features, target, और test_set का आकार। अतिरिक्त रूप से, आप रिकॉर्ड्स को यादृच्छिक रूप से चुनने के लिए random_state का उपयोग कर सकते हैं।
# split X and y into training and testing sets
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=16)यहाँ, डेटासेट को 75:25 के अनुपात में दो भागों में तोड़ा गया है। इसका अर्थ है 75% डेटा मॉडल प्रशिक्षण के लिए और 25% डेटा मॉडल परीक्षण के लिए उपयोग होगा।
मॉडल विकास और भविष्यवाणी
सबसे पहले, LogisticRegression मॉड्यूल आयात करें और पुनरुत्पादकता (reproducibility) के लिए random_state के साथ LogisticRegression() फ़ंक्शन का उपयोग करके एक logistic regression classifier ऑब्जेक्ट बनाएँ।
फिर, fit() का उपयोग करके अपने मॉडल को train सेट पर फिट करें और predict() का उपयोग करके test सेट पर पूर्वानुमान करें।
# import the class
from sklearn.linear_model import LogisticRegression
# instantiate the model (using the default parameters)
logreg = LogisticRegression(random_state=16)
# fit the model with data
logreg.fit(X_train, y_train)
y_pred = logreg.predict(X_test)Confusion Matrix का उपयोग करके मॉडल मूल्यांकन
Confusion matrix एक तालिका है जिसका उपयोग किसी classification मॉडल के प्रदर्शन का आकलन करने के लिए किया जाता है। आप किसी एल्गोरिदम के प्रदर्शन का विज़ुअलाइज़ेशन भी कर सकते हैं। Confusion matrix का मूल हिस्सा क्लास-वार सही और गलत भविष्यवाणियों की संख्या का योग है।
# import the metrics class
from sklearn import metrics
cnf_matrix = metrics.confusion_matrix(y_test, y_pred)
cnf_matrixarray([[115, 8],
[ 30, 39]])यहाँ, आप confusion matrix को एक array ऑब्जेक्ट के रूप में देख सकते हैं। इस मैट्रिक्स का आयाम 2*2 है क्योंकि यह मॉडल binary classification है। आपके पास दो क्लास 0 और 1 हैं। विकर्ण (diagonal) मान सही पूर्वानुमान का प्रतिनिधित्व करते हैं, जबकि गैर-विकर्ण तत्व गलत पूर्वानुमान हैं। आउटपुट में, 115 और 39 वास्तविक (सही) पूर्वानुमान हैं, और 30 तथा 8 गलत पूर्वानुमान हैं।
हीटमैप का उपयोग करके confusion matrix का विज़ुअलाइज़ेशन
आइए matplotlib और seaborn का उपयोग करके मॉडल के परिणामों को confusion matrix के रूप में विज़ुअलाइज़ करें।
यहाँ, आप Heatmap का उपयोग करके confusion matrix का विज़ुअलाइज़ेशन करेंगे।
# import required modules
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
class_names=[0,1] # name of classes
fig, ax = plt.subplots()
tick_marks = np.arange(len(class_names))
plt.xticks(tick_marks, class_names)
plt.yticks(tick_marks, class_names)
# create heatmap
sns.heatmap(pd.DataFrame(cnf_matrix), annot=True, cmap="YlGnBu" ,fmt='g')
ax.xaxis.set_label_position("top")
plt.tight_layout()
plt.title('Confusion matrix', y=1.1)
plt.ylabel('Actual label')
plt.xlabel('Predicted label')
Text(0.5,257.44,'Predicted label');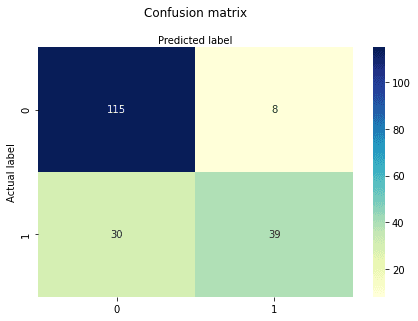
Confusion matrix मूल्यांकन मीट्रिक्स
आइए classification_report का उपयोग करके accuracy, precision, और recall के लिए मॉडल का मूल्यांकन करें।
from sklearn.metrics import classification_report
target_names = ['without diabetes', 'with diabetes']
print(classification_report(y_test, y_pred, target_names=target_names)) precision recall f1-score support
without diabetes 0.79 0.93 0.86 123
with diabetes 0.83 0.57 0.67 69
accuracy 0.80 192
macro avg 0.81 0.75 0.77 192
weighted avg 0.81 0.80 0.79 192अच्छा, आपको 80% का classification दर मिला है, जिसे अच्छी सटीकता माना जाता है।
Precision: Precision का संबंध सटीकता से है, अर्थात आपका मॉडल कितना सही है। दूसरे शब्दों में, जब मॉडल भविष्यवाणी करता है, तो वह कितनी बार सही होता है। आपके पूर्वानुमान मामले में, जब आपके logistic regression मॉडल ने भविष्यवाणी की कि रोगियों को मधुमेह होगा, तब वे रोगी 73% समय पर सही थे।
Recall: यदि टेस्ट सेट में मधुमेह से ग्रस्त रोगी हैं, तो आपका logistic regression मॉडल उन्हें 57% समय पर पहचान सका।
ROC कर्व
Receiver Operating Characteristic (ROC) कर्व true positive rate के विरुद्ध false positive rate का प्लॉट है। यह sensitivity और specificity के बीच के tradeoff को दर्शाता है।
y_pred_proba = logreg.predict_proba(X_test)[::,1]
fpr, tpr, _ = metrics.roc_curve(y_test, y_pred_proba)
auc = metrics.roc_auc_score(y_test, y_pred_proba)
plt.plot(fpr,tpr,label="data 1, auc="+str(auc))
plt.legend(loc=4)
plt.show()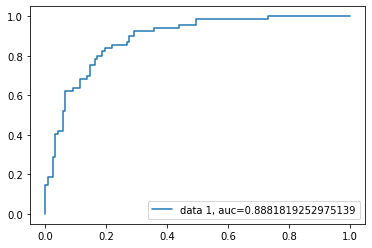
इस मामले के लिए AUC स्कोर 0.88 है। AUC स्कोर 1 एक perfect classifier को दर्शाता है, और 0.5 एक बेकार classifier को।
कोड स्रोत DataLab पर उपलब्ध है: Understanding Logistic Regression in Python।
फायदे
अपनी कुशल और सरल प्रकृति के कारण, इसे उच्च computation power की आवश्यकता नहीं होती, इसे लागू करना आसान है, आसानी से समझा जा सकता है, और डेटा विश्लेषकों और वैज्ञानिकों द्वारा व्यापक रूप से उपयोग किया जाता है। साथ ही, इसे फ़ीचर्स के स्केलिंग की आवश्यकता नहीं होती। Logistic regression अवलोकनों के लिए एक प्रायिकता स्कोर प्रदान करती है।
नुकसान
Logistic regression बड़ी संख्या में श्रेणीबद्ध फ़ीचर्स/चर को संभालने में सक्षम नहीं है। यह overfitting के प्रति संवेदनशील है। साथ ही, यह गैर-रैखिक समस्याओं को हल नहीं कर सकती, इसलिए गैर-रैखिक फ़ीचर्स के रूपांतरण की आवश्यकता होती है। Logistic regression उन स्वतंत्र चरों के साथ अच्छा प्रदर्शन नहीं करेगी जो लक्ष्य चर से सहसंबद्ध नहीं हैं और एक-दूसरे से बहुत समान या सहसंबद्ध हैं।
निष्कर्ष
इस ट्यूटोरियल में, आपने logistic regression के बारे में बहुत से विवरण कवर किए। आपने सीखा कि logistic regression क्या है, संबंधित मॉडल कैसे बनाएँ, परिणामों का विज़ुअलाइज़ेशन कैसे करें, और कुछ सैद्धांतिक पृष्ठभूमि जानकारी। साथ ही, आपने sigmoid फ़ंक्शन, maximum likelihood, confusion matrix, ROC कर्व जैसे कुछ बुनियादी सिद्धांत भी कवर किए।
उम्मीद है, अब आप अपनी स्वयं की डेटासेट्स का विश्लेषण करने के लिए Logistic Regression तकनीक का उपयोग कर सकते हैं। इस ट्यूटोरियल को पढ़ने के लिए धन्यवाद!
यदि आप Logistic Regression के बारे में और सीखना चाहते हैं, तो DataCamp का Machine Learning with scikit-learn कोर्स करें। आप Machine Learning Scientist with Python करियर ट्रैक में साइन अप करके मशीन लर्निंग इंजीनियर बनने की अपनी यात्रा भी शुरू कर सकते हैं।
Classification तकनीकें मशीन लर्निंग और डेटा माइनिंग अनुप्रयोगों का एक आवश्यक हिस्सा हैं। लगभग 70% डेटा साइंस समस्याएँ classification समस्याएँ होती हैं। Classification समस्याएँ कई तरह की होती हैं, लेकिन logistic regression आम और द्विआधारी (binary) classification समस्या को हल करने के लिए उपयोगी regression विधि है। Classification की एक अन्य श्रेणी Multinomial classification है, जो उन मामलों को संभालती है जहाँ लक्ष्य चर में एक से अधिक क्लास होती हैं। उदाहरण के लिए, IRIS डेटासेट बहु-श्रेणी (multi-class) classification का एक बहुत प्रसिद्ध उदाहरण है। अन्य उदाहरण हैं लेख/ब्लॉग/दस्तावेज़ श्रेणियों का वर्गीकरण।
Logistic regression का उपयोग विभिन्न classification समस्याओं के लिए किया जा सकता है, जैसे स्पैम पहचान। अन्य उदाहरणों में शामिल हैं: मधुमेह की भविष्यवाणी, क्या कोई ग्राहक किसी विशेष उत्पाद को खरीदेगा; कोई ग्राहक churn करेगा या नहीं, उपयोगकर्ता किसी दिए गए विज्ञापन लिंक पर क्लिक करेगा या नहीं, इत्यादि।
Logistic Regression दो-क्लास classification के लिए सबसे सरल और सबसे अधिक उपयोग किए जाने वाले मशीन लर्निंग एल्गोरिदम में से एक है। इसे लागू करना आसान है और किसी भी binary classification समस्या के लिए बेसलाइन के रूप में उपयोग किया जा सकता है। इसके मूलभूत सिद्धांत deep learning में भी रचनात्मक होते हैं। Logistic regression एक आश्रित द्विआधारी चर और स्वतंत्र चर के बीच संबंध का वर्णन और आकलन करता है।
इस ट्यूटोरियल के सभी उदाहरण कोड को स्वयं आसानी से चलाने के लिए, आप निःशुल्क एक DataLab वर्कबुक बनाएँ जिसमें Python पहले से इंस्टॉल है और सभी कोड सैंपल शामिल हैं। Logistic regression पर और अभ्यास के लिए, हमारे Credit Risk Modeling in R कोर्स में दिए गए अभ्यास देखें, जिसमें अनेक वास्तविक-world उदाहरण हैं।
Logistic Regression क्या है?
Logistic regression द्विआधारी क्लास की भविष्यवाणी करने की एक सांख्यिकीय विधि है। परिणाम या लक्ष्य चर द्विक (dichotomous) प्रकृति का होता है। Dichotomous का अर्थ है कि केवल दो संभावित क्लास होती हैं। उदाहरण के लिए, इसे कैंसर पहचान समस्याओं के लिए उपयोग किया जा सकता है। यह किसी घटना के घटित होने की प्रायिकता (probability) की गणना करता है।
यह रैखिक प्रतिगमन (linear regression) का एक विशेष मामला है जहाँ लक्ष्य चर श्रेणीबद्ध (categorical) होता है। यह आश्रित चर के रूप में odds के log का उपयोग करता है। Logistic Regression logit फ़ंक्शन का उपयोग करके किसी द्विआधारी घटना के घटित होने की प्रायिकता की भविष्यवाणी करता है।
Linear Regression समीकरण:
जहाँ y आश्रित चर है और x1, x2 ... तथा Xn व्याख्यात्मक (explanatory) चर हैं।
Sigmoid फ़ंक्शन:
Linear regression पर Sigmoid फ़ंक्शन लागू करें:
Logistic Regression के गुण:
Linear Regression बनाम Logistic Regression
Linear regression सतत (continuous) आउटपुट देती है, जबकि logistic regression विविक्त (discrete) आउटपुट देती है। सतत आउटपुट के उदाहरण हैं घर की कीमत और स्टॉक मूल्य। विविक्त आउटपुट के उदाहरण हैं यह भविष्यवाणी करना कि किसी रोगी को कैंसर है या नहीं, तथा यह कि कोई ग्राहक churn करेगा या नहीं। Logistic regression का अनुमान अधिकतम प्रायिकता अनुमान (MLE) विधि से लगाया जाता है, जबकि linear regression प्रायः ordinary least squares (OLS) से अनुमानित होती है, जिसे तब MLE का विशेष मामला भी माना जा सकता है जब मॉडल में त्रुटियाँ सामान्य वितरण का अनुसरण करती हों।
Maximum Likelihood Estimation बनाम Least Squares विधि
MLE एक "likelihood" अधिकतम करने की विधि है, जबकि OLS दूरी-न्यूनतम (distance-minimizing) प्रत्यय विधि है। Likelihood फ़ंक्शन को अधिकतम करने से वे पैरामीटर निर्धारित होते हैं जो अवलोकित डेटा को उत्पन्न करने की सबसे अधिक संभावना रखते हैं। सांख्यिकीय दृष्टिकोण से, MLE दिए गए मॉडल के लिए विशिष्ट पैरामीट्रिक मानों का निर्धारण करते समय माध्य और विचरण को पैरामीटर के रूप में सेट करता है। इस पैरामीटर सेट का उपयोग सामान्य वितरण में आवश्यक डेटा की भविष्यवाणी के लिए किया जा सकता है।
Ordinary Least Squares अनुमान दिए गए डेटा बिंदुओं पर ऐसी रिग्रेशन रेखा फिट करके गणना किए जाते हैं जिसका वर्ग विचलनों (least square error) का योग न्यूनतम हो। दोनों का उपयोग रैखिक प्रतिगमन मॉडल के पैरामीटर का अनुमान लगाने के लिए किया जाता है। MLE एक संयुक्त probability mass फ़ंक्शन मानता है, जबकि OLS दूरी को न्यूनतम करने के लिए किसी stochastic धारणा की आवश्यकता नहीं रखता।
Sigmoid फ़ंक्शन
Sigmoid फ़ंक्शन, जिसे logistic फ़ंक्शन भी कहा जाता है, एक ‘S’ आकार का वक्र देता है जो किसी भी वास्तविक मान (real-valued number) को 0 और 1 के बीच के मान में मैप कर सकता है। यदि वक्र धनात्मक अनंत की ओर जाता है, तो y का पूर्वानुमान 1 हो जाएगा, और यदि वक्र ऋणात्मक अनंत की ओर जाता है, तो y का पूर्वानुमान 0 हो जाएगा। यदि sigmoid फ़ंक्शन का आउटपुट 0.5 से अधिक है, तो हम परिणाम को 1 या YES के रूप में वर्गीकृत कर सकते हैं, और यदि यह 0.5 से कम है, तो 0 या NO के रूप में। उदाहरण के लिए, यदि आउटपुट 0.75 है, तो हम प्रायिकता की दृष्टि से कह सकते हैं कि किसी रोगी के कैंसर से ग्रस्त होने की 75 प्रतिशत संभावना है।
Logistic Regression के प्रकार
Logistic Regression के प्रकार: