在我之前的关于模型可解释性的文章中,我概述了常用的模型分析技术。在这篇博文中,我将更详细地解释LIME。
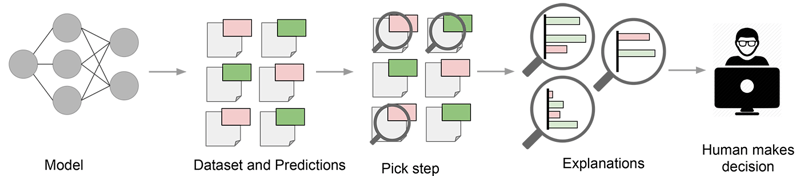 LIME 在数据样本层面解释模型预测。它使终端用户能够解读这些预测并据此采取行动。来源
为什么有必要了解可解释性方法?
当您信任某种技术来解释模型的预测时,理解该技术的底层机制以及潜在的风险至关重要。可解释性技术并非万无一失,如果对方法缺乏充分理解,您很可能会基于错误的前提做出判断。
下面这篇关于随机森林重要性的博文进行了类似但更为深入的研究。特征重要性常用于判断哪些特征在模型预测中起关键作用。随机森林提供了开箱即用的方法来确定数据集中最重要的特征,许多人依赖这些特征重要性,将其解读为数据集的“真相解释”。
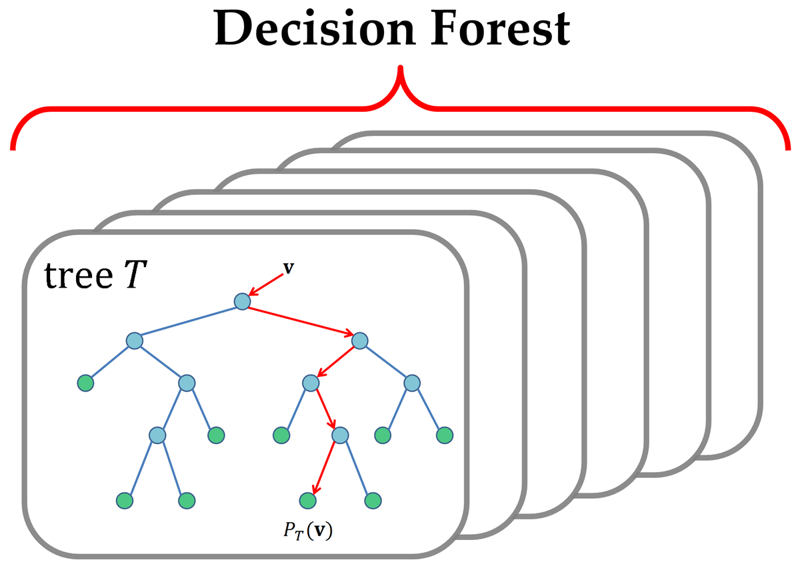 决策森林或随机森林由多棵决策树组成。通过研究哪些特征被用于构建“最佳”树,可以估计特征的重要性。来源
作者研究了两种随机森林(RF)实现及其提供的标准特征重要性度量。作者表明,相比随机森林的重要性度量,当变量强相关时,置换重要性可以给出更稳健的估计。强烈建议阅读他们的博文以深入理解其结论。
LIME
LIME 与模型无关,意味着它可以应用于任何机器学习模型。该技术试图通过扰动数据样本的输入并观察预测如何变化来理解模型。
 LIME 将机器学习模型视为黑箱,并研究由模型表示的输入与输出之间的关系。
针对特定模型的方法旨在通过分析内部组件及其交互来理解黑箱模型。在深度学习模型中,例如可以研究激活单元,并将内部激活关联回输入。这需要对网络有深入理解,且难以推广到其他模型。
LIME 提供局部模型可解释性。LIME 通过微调特征值来修改单个数据样本,并观察由此对输出产生的影响。这往往也契合人们在查看模型输出时的关注点。最常见的问题可能是:为什么会做出这个预测?或是哪些变量导致了这一预测?
其他模型可解释性技术往往仅从整个数据集的角度回答上述问题。特征重要性在数据集层面解释哪些特征重要。它可以帮助您验证假设并判断模型是否对噪声过拟合,但难以诊断具体的模型预测。
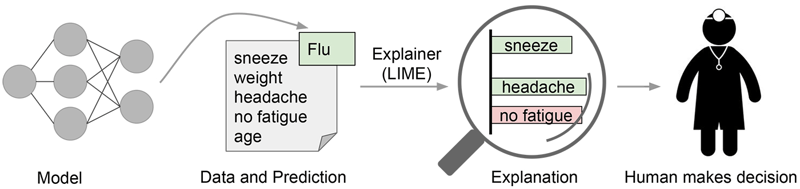 LIME 试图扮演“解释者”的角色,为每个数据样本的预测提供解释。来源
LIME 背后的直觉
LIME 的一个关键前提是使用对人类可理解的可解释输入表示。例如,NLP 可用词袋(BoW)向量,计算机视觉可用图像。相反,稠密嵌入不可解释,应用 LIME 可能无法提升可解释性。
LIME 的输出是一组解释,反映每个特征对某个数据样本预测的贡献。这提供了局部可解释性,也有助于判断哪些特征变动会对预测产生最大影响。
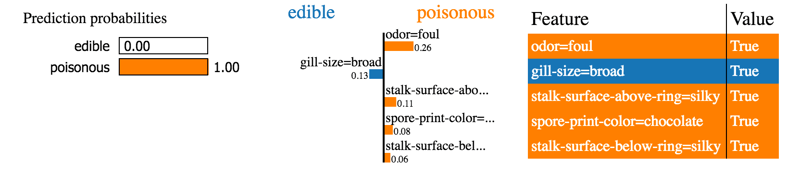 一个将 LIME 应用于经典分类问题的示例。来源
解释是通过在局部用一个可解释模型去近似底层模型来生成的。可解释模型例如带强正则化的线性模型、决策树等。这些可解释模型在原始实例的小扰动上进行训练,只需提供良好的局部近似。可以通过向连续特征添加噪声、删除词语或遮挡图像部分等方式来创建“数据集”。仅在黑箱的局部(数据样本的邻域)进行近似,大大简化了任务。
潜在陷阱
尽管 LIME 的总体思想听起来简单,但存在一些潜在的不足。
在当前实现中,仅使用线性模型来近似局部行为。在非常小的数据样本邻域内,这一假设在一定程度上是成立的。然而,随着邻域范围扩大,线性模型可能不足以解释原始模型的行为。对于需要复杂、不可解释模型的数据集,局部区域也会出现非线性。在这些情形下无法应用 LIME 是一个显著的缺陷。
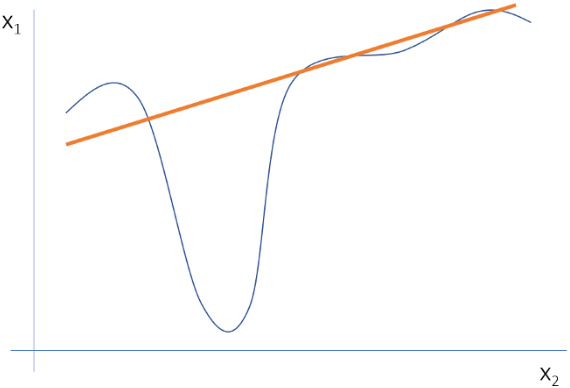 对两个特征的局部行为进行线性近似并非良好表示,无法捕捉模型的高度非线性行为。
其次,为获得合适的解释需要对数据进行的修改通常与具体用例相关。作者在论文中给出了如下示例:例如,一个将棕褐色调图像预测为“复古”的模型,无法通过是否存在超像素来解释。
很多时候,简单的扰动并不够。理想情况下,扰动应由数据集中观察到的变异性来驱动。另一方面,人工干预扰动方式可能并非好主意,因为这很可能会将偏差引入模型解释。
结论
LIME 是解释机器学习分类器(或模型)行为的有力工具。它与模型无关,基于简单易懂的理念,且运行成本不高。与往常一样,即使使用 LIME,也仍需正确解读其输出。
如果您对机器学习中的可解释性有任何问题,欢迎在评论区留言。我也欢迎您在Medium或Twitter上关注我,获取我的博文更新!
如果您希望进一步学习建模,请查看 DataCamp 的R 语言统计建模入门课程。


在我之前的关于模型可解释性的文章中,我概述了常用的模型分析技术。在这篇博文中,我将更详细地解释LIME。
为什么有必要了解可解释性方法?
当您信任某种技术来解释模型的预测时,理解该技术的底层机制以及潜在的风险至关重要。可解释性技术并非万无一失,如果对方法缺乏充分理解,您很可能会基于错误的前提做出判断。
下面这篇关于随机森林重要性的博文进行了类似但更为深入的研究。特征重要性常用于判断哪些特征在模型预测中起关键作用。随机森林提供了开箱即用的方法来确定数据集中最重要的特征,许多人依赖这些特征重要性,将其解读为数据集的“真相解释”。
作者研究了两种随机森林(RF)实现及其提供的标准特征重要性度量。作者表明,相比随机森林的重要性度量,当变量强相关时,置换重要性可以给出更稳健的估计。强烈建议阅读他们的博文以深入理解其结论。
LIME
LIME 与模型无关,意味着它可以应用于任何机器学习模型。该技术试图通过扰动数据样本的输入并观察预测如何变化来理解模型。
针对特定模型的方法旨在通过分析内部组件及其交互来理解黑箱模型。在深度学习模型中,例如可以研究激活单元,并将内部激活关联回输入。这需要对网络有深入理解,且难以推广到其他模型。
LIME 提供局部模型可解释性。LIME 通过微调特征值来修改单个数据样本,并观察由此对输出产生的影响。这往往也契合人们在查看模型输出时的关注点。最常见的问题可能是:为什么会做出这个预测?或是哪些变量导致了这一预测?
其他模型可解释性技术往往仅从整个数据集的角度回答上述问题。特征重要性在数据集层面解释哪些特征重要。它可以帮助您验证假设并判断模型是否对噪声过拟合,但难以诊断具体的模型预测。
LIME 背后的直觉
LIME 的一个关键前提是使用对人类可理解的可解释输入表示。例如,NLP 可用词袋(BoW)向量,计算机视觉可用图像。相反,稠密嵌入不可解释,应用 LIME 可能无法提升可解释性。
LIME 的输出是一组解释,反映每个特征对某个数据样本预测的贡献。这提供了局部可解释性,也有助于判断哪些特征变动会对预测产生最大影响。
解释是通过在局部用一个可解释模型去近似底层模型来生成的。可解释模型例如带强正则化的线性模型、决策树等。这些可解释模型在原始实例的小扰动上进行训练,只需提供良好的局部近似。可以通过向连续特征添加噪声、删除词语或遮挡图像部分等方式来创建“数据集”。仅在黑箱的局部(数据样本的邻域)进行近似,大大简化了任务。
潜在陷阱
尽管 LIME 的总体思想听起来简单,但存在一些潜在的不足。
在当前实现中,仅使用线性模型来近似局部行为。在非常小的数据样本邻域内,这一假设在一定程度上是成立的。然而,随着邻域范围扩大,线性模型可能不足以解释原始模型的行为。对于需要复杂、不可解释模型的数据集,局部区域也会出现非线性。在这些情形下无法应用 LIME 是一个显著的缺陷。
其次,为获得合适的解释需要对数据进行的修改通常与具体用例相关。作者在论文中给出了如下示例:例如,一个将棕褐色调图像预测为“复古”的模型,无法通过是否存在超像素来解释。
很多时候,简单的扰动并不够。理想情况下,扰动应由数据集中观察到的变异性来驱动。另一方面,人工干预扰动方式可能并非好主意,因为这很可能会将偏差引入模型解释。
结论
LIME 是解释机器学习分类器(或模型)行为的有力工具。它与模型无关,基于简单易懂的理念,且运行成本不高。与往常一样,即使使用 LIME,也仍需正确解读其输出。
如果您对机器学习中的可解释性有任何问题,欢迎在评论区留言。我也欢迎您在Medium或Twitter上关注我,获取我的博文更新!
如果您希望进一步学习建模,请查看 DataCamp 的R 语言统计建模入门课程。