Pada tulisan saya sebelumnya tentang interpretabilitas model, saya memberikan gambaran umum teknik-teknik umum untuk menyelidiki model machine learning. Dalam blog post ini, saya akan memberikan penjelasan yang lebih mendalam tentang LIME.
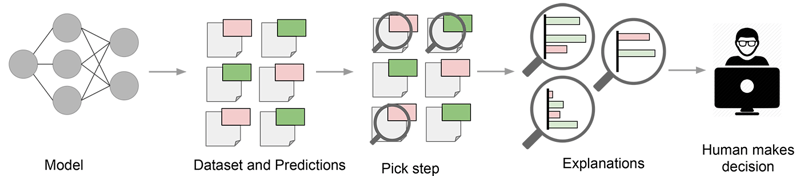 LIME menjelaskan prediksi model pada tingkat sampel data. Ini memungkinkan pengguna akhir menafsirkan prediksi tersebut dan mengambil tindakan berdasarkan prediksi itu. Sumber
Mengapa Perlu Memahami Metode Interpretabilitas?
Jika Anda mempercayai suatu teknik untuk menjelaskan prediksi model Anda, penting untuk memahami mekanisme dasar teknik tersebut, serta potensi jebakan yang terkait dengannya. Teknik interpretabilitas tidak bebas dari kesalahan, dan tanpa pemahaman yang baik tentang metodenya, sangat mungkin Anda mendasarkan asumsi pada hal yang keliru.
Investigasi serupa namun jauh lebih mendalam dilakukan dalam blog post berikut mengenai feature importance pada random forest. Feature importance sering digunakan untuk menentukan fitur mana yang berperan penting dalam prediksi model. Random forest menyediakan metode siap pakai untuk menentukan fitur paling penting dalam dataset dan banyak orang mengandalkan feature importance ini, menafsirkan mereka sebagai ‘penjelasan kebenaran dasar’ dari dataset.
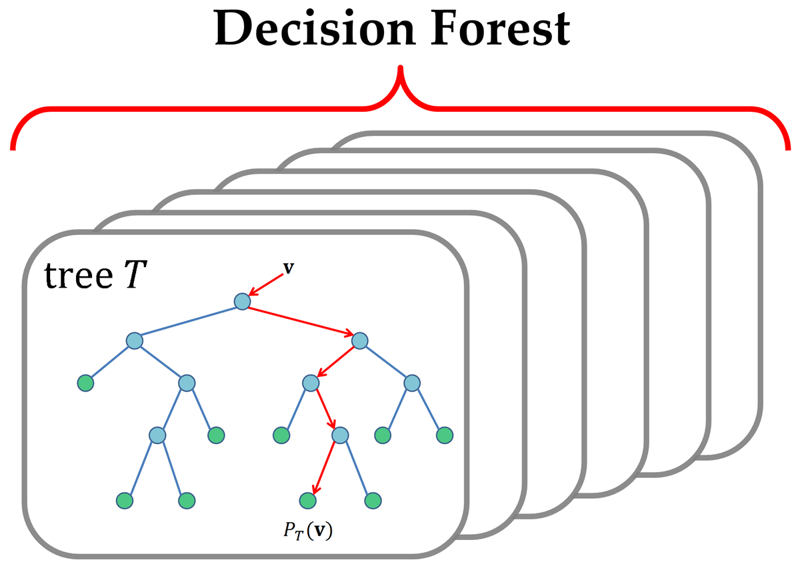 Sebuah decision forest atau random forest terdiri dari banyak pohon keputusan. Dengan menyelidiki fitur mana yang digunakan untuk membangun pohon ‘terbaik’, kita bisa memperkirakan feature importance. Sumber
Para penulis meneliti dua implementasi random forest (RF) dan ukuran feature importance standar yang mereka sediakan. Mereka menunjukkan bahwa permutation importance memberikan estimasi yang lebih andal saat variabel sangat berkorelasi, dibandingkan feature importance pada random forest. Saya sangat menyarankan membaca blog post mereka untuk pemahaman mendalam atas temuannya.
LIME
LIME bersifat model-agnostic, artinya dapat diterapkan pada model machine learning apa pun. Teknik ini berupaya memahami model dengan mengganggu (mengubah) input dari sampel data dan memahami bagaimana prediksinya berubah.
 LIME mengasumsikan model machine learning sebagai kotak hitam dan menyelidiki hubungan antara input dan output yang direpresentasikan oleh model.
Pendekatan spesifik model bertujuan memahami model machine learning kotak hitam dengan menganalisis komponen internal dan bagaimana interaksinya. Pada model deep learning, misalnya, dimungkinkan menyelidiki unit aktivasi dan menautkan aktivasi internal kembali ke input. Ini memerlukan pemahaman menyeluruh tentang jaringan dan tidak dapat dengan mudah diterapkan ke model lain.
LIME memberikan interpretabilitas model secara lokal. LIME memodifikasi satu sampel data dengan mengutak-atik nilai fitur dan mengamati dampaknya pada output. Sering kali, ini juga selaras dengan apa yang diminati manusia saat mengamati output model. Pertanyaan yang paling umum mungkin: mengapa prediksi ini dibuat atau variabel mana yang menyebabkan prediksi tersebut?
Teknik interpretabilitas model lainnya hanya menjawab pertanyaan di atas dari perspektif seluruh dataset. Feature importance menjelaskan pada tingkat dataset fitur mana yang penting. Ini memungkinkan Anda memverifikasi hipotesis dan apakah model overfitting terhadap noise, tetapi sulit untuk mendiagnosis prediksi model yang spesifik.
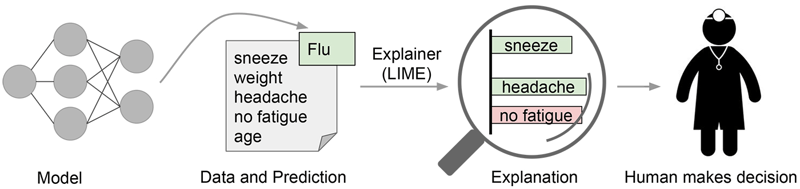 LIME berupaya memainkan peran sebagai ‘penjelas’, menerangkan prediksi untuk setiap sampel data. Sumber
Intuisi di balik LIME
Syarat utama LIME adalah bekerja dengan representasi input yang dapat ditafsirkan dan dipahami manusia. Contoh representasi yang dapat ditafsirkan misalnya vektor BoW untuk NLP, atau sebuah gambar untuk computer vision. Sebaliknya, embedding padat tidak dapat ditafsirkan, dan menerapkan LIME kemungkinan tidak akan meningkatkan interpretabilitas.
Keluaran LIME adalah daftar penjelasan yang mencerminkan kontribusi setiap fitur terhadap prediksi suatu sampel data. Ini memberikan interpretabilitas lokal, dan juga memungkinkan kita menentukan perubahan fitur mana yang paling berdampak pada prediksi.
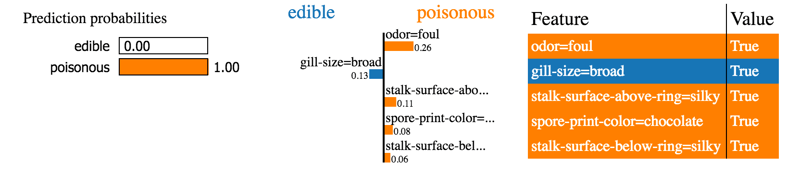 Contoh LIME yang diterapkan pada masalah klasifikasi klasik. Sumber
Sebuah penjelasan dibuat dengan mengaproksimasi model dasar secara lokal menggunakan model yang dapat ditafsirkan. Model yang dapat ditafsirkan misalnya model linear dengan regularisasi kuat, pohon keputusan, dan sebagainya. Model yang dapat ditafsirkan ini dilatih pada gangguan kecil dari instance asli dan hanya perlu memberikan aproksimasi lokal yang baik. ‘Dataset’ dibuat misalnya dengan menambahkan noise pada fitur kontinu, menghapus kata, atau menyembunyikan bagian gambar. Dengan hanya mengaproksimasi kotak hitam secara lokal (di sekitar sampel data), tugasnya menjadi jauh lebih sederhana.
Potensi jebakan
Meskipun gagasan umum LIME terdengar mudah, ada beberapa kelemahan potensial.
Pada implementasi saat ini, hanya model linear yang digunakan untuk mengaproksimasi perilaku lokal. Sampai batas tertentu, asumsi ini benar saat melihat wilayah yang sangat kecil di sekitar sampel data. Namun, dengan memperluas wilayah ini, bisa jadi model linear tidak cukup kuat untuk menjelaskan perilaku model asli. Ketidaklinearan pada wilayah lokal terjadi pada dataset yang memerlukan model kompleks dan tidak dapat ditafsirkan. Ketidakmampuan menerapkan LIME dalam skenario seperti ini merupakan jebakan yang signifikan.
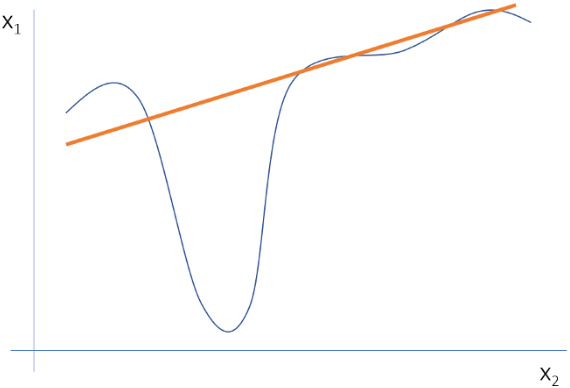 Aproksimasi linear terhadap perilaku lokal untuk dua fitur bukan representasi yang baik dan tidak akan menangkap perilaku model yang sangat non-linear.
Kedua, jenis modifikasi yang perlu dilakukan pada data untuk mendapatkan penjelasan yang tepat biasanya spesifik pada kasus penggunaan. Para penulis memberikan contoh berikut dalam paper mereka: Misalnya, sebuah model yang memprediksi gambar bernuansa sepia sebagai retro tidak dapat dijelaskan oleh ada atau tidaknya superpixel.
Sering kali, gangguan sederhana tidak cukup. Idealnya, gangguan didorong oleh variasi yang diamati dalam dataset. Mengarahkan gangguan secara manual di sisi lain mungkin bukan ide bagus, karena sangat mungkin akan memperkenalkan bias ke dalam penjelasan model.
Kesimpulan
LIME adalah alat yang bagus untuk menjelaskan apa yang dilakukan pengklasifikasi (atau model) machine learning. Ia bersifat model-agnostic, memanfaatkan gagasan sederhana dan mudah dipahami, serta tidak memerlukan banyak upaya untuk dijalankan. Seperti biasa, bahkan saat menggunakan LIME, tetap penting untuk menafsirkan output dengan benar.
Jika Anda memiliki pertanyaan tentang interpretabilitas dalam machine learning, saya dengan senang hati membacanya di kolom komentar. Ikuti saya di Medium atau Twitter jika Anda ingin menerima pembaruan blog post saya!
Jika Anda tertarik mempelajari lebih lanjut tentang pemodelan, ikuti kursus DataCamp Statistical Modeling in R.


 Hugo Bowne-Anderson · 13 min

 David Woods · 13 min

 Dario Radečić · 15 min


Pada tulisan saya sebelumnya tentang interpretabilitas model, saya memberikan gambaran umum teknik-teknik umum untuk menyelidiki model machine learning. Dalam blog post ini, saya akan memberikan penjelasan yang lebih mendalam tentang LIME.
Mengapa Perlu Memahami Metode Interpretabilitas?
Jika Anda mempercayai suatu teknik untuk menjelaskan prediksi model Anda, penting untuk memahami mekanisme dasar teknik tersebut, serta potensi jebakan yang terkait dengannya. Teknik interpretabilitas tidak bebas dari kesalahan, dan tanpa pemahaman yang baik tentang metodenya, sangat mungkin Anda mendasarkan asumsi pada hal yang keliru.
Investigasi serupa namun jauh lebih mendalam dilakukan dalam blog post berikut mengenai feature importance pada random forest. Feature importance sering digunakan untuk menentukan fitur mana yang berperan penting dalam prediksi model. Random forest menyediakan metode siap pakai untuk menentukan fitur paling penting dalam dataset dan banyak orang mengandalkan feature importance ini, menafsirkan mereka sebagai ‘penjelasan kebenaran dasar’ dari dataset.
Para penulis meneliti dua implementasi random forest (RF) dan ukuran feature importance standar yang mereka sediakan. Mereka menunjukkan bahwa permutation importance memberikan estimasi yang lebih andal saat variabel sangat berkorelasi, dibandingkan feature importance pada random forest. Saya sangat menyarankan membaca blog post mereka untuk pemahaman mendalam atas temuannya.
LIME
LIME bersifat model-agnostic, artinya dapat diterapkan pada model machine learning apa pun. Teknik ini berupaya memahami model dengan mengganggu (mengubah) input dari sampel data dan memahami bagaimana prediksinya berubah.
Pendekatan spesifik model bertujuan memahami model machine learning kotak hitam dengan menganalisis komponen internal dan bagaimana interaksinya. Pada model deep learning, misalnya, dimungkinkan menyelidiki unit aktivasi dan menautkan aktivasi internal kembali ke input. Ini memerlukan pemahaman menyeluruh tentang jaringan dan tidak dapat dengan mudah diterapkan ke model lain.
LIME memberikan interpretabilitas model secara lokal. LIME memodifikasi satu sampel data dengan mengutak-atik nilai fitur dan mengamati dampaknya pada output. Sering kali, ini juga selaras dengan apa yang diminati manusia saat mengamati output model. Pertanyaan yang paling umum mungkin: mengapa prediksi ini dibuat atau variabel mana yang menyebabkan prediksi tersebut?
Teknik interpretabilitas model lainnya hanya menjawab pertanyaan di atas dari perspektif seluruh dataset. Feature importance menjelaskan pada tingkat dataset fitur mana yang penting. Ini memungkinkan Anda memverifikasi hipotesis dan apakah model overfitting terhadap noise, tetapi sulit untuk mendiagnosis prediksi model yang spesifik.
Intuisi di balik LIME
Syarat utama LIME adalah bekerja dengan representasi input yang dapat ditafsirkan dan dipahami manusia. Contoh representasi yang dapat ditafsirkan misalnya vektor BoW untuk NLP, atau sebuah gambar untuk computer vision. Sebaliknya, embedding padat tidak dapat ditafsirkan, dan menerapkan LIME kemungkinan tidak akan meningkatkan interpretabilitas.
Keluaran LIME adalah daftar penjelasan yang mencerminkan kontribusi setiap fitur terhadap prediksi suatu sampel data. Ini memberikan interpretabilitas lokal, dan juga memungkinkan kita menentukan perubahan fitur mana yang paling berdampak pada prediksi.
Sebuah penjelasan dibuat dengan mengaproksimasi model dasar secara lokal menggunakan model yang dapat ditafsirkan. Model yang dapat ditafsirkan misalnya model linear dengan regularisasi kuat, pohon keputusan, dan sebagainya. Model yang dapat ditafsirkan ini dilatih pada gangguan kecil dari instance asli dan hanya perlu memberikan aproksimasi lokal yang baik. ‘Dataset’ dibuat misalnya dengan menambahkan noise pada fitur kontinu, menghapus kata, atau menyembunyikan bagian gambar. Dengan hanya mengaproksimasi kotak hitam secara lokal (di sekitar sampel data), tugasnya menjadi jauh lebih sederhana.
Potensi jebakan
Meskipun gagasan umum LIME terdengar mudah, ada beberapa kelemahan potensial.
Pada implementasi saat ini, hanya model linear yang digunakan untuk mengaproksimasi perilaku lokal. Sampai batas tertentu, asumsi ini benar saat melihat wilayah yang sangat kecil di sekitar sampel data. Namun, dengan memperluas wilayah ini, bisa jadi model linear tidak cukup kuat untuk menjelaskan perilaku model asli. Ketidaklinearan pada wilayah lokal terjadi pada dataset yang memerlukan model kompleks dan tidak dapat ditafsirkan. Ketidakmampuan menerapkan LIME dalam skenario seperti ini merupakan jebakan yang signifikan.
Kedua, jenis modifikasi yang perlu dilakukan pada data untuk mendapatkan penjelasan yang tepat biasanya spesifik pada kasus penggunaan. Para penulis memberikan contoh berikut dalam paper mereka: Misalnya, sebuah model yang memprediksi gambar bernuansa sepia sebagai retro tidak dapat dijelaskan oleh ada atau tidaknya superpixel.
Sering kali, gangguan sederhana tidak cukup. Idealnya, gangguan didorong oleh variasi yang diamati dalam dataset. Mengarahkan gangguan secara manual di sisi lain mungkin bukan ide bagus, karena sangat mungkin akan memperkenalkan bias ke dalam penjelasan model.
Kesimpulan
LIME adalah alat yang bagus untuk menjelaskan apa yang dilakukan pengklasifikasi (atau model) machine learning. Ia bersifat model-agnostic, memanfaatkan gagasan sederhana dan mudah dipahami, serta tidak memerlukan banyak upaya untuk dijalankan. Seperti biasa, bahkan saat menggunakan LIME, tetap penting untuk menafsirkan output dengan benar.
Jika Anda memiliki pertanyaan tentang interpretabilitas dalam machine learning, saya dengan senang hati membacanya di kolom komentar. Ikuti saya di Medium atau Twitter jika Anda ingin menerima pembaruan blog post saya!
Jika Anda tertarik mempelajari lebih lanjut tentang pemodelan, ikuti kursus DataCamp Statistical Modeling in R.