No meu post anterior sobre interpretabilidade de modelos, apresentei uma visão geral das técnicas mais usadas para investigar modelos de machine learning. Neste artigo, vou explicar em mais detalhes o LIME.
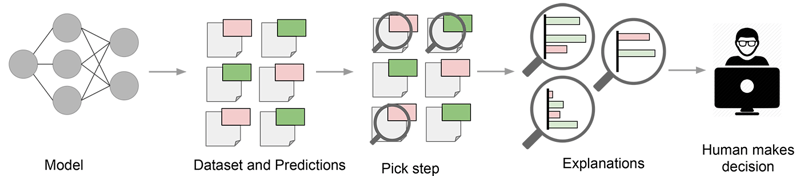 O LIME explica previsões de modelos no nível de cada amostra de dados. Ele permite que usuários finais interpretem essas previsões e ajam com base nelas. Fonte
Por que é importante entender métodos de interpretabilidade?
Se você confia em uma técnica para explicar as previsões do seu modelo, é fundamental entender a mecânica por trás dessa técnica e os possíveis riscos associados. Técnicas de interpretabilidade não são infalíveis e, sem um bom entendimento do método, é bem provável que você baseie suas conclusões em premissas equivocadas.
Uma investigação semelhante, porém muito mais aprofundada, foi feita neste post sobre importâncias em random forest. A importância de variáveis costuma ser usada para identificar quais atributos têm papel relevante nas previsões do modelo. Random forests oferecem um método pronto para apontar as variáveis mais importantes do conjunto de dados, e muita gente interpreta essas importâncias como uma “explicação definitiva” do dataset.
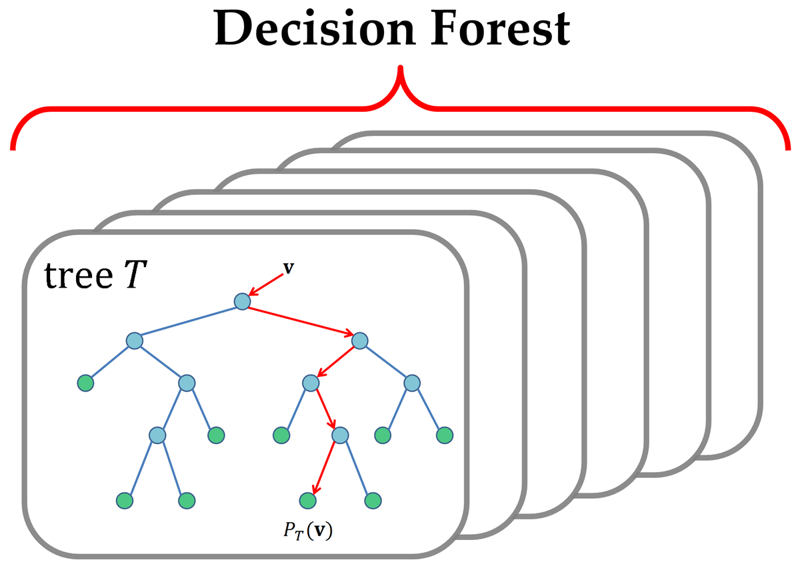 Uma árvore de decisão ou uma random forest é composta por várias árvores. Investigando quais variáveis são usadas para construir as “melhores” árvores, é possível estimar a importância das variáveis. Fonte
Os autores investigaram duas implementações de Random Forest (RF) e as medidas padrão de importância de variáveis que elas oferecem. Eles mostram que a importância por permutação gera estimativas mais robustas quando há variáveis fortemente correlacionadas, em comparação às importâncias da random forest. Recomendo a leitura do post para entender a fundo as conclusões.
LIME
O LIME é independente de modelo (model-agnostic), ou seja, pode ser aplicado a qualquer algoritmo de machine learning. A técnica tenta entender o modelo perturbando a entrada de amostras de dados e observando como as previsões mudam.
 O LIME assume um modelo de machine learning como caixa-preta e investiga a relação entre entrada e saída representada por esse modelo.
Abordagens específicas de modelo buscam entender a caixa-preta analisando os componentes internos e como interagem. Em modelos de deep learning, por exemplo, é possível investigar unidades de ativação e relacionar ativações internas com a entrada. Isso exige entendimento profundo da rede e não se generaliza para outros modelos.
O LIME fornece interpretabilidade local. Ele modifica uma única amostra de dados ajustando valores de variáveis e observa o impacto resultante na saída. Na prática, isso costuma estar alinhado com o que as pessoas querem saber ao analisar a previsão de um modelo: por que essa previsão foi feita? Quais variáveis causaram esse resultado?
Outras técnicas de interpretabilidade respondem à pergunta acima apenas pela ótica do conjunto de dados como um todo. Importâncias de variáveis explicam, no nível do dataset, quais atributos são relevantes. Isso ajuda a verificar hipóteses e a identificar overfitting a ruído, mas dificulta diagnosticar previsões específicas.
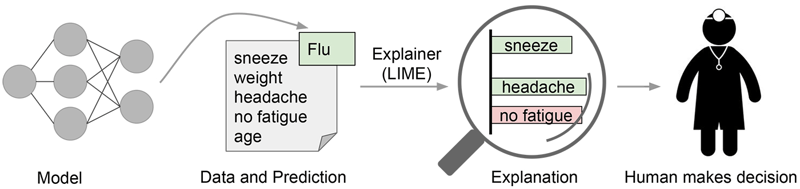 O LIME atua como um “explicador”, justificando previsões para cada amostra de dados. Fonte
Intuição por trás do LIME
Um requisito-chave do LIME é trabalhar com uma representação da entrada que seja interpretável para humanos. Exemplos incluem um vetor BoW em NLP ou a própria imagem em visão computacional. Já embeddings densos não são interpretáveis; aplicar LIME nesse caso provavelmente não trará ganhos de interpretabilidade.
A saída do LIME é uma lista de explicações que reflete a contribuição de cada variável para a previsão de uma amostra. Isso oferece interpretabilidade local e também permite identificar quais alterações de variáveis terão maior impacto na previsão.
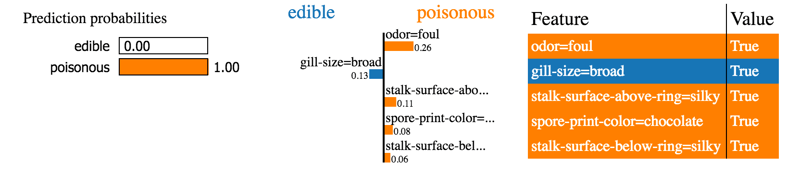 Um exemplo de LIME aplicado a um problema clássico de classificação. Fonte
Uma explicação é criada aproximando localmente o modelo original por um modelo interpretável. Modelos interpretáveis incluem, por exemplo, regressões lineares com forte regularização, árvores de decisão, etc. Esses modelos são treinados em pequenas perturbações da instância original e devem oferecer apenas uma boa aproximação local. O “dataset” é criado, por exemplo, adicionando ruído a variáveis contínuas, removendo palavras ou ocultando partes da imagem. Ao aproximar a caixa-preta apenas localmente (na vizinhança da amostra), a tarefa fica bem mais simples.
Armadilhas em potencial
Apesar de a ideia geral do LIME parecer simples, há alguns possíveis pontos fracos.
Na implementação atual, apenas modelos lineares são usados para aproximar o comportamento local. Em certa medida, essa suposição funciona quando olhamos para uma região muito pequena ao redor da amostra. Porém, ao ampliar essa região, um modelo linear pode não ser suficiente para explicar o comportamento do modelo original. A não linearidade em regiões locais ocorre em datasets que exigem modelos complexos e pouco interpretáveis. Não conseguir aplicar o LIME nesses cenários é uma limitação relevante.
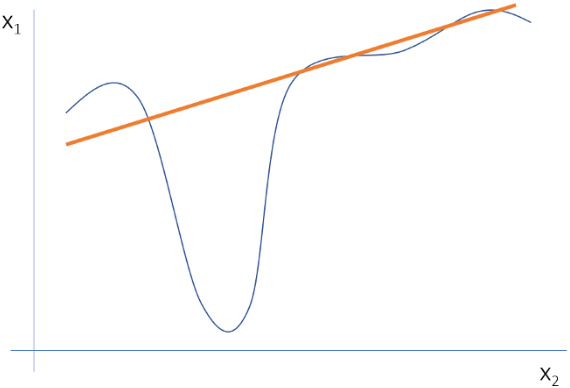 Uma aproximação linear do comportamento local para duas variáveis não representa bem nem captura o comportamento altamente não linear do modelo.
Em segundo lugar, o tipo de modificação necessária nos dados para obter boas explicações costuma ser específico do caso de uso. Os autores dão o seguinte exemplo no artigo: um modelo que prevê que imagens em tom sépia são “retrô” não pode ser explicado pela presença ou ausência de superpixels.
Muitas vezes, perturbações simples não bastam. O ideal é que as perturbações reflitam a variação observada no conjunto de dados. Tentar conduzir manualmente essas perturbações, por outro lado, provavelmente introduzirá vieses nas explicações do modelo.
Conclusão
O LIME é uma ótima ferramenta para explicar o que classificadores (ou modelos) de machine learning estão fazendo. Ele é independente de modelo, se apoia em ideias simples e compreensíveis e não exige muito esforço para rodar. Como sempre, mesmo usando LIME, é essencial interpretar a saída corretamente.
Se você tiver perguntas sobre interpretabilidade em machine learning, vou adorar ler nos comentários. Siga-me no Medium ou no Twitter para receber atualizações dos meus posts!
Se quiser se aprofundar em modelagem, faça o curso da DataCamp Statistical Modeling in R.


 Natassha Selvaraj• 15 min

 Nisha Arya Ahmed• 12 min

 Abid Ali Awan• 5 min


No meu post anterior sobre interpretabilidade de modelos, apresentei uma visão geral das técnicas mais usadas para investigar modelos de machine learning. Neste artigo, vou explicar em mais detalhes o LIME.
Por que é importante entender métodos de interpretabilidade?
Se você confia em uma técnica para explicar as previsões do seu modelo, é fundamental entender a mecânica por trás dessa técnica e os possíveis riscos associados. Técnicas de interpretabilidade não são infalíveis e, sem um bom entendimento do método, é bem provável que você baseie suas conclusões em premissas equivocadas.
Uma investigação semelhante, porém muito mais aprofundada, foi feita neste post sobre importâncias em random forest. A importância de variáveis costuma ser usada para identificar quais atributos têm papel relevante nas previsões do modelo. Random forests oferecem um método pronto para apontar as variáveis mais importantes do conjunto de dados, e muita gente interpreta essas importâncias como uma “explicação definitiva” do dataset.
Os autores investigaram duas implementações de Random Forest (RF) e as medidas padrão de importância de variáveis que elas oferecem. Eles mostram que a importância por permutação gera estimativas mais robustas quando há variáveis fortemente correlacionadas, em comparação às importâncias da random forest. Recomendo a leitura do post para entender a fundo as conclusões.
LIME
O LIME é independente de modelo (model-agnostic), ou seja, pode ser aplicado a qualquer algoritmo de machine learning. A técnica tenta entender o modelo perturbando a entrada de amostras de dados e observando como as previsões mudam.
Abordagens específicas de modelo buscam entender a caixa-preta analisando os componentes internos e como interagem. Em modelos de deep learning, por exemplo, é possível investigar unidades de ativação e relacionar ativações internas com a entrada. Isso exige entendimento profundo da rede e não se generaliza para outros modelos.
O LIME fornece interpretabilidade local. Ele modifica uma única amostra de dados ajustando valores de variáveis e observa o impacto resultante na saída. Na prática, isso costuma estar alinhado com o que as pessoas querem saber ao analisar a previsão de um modelo: por que essa previsão foi feita? Quais variáveis causaram esse resultado?
Outras técnicas de interpretabilidade respondem à pergunta acima apenas pela ótica do conjunto de dados como um todo. Importâncias de variáveis explicam, no nível do dataset, quais atributos são relevantes. Isso ajuda a verificar hipóteses e a identificar overfitting a ruído, mas dificulta diagnosticar previsões específicas.
Intuição por trás do LIME
Um requisito-chave do LIME é trabalhar com uma representação da entrada que seja interpretável para humanos. Exemplos incluem um vetor BoW em NLP ou a própria imagem em visão computacional. Já embeddings densos não são interpretáveis; aplicar LIME nesse caso provavelmente não trará ganhos de interpretabilidade.
A saída do LIME é uma lista de explicações que reflete a contribuição de cada variável para a previsão de uma amostra. Isso oferece interpretabilidade local e também permite identificar quais alterações de variáveis terão maior impacto na previsão.
Uma explicação é criada aproximando localmente o modelo original por um modelo interpretável. Modelos interpretáveis incluem, por exemplo, regressões lineares com forte regularização, árvores de decisão, etc. Esses modelos são treinados em pequenas perturbações da instância original e devem oferecer apenas uma boa aproximação local. O “dataset” é criado, por exemplo, adicionando ruído a variáveis contínuas, removendo palavras ou ocultando partes da imagem. Ao aproximar a caixa-preta apenas localmente (na vizinhança da amostra), a tarefa fica bem mais simples.
Armadilhas em potencial
Apesar de a ideia geral do LIME parecer simples, há alguns possíveis pontos fracos.
Na implementação atual, apenas modelos lineares são usados para aproximar o comportamento local. Em certa medida, essa suposição funciona quando olhamos para uma região muito pequena ao redor da amostra. Porém, ao ampliar essa região, um modelo linear pode não ser suficiente para explicar o comportamento do modelo original. A não linearidade em regiões locais ocorre em datasets que exigem modelos complexos e pouco interpretáveis. Não conseguir aplicar o LIME nesses cenários é uma limitação relevante.
Em segundo lugar, o tipo de modificação necessária nos dados para obter boas explicações costuma ser específico do caso de uso. Os autores dão o seguinte exemplo no artigo: um modelo que prevê que imagens em tom sépia são “retrô” não pode ser explicado pela presença ou ausência de superpixels.
Muitas vezes, perturbações simples não bastam. O ideal é que as perturbações reflitam a variação observada no conjunto de dados. Tentar conduzir manualmente essas perturbações, por outro lado, provavelmente introduzirá vieses nas explicações do modelo.
Conclusão
O LIME é uma ótima ferramenta para explicar o que classificadores (ou modelos) de machine learning estão fazendo. Ele é independente de modelo, se apoia em ideias simples e compreensíveis e não exige muito esforço para rodar. Como sempre, mesmo usando LIME, é essencial interpretar a saída corretamente.
Se você tiver perguntas sobre interpretabilidade em machine learning, vou adorar ler nos comentários. Siga-me no Medium ou no Twitter para receber atualizações dos meus posts!
Se quiser se aprofundar em modelagem, faça o curso da DataCamp Statistical Modeling in R.