In mijn vorige post over modelinterpretatie gaf ik een overzicht van veelgebruikte technieken om machinelearningmodellen te onderzoeken. In deze blogpost geef ik een grondigere uitleg van LIME.
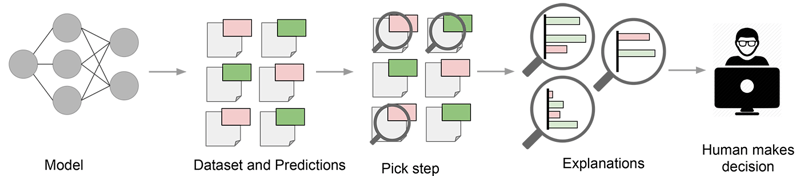 LIME verklaart modelvoorspellingen op het niveau van afzonderlijke datamonsters. Het stelt eindgebruikers in staat deze voorspellingen te interpreteren en ernaar te handelen. Bron
Waarom is het nodig om interpretatiemethoden te begrijpen?
Als je een techniek vertrouwt met het uitleggen van de voorspellingen van je model, is het belangrijk de onderliggende werking van die techniek te begrijpen, plus de mogelijke valkuilen. Interpretatietechnieken zijn niet onfeilbaar en zonder goed begrip van de methode is de kans groot dat je je aannames op onjuistheden baseert.
Een soortgelijk maar aanzienlijk grondiger onderzoek is gedaan in de volgende blogpost over belangrijkheden in random forests. Feature-importance wordt vaak gebruikt om te bepalen welke kenmerken een belangrijke rol spelen in de modelvoorspellingen. Random forests bieden een kant-en-klare methode om de belangrijkste features in de dataset te bepalen, en veel mensen vertrouwen op deze belangrijkheden en zien ze als een ‘grondige uitleg’ van de dataset.
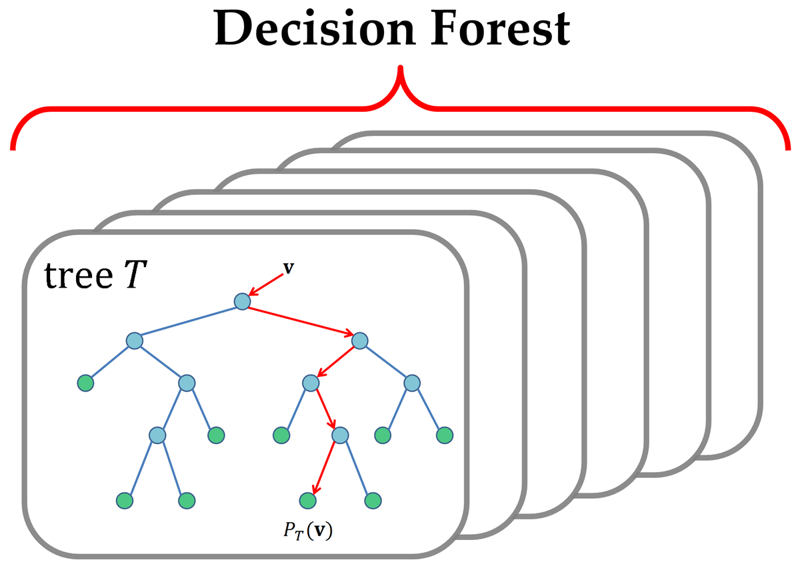 Een decision of random forest bestaat uit meerdere beslisbomen. Door te onderzoeken welke features worden gebruikt om de ‘beste’ bomen te construeren, kun je een schatting krijgen van de feature-importance. Bron
De auteurs onderzochten twee implementaties van random forests (RF) en de standaardmaten voor feature-importance die ze bieden. Ze laten zien dat permutatiebelangrijkheid robuustere schattingen geeft wanneer variabelen sterk gecorreleerd zijn, vergeleken met de belangrijkheden uit random forests. Ik raad sterk aan hun blogpost te lezen voor een grondig begrip van de bevindingen.
LIME
LIME is model-agnostisch, wat betekent dat het op elk machinelearningmodel kan worden toegepast. De techniek probeert het model te begrijpen door de invoer van datamonsters te verstoren en te analyseren hoe de voorspellingen veranderen.
 LIME gaat uit van een black-box machinelearningmodel en onderzoekt de relatie tussen invoer en uitvoer die door het model wordt gerepresenteerd.
Modelspecifieke benaderingen proberen het black-box model te begrijpen door de interne componenten en hun interacties te analyseren. In deep-learningmodellen is het bijvoorbeeld mogelijk activatie-eenheden te onderzoeken en interne activaties terug te koppelen naar de input. Dit vereist een grondig begrip van het netwerk en schaalt niet naar andere modellen.
LIME biedt lokale modelinterpretatie. LIME past één datamonster aan door de featurewaarden te wijzigen en observeert het effect op de output. Dit sluit vaak aan bij wat mensen willen weten wanneer ze de output van een model bekijken. De meest voorkomende vraag is waarschijnlijk: waarom is deze voorspelling gemaakt of welke variabelen veroorzaakten de voorspelling?
Andere interpretatietechnieken beantwoorden die vraag alleen vanuit het perspectief van de volledige dataset. Feature-importance legt op datasetniveau uit welke features belangrijk zijn. Het stelt je in staat hypothesen te verifiëren en te beoordelen of het model overfit op ruis, maar het is lastig om specifieke modelvoorspellingen te diagnosticeren.
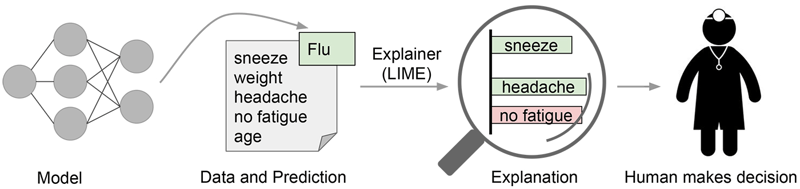 LIME probeert de rol van ‘uitlegger’ op zich te nemen en voorspellingen per datamonster te verklaren. Bron
Intuïtie achter LIME
Een belangrijke voorwaarde voor LIME is werken met een interpreteerbare representatie van de input die voor mensen begrijpelijk is. Voorbeelden van interpreteerbare representaties zijn bijvoorbeeld een BoW-vector voor NLP of een afbeelding voor computervisie. Dichte embeddings daarentegen zijn niet interpreteerbaar en LIME toepassen zal de interpreteerbaarheid waarschijnlijk niet verbeteren.
De output van LIME is een lijst met verklaringen die de bijdrage van elke feature aan de voorspelling van een datamonster weergeeft. Dit biedt lokale interpreteerbaarheid en maakt het ook mogelijk te bepalen welke featurewijzigingen de grootste impact op de voorspelling hebben.
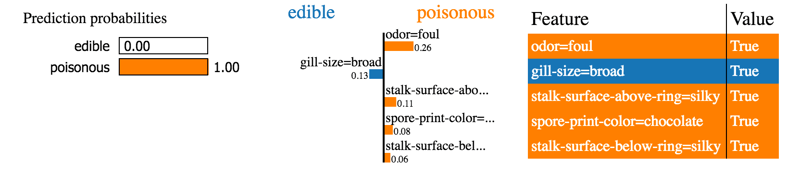 Een voorbeeld van LIME toegepast op een klassiek classificatieprobleem. Bron
Een verklaring wordt gecreëerd door het onderliggende model lokaal te benaderen met een interpreteerbaar model. Interpreteerbare modellen zijn bijvoorbeeld lineaire modellen met sterke regularisatie, beslisbomen, enzovoort. De interpreteerbare modellen worden getraind op kleine verstoringen van het oorspronkelijke voorbeeld en hoeven alleen lokaal goed te benaderen. De ‘dataset’ wordt gemaakt door bijvoorbeeld ruis toe te voegen aan continue features, woorden te verwijderen of delen van de afbeelding te verbergen. Door de black-box alleen lokaal te benaderen (in de buurt van het datamonster) wordt de taak aanzienlijk vereenvoudigd.
Mogelijke valkuilen
Hoewel het algemene idee van LIME eenvoudig klinkt, zijn er een paar mogelijke nadelen.
In de huidige implementatie worden alleen lineaire modellen gebruikt om lokaal gedrag te benaderen. Tot op zekere hoogte klopt die aanname wanneer je naar een heel kleine regio rond het datamonster kijkt. Als je deze regio echter uitbreidt, kan een lineair model mogelijk niet krachtig genoeg zijn om het gedrag van het oorspronkelijke model uit te leggen. Niet-lineariteit op lokale regio’s komt voor bij datasets die complexe, niet-interpreteerbare modellen vereisen. LIME niet kunnen toepassen in deze scenario’s is een aanzienlijke valkuil.
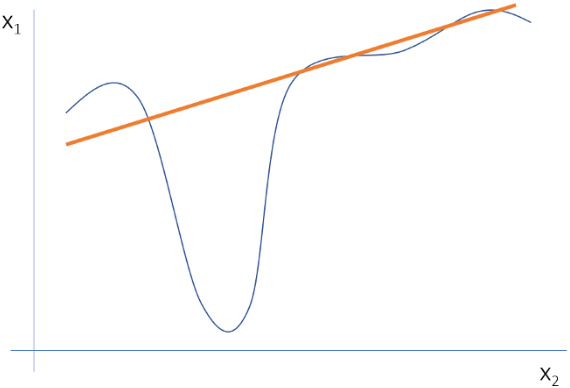 Een lineaire benadering van het lokale gedrag voor twee features is geen goede representatie en zal het sterk niet-lineaire gedrag van het model niet vastleggen.
Ten tweede zijn de soorten aanpassingen die je aan de data moet doen om goede verklaringen te krijgen, meestal specifiek voor de usecase. De auteurs gaven het volgende voorbeeld in hun paper: een model dat sepia-getinte afbeeldingen als retro bestempelt, kan niet worden verklaard door de aanwezigheid of afwezigheid van superpixels.
Vaak zijn eenvoudige verstoringen niet voldoende. Idealiter worden de verstoringen gestuurd door de variatie die in de dataset wordt waargenomen. De verstoringen daarentegen handmatig sturen is waarschijnlijk geen goed idee, omdat je zo waarschijnlijk bias introduceert in de modelverklaringen.
Conclusie
LIME is een geweldig hulpmiddel om uit te leggen wat machinelearning-classifiers (of modellen) doen. Het is model-agnostisch, maakt gebruik van eenvoudige en begrijpelijke ideeën en vergt weinig moeite om te draaien. Zoals altijd blijft het, ook bij LIME, belangrijk om de output correct te interpreteren.
Als je vragen hebt over interpretatie in machine learning, lees ik die graag in de comments. Volg me op Medium of Twitter als je updates over mijn blogposts wilt ontvangen!
Als je meer wilt leren over modelleren, volg dan DataCamp's cursus Statistical Modeling in R.



 Adel Nehme · 15 min
In mijn vorige post over modelinterpretatie gaf ik een overzicht van veelgebruikte technieken om machinelearningmodellen te onderzoeken. In deze blogpost geef ik een grondigere uitleg van LIME.
Waarom is het nodig om interpretatiemethoden te begrijpen?
Als je een techniek vertrouwt met het uitleggen van de voorspellingen van je model, is het belangrijk de onderliggende werking van die techniek te begrijpen, plus de mogelijke valkuilen. Interpretatietechnieken zijn niet onfeilbaar en zonder goed begrip van de methode is de kans groot dat je je aannames op onjuistheden baseert.
Een soortgelijk maar aanzienlijk grondiger onderzoek is gedaan in de volgende blogpost over belangrijkheden in random forests. Feature-importance wordt vaak gebruikt om te bepalen welke kenmerken een belangrijke rol spelen in de modelvoorspellingen. Random forests bieden een kant-en-klare methode om de belangrijkste features in de dataset te bepalen, en veel mensen vertrouwen op deze belangrijkheden en zien ze als een ‘grondige uitleg’ van de dataset.
De auteurs onderzochten twee implementaties van random forests (RF) en de standaardmaten voor feature-importance die ze bieden. Ze laten zien dat permutatiebelangrijkheid robuustere schattingen geeft wanneer variabelen sterk gecorreleerd zijn, vergeleken met de belangrijkheden uit random forests. Ik raad sterk aan hun blogpost te lezen voor een grondig begrip van de bevindingen.
LIME
LIME is model-agnostisch, wat betekent dat het op elk machinelearningmodel kan worden toegepast. De techniek probeert het model te begrijpen door de invoer van datamonsters te verstoren en te analyseren hoe de voorspellingen veranderen.
Modelspecifieke benaderingen proberen het black-box model te begrijpen door de interne componenten en hun interacties te analyseren. In deep-learningmodellen is het bijvoorbeeld mogelijk activatie-eenheden te onderzoeken en interne activaties terug te koppelen naar de input. Dit vereist een grondig begrip van het netwerk en schaalt niet naar andere modellen.
LIME biedt lokale modelinterpretatie. LIME past één datamonster aan door de featurewaarden te wijzigen en observeert het effect op de output. Dit sluit vaak aan bij wat mensen willen weten wanneer ze de output van een model bekijken. De meest voorkomende vraag is waarschijnlijk: waarom is deze voorspelling gemaakt of welke variabelen veroorzaakten de voorspelling?
Andere interpretatietechnieken beantwoorden die vraag alleen vanuit het perspectief van de volledige dataset. Feature-importance legt op datasetniveau uit welke features belangrijk zijn. Het stelt je in staat hypothesen te verifiëren en te beoordelen of het model overfit op ruis, maar het is lastig om specifieke modelvoorspellingen te diagnosticeren.
Intuïtie achter LIME
Een belangrijke voorwaarde voor LIME is werken met een interpreteerbare representatie van de input die voor mensen begrijpelijk is. Voorbeelden van interpreteerbare representaties zijn bijvoorbeeld een BoW-vector voor NLP of een afbeelding voor computervisie. Dichte embeddings daarentegen zijn niet interpreteerbaar en LIME toepassen zal de interpreteerbaarheid waarschijnlijk niet verbeteren.
De output van LIME is een lijst met verklaringen die de bijdrage van elke feature aan de voorspelling van een datamonster weergeeft. Dit biedt lokale interpreteerbaarheid en maakt het ook mogelijk te bepalen welke featurewijzigingen de grootste impact op de voorspelling hebben.
Een verklaring wordt gecreëerd door het onderliggende model lokaal te benaderen met een interpreteerbaar model. Interpreteerbare modellen zijn bijvoorbeeld lineaire modellen met sterke regularisatie, beslisbomen, enzovoort. De interpreteerbare modellen worden getraind op kleine verstoringen van het oorspronkelijke voorbeeld en hoeven alleen lokaal goed te benaderen. De ‘dataset’ wordt gemaakt door bijvoorbeeld ruis toe te voegen aan continue features, woorden te verwijderen of delen van de afbeelding te verbergen. Door de black-box alleen lokaal te benaderen (in de buurt van het datamonster) wordt de taak aanzienlijk vereenvoudigd.
Mogelijke valkuilen
Hoewel het algemene idee van LIME eenvoudig klinkt, zijn er een paar mogelijke nadelen.
In de huidige implementatie worden alleen lineaire modellen gebruikt om lokaal gedrag te benaderen. Tot op zekere hoogte klopt die aanname wanneer je naar een heel kleine regio rond het datamonster kijkt. Als je deze regio echter uitbreidt, kan een lineair model mogelijk niet krachtig genoeg zijn om het gedrag van het oorspronkelijke model uit te leggen. Niet-lineariteit op lokale regio’s komt voor bij datasets die complexe, niet-interpreteerbare modellen vereisen. LIME niet kunnen toepassen in deze scenario’s is een aanzienlijke valkuil.
Ten tweede zijn de soorten aanpassingen die je aan de data moet doen om goede verklaringen te krijgen, meestal specifiek voor de usecase. De auteurs gaven het volgende voorbeeld in hun paper: een model dat sepia-getinte afbeeldingen als retro bestempelt, kan niet worden verklaard door de aanwezigheid of afwezigheid van superpixels.
Vaak zijn eenvoudige verstoringen niet voldoende. Idealiter worden de verstoringen gestuurd door de variatie die in de dataset wordt waargenomen. De verstoringen daarentegen handmatig sturen is waarschijnlijk geen goed idee, omdat je zo waarschijnlijk bias introduceert in de modelverklaringen.
Conclusie
LIME is een geweldig hulpmiddel om uit te leggen wat machinelearning-classifiers (of modellen) doen. Het is model-agnostisch, maakt gebruik van eenvoudige en begrijpelijke ideeën en vergt weinig moeite om te draaien. Zoals altijd blijft het, ook bij LIME, belangrijk om de output correct te interpreteren.
Als je vragen hebt over interpretatie in machine learning, lees ik die graag in de comments. Volg me op Medium of Twitter als je updates over mijn blogposts wilt ontvangen!
Als je meer wilt leren over modelleren, volg dan DataCamp's cursus Statistical Modeling in R.