Kurs
Machine Learning verstehen
2 Std.
308.2K
In meinem vorherigen Beitrag zur Modellinterpretierbarkeit habe ich einen Überblick über gängige Techniken zur Untersuchung von Machine-Learning-Modellen gegeben. In diesem Blogpost gehe ich ausführlicher auf LIME ein.
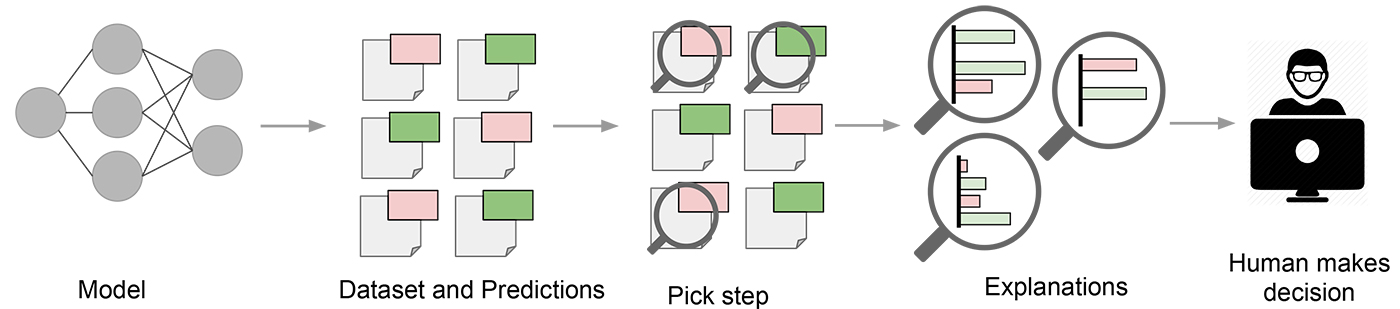
Wenn du einer Technik die Erklärung der Vorhersagen deines Modells anvertraust, musst du die zugrunde liegende Funktionsweise und mögliche Fallstricke kennen. Interpretierbarkeitsmethoden sind nicht unfehlbar. Ohne gutes Verständnis läufst du Gefahr, Annahmen auf falsche Grundlagen zu stützen.
Eine ähnliche, aber deutlich gründlichere Untersuchung findest du in diesem Blogpost zu Random-Forest-Importanzen. Feature-Importanz wird häufig genutzt, um zu bestimmen, welche Merkmale einen großen Einfluss auf die Modellvorhersagen haben. Random Forests liefern out of the box eine Methode, die wichtigsten Merkmale im Datensatz zu bestimmen, und viele interpretieren diese Importanzen als eine Art „Ground Truth“ für den Datensatz.
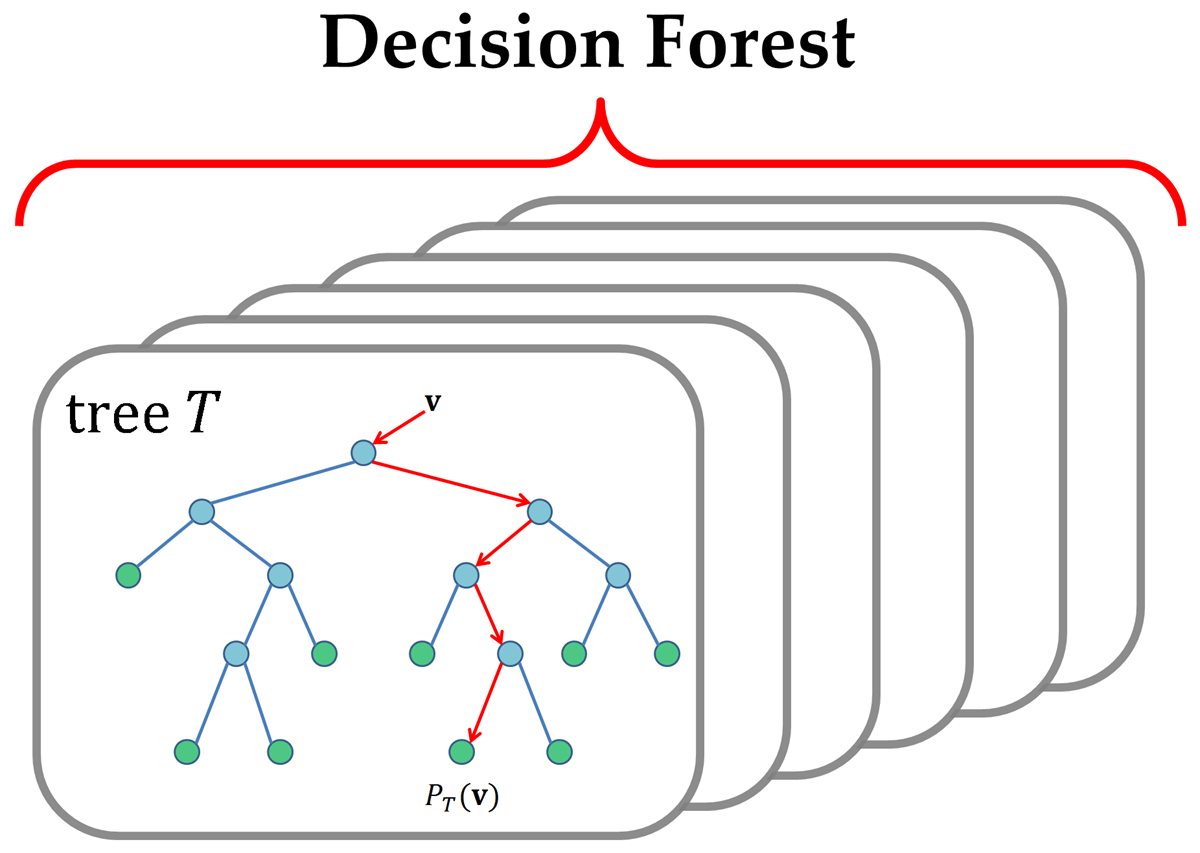
Die Autorinnen und Autoren untersuchten zwei Random-Forest-(RF)-Implementierungen und deren Standardmaße für Feature-Importanz. Sie zeigen, dass die Permutationsimportanz robustere Schätzungen liefert, wenn Variablen stark korreliert sind, als die klassischen Random-Forest-Importanzen. Die Lektüre des Blogposts lohnt sich für ein fundiertes Verständnis der Ergebnisse.
LIME ist modellagnostisch, das heißt, es lässt sich auf jedes Machine-Learning-Modell anwenden. Die Technik versucht, das Modell zu verstehen, indem sie die Eingaben einzelner Datenpunkte verändert und beobachtet, wie sich die Vorhersagen ändern.
Modellspezifische Ansätze versuchen, das Black-Box-Modell zu verstehen, indem sie interne Komponenten und deren Zusammenspiel analysieren. In Deep-Learning-Modellen lassen sich z. B. Aktivierungseinheiten untersuchen und interne Aktivierungen auf die Eingabe zurückführen. Das erfordert jedoch ein tiefes Verständnis des Netzwerks und lässt sich nicht ohne Weiteres auf andere Modelle übertragen.
LIME liefert lokale Interpretierbarkeit. LIME verändert einen einzelnen Datenpunkt, indem es Merkmalswerte variiert, und beobachtet die Auswirkungen auf die Ausgabe. Das entspricht oft dem, was Menschen beim Blick auf eine Modellvorhersage interessiert: Warum wurde diese Vorhersage getroffen, oder welche Variablen haben sie verursacht?
Andere Interpretierbarkeitsmethoden beantworten diese Frage eher aus Sicht des gesamten Datensatzes. Feature-Importanzen zeigen auf Datensatzebene, welche Merkmale wichtig sind. Das hilft, Hypothesen zu prüfen und zu erkennen, ob das Modell auf Rauschen überanpasst. Konkrete Einzelvorhersagen lassen sich damit jedoch schwer diagnostizieren.
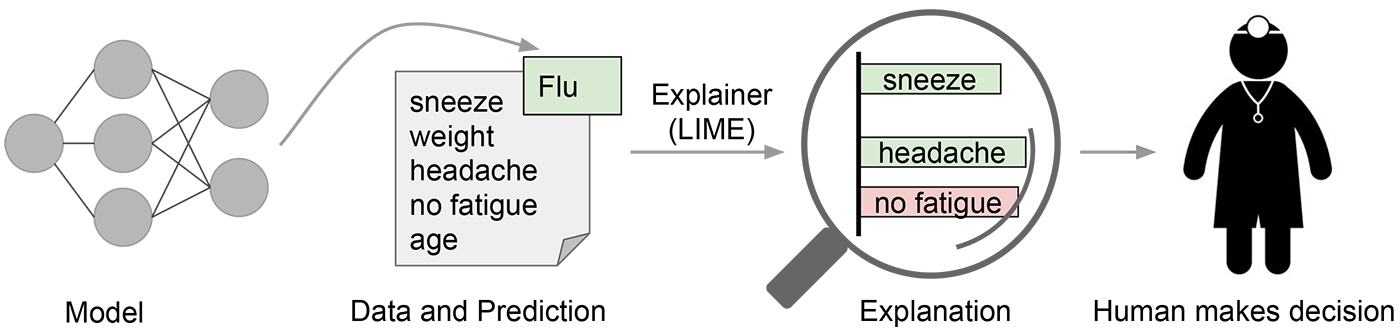
Eine zentrale Voraussetzung für LIME ist eine für Menschen verständliche, interpretierbare Darstellung der Eingabe. Beispiele sind etwa ein BoW-Vektor im NLP oder ein Bild in der Computer Vision. Dichte Embeddings sind hingegen nicht interpretierbar; LIME darauf anzuwenden, verbessert die Interpretierbarkeit in der Regel nicht.
Das Ergebnis von LIME ist eine Liste von Erklärungen, die den Beitrag jedes Merkmals zur Vorhersage eines Datenpunkts widerspiegeln. Das schafft lokale Interpretierbarkeit und zeigt zudem, welche Merkmalsänderungen die größte Wirkung auf die Vorhersage hätten.
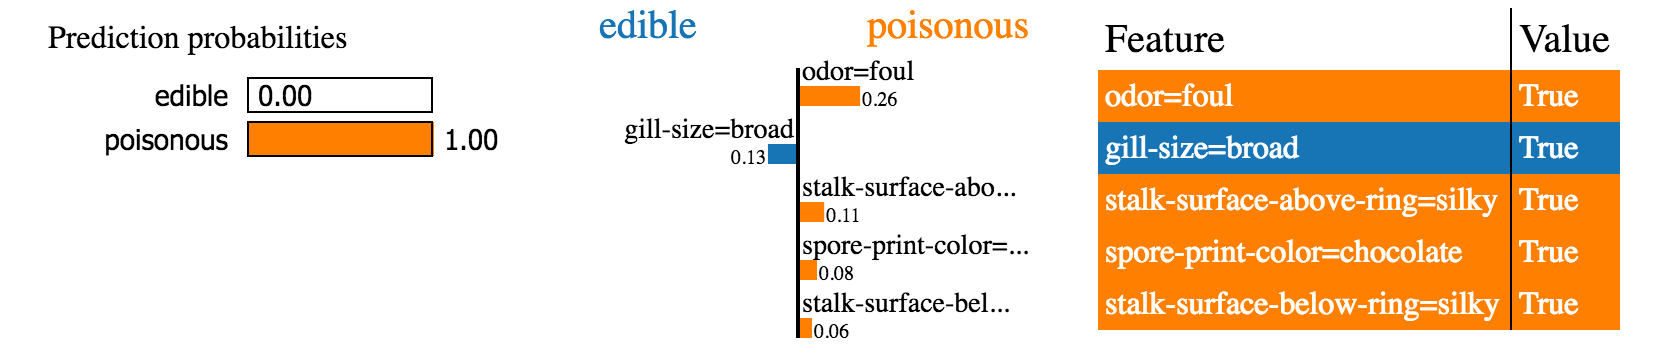
Eine Erklärung entsteht, indem das zugrunde liegende Modell lokal durch ein interpretierbares Modell angenähert wird. Interpretierbare Modelle sind z. B. stark regularisierte lineare Modelle, Entscheidungsbäume etc. Diese Modelle werden auf kleinen Störungen der Originalinstanz trainiert und sollen nur lokal gut annähern. Das „Datenset“ entsteht, indem man z. B. Rauschen zu kontinuierlichen Merkmalen addiert, Wörter entfernt oder Bildbereiche ausblendet. Durch die rein lokale Annäherung an die Black Box (im Umfeld des Datenpunkts) wird die Aufgabe deutlich vereinfacht.
So eingängig die Grundidee von LIME ist, es gibt einige potenzielle Nachteile.
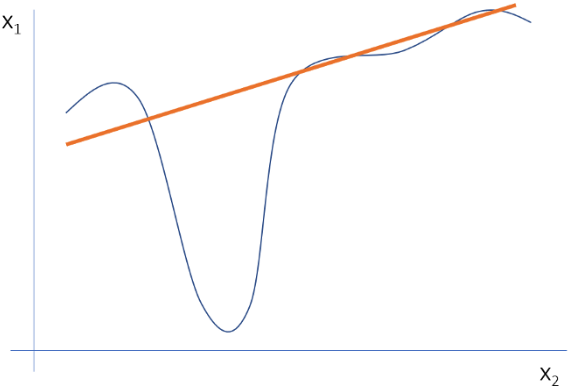
In der aktuellen Implementierung werden zur lokalen Annäherung nur lineare Modelle eingesetzt. Bis zu einem gewissen Grad stimmt diese Annahme in einer sehr kleinen Umgebung des Datenpunkts. Vergrößert man diese Region jedoch, kann ein lineares Modell zu schwach sein, um das Verhalten des Originalmodells zu erklären. Lokale Nichtlinearität tritt gerade bei Datensätzen auf, die komplexe, schwer interpretierbare Modelle erfordern. LIME in solchen Situationen nicht sinnvoll anwenden zu können, ist ein gravierender Nachteil.
Zweitens sind die nötigen Modifikationen an den Daten für brauchbare Erklärungen meist an den Use Case gebunden. Ein Beispiel aus dem Paper: Ein Modell, das sepia-getönte Bilder als „retro“ klassifiziert, lässt sich nicht über Vorhandensein oder Abwesenheit von Superpixeln erklären.
Oft reichen einfache Störungen nicht aus. Ideal wären Perturbationen, die sich an der im Datensatz beobachteten Variation orientieren. Diese manuell zu steuern, ist hingegen keine gute Idee, da dadurch sehr wahrscheinlich Verzerrungen in die Modellerklärungen eingebracht werden.
LIME ist ein starkes Werkzeug, um zu erklären, was Machine-Learning-Klassifikatoren (oder -Modelle) tun. Es ist modellagnostisch, beruht auf einfachen, gut nachvollziehbaren Ideen und ist mit wenig Aufwand einsetzbar. Wie immer gilt: Auch bei LIME ist es entscheidend, die Ausgaben richtig zu interpretieren.
Wenn du Fragen zur Interpretierbarkeit im Machine Learning hast, schreib sie gern in die Kommentare. Folge mir auf Medium oder Twitter, um Updates zu neuen Blogposts zu erhalten!
Wenn du mehr über Modellierung lernen möchtest, schau dir den DataCamp-Kurs Statistical Modeling in R an.
Mehr über Machine Learning lernen
Kurs
Kurs
Kurs
Blog
Tutorial
Matt Crabtree
5 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Sejal Jaiswal
24 Min.





