Nel mio precedente post sull’interpretabilità dei modelli ho fornito una panoramica delle tecniche più comuni per analizzare i modelli di machine learning. In questo articolo, offrirò una spiegazione più approfondita di LIME.
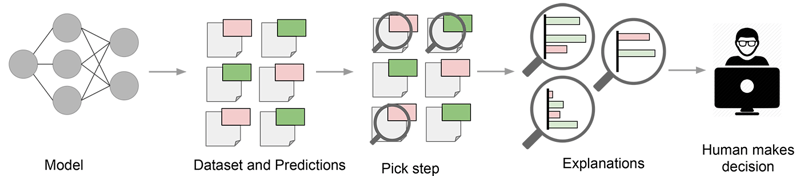 LIME spiega le previsioni del modello a livello di singolo campione di dati. Consente agli utenti finali di interpretare queste previsioni e agire di conseguenza. Fonte
Perché è necessario comprendere i metodi di interpretabilità?
Se affidi a una tecnica il compito di spiegare le previsioni del tuo modello, è importante capirne i meccanismi di base e le possibili insidie. Le tecniche di interpretabilità non sono infallibili e, senza una buona comprensione del metodo, è molto probabile che tu fondi le tue supposizioni su premesse errate.
Un’analisi simile, ma significativamente più approfondita, è stata presentata nel seguente post sul blog dedicato alle importanze nelle random forest. La feature importance è spesso usata per determinare quali variabili svolgono un ruolo importante nelle previsioni del modello. Le random forest offrono un metodo pronto all’uso per individuare le feature più importanti nel dataset e molte persone fanno affidamento su queste importanze, interpretandole come una “spiegazione veritiera” del dataset.
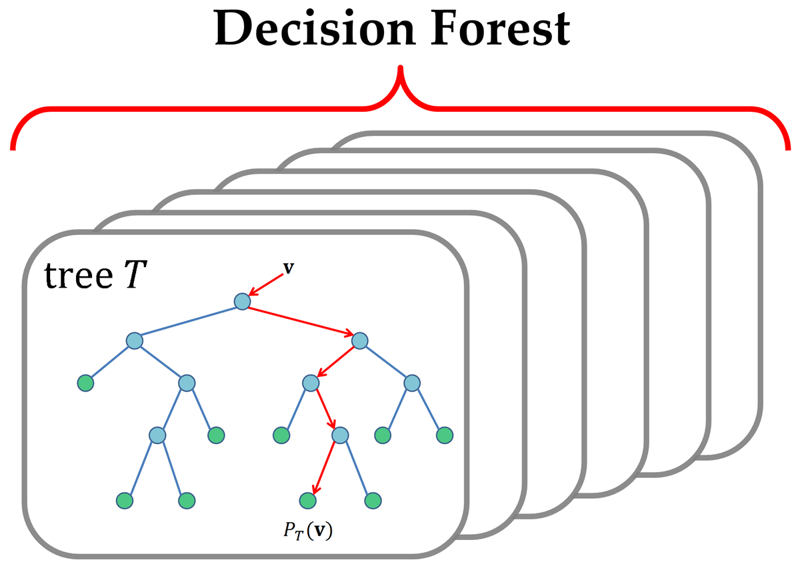 Un albero decisionale o una random forest è composta da più alberi decisionali. Analizzando quali feature sono usate per costruire gli alberi “migliori”, è possibile ottenere una stima della loro importanza. Fonte
Gli autori hanno analizzato due implementazioni di Random Forest (RF) e le misure standard di feature importance che forniscono. Dimostrano che la permutation importance offre stime più robuste quando le variabili sono fortemente correlate, rispetto alle importanze delle random forest. Consiglio vivamente di leggere il loro post per comprendere a fondo i risultati.
LIME
LIME è indipendente dal modello, il che significa che può essere applicato a qualsiasi modello di machine learning. La tecnica tenta di comprendere il modello perturbando l’input dei campioni di dati e osservando come cambiano le previsioni.
 LIME assume un modello di machine learning a scatola nera e indaga la relazione tra input e output rappresentata dal modello.
Gli approcci specifici del modello mirano a comprendere il modello a scatola nera analizzandone i componenti interni e il loro funzionamento. Nei modelli di deep learning, ad esempio, è possibile indagare le unità di attivazione e ricollegare le attivazioni interne all’input. Questo richiede una profonda comprensione della rete e non è generalizzabile ad altri modelli.
LIME fornisce interpretabilità locale del modello. LIME modifica un singolo campione di dati ritoccando i valori delle feature e osserva l’impatto risultante sull’output. Spesso questo è anche ciò che interessa agli esseri umani quando osservano l’output di un modello. La domanda più comune è probabilmente: perché è stata fatta questa previsione o quali variabili l’hanno causata?
Altre tecniche di interpretabilità rispondono alla domanda precedente solo dalla prospettiva dell’intero dataset. Le importanze delle feature spiegano, a livello di dataset, quali feature sono importanti. Ti permettono di verificare ipotesi e capire se il modello sta overfittando al rumore, ma è difficile diagnosticare previsioni specifiche del modello.
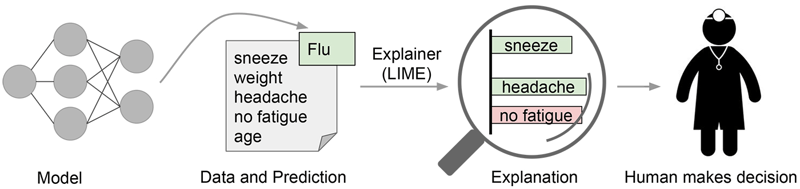 LIME cerca di svolgere il ruolo di “spiegatore”, fornendo spiegazioni per ogni campione di dati. Fonte
Intuizione alla base di LIME
Un requisito chiave per LIME è lavorare con una rappresentazione interpretabile dell’input, comprensibile agli esseri umani. Esempi di rappresentazioni interpretabili sono, ad esempio, un vettore BoW per l’NLP o un’immagine per la computer vision. Le embedding dense, invece, non sono interpretabili e applicare LIME probabilmente non ne migliorerà l’interpretabilità.
L’output di LIME è un elenco di spiegazioni che riflette il contributo di ciascuna feature alla previsione di un campione di dati. Questo fornisce interpretabilità locale e consente anche di determinare quali modifiche alle feature avranno il maggior impatto sulla previsione.
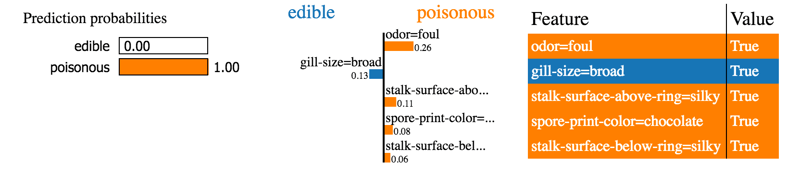 Un esempio di LIME applicato a un classico problema di classificazione. Fonte
Una spiegazione viene creata approssimando localmente il modello sottostante con uno interpretabile. Modelli interpretabili sono, ad esempio, modelli lineari con forte regolarizzazione, alberi decisionali, ecc. I modelli interpretabili vengono addestrati su piccole perturbazioni dell’istanza originale e dovrebbero fornire solo una buona approssimazione locale. Il “dataset” viene creato, per esempio, aggiungendo rumore alle feature continue, rimuovendo parole o nascondendo parti dell’immagine. Limitandosi ad approssimare la scatola nera localmente (nel vicinato del campione di dati) il compito è notevolmente semplificato.
Possibili insidie
Benché l’idea generale di LIME sembri semplice, ci sono alcuni potenziali svantaggi.
Nell’implementazione attuale si usano solo modelli lineari per approssimare il comportamento locale. Entro certi limiti, questa assunzione è corretta quando si guarda a una regione molto piccola attorno al campione. Espandendo però questa regione, è possibile che un modello lineare non sia abbastanza potente da spiegare il comportamento del modello originale. La non linearità a livello locale si verifica per quei dataset che richiedono modelli complessi e non interpretabili. Non poter applicare LIME in questi scenari è un’insidia significativa.
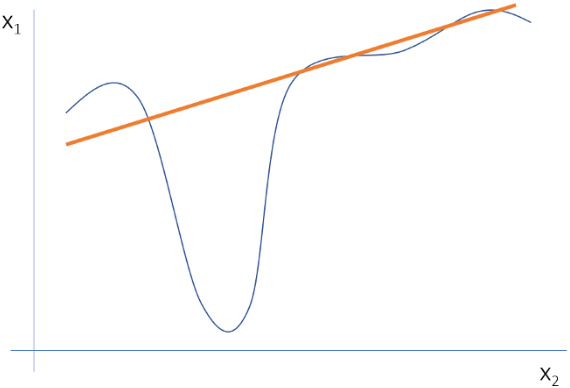 Una approssimazione lineare del comportamento locale per due feature non è una buona rappresentazione e non catturerà l’elevata non linearità del modello.
In secondo luogo, il tipo di modifiche da apportare ai dati per ottenere spiegazioni adeguate è in genere specifico del caso d’uso. Gli autori hanno fornito il seguente esempio nel loro articolo: per esempio, un modello che predice che le immagini in seppia siano “retrò” non può essere spiegato dalla presenza o assenza di superpixel.
Spesso, semplici perturbazioni non bastano. Idealmente, le perturbazioni dovrebbero essere guidate dalla variazione osservata nel dataset. Guidare manualmente le perturbazioni, invece, probabilmente non è una buona idea, perché introdurrebbe bias nelle spiegazioni del modello.
Conclusione
LIME è un ottimo strumento per spiegare cosa fanno i classificatori (o modelli) di machine learning. È indipendente dal modello, si basa su idee semplici e comprensibili e non richiede molto sforzo per essere eseguito. Come sempre, anche usando LIME è comunque importante interpretare correttamente l’output.
Se hai domande sull’interpretabilità nel machine learning, sarò felice di leggerle nei commenti. Seguimi su Medium o Twitter se vuoi ricevere aggiornamenti sui miei post!
Se ti interessa approfondire il modeling, segui il corso di DataCamp Statistical Modeling in R.



 Abid Ali Awan · 10 min

 Tim Lu · 12 min

Nel mio precedente post sull’interpretabilità dei modelli ho fornito una panoramica delle tecniche più comuni per analizzare i modelli di machine learning. In questo articolo, offrirò una spiegazione più approfondita di LIME.
Perché è necessario comprendere i metodi di interpretabilità?
Se affidi a una tecnica il compito di spiegare le previsioni del tuo modello, è importante capirne i meccanismi di base e le possibili insidie. Le tecniche di interpretabilità non sono infallibili e, senza una buona comprensione del metodo, è molto probabile che tu fondi le tue supposizioni su premesse errate.
Un’analisi simile, ma significativamente più approfondita, è stata presentata nel seguente post sul blog dedicato alle importanze nelle random forest. La feature importance è spesso usata per determinare quali variabili svolgono un ruolo importante nelle previsioni del modello. Le random forest offrono un metodo pronto all’uso per individuare le feature più importanti nel dataset e molte persone fanno affidamento su queste importanze, interpretandole come una “spiegazione veritiera” del dataset.
Gli autori hanno analizzato due implementazioni di Random Forest (RF) e le misure standard di feature importance che forniscono. Dimostrano che la permutation importance offre stime più robuste quando le variabili sono fortemente correlate, rispetto alle importanze delle random forest. Consiglio vivamente di leggere il loro post per comprendere a fondo i risultati.
LIME
LIME è indipendente dal modello, il che significa che può essere applicato a qualsiasi modello di machine learning. La tecnica tenta di comprendere il modello perturbando l’input dei campioni di dati e osservando come cambiano le previsioni.
Gli approcci specifici del modello mirano a comprendere il modello a scatola nera analizzandone i componenti interni e il loro funzionamento. Nei modelli di deep learning, ad esempio, è possibile indagare le unità di attivazione e ricollegare le attivazioni interne all’input. Questo richiede una profonda comprensione della rete e non è generalizzabile ad altri modelli.
LIME fornisce interpretabilità locale del modello. LIME modifica un singolo campione di dati ritoccando i valori delle feature e osserva l’impatto risultante sull’output. Spesso questo è anche ciò che interessa agli esseri umani quando osservano l’output di un modello. La domanda più comune è probabilmente: perché è stata fatta questa previsione o quali variabili l’hanno causata?
Altre tecniche di interpretabilità rispondono alla domanda precedente solo dalla prospettiva dell’intero dataset. Le importanze delle feature spiegano, a livello di dataset, quali feature sono importanti. Ti permettono di verificare ipotesi e capire se il modello sta overfittando al rumore, ma è difficile diagnosticare previsioni specifiche del modello.
Intuizione alla base di LIME
Un requisito chiave per LIME è lavorare con una rappresentazione interpretabile dell’input, comprensibile agli esseri umani. Esempi di rappresentazioni interpretabili sono, ad esempio, un vettore BoW per l’NLP o un’immagine per la computer vision. Le embedding dense, invece, non sono interpretabili e applicare LIME probabilmente non ne migliorerà l’interpretabilità.
L’output di LIME è un elenco di spiegazioni che riflette il contributo di ciascuna feature alla previsione di un campione di dati. Questo fornisce interpretabilità locale e consente anche di determinare quali modifiche alle feature avranno il maggior impatto sulla previsione.
Una spiegazione viene creata approssimando localmente il modello sottostante con uno interpretabile. Modelli interpretabili sono, ad esempio, modelli lineari con forte regolarizzazione, alberi decisionali, ecc. I modelli interpretabili vengono addestrati su piccole perturbazioni dell’istanza originale e dovrebbero fornire solo una buona approssimazione locale. Il “dataset” viene creato, per esempio, aggiungendo rumore alle feature continue, rimuovendo parole o nascondendo parti dell’immagine. Limitandosi ad approssimare la scatola nera localmente (nel vicinato del campione di dati) il compito è notevolmente semplificato.
Possibili insidie
Benché l’idea generale di LIME sembri semplice, ci sono alcuni potenziali svantaggi.
Nell’implementazione attuale si usano solo modelli lineari per approssimare il comportamento locale. Entro certi limiti, questa assunzione è corretta quando si guarda a una regione molto piccola attorno al campione. Espandendo però questa regione, è possibile che un modello lineare non sia abbastanza potente da spiegare il comportamento del modello originale. La non linearità a livello locale si verifica per quei dataset che richiedono modelli complessi e non interpretabili. Non poter applicare LIME in questi scenari è un’insidia significativa.
In secondo luogo, il tipo di modifiche da apportare ai dati per ottenere spiegazioni adeguate è in genere specifico del caso d’uso. Gli autori hanno fornito il seguente esempio nel loro articolo: per esempio, un modello che predice che le immagini in seppia siano “retrò” non può essere spiegato dalla presenza o assenza di superpixel.
Spesso, semplici perturbazioni non bastano. Idealmente, le perturbazioni dovrebbero essere guidate dalla variazione osservata nel dataset. Guidare manualmente le perturbazioni, invece, probabilmente non è una buona idea, perché introdurrebbe bias nelle spiegazioni del modello.
Conclusione
LIME è un ottimo strumento per spiegare cosa fanno i classificatori (o modelli) di machine learning. È indipendente dal modello, si basa su idee semplici e comprensibili e non richiede molto sforzo per essere eseguito. Come sempre, anche usando LIME è comunque importante interpretare correttamente l’output.
Se hai domande sull’interpretabilità nel machine learning, sarò felice di leggerle nei commenti. Seguimi su Medium o Twitter se vuoi ricevere aggiornamenti sui miei post!
Se ti interessa approfondire il modeling, segui il corso di DataCamp Statistical Modeling in R.