अपने पिछले मॉडल की व्याख्यात्मकता पर पोस्ट में, मैंने मशीन लर्निंग मॉडलों की जांच के लिए उपयोग की जाने वाली सामान्य तकनीकों का एक अवलोकन दिया था। इस ब्लॉग पोस्ट में, मैं LIME की अधिक विस्तृत व्याख्या दूंगा।
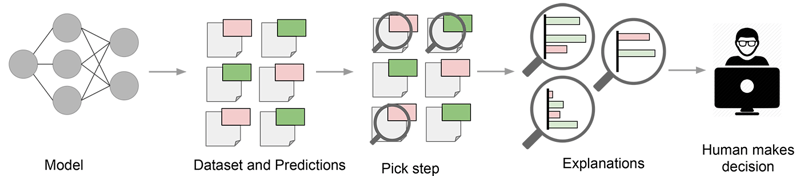 LIME डेटा सैंपल स्तर पर मॉडल की भविष्यवाणियों को समझाता है। यह अंतिम-उपयोगकर्ताओं को इन भविष्यवाणियों की व्याख्या करने और उनके आधार पर कार्रवाई करने की अनुमति देता है। स्रोत
व्याख्यात्मकता विधियों को समझना क्यों आवश्यक है?
यदि आप अपने मॉडल की भविष्यवाणियों को समझाने के लिए किसी तकनीक पर भरोसा करते हैं, तो उस तकनीक की मूल कार्यप्रणाली और उससे जुड़ी संभावित खामियों को समझना महत्वपूर्ण है। व्याख्यात्मकता तकनीकें त्रुटिरहित नहीं हैं, और विधि की अच्छी समझ के बिना, आप बहुत संभवतः गलत धारणाओं पर अपने निष्कर्ष आधारित कर देंगे।
इसी तरह की परंतु कहीं अधिक गहन जांच रैंडम फॉरेस्ट की फीचर इंपोर्टेंस पर निम्नलिखित ब्लॉग पोस्ट में की गई थी। फीचर इंपोर्टेंस का उपयोग अक्सर यह निर्धारित करने के लिए होता है कि कौन-से फीचर मॉडल की भविष्यवाणियों में महत्वपूर्ण भूमिका निभाते हैं। रैंडम फॉरेस्ट डेटासेट में सबसे महत्वपूर्ण फीचरों को निर्धारित करने की एक रेडी-टू-यूज़ विधि प्रदान करता है और बहुत से लोग इन फीचर इंपोर्टेंस को डेटासेट की ‘ग्राउंड ट्रुथ व्याख्या’ मानकर उन पर निर्भर करते हैं।
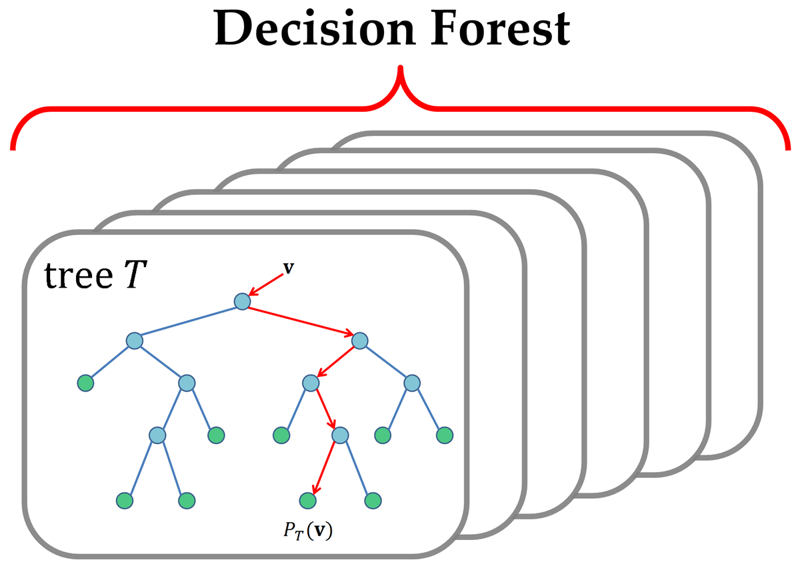 एक निर्णय वृक्ष या रैंडम फॉरेस्ट कई निर्णय वृक्षों से मिलकर बना होता है। जिन फीचरों का उपयोग ‘सबसे अच्छे’ वृक्षों को बनाने में होता है, उनकी जांच करके फीचर इंपोर्टेंस का अनुमान लगाया जा सकता है। स्रोत
लेखकों ने दो रैंडम फॉरेस्ट (RF) इम्प्लीमेंटेशन और उनके द्वारा प्रदान की जाने वाली मानक फीचर इंपोर्टेंस मापों की जांच की। लेखक दिखाते हैं कि जब वेरिएबल्स में मजबूत सह-संबंध होता है, तो परमीटेशन इंपोर्टेंस, रैंडम फॉरेस्ट इंपोर्टेंस की तुलना में अधिक मजबूत अनुमान देती है। उनके निष्कर्षों को अच्छी तरह समझने के लिए मैं उनका ब्लॉग पोस्ट पढ़ने की अत्यधिक अनुशंसा करता हूं।
LIME
LIME मॉडल-अज्ञेयवादी है, यानी इसे किसी भी मशीन लर्निंग मॉडल पर लागू किया जा सकता है। यह तकनीक डेटा सैंपल के इनपुट में बदलाव करके और यह समझकर कि भविष्यवाणियां कैसे बदलती हैं, मॉडल को समझने का प्रयास करती है।
 LIME एक ब्लैक बॉक्स मशीन लर्निंग मॉडल मानकर इनपुट और आउटपुट के बीच संबंध की जांच करता है, जो मॉडल द्वारा निरूपित होता है।
मॉडल-विशिष्ट तरीकों का उद्देश्य ब्लैक बॉक्स मशीन लर्निंग मॉडल को उसकी आंतरिक इकाइयों और उनके परस्पर क्रिया-कलाप का विश्लेषण करके समझना होता है। डीप लर्निंग मॉडलों में, उदाहरण के लिए, ऐक्टिवेशन यूनिट्स की जांच करना और आंतरिक ऐक्टिवेशन को इनपुट से जोड़ना संभव है। इसके लिए नेटवर्क की गहन समझ चाहिए होती है और यह अन्य मॉडलों पर स्केल नहीं होता।
LIME स्थानीय स्तर पर मॉडल की व्याख्यात्मकता प्रदान करता है। LIME एकल डेटा सैंपल को फीचर मानों में हल्का-फुल्का बदलाव करके संशोधित करता है और आउटपुट पर उसके प्रभाव का अवलोकन करता है। अक्सर, जब लोग किसी मॉडल का आउटपुट देखते हैं तो वे भी इसी तरह की बातों में रुचि रखते हैं। सबसे सामान्य प्रश्न संभवतः यह होता है: यह भविष्यवाणी क्यों की गई या किन वेरिएबल्स ने इस भविष्यवाणी को प्रभावित किया?
अन्य मॉडल-व्याख्यात्मकता तकनीकें ऊपर वाले प्रश्न का उत्तर प्रायः पूरे डेटासेट के परिप्रेक्ष्य से देती हैं। फीचर इंपोर्टेंस डेटासेट स्तर पर बताती है कि कौन-से फीचर महत्वपूर्ण हैं। यह आपको परिकल्पनाओं की जांच करने और यह देखने में मदद करती है कि कहीं मॉडल शोर पर तो ओवरफिट नहीं कर रहा, लेकिन विशिष्ट भविष्यवाणियों का निदान करना कठिन होता है।
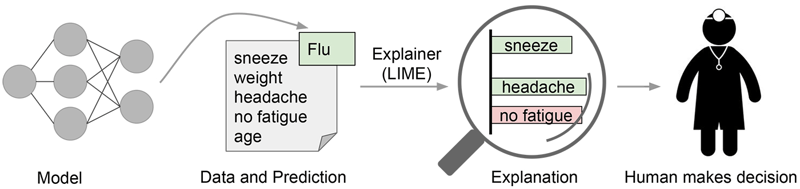 LIME ‘व्याख्याता’ की भूमिका निभाने का प्रयास करता है, प्रत्येक डेटा सैंपल के लिए भविष्यवाणियों को समझाते हुए। स्रोत
LIME के पीछे का सहज बोध
LIME के लिए एक प्रमुख आवश्यकता है कि इनपुट का एक ऐसी व्याख्यात्मक अभिव्यक्ति के साथ काम किया जाए जिसे मनुष्य समझ सकें। व्याख्यात्मक अभिव्यक्तियों के उदाहरण हैं, जैसे NLP के लिए BoW वेक्टर, या कंप्यूटर विज़न के लिए एक छवि। दूसरी ओर, घने एम्बेडिंग्स व्याख्यात्मक नहीं होते, और LIME लागू करने से उनकी व्याख्यात्मकता संभवतः नहीं बढ़ेगी।
LIME का आउटपुट व्याख्याओं की एक सूची होता है, जो किसी डेटा सैंपल की भविष्यवाणी में प्रत्येक फीचर के योगदान को दर्शाता है। यह स्थानीय व्याख्यात्मकता प्रदान करता है, और यह भी बताता है कि किन फीचरों में बदलाव का भविष्यवाणी पर सबसे अधिक प्रभाव पड़ेगा।
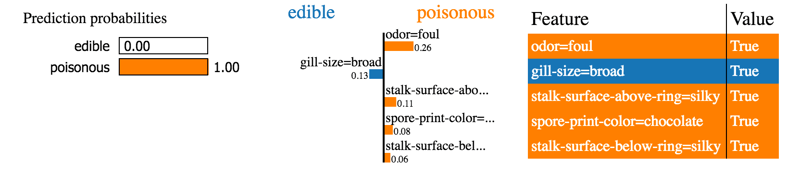 एक क्लासिक वर्गीकरण समस्या पर लागू LIME का उदाहरण। स्रोत
किसी व्याख्या का निर्माण, अंतर्निहित मॉडल का स्थानीय रूप से एक व्याख्यात्मक मॉडल से सन्निकटन करके किया जाता है। व्याख्यात्मक मॉडल जैसे कि प्रबल नियमितीकरण वाले रैखिक मॉडल, निर्णय वृक्ष, आदि। इन व्याख्यात्मक मॉडलों को मूल इंस्टेंस के छोटे-छोटे परिवर्तनों पर प्रशिक्षित किया जाता है और इन्हें केवल स्थानीय तौर पर अच्छा सन्निकटन देना चाहिए। ‘डेटासेट’ का निर्माण, जैसे सतत फीचरों में शोर जोड़ना, शब्द हटाना या छवि के हिस्सों को छिपाना, करके किया जाता है। ब्लैक बॉक्स का केवल स्थानीय (डेटा सैंपल के पड़ोस में) सन्निकटन करने से कार्य काफी सरल हो जाता है।
संभावित कठिनाइयाँ
हालांकि LIME का सामान्य विचार सरल लगता है, कुछ संभावित कमियाँ हैं।
वर्तमान इम्प्लीमेंटेशन में, स्थानीय व्यवहार का सन्निकटन करने के लिए केवल रैखिक मॉडलों का उपयोग होता है। एक हद तक, यह मान्यता तब सही बैठती है जब डेटा सैंपल के बहुत छोटे क्षेत्र पर देखा जाए। हालांकि, इस क्षेत्र का विस्तार करने पर संभव है कि रैखिक मॉडल मूल मॉडल के व्यवहार को समझाने के लिए पर्याप्त शक्तिशाली न हो। स्थानीय क्षेत्रों में गैर-रैखिकता उन डेटासेट्स में होती है जिनके लिए जटिल, अव्याख्यात्मक मॉडलों की आवश्यकता होती है। इन परिदृश्यों में LIME लागू न कर पाना एक महत्वपूर्ण कमी है।
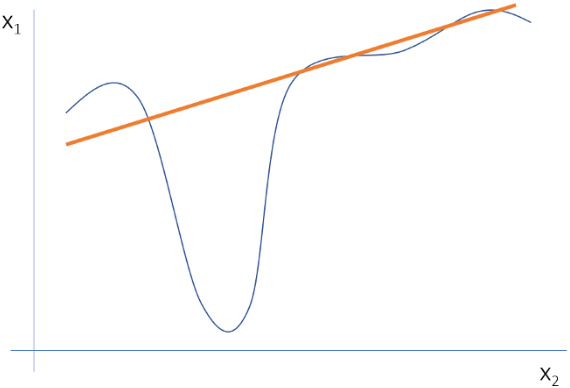 दो फीचरों के लिए स्थानीय व्यवहार का रैखिक सन्निकटन एक अच्छा निरूपण नहीं है और मॉडल के अत्यधिक गैर-रैखिक व्यवहार को पकड़ नहीं पाएगा।
दूसरे, उचित व्याख्याएँ पाने के लिए डेटा पर किए जाने वाले संशोधनों का प्रकार आमतौर पर उपयोग मामले-विशिष्ट होता है। लेखकों ने अपने पेपर में यह उदाहरण दिया: उदाहरण के लिए, जो मॉडल सेपिया-टोन वाली छवियों को रेट्रो बताता है, उसे सुपर-पिक्सल की उपस्थिति या अनुपस्थिति से समझाया नहीं जा सकता।
अक्सर, साधारण परिवर्तनों से काम नहीं चलता। आदर्श रूप से, परिवर्तनों को उस भिन्नता द्वारा संचालित होना चाहिए जो डेटासेट में देखी जाती है। दूसरी ओर, परिवर्तनों को मैनुअली निर्देशित करना शायद अच्छा विचार नहीं है, क्योंकि इससे मॉडल की व्याख्याओं में पक्षपात आने की संभावना रहती है।
निष्कर्ष
LIME यह समझाने का एक बढ़िया साधन है कि मशीन लर्निंग क्लासिफ़ायर्स (या मॉडल) क्या कर रहे हैं। यह मॉडल-अज्ञेयवादी है, सरल और समझने योग्य विचारों का उपयोग करता है, और चलाने में अधिक मेहनत नहीं लगती। हमेशा की तरह, LIME का उपयोग करते समय भी, आउटपुट की सही व्याख्या करना महत्वपूर्ण है।
यदि आपके पास मशीन लर्निंग में व्याख्यात्मकता पर कोई प्रश्न हैं, तो मुझे उन्हें टिप्पणियों में पढ़कर खुशी होगी। मेरे ब्लॉग पोस्ट के अपडेट पाने के लिए मुझे Medium या Twitter पर फ़ॉलो करें!
यदि आप मॉडलिंग के बारे में और सीखने में रुचि रखते हैं, तो DataCamp का Statistical Modeling in R कोर्स करें।


अपने पिछले मॉडल की व्याख्यात्मकता पर पोस्ट में, मैंने मशीन लर्निंग मॉडलों की जांच के लिए उपयोग की जाने वाली सामान्य तकनीकों का एक अवलोकन दिया था। इस ब्लॉग पोस्ट में, मैं LIME की अधिक विस्तृत व्याख्या दूंगा।
व्याख्यात्मकता विधियों को समझना क्यों आवश्यक है?
यदि आप अपने मॉडल की भविष्यवाणियों को समझाने के लिए किसी तकनीक पर भरोसा करते हैं, तो उस तकनीक की मूल कार्यप्रणाली और उससे जुड़ी संभावित खामियों को समझना महत्वपूर्ण है। व्याख्यात्मकता तकनीकें त्रुटिरहित नहीं हैं, और विधि की अच्छी समझ के बिना, आप बहुत संभवतः गलत धारणाओं पर अपने निष्कर्ष आधारित कर देंगे।
इसी तरह की परंतु कहीं अधिक गहन जांच रैंडम फॉरेस्ट की फीचर इंपोर्टेंस पर निम्नलिखित ब्लॉग पोस्ट में की गई थी। फीचर इंपोर्टेंस का उपयोग अक्सर यह निर्धारित करने के लिए होता है कि कौन-से फीचर मॉडल की भविष्यवाणियों में महत्वपूर्ण भूमिका निभाते हैं। रैंडम फॉरेस्ट डेटासेट में सबसे महत्वपूर्ण फीचरों को निर्धारित करने की एक रेडी-टू-यूज़ विधि प्रदान करता है और बहुत से लोग इन फीचर इंपोर्टेंस को डेटासेट की ‘ग्राउंड ट्रुथ व्याख्या’ मानकर उन पर निर्भर करते हैं।
लेखकों ने दो रैंडम फॉरेस्ट (RF) इम्प्लीमेंटेशन और उनके द्वारा प्रदान की जाने वाली मानक फीचर इंपोर्टेंस मापों की जांच की। लेखक दिखाते हैं कि जब वेरिएबल्स में मजबूत सह-संबंध होता है, तो परमीटेशन इंपोर्टेंस, रैंडम फॉरेस्ट इंपोर्टेंस की तुलना में अधिक मजबूत अनुमान देती है। उनके निष्कर्षों को अच्छी तरह समझने के लिए मैं उनका ब्लॉग पोस्ट पढ़ने की अत्यधिक अनुशंसा करता हूं।
LIME
LIME मॉडल-अज्ञेयवादी है, यानी इसे किसी भी मशीन लर्निंग मॉडल पर लागू किया जा सकता है। यह तकनीक डेटा सैंपल के इनपुट में बदलाव करके और यह समझकर कि भविष्यवाणियां कैसे बदलती हैं, मॉडल को समझने का प्रयास करती है।
मॉडल-विशिष्ट तरीकों का उद्देश्य ब्लैक बॉक्स मशीन लर्निंग मॉडल को उसकी आंतरिक इकाइयों और उनके परस्पर क्रिया-कलाप का विश्लेषण करके समझना होता है। डीप लर्निंग मॉडलों में, उदाहरण के लिए, ऐक्टिवेशन यूनिट्स की जांच करना और आंतरिक ऐक्टिवेशन को इनपुट से जोड़ना संभव है। इसके लिए नेटवर्क की गहन समझ चाहिए होती है और यह अन्य मॉडलों पर स्केल नहीं होता।
LIME स्थानीय स्तर पर मॉडल की व्याख्यात्मकता प्रदान करता है। LIME एकल डेटा सैंपल को फीचर मानों में हल्का-फुल्का बदलाव करके संशोधित करता है और आउटपुट पर उसके प्रभाव का अवलोकन करता है। अक्सर, जब लोग किसी मॉडल का आउटपुट देखते हैं तो वे भी इसी तरह की बातों में रुचि रखते हैं। सबसे सामान्य प्रश्न संभवतः यह होता है: यह भविष्यवाणी क्यों की गई या किन वेरिएबल्स ने इस भविष्यवाणी को प्रभावित किया?
अन्य मॉडल-व्याख्यात्मकता तकनीकें ऊपर वाले प्रश्न का उत्तर प्रायः पूरे डेटासेट के परिप्रेक्ष्य से देती हैं। फीचर इंपोर्टेंस डेटासेट स्तर पर बताती है कि कौन-से फीचर महत्वपूर्ण हैं। यह आपको परिकल्पनाओं की जांच करने और यह देखने में मदद करती है कि कहीं मॉडल शोर पर तो ओवरफिट नहीं कर रहा, लेकिन विशिष्ट भविष्यवाणियों का निदान करना कठिन होता है।
LIME के पीछे का सहज बोध
LIME के लिए एक प्रमुख आवश्यकता है कि इनपुट का एक ऐसी व्याख्यात्मक अभिव्यक्ति के साथ काम किया जाए जिसे मनुष्य समझ सकें। व्याख्यात्मक अभिव्यक्तियों के उदाहरण हैं, जैसे NLP के लिए BoW वेक्टर, या कंप्यूटर विज़न के लिए एक छवि। दूसरी ओर, घने एम्बेडिंग्स व्याख्यात्मक नहीं होते, और LIME लागू करने से उनकी व्याख्यात्मकता संभवतः नहीं बढ़ेगी।
LIME का आउटपुट व्याख्याओं की एक सूची होता है, जो किसी डेटा सैंपल की भविष्यवाणी में प्रत्येक फीचर के योगदान को दर्शाता है। यह स्थानीय व्याख्यात्मकता प्रदान करता है, और यह भी बताता है कि किन फीचरों में बदलाव का भविष्यवाणी पर सबसे अधिक प्रभाव पड़ेगा।
किसी व्याख्या का निर्माण, अंतर्निहित मॉडल का स्थानीय रूप से एक व्याख्यात्मक मॉडल से सन्निकटन करके किया जाता है। व्याख्यात्मक मॉडल जैसे कि प्रबल नियमितीकरण वाले रैखिक मॉडल, निर्णय वृक्ष, आदि। इन व्याख्यात्मक मॉडलों को मूल इंस्टेंस के छोटे-छोटे परिवर्तनों पर प्रशिक्षित किया जाता है और इन्हें केवल स्थानीय तौर पर अच्छा सन्निकटन देना चाहिए। ‘डेटासेट’ का निर्माण, जैसे सतत फीचरों में शोर जोड़ना, शब्द हटाना या छवि के हिस्सों को छिपाना, करके किया जाता है। ब्लैक बॉक्स का केवल स्थानीय (डेटा सैंपल के पड़ोस में) सन्निकटन करने से कार्य काफी सरल हो जाता है।
संभावित कठिनाइयाँ
हालांकि LIME का सामान्य विचार सरल लगता है, कुछ संभावित कमियाँ हैं।
वर्तमान इम्प्लीमेंटेशन में, स्थानीय व्यवहार का सन्निकटन करने के लिए केवल रैखिक मॉडलों का उपयोग होता है। एक हद तक, यह मान्यता तब सही बैठती है जब डेटा सैंपल के बहुत छोटे क्षेत्र पर देखा जाए। हालांकि, इस क्षेत्र का विस्तार करने पर संभव है कि रैखिक मॉडल मूल मॉडल के व्यवहार को समझाने के लिए पर्याप्त शक्तिशाली न हो। स्थानीय क्षेत्रों में गैर-रैखिकता उन डेटासेट्स में होती है जिनके लिए जटिल, अव्याख्यात्मक मॉडलों की आवश्यकता होती है। इन परिदृश्यों में LIME लागू न कर पाना एक महत्वपूर्ण कमी है।
दूसरे, उचित व्याख्याएँ पाने के लिए डेटा पर किए जाने वाले संशोधनों का प्रकार आमतौर पर उपयोग मामले-विशिष्ट होता है। लेखकों ने अपने पेपर में यह उदाहरण दिया: उदाहरण के लिए, जो मॉडल सेपिया-टोन वाली छवियों को रेट्रो बताता है, उसे सुपर-पिक्सल की उपस्थिति या अनुपस्थिति से समझाया नहीं जा सकता।
अक्सर, साधारण परिवर्तनों से काम नहीं चलता। आदर्श रूप से, परिवर्तनों को उस भिन्नता द्वारा संचालित होना चाहिए जो डेटासेट में देखी जाती है। दूसरी ओर, परिवर्तनों को मैनुअली निर्देशित करना शायद अच्छा विचार नहीं है, क्योंकि इससे मॉडल की व्याख्याओं में पक्षपात आने की संभावना रहती है।
निष्कर्ष
LIME यह समझाने का एक बढ़िया साधन है कि मशीन लर्निंग क्लासिफ़ायर्स (या मॉडल) क्या कर रहे हैं। यह मॉडल-अज्ञेयवादी है, सरल और समझने योग्य विचारों का उपयोग करता है, और चलाने में अधिक मेहनत नहीं लगती। हमेशा की तरह, LIME का उपयोग करते समय भी, आउटपुट की सही व्याख्या करना महत्वपूर्ण है।
यदि आपके पास मशीन लर्निंग में व्याख्यात्मकता पर कोई प्रश्न हैं, तो मुझे उन्हें टिप्पणियों में पढ़कर खुशी होगी। मेरे ब्लॉग पोस्ट के अपडेट पाने के लिए मुझे Medium या Twitter पर फ़ॉलो करें!
यदि आप मॉडलिंग के बारे में और सीखने में रुचि रखते हैं, तो DataCamp का Statistical Modeling in R कोर्स करें।