Cours
Comprendre le Machine Learning
2 h
308.2K
Dans mon précédent article sur l’interprétabilité des modèles, j’ai présenté un panorama des techniques courantes pour analyser les modèles d’apprentissage automatique. Dans ce billet, je vais proposer une explication plus approfondie de LIME.
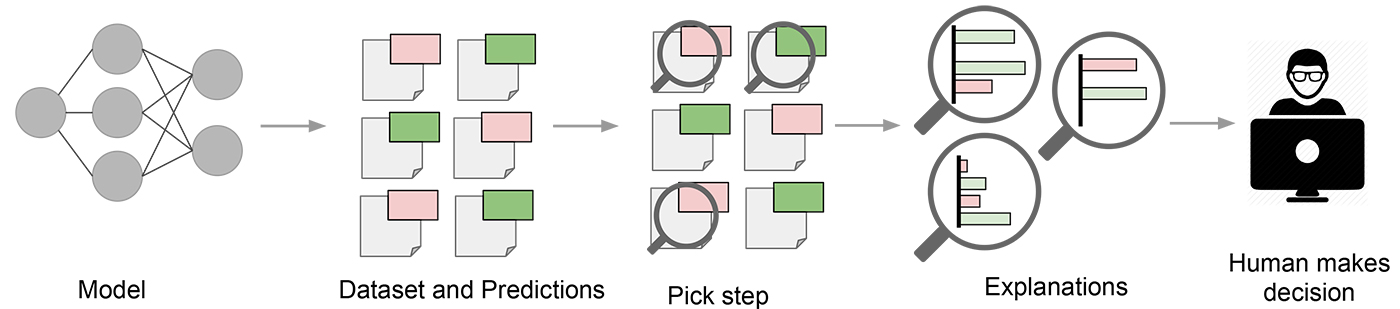
Si vous confiez à une technique le soin d’expliquer les prédictions de votre modèle, il est essentiel d’en comprendre les mécanismes sous-jacents ainsi que les écueils potentiels. Les techniques d’interprétabilité ne sont pas infaillibles et, sans une bonne compréhension de la méthode, vous risquez de fonder vos hypothèses sur des contre‑vérités.
Une investigation similaire, mais bien plus approfondie, a été menée dans l’article ci-dessous sur l’importance des variables dans les forêts aléatoires. L’importance des variables est souvent utilisée pour déterminer quelles caractéristiques jouent un rôle clé dans les prédictions du modèle. Les forêts aléatoires proposent une méthode prête à l’emploi pour identifier les variables les plus importantes du jeu de données, et beaucoup s’y fient en les interprétant comme une « vérité terrain » du jeu de données.
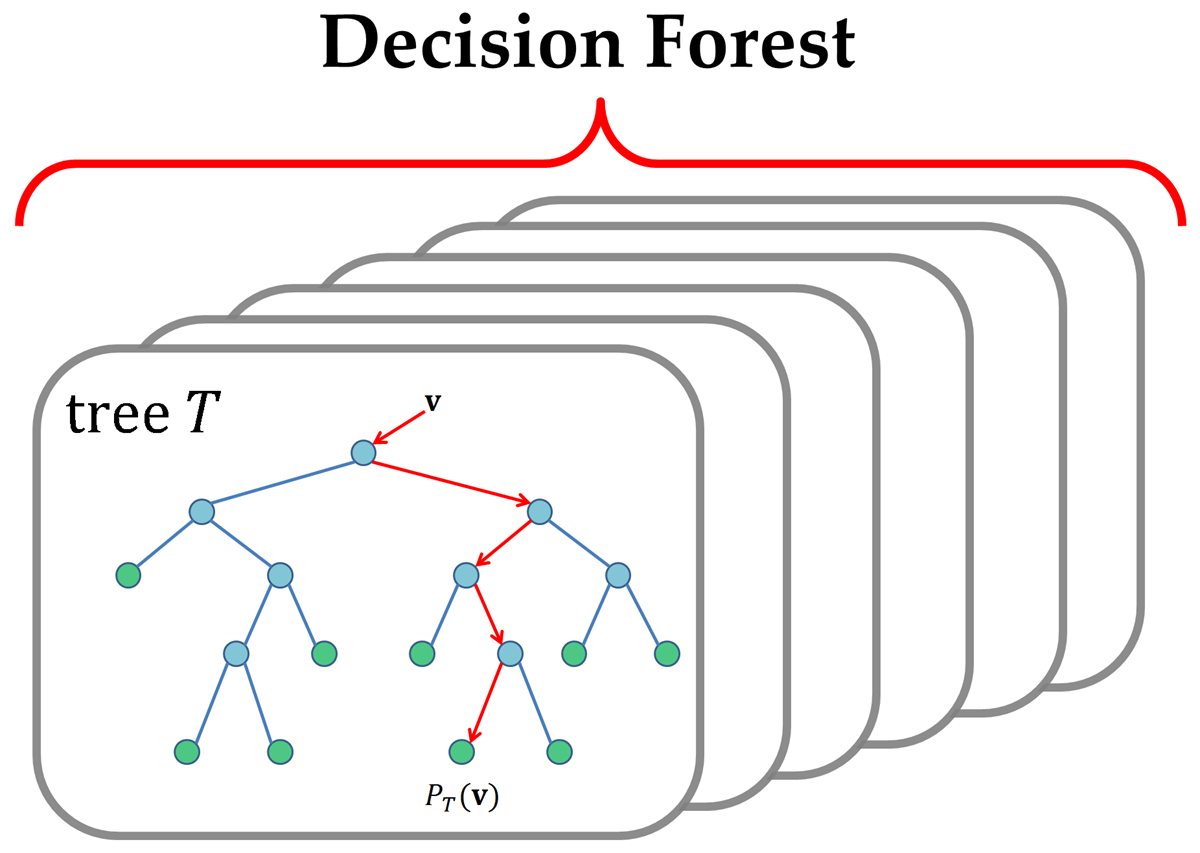
Les auteurs ont étudié deux implémentations de random forest (RF) et les mesures standard d’importance des variables qu’elles fournissent. Ils montrent que l’importance par permutation donne des estimations plus robustes lorsque des variables sont fortement corrélées, comparée aux importances issues des forêts aléatoires. Je vous recommande vivement de lire leur article pour une compréhension complète de leurs conclusions.
LIME est indépendant du modèle, ce qui signifie qu’il peut s’appliquer à tout modèle d’apprentissage automatique. La technique cherche à comprendre le modèle en perturbant l’entrée des échantillons de données et en observant comment les prédictions évoluent.
Les approches spécifiques à un modèle visent à comprendre la boîte noire en analysant ses composants internes et leurs interactions. Dans les réseaux de neurones, par exemple, on peut examiner les unités d’activation et relier certaines activations internes à l’entrée. Cela suppose une connaissance approfondie du réseau et ne se généralise pas facilement à d’autres modèles.
LIME fournit une interprétabilité locale. LIME modifie un seul échantillon en ajustant les valeurs de ses variables et observe l’impact sur la sortie. C’est souvent ce qui intéresse les humains lorsqu’ils examinent la sortie d’un modèle. La question la plus fréquente est sans doute : pourquoi cette prédiction a‑t‑elle été faite, ou quelles variables l’ont provoquée ?
D’autres techniques d’interprétabilité ne répondent à cette question qu’à l’échelle du jeu de données. Les importances de variables expliquent, au niveau global, quelles caractéristiques comptent. Cela permet de valider des hypothèses et de vérifier si le modèle surapprend le bruit, mais il est difficile de diagnostiquer des prédictions particulières.
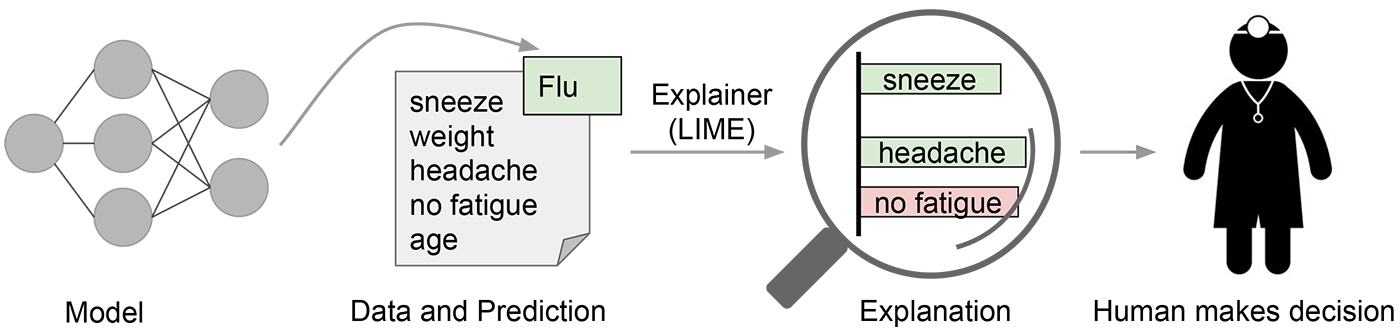
Une exigence clé de LIME est de travailler avec une représentation interprétable de l’entrée, compréhensible par des humains. Exemples de représentations interprétables : un vecteur BoW pour le TALN, ou une image en vision par ordinateur. À l’inverse, des plongements denses ne sont pas interprétables, et appliquer LIME n’améliorera probablement pas l’interprétabilité.
La sortie de LIME est une liste d’explications qui reflètent la contribution de chaque variable à la prédiction d’un échantillon. Cela apporte une interprétabilité locale et permet aussi d’identifier quelles modifications de variables auront le plus d’impact sur la prédiction.
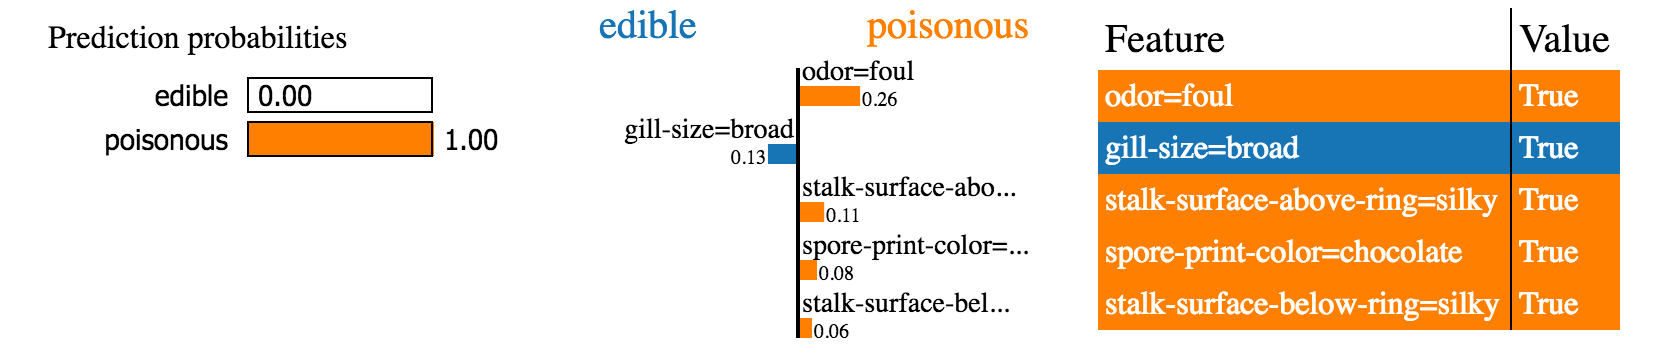
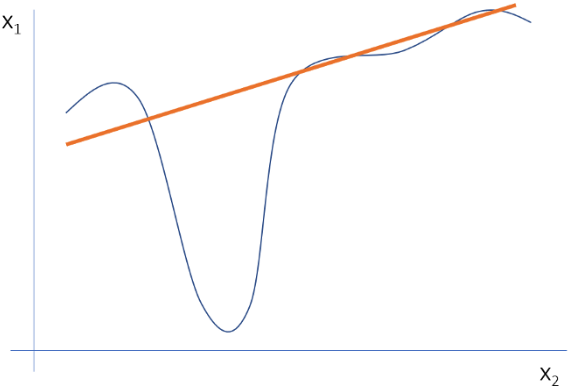
Une explication est produite en approximant localement le modèle sous‑jacent par un modèle interprétable. Les modèles interprétables sont par exemple des modèles linéaires fortement régularisés, des arbres de décision, etc. Ces modèles interprétables sont entraînés sur de petites perturbations de l’instance d’origine et ne doivent fournir qu’une bonne approximation locale. Le « jeu de données » est créé, par exemple, en ajoutant du bruit aux variables continues, en supprimant des mots ou en masquant des parties de l’image. En n’approximent la boîte noire que localement (dans le voisinage de l’échantillon), la tâche est considérablement simplifiée.
Même si l’idée générale de LIME semble simple, elle présente quelques limites.
Dans l’implémentation actuelle, seuls des modèles linéaires sont utilisés pour approximer le comportement local. Jusqu’à un certain point, cette hypothèse est valable sur une région très restreinte autour de l’échantillon. En élargissant cette région, il est possible qu’un modèle linéaire ne soit pas assez expressif pour expliquer le comportement du modèle d’origine. La non‑linéarité locale est fréquente pour les jeux de données qui exigent des modèles complexes et peu interprétables. L’impossibilité d’appliquer LIME dans ces situations constitue un écueil important.
Deuxièmement, le type de modifications à appliquer aux données pour obtenir de bonnes explications dépend souvent du cas d’usage. Les auteurs donnent l’exemple suivant dans leur article : un modèle qui prédit que des images sépia sont « rétro » ne peut pas être expliqué par la simple présence ou absence de super‑pixels.
Souvent, de simples perturbations ne suffisent pas. Idéalement, les perturbations devraient refléter la variabilité observée dans le jeu de données. Les piloter manuellement n’est sans doute pas une bonne idée, car cela introduirait probablement des biais dans les explications produites.
LIME est un excellent outil pour expliquer le comportement des classificateurs (ou modèles) en apprentissage automatique. Il est indépendant du modèle, s’appuie sur des idées simples et compréhensibles, et se met en œuvre sans effort démesuré. Comme toujours, même avec LIME, il reste essentiel d’interpréter correctement la sortie.
Si vous avez des questions sur l’interprétabilité en apprentissage automatique, je serai ravi de les lire dans les commentaires. Suivez‑moi sur Medium ou Twitter pour être informé de mes prochains articles !
Si vous souhaitez aller plus loin sur la modélisation, suivez le cours de DataCamp Statistical Modeling in R.
Aller plus loin en machine learning
Cours
Cours
Cours