Curso
Comprender el machine learning
2 h
308K
En mi artículo anterior sobre interpretabilidad de modelos hice un repaso de las técnicas más comunes para investigar modelos de machine learning. En esta entrada voy a explicar con más detalle LIME.
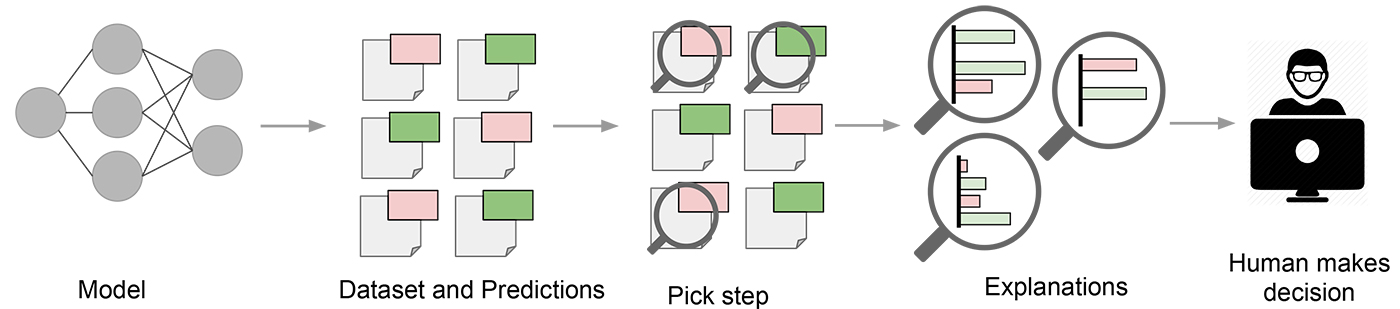
Si confías en una técnica para explicar las predicciones de tu modelo, es importante comprender bien su mecánica y las posibles trampas que conlleva. Las técnicas de interpretabilidad no son infalibles y, sin un buen entendimiento del método, es fácil basar tus conclusiones en premisas erróneas.
Un análisis similar, pero mucho más exhaustivo, se publicó en el siguiente artículo sobre la importancia de variables en random forests. La importancia de variables se usa a menudo para determinar qué características influyen más en las predicciones del modelo. Los random forests ofrecen un método listo para usar para estimar las variables más importantes del conjunto de datos, y mucha gente se apoya en estas importancias interpretándolas como una «explicación veraz» del dataset.
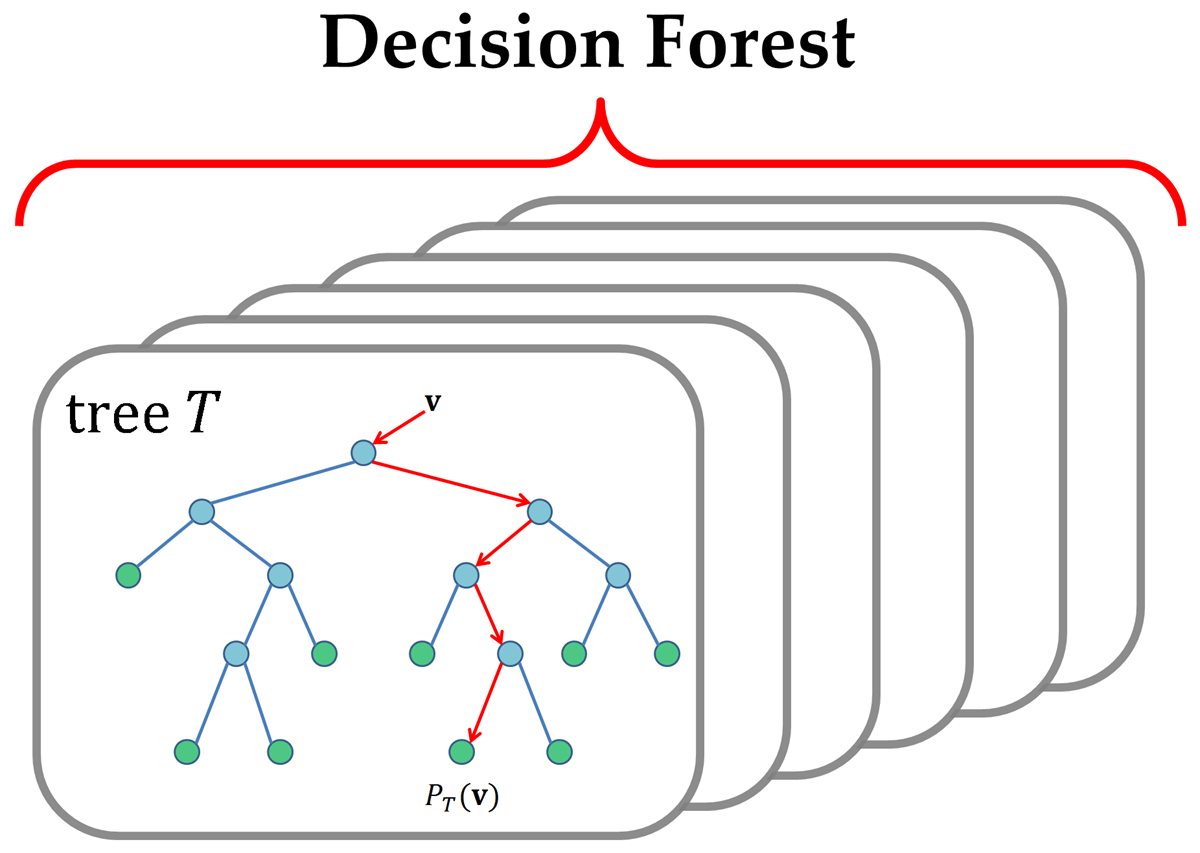
Los autores investigaron dos implementaciones de random forest (RF) y las medidas estándar de importancia de variables que proporcionan. Demuestran que la importancia por permutación ofrece estimaciones más robustas cuando hay variables fuertemente correlacionadas, en comparación con las importancias típicas de random forest. Te recomiendo leer su artículo para entender bien las conclusiones.
LIME es independiente del modelo: puede aplicarse a cualquier modelo de machine learning. La técnica busca entender el modelo perturbando la entrada de muestras y observando cómo cambian las predicciones.
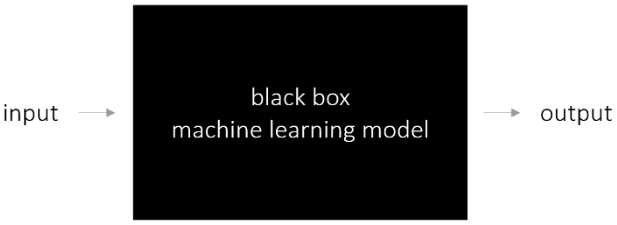
Los enfoques específicos de modelo intentan comprender la caja negra analizando sus componentes internos y cómo interactúan. En modelos de deep learning, por ejemplo, es posible estudiar unidades de activación y vincular activaciones internas con la entrada. Esto requiere un conocimiento profundo de la red y no se traslada bien a otros modelos.
LIME ofrece interpretabilidad local del modelo. Modifica una única muestra ajustando los valores de sus variables y observa el impacto resultante en la salida. A menudo esto encaja con lo que las personas quieren saber al ver la salida de un modelo. La pregunta más común suele ser: ¿por qué se ha hecho esta predicción o qué variables la han provocado?
Otras técnicas de interpretabilidad responden a esa pregunta, pero desde la perspectiva de todo el conjunto de datos. Las importancias de variables explican a nivel de dataset qué características son relevantes. Sirve para contrastar hipótesis y detectar si el modelo está sobreajustando al ruido, pero es difícil diagnosticar predicciones concretas.
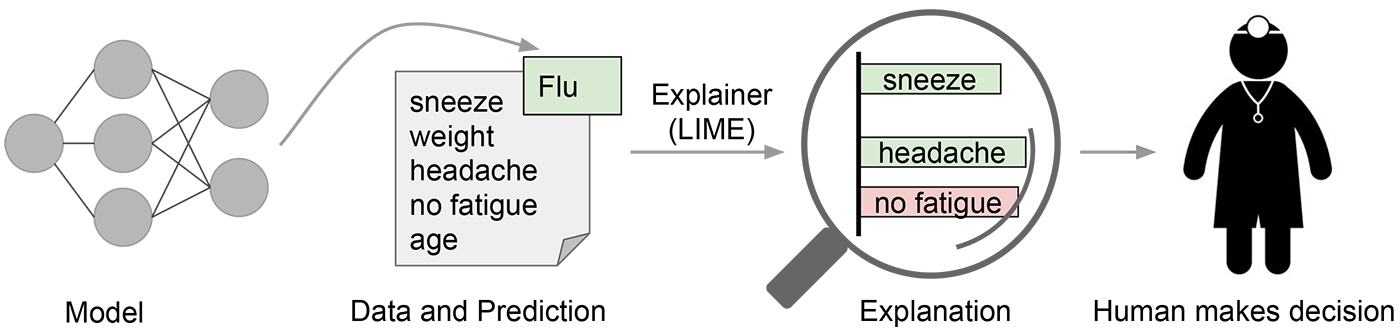
Un requisito clave de LIME es trabajar con una representación interpretable de la entrada, comprensible para las personas. Ejemplos de representaciones interpretables son, por ejemplo, un vector BoW en NLP o una imagen en visión por computador. En cambio, las incrustaciones densas no son interpretables y aplicar LIME probablemente no mejorará la interpretabilidad.
La salida de LIME es una lista de explicaciones que refleja la contribución de cada variable a la predicción de una muestra. Esto proporciona interpretabilidad local y permite identificar qué cambios en las variables tendrán mayor impacto en la predicción.
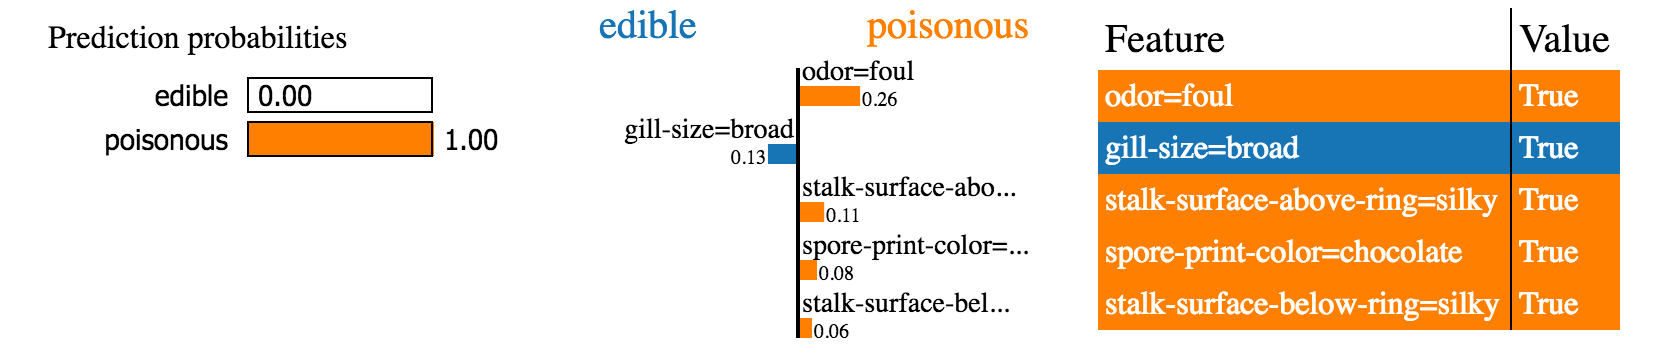
La explicación se crea aproximando localmente el modelo subyacente con otro interpretable. Entre los modelos interpretables están, por ejemplo, los modelos lineales con regularización fuerte, los árboles de decisión, etc. Estos modelos interpretables se entrenan con pequeñas perturbaciones de la instancia original y solo deben dar una buena aproximación local. El «conjunto de datos» se genera, por ejemplo, añadiendo ruido a variables continuas, eliminando palabras o ocultando partes de la imagen. Al aproximar la caja negra solo de forma local (en el vecindario de la muestra), la tarea se simplifica mucho.
Aunque la idea general de LIME es sencilla, presenta varios inconvenientes potenciales.
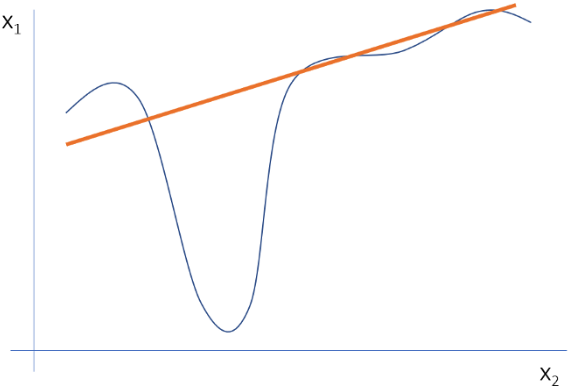
En la implementación actual, solo se usan modelos lineales para aproximar el comportamiento local. Hasta cierto punto, esta suposición es válida si miramos una región muy pequeña alrededor de la muestra. Sin embargo, al ampliar esa región, es posible que un modelo lineal no sea lo bastante potente para explicar el comportamiento del modelo original. La no linealidad local aparece en datasets que requieren modelos complejos y poco interpretables. No poder aplicar LIME en estos escenarios es una limitación importante.
En segundo lugar, el tipo de modificaciones necesarias sobre los datos para obtener explicaciones adecuadas suele ser específico del caso de uso. Los autores ponen este ejemplo en su artículo: un modelo que predice que las imágenes en tonos sepia son retro no puede explicarse por la presencia o ausencia de superpíxeles.
A menudo, las perturbaciones simples no bastan. Lo ideal sería que las perturbaciones estuvieran guiadas por la variación observada en el dataset. En cambio, dirigirlas manualmente probablemente no sea buena idea, ya que introduciría sesgos en las explicaciones.
LIME es una gran herramienta para explicar qué hacen los clasificadores (o modelos) de machine learning. Es independiente del modelo, se apoya en ideas sencillas y comprensibles y no requiere mucho esfuerzo para ejecutarse. Como siempre, incluso usando LIME, sigue siendo clave interpretar correctamente la salida.
Si tienes preguntas sobre interpretabilidad en machine learning, estaré encantado de leerte en los comentarios. Sígueme en Medium o en Twitter si quieres recibir novedades sobre mis publicaciones.
Si te interesa aprender más sobre modelado, haz el curso de DataCamp Statistical Modeling in R.
Aprende más sobre machine learning
Curso
Curso
Curso
blog
Natassha Selvaraj
15 min
blog
Zoumana Keita
14 min
blog
Matt Crabtree
14 min
Tutorial
Zoumana Keita
12 min
Tutorial
Abid Ali Awan
9 min
Tutorial
Thushan Ganegedara
15 min





