Trong bài viết trước về khả năng diễn giải mô hình, tôi đã giới thiệu tổng quan về các kỹ thuật phổ biến dùng để khảo sát mô hình học máy. Trong bài viết này, tôi sẽ giải thích chi tiết hơn về LIME.
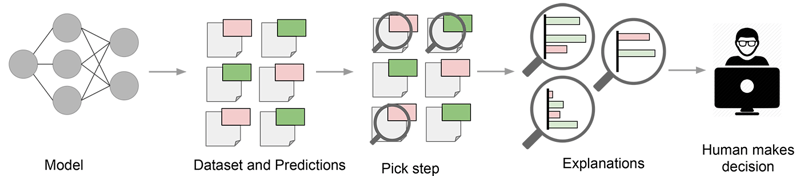 LIME giải thích dự đoán của mô hình ở cấp độ mẫu dữ liệu. Nó cho phép người dùng cuối diễn giải các dự đoán này và đưa ra hành động dựa trên đó. Nguồn
Vì sao cần hiểu các phương pháp diễn giải?
Nếu bạn tin tưởng một kỹ thuật để giải thích các dự đoán của mô hình, điều quan trọng là phải hiểu cơ chế nền tảng của kỹ thuật đó và các rủi ro tiềm ẩn đi kèm. Các kỹ thuật diễn giải không hề hoàn hảo, và nếu không hiểu rõ phương pháp, bạn rất dễ dựa trên những giả định sai lệch.
Một nghiên cứu tương tự nhưng sâu hơn nhiều đã được trình bày trong bài viết sau về tầm quan trọng của rừng ngẫu nhiên. Tầm quan trọng của đặc trưng thường được dùng để xác định những đặc trưng nào đóng vai trò quan trọng trong dự đoán của mô hình. Rừng ngẫu nhiên cung cấp một phương pháp có sẵn để xác định các đặc trưng quan trọng nhất trong tập dữ liệu và nhiều người dựa vào các chỉ số tầm quan trọng này, diễn giải chúng như một “lời giải thích chân lý” của tập dữ liệu.
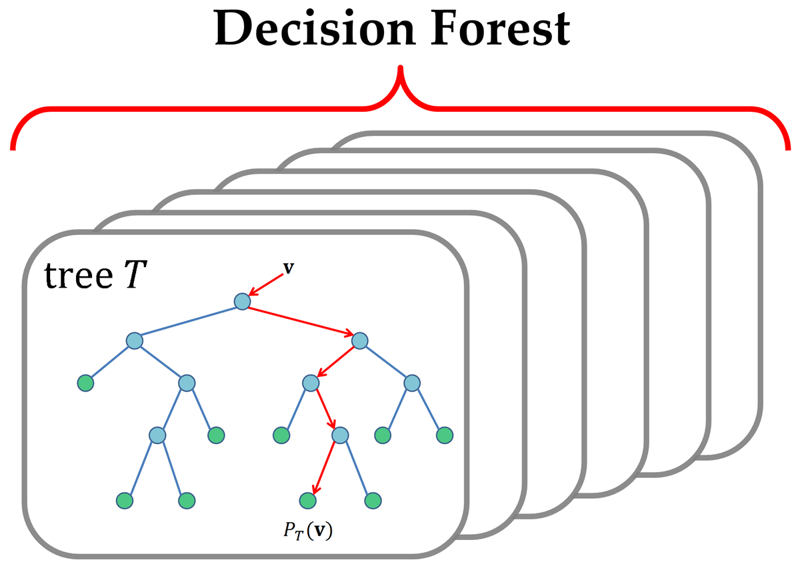 Một rừng quyết định hay rừng ngẫu nhiên gồm nhiều cây quyết định. Bằng cách xem xét các đặc trưng được dùng để xây dựng những cây “tốt” nhất, ta có thể ước lượng tầm quan trọng của đặc trưng. Nguồn
Các tác giả đã khảo sát hai triển khai rừng ngẫu nhiên (RF) và các thước đo tầm quan trọng đặc trưng tiêu chuẩn mà chúng cung cấp. Họ chỉ ra rằng tầm quan trọng theo hoán vị cho ước lượng vững hơn khi các biến có tương quan mạnh, so với các chỉ số tầm quan trọng của rừng ngẫu nhiên. Tôi rất khuyến nghị đọc bài viết của họ để hiểu thấu đáo các phát hiện này.
LIME
LIME không phụ thuộc mô hình, tức có thể áp dụng cho bất kỳ mô hình học máy nào. Kỹ thuật này cố gắng hiểu mô hình bằng cách gây nhiễu đầu vào của các mẫu dữ liệu và quan sát cách dự đoán thay đổi.
 LIME giả định một mô hình học máy hộp đen và khảo sát mối quan hệ giữa đầu vào và đầu ra do mô hình thể hiện.
Các cách tiếp cận đặc thù mô hình nhằm hiểu mô hình học máy hộp đen bằng cách phân tích các thành phần bên trong và cách chúng tương tác. Trong các mô hình học sâu, ví dụ có thể khảo sát các đơn vị kích hoạt và liên kết kích hoạt nội bộ trở lại đầu vào. Điều này đòi hỏi hiểu biết sâu về mạng và không dễ mở rộng sang các mô hình khác.
LIME cung cấp khả năng diễn giải cục bộ. LIME sửa đổi một mẫu dữ liệu bằng cách điều chỉnh các giá trị đặc trưng và quan sát tác động lên đầu ra. Thường thì đây cũng là điều con người quan tâm khi xem kết quả của một mô hình. Câu hỏi phổ biến nhất có lẽ là: vì sao dự đoán này được đưa ra hoặc những biến nào đã khiến dự đoán như vậy?
Các kỹ thuật diễn giải mô hình khác chỉ trả lời câu hỏi trên từ góc độ toàn bộ tập dữ liệu. Các chỉ số tầm quan trọng của đặc trưng giải thích ở cấp độ tập dữ liệu những đặc trưng nào là quan trọng. Chúng cho phép bạn kiểm chứng giả thuyết và liệu mô hình có đang khớp quá mức với nhiễu hay không, nhưng lại khó chẩn đoán các dự đoán cụ thể của mô hình.
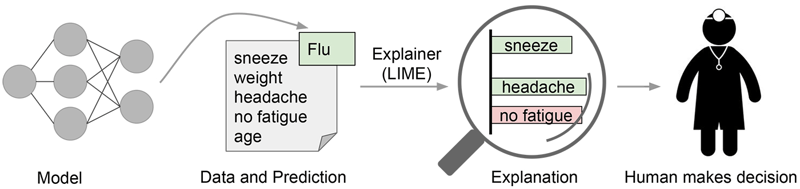 LIME cố gắng đóng vai trò “người giải thích”, giải thích dự đoán cho từng mẫu dữ liệu. Nguồn
Trực giác đằng sau LIME
Một yêu cầu then chốt của LIME là làm việc với một biểu diễn đầu vào có thể diễn giải và con người hiểu được. Ví dụ về biểu diễn có thể diễn giải gồm vector BoW cho NLP hoặc một bức ảnh trong thị giác máy tính. Ngược lại, các embedding đặc dày thì không thể diễn giải và áp dụng LIME có lẽ sẽ không cải thiện khả năng diễn giải.
Đầu ra của LIME là một danh sách lời giải thích, phản ánh mức đóng góp của từng đặc trưng vào dự đoán của một mẫu dữ liệu. Điều này cung cấp khả năng diễn giải cục bộ, đồng thời cho phép xác định những thay đổi ở đặc trưng nào sẽ tác động lớn nhất đến dự đoán.
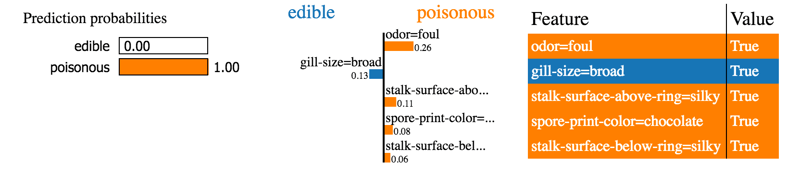 Một ví dụ LIME áp dụng cho bài toán phân loại kinh điển. Nguồn
Một lời giải thích được tạo ra bằng cách xấp xỉ cục bộ mô hình nền bằng một mô hình có thể diễn giải. Các mô hình có thể diễn giải ví dụ như mô hình tuyến tính với chuẩn hóa mạnh, cây quyết định, v.v. Các mô hình này được huấn luyện trên các nhiễu loạn nhỏ của thể hiện gốc và chỉ cần cho xấp xỉ tốt ở phạm vi cục bộ. “Tập dữ liệu” được tạo bằng cách thêm nhiễu vào đặc trưng liên tục, loại bỏ từ hoặc che khuất các phần của ảnh. Chỉ xấp xỉ mô hình hộp đen ở khu vực lân cận mẫu dữ liệu giúp nhiệm vụ đơn giản đi đáng kể.
Những cạm bẫy tiềm ẩn
Mặc dù ý tưởng tổng quát của LIME nghe có vẻ đơn giản, vẫn có một vài hạn chế tiềm ẩn.
Trong hiện thực triển khai hiện tại, chỉ các mô hình tuyến tính được dùng để xấp xỉ hành vi cục bộ. Ở một mức độ nào đó, giả định này đúng khi nhìn vào vùng rất nhỏ quanh mẫu dữ liệu. Tuy nhiên, khi mở rộng vùng này, có thể mô hình tuyến tính sẽ không đủ mạnh để giải thích hành vi của mô hình gốc. Tính phi tuyến ở vùng cục bộ xuất hiện với những tập dữ liệu đòi hỏi các mô hình phức tạp, khó diễn giải. Không thể áp dụng LIME trong các kịch bản như vậy là một hạn chế đáng kể.
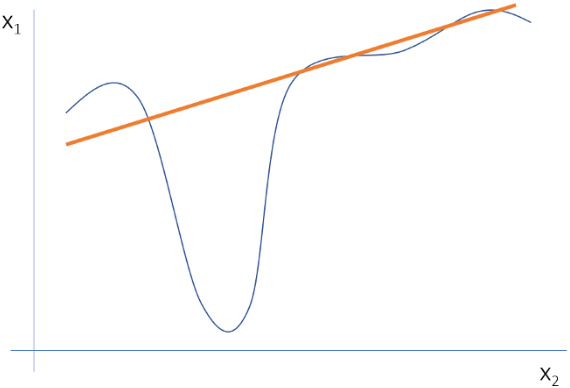 Một xấp xỉ tuyến tính của hành vi cục bộ với hai đặc trưng không phải là biểu diễn tốt và sẽ không nắm bắt được hành vi phi tuyến mạnh của mô hình.
Thứ hai, kiểu sửa đổi cần thực hiện trên dữ liệu để có lời giải thích phù hợp thường phụ thuộc vào bài toán. Các tác giả đã nêu ví dụ trong bài báo của họ: chẳng hạn, một mô hình dự đoán ảnh tông màu sepia là “retro” thì không thể được giải thích bằng sự hiện diện hay vắng mặt của các siêu điểm ảnh.
Thường thì các nhiễu loạn đơn giản là chưa đủ. Lý tưởng nhất, các nhiễu loạn nên được dẫn dắt bởi biến thiên quan sát được trong tập dữ liệu. Tự tay điều khiển các nhiễu loạn rất có thể không phải ý hay, vì khả năng lớn sẽ đưa thiên lệch vào lời giải thích của mô hình.
Kết luận
LIME là công cụ tuyệt vời để giải thích những gì các bộ phân loại (hoặc mô hình) học máy đang làm. Nó không phụ thuộc mô hình, dựa trên các ý tưởng đơn giản và dễ hiểu, và không đòi hỏi nhiều công sức để chạy. Như mọi khi, ngay cả khi dùng LIME, việc diễn giải đúng đầu ra vẫn rất quan trọng.
Nếu bạn có bất kỳ câu hỏi nào về khả năng diễn giải trong học máy, tôi rất vui được đọc chúng trong phần bình luận. Theo dõi tôi trên Medium hoặc Twitter nếu bạn muốn nhận cập nhật về các bài viết của tôi!
Nếu bạn quan tâm học thêm về mô hình hóa, hãy học khóa Statistical Modeling in R của DataCamp.


 Matt Crabtree · 10 min
Trong bài viết trước về khả năng diễn giải mô hình, tôi đã giới thiệu tổng quan về các kỹ thuật phổ biến dùng để khảo sát mô hình học máy. Trong bài viết này, tôi sẽ giải thích chi tiết hơn về LIME.
Vì sao cần hiểu các phương pháp diễn giải?
Nếu bạn tin tưởng một kỹ thuật để giải thích các dự đoán của mô hình, điều quan trọng là phải hiểu cơ chế nền tảng của kỹ thuật đó và các rủi ro tiềm ẩn đi kèm. Các kỹ thuật diễn giải không hề hoàn hảo, và nếu không hiểu rõ phương pháp, bạn rất dễ dựa trên những giả định sai lệch.
Một nghiên cứu tương tự nhưng sâu hơn nhiều đã được trình bày trong bài viết sau về tầm quan trọng của rừng ngẫu nhiên. Tầm quan trọng của đặc trưng thường được dùng để xác định những đặc trưng nào đóng vai trò quan trọng trong dự đoán của mô hình. Rừng ngẫu nhiên cung cấp một phương pháp có sẵn để xác định các đặc trưng quan trọng nhất trong tập dữ liệu và nhiều người dựa vào các chỉ số tầm quan trọng này, diễn giải chúng như một “lời giải thích chân lý” của tập dữ liệu.
Các tác giả đã khảo sát hai triển khai rừng ngẫu nhiên (RF) và các thước đo tầm quan trọng đặc trưng tiêu chuẩn mà chúng cung cấp. Họ chỉ ra rằng tầm quan trọng theo hoán vị cho ước lượng vững hơn khi các biến có tương quan mạnh, so với các chỉ số tầm quan trọng của rừng ngẫu nhiên. Tôi rất khuyến nghị đọc bài viết của họ để hiểu thấu đáo các phát hiện này.
LIME
LIME không phụ thuộc mô hình, tức có thể áp dụng cho bất kỳ mô hình học máy nào. Kỹ thuật này cố gắng hiểu mô hình bằng cách gây nhiễu đầu vào của các mẫu dữ liệu và quan sát cách dự đoán thay đổi.
Các cách tiếp cận đặc thù mô hình nhằm hiểu mô hình học máy hộp đen bằng cách phân tích các thành phần bên trong và cách chúng tương tác. Trong các mô hình học sâu, ví dụ có thể khảo sát các đơn vị kích hoạt và liên kết kích hoạt nội bộ trở lại đầu vào. Điều này đòi hỏi hiểu biết sâu về mạng và không dễ mở rộng sang các mô hình khác.
LIME cung cấp khả năng diễn giải cục bộ. LIME sửa đổi một mẫu dữ liệu bằng cách điều chỉnh các giá trị đặc trưng và quan sát tác động lên đầu ra. Thường thì đây cũng là điều con người quan tâm khi xem kết quả của một mô hình. Câu hỏi phổ biến nhất có lẽ là: vì sao dự đoán này được đưa ra hoặc những biến nào đã khiến dự đoán như vậy?
Các kỹ thuật diễn giải mô hình khác chỉ trả lời câu hỏi trên từ góc độ toàn bộ tập dữ liệu. Các chỉ số tầm quan trọng của đặc trưng giải thích ở cấp độ tập dữ liệu những đặc trưng nào là quan trọng. Chúng cho phép bạn kiểm chứng giả thuyết và liệu mô hình có đang khớp quá mức với nhiễu hay không, nhưng lại khó chẩn đoán các dự đoán cụ thể của mô hình.
Trực giác đằng sau LIME
Một yêu cầu then chốt của LIME là làm việc với một biểu diễn đầu vào có thể diễn giải và con người hiểu được. Ví dụ về biểu diễn có thể diễn giải gồm vector BoW cho NLP hoặc một bức ảnh trong thị giác máy tính. Ngược lại, các embedding đặc dày thì không thể diễn giải và áp dụng LIME có lẽ sẽ không cải thiện khả năng diễn giải.
Đầu ra của LIME là một danh sách lời giải thích, phản ánh mức đóng góp của từng đặc trưng vào dự đoán của một mẫu dữ liệu. Điều này cung cấp khả năng diễn giải cục bộ, đồng thời cho phép xác định những thay đổi ở đặc trưng nào sẽ tác động lớn nhất đến dự đoán.
Một lời giải thích được tạo ra bằng cách xấp xỉ cục bộ mô hình nền bằng một mô hình có thể diễn giải. Các mô hình có thể diễn giải ví dụ như mô hình tuyến tính với chuẩn hóa mạnh, cây quyết định, v.v. Các mô hình này được huấn luyện trên các nhiễu loạn nhỏ của thể hiện gốc và chỉ cần cho xấp xỉ tốt ở phạm vi cục bộ. “Tập dữ liệu” được tạo bằng cách thêm nhiễu vào đặc trưng liên tục, loại bỏ từ hoặc che khuất các phần của ảnh. Chỉ xấp xỉ mô hình hộp đen ở khu vực lân cận mẫu dữ liệu giúp nhiệm vụ đơn giản đi đáng kể.
Những cạm bẫy tiềm ẩn
Mặc dù ý tưởng tổng quát của LIME nghe có vẻ đơn giản, vẫn có một vài hạn chế tiềm ẩn.
Trong hiện thực triển khai hiện tại, chỉ các mô hình tuyến tính được dùng để xấp xỉ hành vi cục bộ. Ở một mức độ nào đó, giả định này đúng khi nhìn vào vùng rất nhỏ quanh mẫu dữ liệu. Tuy nhiên, khi mở rộng vùng này, có thể mô hình tuyến tính sẽ không đủ mạnh để giải thích hành vi của mô hình gốc. Tính phi tuyến ở vùng cục bộ xuất hiện với những tập dữ liệu đòi hỏi các mô hình phức tạp, khó diễn giải. Không thể áp dụng LIME trong các kịch bản như vậy là một hạn chế đáng kể.
Thứ hai, kiểu sửa đổi cần thực hiện trên dữ liệu để có lời giải thích phù hợp thường phụ thuộc vào bài toán. Các tác giả đã nêu ví dụ trong bài báo của họ: chẳng hạn, một mô hình dự đoán ảnh tông màu sepia là “retro” thì không thể được giải thích bằng sự hiện diện hay vắng mặt của các siêu điểm ảnh.
Thường thì các nhiễu loạn đơn giản là chưa đủ. Lý tưởng nhất, các nhiễu loạn nên được dẫn dắt bởi biến thiên quan sát được trong tập dữ liệu. Tự tay điều khiển các nhiễu loạn rất có thể không phải ý hay, vì khả năng lớn sẽ đưa thiên lệch vào lời giải thích của mô hình.
Kết luận
LIME là công cụ tuyệt vời để giải thích những gì các bộ phân loại (hoặc mô hình) học máy đang làm. Nó không phụ thuộc mô hình, dựa trên các ý tưởng đơn giản và dễ hiểu, và không đòi hỏi nhiều công sức để chạy. Như mọi khi, ngay cả khi dùng LIME, việc diễn giải đúng đầu ra vẫn rất quan trọng.
Nếu bạn có bất kỳ câu hỏi nào về khả năng diễn giải trong học máy, tôi rất vui được đọc chúng trong phần bình luận. Theo dõi tôi trên Medium hoặc Twitter nếu bạn muốn nhận cập nhật về các bài viết của tôi!
Nếu bạn quan tâm học thêm về mô hình hóa, hãy học khóa Statistical Modeling in R của DataCamp.