torchrun --nproc_per_node=8 generate.py --task t2v-14B --size1280*720 --ckpt_dir ./Wan2.1-T2V-14B --dit_fsdp--t5_fsdp--ulysses_size8--prompt "A futuristic city with flying cars and neon lights.`技术支持
这会将工作负载分配到多块 GPU 上,从而加快生成速度。
使用提示词扩展(生成更细致、逼真的视频)
Wan 2.1 可以自动优化您的提示词,使生成视频更细节丰富、视觉更出众。
有两种提示词扩展方式:
使用 Dashscope API(需要 API Key)。
使用本地模型(离线在本机运行)。
使用 Dashscope API:
DASH_API_KEY=your_key python generate.py --task t2v-14B --size1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt"A futuristic city with flying cars and neon lights."--use_prompt_extend--prompt_extend_method'dashscope'技术支持
使用本地模型:
python generate.py --task t2v-14B --size1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt"A futuristic city with flying cars and neon lights."--use_prompt_extend--prompt_extend_method'local_qwen'技术支持
结合 Diffusers 运行 Wan 2.1
如果您希望使用 Hugging Face 的 Diffusers 库而非直接运行脚本,可以用 Python 生成视频:
import torch
from diffusers.utils import export_to_video
from diffusers import AutoencoderKLWan, WanPipeline
from diffusers.schedulers.scheduling_unipc_multistep import UniPCMultistepScheduler
# Available models: Wan-AI/Wan2.1-T2V-14B-Diffusers, Wan-AI/Wan2.1-T2V-1.3B-Diffusers
model_id ="Wan-AI/Wan2.1-T2V-14B-Diffusers"# Load the autoencoder for video generation
vae = AutoencoderKLWan.from_pretrained(model_id, subfolder="vae", torch_dtype=torch.float32)# Define the scheduler for controlling video motion flow
flow_shift =5.0# 5.0 for 720P, 3.0 for 480P
scheduler = UniPCMultistepScheduler(
prediction_type='flow_prediction',
use_flow_sigmas=True,
num_train_timesteps=1000,
flow_shift=flow_shift
)# Load the video generation pipeline with the model
pipe = WanPipeline.from_pretrained(model_id, vae=vae, torch_dtype=torch.bfloat16)
pipe.scheduler = scheduler
pipe.to("cuda")# New prompt
prompt ="A futuristic city at sunset, filled with flying cars and neon lights. The buildings have a sleek, cyberpunk design, and people walk on glowing sidewalks. The scene is full of vibrant colors, reflections, and dynamic movement."# New negative prompt
negative_prompt ="Dull colors, grainy texture, washed-out details, static frames, incorrect lighting, unnatural shadows, distorted faces, artifacts, low-resolution elements, flickering, blurry motion, repetitive patterns, unrealistic reflections, overly simplistic backgrounds, three legged people, walking backwards."# Generate the video frames
output = pipe(
prompt=prompt,
negative_prompt=negative_prompt,
height=720,
width=1280,
num_frames=81,
guidance_scale=5.0,).frames[0]# Export the generated frames as a video
export_to_video(output,"output.mp4", fps=16)技术支持
Ana Rojo Echeburúa 是一位人工智能与数据专家,拥有应用数学博士学位。她热衷于将数据转化为可执行的洞见,并在带领技术团队方面拥有丰富经验。Ana 喜欢与客户密切合作,解决其业务难题并打造创新的 AI 解决方案。她以出色的问题解决能力和清晰的沟通著称,对人工智能,尤其是生成式 AI 充满热情。Ana 致力于持续学习与负责任的 AI 开发,同时专注于简化复杂问题,并以通俗易懂的方式解释技术。



Qwen 的 Wan2.1 是一个开源的视频生成模型,既强大又易用,可在消费级 GPU 上运行。
凭借出色的性能,Wan2.1 不仅能与 HunyuanVideo、SkyReels 等开源模型竞争,也能对标 Sora 和 Runway 等商用方案。
在本文中,我将介绍 Wan2.1 是什么、其关键特性及工作原理,并带您了解如何访问和使用它,通过不同类型的提示生成视频,直观展示其能力。
Wan 2.1 是什么?
Wan 2.1 是由 Qwen 开发的高级视频生成模型,属于大规模视频基础模型家族,能够基于不同类型的输入(本文案例为文本描述和图像)生成高质量视频。
Wan 2.1 将强大的视频生成能力与可用性相结合。与许多需要昂贵硬件的 AI 视频模型不同,它可以在消费级 GPU 上运行,更具实用性,而且是开源的。
它基于扩散 Transformer 技术构建,这种方法可以生成流畅、逼真的视频,具有出色的运动质量。Wan 2.1 还引入了独特的视频变分自编码器(VAE),可在 1080p 等更高分辨率下依然保持视频的一致性和细节。
其主要特性如下:
1. 业界领先(SOTA)的性能
Wan 2.1 在多个基准测试上优于开源与商用 AI 视频模型,意味着它比许多替代方案能生成更逼真、更高质量的视频。
来源:GitHub(Wan-Video/Wan2.1)
在上表中,我们可以看到不同视频生成模型在 Wan-Bench 各维度的对比评测,涵盖运动生成、画面稳定性、目标准确性、指令遵循等关键方面。每个类别表现最好的模型以粗体标注。
Wan-14B 获得了最高的总体加权得分(0.724),显示出其在多项基准上的强大能力。
2. 可在消费级 GPU 上运行
相比大多数需要昂贵硬件的高端 AI 视频模型,Wan 2.1 的 T2V-1.3B 模型仅需 8.19GB 显存。这意味着您可以使用常见的 GPU(如 RTX 4090)在几分钟内生成视频,无需超级计算机。
3. 支持多种视频生成任务与功能
使用 Wan,您不仅可以进行文本转视频(T2V)。它还提供多种高级功能来提升生成质量和自定义能力,包括:
此外,Wan 支持图像转视频(I2V),可将静态图像转换为动画视频。您可以添加可选文本提示以获得更强的生成控制,并定义首尾帧来塑造视频的构图与节奏。
4. 视觉文本生成(英文与中文)
Wan 2.1 是首个可在视频中生成可读文本(支持英文与中文)的 AI 视频模型。非常适合在视频内容中创建字幕、动态文字与图形叠加。
5. 视频变分自编码器(VAE)
Wan 2.1 使用先进的视频变分自编码器(Wan-VAE),可实现:
如何在线访问 Wan 2.1?
有多种上手方式——您可以在线体验,也可以在本地电脑运行。
如果您想在无需安装的情况下试用 Wan 2.1,可通过以下途径:
1. Hugging Face Space:可直接在网页界面运行模型。
2. WanVideo 官网:不仅能生成视频,还可生成图像,并浏览其他用户生成的作品及其提示词。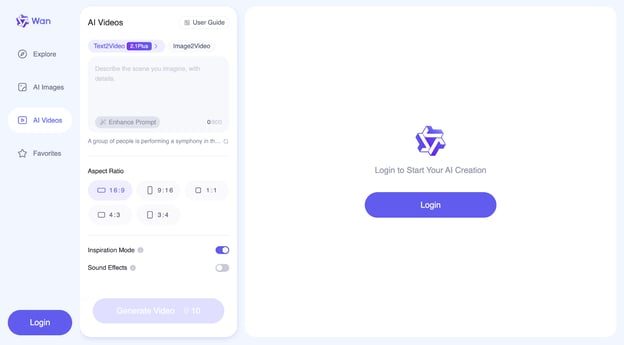
这些方式可帮助您快速测试模型,无需关心环境配置或硬件问题。
如何本地安装并运行 Wan 2.1
如果您需要完全的控制与自定义,可在本机安装 Wan 2.1。下面一步步说明:
初始设置
步骤 1:克隆仓库
首先,从 GitHub 下载 Wan 2.1 的代码:
步骤 2:安装依赖
确保已安装 Python 与 PyTorch(2.4.0 或更高版本),然后安装所需库:
步骤 3:下载模型权重
您需要从 Hugging Face(更多信息见 此处)或 ModelScope(更多信息见 此处)下载预训练模型文件。可下载的模型如下:
模型
下载链接
备注
T2V-14B
Huggingface
ModelScope
支持 480P 与 720P
I2V-14B-720P
Huggingface
ModelScope
支持 720P
I2V-14B-480P
Huggingface
ModelScope
支持 480P
T2V-1.3B
Huggingface
ModelScope
支持 480P
1.3B 模型可以生成 720P 分辨率视频,但由于在该质量上的训练较少,效果可能不如 480P 稳定。为获得最佳表现,推荐使用 480P 分辨率。
使用 Wan 2.1 运行文本转视频
Wan 2.1 支持通过两种模型版本从文本描述生成视频:
如果只想快速生成视频,可使用以下命令(不启用提示词增强)。
用于 T2V-14B 模型(更高质量、更大模型):
用于 T2V-1.3B 模型(更小、可在低端 GPU 上运行):
如果出现内存不足(OOM)错误,可使用
--offload_model True与--t5_cpu来降低内存占用。使用多 GPU 运行文本转视频(加速处理)
如果您有多块 GPU,可通过以下命令加速生成:
这会将工作负载分配到多块 GPU 上,从而加快生成速度。
使用提示词扩展(生成更细致、逼真的视频)
Wan 2.1 可以自动优化您的提示词,使生成视频更细节丰富、视觉更出众。
有两种提示词扩展方式:
使用 Dashscope API:
使用本地模型:
结合 Diffusers 运行 Wan 2.1
如果您希望使用 Hugging Face 的 Diffusers 库而非直接运行脚本,可以用 Python 生成视频:
脚本首先加载 Wan2.1-T2V-14B-Diffusers 模型用于视频生成,并加载用于处理与优化视频帧的 VAE(自编码器)。为控制视频中的运动平滑度,脚本使用了调度器(UniPCMultistepScheduler)。
flow_shift设置用于调节运动处理方式,720P 建议 5.0,480P 建议 3.0。随后脚本构建视频生成管线(WanPipeline)并应用调度器以确保帧间过渡更平滑。正向提示描绘了日落时的未来城市、飞行汽车与霓虹灯,而反向提示用于规避不希望出现的效果,例如模糊细节、色彩灰暗与帧闪烁。
模型随后生成 81 帧,以 16 帧/秒(FPS)约合 5 秒视频。
guidance_scale设为 5.0,有助于模型遵循提示同时保留一定创造性。生成完成后,将帧合成为 16 FPS 的"output.mp4"并保存。反向提示在提升成片质量方面很重要,它告诉模型需要避免的内容,帮助消除画质欠佳、奇怪变形或任何可能让视频显得不真实的因素。在本例中,它确保未来场景干净、锐利且具有视觉吸引力。
使用本地 Gradio 界面运行 Wan 2.1
如果您更喜欢通过交互式网页界面来生成视频,而不是写代码,可使用 Gradio 运行 Wan 2.1:
使用 Dashscope 提示词扩展:
使用本地提示词扩展:
与文本转视频类似,图像转视频也分为包含与不包含提示词扩展的流程。有关实现细节,您可以访问官方 GitHub。您也可以加入他们的 Discord 频道,讨论 Wan2.1、分享作品、获取新功能与进展更新,并访问 官方网站 浏览生成示例。
Wan 2.1 的工作原理
Wan 2.1 基于先进的 AI 技术生成高质量、逼真的视频。它采用扩散式的方法,并结合 Transformer,确保跨帧的运动平滑、一致且细节到位。
扩散 Transformer 技术
Wan 2.1 采用称为扩散模型的技术,主要包含两步:
这有点像在暗房中显影——图像起初模糊粗糙,随着处理步骤推进逐渐清晰。
Wan 2.1 通过引入扩散 Transformer(DiT)改进了这一过程,在生成多帧视频时更好地保持清晰细节与平滑运动。
来源:GitHub(Wan-Video/Wan2.1)
该图展示了 Wan 2.1 如何基于带有 DiT 的扩散模型生成视频帧。流程从输入描述开始(如 “A panda is holding up a cardboard that says 'Wan2.1'”)。文本由 UMT5 语言模型处理,帮助理解与优化提示词。
同时,引入初始噪声图像作为起点。Wan-Encoder 对输入进行处理并编码为模型可操作的形式。随后通过 N 个 DiT 模块迭代细化图像。
扩散模型逐步从帧中去除噪声,并利用交叉注意力将输出与提示词对齐。时间步(t)表示去噪的渐进过程,确保视频随时间平滑成形。
经过多次细化,Wan-Decoder 从处理后的数据中重建最终视频帧。输出是一系列与原始描述一致的帧,兼顾清晰细节、平滑运动与一致性。
用于高质量视频的 VAE
Wan 2.1 配备 Wan-VAE,这是一种强大的压缩工具,可帮助模型:
这有点像您为视频打包压缩:它高效压缩并存储关键细节,在生成视频时再准确重建。
来源:GitHub(Wan-Video/Wan2.1)
该图比较了不同视频压缩模型在视频质量(PSNR)与效率(处理帧速)方面的表现。每个气泡代表一个模型,大小表示模型规模。横轴衡量处理帧的效率,数值越高越快;纵轴代表视频质量,数值越高画面越清晰细致。
橙色的 Wan-VAE 在保持较小规模(1.27 亿参数)的同时,实现了高视频质量与快速处理的平衡,优于其他模型。其他如 Step Video、Mochi 虽然更大,但处理效率不及 Wan-VAE。这意味着 Wan-VAE 能在不降速的情况下生成更长、更高质量的视频,同时保持细节清晰、运动流畅。
Wan 2.1 的应用场景
Wan 2.1 是一款通用性很强的 AI 视频生成模型,可用于多个行业。本节我将针对不同场景做一些示例尝试。
内容创作与社交媒体
Wan 2.1 可帮助您在无需昂贵设备或长时间剪辑的情况下生成独特视频内容。假设我是生活方式博主,打算围绕“惬意的一天”创作一些内容。我将使用以下提示词为我的视频生成一个片段:
一段温馨咖啡馆从清晨到傍晚的延时动画,展示人来人往、咖啡煮制,以及夕阳在窗户上的倒影。
为了尽可能真实,我还开启了灵感模式。以下是我得到的结果: