Khóa học
Retrieval Augmented Generation (RAG) với LangChain
3 giờ
21.3K
Wan2.1 của Qwen là mô hình tạo video mã nguồn mở được thiết kế vừa mạnh mẽ vừa dễ tiếp cận, vì có thể chạy trên GPU phổ thông.
Với hiệu năng ấn tượng, Wan2.1 cạnh tranh với các mô hình nguồn mở như HunyuanVideo và SkyReels và các giải pháp thương mại như Sora và Runway.
Trong bài viết này, tôi sẽ khám phá Wan2.1 là gì, các tính năng chính và cách nó hoạt động. Ngoài ra, tôi sẽ hướng dẫn bạn cách truy cập và sử dụng để tạo video từ nhiều loại prompt, qua đó trình diễn khả năng thực tế của nó.
Wan 2.1 là mô hình tạo video tiên tiến do Qwen phát triển. Nó thuộc họ các mô hình nền tảng video quy mô lớn, nghĩa là có thể tạo video chất lượng cao từ nhiều loại đầu vào, ở đây là mô tả văn bản và hình ảnh.
Wan 2.1 kết hợp khả năng tạo video mạnh với tính dễ tiếp cận. Nó có thể chạy trên GPU cho người dùng phổ thông, khác với nhiều mô hình video AI khác đòi hỏi phần cứng đắt tiền, khiến nó thực tiễn hơn. Thêm nữa, nó là mã nguồn mở.
Mô hình được xây dựng trên công nghệ diffusion transformer, một cách tiếp cận cho phép tạo ra video mượt mà, chân thực với chất lượng chuyển động ấn tượng. Wan 2.1 cũng giới thiệu Video Variational Autoencoder (VAE) độc đáo, giúp duy trì tính nhất quán và chi tiết của video, ngay cả ở độ phân giải cao như 1080p.
Dưới đây là các tính năng chính:
Wan 2.1 vượt trội so với cả mô hình AI video nguồn mở và thương mại trên nhiều bộ đánh giá chuẩn, tức là tạo ra video chân thực, chất lượng cao hơn nhiều lựa chọn thay thế.
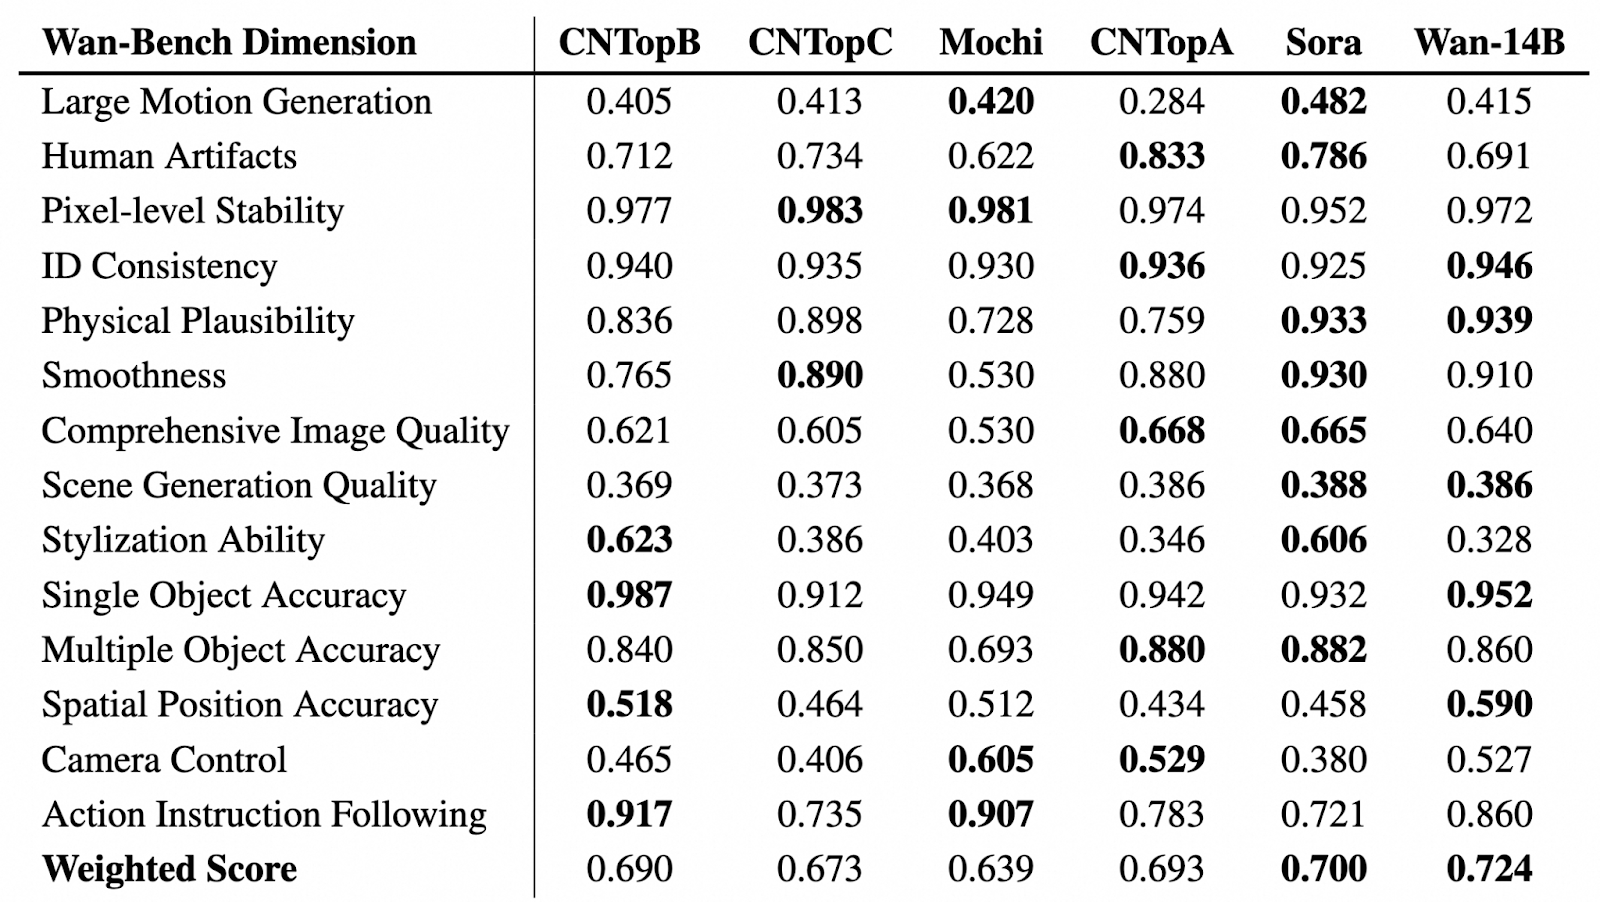
Nguồn: GitHub (Wan-Video/Wan2.1)
Trong bảng trên, chúng ta thấy đánh giá so sánh các mô hình tạo video trên nhiều chiều của Wan-Bench, đánh giá hiệu năng ở các khía cạnh như tạo chuyển động, ổn định thị giác, độ chính xác đối tượng và khả năng làm theo hướng dẫn. Mô hình có hiệu năng cao nhất trong mỗi hạng mục được in đậm.
Wan-14B đạt điểm tổng có trọng số cao nhất (0,724), thể hiện năng lực mạnh mẽ trên nhiều bộ đánh giá chuẩn.
So với hầu hết mô hình AI video cao cấp cần phần cứng đắt tiền, mô hình T2V-1.3B của Wan 2.1 chỉ cần 8,19GB VRAM. Nghĩa là bạn có thể tạo video bằng GPU thông thường, như RTX 4090, chỉ trong vài phút mà không cần siêu máy tính.
Với Wan, bạn có thể làm nhiều hơn là Chuyển văn bản thành video (T2V). Nó cung cấp các tính năng nâng cao để cải thiện chất lượng và tùy biến video, bao gồm:
Ngoài ra, Wan hỗ trợ Chuyển hình ảnh thành video (I2V) để bạn biến ảnh tĩnh thành video chuyển động. Bạn có thể thêm prompt văn bản tùy chọn để kiểm soát tốt hơn quá trình tạo video và xác định khung hình đầu/cuối để định hình bố cục và nhịp chảy của video.
Wan 2.1 là mô hình video AI đầu tiên có thể tạo văn bản đọc được trong video bằng cả tiếng Anh và tiếng Trung. Điều này rất hữu ích để tạo phụ đề, chữ động và lớp phủ đồ họa trong nội dung video.
Wan 2.1 sử dụng Video Variational Auto Encoder (Wan-VAE) tiên tiến cho phép:
Có vài cách để bắt đầu—bạn có thể dùng trực tuyến hoặc chạy cục bộ trên máy tính của mình.
Nếu muốn thử nghiệm Wan 2.1 mà không cần cài đặt gì, bạn có thể truy cập qua:
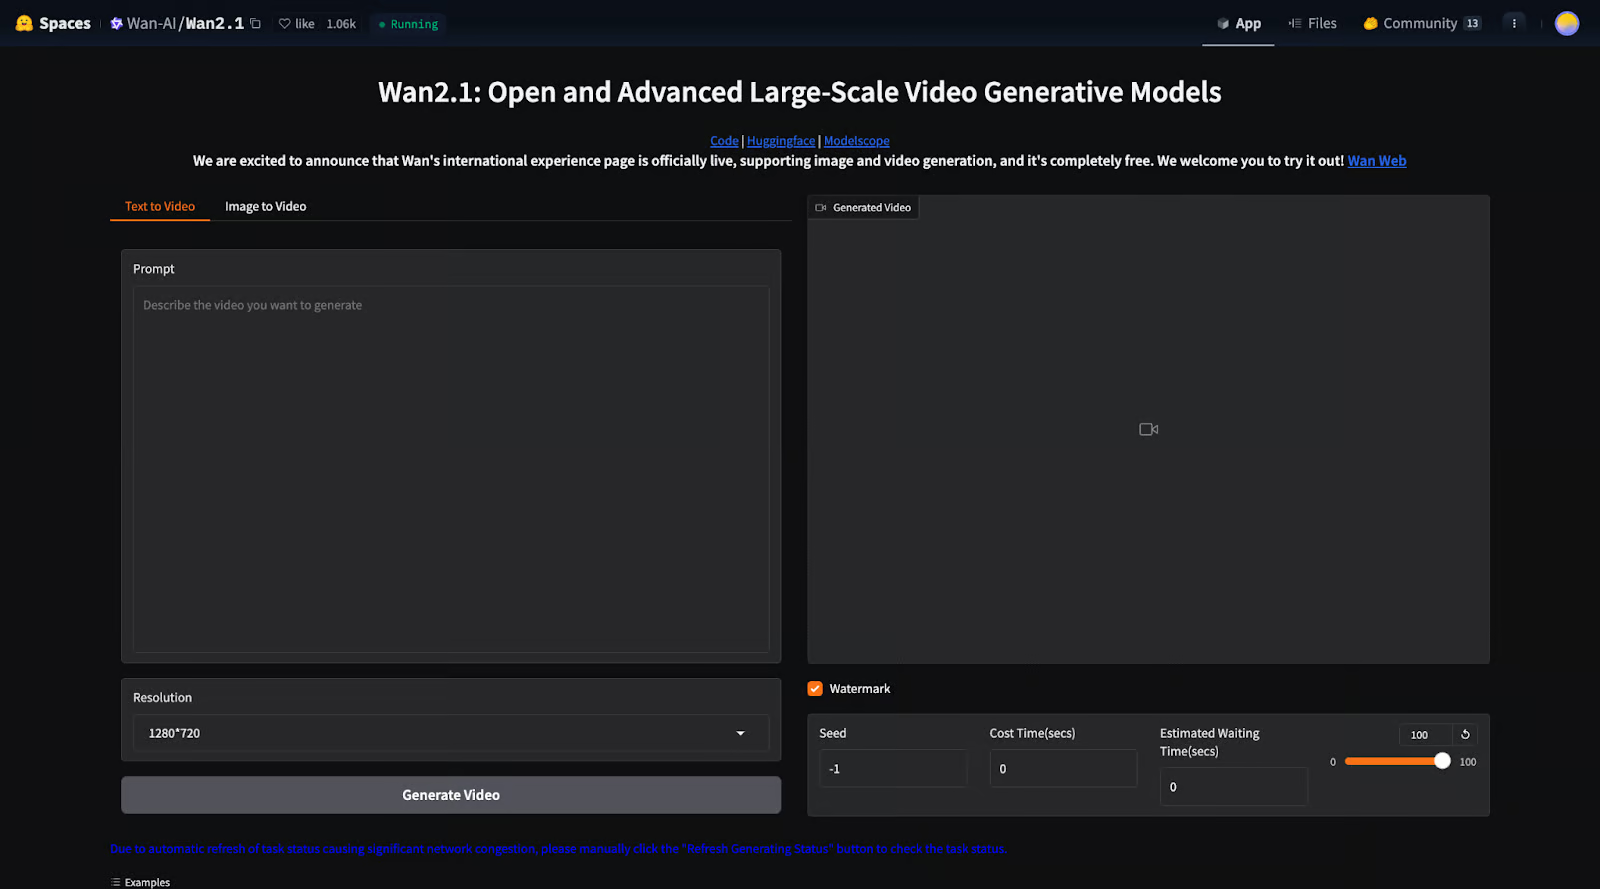
1. Không gian Hugging Face: Bạn có thể chạy mô hình trực tiếp trên giao diện web.
2. Trang web WanVideo: Ở đây, bạn có thể làm nhiều hơn là tạo video. Trang chính thức còn cho phép tạo hình ảnh và khám phá bộ sưu tập video, hình ảnh do người dùng khác tạo kèm các prompt họ đã dùng.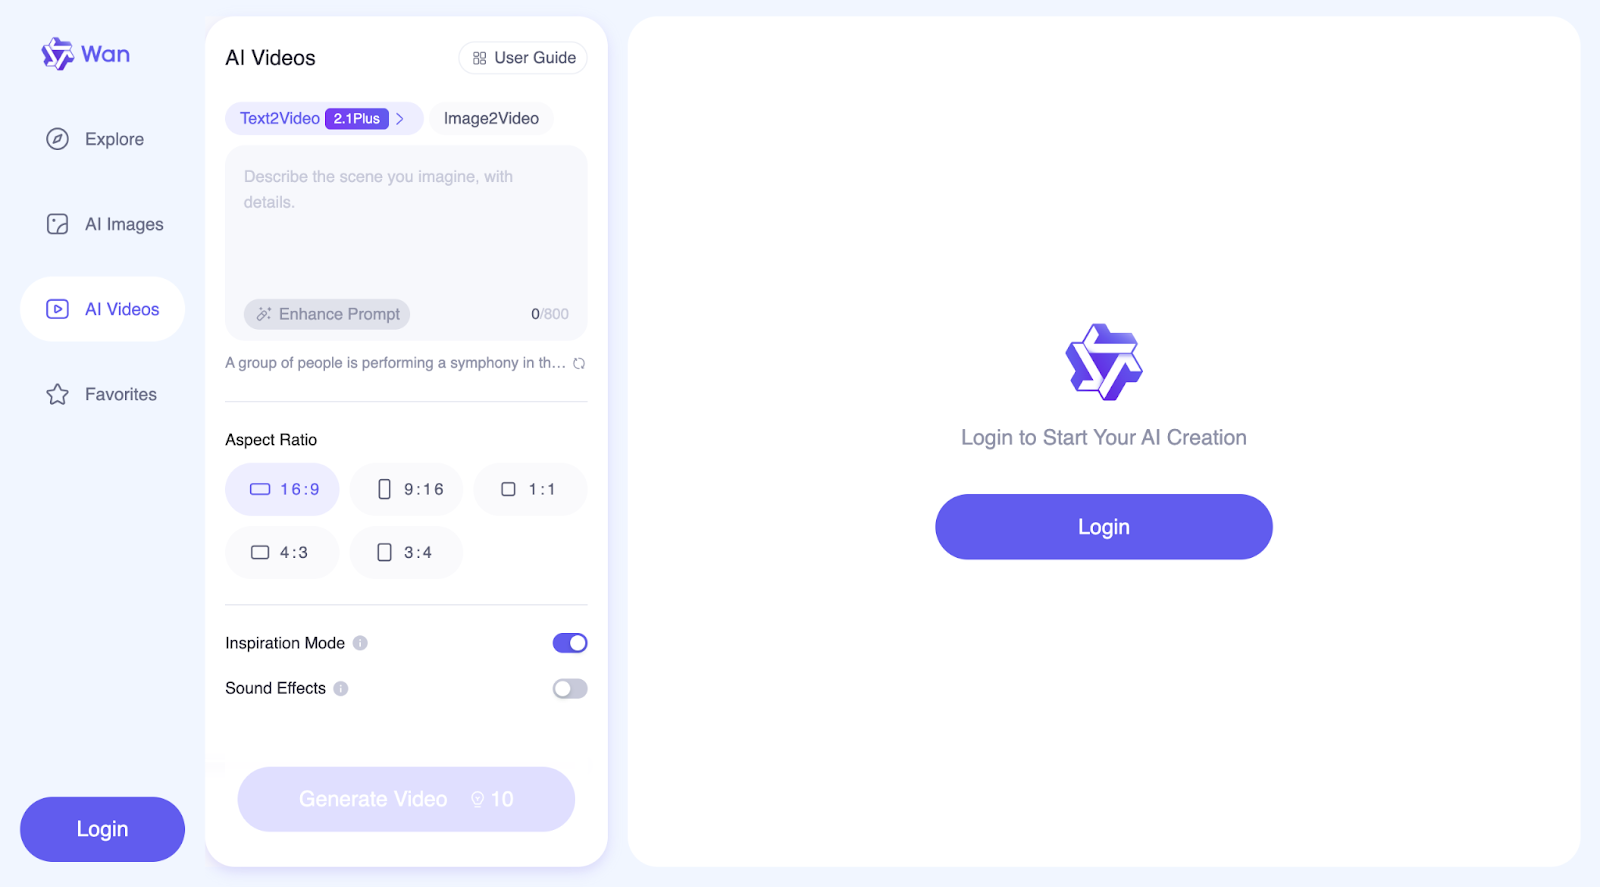
Những lựa chọn này cho phép bạn thử mô hình nhanh chóng mà không lo phần cứng hay cài đặt.
Nếu bạn muốn toàn quyền kiểm soát và tùy biến, có thể cài đặt Wan 2.1 trên máy của riêng mình. Hãy làm theo từng bước như sau:
Trước hết, tải mã nguồn Wan 2.1 từ GitHub:
git clone https://github.com/Wan-Video/Wan2.1.git
cd Wan2.1Hãy đảm bảo bạn đã cài Python và PyTorch (phiên bản 2.4.0 trở lên), sau đó cài các thư viện cần thiết:
pip install -r requirements.txtBạn cần tải các tệp mô hình đã huấn luyện sẵn từ Hugging Face (xem thêm tại đây) hoặc ModelScope (xem thêm tại đây).Có nhiều mô hình để bạn tải:
|
Mô hình |
Liên kết tải |
Ghi chú |
|
T2V-14B |
Hỗ trợ cả 480P và 720P |
|
|
I2V-14B-720P |
Hỗ trợ 720P |
|
|
I2V-14B-480P |
Hỗ trợ 480P |
|
|
T2V-1.3B |
Hỗ trợ 480P |
Mô hình 1.3B có thể tạo video ở độ phân giải 720P, nhưng do được huấn luyện ít hơn ở chất lượng này, kết quả có thể kém ổn định hơn so với 480P. Để đạt hiệu năng tốt nhất, khuyến nghị dùng 480P.
Wan 2.1 cho phép bạn tạo video từ mô tả văn bản bằng hai phiên bản mô hình:
Nếu bạn chỉ muốn tạo video nhanh, có thể dùng các lệnh sau, trong đó không bật tính năng tăng cường prompt.
Với mô hình T2V-14B (chất lượng cao hơn, mô hình lớn hơn):
python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights."Với mô hình T2V-1.3B (nhỏ hơn, chạy trên GPU tầm thấp):
python generate.py --task t2v-1.3B --size 832*480 --ckpt_dir ./Wan2.1-T2V-1.3B --prompt "A futuristic city with flying cars and neon lights."Nếu máy bạn bị thiếu bộ nhớ (lỗi OOM), bạn có thể dùng --offload_model True và --t5_cpu để giảm mức sử dụng bộ nhớ.
Nếu bạn có nhiều GPU, có thể tăng tốc tạo video bằng lệnh sau:
torchrun --nproc_per_node=8 generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --dit_fsdp --t5_fsdp --ulysses_size 8 --prompt "A futuristic city with flying cars and neon lights.`Cách này cho phép chia tải công việc lên nhiều GPU, giúp quá trình nhanh hơn.
Wan 2.1 có thể tự động cải thiện prompt của bạn, giúp video chi tiết và bắt mắt hơn.
Có hai cách để mở rộng prompt:
Để dùng Dashscope API:
DASH_API_KEY=your_key python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights." --use_prompt_extend --prompt_extend_method 'dashscope'Để dùng mô hình cục bộ của bạn:
python generate.py --task t2v-14B --size 1280*720 --ckpt_dir ./Wan2.1-T2V-14B --prompt "A futuristic city with flying cars and neon lights." --use_prompt_extend --prompt_extend_method 'local_qwen'Nếu bạn muốn dùng thư viện Diffusers của Hugging Face thay vì chạy script thô, bạn có thể tạo video bằng Python:
import torch
from diffusers.utils import export_to_video
from diffusers import AutoencoderKLWan, WanPipeline
from diffusers.schedulers.scheduling_unipc_multistep import UniPCMultistepScheduler
# Available models: Wan-AI/Wan2.1-T2V-14B-Diffusers, Wan-AI/Wan2.1-T2V-1.3B-Diffusers
model_id = "Wan-AI/Wan2.1-T2V-14B-Diffusers"
# Load the autoencoder for video generation
vae = AutoencoderKLWan.from_pretrained(model_id, subfolder="vae", torch_dtype=torch.float32)
# Define the scheduler for controlling video motion flow
flow_shift = 5.0  # 5.0 for 720P, 3.0 for 480P
scheduler = UniPCMultistepScheduler(
    prediction_type='flow_prediction',
    use_flow_sigmas=True,
    num_train_timesteps=1000,
    flow_shift=flow_shift
)
# Load the video generation pipeline with the model
pipe = WanPipeline.from_pretrained(model_id, vae=vae, torch_dtype=torch.bfloat16)
pipe.scheduler = scheduler
pipe.to("cuda")
# New prompt
prompt = "A futuristic city at sunset, filled with flying cars and neon lights. The buildings have a sleek, cyberpunk design, and people walk on glowing sidewalks. The scene is full of vibrant colors, reflections, and dynamic movement."
# New negative prompt
negative_prompt = "Dull colors, grainy texture, washed-out details, static frames, incorrect lighting, unnatural shadows, distorted faces, artifacts, low-resolution elements, flickering, blurry motion, repetitive patterns, unrealistic reflections, overly simplistic backgrounds, three legged people, walking backwards."
# Generate the video frames
output = pipe(
     prompt=prompt,
     negative_prompt=negative_prompt,
     height=720,
     width=1280,
     num_frames=81,
     guidance_scale=5.0,
).frames[0]
# Export the generated frames as a video
export_to_video(output, "output.mp4", fps=16)
Script bắt đầu bằng cách tải mô hình Wan2.1-T2V-14B-Diffusers, dùng để tạo video. Nó cũng tải một VAE (Autoencoder), hỗ trợ xử lý và cải thiện các khung hình. Để kiểm soát độ mượt của chuyển động trong video, script sử dụng một scheduler (UniPCMultistepScheduler). Thiết lập flow_shift điều chỉnh cách xử lý chuyển động, với 5,0 phù hợp cho độ phân giải cao (720P) và 3,0 cho độ phân giải thấp hơn (480P).
Tiếp theo, script thiết lập pipeline tạo video (WanPipeline) và áp dụng scheduler để đảm bảo chuyển cảnh mượt giữa các khung hình. Prompt mô tả một thành phố tương lai với xe bay và đèn neon rực rỡ, còn negative prompt giúp loại bỏ các hiệu ứng không mong muốn như chi tiết mờ, màu nhợt và khung hình nhấp nháy.
Mô hình tạo 81 khung hình, tương đương khoảng 5 giây video ở tốc độ 16 khung hình/giây (FPS). guidance_scale được đặt là 5,0, giúp mô hình bám sát prompt đồng thời vẫn có không gian sáng tạo. Khi video được tạo xong, các khung hình được ghép và lưu thành "output.mp4" ở 16 FPS.
Negative prompt đóng vai trò quan trọng trong việc cải thiện video cuối cùng bằng cách cho mô hình biết cần tránh gì. Nó giúp loại bỏ các yếu tố như chất lượng hình ảnh kém, méo mó lạ hoặc bất cứ điều gì khiến video trông thiếu chân thực. Trong trường hợp này, nó giúp cảnh tương lai trông sạch, sắc nét và hấp dẫn thị giác.
Nếu bạn thích giao diện web tương tác để tạo video thay vì dùng mã, bạn có thể chạy Wan 2.1 với Gradio:
Với mở rộng prompt bằng Dashscope:
DASH_API_KEY=your_key python t2v_14B_singleGPU.py --prompt_extend_method 'dashscope' --ckpt_dir ./Wan2.1-T2V-14BVới mở rộng prompt cục bộ:
python t2v_14B_singleGPU.py --prompt_extend_method 'local_qwen' --ckpt_dir ./Wan2.1-T2V-14BTương tự text-to-video, image-to-video cũng được chia thành quy trình có và không có bước mở rộng prompt. Để biết thêm chi tiết triển khai, bạn có thể truy cập GitHub chính thức. Bạn cũng có thể tham gia kênh Discord để thảo luận về Wan2.1, chia sẻ sản phẩm của bạn, nhận cập nhật về tính năng và phát triển mới, và ghé trang web chính thức để khám phá các ví dụ đã tạo.
Wan 2.1 được xây dựng bằng các kỹ thuật AI tiên tiến để tạo video chất lượng cao, chân thực. Nó theo cách tiếp cận dựa trên diffusion và tích hợp transformer để đảm bảo chuyển động mượt, nhất quán và chi tiết qua các khung hình.
Wan 2.1 dùng kỹ thuật gọi là diffusion model, hoạt động theo hai bước:
Nó khá giống việc tráng ảnh trong buồng tối—ban đầu ảnh mờ và nhiễu, nhưng rõ dần qua từng bước xử lý.
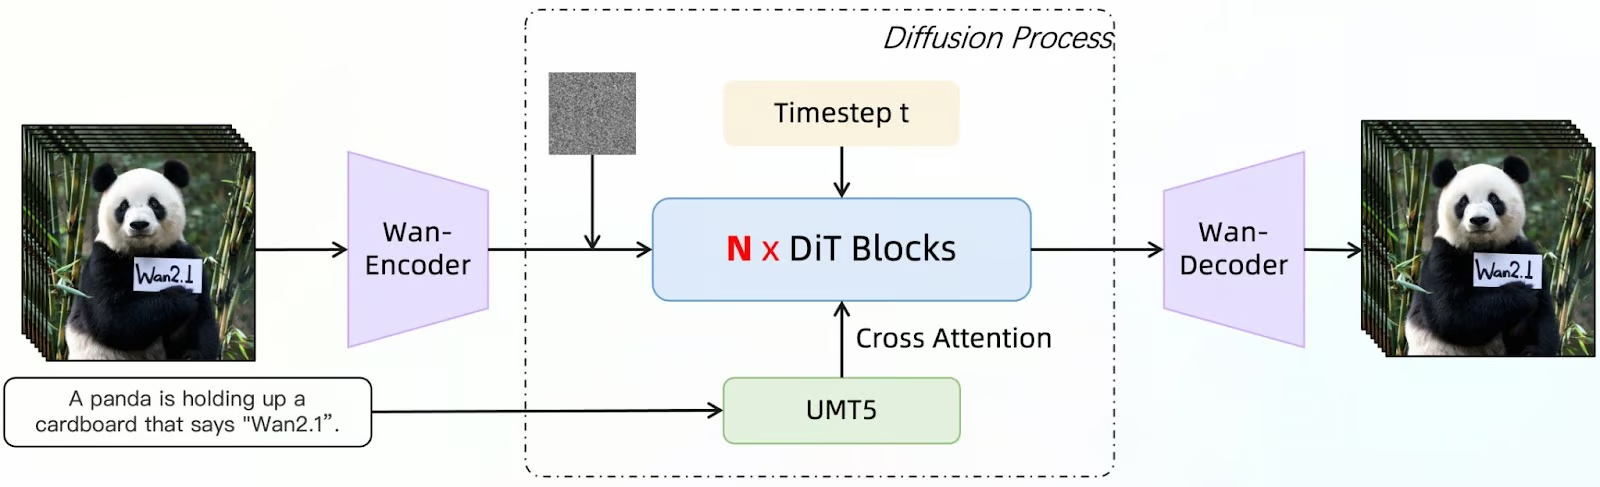
Wan 2.1 cải tiến cách tiếp cận này bằng Diffusion Transformer (DiT), giúp giữ chi tiết sắc nét và chuyển động mượt khi tạo nhiều khung hình.
Nguồn: GitHub (Wan-Video/Wan2.1)
Sơ đồ này cho thấy Wan 2.1 tạo các khung hình video bằng mô hình diffusion được tăng cường với Diffusion Transformer (DiT). Quá trình bắt đầu từ mô tả đầu vào (ví dụ: "Một con gấu trúc cầm tấm bìa ghi 'Wan2.1'"). Văn bản này được UMT5 xử lý, là mô hình ngôn ngữ hỗ trợ hệ thống hiểu và tinh chỉnh prompt.
Đồng thời, một ảnh nhiễu ban đầu được đưa vào làm điểm xuất phát. Wan-Encoder sau đó xử lý các đầu vào này, mã hóa chúng thành dạng mà mô hình có thể thao tác. Các khối DiT (N x) tinh chỉnh ảnh lặp đi lặp lại.
Mô hình diffusion dần dần loại bỏ nhiễu khỏi các khung, dùng cơ chế cross-attention để căn chỉnh đầu ra với prompt đã cung cấp. Tham số timestep (t) biểu thị các bước khử nhiễu tuần tự, đảm bảo video phát triển mượt theo thời gian.
Sau nhiều bước tinh chỉnh, Wan-Decoder tái tạo các khung hình cuối cùng từ dữ liệu đã xử lý. Đầu ra là chuỗi khung hình phù hợp với mô tả ban đầu, duy trì chi tiết sắc nét, chuyển động mượt và tính nhất quán.
Wan 2.1 tích hợp Wan-VAE, công cụ nén mạnh mẽ giúp mô hình:
Nó giống như khi bạn nén tệp video: nén và lưu các chi tiết then chốt, rồi tái tạo chính xác khi tạo video.
Nguồn: GitHub (Wan-Video/Wan2.1)
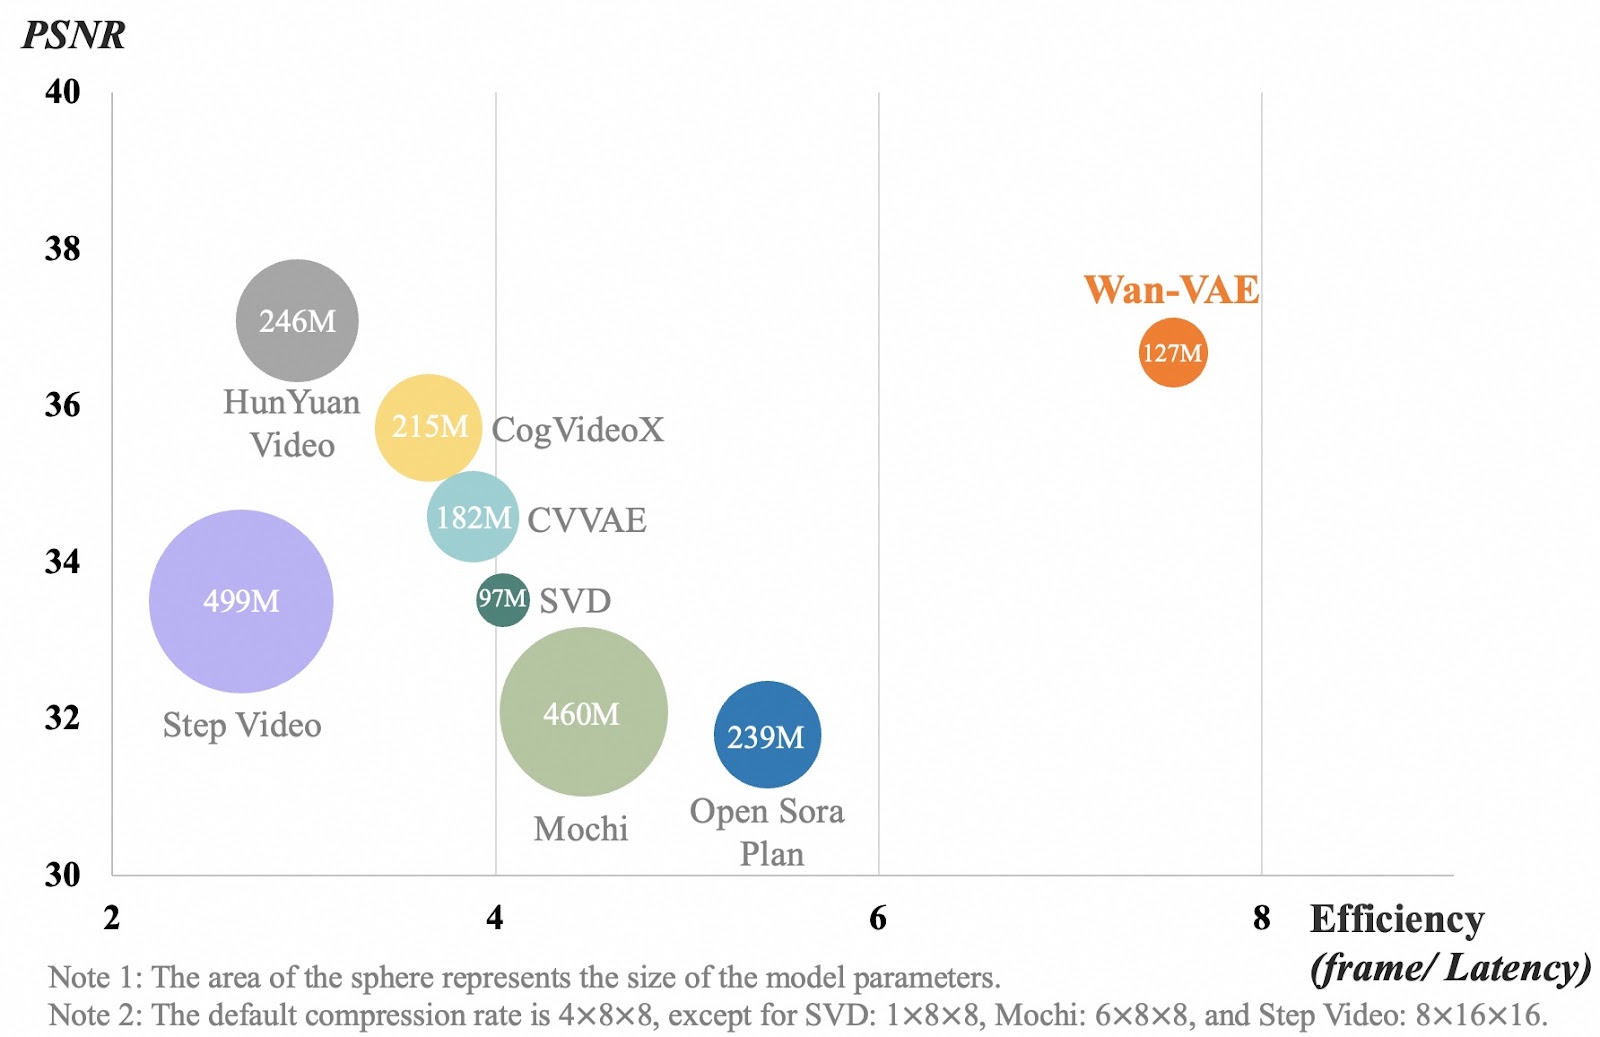
Biểu đồ so sánh các mô hình nén video dựa trên chất lượng video (PSNR) và hiệu suất (tốc độ xử lý khung hình). Mỗi bong bóng đại diện cho một mô hình, kích thước thể hiện độ lớn mô hình. Trục hoành đo hiệu suất xử lý khung hình, số lớn hơn nghĩa là nhanh hơn. Trục tung thể hiện chất lượng video, số lớn hơn nghĩa là video rõ và chi tiết hơn.
Wan-VAE, thể hiện bằng màu cam, hoạt động tốt hơn các mô hình khác khi cân bằng giữa chất lượng video cao và tốc độ xử lý nhanh trong khi vẫn khá nhỏ (127M tham số). Các mô hình khác như Step Video và Mochi lớn hơn nhiều nhưng không xử lý khung hiệu quả bằng. Điều này có nghĩa Wan-VAE có thể tạo video dài, chất lượng cao trong khi giữ chi tiết sắc nét và chuyển động mượt mà, mà không làm chậm lại.
Wan 2.1 là mô hình tạo video AI đa năng có thể dùng trong nhiều ngành. Ở phần này, tôi sẽ thử một vài ví dụ cho các trường hợp sử dụng khác nhau.
Wan 2.1 có thể giúp bạn tạo nội dung video độc đáo mà không cần thiết bị đắt tiền hay hàng giờ chỉnh sửa. Vậy, hãy tưởng tượng tôi là một influencer về phong cách sống và muốn tạo nội dung về một ngày ấm áp, thư thái của mình.Tôi sẽ dùng prompt sau để tạo một đoạn clip cho video:
Một hoạt cảnh tua nhanh thời gian của quán cà phê ấm cúng từ sáng đến tối, cho thấy người ra vào, cà phê đang được pha và hoàng hôn phản chiếu trên cửa sổ.
Vì tôi muốn càng chân thực càng tốt, tôi cũng đã bật chế độ truyền cảm hứng. Đây là kết quả tôi nhận được:
Khi video được tạo, thoạt nhìn tôi rất ấn tượng. Nhưng xem kỹ hơn, tôi nhận ra vài điều. Đầu tiên, có người biến mất ở hậu cảnh. Thêm nữa, đây không phải là tua nhanh thời gian, và không có cảnh pha cà phê. Vậy nên, dù video trông khá chân thực, nó không phản ánh chính xác prompt.
Giờ hãy tưởng tượng bạn là một nhà phát triển game. Bạn có thể dùng Wan 2.1 để tạo các đoạn cắt cảnh chân thực, hoạt ảnh nền hoặc concept art cho dự án. Ví dụ, nếu bạn đã có ý tưởng nhân vật và đội sáng tạo đã đưa ra một số thiết kế, bạn có thể thổi hồn cho nhân vật bằng tính năng image-to-video của Wan.
Ngoài hoạt ảnh nhân vật, Wan 2.1 cũng có thể giúp tạo môi trường động, như hiệu ứng thời tiết thay đổi, phố xá nhộn nhịp hoặc khung cảnh huyền ảo, mà không cần tự tay dựng từng khung hình.
Bên cạnh đó, với kiểm soát tỷ lệ khung hình, bạn có thể đảm bảo hoạt ảnh vừa vặn hoàn hảo với các cảnh game khác nhau, như điện ảnh màn rộng (16:9), khung dọc thân thiện di động (9:16) hoặc bố cục vuông (1:1) cho teaser trên mạng xã hội.
Bạn thậm chí có thể dùng tính năng hiệu ứng âm thanh để tạo âm nền, như tiếng lá xào xạc, tiếng ù của thành phố tương lai, hoặc âm cảnh trận chiến.
Hãy thử nhé!Tôi đã tạo bản nháp một hiệp sĩ thời trung cổ bằng DALL-E:
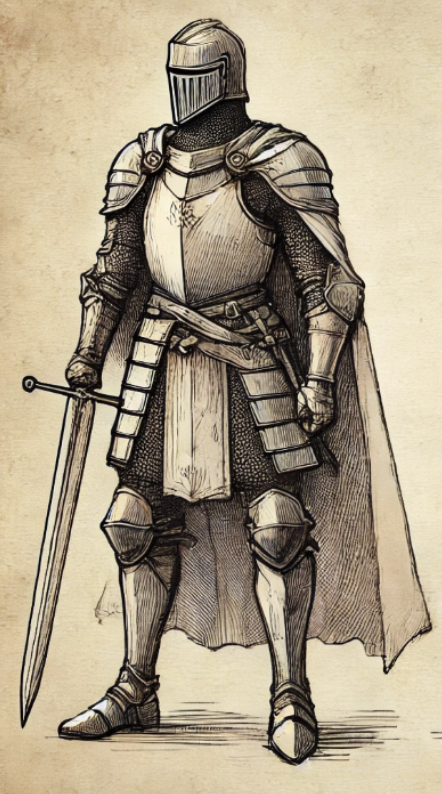
Dùng Wan, tôi nhập prompt sau bằng GPT-4o-mini:
Một hiệp sĩ trung cổ đứng trong tư thế anh hùng, nắm chặt thanh kiếm lớn bằng cả hai tay. Áo choàng của anh bay trong gió khi anh quan sát chiến trường. Hiệp sĩ từ từ quay đầu, quét nhìn đường chân trời với vẻ kiên định. Hoạt ảnh mang phong cách điện ảnh.Sau đó, tôi nhấn Enhanced Prompt, và đây là kết quả:
Hiệp sĩ Trung cổ Điện ảnh: Một hiệp sĩ hào hiệp đứng vững vàng, khoác giáp tấm toàn thân, nắm chặt một thanh đại đao hùng mạnh bằng cả hai tay. Mũ chụp che mặt và giáp vai lấp lánh dưới ánh mặt trời, trong khi huy hiệu cao quý trang trí trên ngực giáp. Dải lưng thắt chặt eo, cố định toàn trang phục. Áo choàng đỏ thẫm tung bay đầy kịch tính trong gió, làm tăng vẻ uy nghi. Với ánh nhìn thép, anh xoay đầu, quan sát bãi chiến trường cát mênh mông. Khung cảnh hiện lên trên nền giấy có kết cấu như bản thảo cổ, gợi cảm giác thư tịch xưa. Đây là cú máy toàn thân hoành tráng, bắt trọn dáng đứng khải hoàn của hiệp sĩ, gợi nhớ điện ảnh trung cổ sử thi.
Tôi tắt Chế độ Truyền cảm hứng nhưng bật Hiệu ứng Âm thanh. Đây là kết quả:
Không tệ! Dù tôi phải thừa nhận, tôi kỳ vọng một phiên bản điện ảnh hơn của bản nháp thay vì hoạt họa chính bản nháp đó. Nhưng có lẽ tôi nên diễn đạt rõ ràng hơn trong prompt. Âm nhạc khá thú vị, và có vẻ hợp với hoạt ảnh!
Nếu bạn là marketer, bạn có thể dùng Wan 2.1 để tạo video quảng bá cho thương hiệu, sản phẩm, dịch vụ hoặc thậm chí hoạt họa logo.
Hãy tưởng tượng bạn có một doanh nghiệp kem và muốn hoạt họa logo để chèn vào cuối các quảng cáo hoặc video khuyến mãi.Để thử ý tưởng này, tôi lại tạo hình ảnh sau bằng DALL-E:
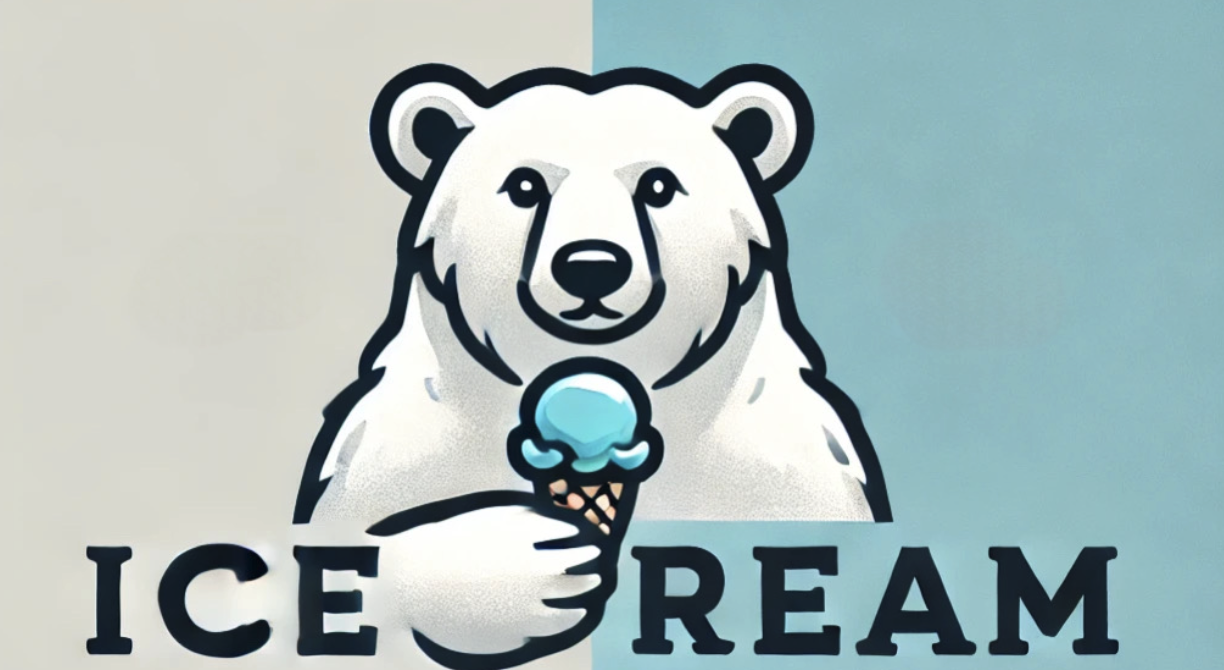
Sau đó, tôi dùng prompt: Gấu Bắc Cực ăn kem. Đây là kết quả tạo image-to-video:
Học AI với những khóa học này!
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
