
Curso
Conceptos de AWS
2 h
51.8K
Aunque la mayoría asocia Amazon con entregas Prime y contenido, la compañía también es muy valorada entre los desarrolladores. En concreto, Amazon Web Services (AWS) ofrece tecnologías en la nube a más de 1 millón de usuarios activos, incluidas grandes empresas y pymes.
En este artículo nos centraremos en AWS SageMaker, una plataforma diseñada para ejecutar flujos de trabajo de aprendizaje automático (ML) de extremo a extremo a gran escala, que forma parte del ecosistema de AWS. Al final del artículo, tendremos un modelo desplegado al que podremos enviar peticiones para generar predicciones en una tarea de clasificación.
Amazon SageMaker es un servicio totalmente gestionado que proporciona las herramientas e infraestructura necesarias para crear, entrenar y desplegar modelos de aprendizaje automático. Simplifica el flujo de trabajo de ML y permite a científicos de datos y desarrolladores crear, entrenar y desplegar modelos de forma rápida y eficiente.
En un proyecto típico de machine learning pasarás por varias fases:
Cada fase requiere herramientas distintas y un equipo con las habilidades adecuadas para orquestarlas sin fricciones. Amazon SageMaker reúne todo este proceso en una única plataforma. Estos son algunos de sus beneficios:
Estas ventajas hacen de Amazon SageMaker una plataforma potente y flexible para crear, entrenar y desplegar modelos de machine learning a escala.
Como comentábamos, SageMaker forma parte del ecosistema de AWS, que incluye numerosas soluciones de computación en la nube para almacenamiento, redes, bases de datos, analítica y capacidades de machine learning. Todas estas soluciones funcionan en sintonía con SageMaker para unificar tu flujo de trabajo de ML.
Por ese motivo, SageMaker requiere que crees una cuenta de AWS si aún no la tienes.
Para crear tu cuenta, ve a https://aws.amazon.com/ y sigue el proceso para abrir una nueva cuenta.
El alta incluye añadir información de facturación y verificar tu número de teléfono. No te preocupes: no se te cobrará hasta que empieces a usar alguna funcionalidad de SageMaker (que suele ser rentable).
Una vez completes el registro, irás a tu consola de AWS, que normalmente se ve como en la imagen siguiente. Ten en cuenta que algunos widgets pueden variar en tu caso.
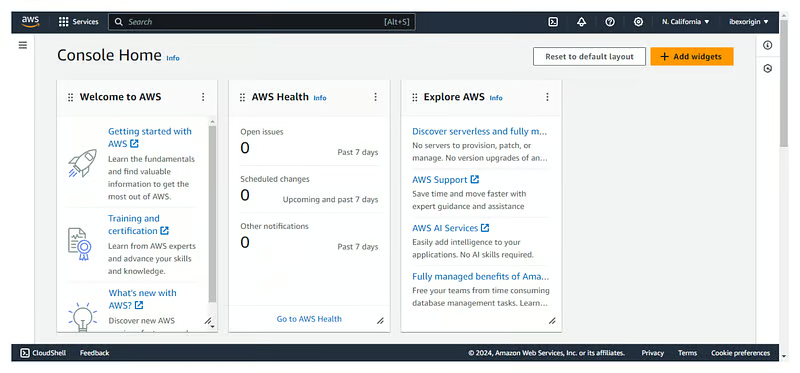
Ahora crearemos una sesión de JupyterLab para ejecutar código en máquinas en la nube de Amazon.
Desde tu consola de AWS, busca el panel de SageMaker usando la barra de búsqueda de la parte superior:
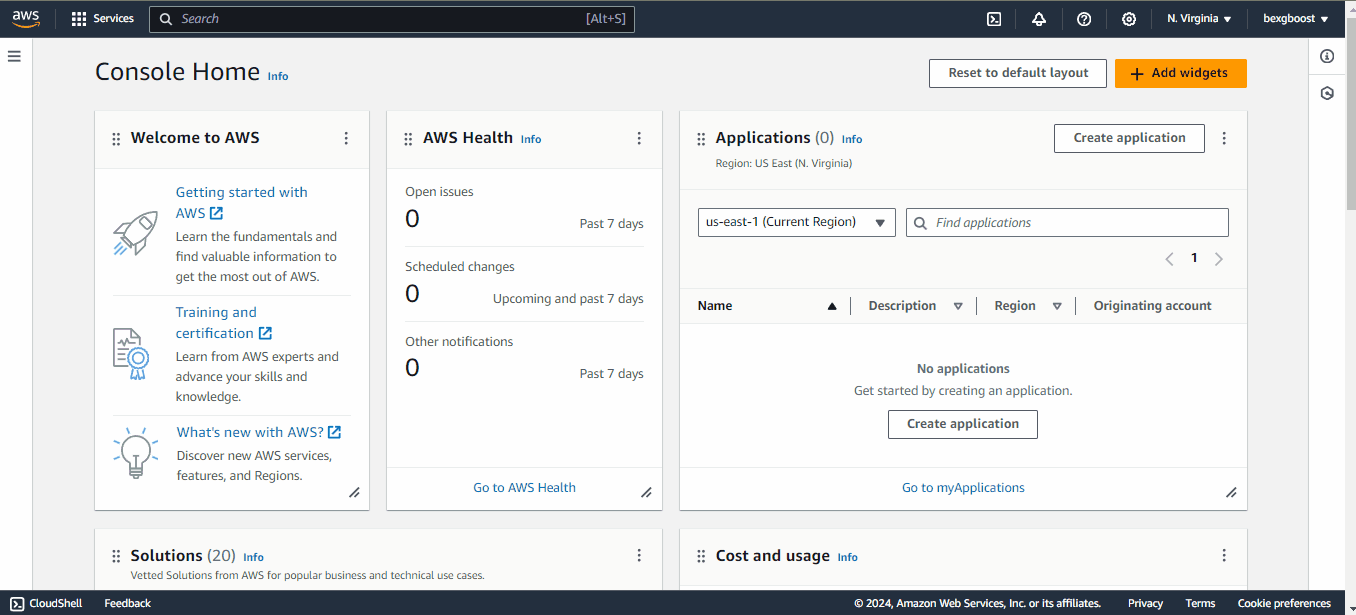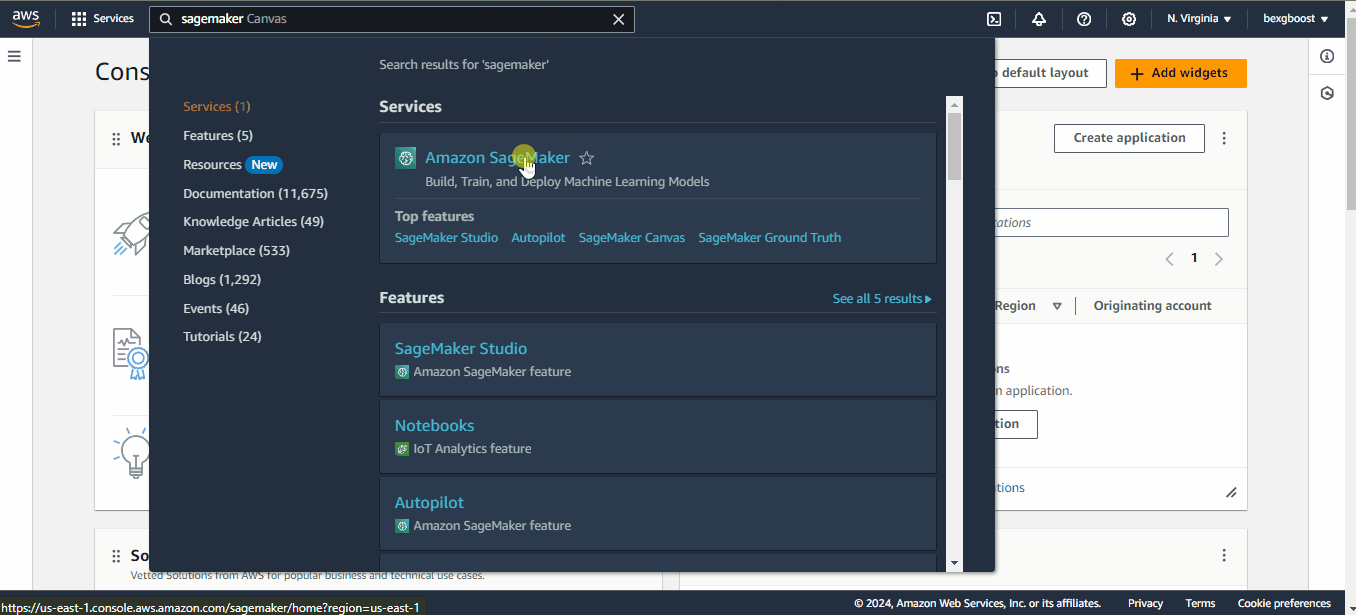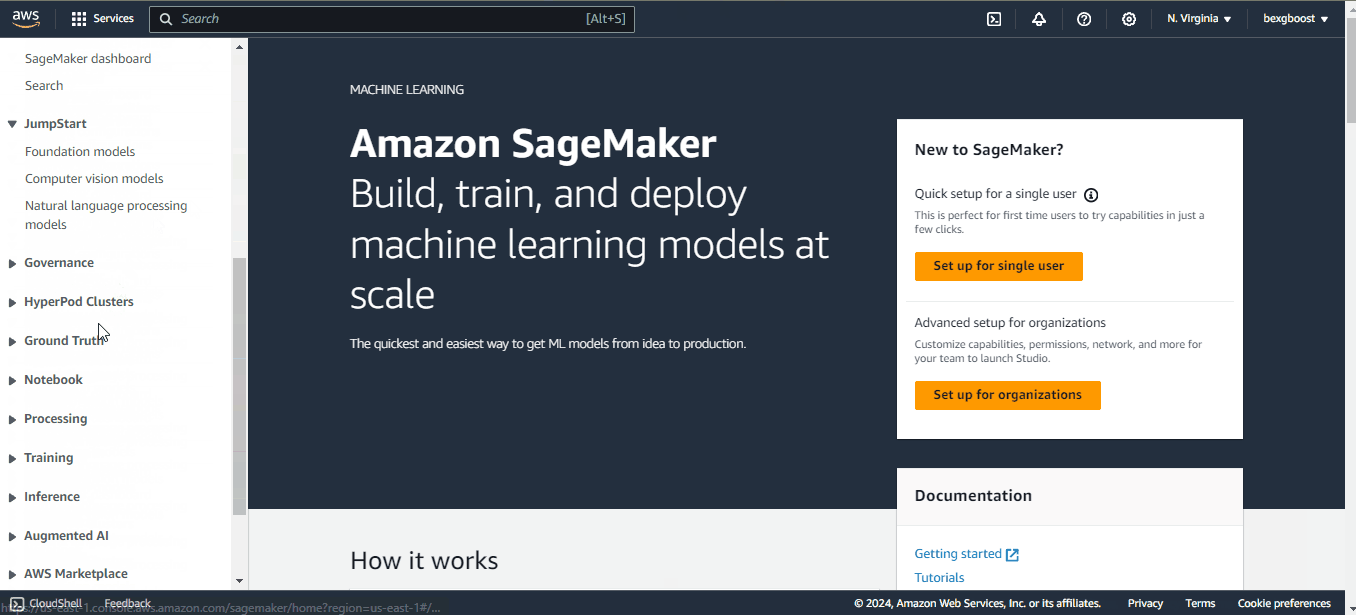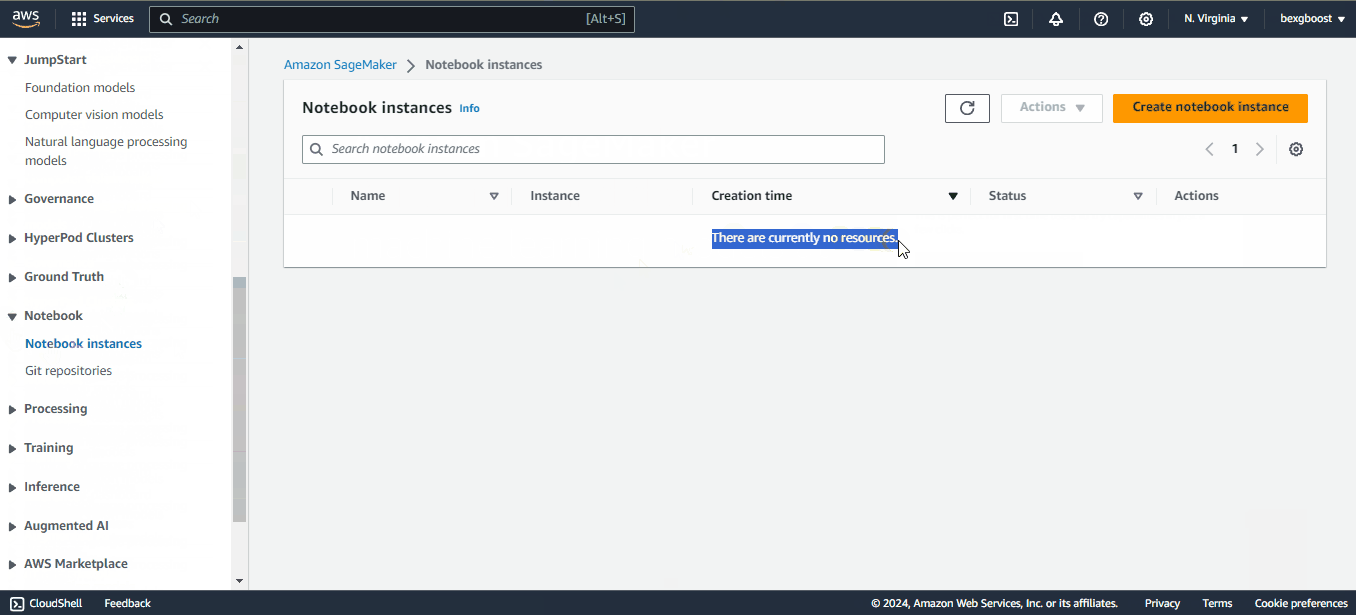
Después, desplázate hasta la pestaña “Notebooks” y dentro, la opción “Notebooks instances”. No verás instancias todavía, así que vamos a crear una:
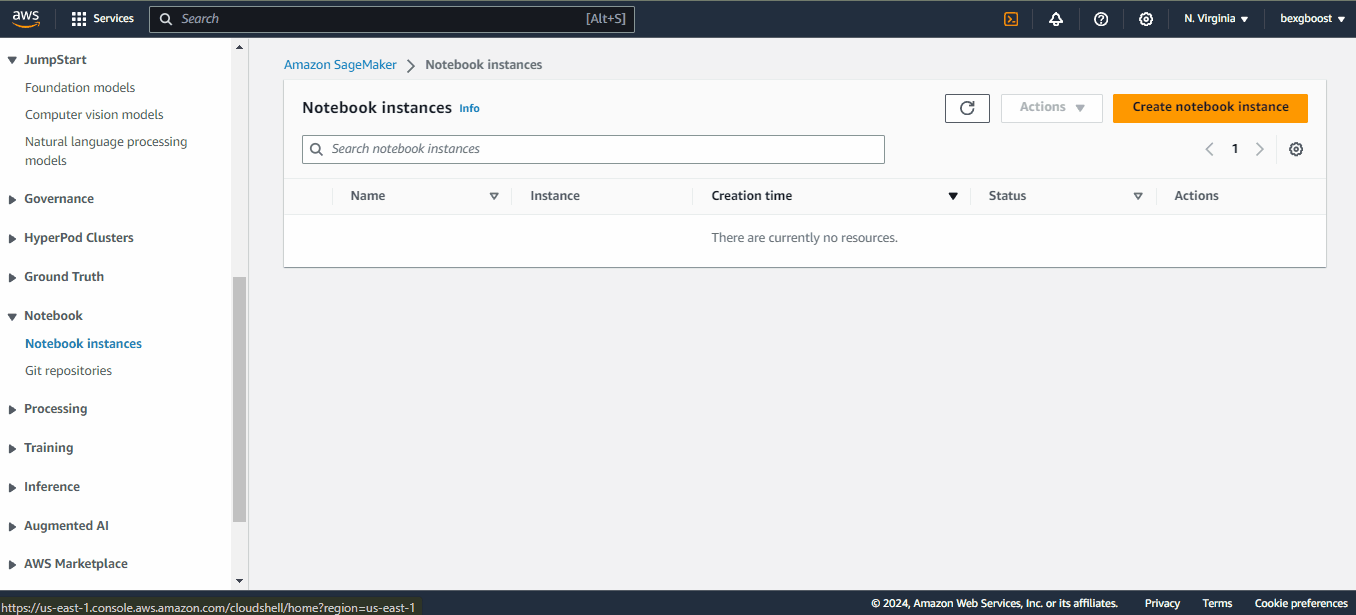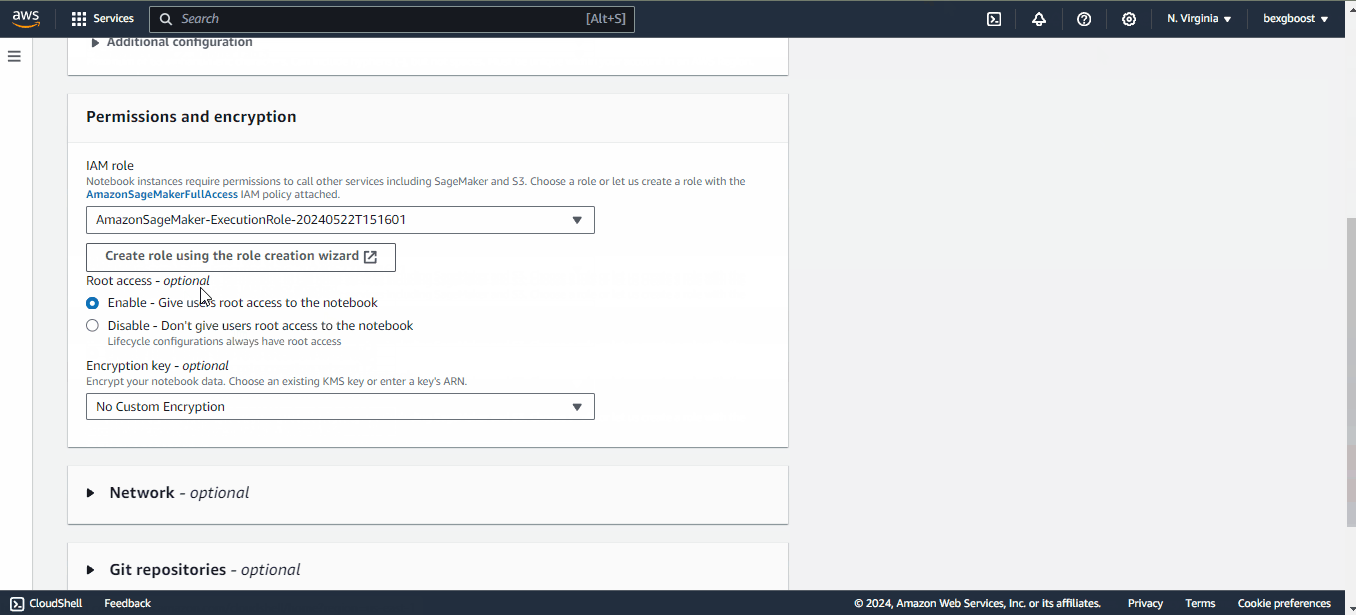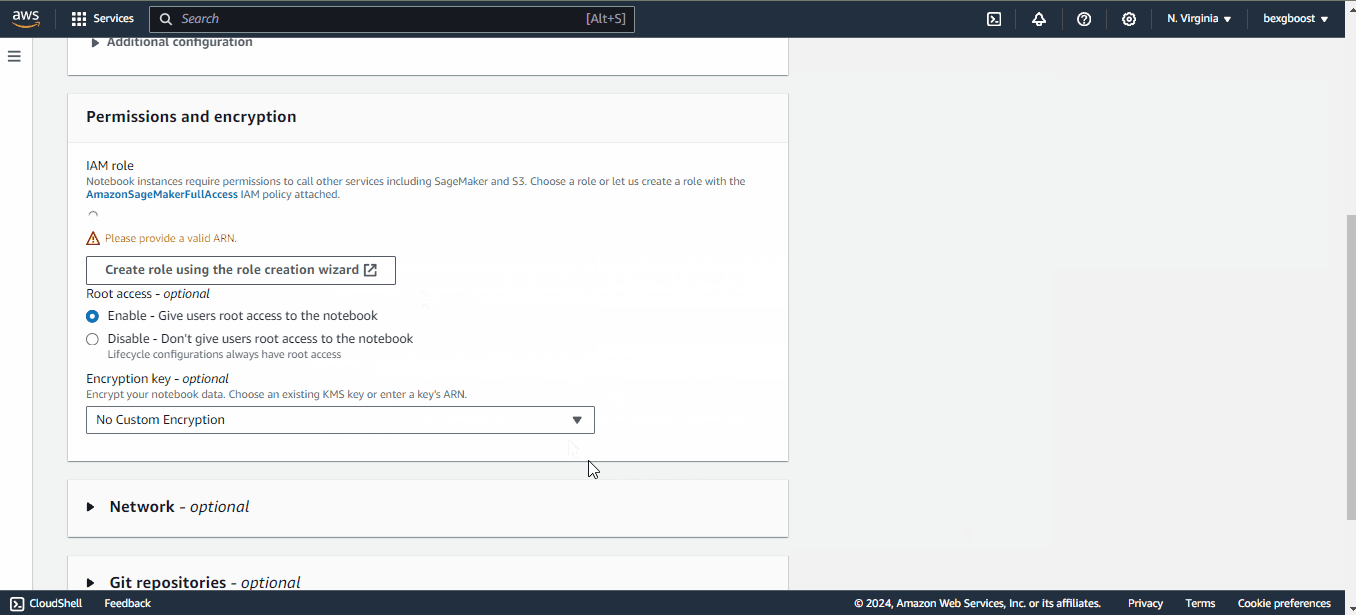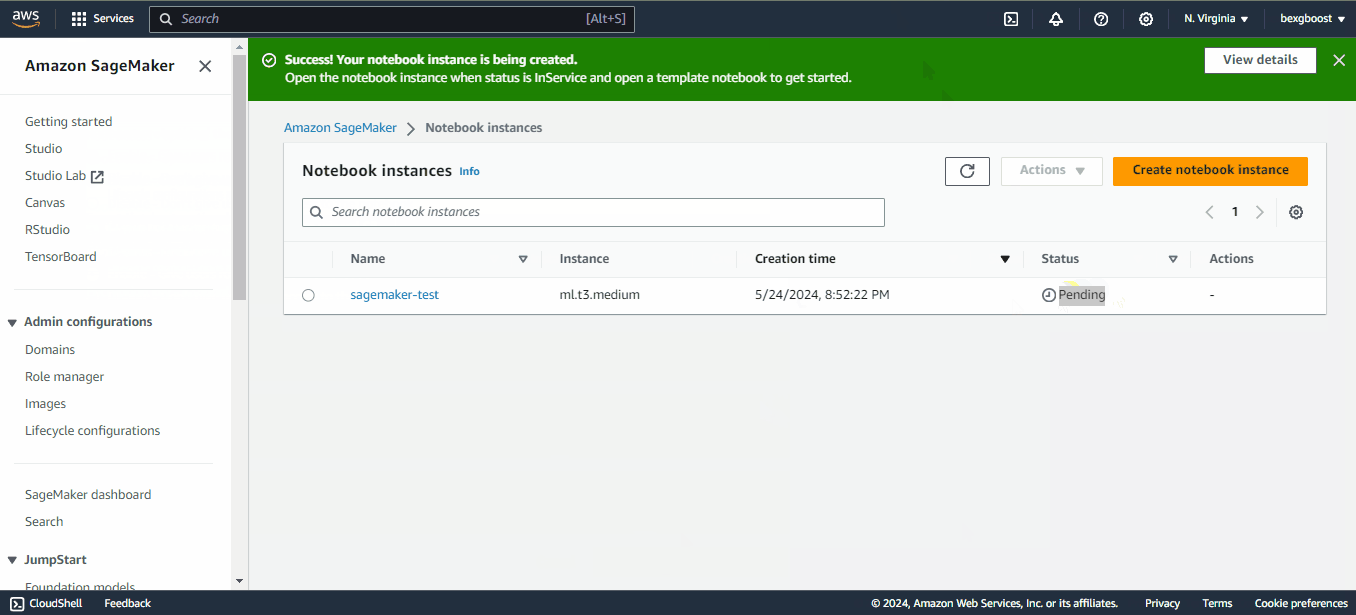
Para crear un nuevo notebook, haz clic en “Create notebook instance” en la esquina superior derecha. Luego completa estos campos:
sagemaker-test.Cuando completes la información requerida, haz clic en “Create notebook instance”.
Cuando el estado pase de “Pending” a “inService”, puedes abrir JupyterLab haciendo clic en el enlace “Open in JupyterLab” junto al notebook:
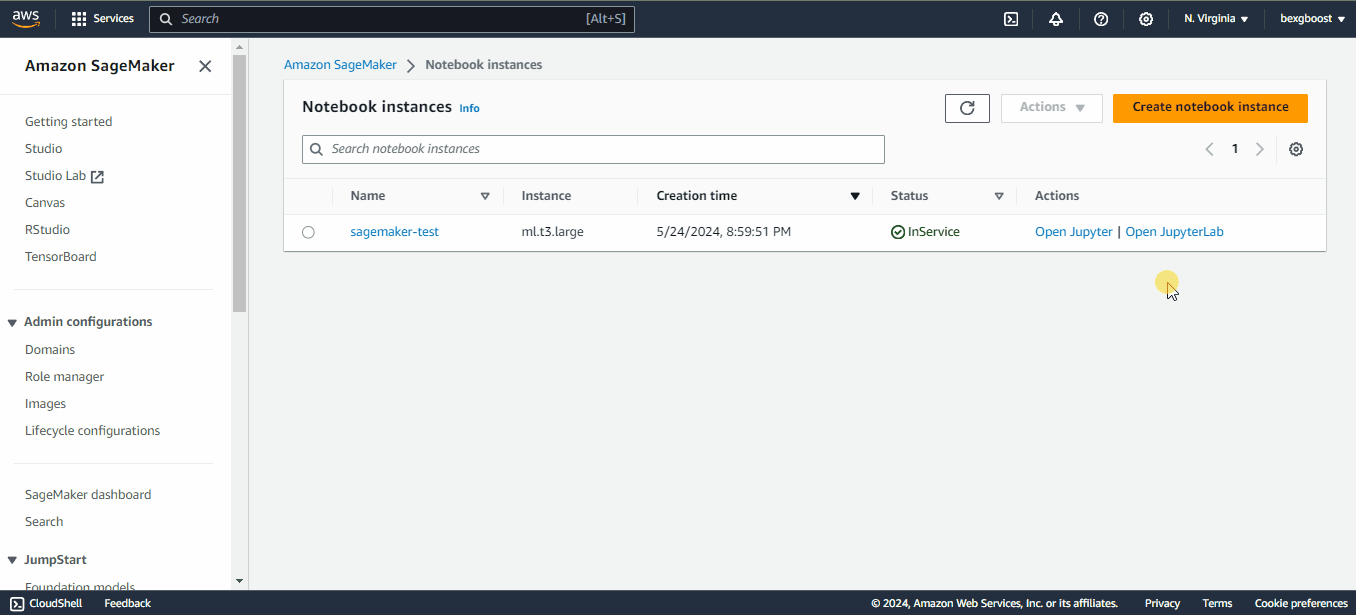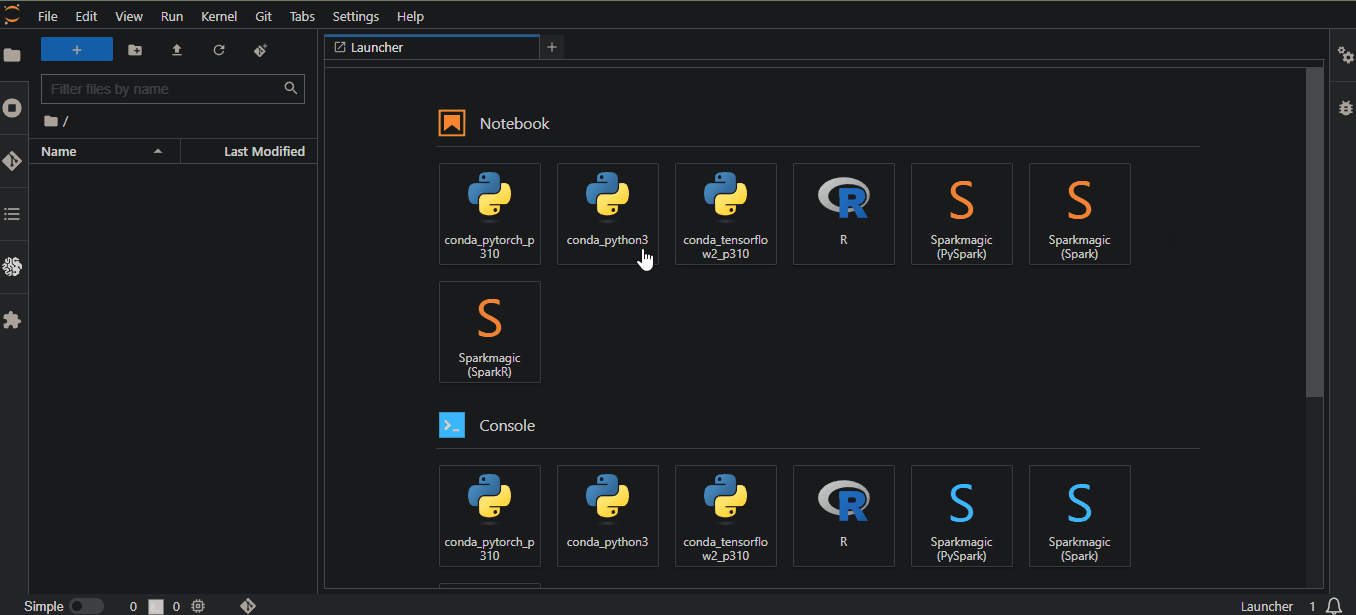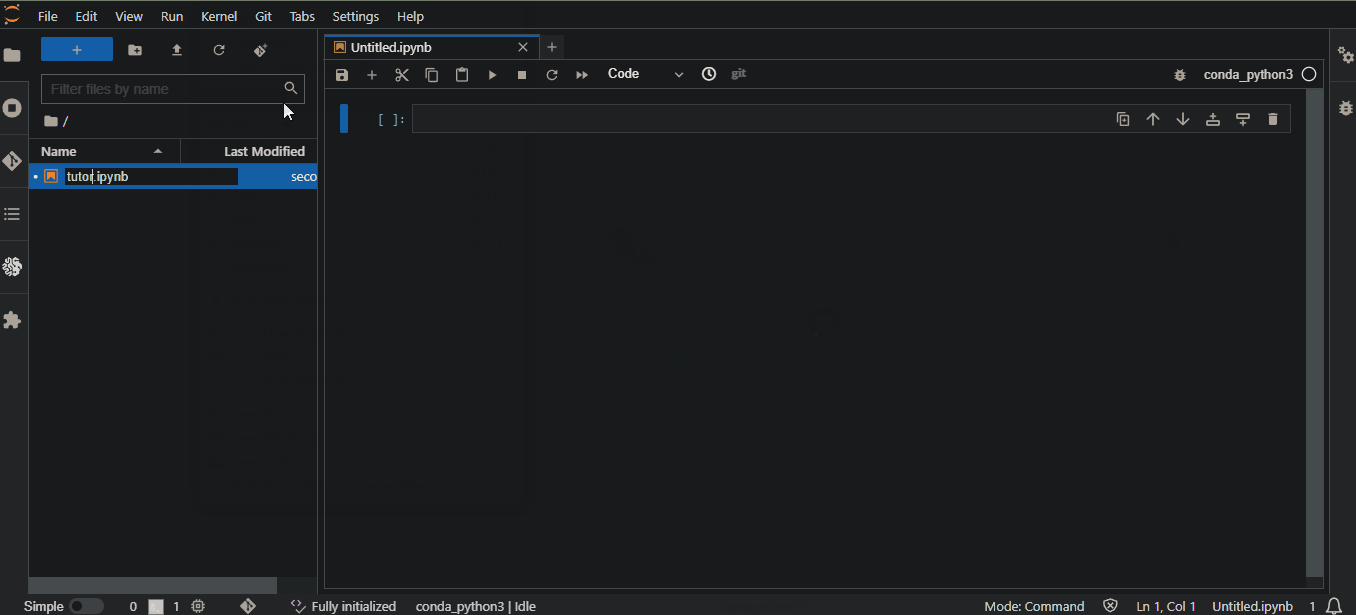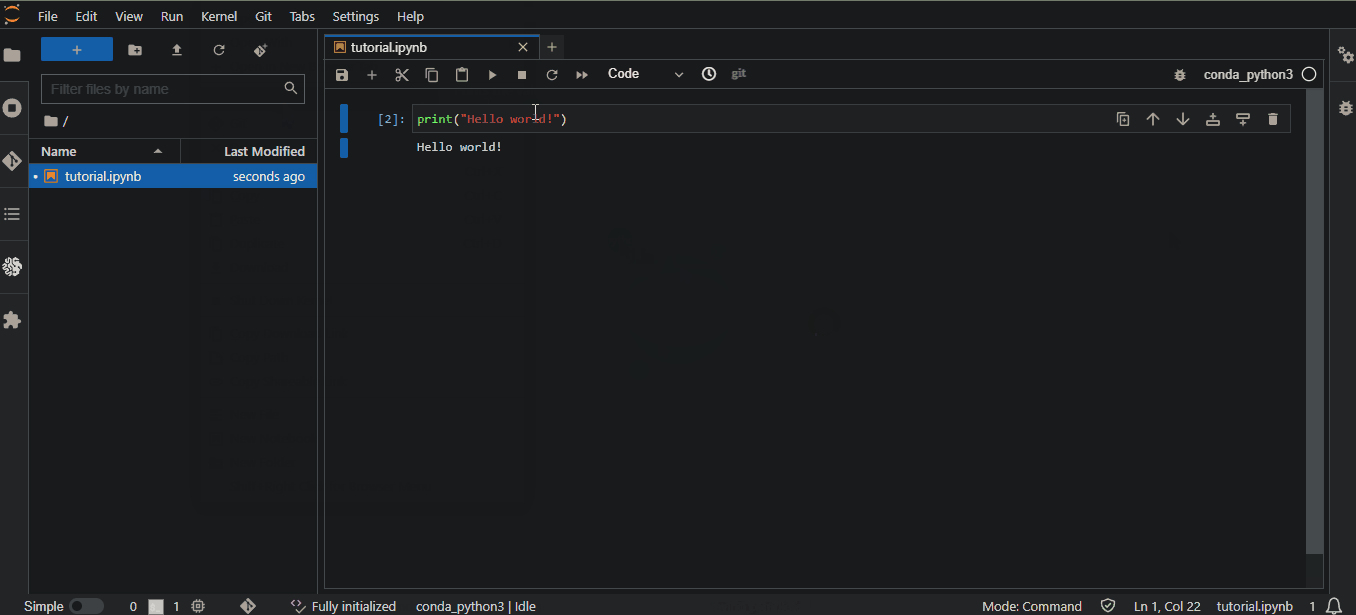
En cuanto la instancia está en servicio, el contador empieza y la facturación también. Si vas a hacer una pausa, no olvides detener la instancia en “Actions” > “Stop” para evitar costes innecesarios. El apagado por inactividad es de dos horas por defecto:
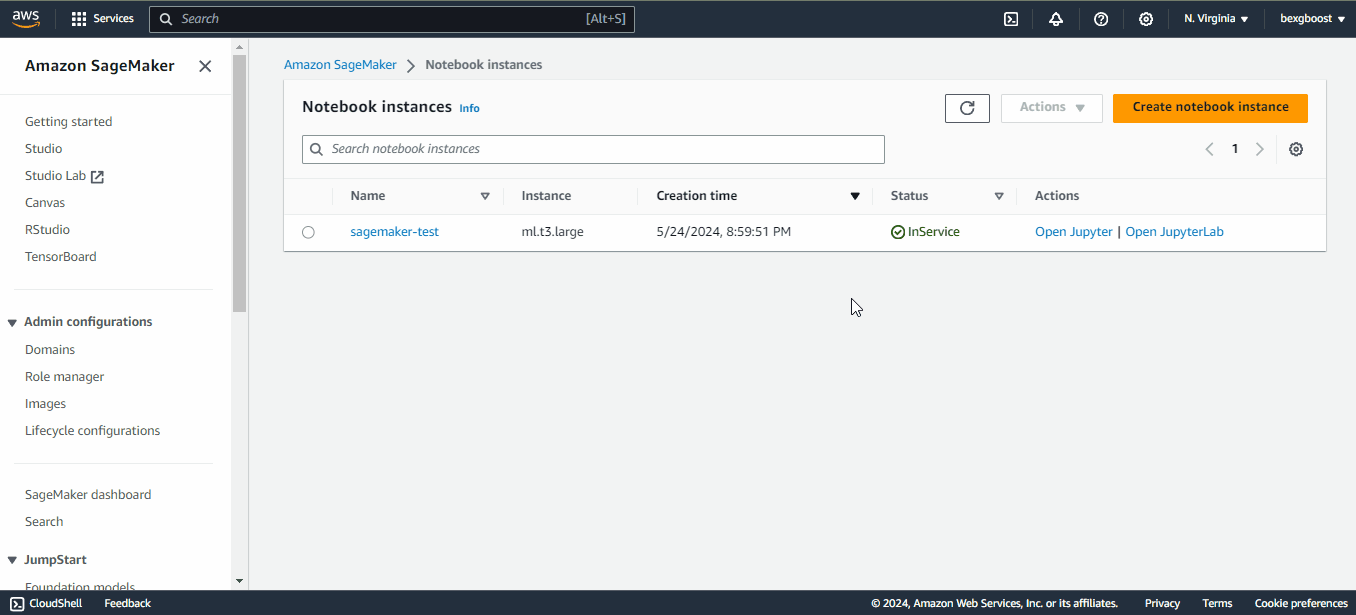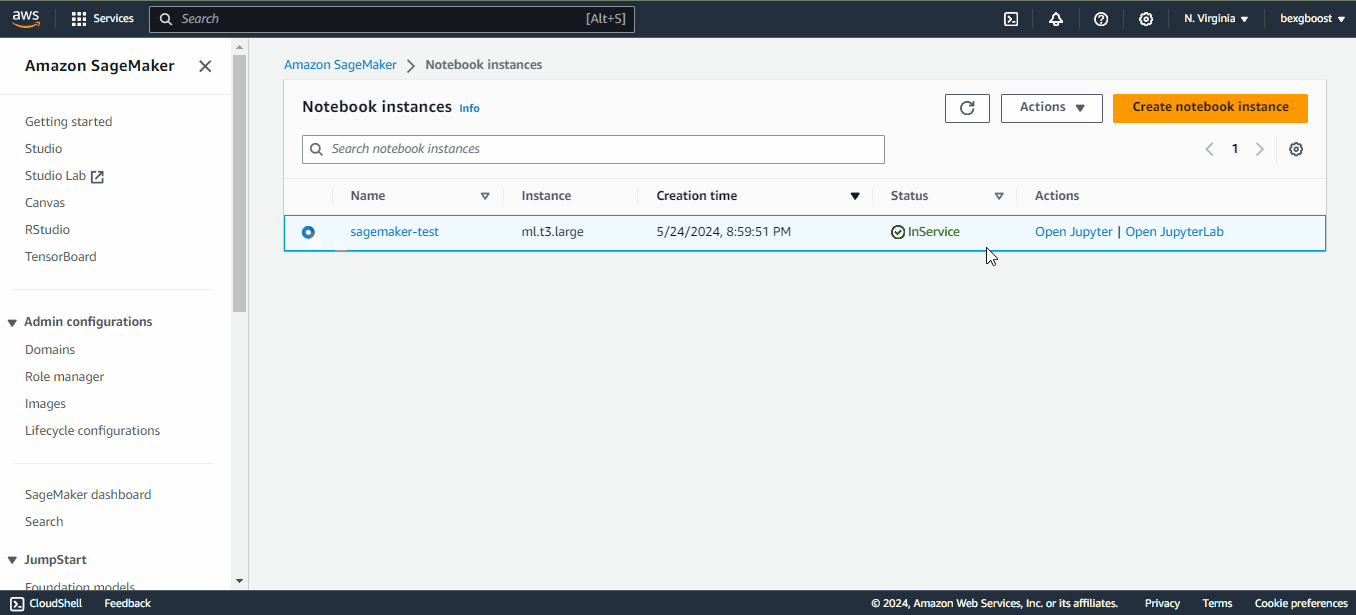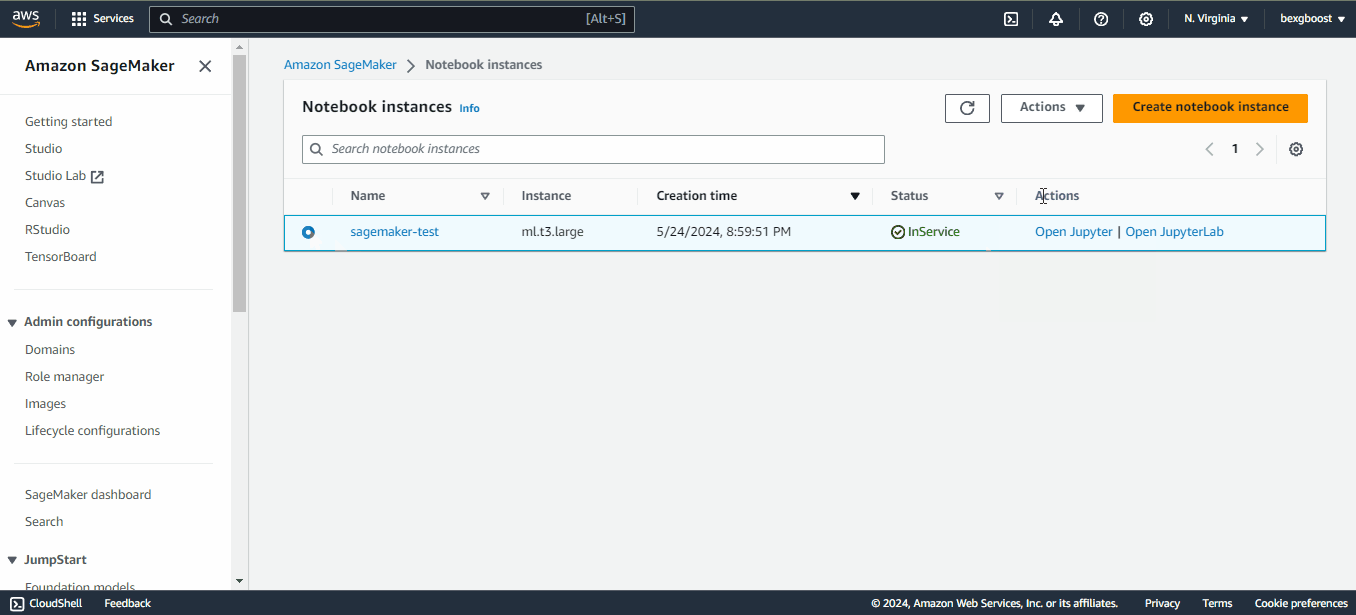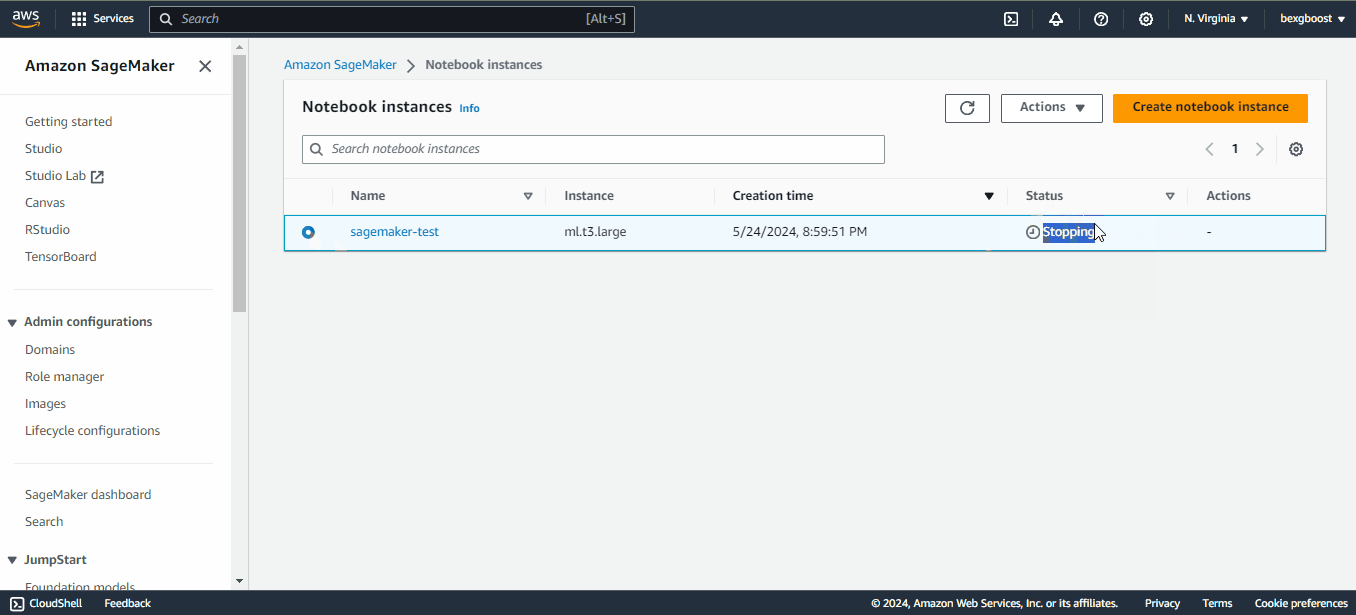
Si detienes una instancia de notebook, podrás reiniciarla más tarde. Tu entorno se conservará.
En esta sección aprenderás a subir un archivo local a los servidores de Amazon, requisito necesario para SageMaker.
Crearemos un clasificador multiclase usando el Dry Bean dataset del repositorio de UCI ML. Contiene 13k instancias de judías y 15 medidas numéricas.
La tarea consiste en clasificarlas en siete tipos de judías: Seker, Barbunya, Bombay, Cali, Dermosan, Horoz y Sira.
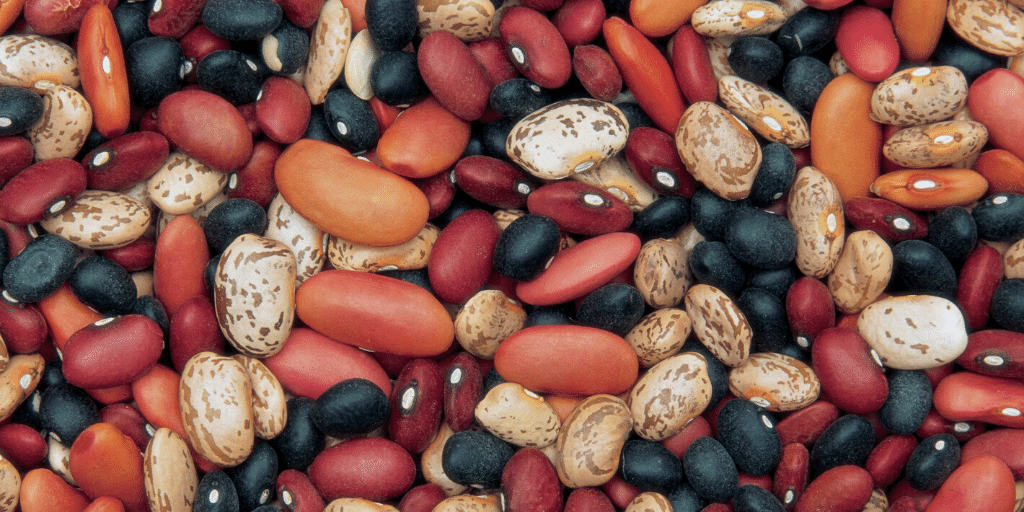
Los siete tipos de judías: Seker, Barbunya, Bombay, Cali, Dermosan, Horoz y Sira.
Tras la descarga, guarda el archivo de Excel dentro del ZIP en tu directorio local de datos en JupyterLab y añade este código a tu notebook:
from pathlib import Path

cwd = Path.cwd()
data_path = cwd / "data" / "Dry_Bean_Dataset.xlsx"
Luego, con el siguiente código, leemos el Excel con pandas y lo guardamos como CSV:
import pandas as pd

beans = pd.read_excel(data_path)
beans.to_csv(cwd / "data" / "dry_bean.csv", index=False)Nuestro dataset debe estar en un bucket de S3 para que SageMaker pueda acceder a él. AWS S3 es una solución de almacenamiento en la nube que te permite guardar objetos de tus proyectos en buckets alojados en los servidores de Amazon.
Para crear un bucket, sigue estos pasos:
dry-bean-bucket como yo.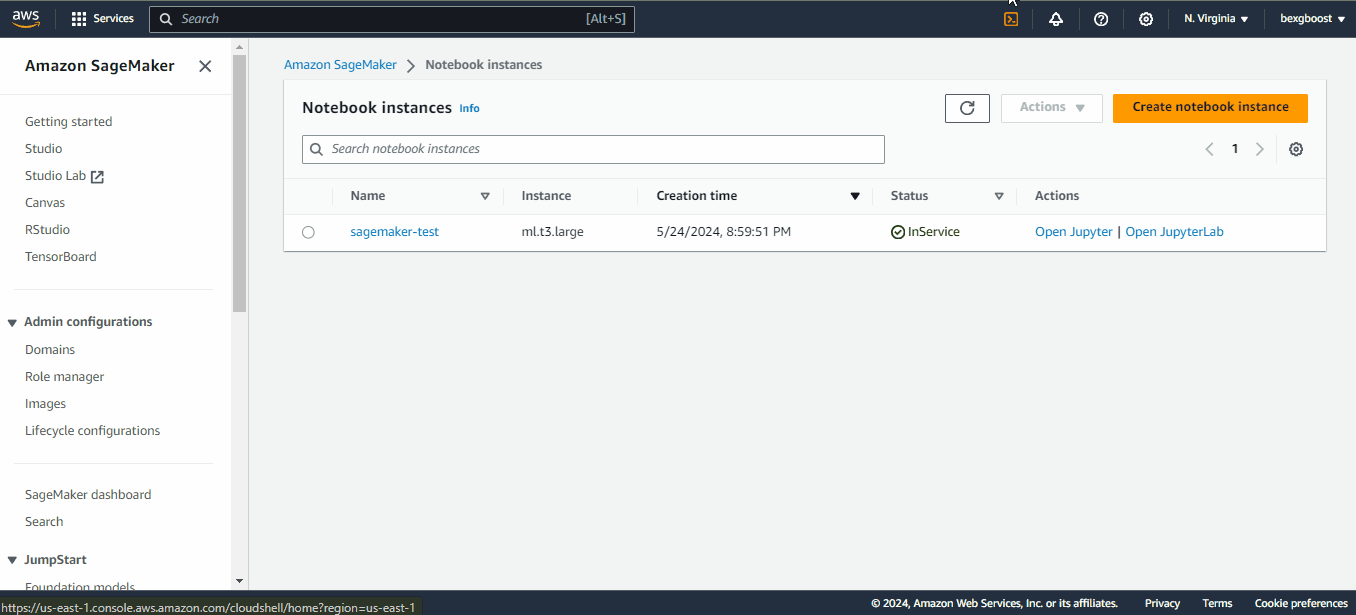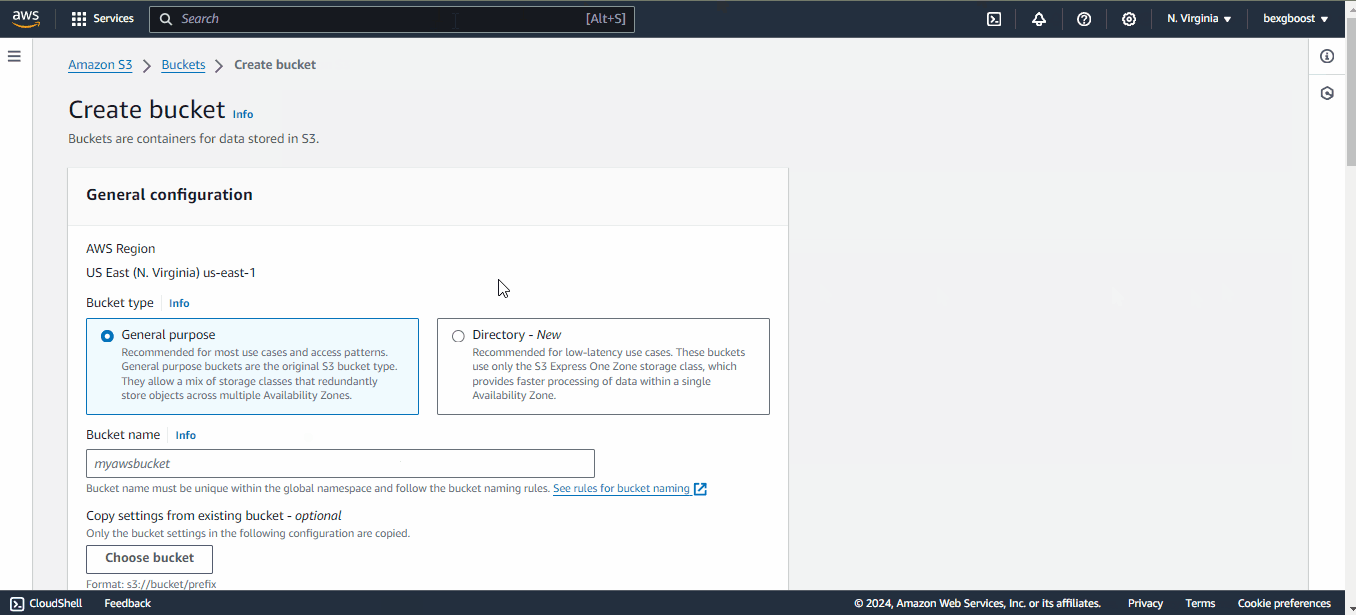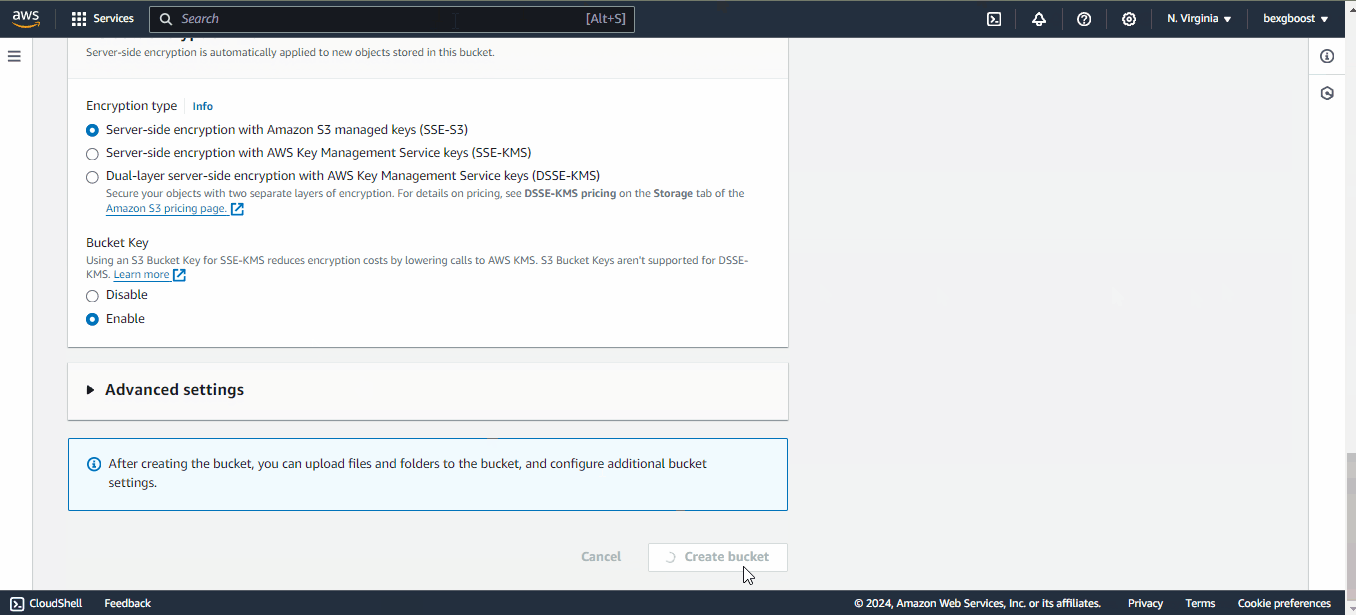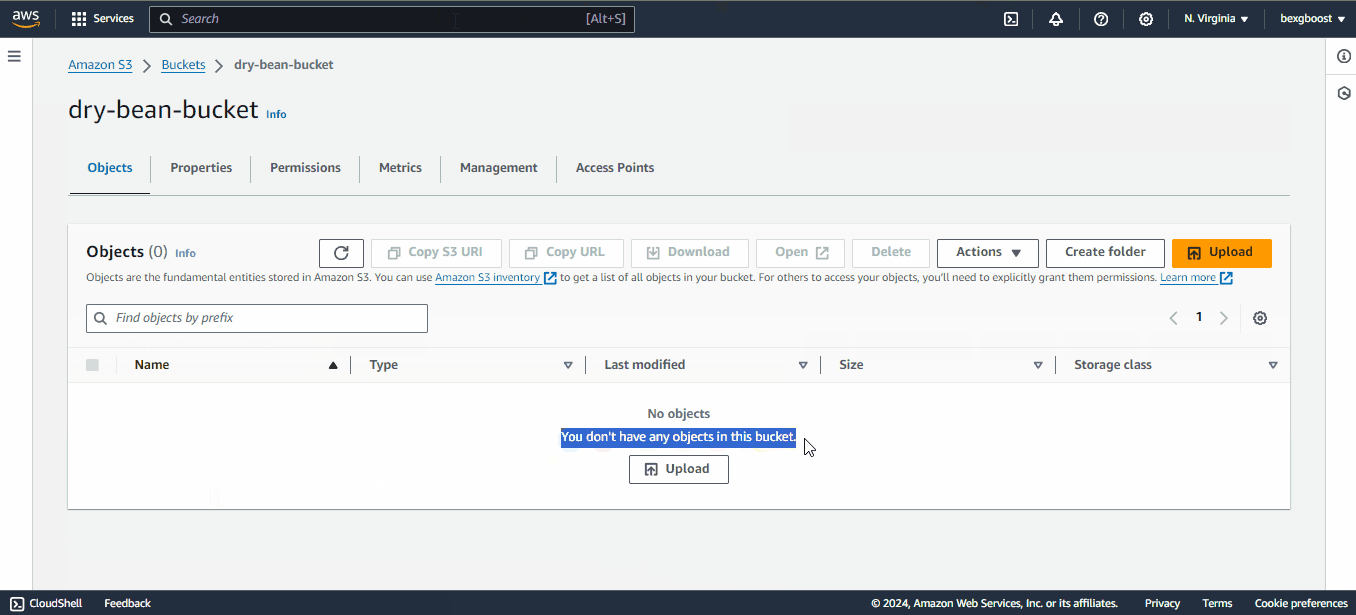
Una vez creado, haz clic en el bucket para subir el CSV que guardamos antes:
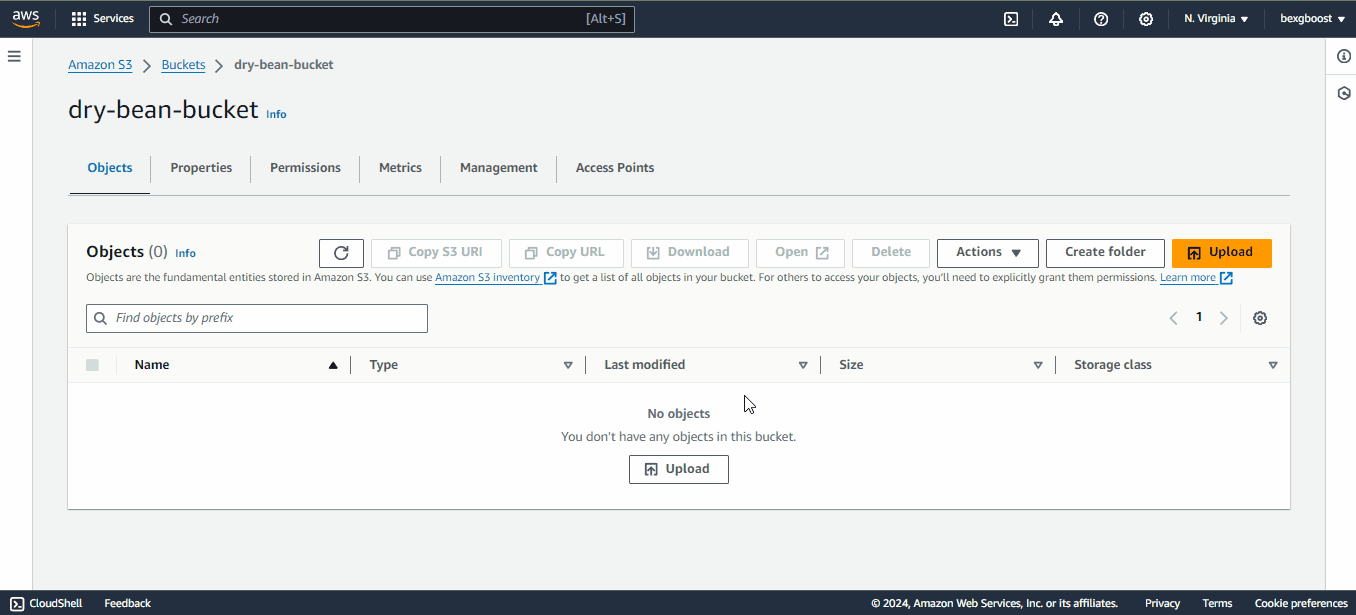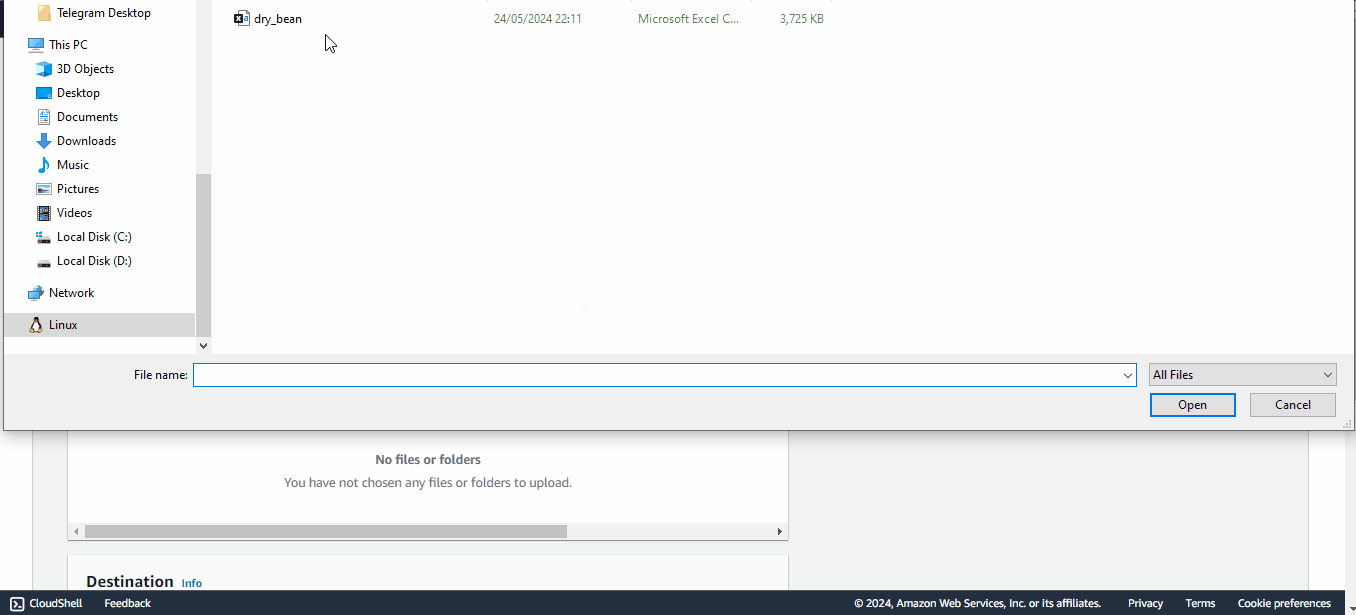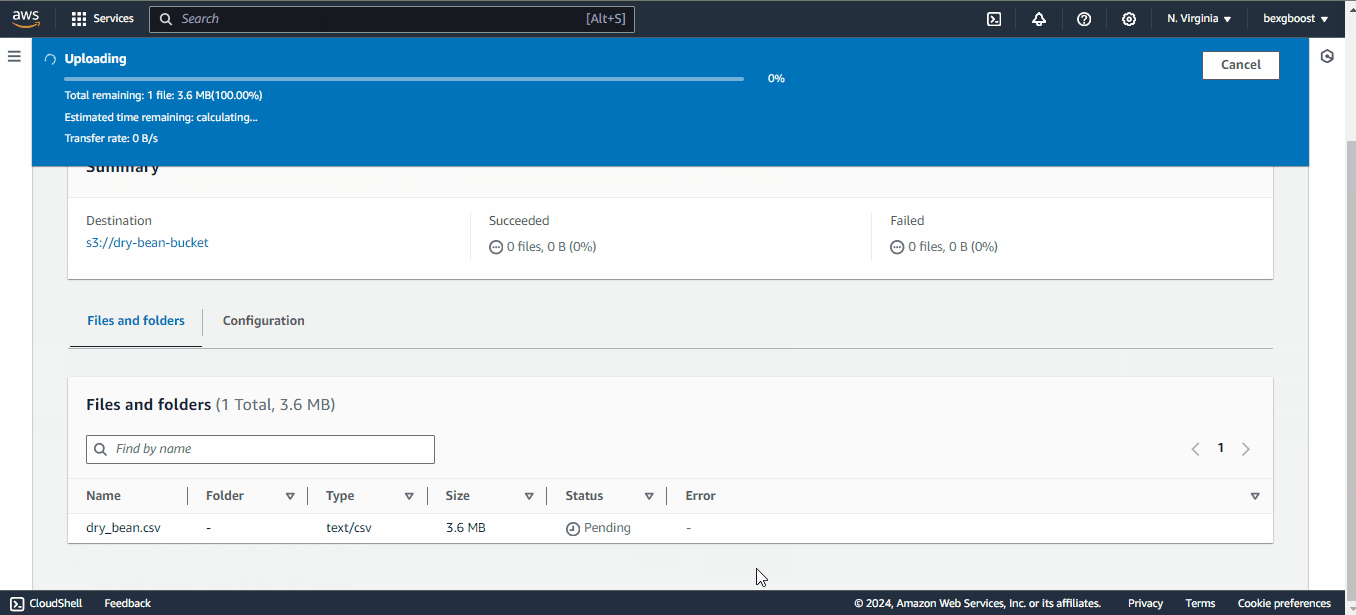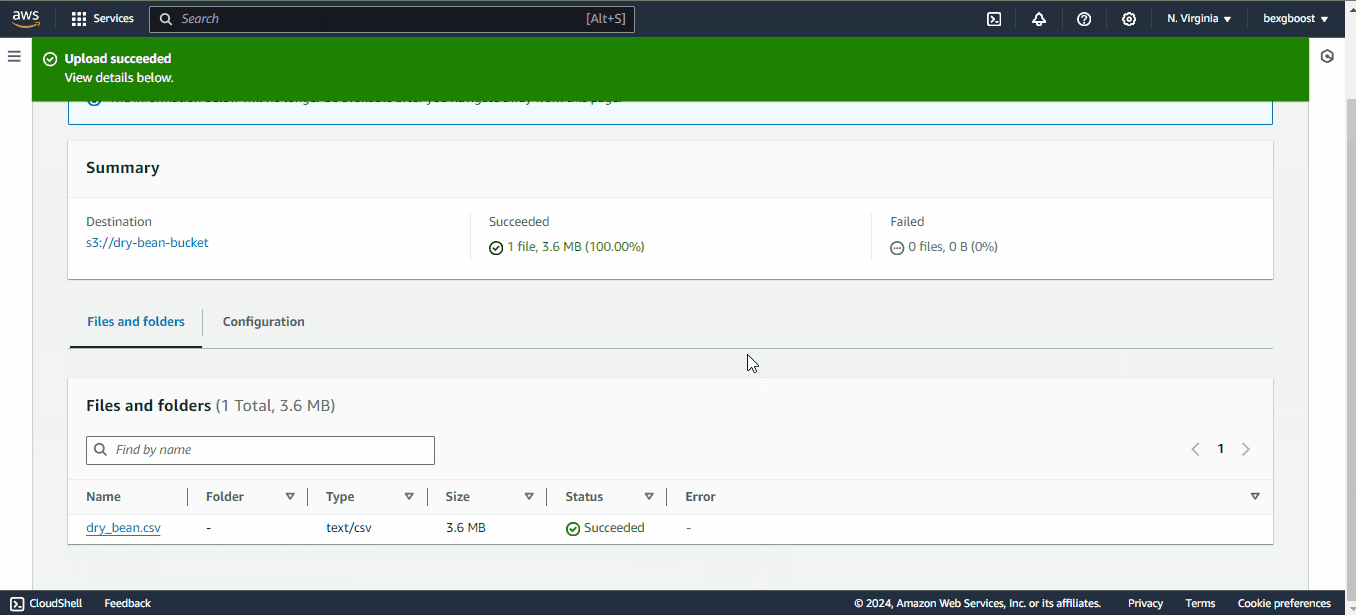
Después, vuelve a la interfaz de JupyterLab porque por fin vamos a ejecutar algo de código.
En esta sección, recorreremos un flujo completo que nos llevará de un dataset en CSV a un modelo desplegado en un endpoint. Pero antes de entrar en los detalles técnicos, veamos primero la vista general de lo que haremos.
Hacer machine learning en SageMaker es un poco diferente a hacerlo en tu máquina local. Ya hemos cubierto los primeros pasos:
Igual que en tus notebooks locales, las instancias de notebook de SageMaker sirven para el análisis exploratorio: limpieza, exploración, ingesta de datos y experimentación básica.
Cuando llegas a la fase de entrenamiento, SageMaker espera que sigas sus reglas. En concreto, para desplegar tus modelos personalizados como endpoints, requiere un script de entrenamiento que haga lo siguiente:
El script también debe aceptar variables dinámicamente como argumentos de línea de comandos. Así, cualquier cosa que quieras cambiar en el futuro dentro del script debe definirse como argumento (hiperparámetros, rutas de archivos, etc.).
Una vez listo, este script se pasa a estimadores especiales de SageMaker. Son complementos para librerías de ML populares como scikit-learn, XGBoost, TensorFlow, PyTorch, etc. Con estos estimadores, SageMaker construye contenedores de Docker alrededor de tu script y lo despliega como endpoint para servirlo a escala.
Todo lo anterior irá cobrando sentido a medida que avancemos paso a paso.
Empecemos importando las librerías necesarias en el notebook sagemaker-test que creaste antes:
import boto3
import numpy as np
import pandas as pd
import sagemaker
from sagemaker import get_execution_role
from sklearn.model_selection import train_test_split
Esto es lo que hacen algunas de estas importaciones:
sagemaker es el SDK oficial de Python para entrenar y desplegar modelos en Amazon SageMaker. Con el SDK puedes entrenar y desplegar usando frameworks de deep learning populares, algoritmos de Amazon o tus propios algoritmos en imágenes Docker compatibles con SageMaker.boto3 es otro SDK oficial de Python, pero actúa como puente entre tu código y todos los servicios de AWS, no solo SageMaker. Puedes aprender más en este curso sobre boto3.Tras las importaciones, creemos algunos recursos que usaremos durante el tutorial:
sm_boto3 = boto3.client("sagemaker")
sess = sagemaker.Session()boto3.Ambos objetos nos permiten interactuar con la plataforma SageMaker de distintas formas.
Ahora definamos algunas variables globales que necesitaremos:
region = sess.boto_session.region_name
BUCKET_URI = "s3://dry-bean-bucket"
BUCKET_NAME = "dry-bean-bucket"
DATASET_PATH = f"{BUCKET_URI}/dry_bean.csv"
TARGET_NAME = "Class"
Estas variables se explican por sí solas y las usaremos a lo largo del tutorial.
En la mayoría de proyectos, el dataset de entrenamiento estará en un almacenamiento en la nube como BigQuery, GCS o un bucket de AWS S3. Nosotros lo guardamos en este último, así que carguémoslo con pandas. Añade y ejecuta este código en tu notebook:
dry_bean = pd.read_csv(DATASET_PATH)
dry_bean.head()
Una ventaja de trabajar en un notebook de SageMaker es que podemos leer archivos de S3 directamente con pandas. Todos los entornos de SageMaker están configurados con tus credenciales para que pandas pueda descargar el CSV del bucket. Este código no funcionaría si lo ejecutases en local.
Dedicar tiempo al análisis exploratorio de datos (EDA) debe ser parte de cualquier proyecto, y este no es la excepción. Aun así, no haremos un análisis profundo para no desviarnos del tema principal.
Nos conformaremos con imprimir algunas estadísticas y gráficos resumidos:
dry_bean.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 13611 entries, 0 to 13610
Data columns (total 17 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Area 13611 non-null int64
1 Perimeter 13611 non-null float64
2 MajorAxisLength 13611 non-null float64
3 MinorAxisLength 13611 non-null float64
4 AspectRation 13611 non-null float64
5 Eccentricity 13611 non-null float64
6 ConvexArea 13611 non-null int64
7 EquivDiameter 13611 non-null float64
8 Extent 13611 non-null float64
9 Solidity 13611 non-null float64
10 roundness 13611 non-null float64
11 Compactness 13611 non-null float64
12 ShapeFactor1 13611 non-null float64
13 ShapeFactor2 13611 non-null float64
14 ShapeFactor3 13611 non-null float64
15 ShapeFactor4 13611 non-null float64
16 Class 13611 non-null object
dtypes: float64(14), int64(2), object(1)
memory usage: 1.8+ MBLa información anterior nos indica que hay 16 variables numéricas y una única variable objetivo llamada Class. El dataset es pequeño, con solo 13k instancias, así que no necesitaremos máquinas potentes ni gastar mucho para entrenar un modelo.
Ahora, creemos un pair plot de algunas características con seaborn:
import seaborn as sns

sns.pairplot(
   dry_bean,
   vars=["Area", "MajorAxisLength", "MinorAxisLength", "Eccentricity", "roundness"],
   hue="Class",
);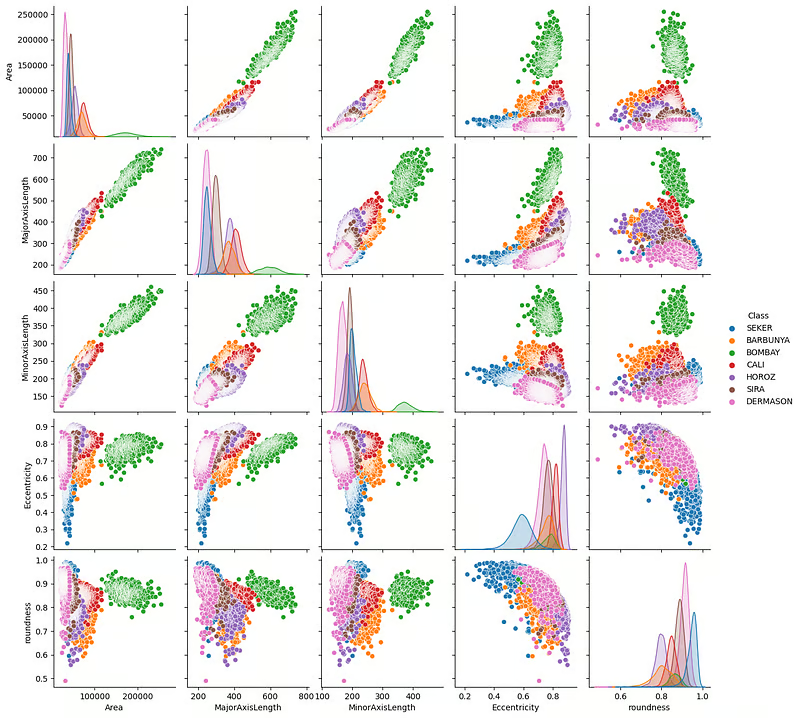
Los gráficos muestran que las judías se diferencian claramente por sus medidas físicas. Las verdes (Bombay) destacan especialmente.
También podemos trazar una matriz de correlación para ver relaciones entre variables:
import matplotlib.pyplot as plt

correlation = dry_bean.corr(numeric_only=True)

# Crear un mapa de calor cuadrado centrado en 0
sns.heatmap(correlation, center=0, square=True, cmap="coolwarm", vmin=-1, vmax=1)
plt.show()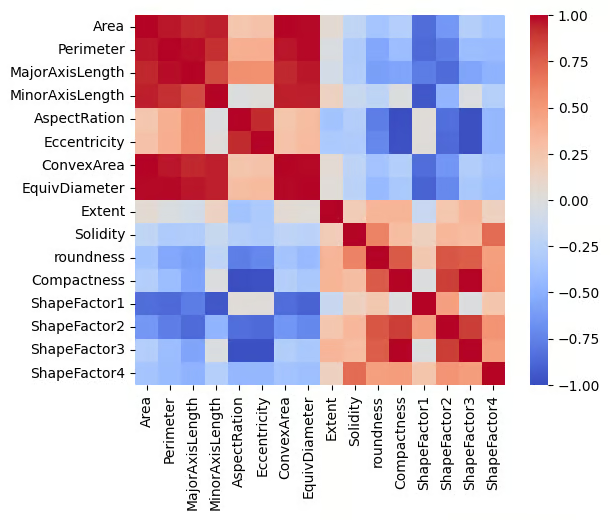
Se observan muchas características perfectamente correlacionadas (positiva y negativamente), lo cual tiene sentido al tratarse de medidas físicas.
A partir de aquí, te dejo continuar con la exploración.
Tras la exploración, debes resolver cualquier problema de calidad o lógica en tu dataset y crear nuevas características si es necesario antes de entrenar.
El dataset de Dry Bean está bastante limpio, así que será sencillo. Solo necesitamos codificar la variable objetivo porque contiene texto. Usaremos scikit-learn para ello:
from sklearn.preprocessing import LabelEncoder

# Para el preprocesado
df = dry_bean.copy(deep=True)

# Codificar la variable objetivo
le = LabelEncoder()
df[TARGET_NAME] = le.fit_transform(df[TARGET_NAME])
Cuando terminemos el preprocesado, debemos dividir el dataset:
from sklearn.model_selection import train_test_split

# Dividir los datos en dos conjuntos
train, test = train_test_split(df, random_state=1, test_size=0.2)
Puedes dividirlo además en un tercer conjunto de validación si lo prefieres, pero lo mantendremos simple.
Ahora guardemos los conjuntos como CSV:
train.to_csv("dry-bean-train.csv")
test.to_csv("dry-bean-test.csv")
Y súbelos a nuestro bucket de S3:
# Enviar datos a S3. SageMaker tomará los datos de entrenamiento de S3
trainpath = sess.upload_data(
   path="dry-bean-train.csv",
   bucket=BUCKET_NAME,
   key_prefix="sagemaker/sklearncontainer",
)

testpath = sess.upload_data(
   path="dry-bean-test.csv",
   bucket=BUCKET_NAME,
   key_prefix="sagemaker/sklearncontainer",
)
La función .upload_data() de la sesión devuelve la ruta completa del archivo subido, que se guarda en las variables trainpath y testpath. Las usaremos más adelante.
En una celda nueva del notebook, pega el siguiente código:
%%writefile script.py

import argparse
import os
import joblib
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import balanced_accuracy_score

if __name__ == "__main__":
   print("extracting arguments")
   parser = argparse.ArgumentParser()

   # Hyperparameters sent by the client are passed as command-line arguments to the script.
   parser.add_argument("--n-estimators", type=int, default=10)
   parser.add_argument("--min-samples-leaf", type=int, default=3)

   # Data, model, and output directories
   parser.add_argument("--model-dir", type=str, default=os.environ.get("SM_MODEL_DIR"))
   parser.add_argument("--train", type=str, default=os.environ.get("SM_CHANNEL_TRAIN"))
   parser.add_argument("--test", type=str, default=os.environ.get("SM_CHANNEL_TEST"))
   parser.add_argument("--train-file", type=str, default="dry-bean-train.csv")
   parser.add_argument("--test-file", type=str, default="dry-bean-test.csv")
   args, _ = parser.parse_known_args()

   print("reading data")

   train_df = pd.read_csv(os.path.join(args.train, args.train_file))
   test_df = pd.read_csv(os.path.join(args.test, args.test_file))

   print("building training and testing datasets")

   X_train = train_df.drop("Class", axis=1)
   X_test = test_df.drop("Class", axis=1)
   y_train = train_df[["Class"]]
   y_test = test_df[["Class"]]

   # Train model
   print("training model")

   model = RandomForestClassifier(
       n_estimators=args.n_estimators,
       min_samples_leaf=args.min_samples_leaf,
       n_jobs=-1,
   )

   model.fit(X_train, y_train)

   # Print abs error
   print("validating model")

   bal_acc_train = balanced_accuracy_score(y_train, model.predict(X_train))
   bal_acc_test = balanced_accuracy_score(y_test, model.predict(X_test))

   print(f"Train balanced accuracy: {bal_acc_train:.3f}")
   print(f"Test balanced accuracy: {bal_acc_test:.3f}")

   # Persist model
   path = os.path.join(args.model_dir, "model.joblib")
   joblib.dump(model, path)
   print("model persisted at " + path)
El comando mágico %%writefile script.py convierte el contenido de la celda en un script de Python en lugar de ejecutarlo.
Ahora, repasemos lo que ocurre en el script paso a paso:
import argparse
import os
import joblib
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import balanced_accuracy_score
Primero importamos las librerías necesarias.
if __name__ == "__main__":
   print("extracting arguments")
   parser = argparse.ArgumentParser()

   # Hyperparameters sent by the client are passed as command-line arguments to the script.
   parser.add_argument("--n-estimators", type=int, default=10)
   parser.add_argument("--min-samples-leaf", type=int, default=3)

   # Data, model, and output directories
   parser.add_argument("--model-dir", type=str, default=os.environ.get("SM_MODEL_DIR"))
   parser.add_argument("--train", type=str, default=os.environ.get("SM_CHANNEL_TRAIN"))
   parser.add_argument("--test", type=str, default=os.environ.get("SM_CHANNEL_TEST"))
   parser.add_argument("--train-file", type=str, default="dry-bean-train.csv")
   parser.add_argument("--test-file", type=str, default="dry-bean-test.csv")
   args, _ = parser.parse_known_args()
A continuación, creamos un parser de argumentos para leer los parámetros de línea de comandos. Como decía, cualquier valor que pueda cambiar en el futuro debe pasarse como argumento. Esta sección define esos argumentos:
Si te fijas en los valores por defecto de los directorios model-dir, train y test, verás variables de entorno. Se toman de la documentación del SDK de SageMaker, que también explica cómo escribir estos scripts.
print("reading data")
train_df = pd.read_csv(os.path.join(args.train, args.train_file))
test_df = pd.read_csv(os.path.join(args.test, args.test_file))
print("building training and testing datasets")
X_train = train_df.drop("Class", axis=1)
X_test = test_df.drop("Class", axis=1)
y_train = train_df[["Class"]]
y_test = test_df[["Class"]]
Una vez definidos los valores dinámicos, leemos y construimos los conjuntos de entrenamiento y test. En lugar de rutas fijas, usamos los valores de args.argument.
# Train model
print("training model")

model = RandomForestClassifier(
    n_estimators=args.n_estimators,
    min_samples_leaf=args.min_samples_leaf,
    n_jobs=-1,
)

model.fit(X_train, y_train)

# Print abs error
print("validating model")

bal_acc_train = balanced_accuracy_score(y_train, model.predict(X_train))
bal_acc_test = balanced_accuracy_score(y_test, model.predict(X_test))

print(f"Train balanced accuracy: {bal_acc_train:.3f}")
print(f"Test balanced accuracy: {bal_acc_test:.3f}")
Ajustamos el modelo, lo evaluamos en entrenamiento y test, y mostramos el rendimiento.
# Persist model
path = os.path.join(args.model_dir, "model.joblib")
joblib.dump(model, path)
print("model persisted at " + path)
Por último, guardamos el modelo en el directorio indicado con joblib.
Al ejecutar esta celda, aparecerá el archivo script.py en tu entorno de JupyterLab. Puedes comprobar que funciona ejecutándolo así:
! python script.py --n-estimators 100 \

                  --min-samples-leaf 2 \

                  --model-dir ./ \

                  --train ./ \

                  --test ./ \
extracting arguments
reading data
building training and testing datasets
validating model
Train balanced accuracy: 1.000
Test balanced accuracy: 0.998
model persisted at ./modejoblibGenial, hemos logrado un 99% de balanced accuracy: difícilmente mejor. Ya podemos lanzar un trabajo de entrenamiento.
Ahora pasaremos el script a un objeto estimador de SageMaker. En el contexto de AWS, un trabajo de entrenamiento es un proceso en el que se entrena un modelo usando un algoritmo, dataset y recursos de cómputo específicos proporcionados por AWS SageMaker. A diferencia del entrenamiento en local, este trabajo se ejecuta en la nube sobre una infraestructura escalable, con más potencia, mayor velocidad y capacidad para datasets más grandes.
Añade este código en una celda nueva:
# Usamos el Estimator del SDK de SageMaker para Python
from sagemaker.sklearn.estimator import SKLearn
FRAMEWORK_VERSION = "0.23-1"

sklearn_estimator = SKLearn(
   entry_point="script.py",
   role=get_execution_role(),
   instance_count=1,
   instance_type="ml.c5.xlarge",
   framework_version=FRAMEWORK_VERSION,
   base_job_name="rf-scikit",
   hyperparameters={
       "n-estimators": 100,
       "min-samples-leaf": 3,
   },
)
En el código anterior, la clase SKLearn gestiona scripts de scikit‑learn. Parámetros clave:
entry_point: ruta al script.role: el rol de usuario con acceso a SageMaker.instance_count: número de máquinas a arrancar.instance_type: tipo de máquina.En hiperparámetros, pasa solo los que definiste en el script de entrenamiento. Si no, habrá error.
Ahora podemos ajustar este estimador con nuestros datos:
# Lanzar el trabajo de entrenamiento
sklearn_estimator.fit({"train": trainpath, "test": testpath}, wait=True)
Recuerda que trainpath y testpath son rutas en S3 que apuntan a nuestros CSV.
Al ejecutar la celda, comenzará el entrenamiento:
INFO:sagemaker:Creating training-job with name: rf-scikit-2024-06-04-10-36-31-142

2024-06-04 10:36:31 Starting - Starting the training job...

2024-06-04 10:36:46 Starting - Preparing the instances for training...

2024-06-04 10:37:13 Downloading - Downloading input data...

2024-06-04 10:37:53 Training - Training image download completed. Training in progress...
SageMaker descarga la imagen de Docker necesaria para ejecutar código de scikit‑learn y ejecuta tu script. Al finalizar, verás este mensaje:
2024-06-04 10:38:17 Uploading - Uploading generated training model

2024-06-04 10:38:17 Completed - Training job completed

Training seconds: 65

Billable seconds: 65
Si vas a “SageMaker” > “Traning” > “Training Jobs” en el panel de SageMaker, también verás el trabajo listado allí.
Como nuestro dataset es pequeño, nos basta con una máquina económica y modesta para entrenar: ml.c5.xlarge. Sin embargo, en tus proyectos puede que trabajes con millones de registros o datasets masivos de imágenes. En esos casos, necesitarás máquinas mucho más potentes y con GPU.
Usarlas bajo demanda puede ser muy caro. Para abaratar, Amazon ofrece instancias de Spot Training. Con ellas, puedes usar recursos de alto rendimiento a un precio menor con una única condición: el entrenamiento no empieza de inmediato. SageMaker espera a que baje la demanda y la máquina solicitada esté disponible.
Para activar Spot Training, añade un par de líneas al bloque anterior:
spot_sklearn_estimator = SKLearn(
   entry_point="script.py",
   role=get_execution_role(),
   instance_count=1,
   instance_type="ml.c5.xlarge",
   framework_version=FRAMEWORK_VERSION,
   base_job_name="rf-scikit",
   hyperparameters={
       "n-estimators": 100,
       "min-samples-leaf": 3,
   },
   use_spot_instances=True,
   max_wait=7200,
   max_run=3600,
)
Al establecer use_spot_instances en True, spot_sklearn_estimator usará entrenamiento Spot. También puedes definir el tiempo máximo de espera y el tiempo máximo de ejecución.
El entrenamiento empieza cuando llamas de nuevo a .fit():
# Lanzar el trabajo de entrenamiento
spot_sklearn_estimator.fit({"train": trainpath, "test": testpath}, wait=True)Con el mismo script de entrenamiento podemos obtener un modelo ajustado con un flujo similar.
Primero, importa la clase IntegerParameter desde sagemaker.tuner:
from sagemaker.tuner import IntegerParameterLa clase IntegerParameter permite definir rangos de búsqueda para parámetros que aceptan valores enteros. El módulo tuner incluye clases para otros tipos de parámetros:
CategoricalParameter: define hiperparámetros con un conjunto discreto de valores categóricos.ContinuousParameter: define rangos para hiperparámetros con valores continuos.Nos quedaremos con IntegerParameter en este tutorial porque solo ajustaremos dos parámetros de Random Forest:
# Usamos el Hyperparameter Tuner
from sagemaker.tuner import IntegerParameter

# Definir los límites de exploración
hyperparameter_ranges = {
   "n-estimators": IntegerParameter(20, 100),
   "min-samples-leaf": IntegerParameter(2, 6),
}
Luego creamos el objeto de optimización:
# Crear el optimizador
Optimizer = sagemaker.tuner.HyperparameterTuner(
   estimator=sklearn_estimator,
   hyperparameter_ranges=hyperparameter_ranges,
   base_tuning_job_name="RF-tuner",
   objective_type="Maximize",
   objective_metric_name="balanced-accuracy",
   metric_definitions=[
       {"Name": "balanced-accuracy", "Regex": "Test balanced accuracy: ([0-9.]+).*$"}
   ],  # Extraer la métrica de los logs con una regexp
   max_jobs=10,
   max_parallel_jobs=2,
)
Parámetros esenciales de Optimizer:
estimator: el estimador compatible con tu script.hyperparameter_ranges: rangos definidos con las clases del módulo tuner.objective_type: si hay que maximizar o minimizar la métrica. La balanced accuracy se maximiza.metric_definitions: nombre de la métrica a optimizar y cómo extraerla de los logs.El parámetro metric_definitions puede ser algo delicado por la flexibilidad que ofrece.
En el script de entrenamiento, informamos de la balanced accuracy con estos logs:
print(f"Train balanced accuracy: {bal_acc_train:.3f}")
print(f"Test balanced accuracy: {bal_acc_test:.3f}")
metric_definitions nos pide capturar ese mensaje con expresiones regulares. Por eso usamos este diccionario, que da un nombre a la métrica capturada que empieza por “Test balanced accuracy”.
{
   "Name": "balanced-accuracy",
   "Regex": "Test balanced accuracy: ([0-9.]+).*$",
}
El resto del código ya te resultará familiar:
Optimizer.fit({"train": trainpath, "test": testpath})INFO:sagemaker:Creating hyperparameter tuning job with name: RF-tuner-240604-1049Cuando termine la optimización, puedes ver los resultados en un DataFrame:
# Obtener resultados del tuner en un df
results = Optimizer.analytics().dataframe()

while results.empty:
   time.sleep(1)
   results = Optimizer.analytics().dataframe()

results.head()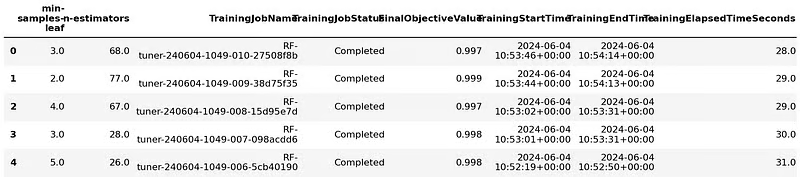
Después, puedes recuperar el mejor estimador:
best_estimator = Optimizer.best_estimator()Cuando decidas qué modelo usar, puedes subirlo a SageMaker con todos sus artefactos. Esta tarea puede hacerse con boto3:
artifact_path = sm_boto3.describe_training_job(
   TrainingJobName=best_estimator.latest_training_job.name
)["ModelArtifacts"]["S3ModelArtifacts"]

print("Model artifact persisted at " + artifact)
Model artifact persisted at s3://sagemaker-us-east-1-496320894061/RF-tuner-240604-1049-009-38d75f35/output/model.tar.gzLa función describe_training_job() toma un estimador y lo envía a una ubicación predeterminada de S3 proporcionada por SageMaker. Como ves arriba, convierte el modelo en un tarball antes de subirlo.
Los modelos subidos aparecen en “Inference” > “Models” en tu panel de SageMaker:
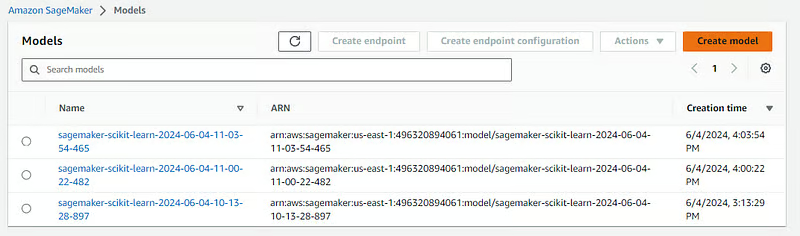
Si haces clic en cualquiera, verás un botón “Create endpoint” arriba a la derecha:
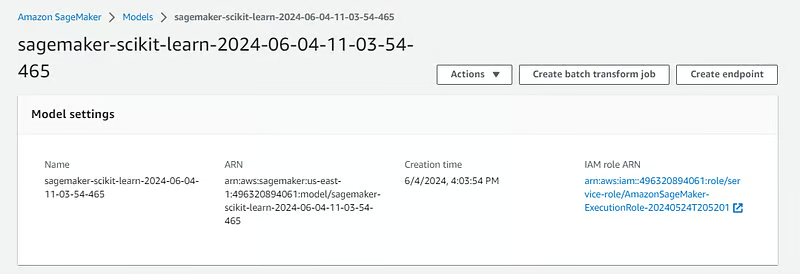
Puedes desplegar el modelo con ese botón o con código, volviendo al notebook y usando el método .deploy():
from sagemaker.sklearn.model import SKLearnModel

model = SKLearnModel(
   model_data=artifact_path,
   role=get_execution_role(),
   entry_point="script.py",
   framework_version=FRAMEWORK_VERSION,
)
Esta vez usamos la clase SKLearnModel, pensada para modelos ya entrenados. Requiere la ubicación en S3 de los artefactos y el script con el que se entrenó. Con esa información, puedes desplegarlo así:
predictor = model.deploy(instance_type="ml.c5.large", initial_instance_count=1)
INFO:sagemaker:Creating model with name: sagemaker-scikit-learn-2024-06-04-11-03-54-465
INFO:sagemaker:Creating endpoint-config with name sagemaker-scikit-learn-2024-06-04-11-03-54-960
INFO:sagemaker:Creating endpoint with name sagemaker-scikit-learn-2024-06-04-11-03-54-960
Después, deberías ver el endpoint en “Inference” > “Endpoints” en el panel de SageMaker:
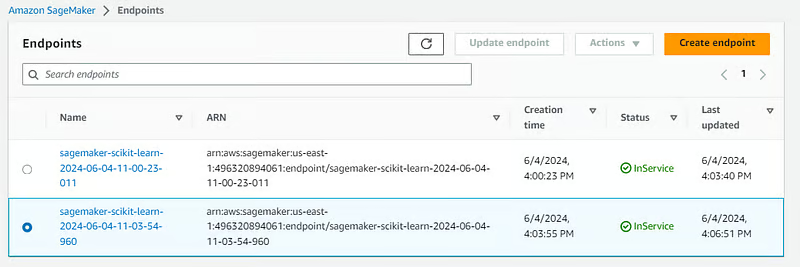
Para usarlo en predicción, puedes llamar a .predict() desde tu notebook:
preds = predictor.predict(test.sample(4).drop("Class", axis=1))
preds
array([3, 0, 1, 2])¡Enhorabuena, acabas de desplegar tu primer modelo con SageMaker!
Cuando termines de usarlo, no olvides borrar el endpoint, ya que genera costes continuamente:
sm_boto3.delete_endpoint(EndpointName=predictor.endpoint)Recuerda: cada instancia de notebook en SageMaker incluye una pestaña con notebooks de ejemplo que muestran diferentes funciones de la plataforma:
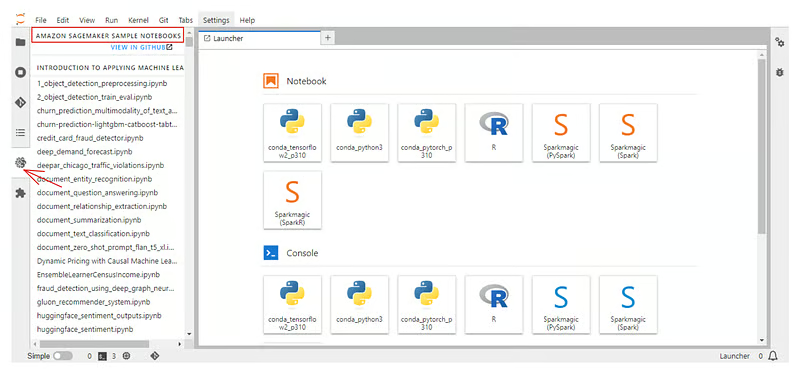
Además, consulta la documentación oficial del SDK de Python de SageMaker.
Hoy hemos visto cómo usar una de las plataformas de machine learning empresarial más populares: AWS SageMaker. Hemos cubierto desde la creación de una cuenta de AWS hasta el despliegue de modelos de ML como endpoints en SageMaker.
Como con cualquier plataforma, solo hemos arañado la superficie. Puedes hacer mucho más si lo combinas con otras tecnologías de AWS en tus proyectos. Aquí tienes recursos relacionados:
¡Sigue aprendiendo sobre machine learning y AWS con estos cursos!
Curso
Curso
Curso
blog
Natassha Selvaraj
15 min
blog
Joleen Bothma
12 min
blog
Abid Ali Awan
15 min
blog
Srujana Maddula
13 min
Tutorial
Tim Lu
15 min
Tutorial
Abid Ali Awan
15 min





