
Kurs
Konzeptuelle Grundlagen von AWS
2 Std.
51.8K
Auch wenn die meisten Amazon mit Prime-Lieferungen und Inhalten verbinden, ist das Unternehmen unter Entwicklerinnen und Entwicklern erstklassig bewertet. Amazon Web Services (AWS) stellt Cloud-Technologien für mehr als 1 Million aktive Nutzer bereit, von Konzernen bis hin zu kleinen und mittelständischen Unternehmen.
In diesem Artikel konzentrieren wir uns auf AWS SageMaker, eine dedizierte Plattform für End-to-End-Workflows im Machine Learning (ML) im großen Maßstab – als Teil des AWS-Ökosystems. Am Ende des Artikels haben wir ein bereitgestelltes Modell, an das wir Anfragen senden können, um Vorhersagen für eine Klassifikationsaufgabe zu generieren.
Amazon SageMaker ist ein vollständig verwalteter Service mit Tools und Infrastruktur zum Erstellen, Trainieren und Bereitstellen von Machine-Learning-Modellen. Er vereinfacht den ML-Workflow und ermöglicht Datenwissenschaftlerinnen, -wissenschaftlern und Entwicklerinnen, Entwicklern, Modelle schnell und effizient zu erstellen, zu trainieren und zu deployen.
Ein typisches Machine-Learning-Projekt durchläuft mehrere Phasen:
Jede Phase benötigt eigene Tools und ein erfahrenes Team, das alles reibungslos orchestriert. Amazon SageMaker führt diesen gesamten Prozess auf einer einzigen Plattform zusammen. Hier sind einige Vorteile:
Diese Vorteile machen Amazon SageMaker zu einer leistungsfähigen und flexiblen Plattform, um ML-Modelle in großem Maßstab zu entwickeln, zu trainieren und bereitzustellen.
Wie erwähnt, ist SageMaker Teil des AWS-Ökosystems mit vielen Cloud-Computing-Lösungen für Storage, Networking, Datenbanken, Analytics und Machine Learning. All diese Lösungen greifen nahtlos ineinander und binden sich in deinen SageMaker-Workflow ein.
Daher benötigst du für SageMaker ein AWS-Konto, falls du noch keines hast.
Gehe zur Kontoerstellung auf https://aws.amazon.com/ und folge dem Prozess, um ein neues Konto anzulegen.
Die Registrierung umfasst das Hinzufügen von Zahlungsdaten und die Verifizierung deiner Telefonnummer. Keine Sorge – es fallen erst Kosten an, wenn du tatsächlich SageMaker-Funktionen nutzt (die in der Regel kosteneffizient sind).
Anschließend landest du in deiner AWS-Konsole, die normalerweise wie im folgenden Bild aussieht. Beachte, dass einige Widgets bei dir abweichen können.
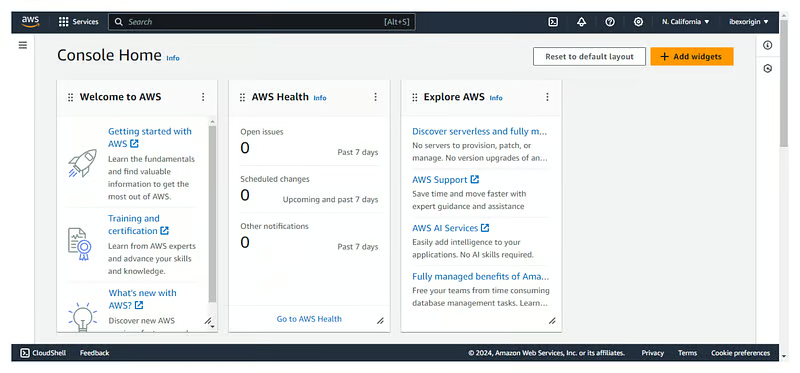
Jetzt erstellen wir eine JupyterLab-Session, um Code auf den Cloud-Maschinen von Amazon auszuführen.
Suche in deiner AWS-Konsole über die Suchleiste oben nach dem SageMaker-Dashboard:
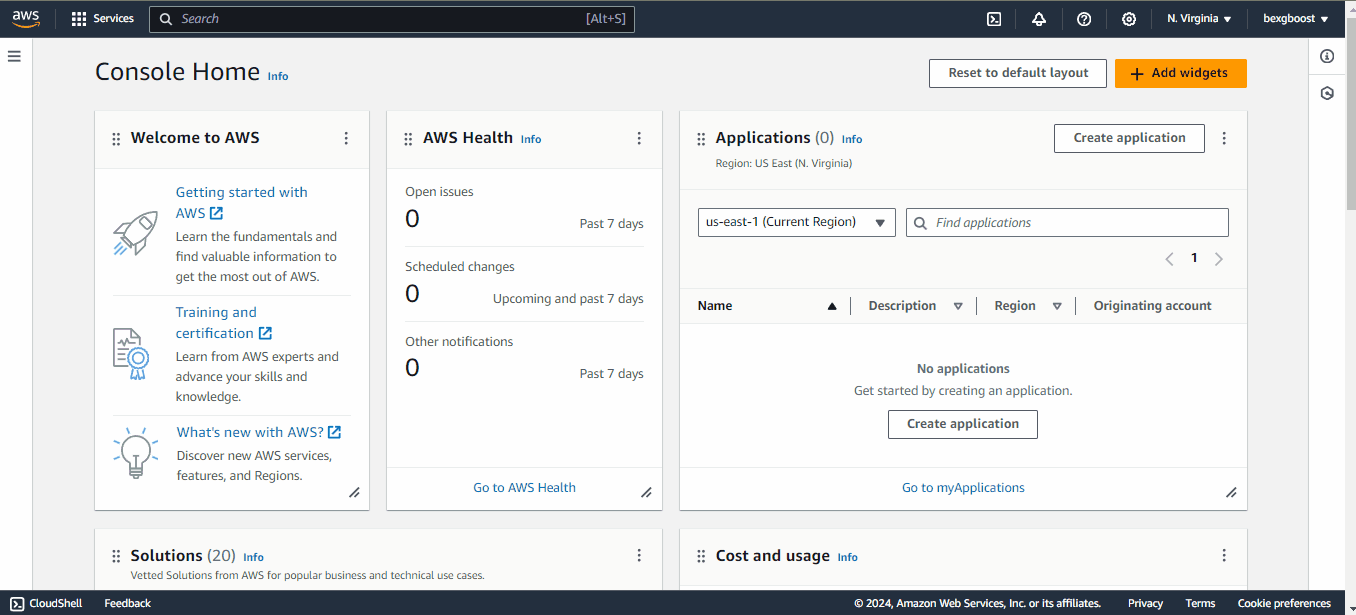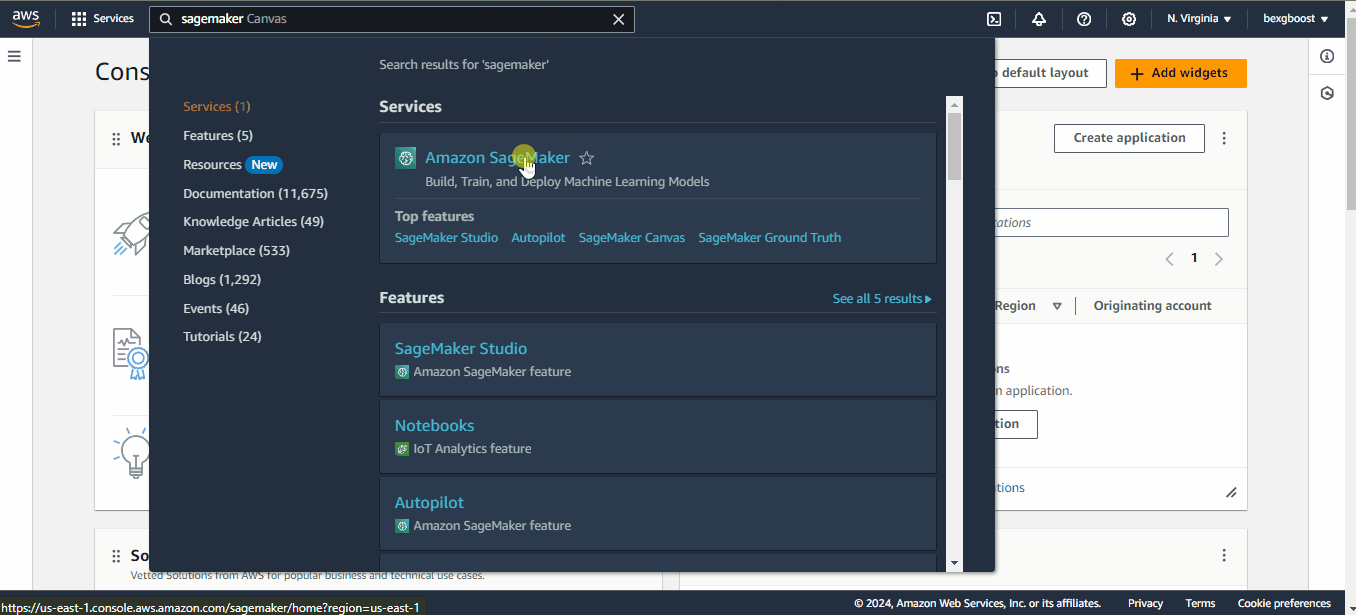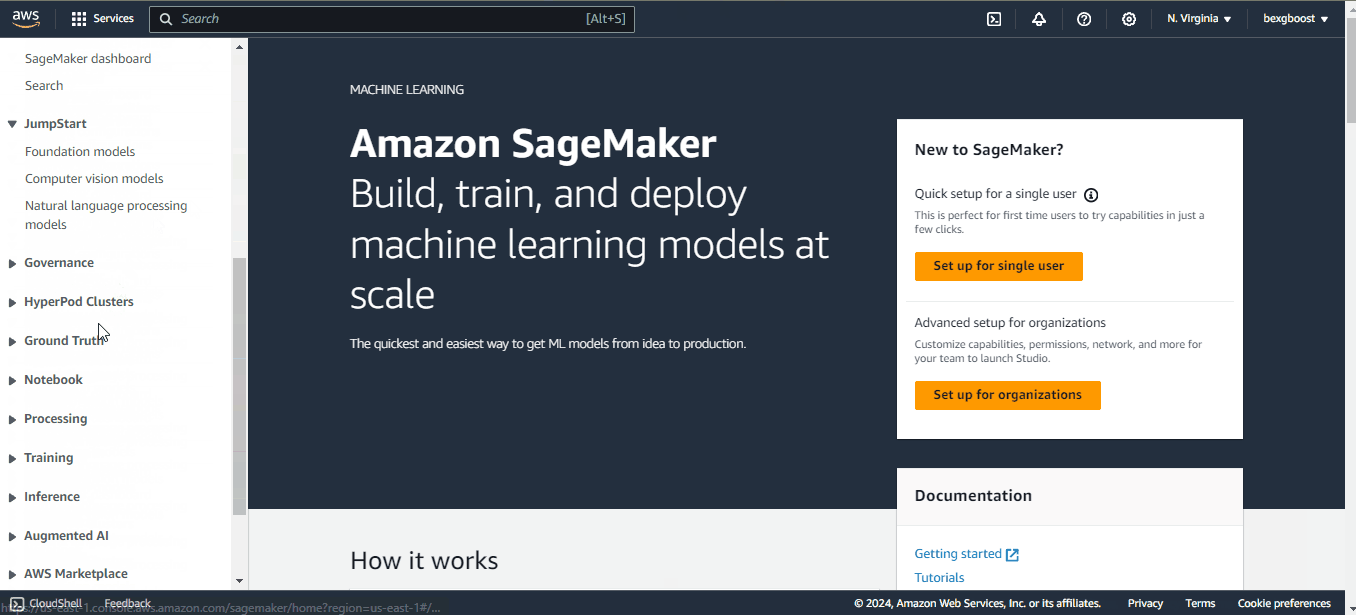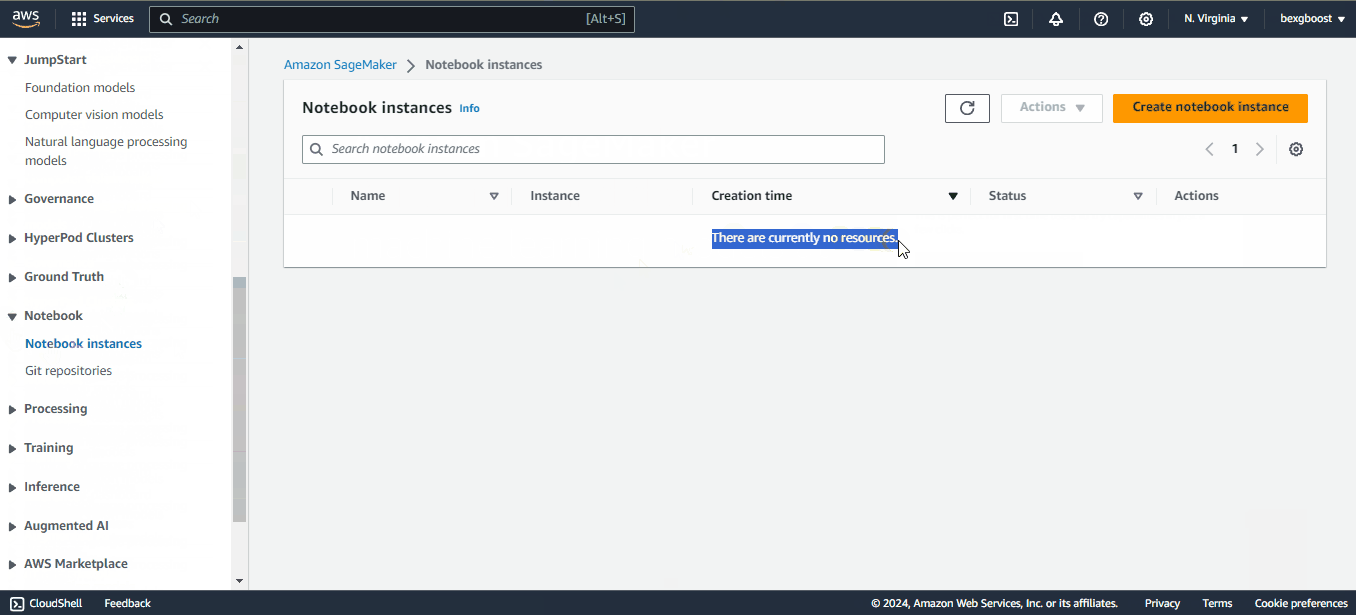
Scrolle dann nach unten zum Tab „Notebooks“ und darin zu „Notebook instances“. Es sind noch keine Instanzen vorhanden, also legen wir eine an:
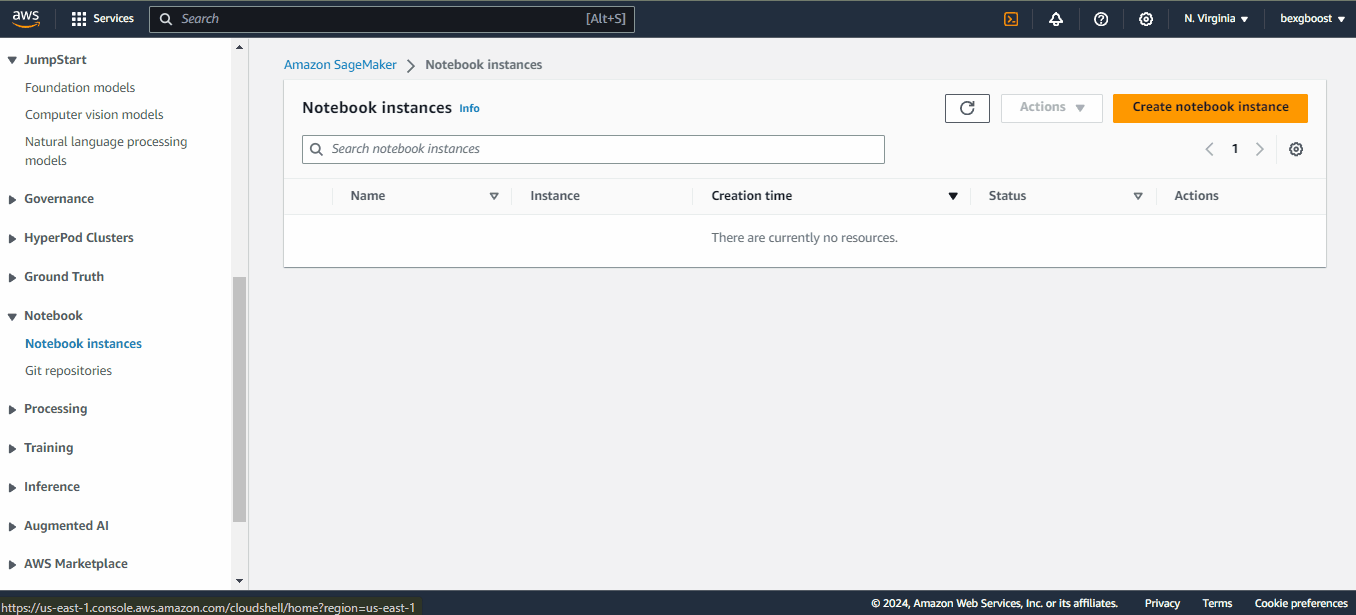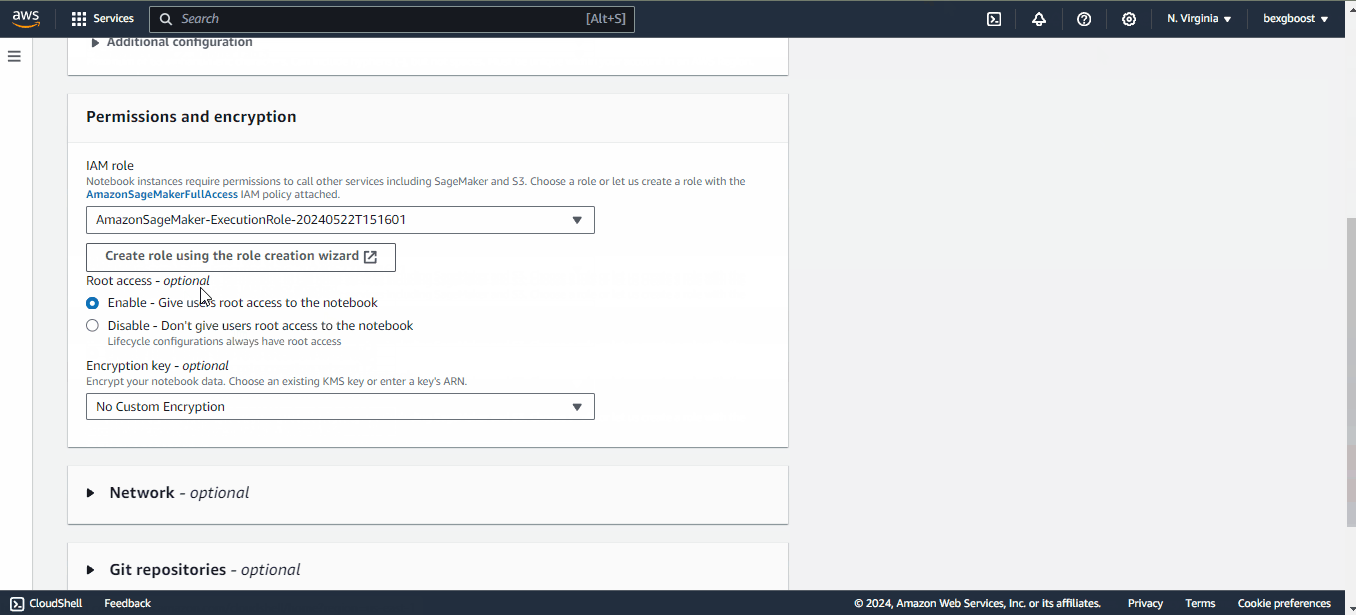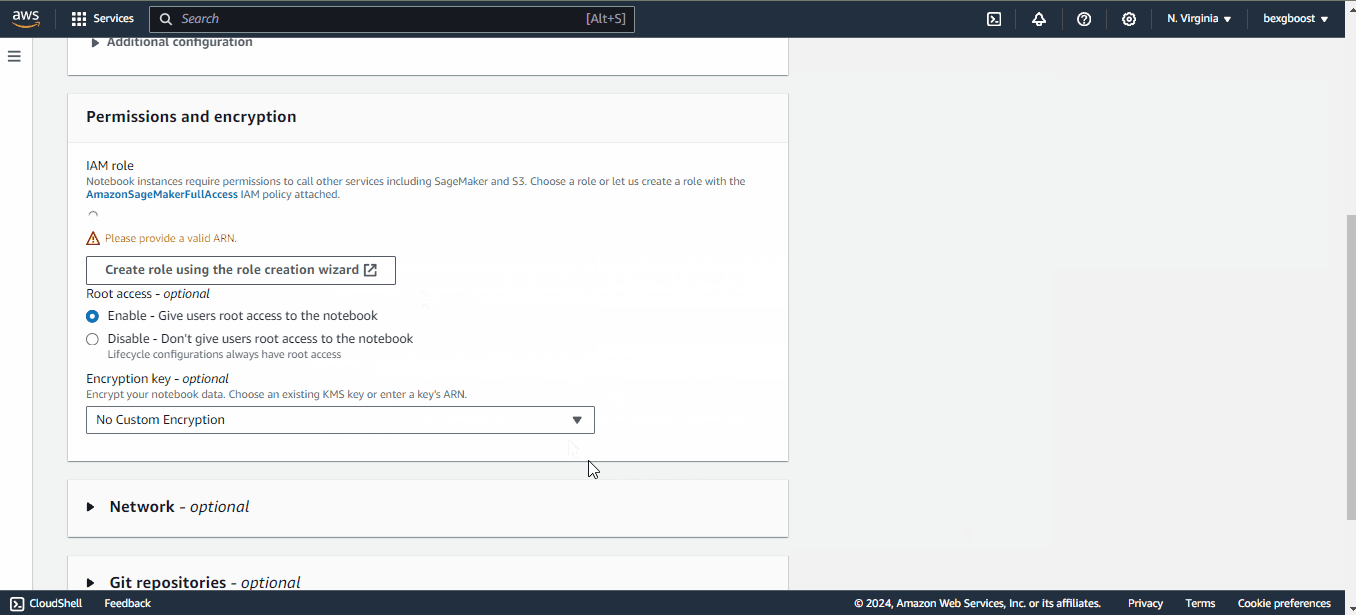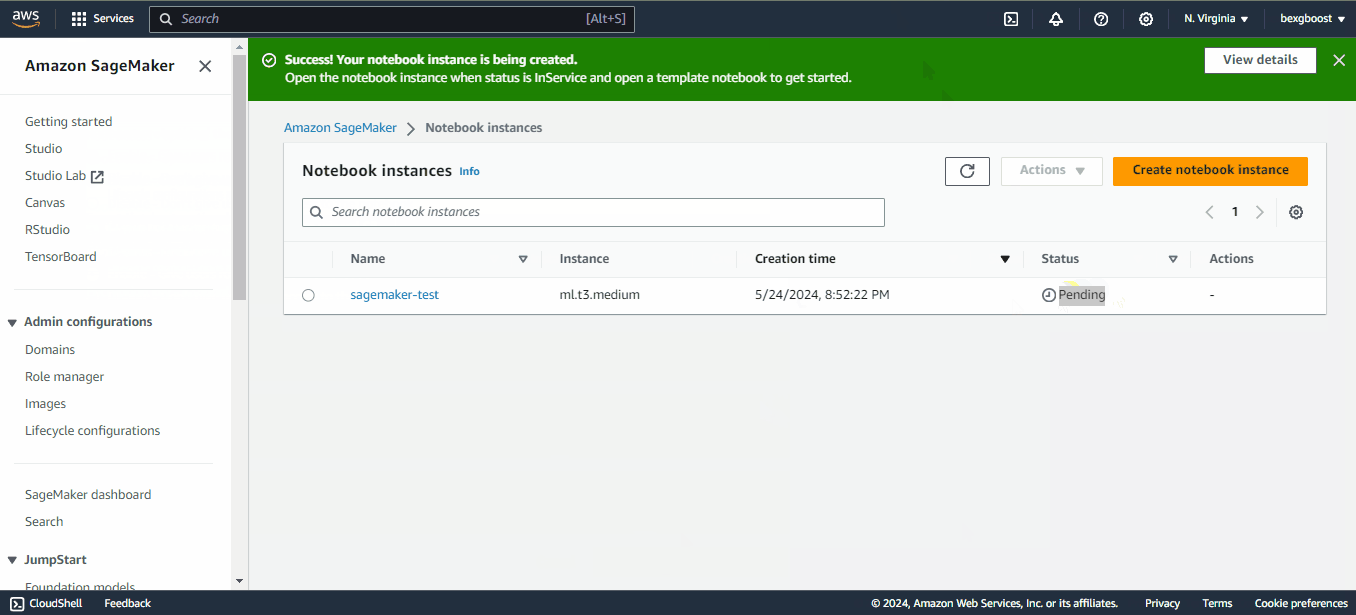
Klicke oben rechts auf „Create notebook instance“ und fülle Folgendes aus:
sagemaker-test.Nach dem Ausfüllen aller Pflichtfelder klicke auf „Create notebook instance“.
Sobald der Status von „Pending“ auf „inService“ wechselt, kannst du JupyterLab über den Link „Open in JupyterLab“ neben der Instanz starten:
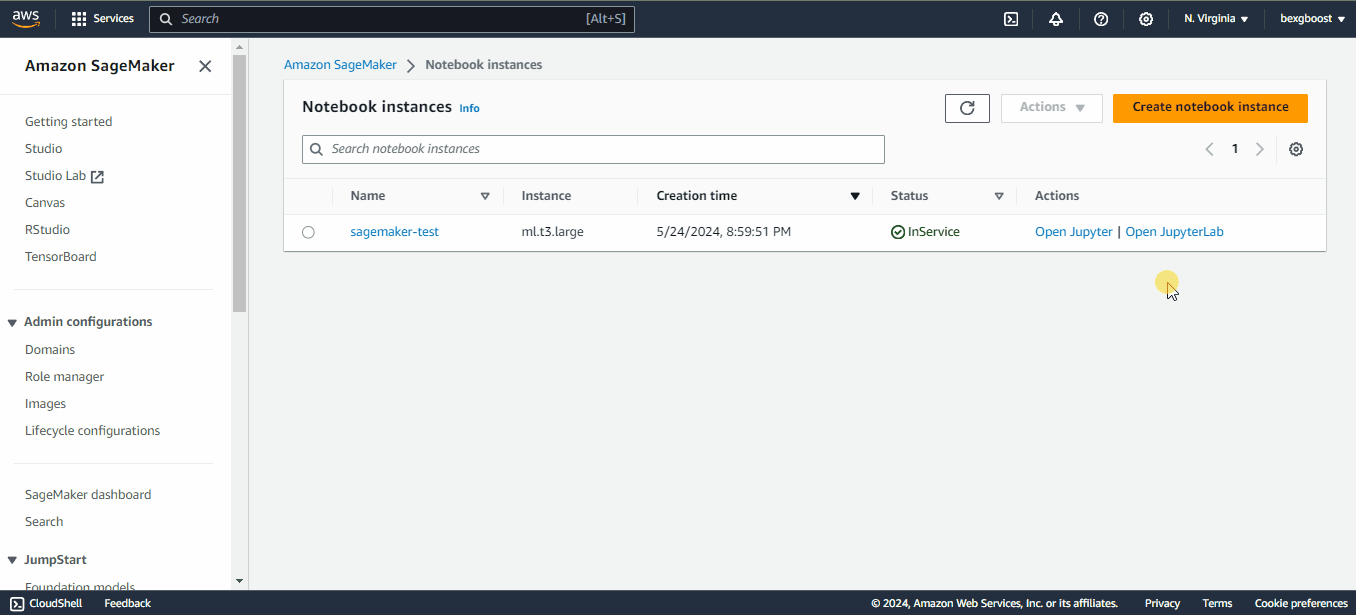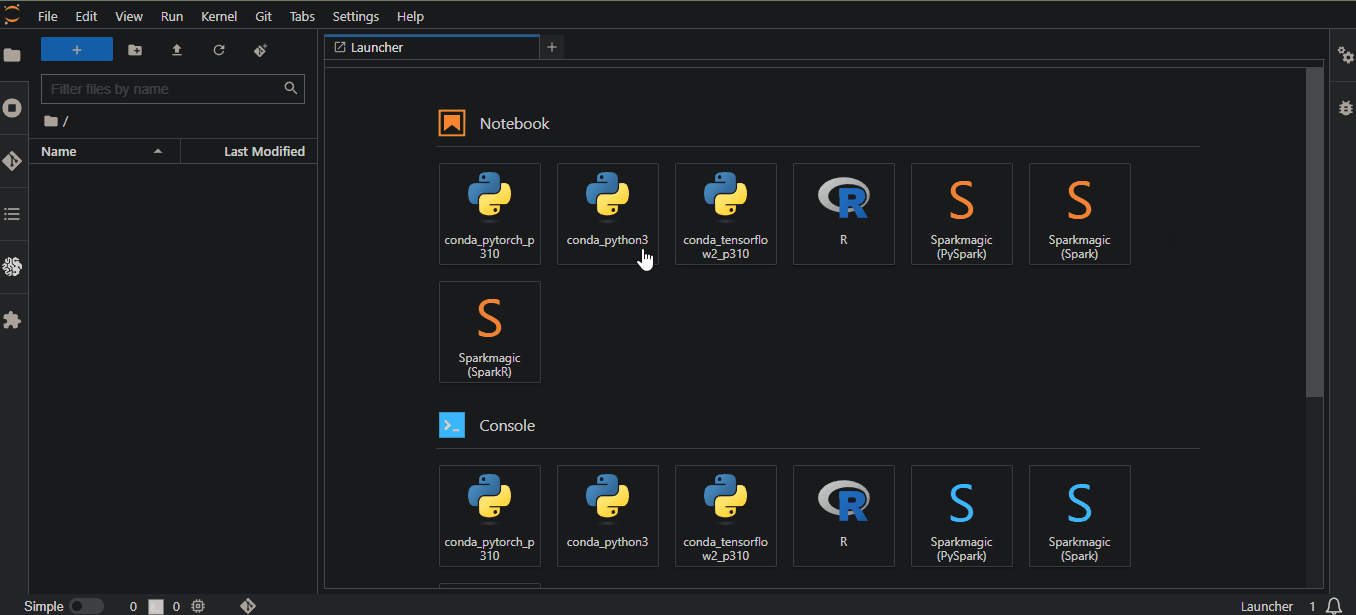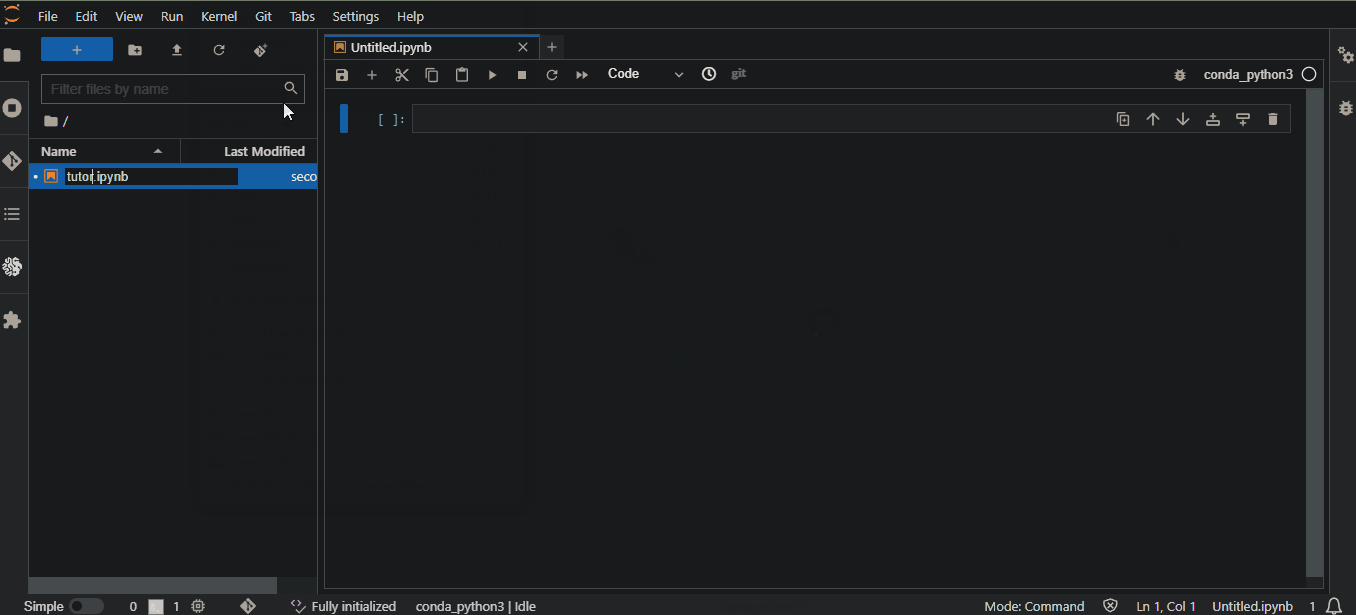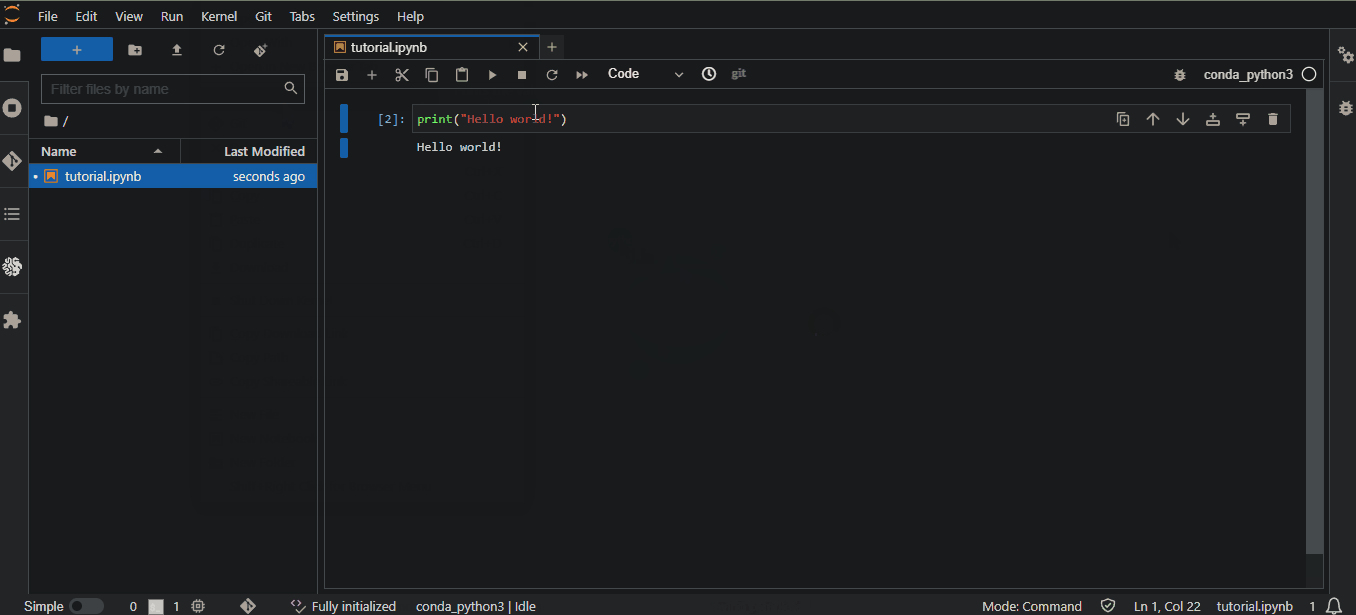
Sobald die Instanz aktiv ist, beginnt die Abrechnung. Wenn du eine Pause einlegen willst, stoppe die Instanz über „Actions“ > „Stop“, um unnötige Kosten zu vermeiden. Das Leerlauf-Timeout beträgt standardmäßig zwei Stunden:
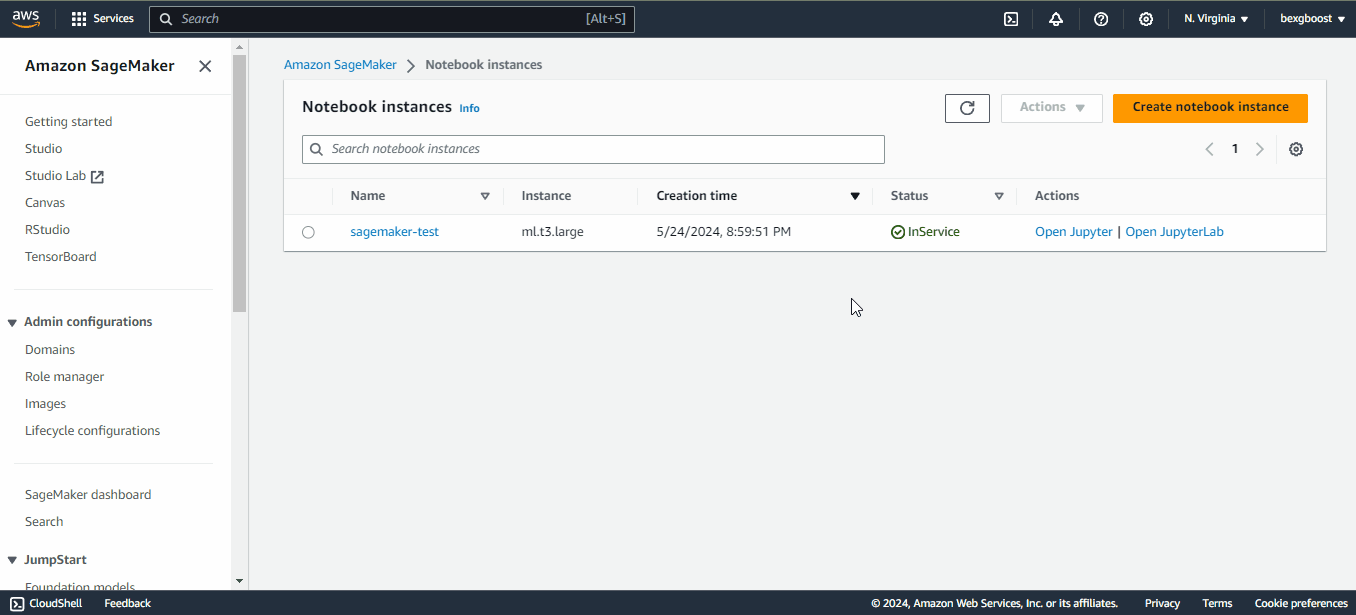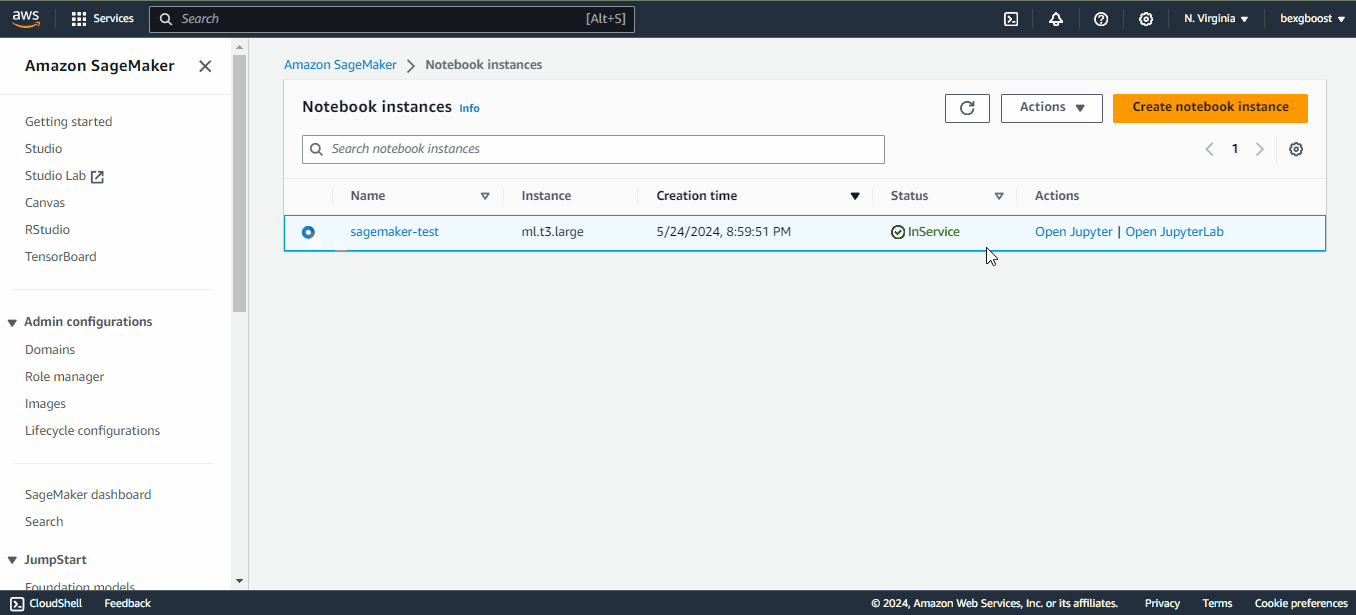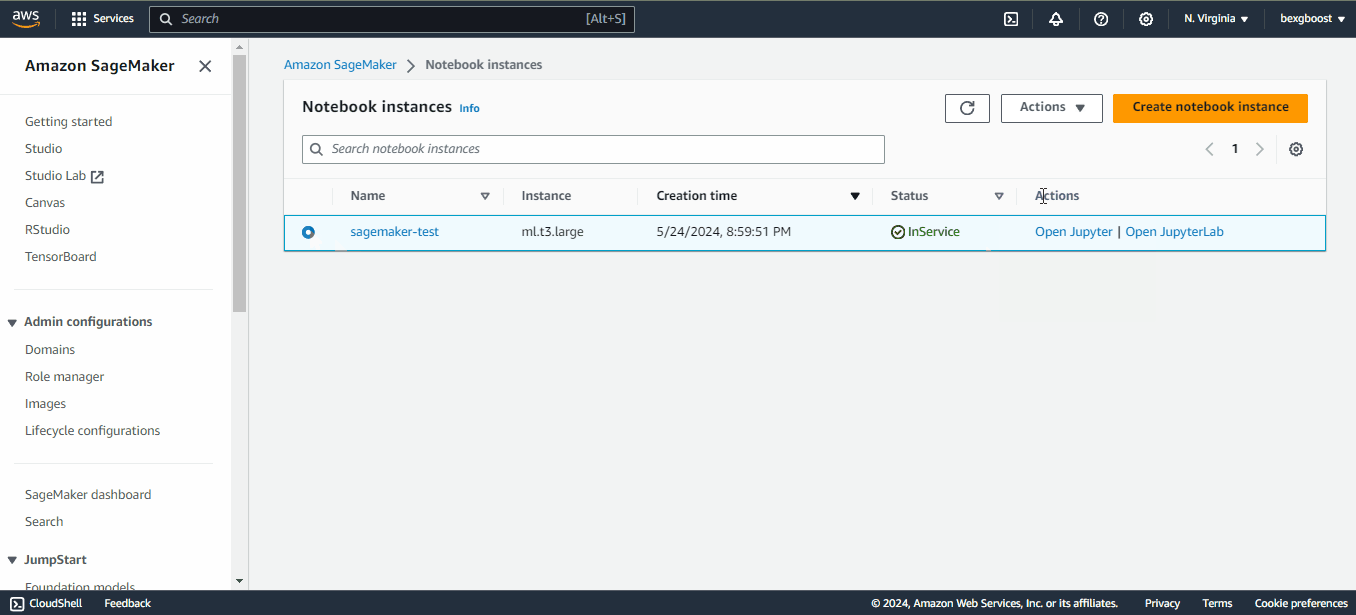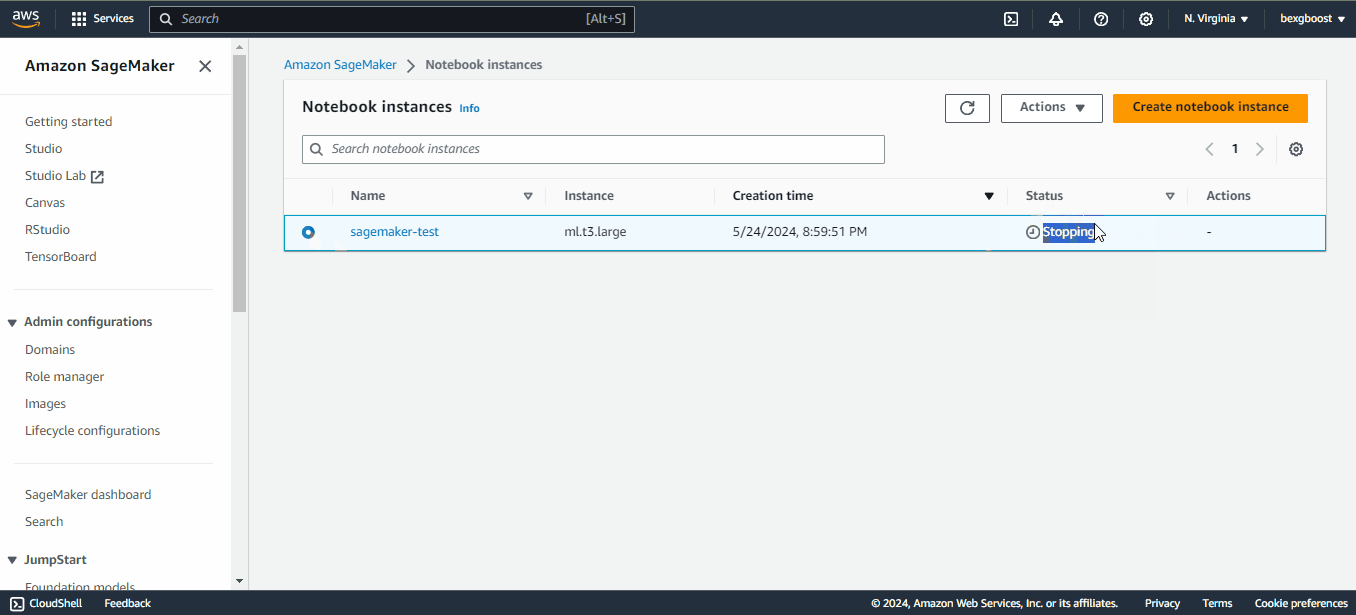
Wenn du eine Notebook-Instanz stoppst, kannst du sie später wieder starten. Deine Umgebung bleibt erhalten.
In diesem Abschnitt laden wir eine lokale Datei auf die Amazon-Server hoch – eine Voraussetzung für SageMaker.
Wir bauen einen Multiclass-Klassifikator mit dem Dry Bean Dataset aus dem UCI-ML-Repository. Es enthält 13.000 Bohnen-Instanzen und 15 numerische Messwerte.
Die Aufgabe ist, sie in sieben Bohnentypen zu klassifizieren: Seker, Barbunya, Bombay, Cali, Dermosan, Horoz und Sira.
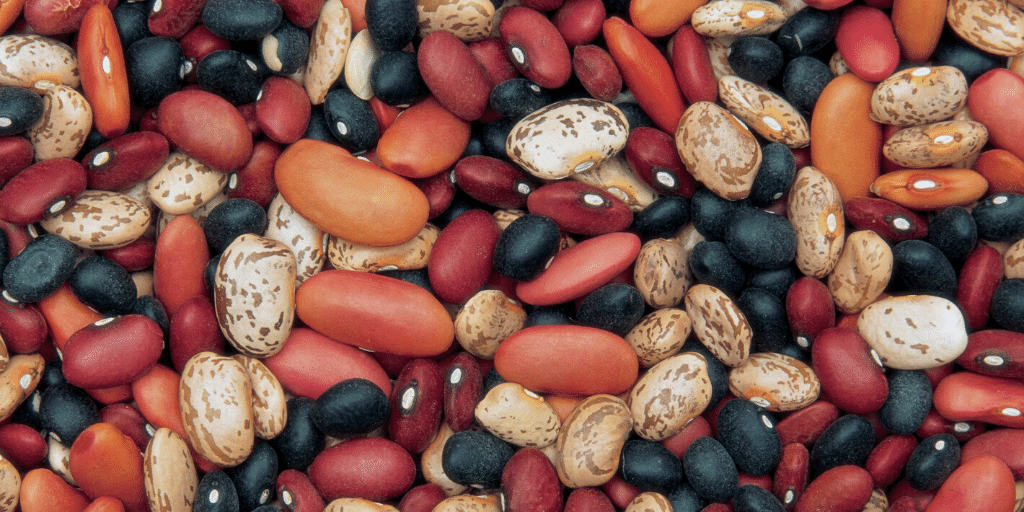
Die sieben Bohnentypen: Seker, Barbunya, Bombay, Cali, Dermosan, Horoz und Sira.
Speichere nach dem Download die Excel-Datei aus dem ZIP-Archiv lokal im data-Verzeichnis in JupyterLab und füge dann folgenden Code in dein Notebook ein:
from pathlib import Path

cwd = Path.cwd()
data_path = cwd / "data" / "Dry_Bean_Dataset.xlsx"
Mit dem folgenden Code lesen wir die Excel-Datei mit pandas und speichern sie als CSV:
import pandas as pd

beans = pd.read_excel(data_path)
beans.to_csv(cwd / "data" / "dry_bean.csv", index=False)Damit SageMaker auf unser Dataset zugreifen kann, muss es in einem S3-Bucket liegen. AWS S3 ist eine Cloud-Storage-Lösung, mit der du projektbezogene Objekte in Buckets auf Amazon-Servern ablegst.
So erstellst du einen Bucket:
dry-bean-bucket verwenden wie ich.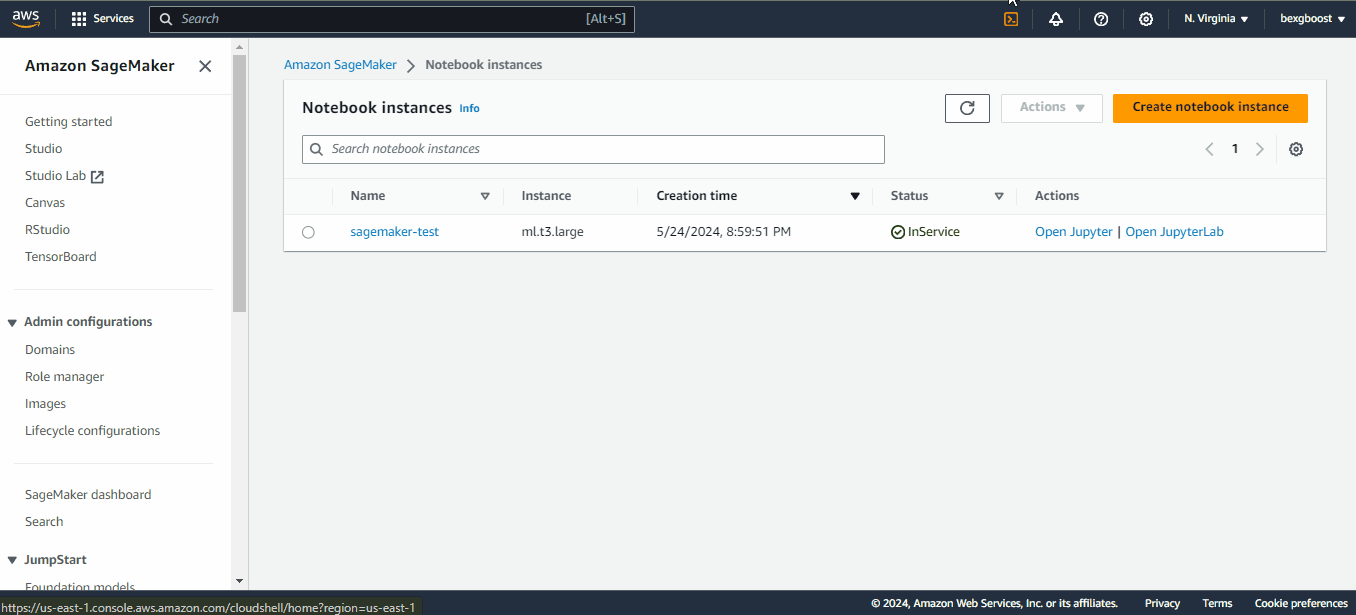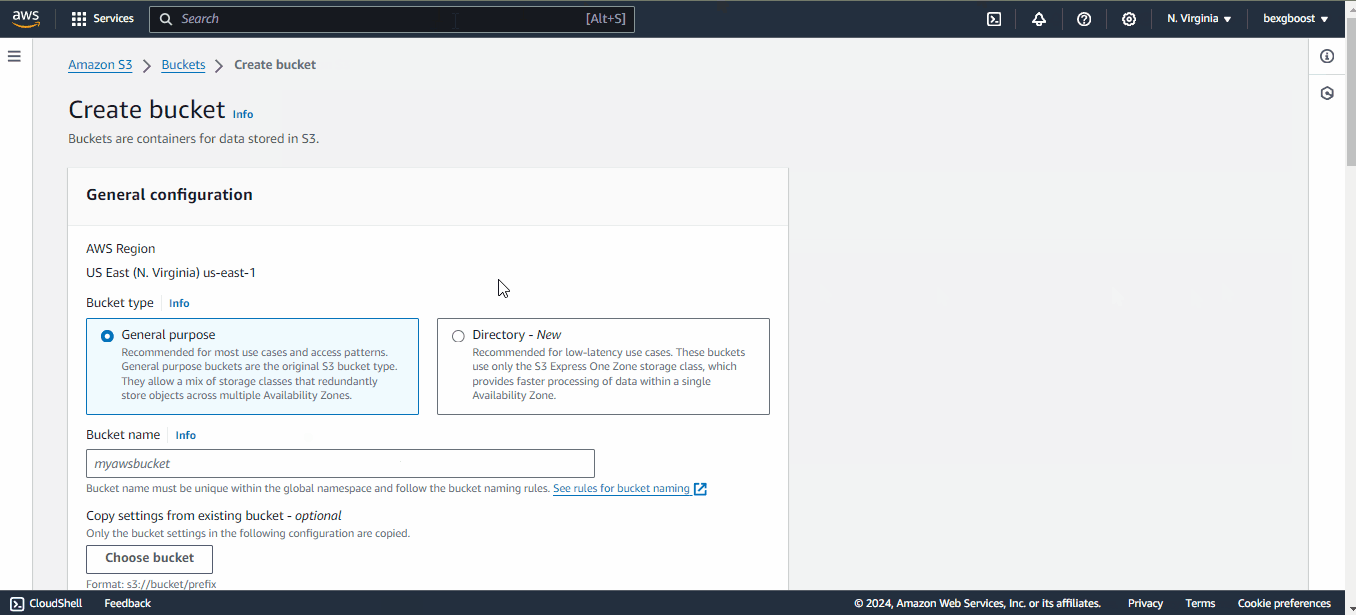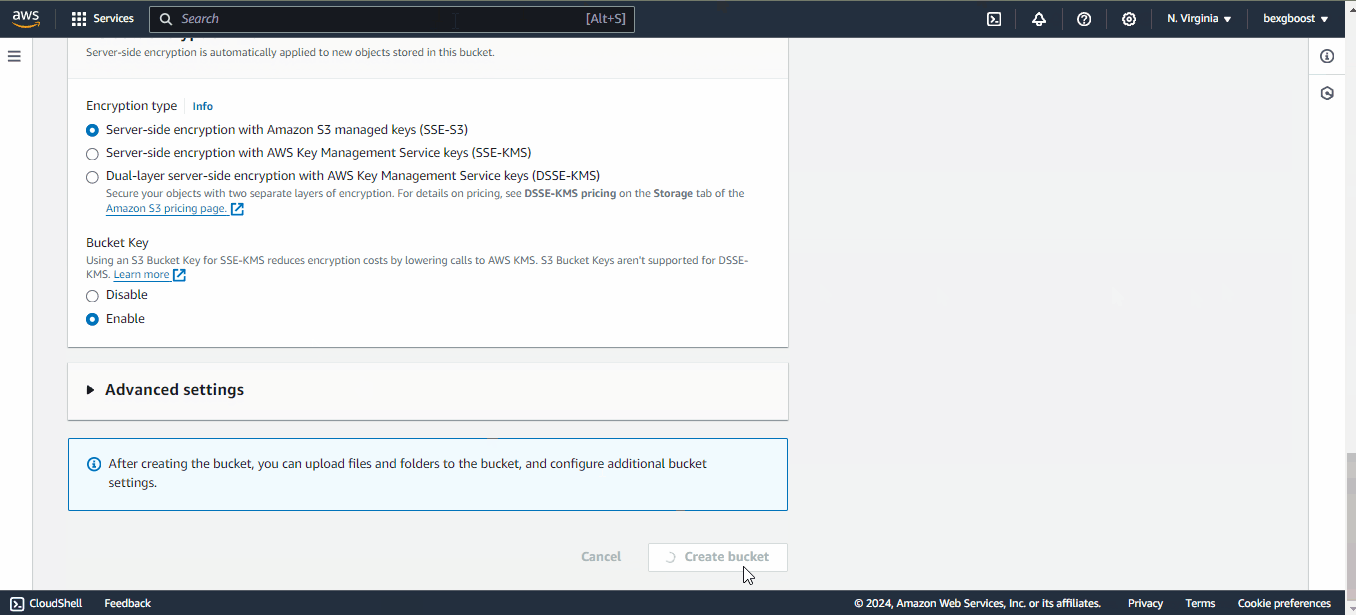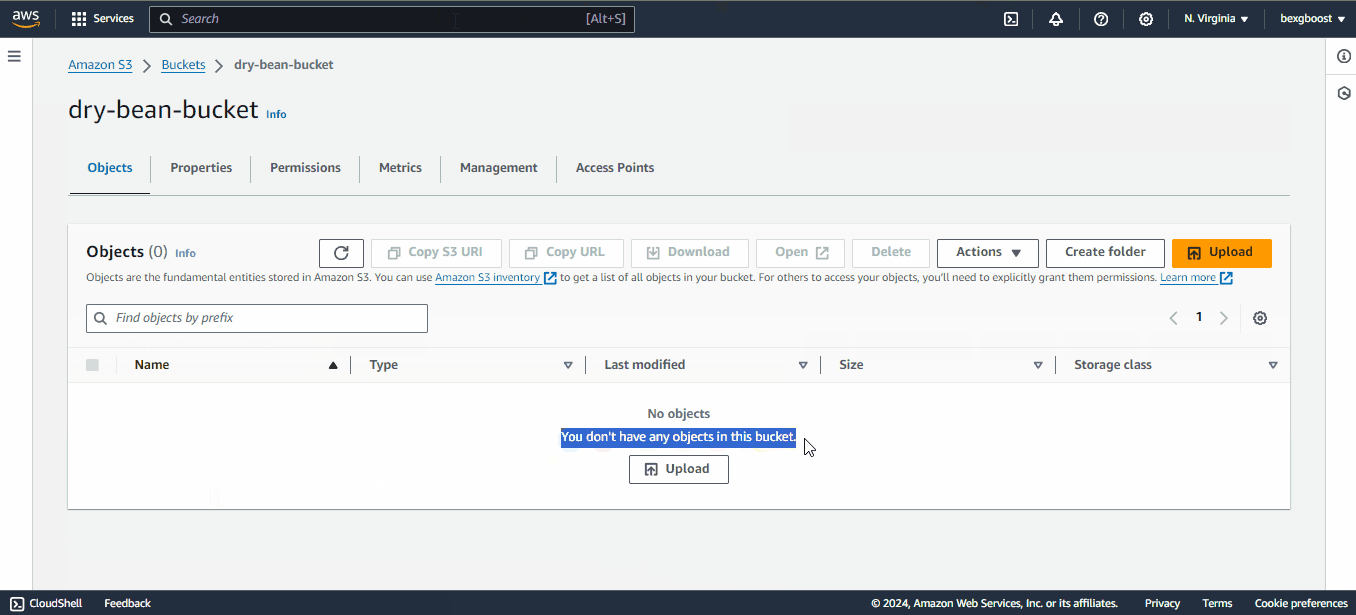
Klicke nach der Erstellung auf den Bucket und lade die zuvor gespeicherte CSV hoch:
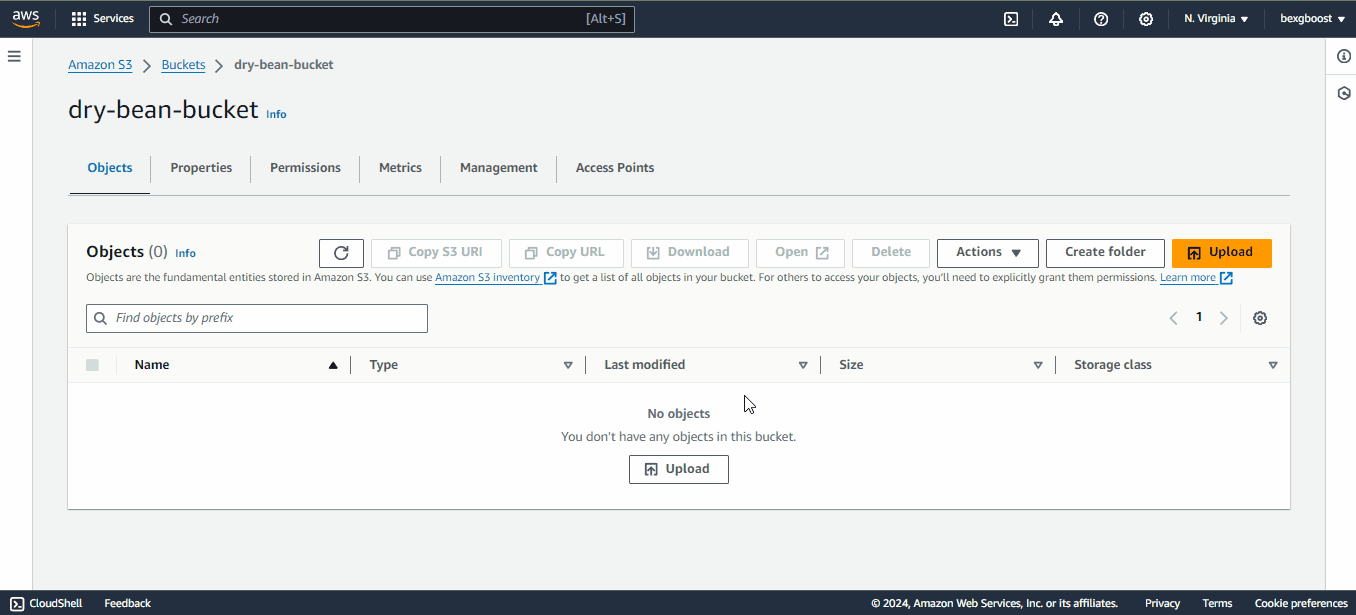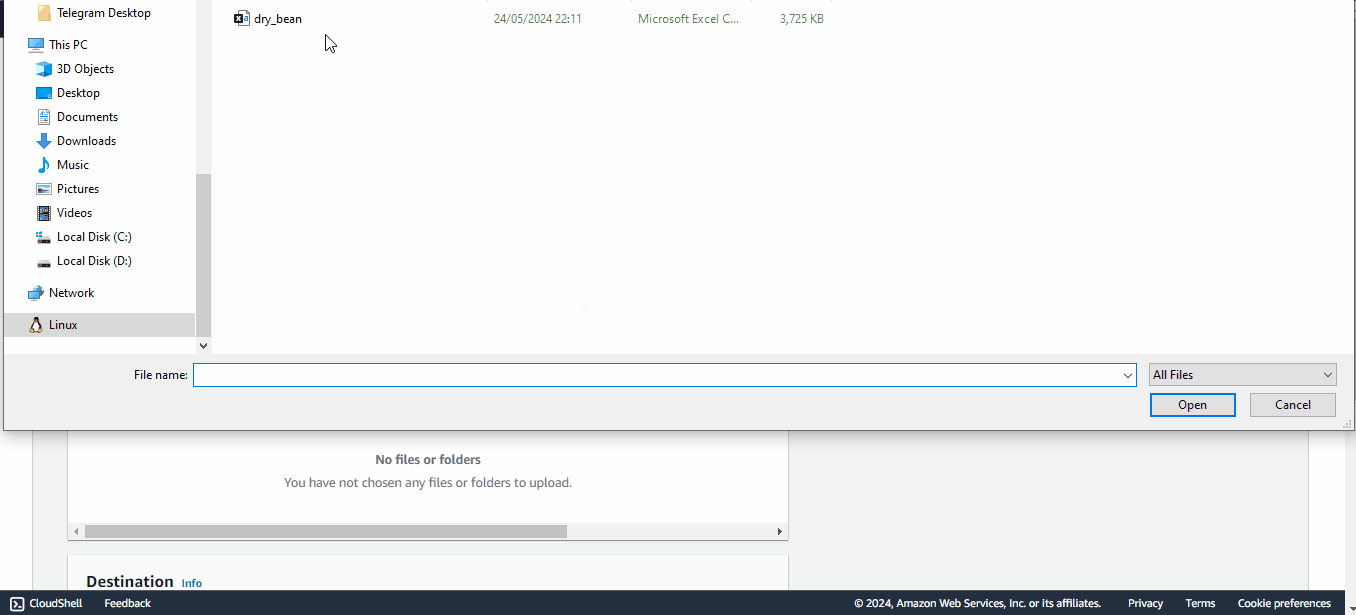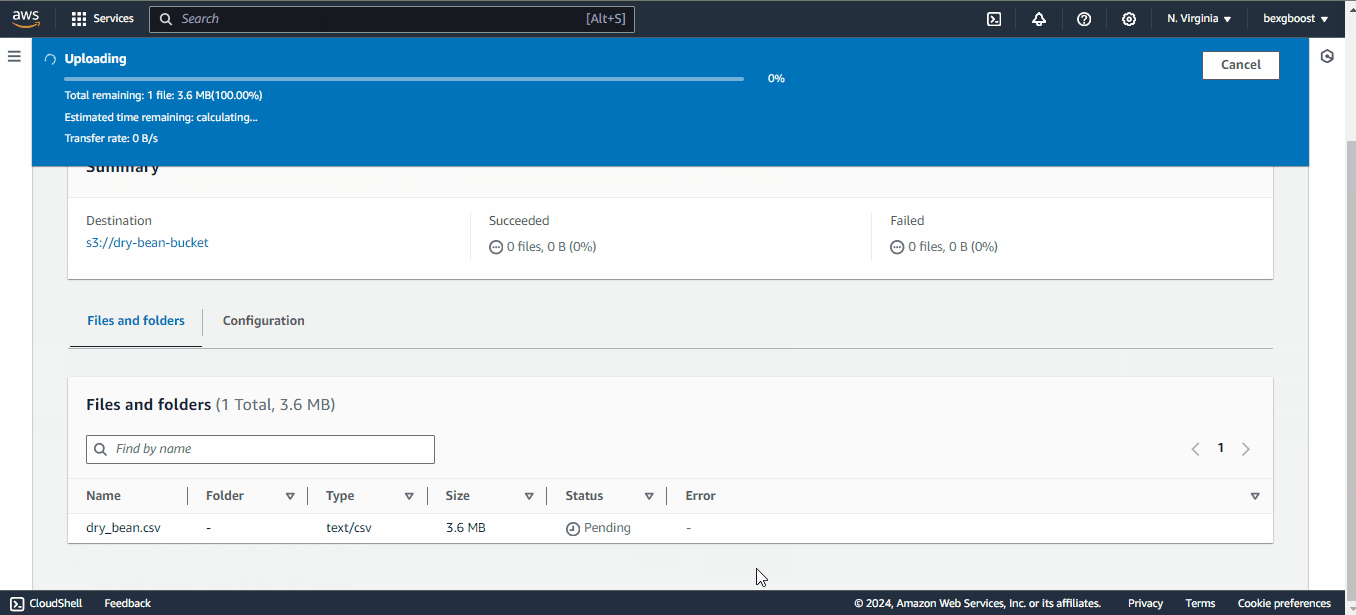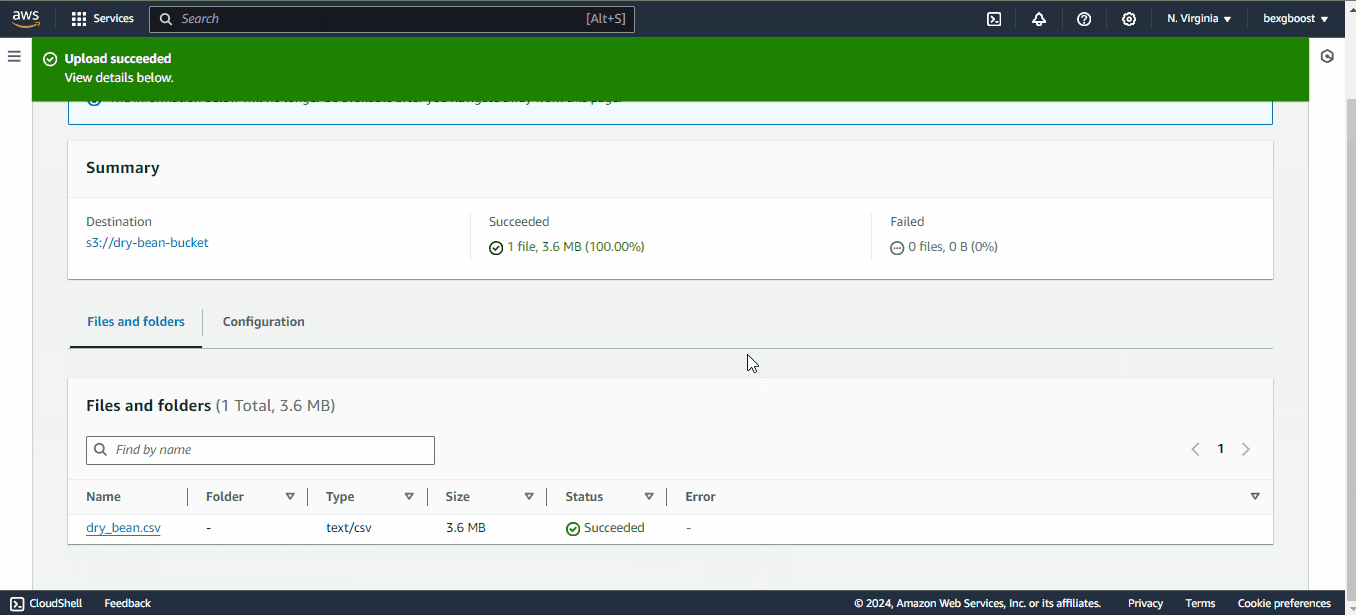
Danach kannst du zur JupyterLab-Oberfläche zurückkehren, denn jetzt wird endlich Code ausgeführt!
In diesem Abschnitt gehen wir einen End-to-End-Workflow durch – vom CSV-Dataset bis zum bereitgestellten Modell an einem Endpunkt. Bevor wir in die technischen Details einsteigen, ein kurzer Überblick, was wir auf hoher Ebene tun.
Machine Learning in SageMaker unterscheidet sich etwas von deinem lokalen Setup. Die ersten Schritte haben wir bereits erledigt:
Wie lokale Notebooks eignen sich SageMaker-Notebook-Instanzen für explorative Analysen – Datenbereinigung, -exploration, -aufnahme und erste Experimente.
Sobald du die Trainingsphase erreichst, erwartet SageMaker ein bestimmtes Vorgehen. Damit SageMaker deine eigenen Modelle als Endpunkte bereitstellen kann, benötigt es ein Trainingsskript, das Folgendes erledigt:
Außerdem muss das Skript Variablen dynamisch als Kommandozeilenargumente akzeptieren. Alles, was du zukünftig ändern willst (Model-Hyperparameter, Dateipfade usw.), setzt du als CLI-Argumente.
Ist das Skript bereit, wird es in spezielle Estimatoren von SageMaker eingebunden. Diese sind die Begleiter für beliebte ML-Bibliotheken wie scikit-learn, XGBoost, TensorFlow, PyTorch usw. Mit diesen Estimatoren baut SageMaker Docker-Container rund um dein Skript und deployt es als Endpunkt für skalierte Nutzung.
All das ergibt Schritt für Schritt Sinn, sobald wir es gemeinsam durchgehen.
Beginnen wir mit dem Import der benötigten Bibliotheken in deinem zuvor erstellten Notebook sagemaker-test:
import boto3
import numpy as np
import pandas as pd
import sagemaker
from sagemaker import get_execution_role
from sklearn.model_selection import train_test_split
Das leisten einige dieser Importe:
sagemaker ist das offizielle Python-SDK zum Trainieren und Bereitstellen von ML-Modellen auf Amazon SageMaker. Damit kannst du Modelle mit Deep-Learning-Frameworks, Amazon-Algorithmen oder eigenen Algorithmen in SageMaker-kompatiblen Docker-Images trainieren und deployen.boto3 ist ein weiteres offizielles Python-SDK, das als Brücke zwischen deinem Code und allen AWS-Services dient – nicht nur SageMaker. Mehr dazu im boto3-Kurs. Nach den Imports erstellen wir Ressourcen, die wir im Tutorial benötigen:
sm_boto3 = boto3.client("sagemaker")
sess = sagemaker.Session()boto3. Beide Objekte erlauben uns, auf unterschiedliche Weise mit SageMaker zu interagieren.
Jetzt definieren wir ein paar globale Variablen:
region = sess.boto_session.region_name
BUCKET_URI = "s3://dry-bean-bucket"
BUCKET_NAME = "dry-bean-bucket"
DATASET_PATH = f"{BUCKET_URI}/dry_bean.csv"
TARGET_NAME = "Class"
Diese Variablen sind selbsterklärend und werden im gesamten Tutorial verwendet.
In den meisten Datenprojekten liegt das Trainingsdataset in einer Cloud-Storage-Lösung wie BigQuery, GCS oder einem AWS-S3-Bucket. Wir nutzen Letzteres und laden es mit pandas. Füge diesen Code ins Notebook ein und führe ihn aus:
dry_bean = pd.read_csv(DATASET_PATH)
dry_bean.head()
Ein Vorteil von SageMaker-Notebooks: Wir können Dateien aus S3 direkt mit pandas lesen. Alle SageMaker-Umgebungen sind mit deinen Anmeldedaten vorkonfiguriert, damit pandas die CSV aus dem Bucket laden kann. Lokal würde derselbe Code ohne weitere Konfiguration nicht funktionieren.
Ein wenig EDA (Exploratory Data Analysis) gehört zu jedem Projekt – auch hier. Wir verzichten jedoch auf eine tiefe Analyse, um beim Kernthema des Artikels zu bleiben.
Wir begnügen uns mit einigen Statistik- und Übersichtsplots:
dry_bean.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 13611 entries, 0 to 13610
Data columns (total 17 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Area 13611 non-null int64
1 Perimeter 13611 non-null float64
2 MajorAxisLength 13611 non-null float64
3 MinorAxisLength 13611 non-null float64
4 AspectRation 13611 non-null float64
5 Eccentricity 13611 non-null float64
6 ConvexArea 13611 non-null int64
7 EquivDiameter 13611 non-null float64
8 Extent 13611 non-null float64
9 Solidity 13611 non-null float64
10 roundness 13611 non-null float64
11 Compactness 13611 non-null float64
12 ShapeFactor1 13611 non-null float64
13 ShapeFactor2 13611 non-null float64
14 ShapeFactor3 13611 non-null float64
15 ShapeFactor4 13611 non-null float64
16 Class 13611 non-null object
dtypes: float64(14), int64(2), object(1)
memory usage: 1.8+ MBDiese Infos zeigen: Es gibt 16 numerische Features und ein Zielmerkmal namens Class. Das Dataset ist klein – nur 13.000 Instanzen – und wir benötigen daher keine starken Maschinen und keine hohen Budgets zum Trainieren.
Als Nächstes erstellen wir mit seaborn ein Pairplot einiger wichtiger Features:
import seaborn as sns

sns.pairplot(
   dry_bean,
   vars=["Area", "MajorAxisLength", "MinorAxisLength", "Eccentricity", "roundness"],
   hue="Class",
);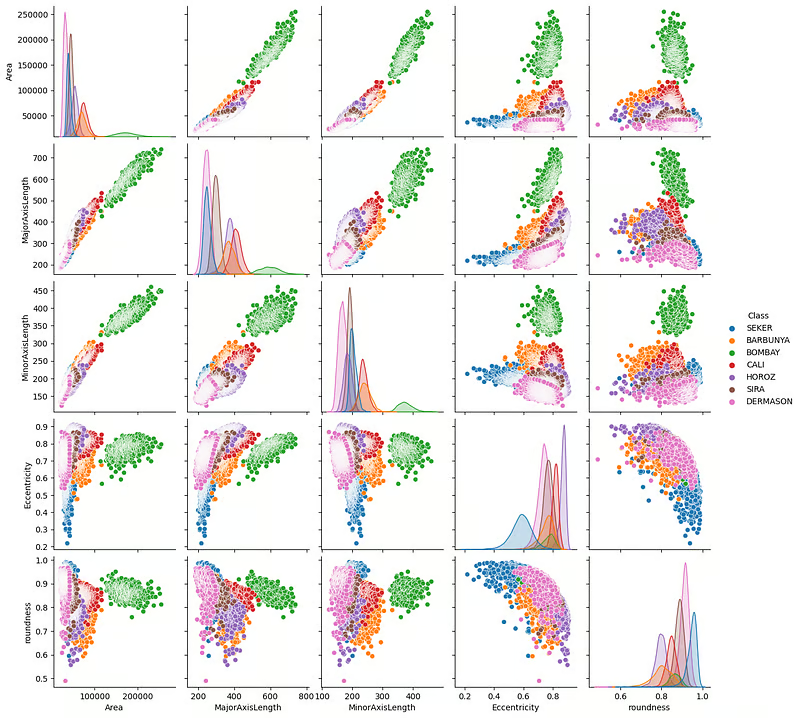
Die Plots zeigen: Die Bohnen unterscheiden sich anhand ihrer physischen Messwerte klar. Die grünen Bohnen (Bombay) sind besonders gut abgegrenzt.
Wir können außerdem eine Korrelationsmatrix darstellen, um Zusammenhänge zwischen Features zu sehen:
import matplotlib.pyplot as plt

correlation = dry_bean.corr(numeric_only=True)

# Create a square heatmap with center at 0
sns.heatmap(correlation, center=0, square=True, cmap="coolwarm", vmin=-1, vmax=1)
plt.show()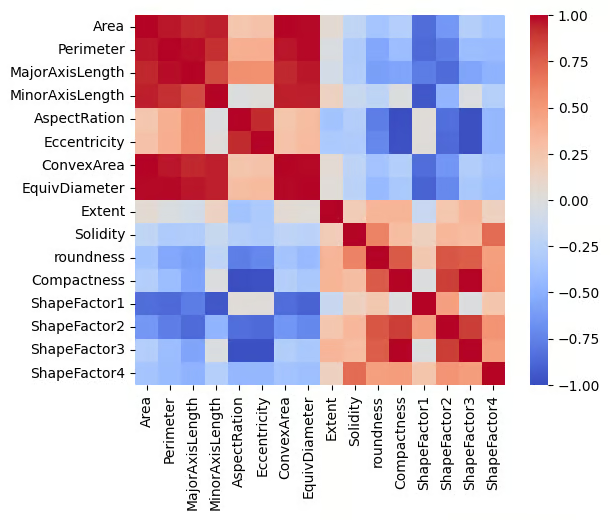
Die Grafik zeigt viele perfekt korrelierte (positiv wie negativ) Features – sinnvoll, da alle Messwerte physisch zusammenhängen.
An diesem Punkt kannst du die Exploration nach Belieben vertiefen.
Nach der Exploration behebst du Qualitäts- oder Logikprobleme im Dataset und entwickelst bei Bedarf neue Features, bevor du trainierst.
Das Dry Bean-Dataset ist recht sauber, also ist unser Job leicht. Wir müssen nur das Zielmerkmal encoden, da es Text enthält. Dafür nutzen wir scikit-learn:
from sklearn.preprocessing import LabelEncoder

# For preprocessing
df = dry_bean.copy(deep=True)

# Encode the target
le = LabelEncoder()
df[TARGET_NAME] = le.fit_transform(df[TARGET_NAME])
Nach dem Preprocessing teilen wir das Dataset:
from sklearn.model_selection import train_test_split

# Split the data into two sets
train, test = train_test_split(df, random_state=1, test_size=0.2)
Du kannst zusätzlich ein drittes Validierungsset abspalten, wir halten es hier jedoch simpel.
Jetzt speichern wir die Datasets als CSV:
train.to_csv("dry-bean-train.csv")
test.to_csv("dry-bean-test.csv")
Und laden sie in unseren S3-Bucket hoch:
# Send data to S3. SageMaker will take training data from s3
trainpath = sess.upload_data(
   path="dry-bean-train.csv",
   bucket=BUCKET_NAME,
   key_prefix="sagemaker/sklearncontainer",
)

testpath = sess.upload_data(
   path="dry-bean-test.csv",
   bucket=BUCKET_NAME,
   key_prefix="sagemaker/sklearncontainer",
)
Die Funktion .upload_data() der Session liefert den vollen Pfad zur hochgeladenen Datei zurück – gespeichert in trainpath bzw. testpath. Diese Pfade verwenden wir später.
Füge in einer neuen Notebook-Zelle folgenden Code ein:
%%writefile script.py

import argparse
import os
import joblib
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import balanced_accuracy_score

if __name__ == "__main__":
   print("extracting arguments")
   parser = argparse.ArgumentParser()

   # Hyperparameters sent by the client are passed as command-line arguments to the script.
   parser.add_argument("--n-estimators", type=int, default=10)
   parser.add_argument("--min-samples-leaf", type=int, default=3)

   # Data, model, and output directories
   parser.add_argument("--model-dir", type=str, default=os.environ.get("SM_MODEL_DIR"))
   parser.add_argument("--train", type=str, default=os.environ.get("SM_CHANNEL_TRAIN"))
   parser.add_argument("--test", type=str, default=os.environ.get("SM_CHANNEL_TEST"))
   parser.add_argument("--train-file", type=str, default="dry-bean-train.csv")
   parser.add_argument("--test-file", type=str, default="dry-bean-test.csv")
   args, _ = parser.parse_known_args()

   print("reading data")

   train_df = pd.read_csv(os.path.join(args.train, args.train_file))
   test_df = pd.read_csv(os.path.join(args.test, args.test_file))

   print("building training and testing datasets")

   X_train = train_df.drop("Class", axis=1)
   X_test = test_df.drop("Class", axis=1)
   y_train = train_df[["Class"]]
   y_test = test_df[["Class"]]

   # Train model
   print("training model")

   model = RandomForestClassifier(
       n_estimators=args.n_estimators,
       min_samples_leaf=args.min_samples_leaf,
       n_jobs=-1,
   )

   model.fit(X_train, y_train)

   # Print abs error
   print("validating model")

   bal_acc_train = balanced_accuracy_score(y_train, model.predict(X_train))
   bal_acc_test = balanced_accuracy_score(y_test, model.predict(X_test))

   print(f"Train balanced accuracy: {bal_acc_train:.3f}")
   print(f"Test balanced accuracy: {bal_acc_test:.3f}")

   # Persist model
   path = os.path.join(args.model_dir, "model.joblib")
   joblib.dump(model, path)
   print("model persisted at " + path)
Der Magic-Befehl %%writefile script.py wandelt den Zelleninhalt in ein Python-Skript um, statt ihn auszuführen.
Gehen wir das Skript Schritt für Schritt durch:
import argparse
import os
import joblib
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import balanced_accuracy_score
Zuerst importieren wir die benötigten Bibliotheken.
if __name__ == "__main__":
   print("extracting arguments")
   parser = argparse.ArgumentParser()

   # Hyperparameters sent by the client are passed as command-line arguments to the script.
   parser.add_argument("--n-estimators", type=int, default=10)
   parser.add_argument("--min-samples-leaf", type=int, default=3)

   # Data, model, and output directories
   parser.add_argument("--model-dir", type=str, default=os.environ.get("SM_MODEL_DIR"))
   parser.add_argument("--train", type=str, default=os.environ.get("SM_CHANNEL_TRAIN"))
   parser.add_argument("--test", type=str, default=os.environ.get("SM_CHANNEL_TEST"))
   parser.add_argument("--train-file", type=str, default="dry-bean-train.csv")
   parser.add_argument("--test-file", type=str, default="dry-bean-test.csv")
   args, _ = parser.parse_known_args()
Dann erstellen wir einen Argument-Parser für die Kommandozeilenargumente. Wie gesagt: Alles, was später veränderlich sein soll, wird als CLI-Argument übergeben. Dieser Abschnitt definiert diese Argumente:
Achte auf die Default-Werte der Verzeichnisse model-dir, train und test: Das sind Umgebungsvariablen aus den SageMaker-SDK-Dokumenten, die auch Anleitungen für solche Skripte enthalten.
print("reading data")
train_df = pd.read_csv(os.path.join(args.train, args.train_file))
test_df = pd.read_csv(os.path.join(args.test, args.test_file))
print("building training and testing datasets")
X_train = train_df.drop("Class", axis=1)
X_test = test_df.drop("Class", axis=1)
y_train = train_df[["Class"]]
y_test = test_df[["Class"]]
Nachdem die dynamischen Werte definiert sind, lesen wir die Daten ein und bauen Trainings- und Testsets. Statt fest kodierter Pfade verwenden wir die args.argument-Werte.
# Train model
print("training model")

model = RandomForestClassifier(
    n_estimators=args.n_estimators,
    min_samples_leaf=args.min_samples_leaf,
    n_jobs=-1,
)

model.fit(X_train, y_train)

# Print abs error
print("validating model")

bal_acc_train = balanced_accuracy_score(y_train, model.predict(X_train))
bal_acc_test = balanced_accuracy_score(y_test, model.predict(X_test))

print(f"Train balanced accuracy: {bal_acc_train:.3f}")
print(f"Test balanced accuracy: {bal_acc_test:.3f}")
Wir trainieren das Modell, evaluieren auf Trainings- und Testdaten und geben die Performance aus.
# Persist model
path = os.path.join(args.model_dir, "model.joblib")
joblib.dump(model, path)
print("model persisted at " + path)
Zum Schluss speichern wir das Modell mit joblib im Model-Verzeichnis.
Wenn du diese Zelle im Notebook ausführst, erscheint die Datei script.py in deiner JupyterLab-Umgebung. Du kannst die Funktion prüfen, indem du sie so startest:
! python script.py --n-estimators 100 \

                  --min-samples-leaf 2 \

                  --model-dir ./ \

                  --train ./ \

                  --test ./ \
extracting arguments
reading data
building training and testing datasets
validating model
Train balanced accuracy: 1.000
Test balanced accuracy: 0.998
model persisted at ./modejoblibStark, wir erreichen 99 % Balanced Accuracy – besser wird es kaum! Damit können wir das Training als Job starten.
Jetzt übergeben wir das Skript an ein SageMaker-Estimator-Objekt. In AWS ist ein Trainingsjob ein Prozess, bei dem ein Modell mit einem angegebenen Algorithmus, Dataset und den von SageMaker bereitgestellten Compute-Ressourcen trainiert wird. Anders als lokal läuft dieser Job in der Cloud auf skalierbarer Infrastruktur – mit mehr Leistung, schnellerer Verarbeitung und der Fähigkeit, größere Datasets zu bewältigen.
Füge folgenden Code in eine neue Notebook-Zelle ein:
# We use the Estimator from the SageMaker Python SDK
from sagemaker.sklearn.estimator import SKLearn
FRAMEWORK_VERSION = "0.23-1"

sklearn_estimator = SKLearn(
   entry_point="script.py",
   role=get_execution_role(),
   instance_count=1,
   instance_type="ml.c5.xlarge",
   framework_version=FRAMEWORK_VERSION,
   base_job_name="rf-scikit",
   hyperparameters={
       "n-estimators": 100,
       "min-samples-leaf": 3,
   },
)
Die Klasse SKLearn arbeitet mit scikit-learn-Skripten. Wichtige Parameter sind:
entry_point: Pfad zum Skript.role: Der Benutzer bzw. die Rolle mit Zugriff auf SageMaker.instance_count: Anzahl der Maschinen.instance_type: Maschinentyp.Bei den Hyperparametern übergib nur die, die im Trainingsskript definiert sind – sonst kommt es zu Fehlern.
Jetzt können wir den Estimator fitten:
# Launch training job, with asynchronous call
sklearn_estimator.fit({"train": trainpath, "test": testpath}, wait=True)
Erinnerung: trainpath und testpath sind S3-Pfade zu unseren CSV-Dateien.
Nach dem Start siehst du die Trainingslogs:
INFO:sagemaker:Creating training-job with name: rf-scikit-2024-06-04-10-36-31-142

2024-06-04 10:36:31 Starting - Starting the training job...

2024-06-04 10:36:46 Starting - Preparing the instances for training...

2024-06-04 10:37:13 Downloading - Downloading input data...

2024-06-04 10:37:53 Training - Training image download completed. Training in progress...
SageMaker lädt das benötigte Docker-Image für scikit-learn und führt dein Skript aus. Nach Abschluss erhältst du eine Meldung wie diese:
2024-06-04 10:38:17 Uploading - Uploading generated training model

2024-06-04 10:38:17 Completed - Training job completed

Training seconds: 65

Billable seconds: 65
Im SageMaker-Dashboard findest du den Job unter „SageMaker“ > „Training“ > „Training Jobs“.
Da unser Dataset klein ist, reicht eine günstige, schwächer konfigurierte Maschine wie ml.c5.xlarge. In deinen Projekten können jedoch Millionen von Datensätzen oder große Bilddatensätze anfallen. Dann brauchst du deutlich leistungsstärkere Maschinen und GPUs.
On-Demand-Nutzung solcher Maschinen kann sehr teuer werden. Um Kosten zu senken, bietet Amazon Spot-Training-Instanzen. Damit bekommst du High-Performance-Ressourcen zu geringen Kosten – mit dem Vorbehalt, dass das Training nicht sofort startet. SageMaker wartet, bis die Nachfrage sinkt und die angeforderte Maschine verfügbar ist.
Zum Aktivieren von Spot Training genügen wenige Zeilen zusätzlich:
spot_sklearn_estimator = SKLearn(
   entry_point="script.py",
   role=get_execution_role(),
   instance_count=1,
   instance_type="ml.c5.xlarge",
   framework_version=FRAMEWORK_VERSION,
   base_job_name="rf-scikit",
   hyperparameters={
       "n-estimators": 100,
       "min-samples-leaf": 3,
   },
   use_spot_instances=True,
   max_wait=7200,
   max_run=3600,
)
Mit use_spot_instances=True nutzt spot_sklearn_estimator Spot-Training. Du kannst zudem maximale Wartezeit bis zur Verfügbarkeit und maximale Trainingsdauer festlegen.
Das Training startet, wenn du erneut .fit() aufrufst:
# Launch training job, with asynchronous call
spot_sklearn_estimator.fit({"train": trainpath, "test": testpath}, wait=True)Mit demselben Trainingsskript können wir ein hyperparameteroptimiertes Modell in einem ähnlichen Workflow erzeugen.
Zuerst importieren wir die Klasse IntegerParameter aus sagemaker.tuner:
from sagemaker.tuner import IntegerParameterDie Klasse IntegerParameter erlaubt es, Tuning-Bereiche für ganzzahlige Parameter festzulegen. Das Modul tuner enthält weitere Parametertypen:
CategoricalParameter: Für diskrete, kategoriale Werte.ContinuousParameter: Für kontinuierliche Wertebereiche.Wir bleiben bei IntegerParameter, da wir zwei Parameter des Random Forest tunen:
# We use the Hyperparameter Tuner
from sagemaker.tuner import IntegerParameter

# Define exploration boundaries
hyperparameter_ranges = {
   "n-estimators": IntegerParameter(20, 100),
   "min-samples-leaf": IntegerParameter(2, 6),
}
Dann erstellen wir das Tuning-Objekt:
# Create Optimizer
Optimizer = sagemaker.tuner.HyperparameterTuner(
   estimator=sklearn_estimator,
   hyperparameter_ranges=hyperparameter_ranges,
   base_tuning_job_name="RF-tuner",
   objective_type="Maximize",
   objective_metric_name="balanced-accuracy",
   metric_definitions=[
       {"Name": "balanced-accuracy", "Regex": "Test balanced accuracy: ([0-9.]+).*$"}
   ],  # Extract tracked metric from logs with regexp
   max_jobs=10,
   max_parallel_jobs=2,
)
Wesentliche Parameter des Optimizer sind:
estimator: Das Estimator-Objekt, kompatibel mit deinem Trainingsskript.hyperparameter_ranges: Die mit den tuner-Klassen definierten Suchräume.objective_type: Ob die Metrik maximiert oder minimiert wird. Balanced Accuracy wird maximiert.metric_definitions: Name der zu optimierenden Metrik und wie sie aus Logs extrahiert wird.Der Parameter metric_definitions ist etwas knifflig, bietet aber viel Flexibilität bei der Definition von Metriken.
Im Trainingsskript geben wir die Balanced Accuracy mit diesen Log-Meldungen aus:
print(f"Train balanced accuracy: {bal_acc_train:.3f}")
print(f"Test balanced accuracy: {bal_acc_test:.3f}")
In metric_definitions erfassen wir diese Meldung per regulärem Ausdruck. Das folgende Dictionary vergibt einen benutzerdefinierten Namen für die Metrik, die mit „Test balanced accuracy“ beginnt.
{
   "Name": "balanced-accuracy",
   "Regex": "Test balanced accuracy: ([0-9.]+).*$",
}
Der Rest ist bekannt:
Optimizer.fit({"train": trainpath, "test": testpath})INFO:sagemaker:Creating hyperparameter tuning job with name: RF-tuner-240604-1049Nach Abschluss kannst du die Ergebnisse als DataFrame anzeigen:
# Get tuner results in a df
results = Optimizer.analytics().dataframe()

while results.empty:
   time.sleep(1)
   results = Optimizer.analytics().dataframe()

results.head()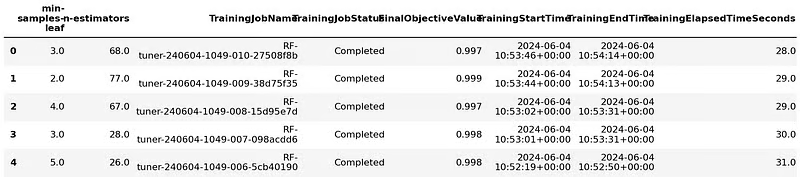
Dann kannst du den besten Estimator abrufen:
best_estimator = Optimizer.best_estimator()Wenn du dich für ein Modell entschieden hast, kannst du es mit allen Artefakten zu SageMaker hochladen. Das geht mit boto3:
artifact_path = sm_boto3.describe_training_job(
   TrainingJobName=best_estimator.latest_training_job.name
)["ModelArtifacts"]["S3ModelArtifacts"]

print("Model artifact persisted at " + artifact)
Model artifact persisted at s3://sagemaker-us-east-1-496320894061/RF-tuner-240604-1049-009-38d75f35/output/model.tar.gzDie Funktion describe_training_job() nimmt das Estimator-Objekt und legt es an einem Standard-S3-Speicherort von SageMaker ab. Wie oben zu sehen, wird das Modell vor dem Upload als Tarball gepackt.
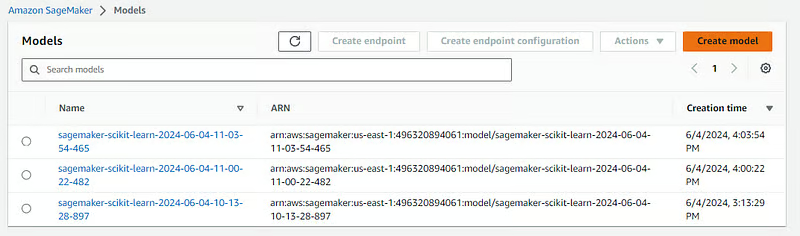
Hochgeladene Modelle findest du im Dashboard unter „Inference“ > „Models“:
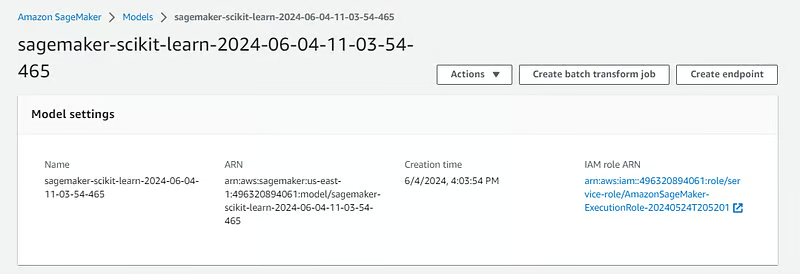
Wenn du auf ein Modell klickst, siehst du oben rechts den Button „Create endpoint“:
Du kannst das Modell über den Button deployen – oder per Code zurück im Notebook mit der Methode .deploy():
from sagemaker.sklearn.model import SKLearnModel

model = SKLearnModel(
   model_data=artifact_path,
   role=get_execution_role(),
   entry_point="script.py",
   framework_version=FRAMEWORK_VERSION,
)
Diesmal nutzen wir die Klasse SKLearnModel für bereits trainierte Modelle. Benötigt werden der S3-Pfad zu den Artefakten und das Skript, mit dem trainiert wurde. Anschließend kannst du deployen:
predictor = model.deploy(instance_type="ml.c5.large", initial_instance_count=1)
INFO:sagemaker:Creating model with name: sagemaker-scikit-learn-2024-06-04-11-03-54-465
INFO:sagemaker:Creating endpoint-config with name sagemaker-scikit-learn-2024-06-04-11-03-54-960
INFO:sagemaker:Creating endpoint with name sagemaker-scikit-learn-2024-06-04-11-03-54-960
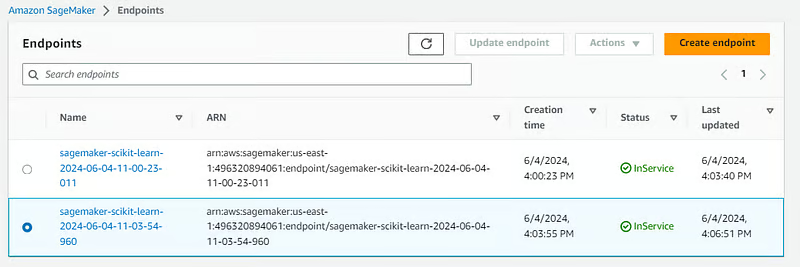
Danach sollte der Endpunkt unter „Inference“ > „Endpoints“ im Dashboard erscheinen:
Für Vorhersagen nutzt du im Notebook die Methode .predict() des Endpunkt-Objekts:
preds = predictor.predict(test.sample(4).drop("Class", axis=1))
preds
array([3, 0, 1, 2])Glückwunsch, du hast soeben dein erstes Modell mit SageMaker bereitgestellt!
Wenn du fertig bist, vergiss nicht, den Endpunkt zu löschen, da sonst laufend Kosten entstehen:
sm_boto3.delete_endpoint(EndpointName=predictor.endpoint)Denk daran: Jede Notebook-Instanz in SageMaker bringt einen separaten Tab mit Beispiel-Notebooks mit, die verschiedene SageMaker-Features demonstrieren:
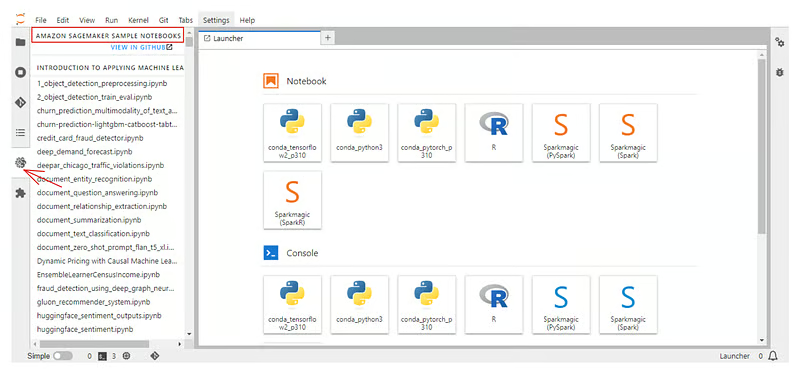
Sieh dir außerdem die offizielle Dokumentation zum SageMaker-Python-SDK an.
Heute hast du eine der beliebtesten Enterprise-ML-Plattformen kennengelernt: AWS SageMaker. Wir sind den gesamten Weg gegangen – vom Anlegen eines AWS-Kontos bis zum Deployment von ML-Modellen als Endpunkte mit SageMaker.
Wie bei jeder Plattform haben wir erst an der Oberfläche gekratzt. In Kombination mit weiteren AWS-Technologien kannst du noch viel mehr herausholen. Hier sind passende Ressourcen:
Lerne mehr über Machine Learning und AWS mit diesen Kursen!
Kurs
Kurs
Kurs