
Cours
Concepts d’AWS
2 h
51.9K
Même si la plupart des gens associent Amazon aux livraisons Prime et au contenu, l’entreprise est aussi très appréciée des développeurs. En particulier, Amazon Web Services (AWS) propose des technologies cloud à plus d’un million d’utilisateurs actifs, des grandes entreprises aux PME.
Dans cet article, nous allons nous concentrer sur AWS SageMaker, une plateforme dédiée pour exécuter des workflows de machine learning (ML) de bout en bout à très grande échelle, au sein de l’écosystème AWS. À la fin, nous aurons déployé un modèle capable de recevoir des requêtes pour générer des prédictions sur une tâche de classification.
Amazon SageMaker est un service entièrement géré qui fournit les outils et l’infrastructure nécessaires pour créer, entraîner et déployer des modèles de machine learning. Il simplifie le workflow ML afin de permettre aux data scientists et aux développeurs de concevoir, entraîner et déployer des modèles rapidement et efficacement.
Dans un projet de machine learning typique, vous passez par plusieurs étapes :
Chaque étape mobilise un outillage spécifique et des experts capables de les orchestrer sans friction. Amazon SageMaker rassemble l’ensemble de ce processus sur une seule plateforme. Voici quelques-uns de ses atouts :
Ces avantages font d’Amazon SageMaker une plateforme puissante et flexible pour créer, entraîner et déployer des modèles de machine learning à l’échelle.
Comme indiqué, SageMaker fait partie de l’écosystème AWS, qui regroupe de nombreuses solutions cloud couvrant le stockage, le réseau, les bases de données, l’analytique et le machine learning. Tous ces services fonctionnent de concert avec SageMaker pour unifier votre workflow ML.
Pour cette raison, SageMaker nécessite la création d’un compte AWS si vous n’en avez pas encore.
Pour créer votre compte, rendez-vous sur https://aws.amazon.com/ et suivez les étapes.
L’inscription inclut l’ajout d’informations de facturation et la vérification de votre numéro de téléphone. Pas d’inquiétude : vous ne serez facturé que lorsque vous commencerez réellement à utiliser des fonctionnalités de SageMaker (généralement à moindre coût).
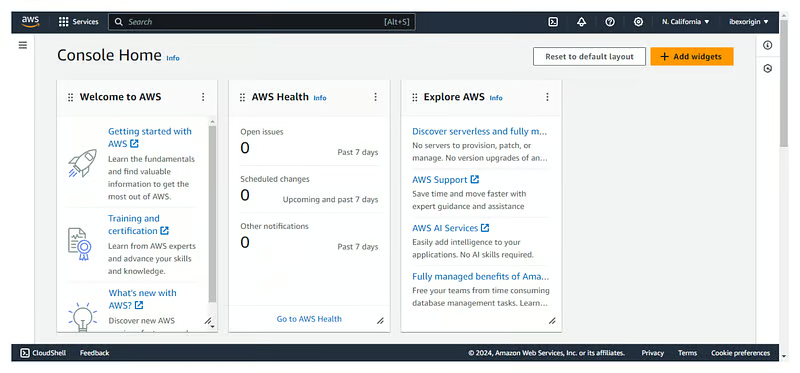
Une fois l’inscription terminée, vous accédez à votre console AWS, qui ressemble en général à l’image suivante. Notez que certains widgets peuvent différer chez vous.
Nous allons maintenant créer une session JupyterLab pour exécuter du code sur les machines cloud d’Amazon.
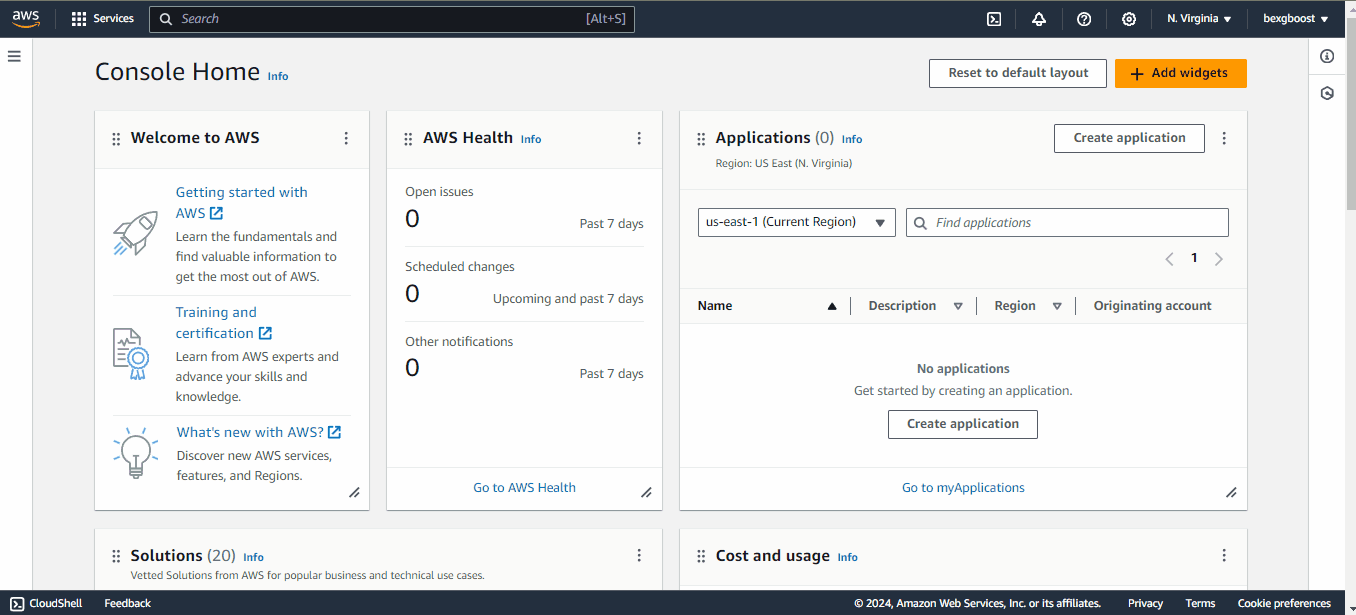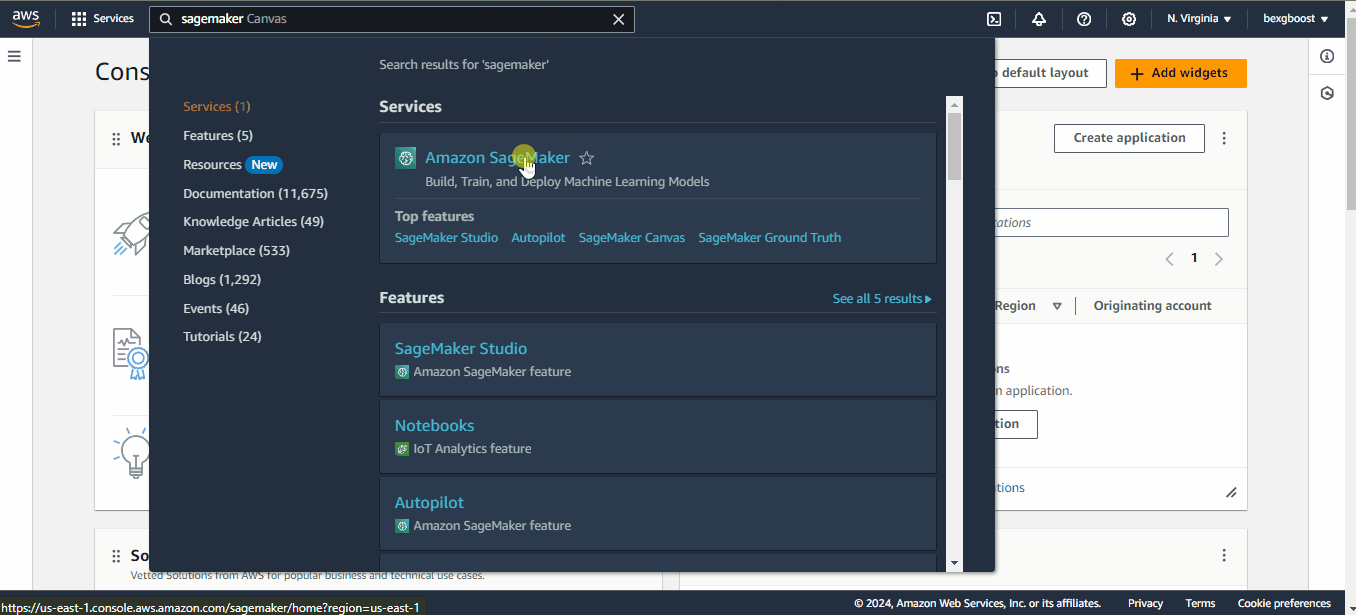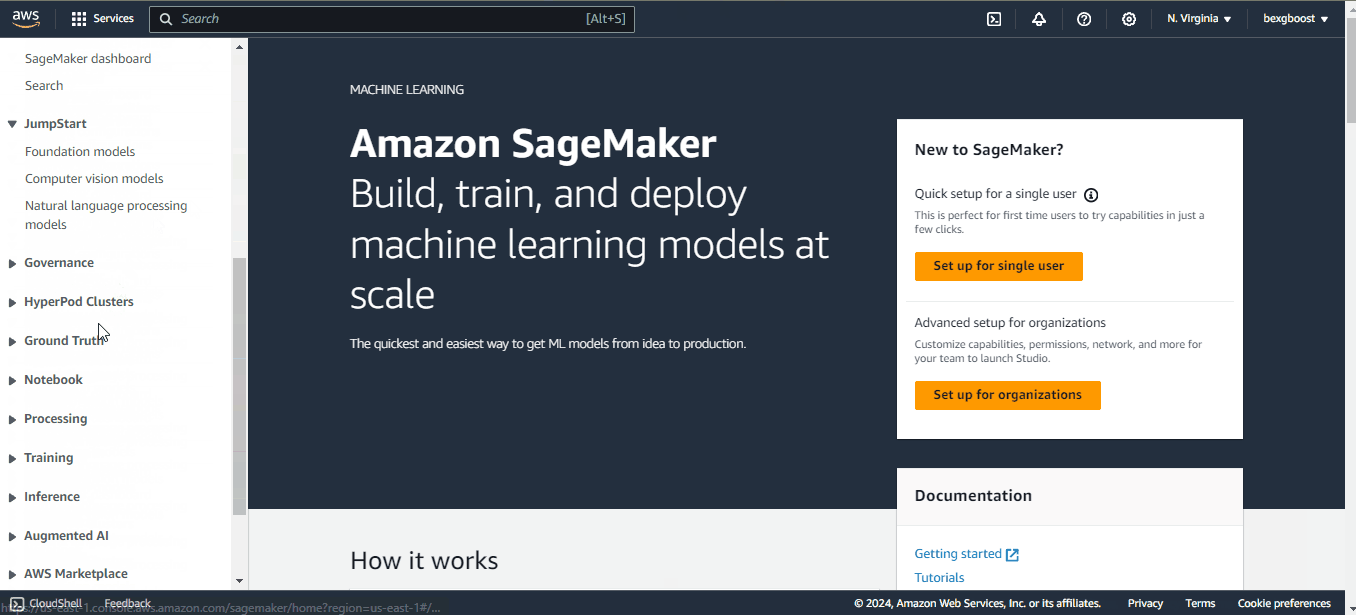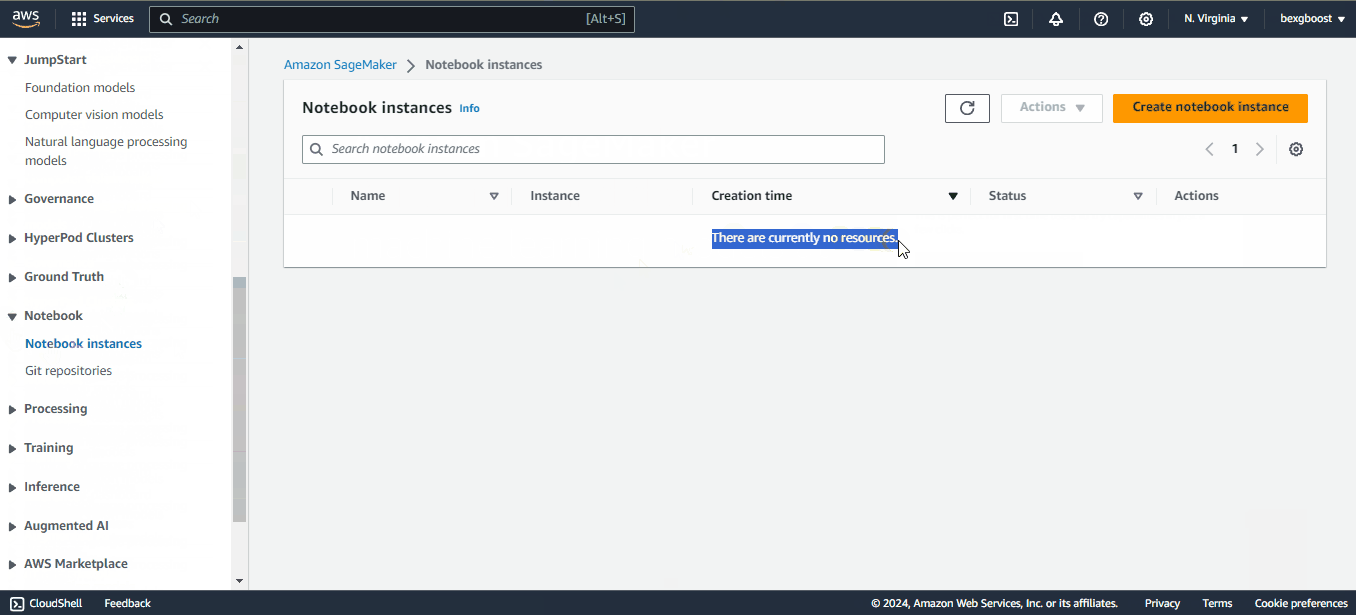
Depuis votre console AWS, recherchez le tableau de bord SageMaker via la barre de recherche en haut de l’écran :
Ensuite, faites défiler pour trouver l’onglet « Notebooks », puis l’option « Notebook instances ». Vous ne verrez aucune instance pour l’instant, nous allons en créer une :
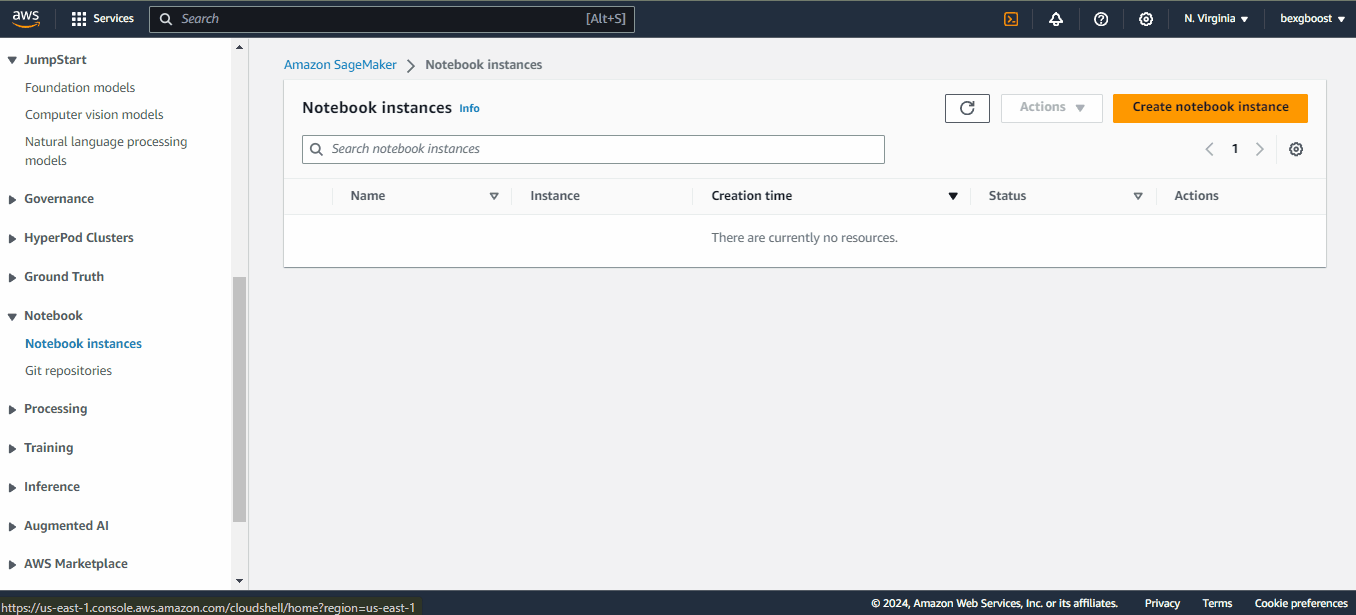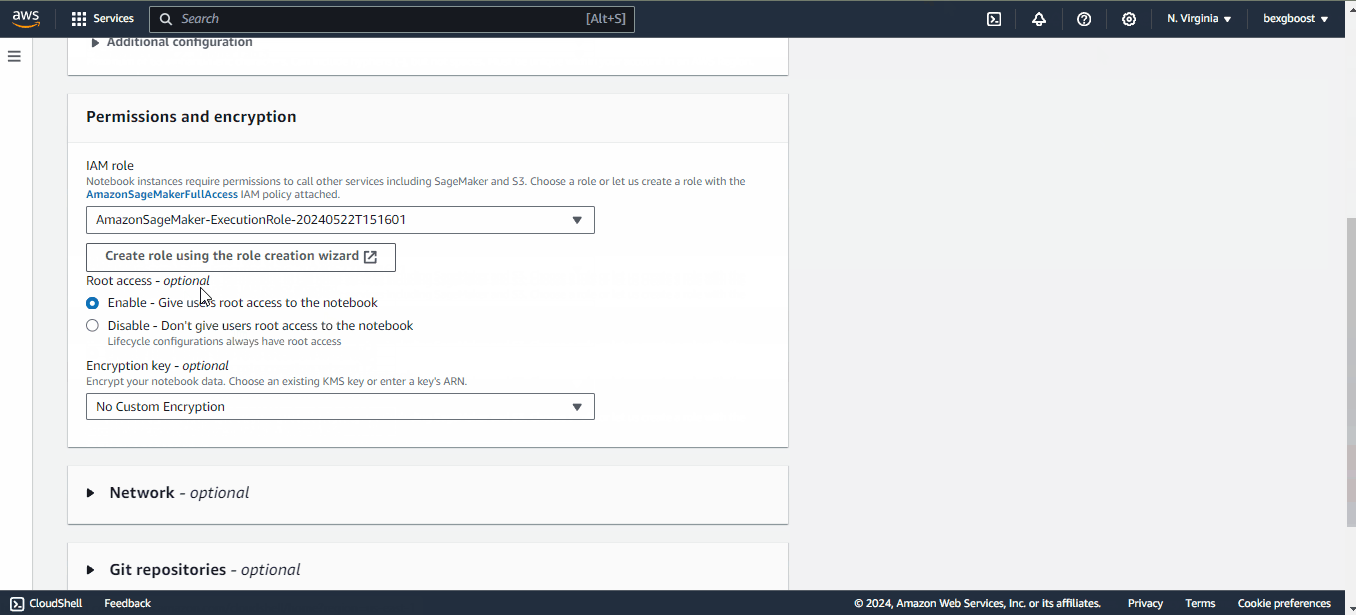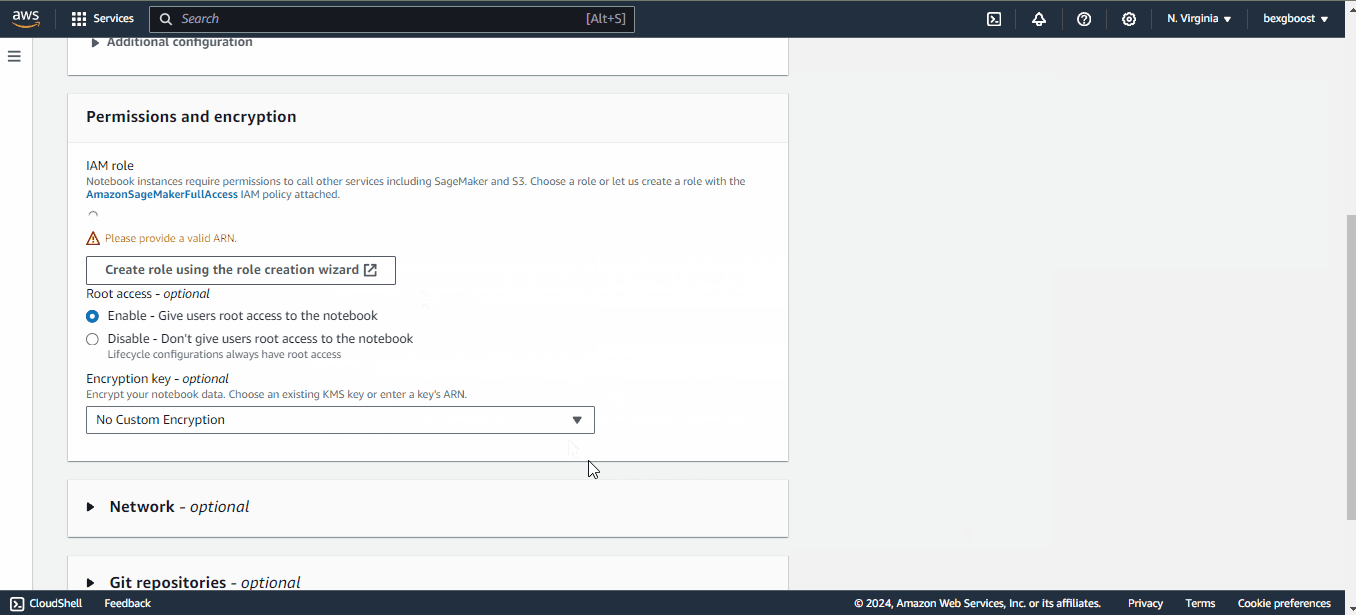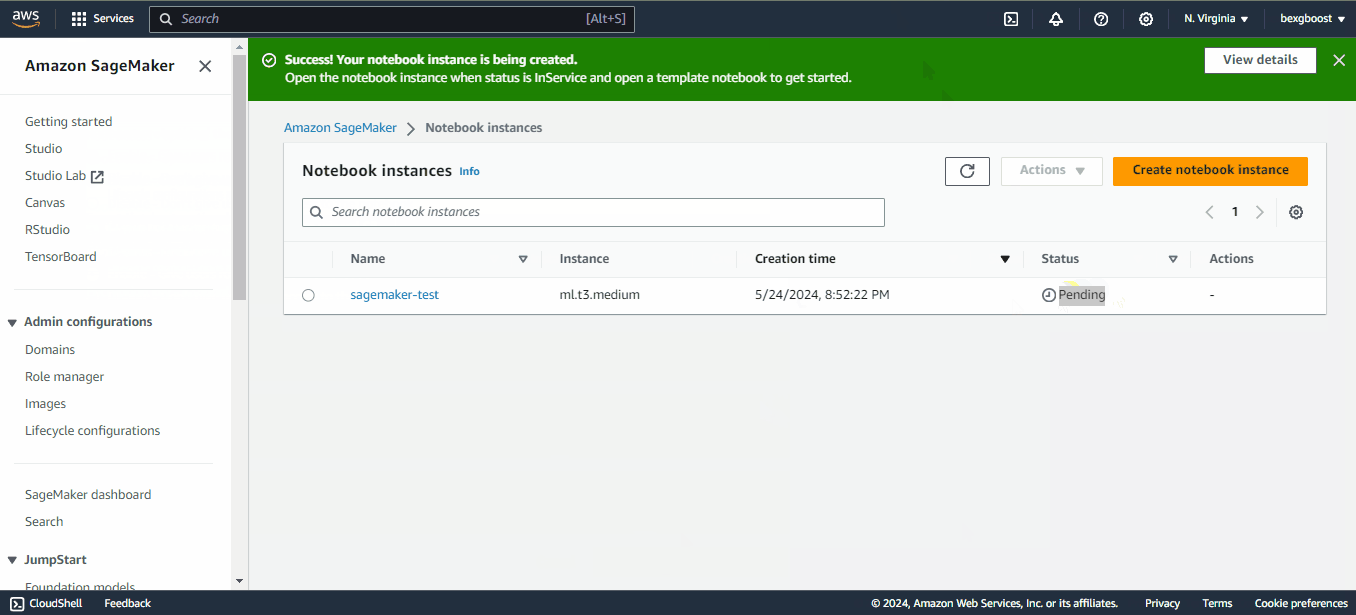
Pour créer un nouveau notebook, cliquez sur « Create notebook instance » en haut à droite. Renseignez ensuite les champs suivants :
sagemaker-test.Une fois les informations renseignées, cliquez sur « Create notebook instance ».
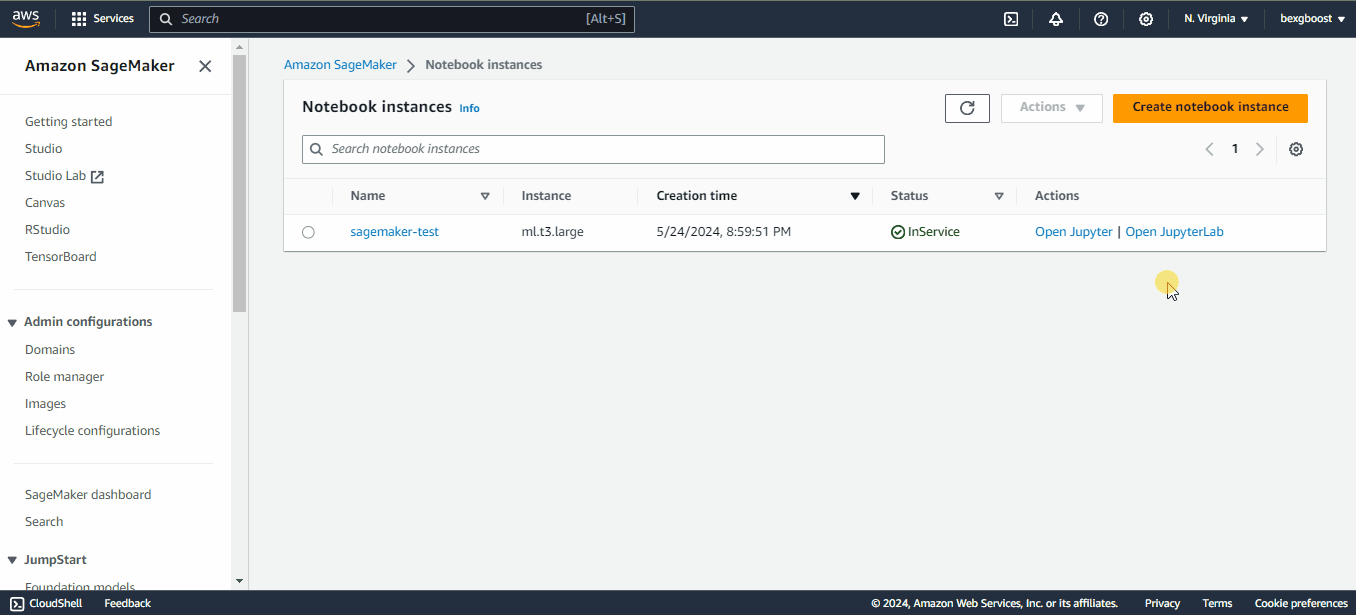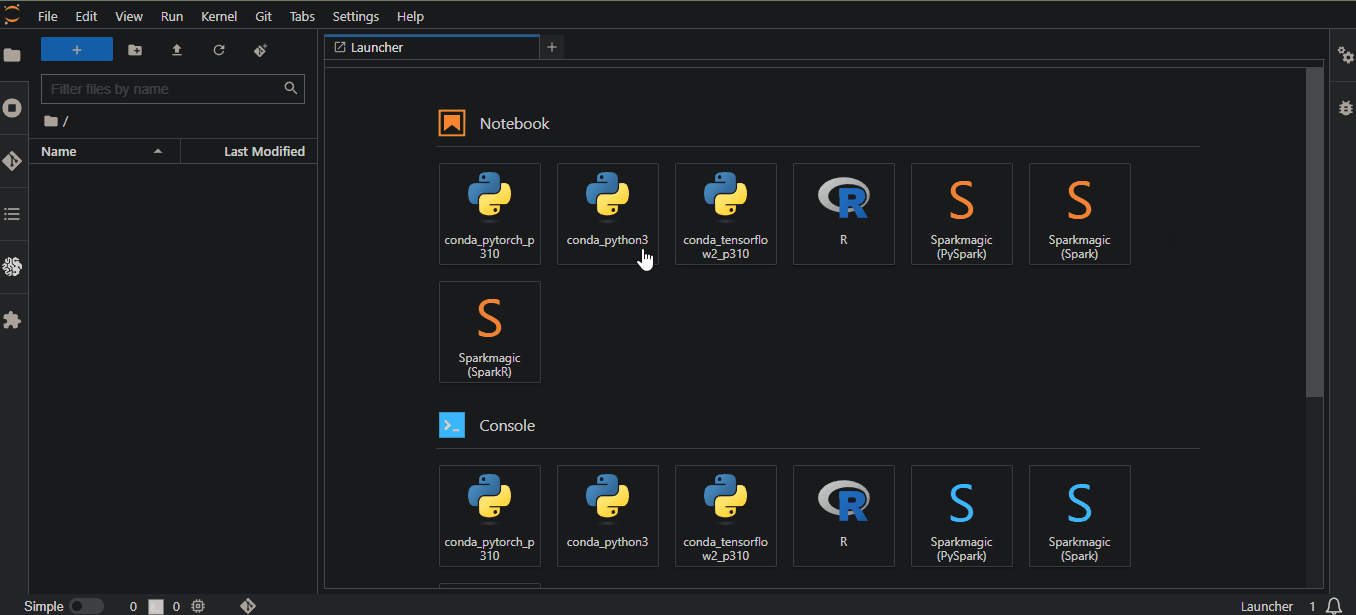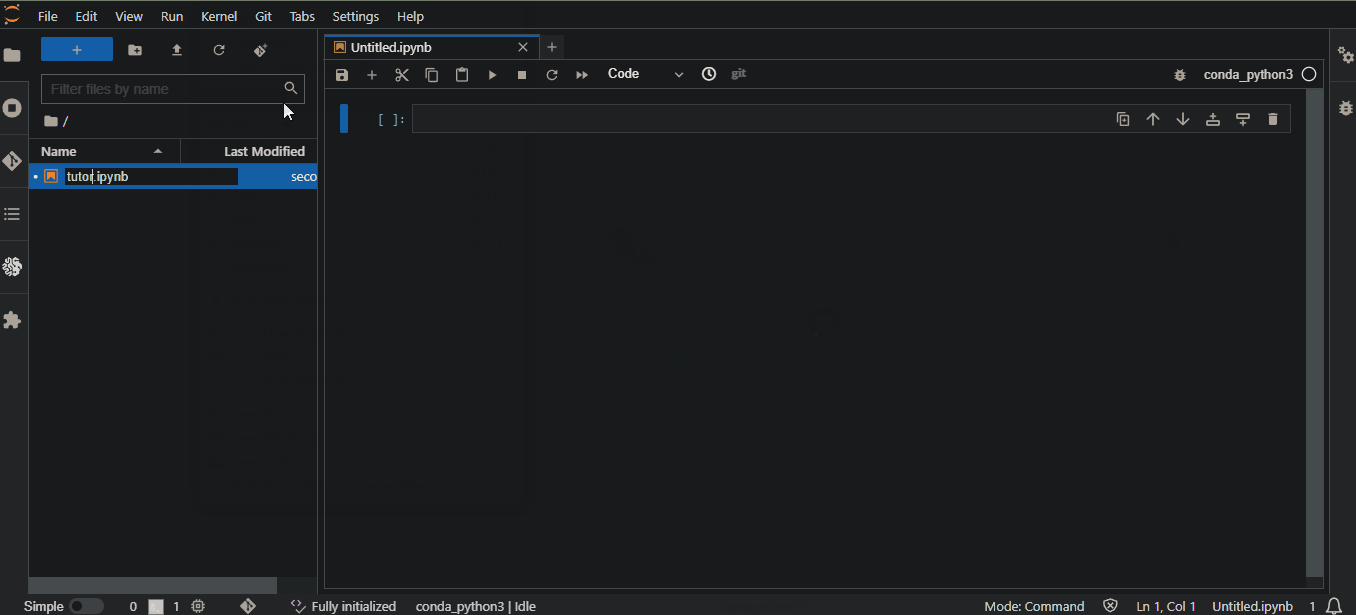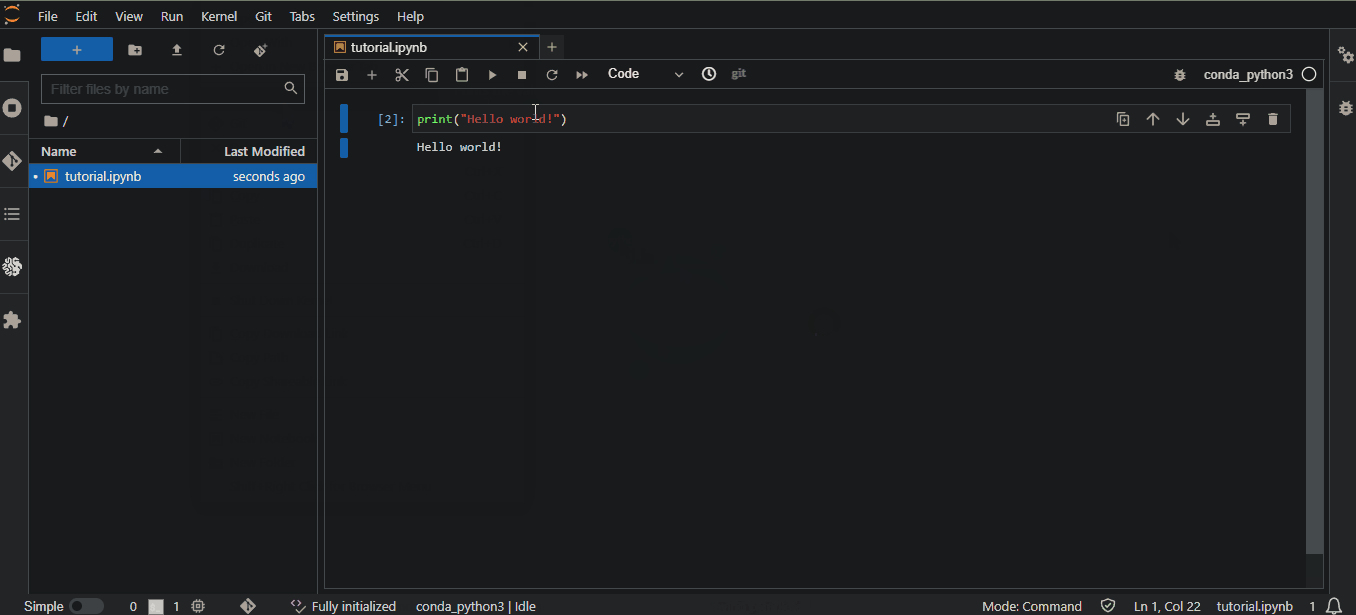
Quand le statut « Pending » passe à « inService », vous pouvez lancer JupyterLab en cliquant sur « Open in JupyterLab » à côté du notebook :
Dès que l’instance est active, le compteur tourne et la facturation commence. Si vous faites une pause, pensez à arrêter l’instance via « Actions » puis « Stop » pour éviter des coûts inutiles. L’arrêt automatique par défaut est fixé à deux heures :
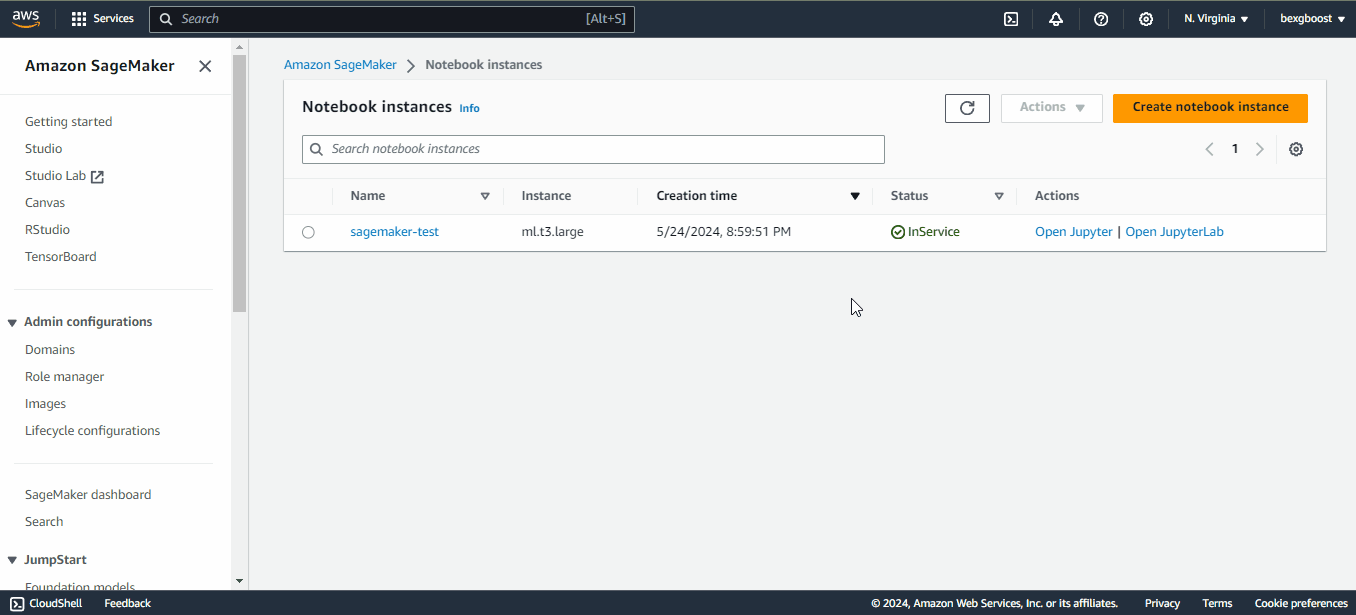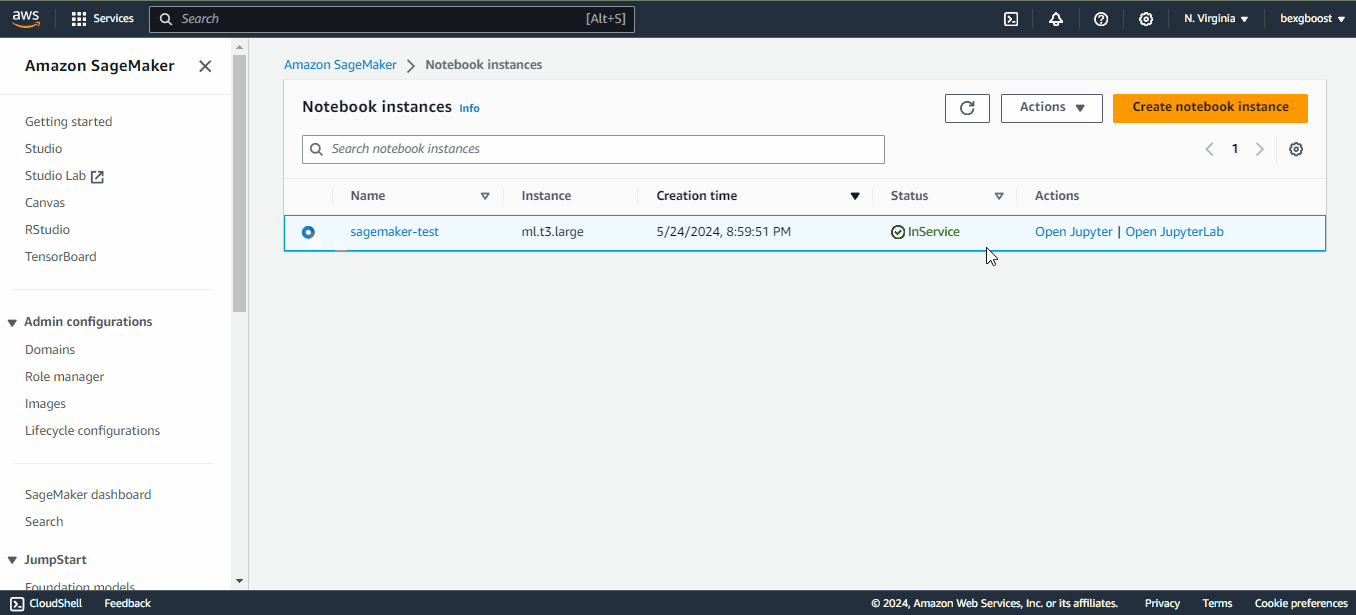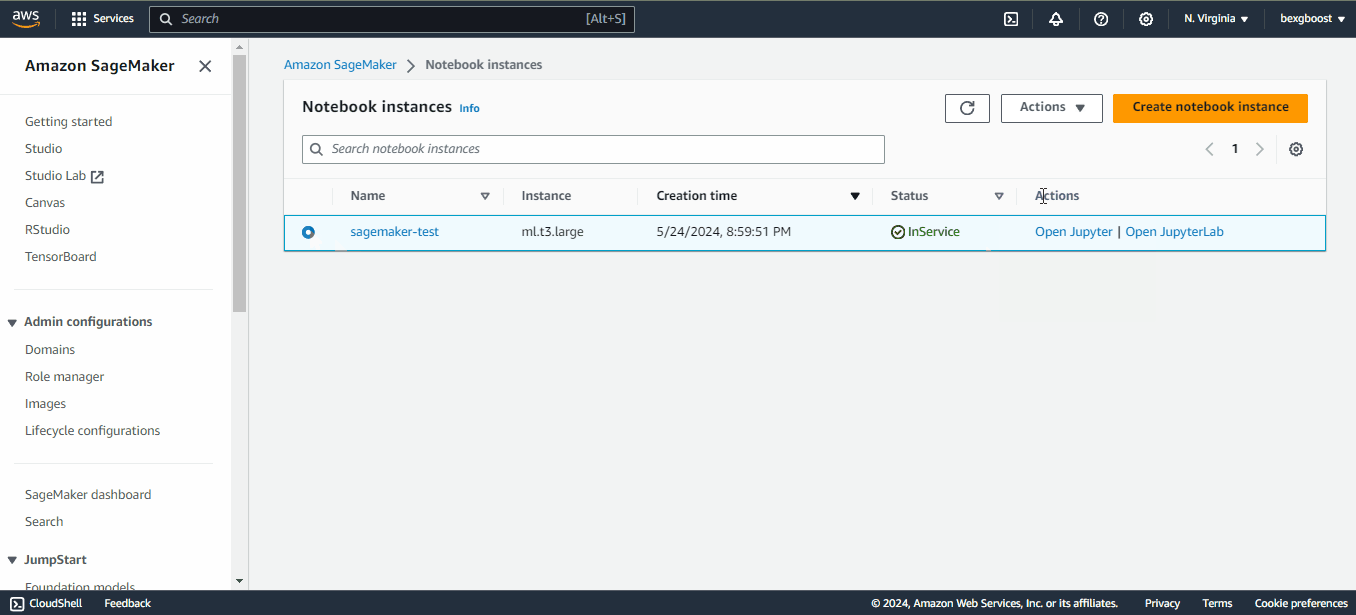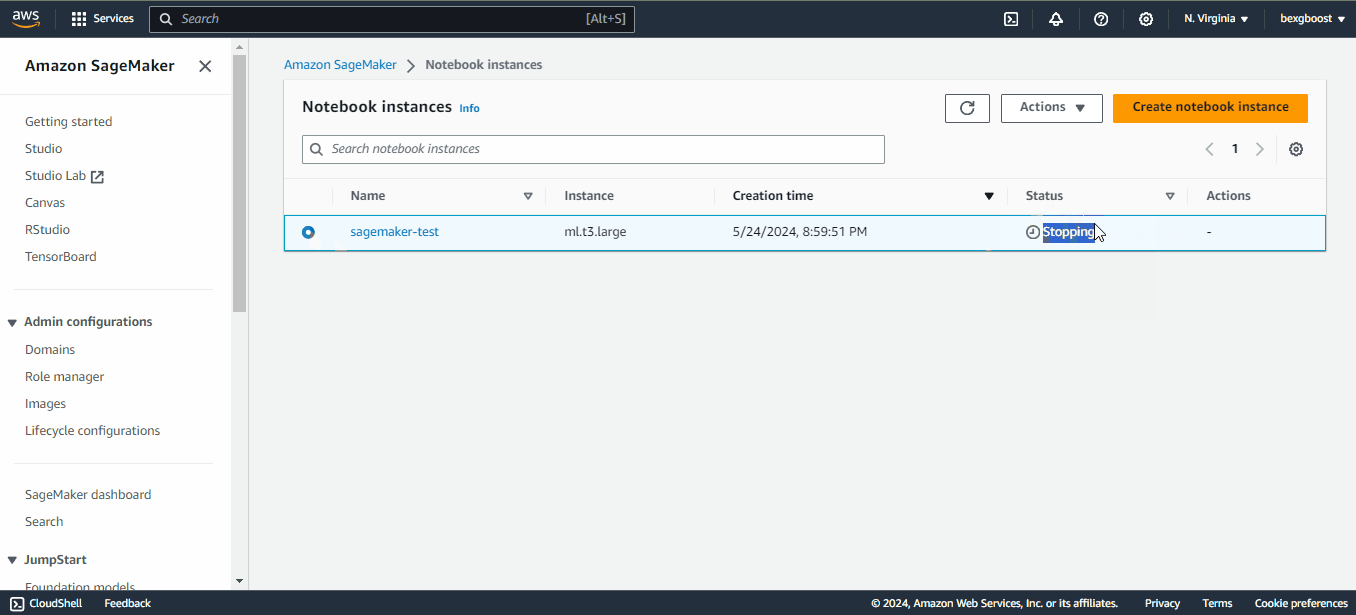
Si vous arrêtez une instance de notebook, vous pourrez la redémarrer plus tard. Votre environnement sera conservé.
Dans cette section, nous allons voir comment charger un fichier local sur les serveurs d’Amazon, condition requise pour SageMaker.
Nous construirons un classifieur multi-classes en utilisant le jeu de données Dry Bean du référentiel UCI ML. Il contient 13 000 enregistrements de haricots et 15 mesures numériques.
L’objectif est de les classer en sept types de haricots : Seker, Barbunya, Bombay, Cali, Dermosan, Horoz et Sira.
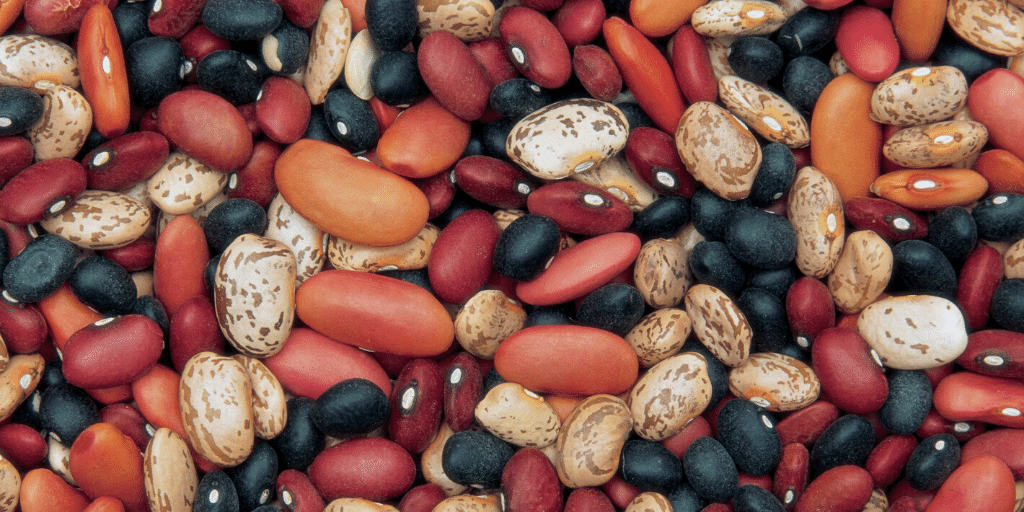
Les sept types de haricots : Seker, Barbunya, Bombay, Cali, Dermosan, Horoz et Sira.
Après téléchargement, enregistrez le fichier Excel contenu dans le ZIP dans votre répertoire local data de JupyterLab, puis ajoutez le code suivant à votre notebook :
from pathlib import Path

cwd = Path.cwd()
data_path = cwd / "data" / "Dry_Bean_Dataset.xlsx"
Ensuite, avec le code ci-dessous, nous lisons le fichier Excel avec pandas et l’enregistrons en CSV :
import pandas as pd

beans = pd.read_excel(data_path)
beans.to_csv(cwd / "data" / "dry_bean.csv", index=False)Notre jeu de données doit se trouver dans un bucket S3 pour être accessible par SageMaker. AWS S3 est une solution de stockage cloud qui vous permet de conserver les objets liés à votre projet dans des buckets hébergés sur les serveurs d’Amazon.
Pour créer un bucket, procédez comme suit :
dry-bean-bucket comme dans notre exemple.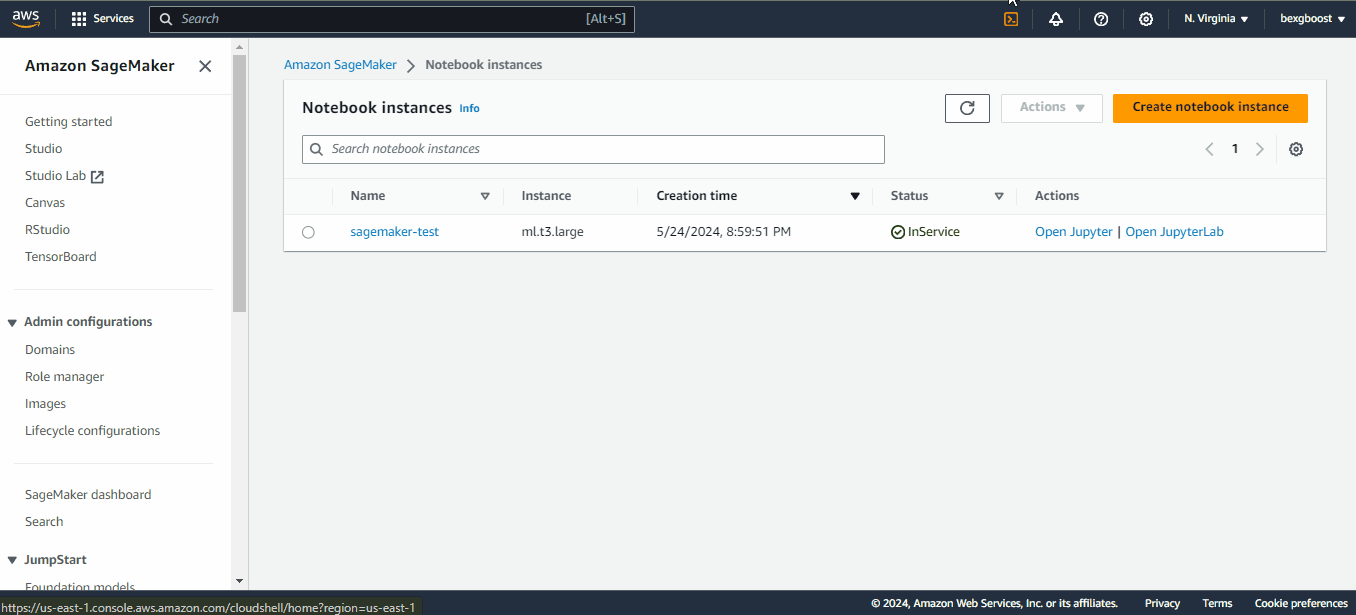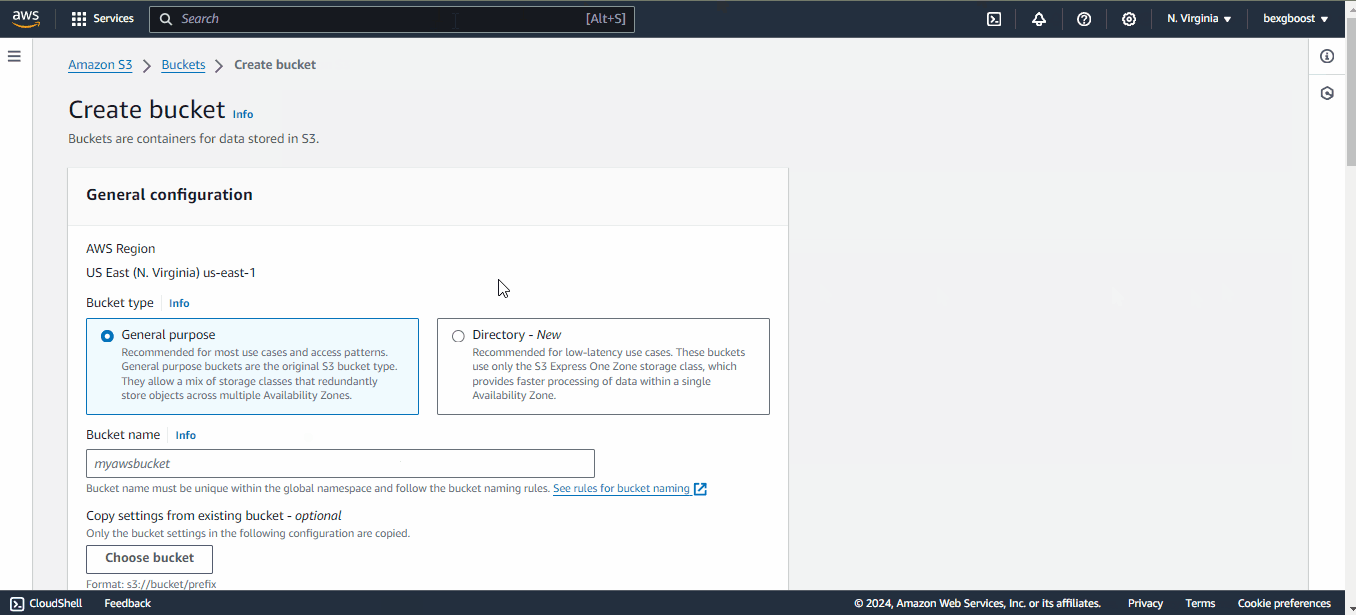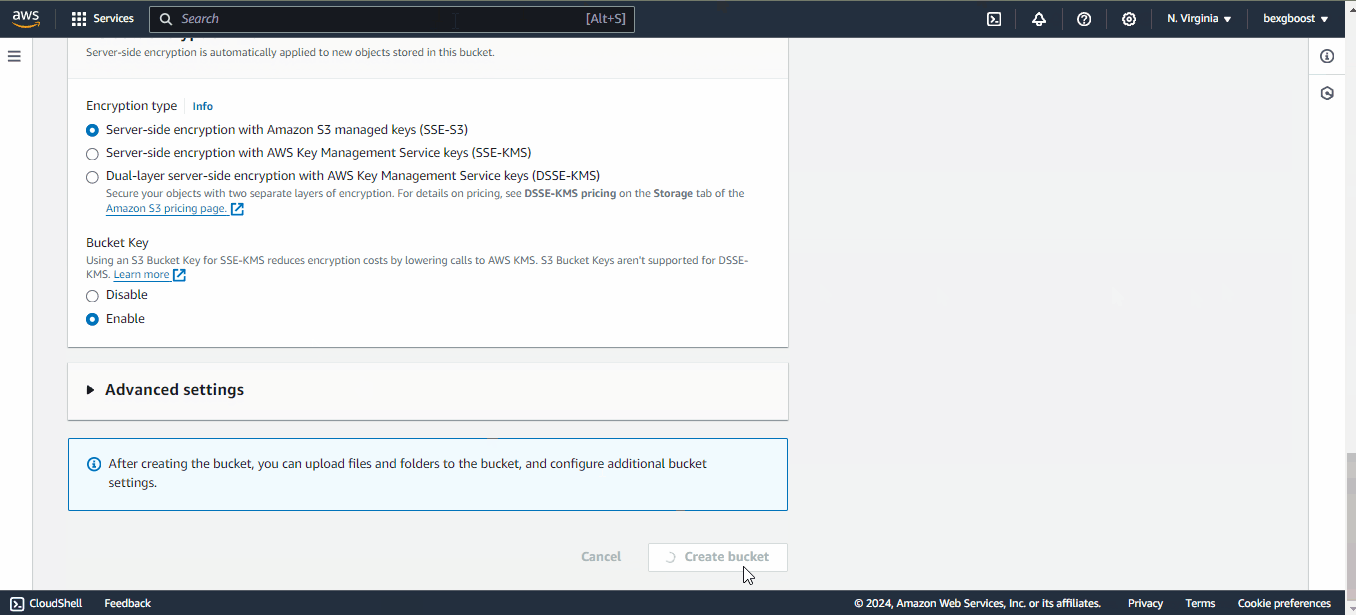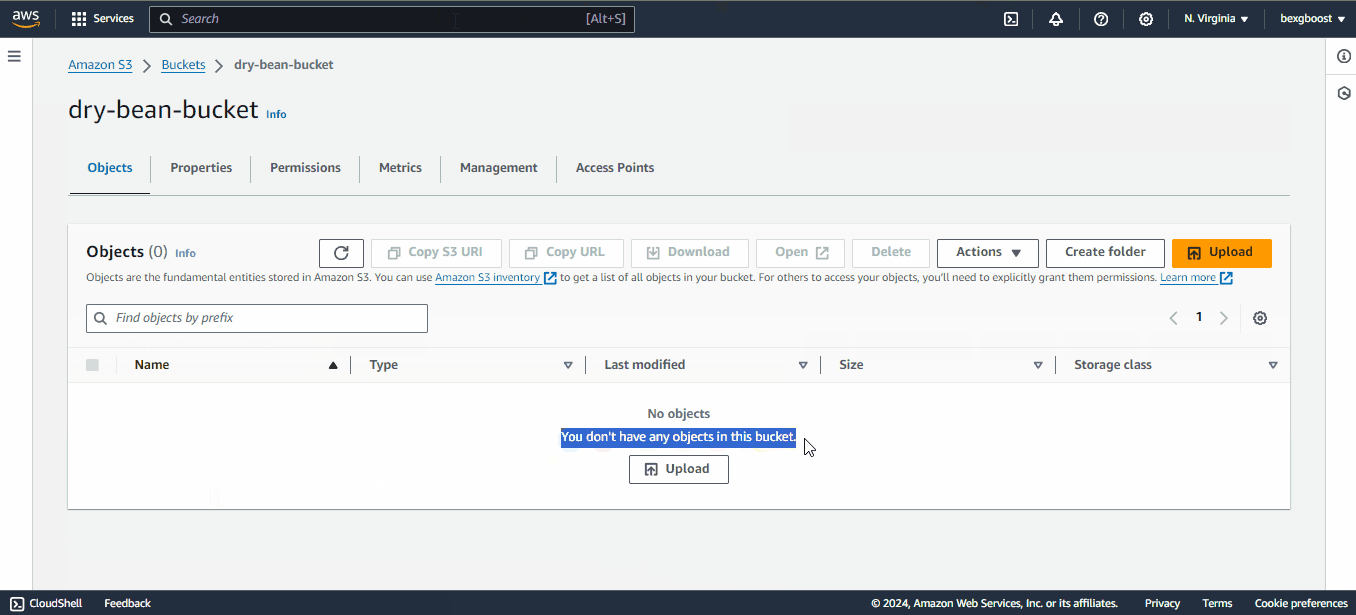
Une fois le bucket créé, cliquez dessus pour téléverser le fichier CSV sauvegardé précédemment :
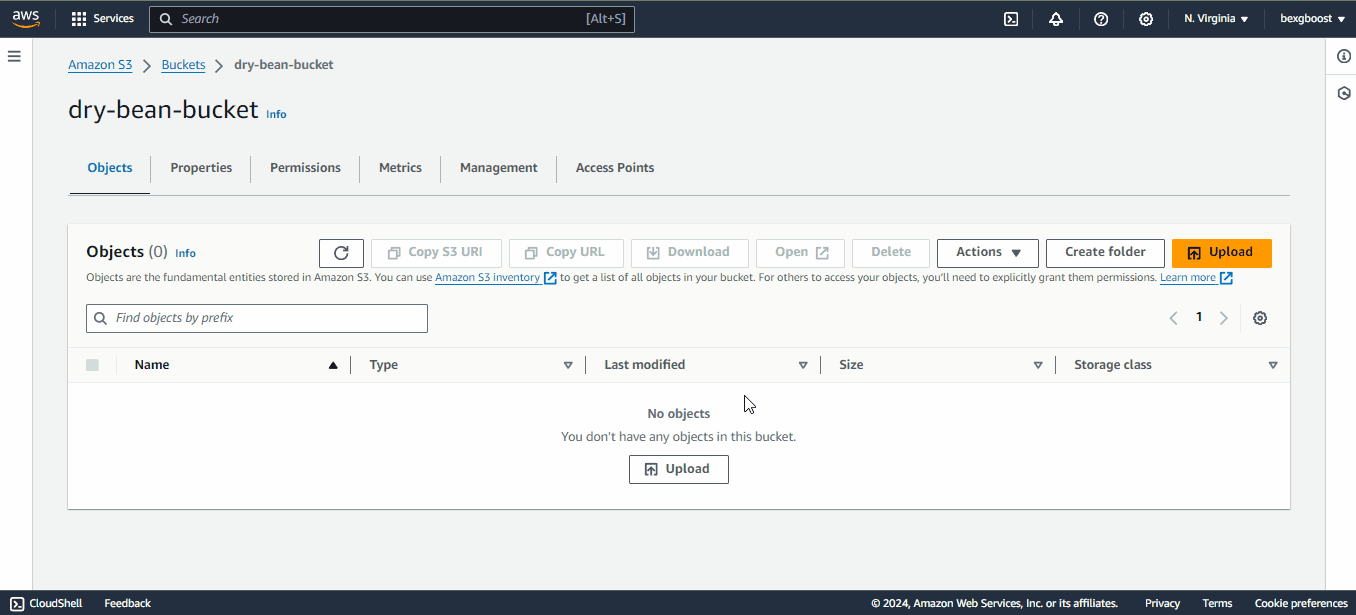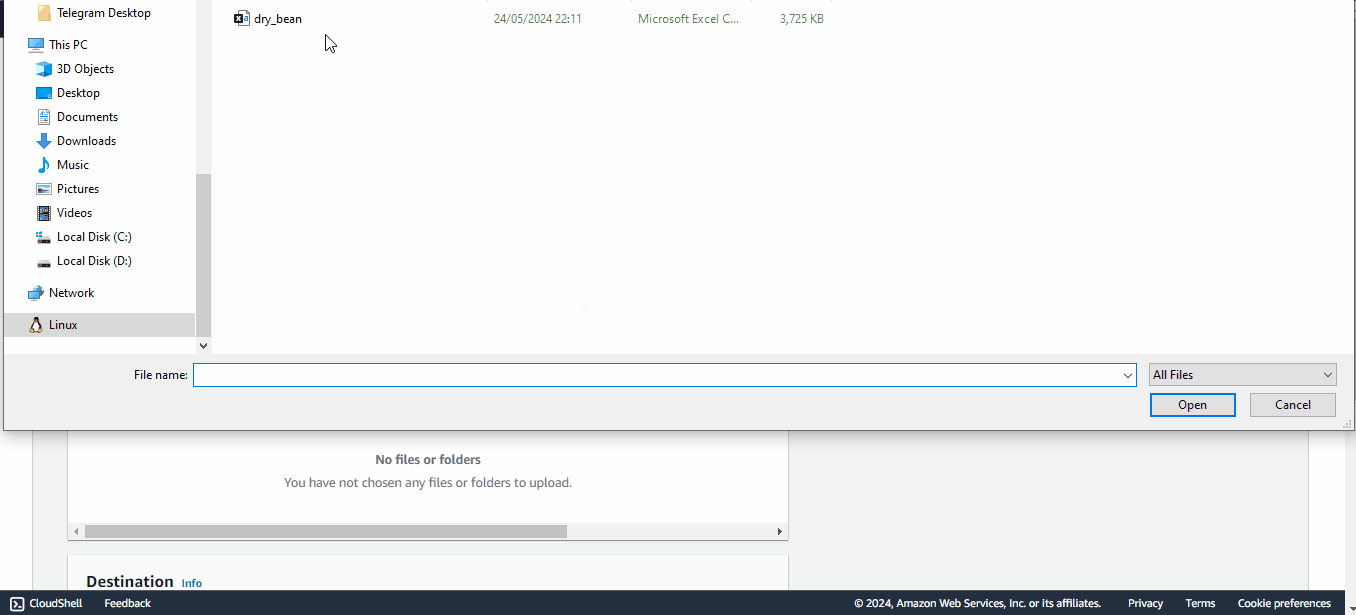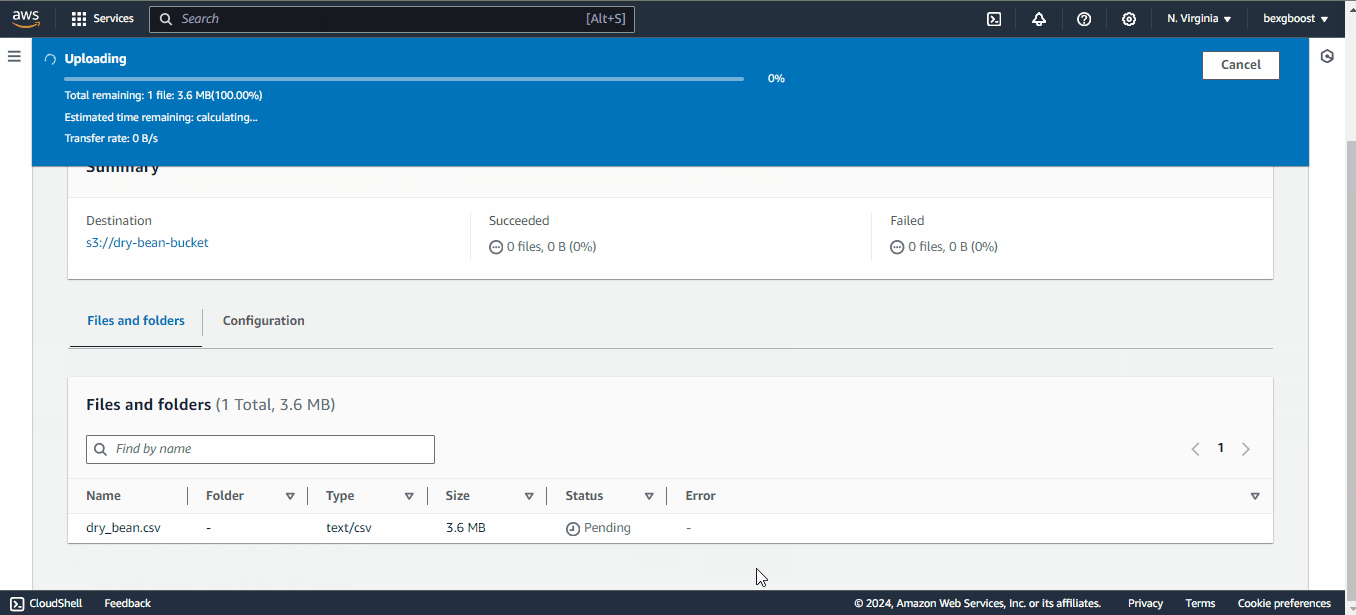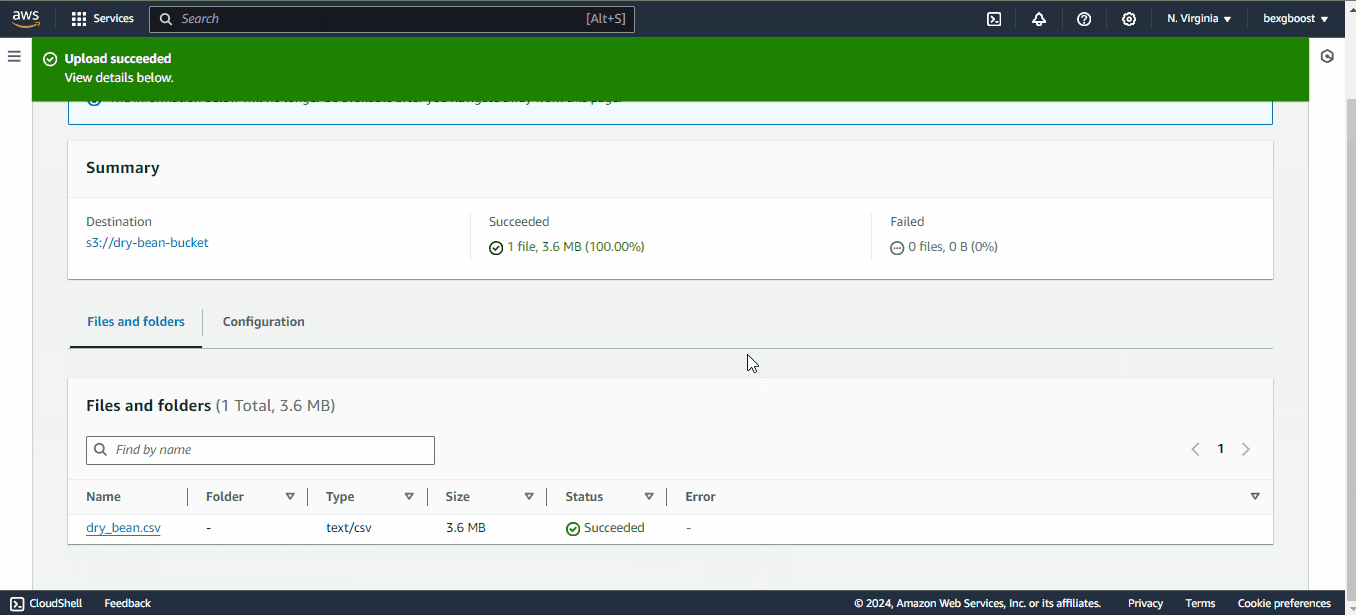
Vous pouvez ensuite revenir à l’interface JupyterLab, nous allons enfin exécuter du code !
Dans cette section, nous allons suivre un workflow de bout en bout, du CSV initial jusqu’à un modèle déployé sur un endpoint. Mais avant d’entrer dans les détails techniques, prenons un moment pour comprendre la démarche à haut niveau.
Faire du ML dans SageMaker diffère légèrement d’un environnement local. Nous avons déjà couvert les premières étapes :
Comme vos notebooks locaux, les instances de notebook SageMaker servent à l’analyse exploratoire : nettoyage, exploration, ingestion des données et premières expérimentations.
Une fois arrivé à l’entraînement, SageMaker impose certaines règles. En particulier, pour déployer vos modèles personnalisés en endpoints, il faut fournir un script d’entraînement qui :
Le script doit aussi accepter dynamiquement les variables via des arguments en ligne de commande. Autrement dit, tout paramètre que vous souhaitez modifier (hyperparamètres, chemins de fichiers, etc.) doit être passé en arguments.
Une fois prêt, ce script est transmis à des estimateurs spéciaux fournis par SageMaker. Ils servent de passerelles vers des bibliothèques ML populaires comme scikit-learn, XGBoost, TensorFlow, PyTorch, etc. À l’aide de ces estimateurs, SageMaker construit des conteneurs Docker autour de votre script et le déploie comme endpoint pour le servir à l’échelle.
Tous ces points deviendront clairs au fil des étapes.
Commençons par importer les bibliothèques nécessaires dans le notebook sagemaker-test que vous avez créé :
import boto3
import numpy as np
import pandas as pd
import sagemaker
from sagemaker import get_execution_role
from sklearn.model_selection import train_test_split
Voici à quoi servent certains de ces imports :
sagemaker est le SDK Python officiel pour entraîner et déployer des modèles sur Amazon SageMaker. Avec ce SDK, vous pouvez entraîner et déployer des modèles via des frameworks de deep learning populaires, des algorithmes fournis par Amazon, ou vos propres algorithmes intégrés dans des images Docker compatibles SageMaker.boto3 est un autre SDK Python officiel, qui fait le lien entre votre code et l’ensemble des services AWS, pas seulement SageMaker. Pour en savoir plus, consultez ce cours sur boto3. Après les imports, créons quelques ressources utiles pour la suite :
sm_boto3 = boto3.client("sagemaker")
sess = sagemaker.Session()boto3. Ces deux objets permettent d’interagir avec la plateforme SageMaker de différentes manières.
Définissons maintenant quelques variables globales :
region = sess.boto_session.region_name
BUCKET_URI = "s3://dry-bean-bucket"
BUCKET_NAME = "dry-bean-bucket"
DATASET_PATH = f"{BUCKET_URI}/dry_bean.csv"
TARGET_NAME = "Class"
Ces variables parlent d’elles-mêmes et nous les réutiliserons tout au long du tutoriel.
Dans la plupart des projets data, le jeu d’entraînement est stocké dans une solution cloud comme BigQuery, GCS ou un bucket AWS S3. Nous avons choisi cette dernière, chargeons donc les données avec pandas. Ajoutez le code suivant à votre notebook et exécutez-le :
dry_bean = pd.read_csv(DATASET_PATH)
dry_bean.head()
Un avantage des notebooks SageMaker est de pouvoir lire des fichiers depuis S3 directement avec pandas. Tous les environnements SageMaker sont configurés avec vos identifiants, ce qui permet à pandas de télécharger le CSV depuis le bucket. Ce code n’aurait pas fonctionné en local.
Consacrer du temps à l’EDA (analyse exploratoire) doit faire partie de chaque projet, et celui-ci ne fait pas exception. Toutefois, nous n’irons pas trop loin ici pour ne pas nous détourner du sujet principal.
Contentons-nous d’imprimer quelques statistiques et graphiques de synthèse :
dry_bean.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 13611 entries, 0 to 13610
Data columns (total 17 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Area 13611 non-null int64
1 Perimeter 13611 non-null float64
2 MajorAxisLength 13611 non-null float64
3 MinorAxisLength 13611 non-null float64
4 AspectRation 13611 non-null float64
5 Eccentricity 13611 non-null float64
6 ConvexArea 13611 non-null int64
7 EquivDiameter 13611 non-null float64
8 Extent 13611 non-null float64
9 Solidity 13611 non-null float64
10 roundness 13611 non-null float64
11 Compactness 13611 non-null float64
12 ShapeFactor1 13611 non-null float64
13 ShapeFactor2 13611 non-null float64
14 ShapeFactor3 13611 non-null float64
15 ShapeFactor4 13611 non-null float64
16 Class 13611 non-null object
dtypes: float64(14), int64(2), object(1)
memory usage: 1.8+ MBCes informations indiquent qu’il y a 16 variables numériques et une cible nommée Class. Le jeu de données est de petite taille (environ 13 000 lignes), nous n’aurons donc pas besoin de machines puissantes ni d’un budget important pour entraîner un modèle.
Créons ensuite un pair plot sur quelques variables avec seaborn :
import seaborn as sns

sns.pairplot(
   dry_bean,
   vars=["Area", "MajorAxisLength", "MinorAxisLength", "Eccentricity", "roundness"],
   hue="Class",
);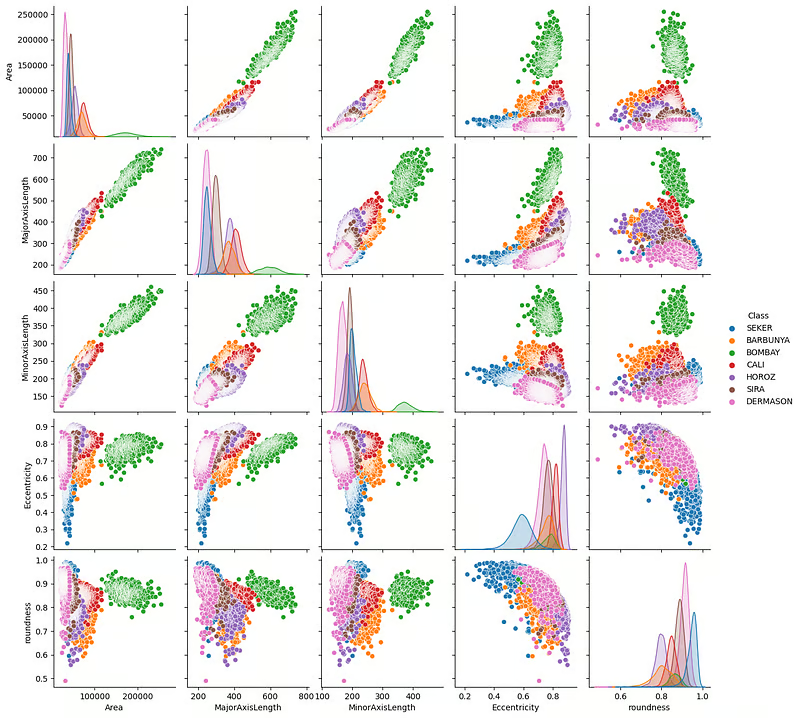
Ces graphiques montrent des différences nettes entre types de haricots selon leurs mesures physiques. Les haricots verts (Bombay) sont particulièrement bien séparés.
On peut aussi tracer une matrice de corrélation pour visualiser les relations entre variables :
import matplotlib.pyplot as plt

correlation = dry_bean.corr(numeric_only=True)

# Créer une heatmap carrée centrée sur 0
sns.heatmap(correlation, center=0, square=True, cmap="coolwarm", vmin=-1, vmax=1)
plt.show()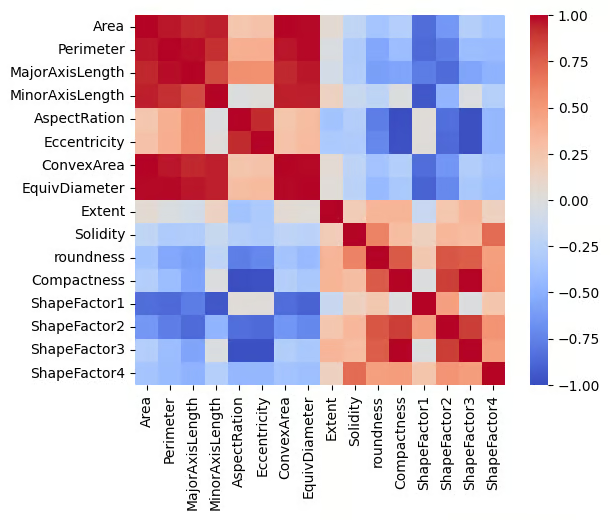
On observe de nombreuses corrélations parfaites (positives et négatives), ce qui est logique pour des mesures physiques interdépendantes.
À ce stade, libre à vous de poursuivre l’exploration.
Après l’exploration, traitez les problèmes de qualité ou de logique et, si nécessaire, créez de nouvelles variables avant l’entraînement.
Le jeu de données Dry Bean est déjà propre, la tâche est donc simple. Il suffit d’encoder la cible, qui est textuelle. Nous allons utiliser scikit-learn :
from sklearn.preprocessing import LabelEncoder

# Pour le prétraitement
df = dry_bean.copy(deep=True)

# Encoder la cible
le = LabelEncoder()
df[TARGET_NAME] = le.fit_transform(df[TARGET_NAME])
Une fois le prétraitement effectué, nous devons scinder le jeu de données :
from sklearn.model_selection import train_test_split

# Séparer les données en deux ensembles
train, test = train_test_split(df, random_state=1, test_size=0.2)
Vous pouvez aller plus loin en créant un troisième ensemble de validation, mais restons simples.
Enregistrons maintenant ces ensembles en CSV :
train.to_csv("dry-bean-train.csv")
test.to_csv("dry-bean-test.csv")
Puis téléversons-les dans notre bucket S3 :
# Envoyer les données sur S3. SageMaker lira les données d’entraînement depuis S3
trainpath = sess.upload_data(
   path="dry-bean-train.csv",
   bucket=BUCKET_NAME,
   key_prefix="sagemaker/sklearncontainer",
)

testpath = sess.upload_data(
   path="dry-bean-test.csv",
   bucket=BUCKET_NAME,
   key_prefix="sagemaker/sklearncontainer",
)
La fonction .upload_data() de l’objet session retourne le chemin complet du fichier téléversé, enregistré respectivement dans trainpath et testpath. Nous les réutiliserons plus tard.
Dans une nouvelle cellule, collez le code suivant :
%%writefile script.py

import argparse
import os
import joblib
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import balanced_accuracy_score

if __name__ == "__main__":
   print("extracting arguments")
   parser = argparse.ArgumentParser()

   # Hyperparameters sent by the client are passed as command-line arguments to the script.
   parser.add_argument("--n-estimators", type=int, default=10)
   parser.add_argument("--min-samples-leaf", type=int, default=3)

   # Data, model, and output directories
   parser.add_argument("--model-dir", type=str, default=os.environ.get("SM_MODEL_DIR"))
   parser.add_argument("--train", type=str, default=os.environ.get("SM_CHANNEL_TRAIN"))
   parser.add_argument("--test", type=str, default=os.environ.get("SM_CHANNEL_TEST"))
   parser.add_argument("--train-file", type=str, default="dry-bean-train.csv")
   parser.add_argument("--test-file", type=str, default="dry-bean-test.csv")
   args, _ = parser.parse_known_args()

   print("reading data")

   train_df = pd.read_csv(os.path.join(args.train, args.train_file))
   test_df = pd.read_csv(os.path.join(args.test, args.test_file))

   print("building training and testing datasets")

   X_train = train_df.drop("Class", axis=1)
   X_test = test_df.drop("Class", axis=1)
   y_train = train_df[["Class"]]
   y_test = test_df[["Class"]]

   # Train model
   print("training model")

   model = RandomForestClassifier(
       n_estimators=args.n_estimators,
       min_samples_leaf=args.min_samples_leaf,
       n_jobs=-1,
   )

   model.fit(X_train, y_train)

   # Print abs error
   print("validating model")

   bal_acc_train = balanced_accuracy_score(y_train, model.predict(X_train))
   bal_acc_test = balanced_accuracy_score(y_test, model.predict(X_test))

   print(f"Train balanced accuracy: {bal_acc_train:.3f}")
   print(f"Test balanced accuracy: {bal_acc_test:.3f}")

   # Persist model
   path = os.path.join(args.model_dir, "model.joblib")
   joblib.dump(model, path)
   print("model persisted at " + path)
La commande magique %%writefile script.py transforme le contenu de la cellule en fichier Python au lieu de l’exécuter immédiatement.
Passons en revue le script, étape par étape :
import argparse
import os
import joblib
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import balanced_accuracy_score
D’abord, nous importons les bibliothèques nécessaires.
if __name__ == "__main__":
   print("extracting arguments")
   parser = argparse.ArgumentParser()

   # Hyperparameters sent by the client are passed as command-line arguments to the script.
   parser.add_argument("--n-estimators", type=int, default=10)
   parser.add_argument("--min-samples-leaf", type=int, default=3)

   # Data, model, and output directories
   parser.add_argument("--model-dir", type=str, default=os.environ.get("SM_MODEL_DIR"))
   parser.add_argument("--train", type=str, default=os.environ.get("SM_CHANNEL_TRAIN"))
   parser.add_argument("--test", type=str, default=os.environ.get("SM_CHANNEL_TEST"))
   parser.add_argument("--train-file", type=str, default="dry-bean-train.csv")
   parser.add_argument("--test-file", type=str, default="dry-bean-test.csv")
   args, _ = parser.parse_known_args()
Ensuite, nous créons un parseur d’arguments pour lire les paramètres en ligne de commande. Comme indiqué, toute valeur susceptible d’être modifiée doit être passée en CLI. Cette section définit ces arguments :
Si vous regardez les valeurs par défaut des répertoires model-dir, train et test, vous verrez des variables d’environnement. Elles proviennent de la documentation du SDK SageMaker, qui explique aussi comment rédiger ce type de script.
print("reading data")
train_df = pd.read_csv(os.path.join(args.train, args.train_file))
test_df = pd.read_csv(os.path.join(args.test, args.test_file))
print("building training and testing datasets")
X_train = train_df.drop("Class", axis=1)
X_test = test_df.drop("Class", axis=1)
y_train = train_df[["Class"]]
y_test = test_df[["Class"]]
Après avoir défini les valeurs dynamiques, nous lisons et construisons les ensembles d’entraînement et de test. Plutôt que d’utiliser des chemins en dur, nous passons par les valeurs args.argument.
# Train model
print("training model")

model = RandomForestClassifier(
    n_estimators=args.n_estimators,
    min_samples_leaf=args.min_samples_leaf,
    n_jobs=-1,
)

model.fit(X_train, y_train)

# Print abs error
print("validating model")

bal_acc_train = balanced_accuracy_score(y_train, model.predict(X_train))
bal_acc_test = balanced_accuracy_score(y_test, model.predict(X_test))

print(f"Train balanced accuracy: {bal_acc_train:.3f}")
print(f"Test balanced accuracy: {bal_acc_test:.3f}")
Nous entraînons le modèle, l’évaluons sur les ensembles d’entraînement et de test, puis affichons les performances.
# Persist model
path = os.path.join(args.model_dir, "model.joblib")
joblib.dump(model, path)
print("model persisted at " + path)
Enfin, nous sauvegardons le modèle dans le répertoire prévu à l’aide de joblib.
Lorsque vous exécutez cette cellule dans votre notebook, le fichier script.py apparaît dans votre environnement JupyterLab. Vous pouvez vérifier qu’il fonctionne en l’exécutant comme suit :
! python script.py --n-estimators 100 \

                  --min-samples-leaf 2 \

                  --model-dir ./ \

                  --train ./ \

                  --test ./ \
extracting arguments
reading data
building training and testing datasets
validating model
Train balanced accuracy: 1.000
Test balanced accuracy: 0.998
model persisted at ./modejoblibExcellent, nous obtenons 99 % de balanced accuracy — difficile de faire mieux ! Nous pouvons lancer un job d’entraînement.
Nous allons maintenant passer le script à un estimateur SageMaker. Dans le contexte AWS, un job d’entraînement correspond au processus d’entraînement d’un modèle avec un algorithme, un jeu de données et des ressources de calcul fournis par AWS SageMaker. Contrairement à un entraînement en local, ce job s’exécute dans le cloud sur une infrastructure scalable, offrant plus de puissance, un traitement plus rapide et la capacité de gérer de grands volumes de données.
Ajoutez le code suivant dans une nouvelle cellule de votre notebook :
# Nous utilisons l’estimateur du SDK Python SageMaker
from sagemaker.sklearn.estimator import SKLearn
FRAMEWORK_VERSION = "0.23-1"

sklearn_estimator = SKLearn(
   entry_point="script.py",
   role=get_execution_role(),
   instance_count=1,
   instance_type="ml.c5.xlarge",
   framework_version=FRAMEWORK_VERSION,
   base_job_name="rf-scikit",
   hyperparameters={
       "n-estimators": 100,
       "min-samples-leaf": 3,
   },
)
Dans ce code, la classe SKLearn gère les scripts scikit-learn. Ses paramètres essentiels :
entry_point : le chemin du script.role : l’utilisateur disposant des accès SageMaker.instance_count : le nombre de machines à lancer.instance_type : le type de machine.Pour les hyperparamètres, ne passez que ceux définis dans le script d’entraînement, sinon vous obtiendrez une erreur.
Nous pouvons maintenant entraîner cet estimateur sur nos données :
# Lancer le job d’entraînement (appel synchrone)
sklearn_estimator.fit({"train": trainpath, "test": testpath}, wait=True)
Si vous vous souvenez, trainpath et testpath sont les chemins S3 vers nos fichiers CSV.
Une fois la cellule exécutée, l’entraînement démarre :
INFO:sagemaker:Creating training-job with name: rf-scikit-2024-06-04-10-36-31-142

2024-06-04 10:36:31 Starting - Starting the training job...

2024-06-04 10:36:46 Starting - Preparing the instances for training...

2024-06-04 10:37:13 Downloading - Downloading input data...

2024-06-04 10:37:53 Training - Training image download completed. Training in progress...
SageMaker télécharge l’image Docker nécessaire pour exécuter du code scikit-learn et lance votre script. Une fois terminé, vous verrez :
2024-06-04 10:38:17 Uploading - Uploading generated training model

2024-06-04 10:38:17 Completed - Training job completed

Training seconds: 65

Billable seconds: 65
Dans votre console, sous « SageMaker » > « Training » > « Training Jobs », vous verrez également le job listé.
Comme notre dataset est petit, nous avons pu utiliser une machine peu coûteuse et modeste : ml.c5.xlarge. Dans vos projets, vous pourrez traiter des jeux de données massifs (millions de lignes, images volumineuses) nécessitant des machines plus puissantes, voire des GPU.
L’usage à la demande de ces machines peut s’avérer très onéreux. Pour réduire les coûts, Amazon propose le Spot Training. Vous profitez ainsi de ressources de calcul haut de gamme à prix réduit, avec une contrepartie : l’entraînement ne démarre pas immédiatement. SageMaker attend que la demande baisse et que la machine demandée soit disponible.
Pour activer le Spot Training, ajoutez simplement quelques lignes au bloc précédent :
spot_sklearn_estimator = SKLearn(
   entry_point="script.py",
   role=get_execution_role(),
   instance_count=1,
   instance_type="ml.c5.xlarge",
   framework_version=FRAMEWORK_VERSION,
   base_job_name="rf-scikit",
   hyperparameters={
       "n-estimators": 100,
       "min-samples-leaf": 3,
   },
   use_spot_instances=True,
   max_wait=7200,
   max_run=3600,
)
En positionnant use_spot_instances à True, spot_sklearn_estimator utilisera les instances Spot. Vous pouvez aussi définir le temps d’attente maximal pour la disponibilité et la durée maximale de run.
L’entraînement démarre quand vous appelez à nouveau .fit() :
# Lancer le job d’entraînement (appel synchrone)
spot_sklearn_estimator.fit({"train": trainpath, "test": testpath}, wait=True)Avec le même script d’entraînement, nous pouvons produire un modèle dont les hyperparamètres ont été optimisés, via un workflow similaire.
Commencez par importer la classe IntegerParameter depuis sagemaker.tuner :
from sagemaker.tuner import IntegerParameterLa classe IntegerParameter permet de définir des plages de recherche pour les paramètres entiers. Le module tuner contient d’autres classes :
CategoricalParameter : définit des hyperparamètres prenant un ensemble discret de valeurs catégorielles.ContinuousParameter : définit des plages de recherche pour des valeurs continues.Nous nous limiterons à IntegerParameter ici, car nous optimisons deux paramètres de Random Forest :
# Utiliser l’optimiseur d’hyperparamètres
from sagemaker.tuner import IntegerParameter

# Définir les bornes d’exploration
hyperparameter_ranges = {
   "n-estimators": IntegerParameter(20, 100),
   "min-samples-leaf": IntegerParameter(2, 6),
}
Créez ensuite un objet tuner :
# Créer l’optimiseur
Optimizer = sagemaker.tuner.HyperparameterTuner(
   estimator=sklearn_estimator,
   hyperparameter_ranges=hyperparameter_ranges,
   base_tuning_job_name="RF-tuner",
   objective_type="Maximize",
   objective_metric_name="balanced-accuracy",
   metric_definitions=[
       {"Name": "balanced-accuracy", "Regex": "Test balanced accuracy: ([0-9.]+).*$"}
   ],  # Extraire la métrique suivie depuis les logs avec une regexp
   max_jobs=10,
   max_parallel_jobs=2,
)
Les paramètres clés d’Optimizer :
estimator : l’estimateur compatible avec votre script d’entraînement.hyperparameter_ranges : la plage de paramètres définie avec les classes du module tuner.objective_type : maximiser ou minimiser la métrique choisie. La balanced accuracy doit être maximisée.metric_definitions : le nom des métriques à optimiser et la façon de les extraire des logs.Le paramètre metric_definitions peut prêter à confusion car il est très flexible.
Dans le script d’entraînement, nous remontons la balanced accuracy via ces logs :
print(f"Train balanced accuracy: {bal_acc_train:.3f}")
print(f"Test balanced accuracy: {bal_acc_test:.3f}")
metric_definitions nous demande de capturer ce message avec une expression régulière. Nous utilisons donc le dictionnaire suivant, qui attribue un nom à la métrique capturée commençant par « Test balanced accuracy ».
{
   "Name": "balanced-accuracy",
   "Regex": "Test balanced accuracy: ([0-9.]+).*$",
}
La suite est familière :
Optimizer.fit({"train": trainpath, "test": testpath})INFO:sagemaker:Creating hyperparameter tuning job with name: RF-tuner-240604-1049Une fois l’optimisation terminée, vous pouvez afficher les résultats sous forme de DataFrame :
# Récupérer les résultats du tuner dans un df
results = Optimizer.analytics().dataframe()

while results.empty:
   time.sleep(1)
   results = Optimizer.analytics().dataframe()

results.head()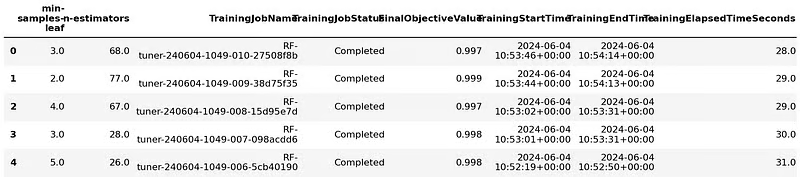
Vous pouvez ensuite récupérer le meilleur estimateur :
best_estimator = Optimizer.best_estimator()Une fois le modèle retenu, vous pouvez le téléverser sur SageMaker avec tous ses artefacts. Cette opération peut se faire avec boto3 :
artifact_path = sm_boto3.describe_training_job(
   TrainingJobName=best_estimator.latest_training_job.name
)["ModelArtifacts"]["S3ModelArtifacts"]

print("Model artifact persisted at " + artifact)
Model artifact persisted at s3://sagemaker-us-east-1-496320894061/RF-tuner-240604-1049-009-38d75f35/output/model.tar.gzLa fonction describe_training_job() prend un objet estimateur et le pousse vers un emplacement S3 par défaut fourni par SageMaker. Comme on le voit ci-dessus, le modèle est converti en archive tar avant chargement.
Les modèles téléversés sont visibles dans votre console, rubrique « Inference » > « Models » :
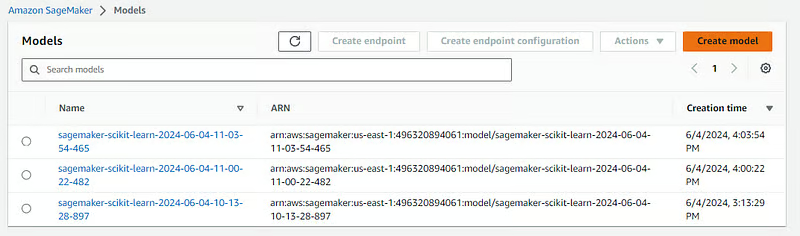
En cliquant sur l’un d’eux, vous verrez un bouton « Create endpoint » en haut à droite :
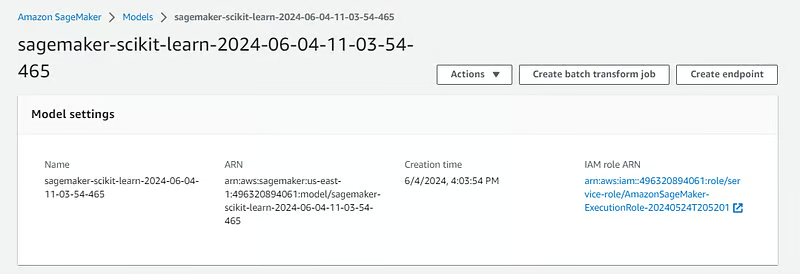
Vous pouvez déployer le modèle via ce bouton ou par le code, depuis votre notebook, avec la méthode .deploy() :
from sagemaker.sklearn.model import SKLearnModel

model = SKLearnModel(
   model_data=artifact_path,
   role=get_execution_role(),
   entry_point="script.py",
   framework_version=FRAMEWORK_VERSION,
)
Ici, nous utilisons la classe SKLearnModel, adaptée aux modèles déjà entraînés. Elle requiert l’emplacement S3 des artefacts et le script utilisé pour l’entraînement. Une fois ces informations fournies, lancez le déploiement :
predictor = model.deploy(instance_type="ml.c5.large", initial_instance_count=1)
INFO:sagemaker:Creating model with name: sagemaker-scikit-learn-2024-06-04-11-03-54-465
INFO:sagemaker:Creating endpoint-config with name sagemaker-scikit-learn-2024-06-04-11-03-54-960
INFO:sagemaker:Creating endpoint with name sagemaker-scikit-learn-2024-06-04-11-03-54-960
Ensuite, vous verrez l’endpoint listé sous « Inference » > « Endpoints » dans votre tableau de bord SageMaker :
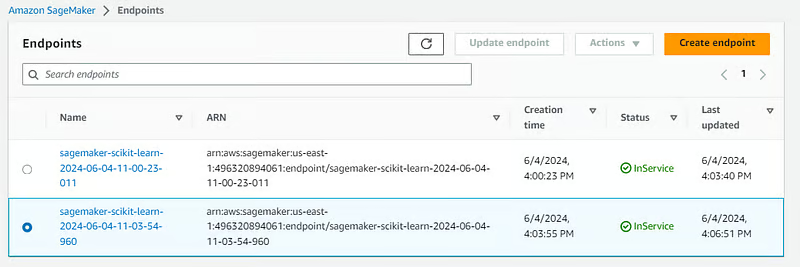
Pour l’utiliser en prédiction, employez la méthode .predict() de l’objet endpoint depuis votre notebook :
preds = predictor.predict(test.sample(4).drop("Class", axis=1))
preds
array([3, 0, 1, 2])Félicitations, vous venez de déployer votre premier modèle avec SageMaker !
Une fois terminé, n’oubliez pas de supprimer l’endpoint, car il génère des coûts en continu :
sm_boto3.delete_endpoint(EndpointName=predictor.endpoint)N’oubliez pas : chaque instance de notebook créée dans SageMaker inclut un onglet séparé avec des notebooks d’exemple présentant les différentes fonctionnalités de SageMaker :
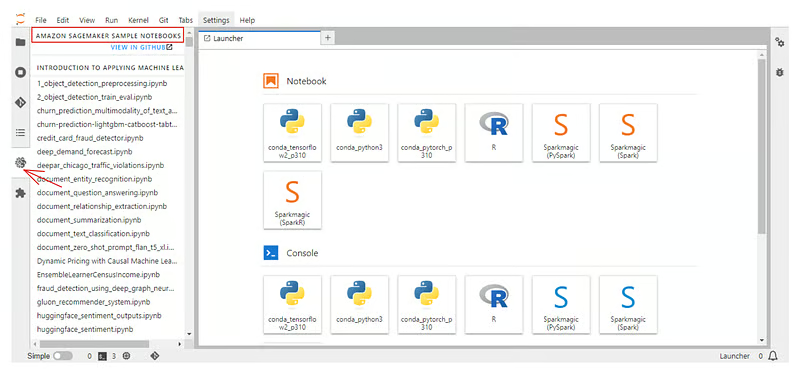
Consultez aussi la documentation officielle du SDK Python SageMaker.
Aujourd’hui, nous avons appris à utiliser l’une des plateformes de machine learning d’entreprise les plus populaires : AWS SageMaker. Nous avons couvert l’essentiel, de la création d’un compte AWS au déploiement de modèles ML en endpoints avec SageMaker.
Comme pour toute plateforme, nous n’en avons exploré que la surface. En la combinant avec d’autres services AWS, vous pouvez aller beaucoup plus loin dans vos projets. Voici quelques ressources à explorer :
Approfondissez le machine learning et AWS avec ces cours !
Cours
Cours
Cours