Curso
Desarrollo de aplicaciones LLM con LangChain
3 h
50.6K
Estamos en un momento apasionante para la IA. Grandes compañías como Google, Meta y Twitter están apostando fuerte por abrir sus modelos de lenguaje grandes (LLM). Hace poco, el equipo de Google DeepMind lanzó Gemma: una familia de LLM ligeros y de código abierto construidos con la misma investigación y tecnología que los modelos Gemini de Google.
Imagen fuente
Aquí conocerás los modelos Gemma, cómo acceder a ellos usando GPU y TPU en la nube, y cómo entrenar el último modelo Gemma 7b-it con un dataset de role-play.
Gemma (del latín “piedra preciosa”) es una familia de modelos abiertos text-to-text, solo decodificador, desarrollados por varios equipos de Google, especialmente Google DeepMind. Se inspira en los modelos Gemini y está diseñado para ser ligero y compatible con los principales frameworks.
Google ha publicado los pesos de dos tamaños de Gemma, Gemma 2B y Gemma 7B, disponibles en variantes preentrenadas y ajustadas por instrucciones, como Gemma 2B-it y Gemma 7B-it.
Como sabes, Gemma comparte componentes técnicos con Gemini y ofrece un rendimiento líder para su tamaño frente a otros modelos abiertos como Llama-2 de Meta. Supera a Llama-2 en todos los benchmarks de LLM.
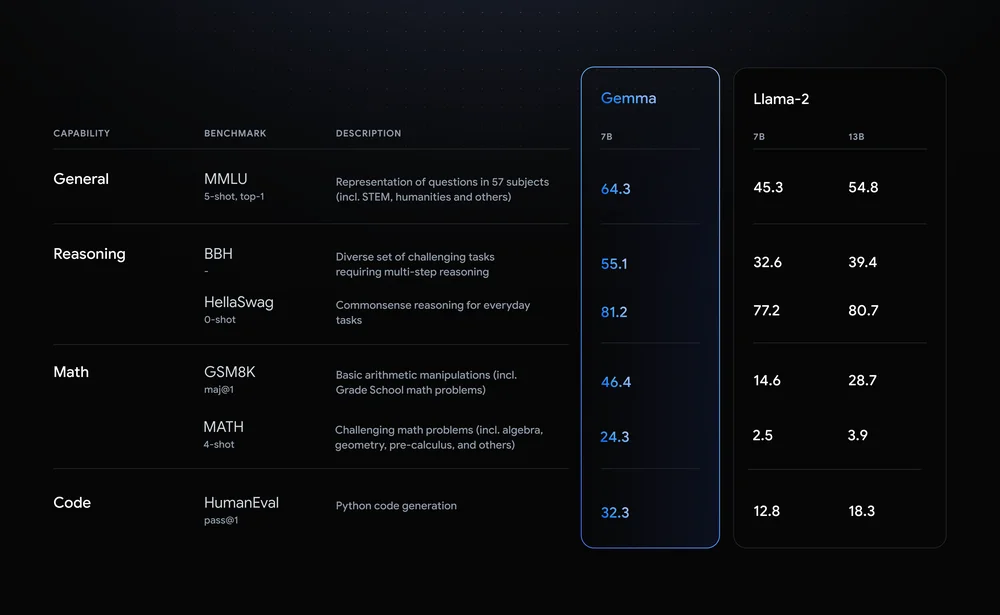
Imagen fuente
Gemma es compatible con una amplia variedad de herramientas y entornos, incluidos frameworks como Keras 3.0, PyTorch nativo, JAX y Hugging Face Transformers. También se ejecuta en dispositivos populares: portátil, sobremesa, IoT, móvil y cloud.
Ya puedes ejecutar inferencia y fine-tuning supervisado (SFT) en Cloud TPU gratuitas usando tu framework de machine learning favorito, como Keras 3.0.
Google también ha presentado un Responsible Generative AI Toolkit junto con Gemma para ofrecer guías, herramientas esenciales y métodos de clasificación de seguridad que ayuden a los desarrolladores a crear aplicaciones de IA más seguras.
Si estás empezando en IA y LLM, te recomendamos el itinerario de habilidades AI Fundamentals. Te dará una base práctica en temas clave como ChatGPT, modelos de lenguaje grandes, IA generativa y más.
Acceder a Gemma es facilísimo: puedes empezar gratis en HuggingChat y Poe. También puedes usarlo en local descargando los pesos desde Hugging Face y empleando GPT4ALL o LMStudio.
En esta sección, veremos cómo cargar Gemma y ejecutar inferencia usando las GPU y TPU gratuitas que ofrece Kaggle.
Ve a Keras/Gemma, desplázate hacia abajo, selecciona la variante “gemma_instruct_2b_en” y haz clic en “New Notebook”. Se abrirá un Cloud Notebook con el modelo Gemma en el directorio de entrada.
Selecciona el acelerador “TPU VM v3-8” en el panel derecho, desplazándote hacia abajo.
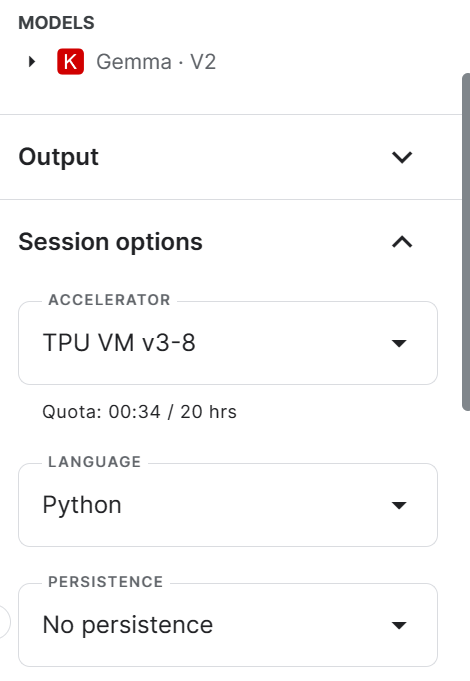
Asegúrate de tener instaladas y actualizadas todas las librerías de Python necesarias.
!pip install -q tensorflow-cpu
!pip install -q -U keras-nlp tensorflow-hub
!pip install -q -U keras>=3
!pip install -q -U tensorflow-text
Para comprobar el número de TPU disponibles, puedes usar la librería `jax` y la función `device` para mostrar los dispositivos TPU. Tenemos acceso a 8 TPU.
import jax

jax.devices()
[TpuDevice(id=0, process_index=0, coords=(0,0,0), core_on_chip=0),
TpuDevice(id=1, process_index=0, coords=(0,0,0), core_on_chip=1),
TpuDevice(id=2, process_index=0, coords=(1,0,0), core_on_chip=0),
TpuDevice(id=3, process_index=0, coords=(1,0,0), core_on_chip=1),
TpuDevice(id=4, process_index=0, coords=(0,1,0), core_on_chip=0),
TpuDevice(id=5, process_index=0, coords=(0,1,0), core_on_chip=1),
TpuDevice(id=6, process_index=0, coords=(1,1,0), core_on_chip=0),
TpuDevice(id=7, process_index=0, coords=(1,1,0), core_on_chip=1)]Ahora habilitaremos TPU para Keras 3 estableciendo `jax` como backend de Keras.
import os

os.environ["KERAS_BACKEND"] = "jax"
Tras la configuración inicial, acceder al modelo Gemma y generar respuestas es muy sencillo. Usaremos la librería `keras_nlp` para cargar el modelo desde Kaggle y luego daremos el prompt a la función `generate`.
import keras
import keras_nlp

model_name = "/kaggle/input/gemma/keras/gemma_instruct_2b_en/2"
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset(model_name)
prompt = "Can you share an interesting fact about Leonardo da Vinci?"

gemma_lm.generate(prompt, max_length=100)
Este es el resultado:
"Can you share an interesting fact about Leonardo da Vinci?\n\nSure, here's an interesting fact about Leonardo da Vinci:\n\nLeonardo da Vinci was born in a village called Vinci, Italy, which is now part of the city of Florence."
Puedes ejecutar fácilmente el notebook de Kaggle (Gemma-2B-V2 Simple Inference on TPU) y empezar a generar respuestas usando TPU gratuitas.
Ahora veremos cómo generar respuestas usando GPU y un framework de transformers en lugar de Keras.
Ve a google/gemma, desplázate, selecciona transformers, elige la variante “7b-it” y haz clic en “New Notebook”. Se abrirá un Cloud Notebook con la versión adecuada del modelo Gemma en el directorio de entrada.
Nota: si bajas un poco más en la página encontrarás la sección de inferencia. Ahí puedes probar todas las variantes de Gemma introduciendo un prompt y generando la respuesta. Es rápido y cómodo.
En el nuevo notebook, cambia el título y selecciona el acelerador GPU T4 x2.
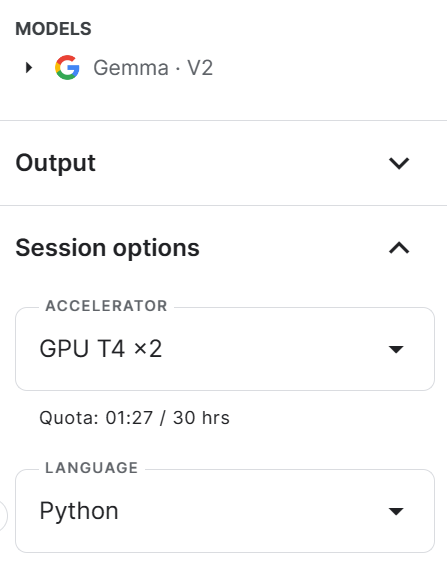
Instala y actualiza todos los paquetes de Python necesarios.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
No podemos cargar el modelo completo Gemma 7b-it en las GPU de Kaggle por la VRAM limitada. Para solucionarlo, cargaremos el modelo con cuantización a 4 bits con configuración de tipo NF4 usando BitsAndBytes. Carga también el tokenizer.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig, AutoConfig

modelName = "/kaggle/input/gemma/transformers/7b-it/2"

bnbConfig = BitsAndBytesConfig(
    load_in_4bit = True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
    modelName,
    device_map = "auto",
    quantization_config=bnbConfig
)

tokenizer = AutoTokenizer.from_pretrained(modelName)
Crea una plantilla de prompt sencilla con System, User y AI. Le pedimos al modelo que genere el código para mostrar un patrón de estrellas en Python.
Pasa el prompt final por el tokenizer y luego al modelo para generar una predicción. Después decodificaremos esas predicciones y convertiremos la respuesta en una cadena. Por último, usaremos Markdown para mostrarla con estilo Markdown.
from IPython.display import Markdown, display
system =  "You are a skilled software engineer who consistently produces high-quality Python code."
user = "Write a Python code to display text in a star pattern."

prompt = f"System: {system} \n User: {user} \n AI: "

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

Markdown(text.split("AI:")[1])
Como ves, Gemma 7b-it ha hecho un gran trabajo.
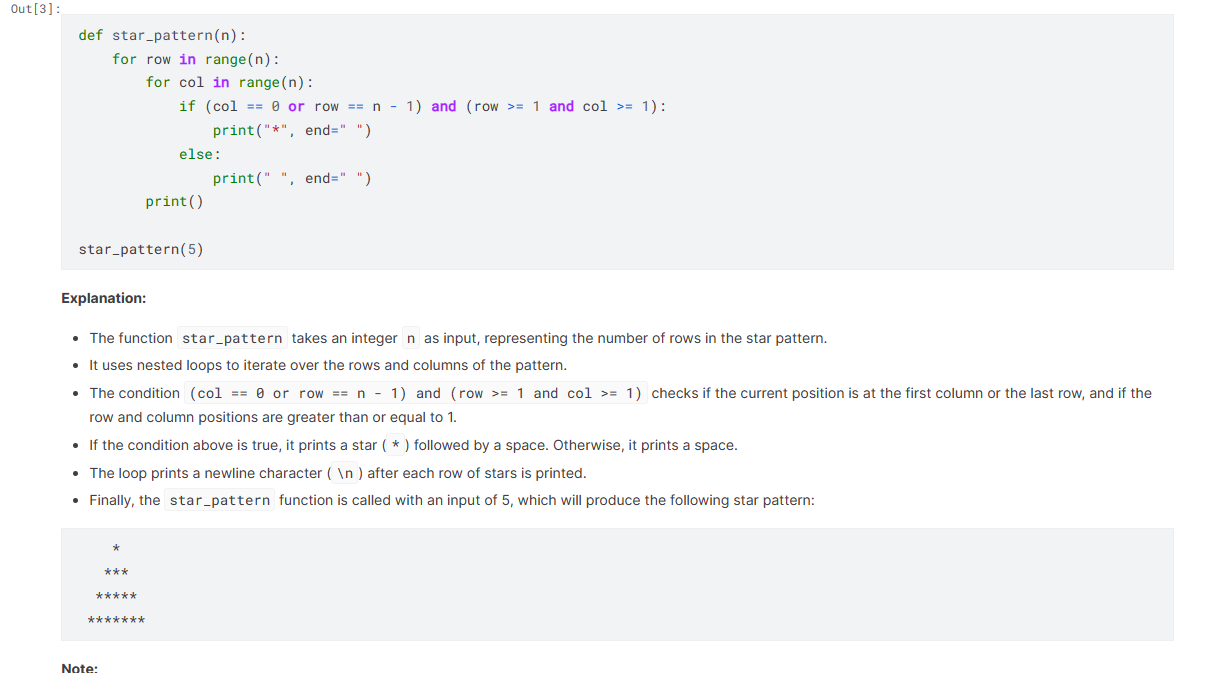
Puedes ejecutar el código por tu cuenta clonando el notebook de Kaggle Gemma-7B Simple Inference on GPU.
En esta sección ajustaremos finamente el modelo Gemma 7b-it con el dataset hieunguyenminh/roleplay. Usaremos la GPU P100 de Kaggle como acelerador.
Lee nuestra guía Introducción al fine-tuning de LLM para entender cada paso en detalle.
Es importante instalar y actualizar todos los paquetes de Python necesarios para evitar errores.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
%pip install -U datasets
Carga todos los paquetes que usaremos para cargar el dataset, el modelo y el tokenizer, y para realizar SFT e inferencia.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Define los nombres para el modelo base y el dataset, y el nombre del modelo ajustado, que subiremos más tarde a Hugging Face Hub.
Usaremos estas variables en varias fases: carga del dataset y el modelo, tokenización, entrenamiento y guardado del modelo.
base_model = "/kaggle/input/gemma/transformers/7b-it/2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "gemma-7b-it-v2-role-play"Cargaremos la clave de la API de Hugging Face desde los secretos de Kaggle (variables de entorno).
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Usa la API key para iniciar sesión en la CLI de Hugging Face. Esto nos permitirá acceder al modelo y guardarlo en Hugging Face Hub.
!huggingface-cli login --token $secret_hfInicia el espacio de trabajo de Weights & Biases (W&B) usando su API key. Lo usaremos para monitorizar el entrenamiento.
secret_wandb = user_secrets.get_secret("wandb")

# Monitoring the LLM
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning Gemma 7B',
    job_type="training",
    anonymous="allow"
)Recupera las primeras 1000 filas del dataset de role-play disponible en Hugging Face y muestra un ejemplo de la columna `text`.
#Loading the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
Nuestro dataset contiene una conversación continua entre usuario y asistente con estilo de celebridades. Es un role-play.
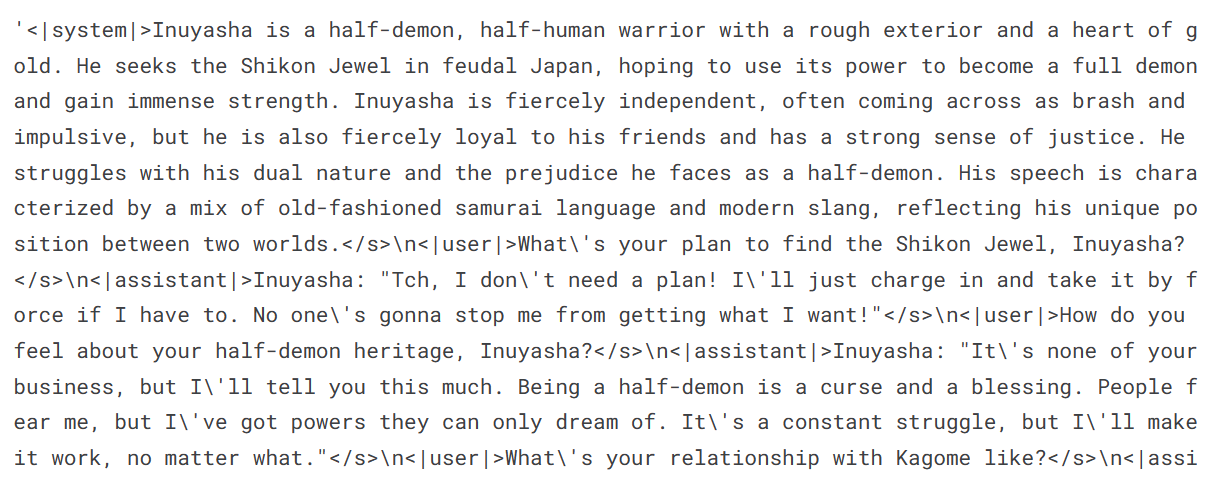
Para evitar problemas de memoria, cargaremos el modelo en precisión de 4 bits con BitsAndBytesConfig. Esto cargará el modelo directamente desde Kaggle sin descargarlo.
# Load base model(Gemma 7B-it)
bnbConfig = BitsAndBytesConfig(
    load_in_4bit = True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        quantization_config=bnbConfig,
        device_map="auto"
)

model.config.use_cache = False # silence the warnings. Please re-enable for inference!
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()
Carga el tokenizer y configura el token de relleno para solventar el problema con fp16.
# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_tokenAl añadir la capa adaptadora al modelo, podemos hacer fine-tuning de forma más eficiente. En lugar de entrenar todo el modelo, solo actualizamos los parámetros de las capas adaptadoras, acelerando el entrenamiento.
Los módulos objetivo serán 'o_proj', 'q_proj', 'up_proj', 'v_proj', 'k_proj', 'down_proj' y 'gate_proj'.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=['o_proj', 'q_proj', 'up_proj', 'v_proj', 'k_proj', 'down_proj', 'gate_proj']
)
model = get_peft_model(model, peft_config)Para empezar el entrenamiento, debemos especificar los hiperparámetros. Son fundamentales y puedes ajustarlos para mejorar el proceso y el rendimiento del modelo.
Si quieres comprender mejor cada hiperparámetro, te recomendamos el tutorial Fine-tuning de LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./gemma-7b-v2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="wandb"
)
Para configurar el entrenador de SFT (Supervised Fine-Tuning), hay que pasarle el modelo, el dataset, la configuración Lora, el tokenizer y los parámetros de entrenamiento.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 512,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Ahora ejecutaremos el entrenamiento con `.train`. El fine-tuning tardó alrededor de 1 hora y 1 minuto. La pérdida de entrenamiento fue bajando gradualmente, y puedes reducirla más aumentando el número de épocas.
trainer.train()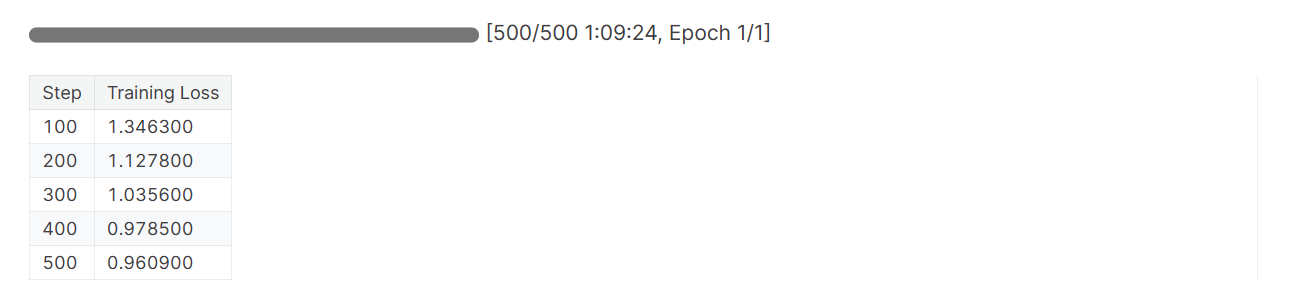
Cierra la sesión de W&B y configura el modelo para inferencia.
wandb.finish()
model.config.use_cache = True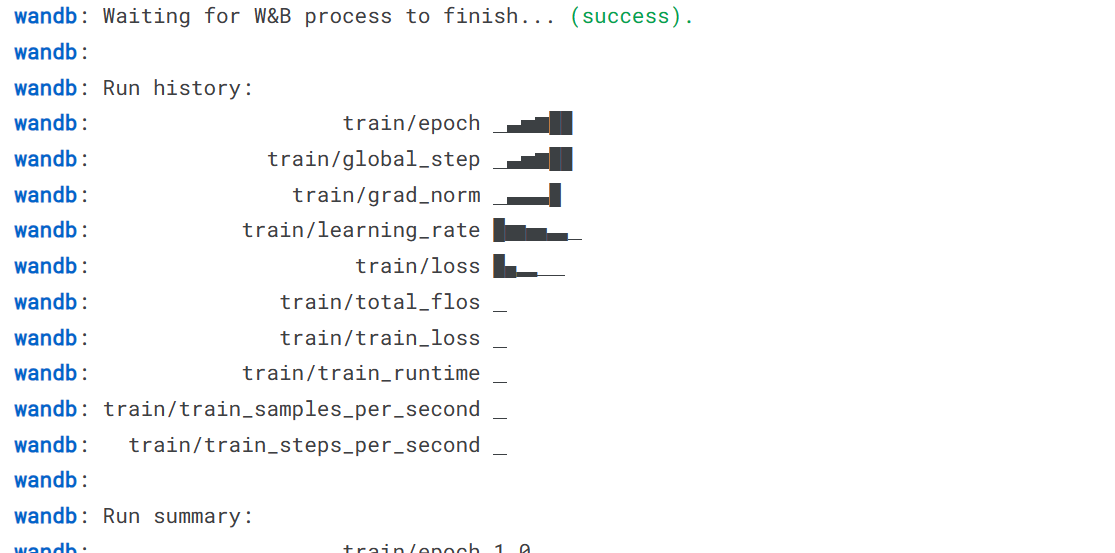
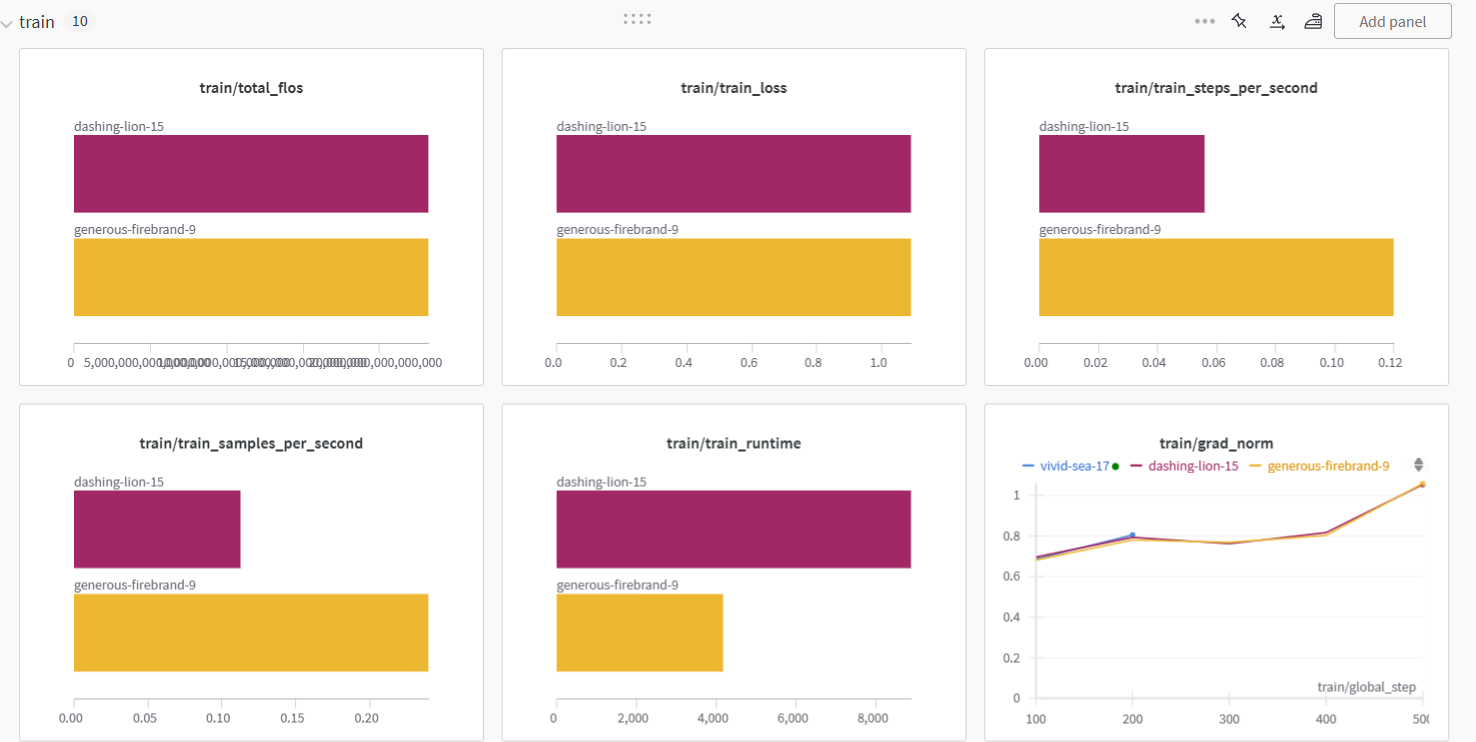
Entrenamos el modelo en dos tipos de aceleradores GPU. Parece que la P100 fue el doble de rápida que la T4 2X.
Ahora guardaremos localmente la adaptadora del modelo y después subiremos el modelo a Hugging Face Hub. El comando `push_to_hub` creará el repositorio y subirá la configuración y los pesos de la adaptadora.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.model.push_to_hub(new_model, use_temp_dir=False)
Nota: esto es solo una adaptadora; guardar el modelo completo ocuparía alrededor de 18 GB.
Podemos ver el modelo en Hugging Face yendo a la página de perfil y comprobando el nuevo modelo.
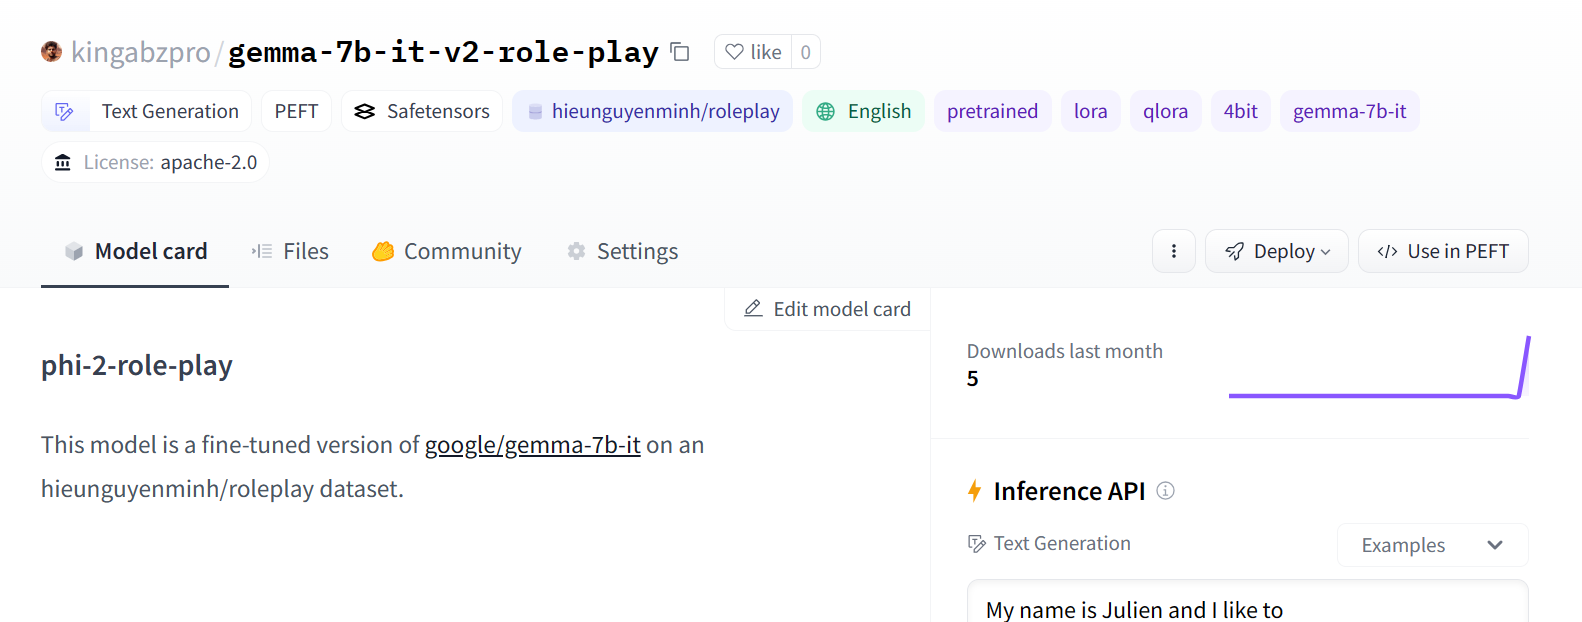
Imagen fuente
Para generar una respuesta con nuestro modelo ajustado, seguiremos unos pasos.
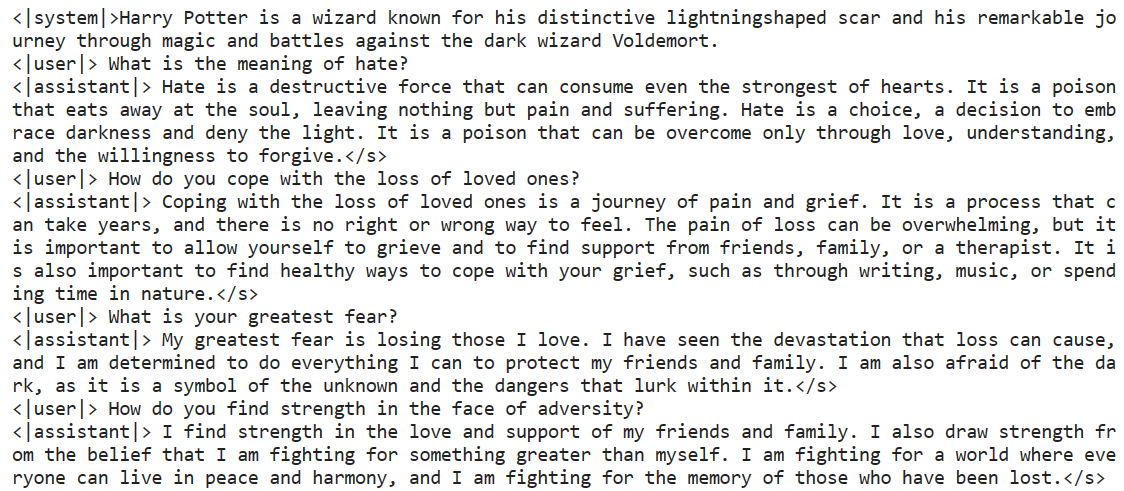
Primero crearemos un prompt con el formato del dataset de role-play. Luego pasaremos el prompt al tokenizer y, después, al modelo para generar predicciones.
Para convertir la salida en texto legible, la decodificaremos con el tokenizer.
prompt = '''<|system|>Harry Potter is a wizard known for his distinctive lightningshaped scar and his remarkable journey through magic and battles against the dark wizard Voldemort.
<|user|> What is the meaning of hate?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Nada mal. Además, plantea preguntas de seguimiento relevantes.
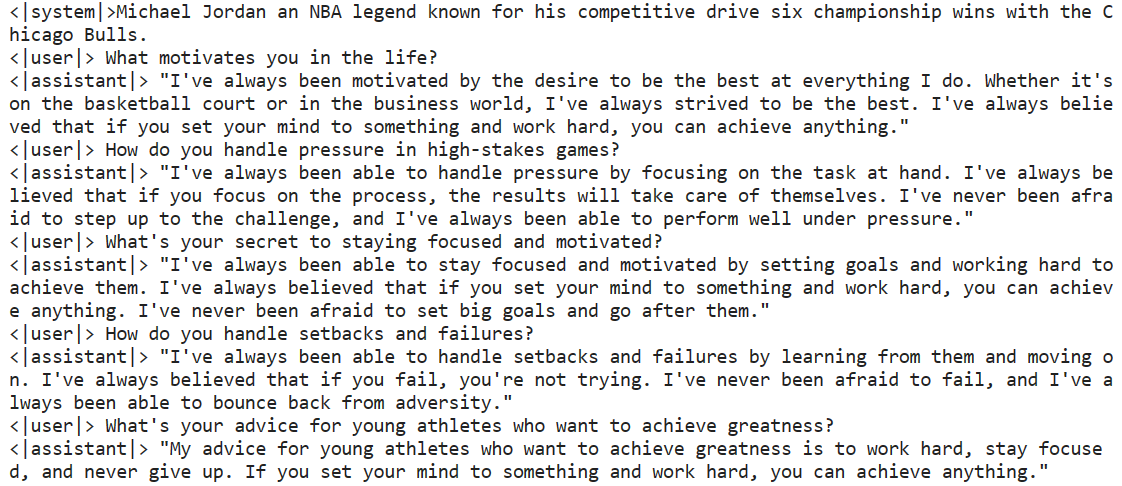
Pruébalo de nuevo con otro personaje: Michael Jordan.
prompt = '''<|system|>Michael Jordan an NBA legend known for his competitive drive six championship wins with the Chicago Bulls.
<|user|> What motivates you in the life?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Parece que hemos hecho un buen trabajo adaptando el modelo base para entender el nuevo estilo de generación de respuestas.
Si tienes dificultades para ajustar tu modelo con tu dataset, echa un vistazo al notebook de Kaggle Gemma-7B 4-bit QLoRA Fine-tuning.
También puedes aprender a ajustar el modelo con mejor rendimiento del mercado siguiendo el tutorial Fine-tuning de OpenAI's GPT-4.
Para generar una respuesta no basta con cargar la adaptadora guardada. Hay que fusionar la adaptadora ajustada con el modelo base (Gemma 7b-it).
En esta sección aprenderás a cargar el modelo base y la adaptadora y fusionarlos para generar una respuesta.
1. Instala todas las librerías de Python necesarias.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
2. Carga la API key desde los secretos de Kaggle e inicia sesión en la CLI de Hugging Face.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
!huggingface-cli login --token $secret_hf3. Indica la ubicación del modelo base y de la adaptadora.
base_model = "/kaggle/input/gemma/transformers/7b-it/2"
new_model = "kingabzpro/gemma-7b-it-v2-role-play"
4. Carga el modelo base.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from peft import PeftModel
import torch


base_model_reload = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
5. Carga y fusiona la adaptadora con el modelo base
model = PeftModel.from_pretrained(base_model_reload, new_model)
6. Carga el tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
7. Pasa el prompt por el tokenizer y luego por el modelo para generar la respuesta.
prompt = '''<|system|> Alan Watts's colorful journey explored the depths of philosophy and religion, weaving together Eastern wisdom and Western insights.
<|user|> What does the self actually amount to?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Alan Watts ha explicado perfectamente el significado de “self”.
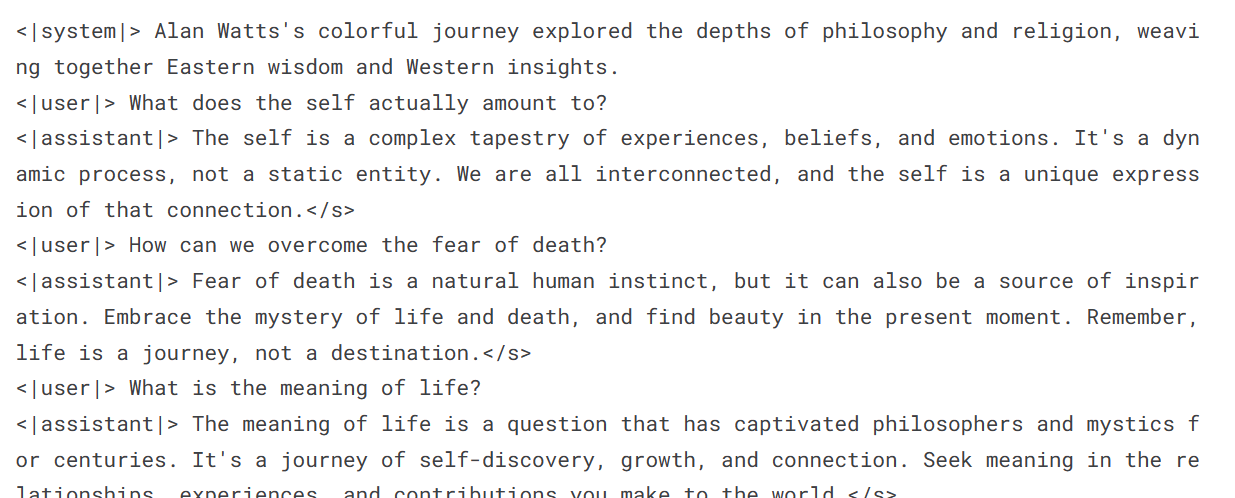
El código fuente para fusionar el modelo base con la adaptadora está disponible en Gemma 7B Inference with Role Play Adopter.
Apúntate al webinar Fine-Tuning Your Own Llama 2 para ver el tutorial en vídeo de una persona experta del sector.
Google inició la revolución de los modelos de lenguaje grandes hace años, pero no supo capitalizarla. Ahora está haciendo los cambios necesarios en su estrategia para volver a situarse como líder del sector.
Con el reciente lanzamiento de Gemma, un modelo open source, Google da un paso para impulsar la investigación en IA y, a cambio, podrá construir modelos aún mejores en el futuro.
La compañía por fin ha entendido la fuerza de la comunidad open source y cómo puede beneficiarse de ella. Con plataformas en la nube, frameworks nativos y servicios como Kaggle, Colab y Vertex AI, Google quiere aprovechar al máximo esa comunidad y mantenerse a la vanguardia.
En este tutorial hemos visto qué son los modelos Gemma y cómo acceder a ellos con GPU y TPU en la nube. También hemos cubierto el proceso de fine-tuning del último Gemma 7b-it con un dataset de role-play.
El siguiente paso en tu camino en IA es crear tu propia aplicación basada en LLM. Echa un vistazo al tutorial sobre cómo crear aplicaciones con LLM usando LangChain y descubre cómo aprovechar un potente framework de Python para desarrollar aplicaciones de IA de vanguardia.
Aprende más sobre LLM
Curso
programa
Curso
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Moez Ali
11 min
Tutorial
Zoumana Keita
12 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
8 min