
Cours
Développement d'applications LLM avec LangChain
3 h
50.6K
C'est une période passionnante pour l'IA. Les grands acteurs comme Google, Meta et Twitter misent fortement sur l'open source pour leurs grands modèles de langage (LLM). Récemment, l'équipe de Google DeepMind a lancé Gemma : une famille de LLM légers et open source, issus des mêmes recherches et technologies que celles ayant permis de créer les modèles Gemini de Google.
Image Source
Dans cet article, nous allons découvrir les modèles Gemma, comment y accéder via des GPU et TPU cloud, et comment entraîner le dernier modèle Gemma 7b-it sur un jeu de données de role-play.
Gemma (le mot latin pour « pierre précieuse ») est une famille de modèles texte-à-texte, de type décodeur seul, ouverts, développés par différentes équipes chez Google, en particulier Google DeepMind. Inspiré des modèles Gemini, Gemma est conçu pour être léger et compatible avec tous les principaux frameworks.
Google a publié les poids pour deux tailles de Gemma, à savoir Gemma 2B et Gemma 7B, disponibles en variantes pré-entraînées et ajustées par instruction, comme Gemma 2B-it et Gemma 7B-it.
Comme on le sait, Gemma partage des composants techniques avec Gemini et offre des performances de premier plan pour sa catégorie, face à d'autres modèles ouverts comme Llama 2 de Meta. Il surpasse Llama 2 sur l'ensemble des benchmarks LLM.
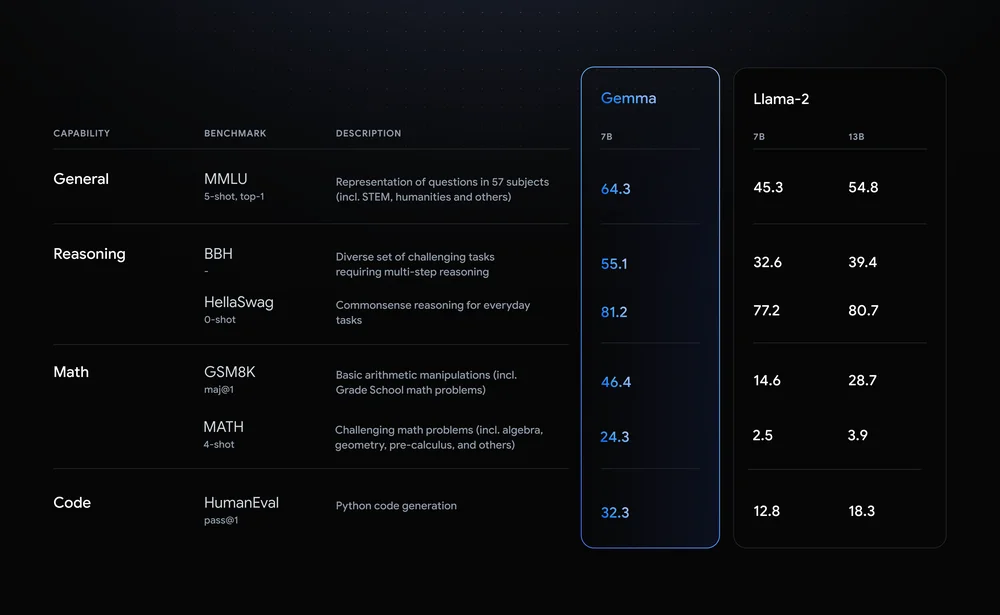
Image Source
Gemma prend en charge un large éventail d'outils et de systèmes, notamment des outils multi‑frameworks comme Keras 3.0, PyTorch natif, JAX et les Transformers de Hugging Face. Il fonctionne aussi sur les principaux types d'appareils : ordinateur portable, ordinateur de bureau, IoT, mobile et cloud.
Vous pouvez désormais exécuter l'inférence et l'ajustement supervisé (SFT) sur des Cloud TPUs gratuits avec votre framework de machine learning préféré, comme Keras 3.0.
Google a également introduit, avec Gemma, un Responsible Generative AI Toolkit pour fournir des recommandations, des outils essentiels et des méthodes de classification de sécurité afin d'aider les développeurs à créer des applications d'IA plus sûres.
Si vous débutez dans l'IA et les LLM, nous vous recommandons le parcours de compétences AI Fundamentals. Il vous apportera des bases pratiques sur des sujets phares comme ChatGPT, les grands modèles de langage, l'IA générative, et plus encore.
L'accès à Gemma est très simple : vous pouvez l'utiliser gratuitement sur HuggingChat et Poe. Vous pouvez même l'exécuter en local en téléchargeant les poids du modèle depuis Hugging Face et en passant par GPT4ALL ou LMStudio.
Dans cette section, nous allons charger le modèle Gemma et exécuter l'inférence en utilisant les GPU et TPU gratuits proposés par la plateforme Kaggle.
Rendez-vous sur Keras/Gemma, descendez, sélectionnez la variante « gemma_instruct_2b_en », puis cliquez sur le bouton « New Notebook ». Un Cloud Notebook s'ouvrira avec le modèle Gemma dans le répertoire d'entrée.
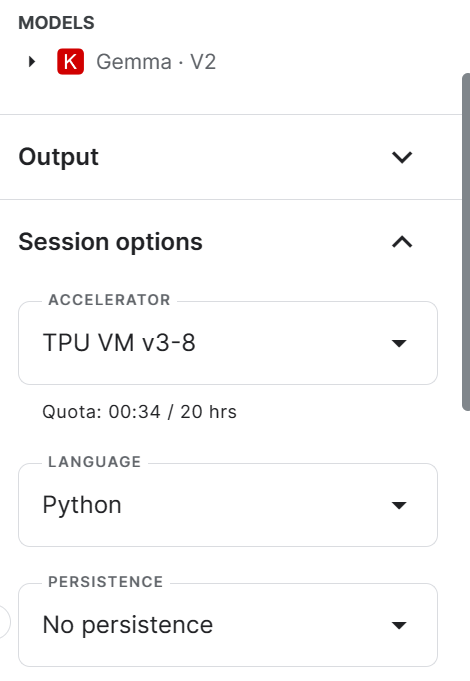
Choisissez l'accélérateur « TPU VM v3-8 » dans le panneau de droite en faisant défiler la page.
Assurez-vous d'installer et de mettre à jour toutes les bibliothèques Python nécessaires.
!pip install -q tensorflow-cpu
!pip install -q -U keras-nlp tensorflow-hub
!pip install -q -U keras>=3
!pip install -q -U tensorflow-text
Pour vérifier le nombre de TPU disponibles, vous pouvez utiliser la bibliothèque `jax` et la fonction `device` pour afficher les périphériques TPU. Nous avons accès à 8 TPU.
import jax

jax.devices()
[TpuDevice(id=0, process_index=0, coords=(0,0,0), core_on_chip=0),
TpuDevice(id=1, process_index=0, coords=(0,0,0), core_on_chip=1),
TpuDevice(id=2, process_index=0, coords=(1,0,0), core_on_chip=0),
TpuDevice(id=3, process_index=0, coords=(1,0,0), core_on_chip=1),
TpuDevice(id=4, process_index=0, coords=(0,1,0), core_on_chip=0),
TpuDevice(id=5, process_index=0, coords=(0,1,0), core_on_chip=1),
TpuDevice(id=6, process_index=0, coords=(1,1,0), core_on_chip=0),
TpuDevice(id=7, process_index=0, coords=(1,1,0), core_on_chip=1)]Nous allons maintenant activer le TPU pour Keras 3 en définissant `jax` comme backend Keras.
import os

os.environ["KERAS_BACKEND"] = "jax"
Après cette configuration initiale, accéder au modèle Gemma et générer une réponse est très simple. Nous utiliserons la bibliothèque `keras_nlp` pour charger le modèle depuis Kaggle puis fournirons l'invite à la fonction `generate`.
import keras
import keras_nlp

model_name = "/kaggle/input/gemma/keras/gemma_instruct_2b_en/2"
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset(model_name)
prompt = "Can you share an interesting fact about Leonardo da Vinci?"

gemma_lm.generate(prompt, max_length=100)
Voici le résultat :
"Can you share an interesting fact about Leonardo da Vinci?\n\nSure, here's an interesting fact about Leonardo da Vinci:\n\nLeonardo da Vinci was born in a village called Vinci, Italy, which is now part of the city of Florence."
Vous pouvez exécuter facilement le notebook Kaggle (Gemma-2B-V2 Simple Inference on TPU) et commencer à générer des réponses avec des TPU gratuits.
Nous allons maintenant générer des réponses sur GPU et utiliser le framework Transformers plutôt que Keras.
Allez sur google/gemma, descendez, sélectionnez Transformers, choisissez la variante « 7b-it », puis cliquez sur « New Notebook ». Cela ouvrira un Cloud Notebook avec la bonne version du modèle Gemma dans le répertoire d'entrée.
Remarque : vous pouvez aussi descendre plus bas sur la page pour accéder à la section inference. Vous pourrez y tester toutes les variantes de Gemma en saisissant une invite et en générant la réponse. C'est rapide et pratique.
Dans le nouveau notebook, changez le titre puis sélectionnez l'accélérateur GPU T4 x2.
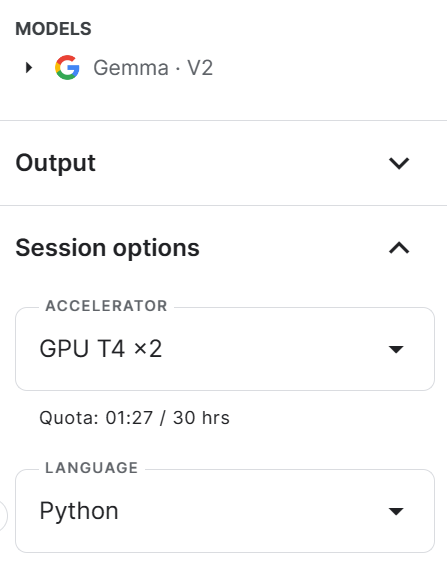
Installez et mettez à jour tous les packages Python requis.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
Nous ne pouvons pas charger l'intégralité du modèle Gemma 7b-it sur les GPU Kaggle en raison d'une VRAM limitée. Pour contourner ce problème, nous allons charger le modèle avec une quantification 4 bits en configuration de type NF4 via BitsAndBytes. Chargez également le tokenizer.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig, AutoConfig

modelName = "/kaggle/input/gemma/transformers/7b-it/2"

bnbConfig = BitsAndBytesConfig(
    load_in_4bit = True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
    modelName,
    device_map = "auto",
    quantization_config=bnbConfig
)

tokenizer = AutoTokenizer.from_pretrained(modelName)
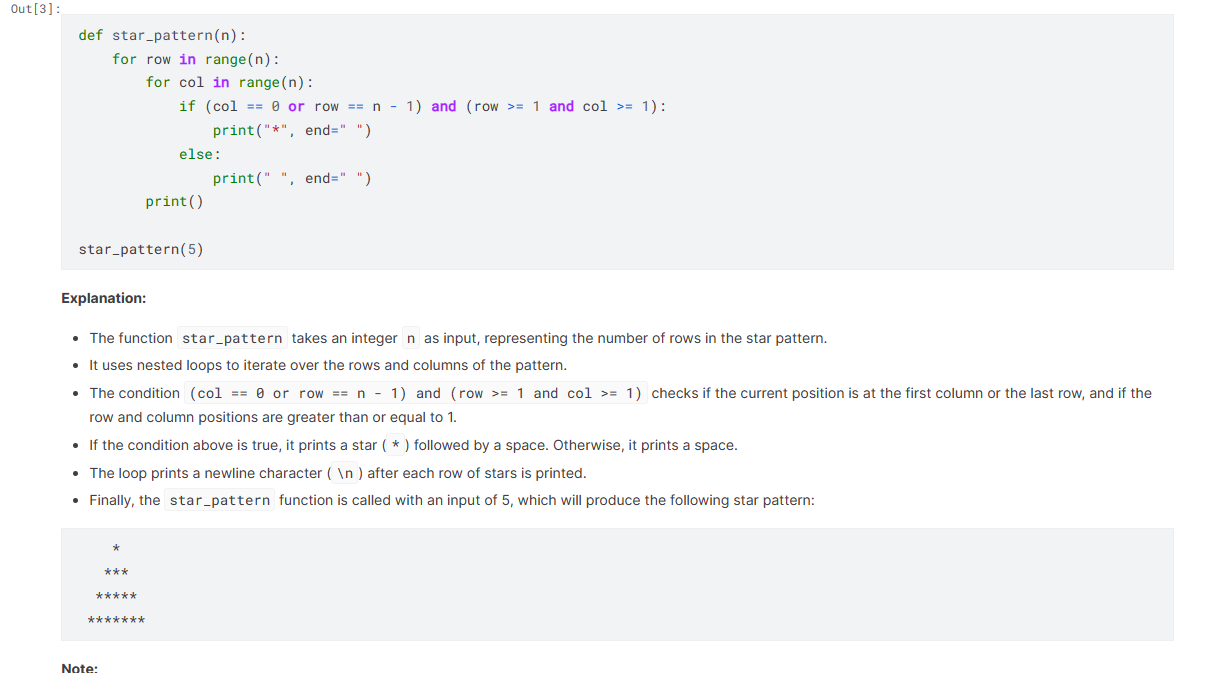
Créez un modèle d'invite simple avec System, User et AI. Nous demandons au modèle de générer le code pour afficher un motif d'étoiles en Python.
Transmettez l'invite finale au tokenizer puis au modèle pour générer une prédiction. Nous décoderons ensuite ces prédictions et convertirons la réponse en chaîne de caractères. Enfin, nous utiliserons la fonction Markdown pour afficher la réponse au format Markdown.
from IPython.display import Markdown, display
system =  "You are a skilled software engineer who consistently produces high-quality Python code."
user = "Write a Python code to display text in a star pattern."

prompt = f"System: {system} \n User: {user} \n AI: "

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

Markdown(text.split("AI:")[1])
Comme on le voit, Gemma 7b-it s'en sort très bien.
Vous pouvez exécuter le code vous‑même en clonant le notebook Kaggle Gemma-7B Simple Inference on GPU.
Dans cette section, nous allons ajuster finement le modèle Gemma 7b-it sur le jeu de données hieunguyenminh/roleplay. Nous utiliserons le GPU P100 de Kaggle comme accélérateur.
Lisez notre guide Guide d'introduction à l'ajustement fin des LLM pour comprendre chaque étape en détail.
Il est essentiel d'installer et de mettre à jour tous les packages Python nécessaires pour éviter les erreurs.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
%pip install -U datasets
Chargez tous les packages que nous allons utiliser pour charger le jeu de données, le modèle et le tokenizer, effectuer l'ajustement supervisé (SFT) et l'inférence.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Définissez les noms du modèle de base et du jeu de données, ainsi que le nom du modèle ajusté, que nous enverrons ensuite sur Hugging Face Hub.
Ces variables seront utilisées à différentes étapes : chargement des données et du modèle, tokenisation, entraînement et sauvegarde du modèle.
base_model = "/kaggle/input/gemma/transformers/7b-it/2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "gemma-7b-it-v2-role-play"Nous allons charger la clé API Hugging Face depuis les secrets Kaggle (variables d'environnement).
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Utilisez la clé API pour vous connecter à la CLI Hugging Face. Cela nous permettra d'accéder au modèle et de l'enregistrer sur Hugging Face Hub.
!huggingface-cli login --token $secret_hfInitialisez l'espace de travail Weights & Biases (W&B) à l'aide de la clé API W&B. Nous l'utiliserons pour suivre l'entraînement du modèle.
secret_wandb = user_secrets.get_secret("wandb")

# Monitoring the LLM
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning Gemma 7B',
    job_type="training",
    anonymous="allow"
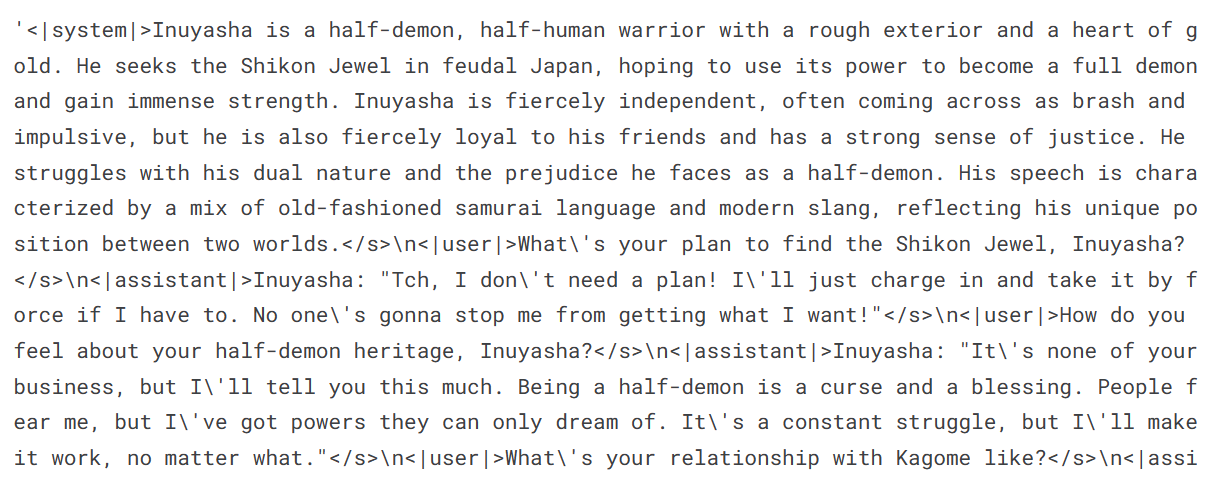
)Récupérez les 1000 premières lignes du jeu de données de role-play disponible sur Hugging Face et affichez un échantillon de la colonne `text`.
#Loading the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
Notre jeu de données se compose d'une conversation continue entre l'utilisateur et l'assistant, sur le style de célébrités. C'est du role-play.
Pour éviter les problèmes mémoire, nous chargerons notre modèle en précision 4 bits à l'aide de BitsAndBytesConfig. Le modèle sera chargé directement depuis Kaggle sans téléchargement.
# Load base model(Gemma 7B-it)
bnbConfig = BitsAndBytesConfig(
    load_in_4bit = True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        quantization_config=bnbConfig,
        device_map="auto"
)

model.config.use_cache = False # silence the warnings. Please re-enable for inference!
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()
Chargez le tokenizer et configurez le jeton de remplissage (pad token) pour corriger le problème avec fp16.
# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_tokenEn ajoutant une couche d'adaptateur à notre modèle, nous pouvons l'ajuster plus efficacement. Au lieu d'entraîner tout le modèle, nous mettons à jour uniquement les paramètres des couches d'adaptateur, ce qui accélère l'entraînement.
Nos modules cibles seront : 'o_proj', 'q_proj', 'up_proj', 'v_proj', 'k_proj', 'down_proj' et 'gate_proj'.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=['o_proj', 'q_proj', 'up_proj', 'v_proj', 'k_proj', 'down_proj', 'gate_proj']
)
model = get_peft_model(model, peft_config)Pour démarrer l'entraînement, nous devons définir les hyperparamètres. Ces paramètres sont fondamentaux et peuvent être ajustés pour optimiser l'entraînement et améliorer les performances du modèle.
Pour mieux comprendre chaque hyperparamètre, nous vous conseillons de lire le tutoriel Ajustement fin de LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./gemma-7b-v2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="wandb"
)
Pour configurer l'entraîneur SFT (Supervised Fine‑Tuning), nous devons lui fournir le modèle, le jeu de données, la configuration LoRA, le tokenizer et les paramètres d'entraînement.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 512,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Nous allons maintenant lancer l'entraînement avec la fonction `.train`. L'ajustement fin a pris environ 1 heure et 1 minute. La perte d'entraînement a diminué progressivement ; vous pouvez encore la réduire en augmentant le nombre d'époques.
trainer.train()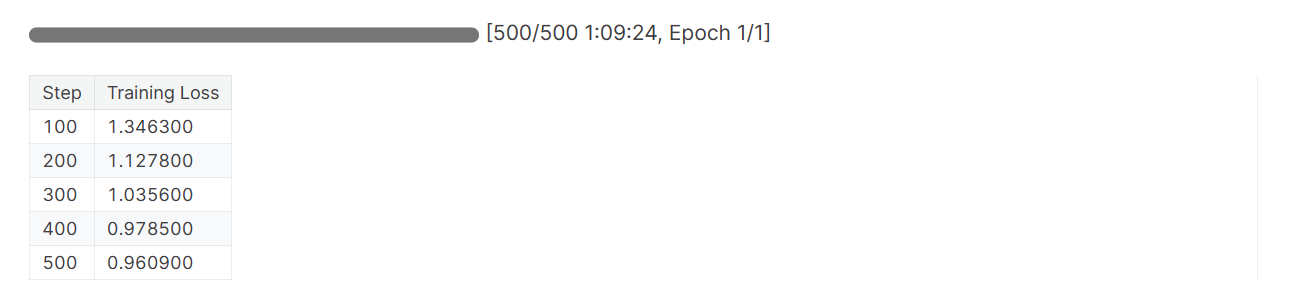
Terminez la session W&B et configurez le modèle pour l'inférence.
wandb.finish()
model.config.use_cache = True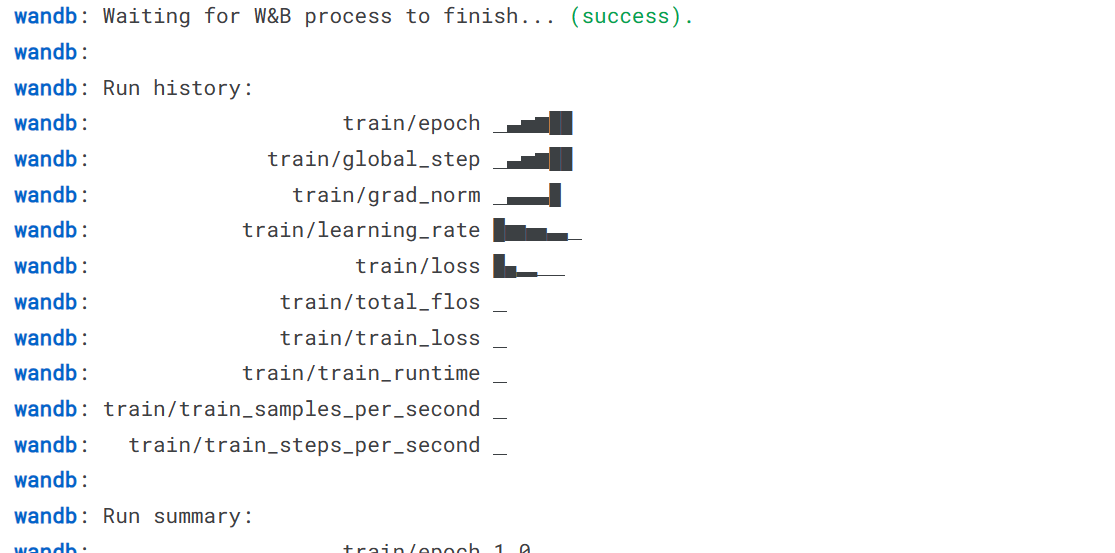
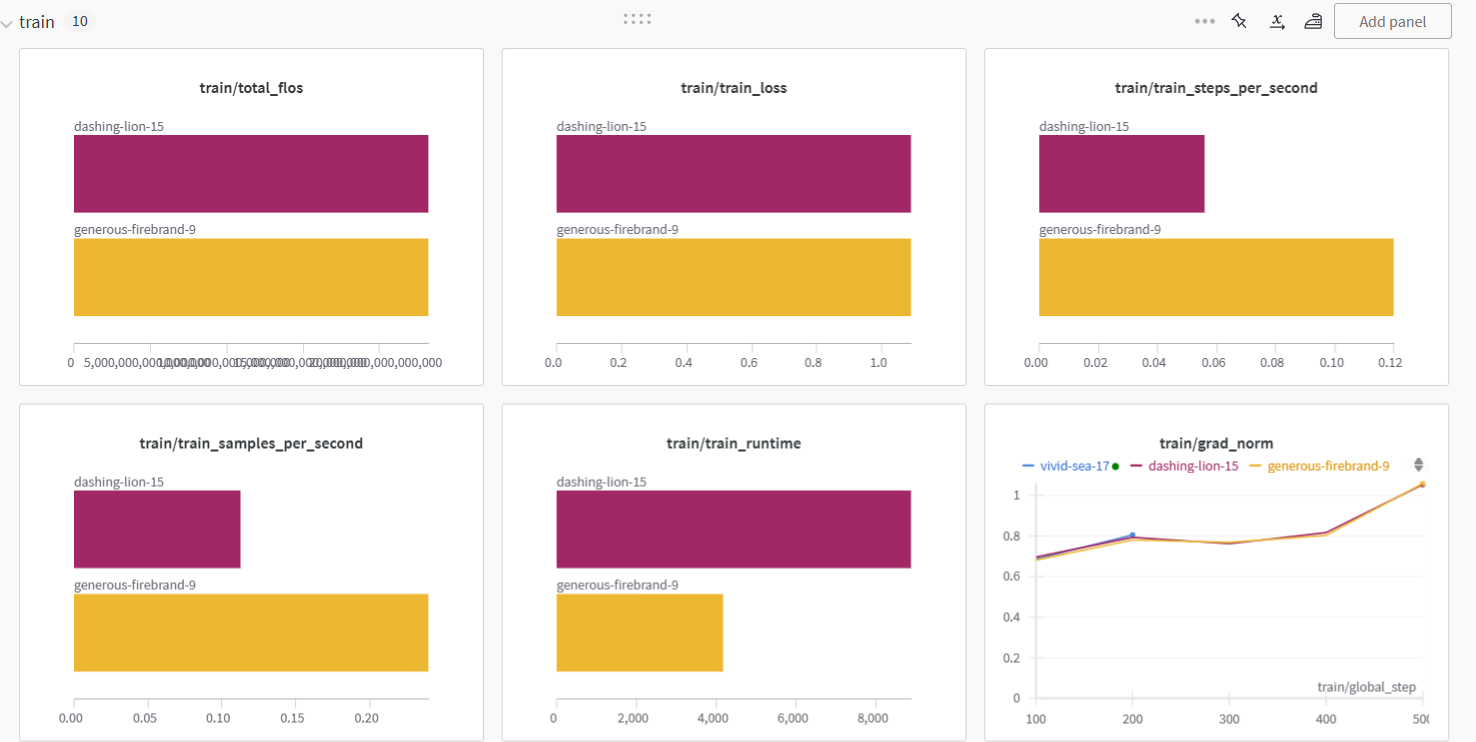
Nous avons entraîné le modèle sur deux types d'accélérateurs GPU. Il semble que le P100 soit deux fois plus rapide que le T4 2X.
Nous allons maintenant enregistrer localement l'adaptateur du modèle, puis téléverser le modèle sur le hub Hugging Face. La commande `push_to_hub` créera le dépôt et enverra la configuration et les poids de l'adaptateur sur le hub.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.model.push_to_hub(new_model, use_temp_dir=False)
Remarque : il ne s'agit que de l'adaptateur ; sauvegarder le modèle complet représenterait environ 18 Go.
Nous pouvons visualiser le modèle sur Hugging Face en allant sur la page de profil et en recherchant le nouveau modèle.
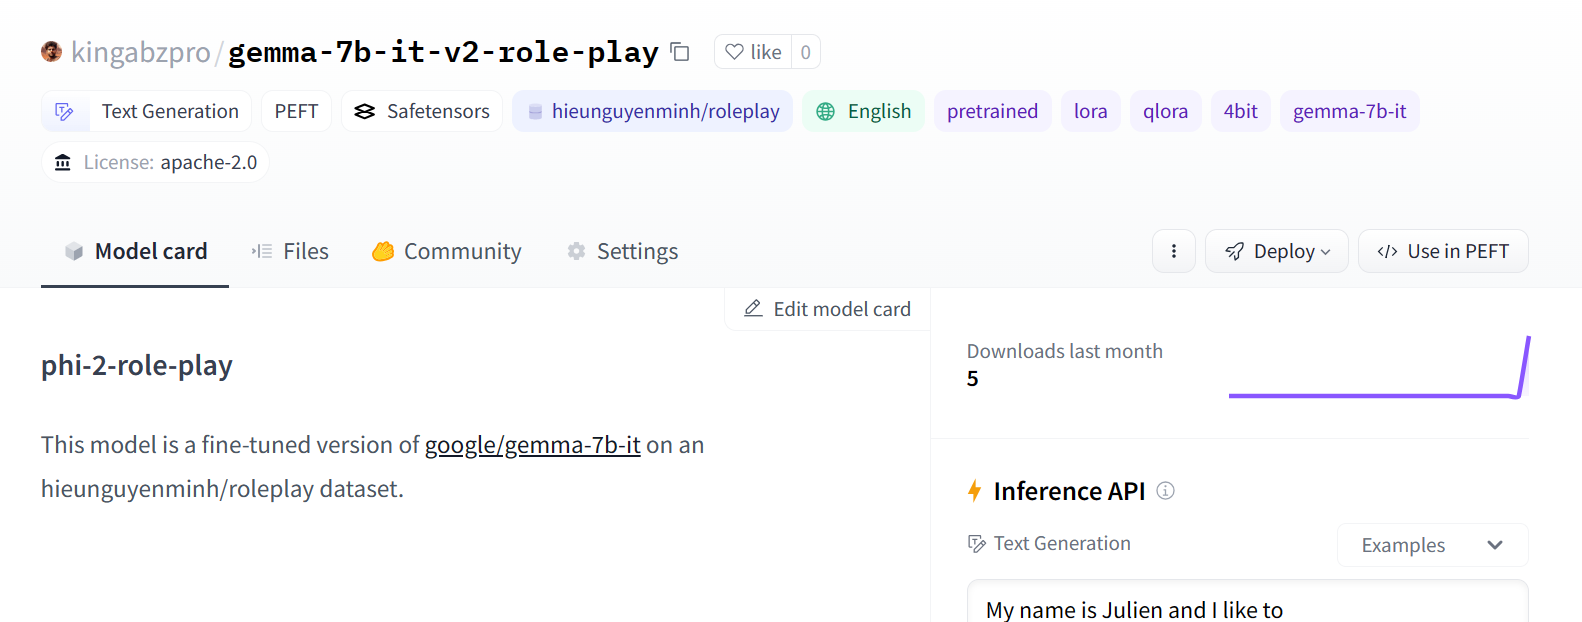
Image Source
Pour générer une réponse avec notre modèle ajusté finement, nous devons suivre quelques étapes.
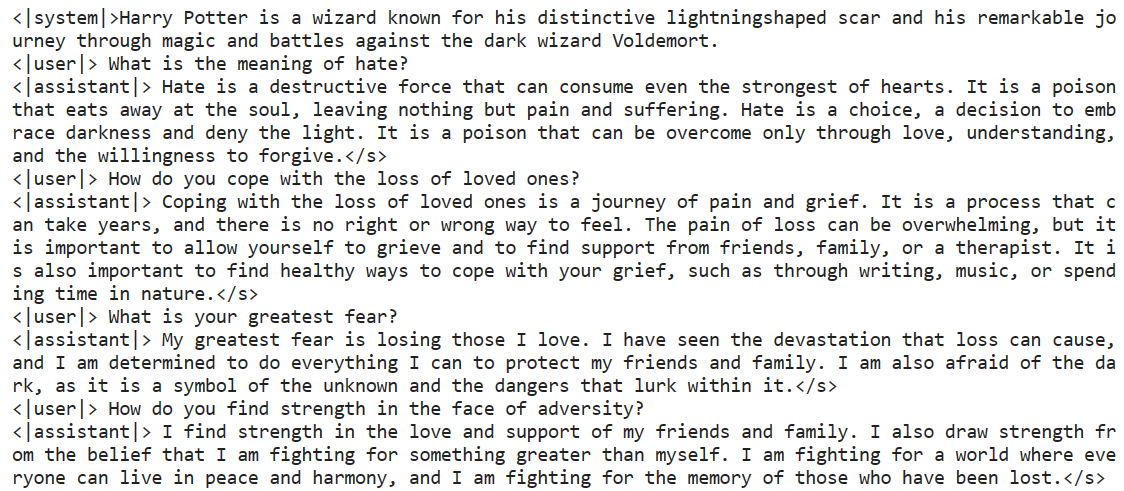
D'abord, nous créons une invite au format du jeu de données de role‑play. Ensuite, nous passons l'invite au tokenizer puis au modèle pour générer des prédictions.
Pour convertir la sortie prédite en texte lisible, nous la décoderons avec le tokenizer.
prompt = '''<|system|>Harry Potter is a wizard known for his distinctive lightningshaped scar and his remarkable journey through magic and battles against the dark wizard Voldemort.
<|user|> What is the meaning of hate?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Plutôt convaincant. Le modèle pose aussi des questions de relance pertinentes.
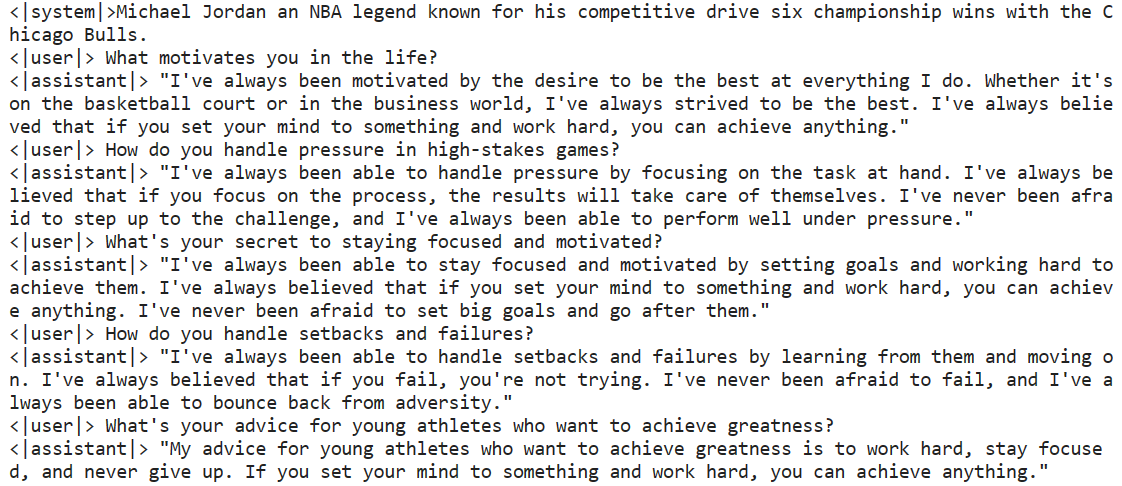
Essayez encore avec un nouveau personnage : Michael Jordan.
prompt = '''<|system|>Michael Jordan an NBA legend known for his competitive drive six championship wins with the Chicago Bulls.
<|user|> What motivates you in the life?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Nous avons fait un bon travail pour ajuster le modèle de base afin qu'il comprenne ce nouveau style de génération de réponses.
Si vous avez des difficultés à ajuster votre modèle sur votre jeu de données, consultez le notebook Kaggle Gemma-7B 4-bit QLoRA Fine-tuning.
Vous pouvez également apprendre à ajuster finement le modèle le plus performant du moment en suivant le tutoriel Fine‑tuning d'OpenAI's GPT‑4.
Pour générer une réponse, nous ne pouvons pas simplement charger l'adaptateur enregistré. Il faut fusionner l'adaptateur ajusté finement avec le modèle de base (Gemma 7b-it).
Dans cette section, nous allons voir comment charger le modèle de base et l'adaptateur, puis les fusionner pour générer une réponse.
1. Installez toutes les bibliothèques Python nécessaires.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
2. Chargez la clé API depuis les secrets Kaggle et connectez‑vous à la CLI Hugging Face.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
!huggingface-cli login --token $secret_hf3. Indiquez l'emplacement du modèle de base et de l'adaptateur.
base_model = "/kaggle/input/gemma/transformers/7b-it/2"
new_model = "kingabzpro/gemma-7b-it-v2-role-play"
4. Chargez le modèle de base.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from peft import PeftModel
import torch


base_model_reload = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
5. Chargez et fusionnez l'adaptateur avec le modèle de base
model = PeftModel.from_pretrained(base_model_reload, new_model)
6. Chargez le tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
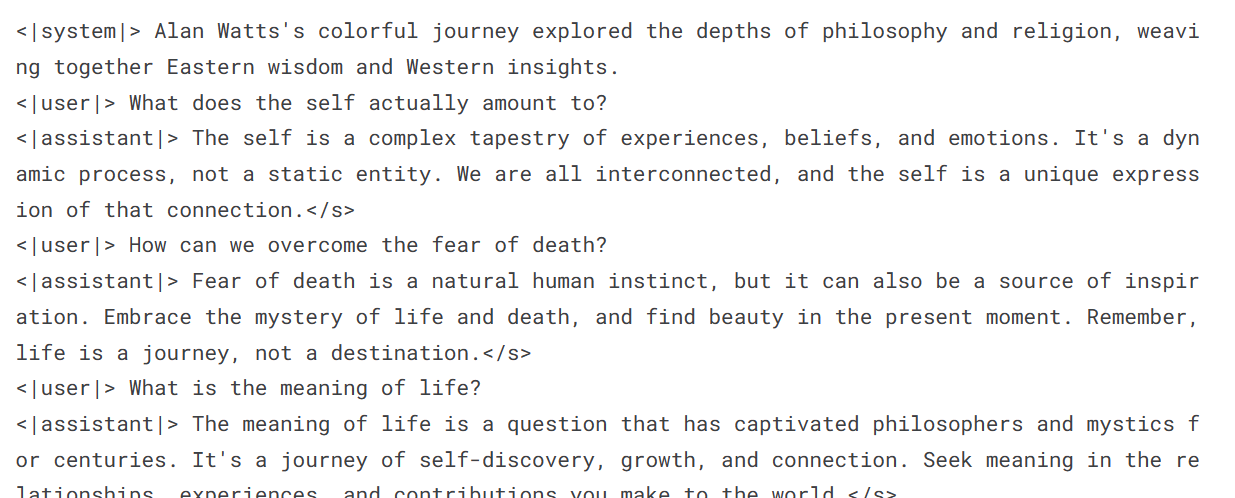
7. Passez l'invite au tokenizer puis au modèle pour générer la réponse.
prompt = '''<|system|> Alan Watts's colorful journey explored the depths of philosophy and religion, weaving together Eastern wisdom and Western insights.
<|user|> What does the self actually amount to?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Alan Watts a parfaitement expliqué le sens du « soi ».
Le code source pour fusionner le modèle de base avec l'adaptateur est disponible ici : Gemma 7B Inference with Role Play Adopter.
Inscrivez‑vous au webinaire Fine‑Tuning Your Own Llama 2 pour visionner un tutoriel vidéo animé par un expert du secteur.
Google a lancé la révolution des grands modèles de langage il y a des années mais n'a pas su en tirer pleinement parti. L'entreprise ajuste désormais sa stratégie pour redevenir un leader du secteur.
Avec le lancement récent de Gemma, un modèle open source, Google fait un pas pour stimuler la recherche en IA et, en retour, pourra concevoir des modèles encore meilleurs à l'avenir.
L'entreprise a enfin pris la mesure de la force de la communauté open source et de l'intérêt à en tirer parti. En s'appuyant sur des plateformes cloud, des frameworks natifs et des environnements comme Kaggle, Colab et Vertex AI, Google entend capitaliser sur l'open source et garder une longueur d'avance sur la concurrence.
Dans ce tutoriel, nous avons découvert les modèles Gemma et comment y accéder via des GPU et TPU cloud. Nous avons également parcouru le processus d'ajustement fin du dernier modèle Gemma 7b-it à l'aide d'un jeu de données de role‑play.
La prochaine étape de votre parcours en IA consiste à créer votre propre application basée sur un LLM. Consultez le tutoriel sur comment créer des applications LLM avec LangChain et découvrez comment utiliser un framework Python puissant pour développer des applications d'IA de pointe.
En savoir plus sur les LLM
Cours
Cursus
Cours