
Kurs
Entwickeln von LLM-Anwendungen mit LangChain
3 Std.
50.6K
Es ist eine spannende Zeit in der Welt der KI. Große Unternehmen wie Google, Meta und Twitter setzen stark darauf, ihre Large Language Models (LLMs) als Open Source bereitzustellen. Kürzlich hat das Google-DeepMind-Team Gemma vorgestellt – eine Familie leichter, quelloffener LLMs, entwickelt auf Basis derselben Forschung und Technologie wie Googles Gemini-Modelle.
Bild Quelle
Hier lernst du die Gemma-Modelle kennen, wie du sie mit Cloud-GPUs und -TPUs nutzt und wie du das aktuelle Gemma-7b-it-Modell mit einem Roleplay-Datensatz trainierst.
Gemma (lateinisch für „Edelstein“) ist eine Familie textbasierter, decoder-only Open-Modelle, entwickelt von verschiedenen Teams bei Google, insbesondere Google DeepMind. Inspiriert von den Gemini-Modellen ist Gemma schlank konzipiert und mit allen gängigen Frameworks kompatibel.
Google hat Modellgewichte in zwei Größen veröffentlicht: Gemma 2B und Gemma 7B – jeweils als vortrainierte und instruktionsabgestimmte Varianten wie Gemma 2B-it und Gemma 7B-it.
Gemma teilt wesentliche technische Bausteine mit Gemini und erreicht in seiner Größenklasse Spitzenleistungen – im Vergleich zu anderen Open-Source-Modellen wie Metas Llama‑2. In Benchmarks schlägt Gemma Llama‑2 durchweg.
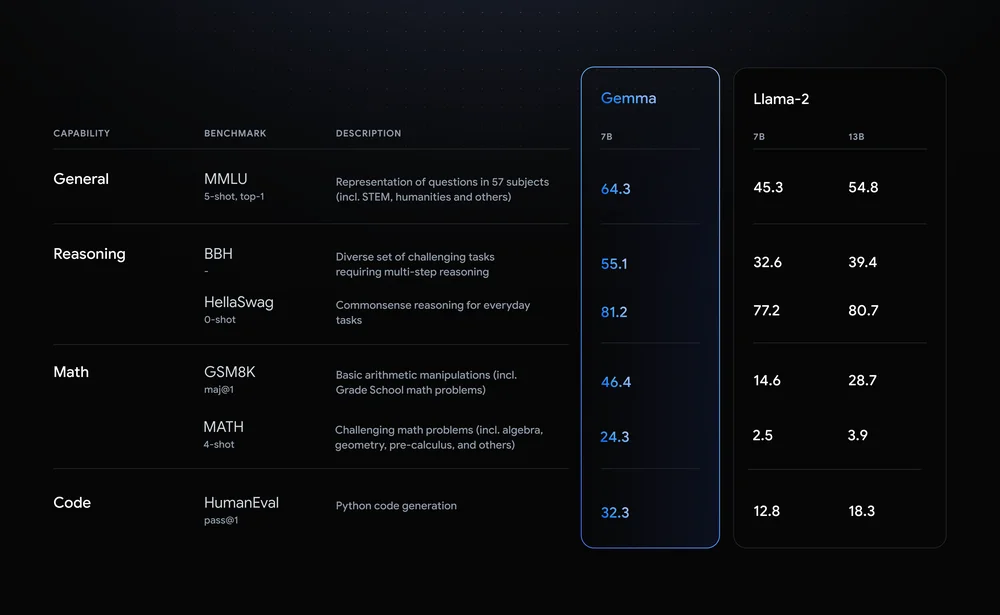
Bild Quelle
Gemma unterstützt eine breite Palette an Tools und Systemen, darunter Framework-übergreifende Tools wie Keras 3.0, natives PyTorch, JAX und Hugging Face Transformers. Das Modell läuft auf gängigen Gerätetypen – von Laptop und Desktop über IoT und Mobile bis zur Cloud.
Du kannst jetzt Inferenz und Supervised Fine-Tuning (SFT) kostenfrei auf Cloud-TPUs mit deinem bevorzugten Machine-Learning-Framework wie Keras 3.0 ausführen.
Zusammen mit Gemma hat Google ein Responsible Generative AI Toolkit veröffentlicht – mit Leitlinien, wichtigen Werkzeugen und Sicherheitsklassifizierungen, damit Entwickler sicherere KI-Anwendungen bauen.
Wenn du neu in der KI- und LLM-Welt bist, empfehlen wir den Skill-Lernpfad AI Fundamentals. Er vermittelt praxisnahes Wissen zu Themen wie ChatGPT, Large Language Models, Generative KI und mehr.
Der Einstieg ist super einfach: Du kannst Gemma kostenlos in HuggingChat und Poe nutzen. Lokal geht es ebenfalls – lade die Modellgewichte bei Hugging Face herunter und verwende GPT4ALL oder LMStudio.
In diesem Abschnitt laden wir das Gemma-Modell und führen Inferenz mit kostenlosen GPUs und TPUs der Kaggle-Plattform aus.
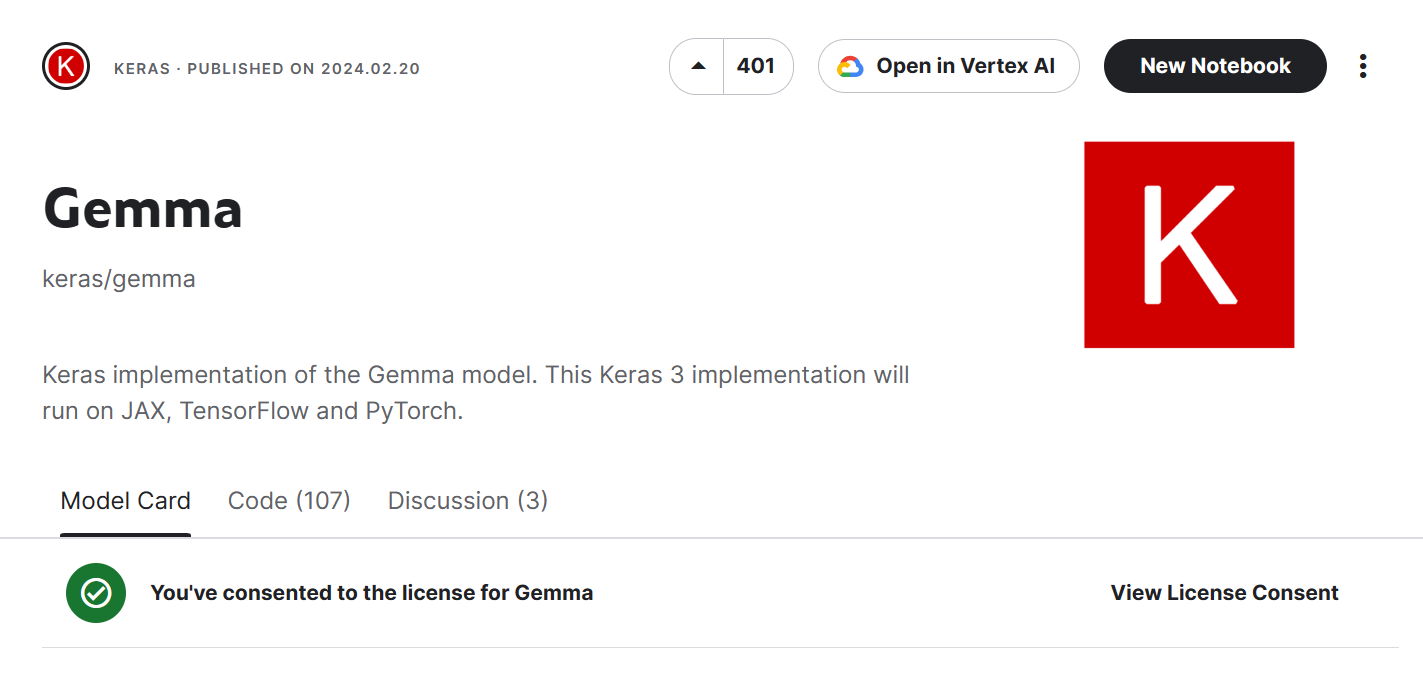
Gehe zu Keras/Gemma, scrolle nach unten, wähle die Variante „gemma_instruct_2b_en“ und klicke auf „New Notebook“. Dadurch startet ein Cloud-Notebook mit dem Gemma-Modell im Input-Verzeichnis.
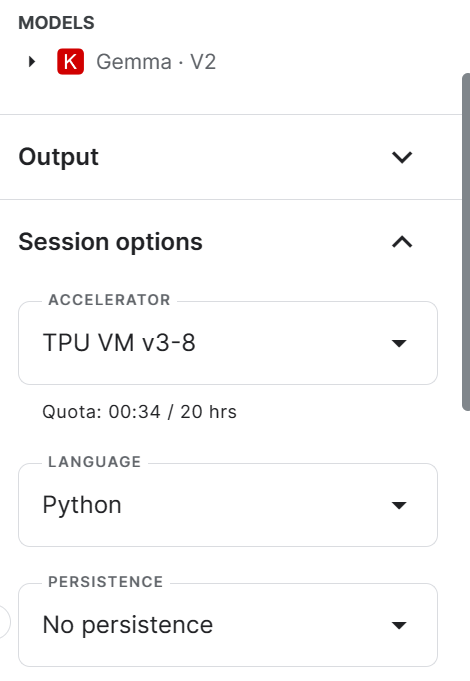
Wähle rechts unter „Accelerator“ die Option „TPU VM v3-8“.
Stelle sicher, dass alle erforderlichen Python-Bibliotheken installiert und aktualisiert sind.
!pip install -q tensorflow-cpu
!pip install -q -U keras-nlp tensorflow-hub
!pip install -q -U keras>=3
!pip install -q -U tensorflow-text
Um die verfügbaren TPUs zu prüfen, kannst du die Bibliothek `jax` verwenden und mit der Funktion `device` die TPU-Geräte anzeigen. Hier stehen 8 TPUs zur Verfügung.
import jax

jax.devices()
[TpuDevice(id=0, process_index=0, coords=(0,0,0), core_on_chip=0),
TpuDevice(id=1, process_index=0, coords=(0,0,0), core_on_chip=1),
TpuDevice(id=2, process_index=0, coords=(1,0,0), core_on_chip=0),
TpuDevice(id=3, process_index=0, coords=(1,0,0), core_on_chip=1),
TpuDevice(id=4, process_index=0, coords=(0,1,0), core_on_chip=0),
TpuDevice(id=5, process_index=0, coords=(0,1,0), core_on_chip=1),
TpuDevice(id=6, process_index=0, coords=(1,1,0), core_on_chip=0),
TpuDevice(id=7, process_index=0, coords=(1,1,0), core_on_chip=1)]Als Nächstes aktivieren wir TPU für Keras 3, indem wir `jax` als Keras-Backend setzen.
import os

os.environ["KERAS_BACKEND"] = "jax"
Nach dem Setup ist der Zugriff auf Gemma und das Generieren von Antworten ganz einfach. Wir nutzen die Bibliothek `keras_nlp`, um das Modell von Kaggle zu laden, und übergeben dann den Prompt an die Funktion `generate`.
import keras
import keras_nlp

model_name = "/kaggle/input/gemma/keras/gemma_instruct_2b_en/2"
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset(model_name)
prompt = "Can you share an interesting fact about Leonardo da Vinci?"

gemma_lm.generate(prompt, max_length=100)
Das Ergebnis sieht so aus:
"Can you share an interesting fact about Leonardo da Vinci?\n\nSure, here's an interesting fact about Leonardo da Vinci:\n\nLeonardo da Vinci was born in a village called Vinci, Italy, which is now part of the city of Florence."
Du kannst das Kaggle-Notebook (Gemma-2B-V2 Simple Inference on TPU) direkt ausführen und mit kostenlosen TPUs Antworten generieren.
Jetzt generieren wir Antworten mit GPUs und einem Transformer-Framework statt Keras.
Gehe zu google/gemma, scrolle nach unten, wähle „Transformers“, dann die Modellvariante „7b-it“ und klicke auf „New Notebook“. Dadurch startet ein Cloud-Notebook mit der passenden Gemma-Version im Input-Verzeichnis.
Hinweis: Weiter unten auf der Seite findest du auch einen Inferenz-Bereich. Dort kannst du alle Gemma-Varianten testen, indem du einen Prompt eingibst und die Antwort generieren lässt – schnell und bequem.
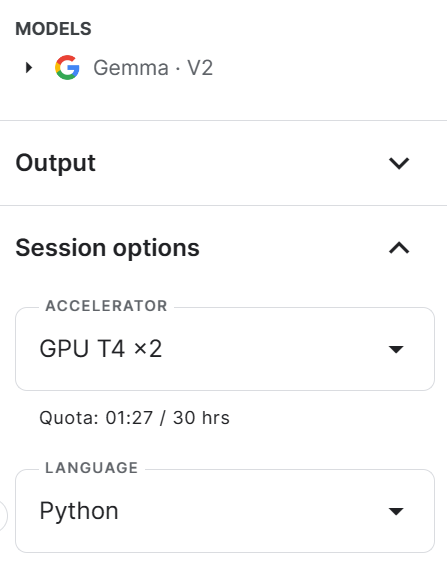
Im neuen Notebook gib ihm einen Titel und stelle den Accelerator auf GPU T4 x2 um.
Installiere und aktualisiere alle benötigten Python-Pakete.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
Das komplette Gemma-7b-it-Modell passt aufgrund begrenzter VRAM nicht in die Kaggle-GPUs. Wir umgehen das, indem wir das Modell mit 4‑Bit-Quantisierung (NF4) über BitsAndBytes laden. Außerdem laden wir den Tokenizer.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig, AutoConfig

modelName = "/kaggle/input/gemma/transformers/7b-it/2"

bnbConfig = BitsAndBytesConfig(
    load_in_4bit = True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
    modelName,
    device_map = "auto",
    quantization_config=bnbConfig
)

tokenizer = AutoTokenizer.from_pretrained(modelName)
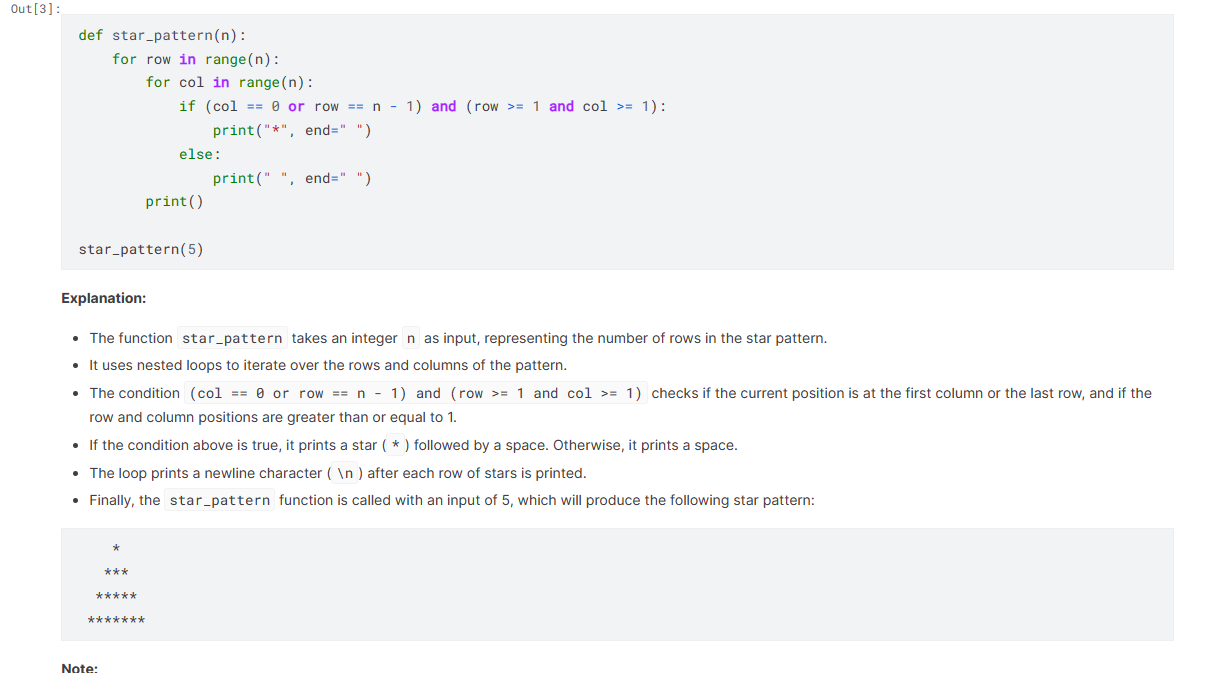
Erstelle eine einfache Prompt-Vorlage mit System, User und AI. Wir lassen das Modell Python-Code für ein Sternmuster generieren.
Gib den finalen Prompt an den Tokenizer und dann an das Modell, um eine Vorhersage zu erzeugen. Anschließend decodieren wir die Ausgabe und zeigen sie formatiert in Markdown an.
from IPython.display import Markdown, display
system =  "You are a skilled software engineer who consistently produces high-quality Python code."
user = "Write a Python code to display text in a star pattern."

prompt = f"System: {system} \n User: {user} \n AI: "

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

Markdown(text.split("AI:")[1])
Wie du siehst, liefert Gemma 7b-it hier sehr gute Ergebnisse.
Du kannst den Code selbst ausführen, indem du das Kaggle-Notebook Gemma-7B Simple Inference on GPU klonst.
Hier stimmen wir das Gemma-7b-it-Modell auf dem Datensatz hieunguyenminh/roleplay fein ab. Als Accelerator nutzen wir die Kaggle-GPU P100.
Lies unsere Anleitung An Introductory Guide to Fine-Tuning LLMs, um jeden Schritt im Detail zu verstehen.
Installiere und aktualisiere alle benötigten Python-Pakete, um Fehler zu vermeiden.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
%pip install -U datasets
Lade alle Pakete, die wir zum Laden von Datensatz, Modell und Tokenizer sowie für Supervised Fine-Tuning (SFT) und Inferenz benötigen.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Definiere Namen für Basismodell und Datensatz sowie den Namen des feinabgestimmten Modells, das wir später auf den Hugging Face Hub hochladen.
Diese Variablen verwenden wir in verschiedenen Schritten, etwa beim Laden von Datensatz und Modell, beim Tokenisieren, Trainieren und Speichern.
base_model = "/kaggle/input/gemma/transformers/7b-it/2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "gemma-7b-it-v2-role-play"Wir laden den Hugging-Face-API-Schlüssel aus den Kaggle Secrets (Umgebungsvariablen).
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Verwende den API-Schlüssel, um dich bei der Hugging Face CLI anzumelden. So können wir auf das Modell zugreifen und es später im Hub speichern.
!huggingface-cli login --token $secret_hfInitialisiere den Weights-&-Biases-(W&B)-Workspace mit dem W&B-API-Schlüssel. Darüber verfolgen wir das Training.
secret_wandb = user_secrets.get_secret("wandb")

# Monitoring the LLM
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning Gemma 7B',
    job_type="training",
    anonymous="allow"
)Rufe die ersten 1000 Zeilen des Roleplay-Datensatzes von Hugging Face ab und zeige ein Beispiel der Spalte `text`.
#Loading the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
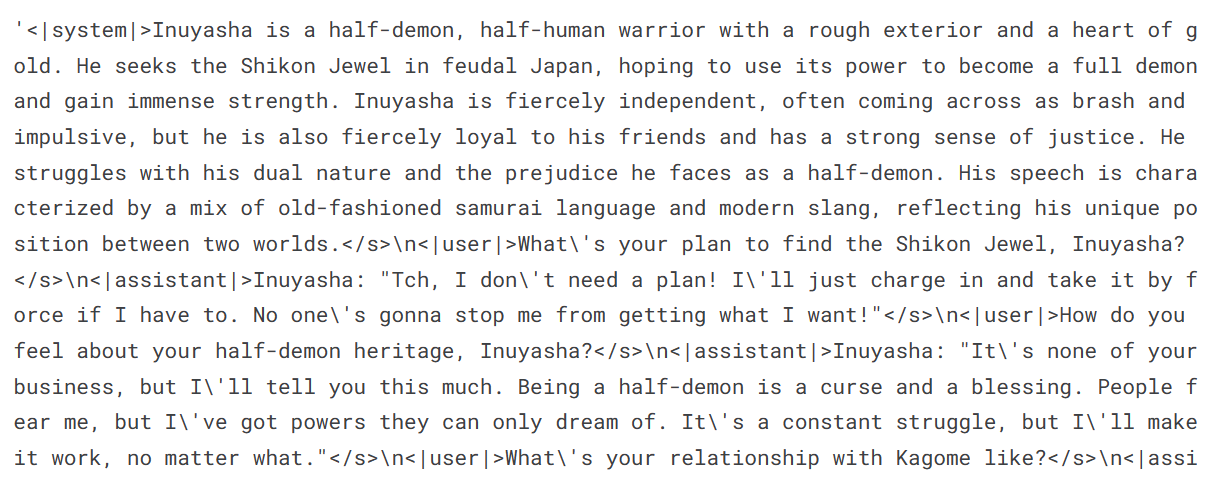
Unser Datensatz besteht aus fortlaufenden Dialogen zwischen Nutzer und Assistent in Promi-Stilen – also Rollenspiel.
Um Speicherprobleme zu vermeiden, laden wir das Modell mit 4‑Bit-Präzision über BitsAndBytesConfig. Das Modell wird direkt aus Kaggle geladen – ohne Download.
# Load base model(Gemma 7B-it)
bnbConfig = BitsAndBytesConfig(
    load_in_4bit = True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        quantization_config=bnbConfig,
        device_map="auto"
)

model.config.use_cache = False # silence the warnings. Please re-enable for inference!
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()
Lade den Tokenizer und setze das Pad-Token, um Probleme mit fp16 zu vermeiden.
# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_tokenDurch Adapter-Layer lässt sich das Modell deutlich effizienter feinabstimmen. Statt das komplette Modell zu trainieren, aktualisieren wir nur die Parameter der Adapter – das beschleunigt das Training.
Unsere Zielmodule sind: 'o_proj', 'q_proj', 'up_proj', 'v_proj', 'k_proj', 'down_proj' und 'gate_proj'.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=['o_proj', 'q_proj', 'up_proj', 'v_proj', 'k_proj', 'down_proj', 'gate_proj']
)
model = get_peft_model(model, peft_config)Für das Training müssen wir die Hyperparameter festlegen. Diese Basiswerte kannst du anpassen, um Training und Modellleistung weiter zu verbessern.
Wenn du die Hyperparameter besser verstehen möchtest, empfehlen wir das Tutorial Fine-Tuning LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./gemma-7b-v2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="wandb"
)
Für den Supervised-Fine-Tuning-(SFT)-Trainer übergeben wir Modell, Datensatz, LoRA-Konfiguration, Tokenizer und Trainingsparameter.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 512,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Starte nun den Trainingslauf mit `.train`. Die Feinabstimmung dauerte rund 1 Stunde und 1 Minute. Der Trainingsverlust fiel stetig; mit mehr Epochen kannst du ihn weiter senken.
trainer.train()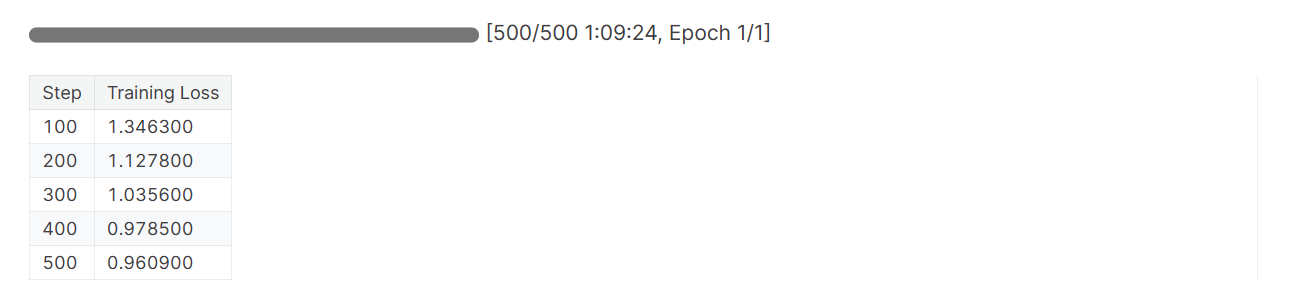
Beende die W&B-Session und aktiviere das Modell für Inferenz.
wandb.finish()
model.config.use_cache = True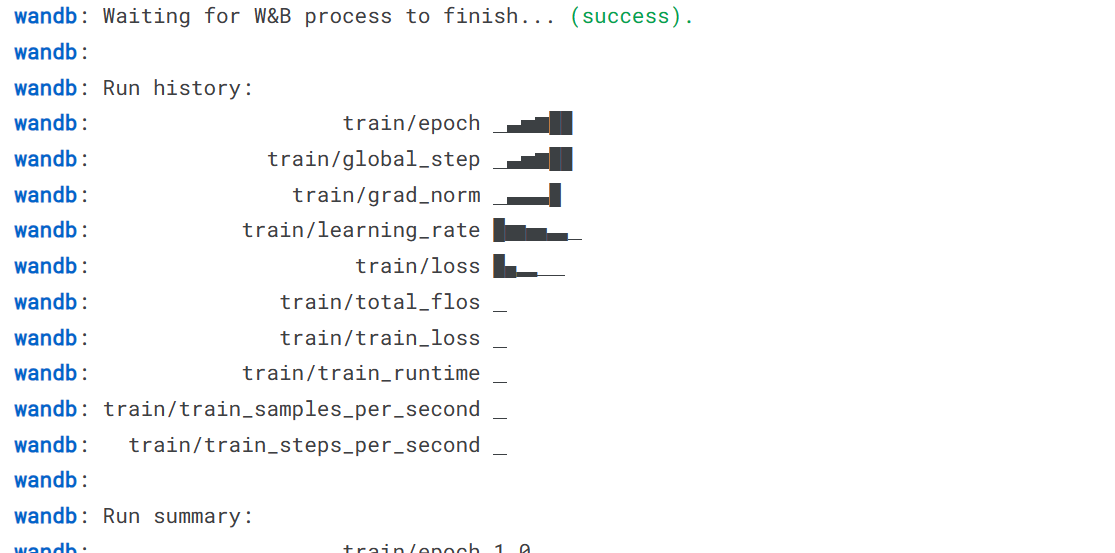
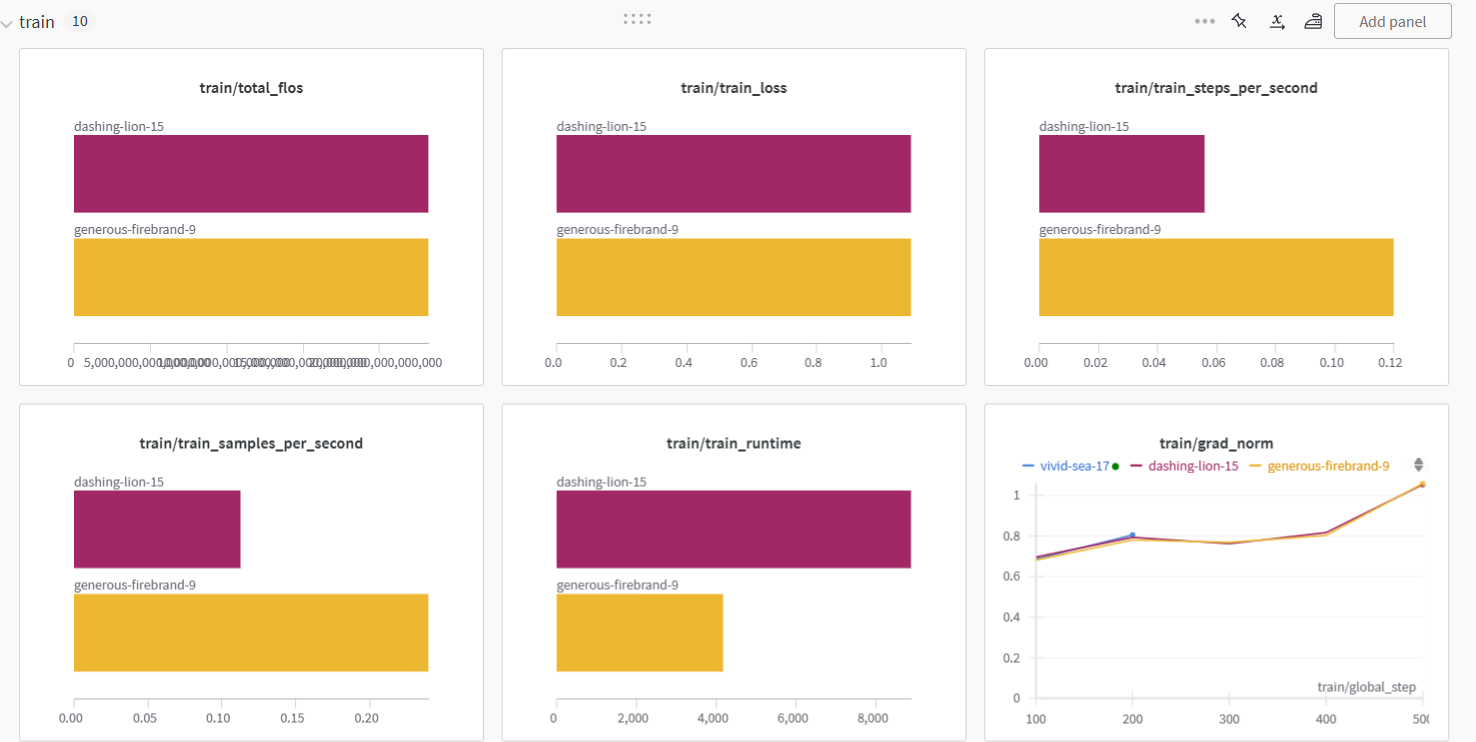
Wir haben auf zwei GPU-Typen trainiert. Offenbar war die P100 etwa doppelt so schnell wie die T4 2X.
Jetzt speichern wir den Adapter lokal und laden ihn anschließend in den Hugging Face Hub hoch. Der Befehl `push_to_hub` erstellt das Repo und überträgt Adapter-Konfiguration und -Gewichte.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.model.push_to_hub(new_model, use_temp_dir=False)
Hinweis: Hier speichern wir nur den Adapter – das vollständige Modell wäre rund 18 GB groß.
Du findest das Modell auf Hugging Face, indem du zu deinem Profil gehst und nach dem neuen Modell suchst.
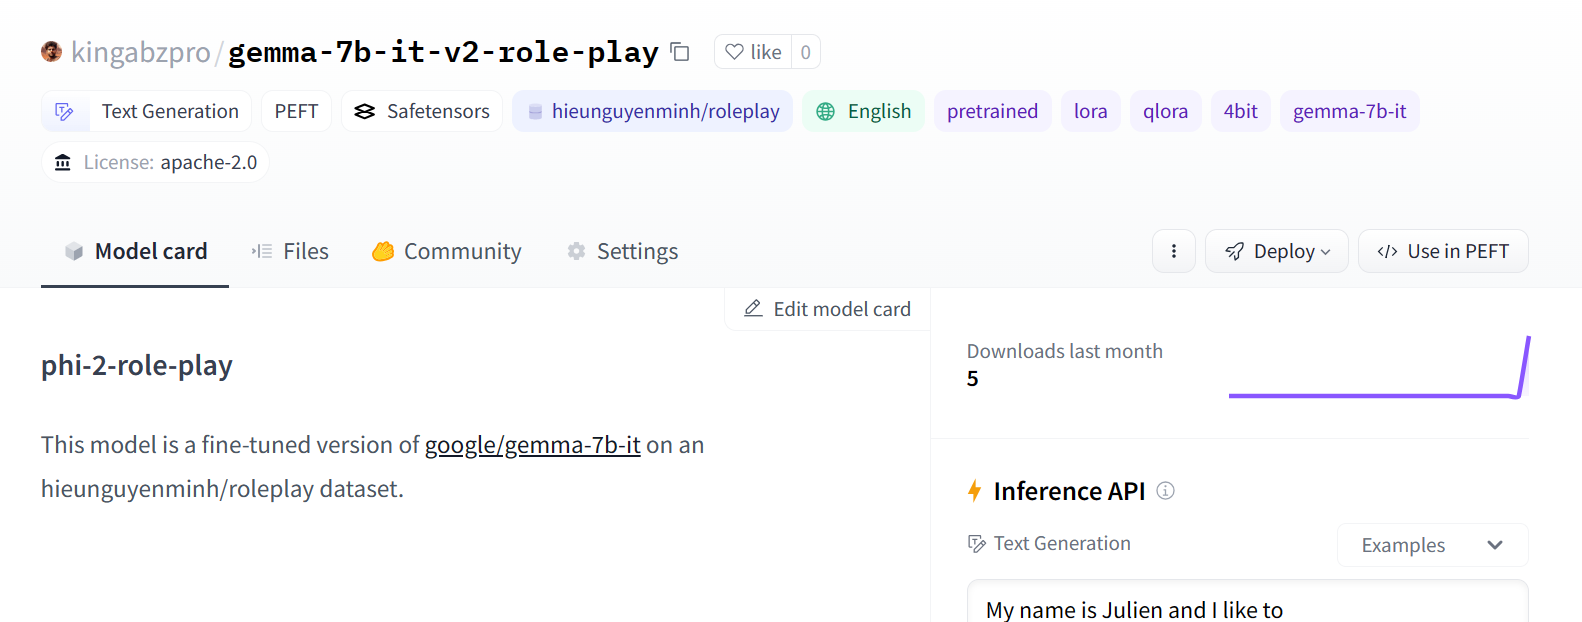
Bild Quelle
Um mit unserem feinabgestimmten Modell eine Antwort zu generieren, sind ein paar Schritte nötig.
Zuerst erstellen wir einen Prompt im Format des Roleplay-Datensatzes. Danach geht der Prompt an den Tokenizer und anschließend an das Modell, um Vorhersagen zu erzeugen.
Damit die Ausgabe lesbar wird, decodieren wir sie mit dem Tokenizer.
prompt = '''<|system|>Harry Potter is a wizard known for his distinctive lightningshaped scar and his remarkable journey through magic and battles against the dark wizard Voldemort.
<|user|> What is the meaning of hate?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Gar nicht schlecht. Das Modell stellt sogar passende Rückfragen.
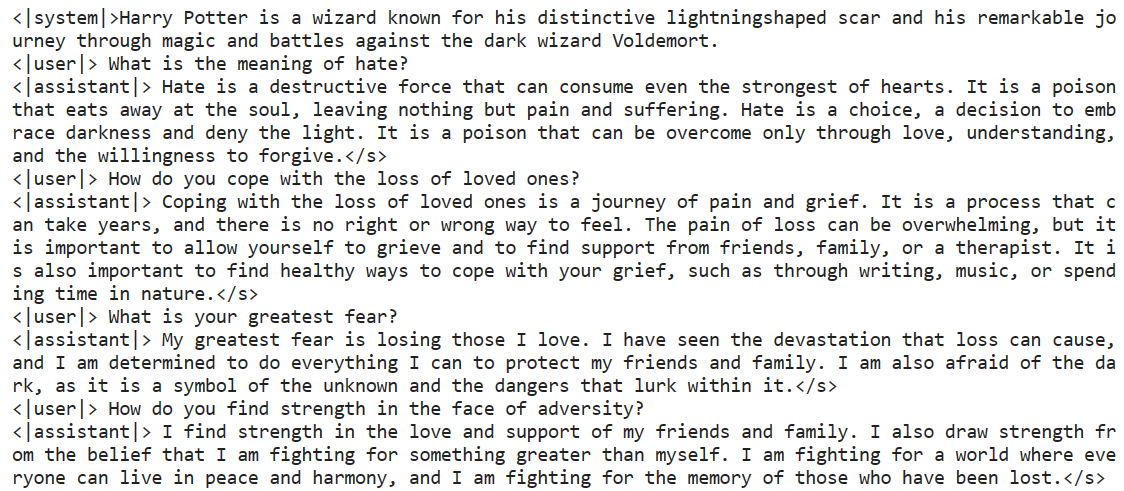
Probier es noch einmal mit einer neuen Figur: Michael Jordan.
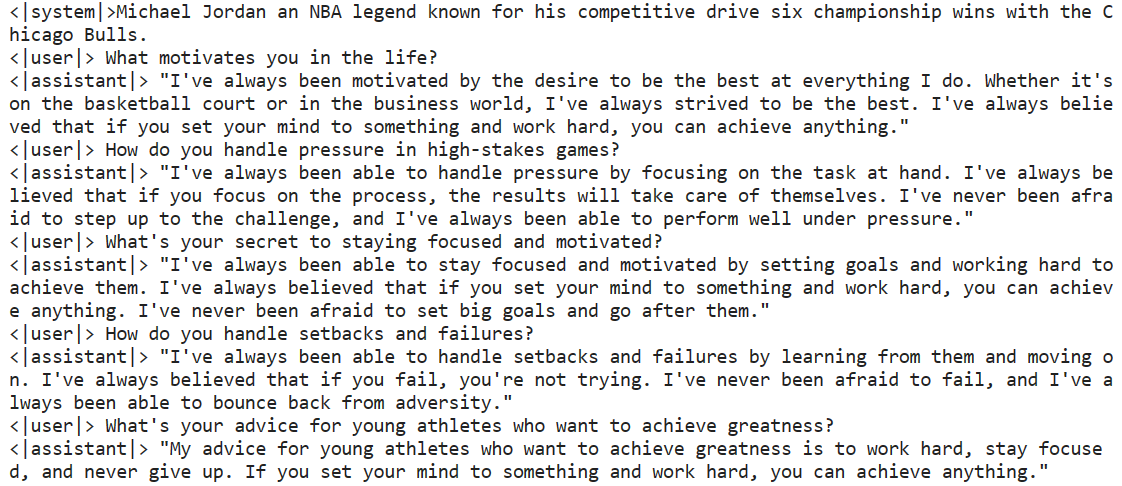
prompt = '''<|system|>Michael Jordan an NBA legend known for his competitive drive six championship wins with the Chicago Bulls.
<|user|> What motivates you in the life?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Die Feinabstimmung hat das Basismodell sichtlich gut auf den neuen Antwortstil konditioniert.
Wenn du Schwierigkeiten hast, dein Modell auf deinem Datensatz zu feinabstimmen, wirf einen Blick ins Kaggle-Notebook Gemma-7B 4-bit QLoRA Fine-tuning.
Du kannst außerdem lernen, wie du ein Topmodell der Branche feinabstimmst – siehe Fine-Tuning OpenAI's GPT-4.
Um Antworten zu generieren, reicht es nicht, nur den gespeicherten Adapter zu laden. Wir müssen den feinabgestimmten Adapter mit dem Basismodell (Gemma 7b-it) zusammenführen.
In diesem Abschnitt laden wir Basis und Adapter und mergen sie, um eine Antwort zu erzeugen.
1. Installiere alle erforderlichen Python-Bibliotheken.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
2. Lade den API-Schlüssel aus Kaggle Secrets und melde dich bei der Hugging Face CLI an.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
!huggingface-cli login --token $secret_hf3. Gib die Pfade für Basismodell und Adapter an.
base_model = "/kaggle/input/gemma/transformers/7b-it/2"
new_model = "kingabzpro/gemma-7b-it-v2-role-play"
4. Lade das Basismodell.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from peft import PeftModel
import torch


base_model_reload = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
5. Lade den Adapter und merge ihn mit dem Basismodell.
model = PeftModel.from_pretrained(base_model_reload, new_model)
6. Lade den Tokenizer.
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
7. Schicke den Prompt durch Tokenizer und Modell, um eine Antwort zu erzeugen.
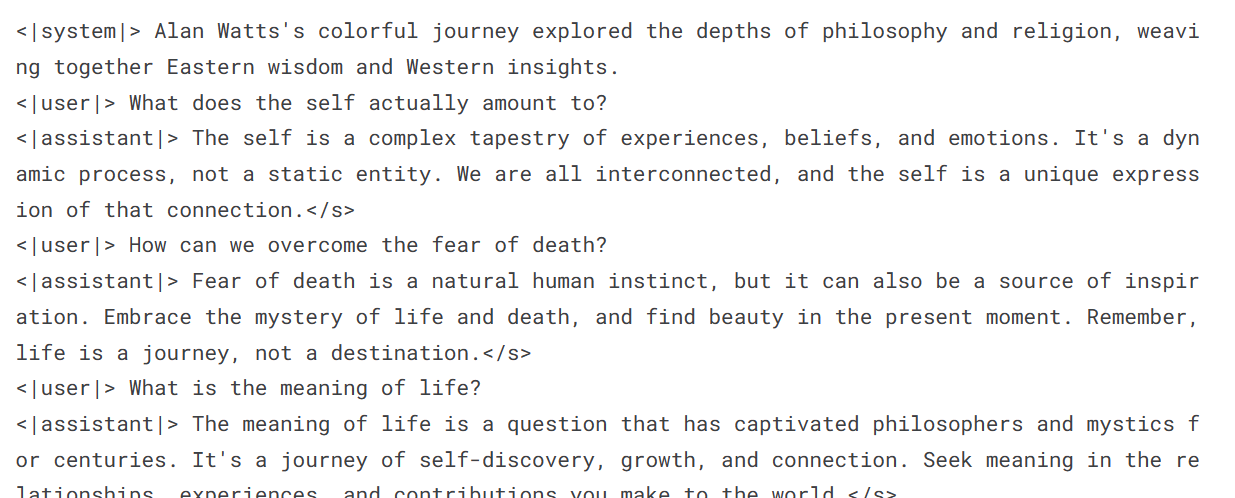
prompt = '''<|system|> Alan Watts's colorful journey explored the depths of philosophy and religion, weaving together Eastern wisdom and Western insights.
<|user|> What does the self actually amount to?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Alan Watts erklärt die Bedeutung des „Selbst“ hier sehr treffend.
Den Code zum Mergen von Basismodell und Adapter findest du hier: Gemma 7B Inference with Role Play Adopter.
Melde dich für das Webinar Fine-Tuning Your Own Llama 2 an und sieh dir die Videoanleitung eines Branchenexperten an.
Google hat die LLM-Revolution früh angestoßen, konnte sie aber lange nicht für sich nutzen. Jetzt passt das Unternehmen seine Strategie an, um wieder zur Spitze aufzuschließen.
Mit dem jüngst veröffentlichten Open-Source-Modell Gemma geht Google einen wichtigen Schritt, der die KI-Forschung beflügelt – und langfristig noch bessere Modelle ermöglicht.
Google hat die Stärke der Open-Source-Community erkannt und wie sehr sie davon profitieren können. Über Cloud-Plattformen, native Frameworks und Angebote wie Kaggle, Colab und Vertex AI will Google die Community einbinden und sich im Wettbewerb die Nase vorn sichern.
In diesem Tutorial hast du die Gemma-Modelle kennengelernt und gelernt, wie du sie mit Cloud-GPUs und -TPUs nutzt. Außerdem haben wir die Feinabstimmung des aktuellen Gemma-7b-it-Modells mit einem Roleplay-Datensatz durchgespielt.
Der nächste Schritt auf deiner KI-Reise: Baue deine eigene LLM-gestützte Anwendung. Sieh dir das Tutorial How to build LLM applications with LangChain an und nutze ein leistungsstarkes Python-Framework für moderne KI-Apps.
Mehr über LLMs lernen
Kurs
Lernpfad
Kurs