Curso
Desenvolvimento de aplicativos de LLM com LangChain
3 h
50.6K
Estamos vivendo um momento empolgante no mundo da IA. Gigantes como Google, Meta e Twitter estão apostando forte em tornar seus grandes modelos de linguagem (LLMs) open source. Recentemente, o time do Google DeepMind lançou o Gemma — uma família de LLMs leves e de código aberto construída com a mesma pesquisa e tecnologia usadas para criar os modelos Gemini do Google.
Imagem Fonte
Aqui, você vai conhecer os modelos Gemma, como acessá-los usando GPUs e TPUs em nuvem e como treinar o mais recente Gemma 7b-it em um dataset de role-play.
Gemma (do latim para “pedra preciosa”) é uma família de modelos abertos, text-to-text e apenas decodificador, desenvolvidos por diferentes equipes do Google, especialmente o Google DeepMind. Inspirado nos modelos Gemini, ele foi projetado para ser leve e compatível com as principais frameworks.
O Google disponibilizou os pesos do modelo em dois tamanhos, Gemma 2B e Gemma 7B, com variantes pré-treinadas e ajustadas por instruções, como Gemma 2B-it e Gemma 7B-it.
Como sabemos, o Gemma compartilha componentes técnicos com o Gemini e entrega performance de ponta para seus tamanhos quando comparado a outros modelos abertos, como o Llama-2 da Meta. Ele superou o Llama-2 em todos os benchmarks de LLM.
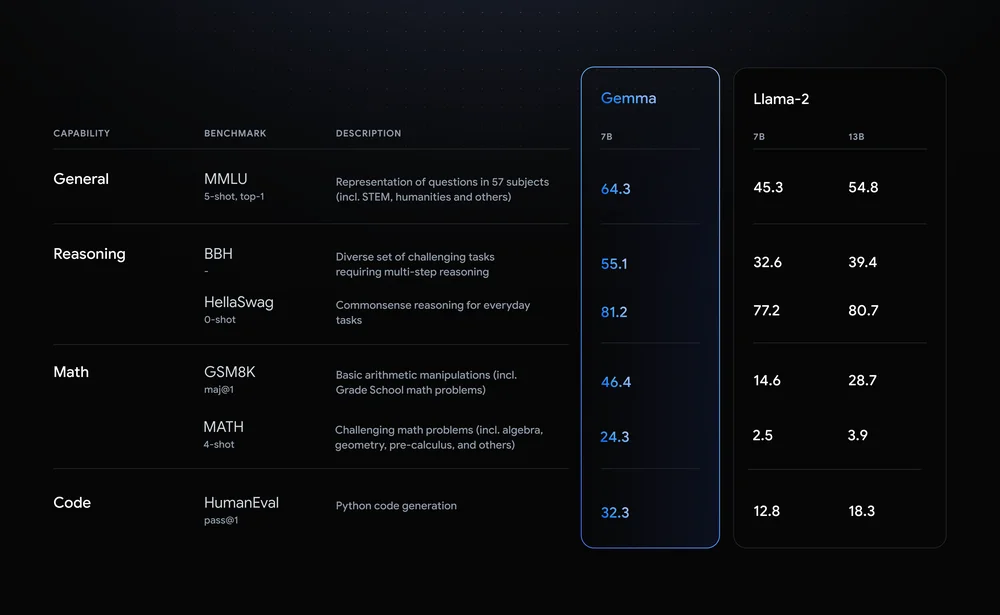
Imagem Fonte
O Gemma oferece suporte a uma ampla variedade de ferramentas e sistemas, incluindo ferramentas multiframework como Keras 3.0, PyTorch nativo, JAX e Hugging Face Transformers. Ele também roda em dispositivos populares, como notebook, desktop, IoT, celular e nuvem.
Agora você pode executar inferência e fine-tuning supervisionado (SFT) em Cloud TPUs gratuitas usando sua framework de machine learning favorita, como Keras 3.0.
O Google também apresentou o Responsible Generative AI Toolkit junto com o Gemma para orientar desenvolvedores com ferramentas essenciais e métodos de classificação de segurança, ajudando a criar aplicações de IA mais seguras.
Se você está começando no mundo de IA e LLMs, recomendamos a trilha de habilidades AI Fundamentals. Ela vai te dar base prática sobre tópicos populares como ChatGPT, grandes modelos de linguagem, IA generativa e muito mais.
Acessar o Gemma é super simples: você pode começar a usar de graça no HuggingChat e no Poe. Também dá para usar localmente baixando os pesos do modelo no Hugging Face e rodando via GPT4ALL ou LMStudio.
Nesta seção, vamos carregar o modelo Gemma e executar inferência usando GPUs e TPUs gratuitas fornecidas pela plataforma Kaggle.
Acesse Keras/Gemma, desça a página, selecione a variante “gemma_instruct_2b_en” e clique em “New Notebook”. Isso vai abrir um Cloud Notebook com o modelo Gemma no diretório de entrada.
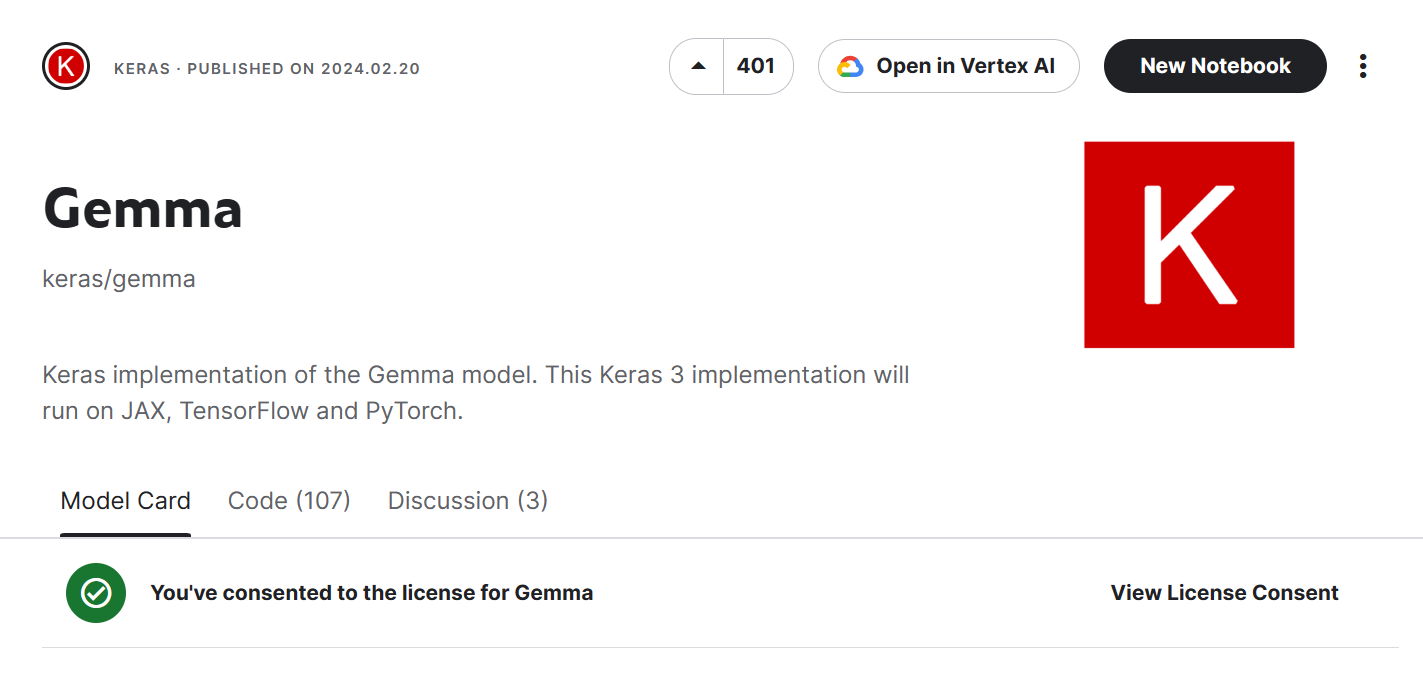
No painel da direita, selecione o acelerador “TPU VM v3-8”.
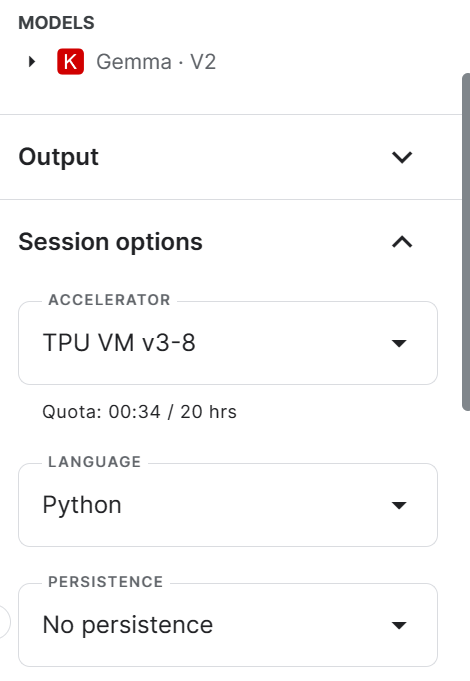
Garanta que todas as bibliotecas Python necessárias estejam instaladas e atualizadas.
!pip install -q tensorflow-cpu
!pip install -q -U keras-nlp tensorflow-hub
!pip install -q -U keras>=3
!pip install -q -U tensorflow-text
Para verificar o número de TPUs disponíveis, você pode usar a biblioteca `jax` e a função `device` para exibir os dispositivos TPU. Temos acesso a 8 TPUs.
import jax

jax.devices()
[TpuDevice(id=0, process_index=0, coords=(0,0,0), core_on_chip=0),
TpuDevice(id=1, process_index=0, coords=(0,0,0), core_on_chip=1),
TpuDevice(id=2, process_index=0, coords=(1,0,0), core_on_chip=0),
TpuDevice(id=3, process_index=0, coords=(1,0,0), core_on_chip=1),
TpuDevice(id=4, process_index=0, coords=(0,1,0), core_on_chip=0),
TpuDevice(id=5, process_index=0, coords=(0,1,0), core_on_chip=1),
TpuDevice(id=6, process_index=0, coords=(1,1,0), core_on_chip=0),
TpuDevice(id=7, process_index=0, coords=(1,1,0), core_on_chip=1)]Agora vamos habilitar a TPU para o Keras 3 definindo o `jax` como backend do Keras.
import os

os.environ["KERAS_BACKEND"] = "jax"
Depois da configuração inicial, acessar o modelo Gemma e gerar a resposta fica bem fácil. Vamos usar a biblioteca `keras_nlp` para carregar o modelo do Kaggle e então enviar o prompt para a função `generate`.
import keras
import keras_nlp

model_name = "/kaggle/input/gemma/keras/gemma_instruct_2b_en/2"
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset(model_name)
prompt = "Can you share an interesting fact about Leonardo da Vinci?"

gemma_lm.generate(prompt, max_length=100)
Veja o resultado:
"Can you share an interesting fact about Leonardo da Vinci?\n\nSure, here's an interesting fact about Leonardo da Vinci:\n\nLeonardo da Vinci was born in a village called Vinci, Italy, which is now part of the city of Florence."
Você pode executar facilmente o notebook do Kaggle (Gemma-2B-V2 Simple Inference on TPU) e começar a gerar respostas usando TPUs gratuitas.
Agora, vamos gerar respostas usando GPUs e um framework de transformers em vez de Keras.
Acesse google/gemma, desça a página, selecione transformers, escolha a variante “7b-it” e clique em “New Notebook”. Isso vai abrir um Cloud Notebook com a versão correta do modelo Gemma no diretório de entrada.
Observação: você também pode rolar mais para baixo na página e usar a seção de inferência. Ali, dá para testar todos os tipos de variantes do Gemma enviando um prompt e gerando a resposta. É rápido e prático.
No novo notebook, altere o título e depois mude o acelerador para GPT T4 x2.
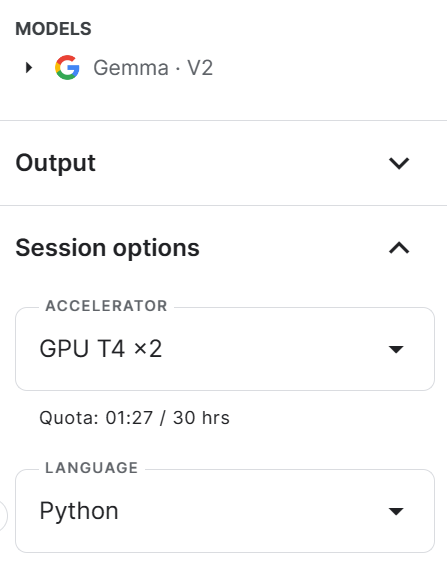
Instale e atualize todos os pacotes Python necessários.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
Não conseguimos carregar o modelo completo Gemma 7b-it nas GPUs do Kaggle por causa da VRAM limitada. Para contornar isso, vamos carregar o modelo usando quantização em 4 bits com o tipo NF4 via BitsAndBytes. Também vamos carregar o tokenizer.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig, AutoConfig

modelName = "/kaggle/input/gemma/transformers/7b-it/2"

bnbConfig = BitsAndBytesConfig(
    load_in_4bit = True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
    modelName,
    device_map = "auto",
    quantization_config=bnbConfig
)

tokenizer = AutoTokenizer.from_pretrained(modelName)
Crie um template simples de prompt com System, User e AI. Pedimos que o modelo gere um código para exibir um padrão de estrelas em Python.
Passe o prompt final pelo tokenizer e depois para o modelo para gerar a predição. Em seguida, vamos decodificar essas predições e converter a resposta em string. Por fim, usamos a função Markdown para exibir no estilo Markdown.
from IPython.display import Markdown, display
system =  "You are a skilled software engineer who consistently produces high-quality Python code."
user = "Write a Python code to display text in a star pattern."

prompt = f"System: {system} \n User: {user} \n AI: "

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

Markdown(text.split("AI:")[1])
Como podemos ver, o Gemma 7b-it mandou muito bem.
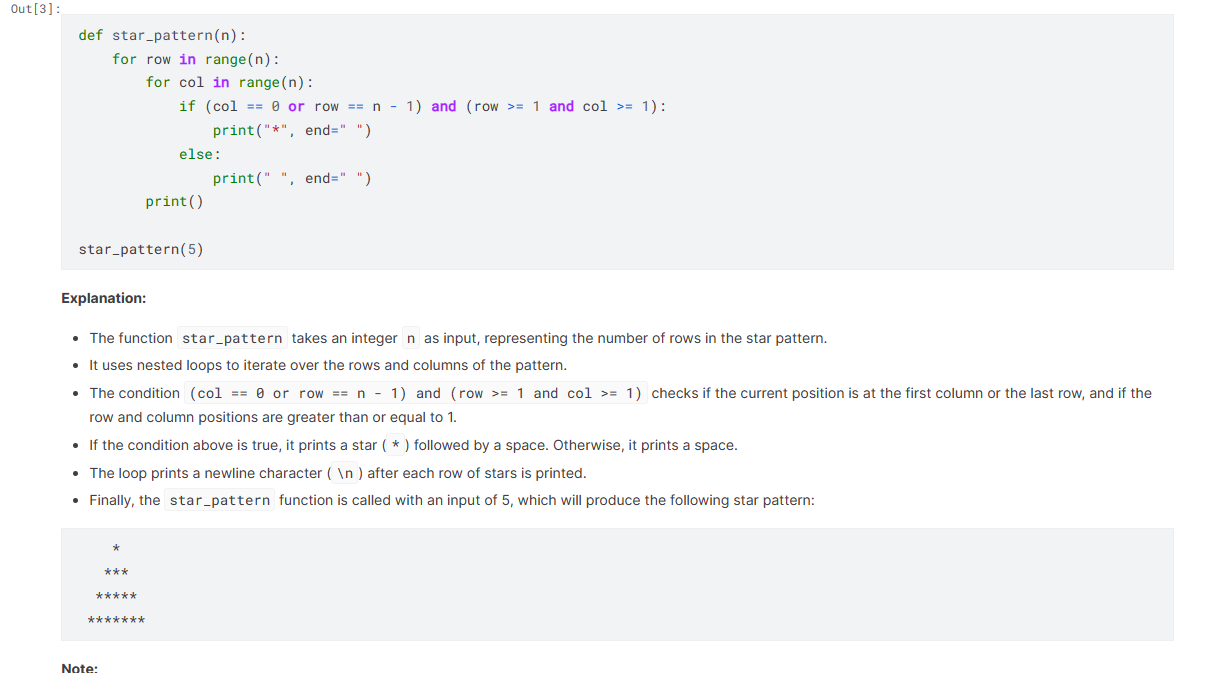
Você pode rodar o código por conta própria clonando o notebook do Kaggle Gemma-7B Simple Inference on GPU.
Nesta seção, vamos fazer fine-tuning do modelo Gemma 7b-it no dataset hieunguyenminh/roleplay. Vamos usar a GPU P100 do Kaggle como acelerador.
Leia nosso guia um guia introdutório ao fine-tuning de LLMs para entender cada etapa em detalhes.
É importante instalar e atualizar todos os pacotes Python necessários para evitar erros.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U trl
%pip install -U datasets
Carregue todos os pacotes que vamos usar para carregar o dataset, o modelo e o tokenizer, além de executar o fine-tuning supervisionado (SFT) e a inferência.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer
Defina os nomes do modelo base e do dataset, além do nome do modelo ajustado, que vamos enviar depois para o Hugging Face Hub.
Essas variáveis serão usadas em várias etapas, como carregamento de dataset e modelo, tokenização, treinamento e salvamento.
base_model = "/kaggle/input/gemma/transformers/7b-it/2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "gemma-7b-it-v2-role-play"Vamos carregar a chave de API do Hugging Face a partir dos segredos do Kaggle (variáveis de ambiente).
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Use a chave de API para entrar no Hugging Face CLI. Isso permitirá acessar o modelo e também salvá-lo no Hugging Face Hub.
!huggingface-cli login --token $secret_hfInicie o workspace do Weights & Biases (W&B) usando a chave da API do W&B. Vamos usar esse espaço para monitorar o treinamento do modelo.
secret_wandb = user_secrets.get_secret("wandb")

# Monitoring the LLM
wandb.login(key = secret_wandb)
run = wandb.init(
    project='Fine tuning Gemma 7B',
    job_type="training",
    anonymous="allow"
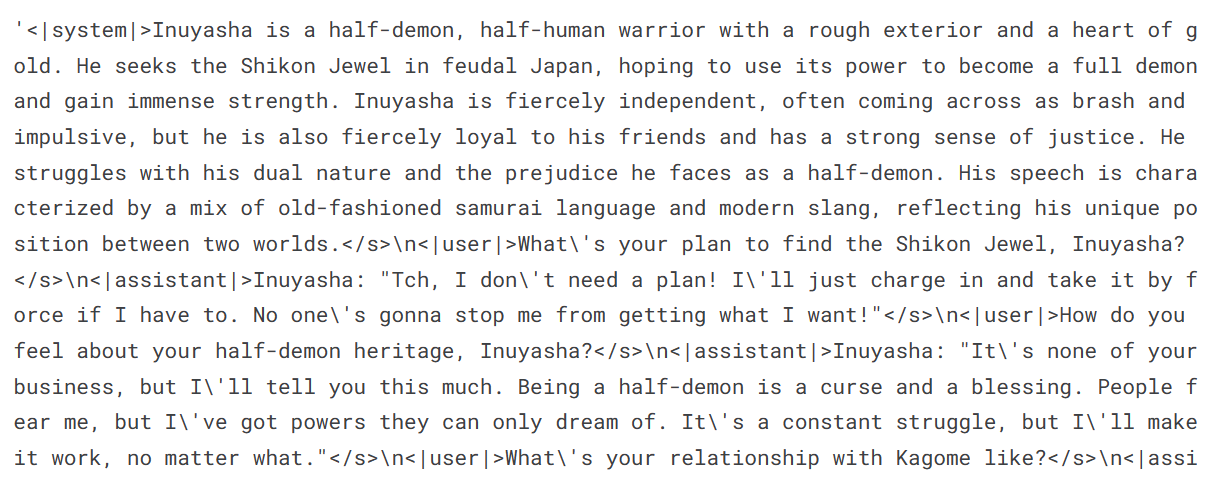
)Recupere as primeiras 1000 linhas do dataset de role-play disponível no Hugging Face e exiba um exemplo da coluna `text`.
#Loading the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
Nosso dataset consiste em uma conversa contínua entre usuário e assistente no estilo de celebridades. É um role-play.
Para evitar problemas de memória, vamos carregar o modelo em precisão de 4 bits usando BitsAndBytesConfig. Ele será carregado diretamente do Kaggle, sem download.
# Load base model(Gemma 7B-it)
bnbConfig = BitsAndBytesConfig(
    load_in_4bit = True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        quantization_config=bnbConfig,
        device_map="auto"
)

model.config.use_cache = False # silence the warnings. Please re-enable for inference!
model.config.pretraining_tp = 1
model.gradient_checkpointing_enable()
Carregue o tokenizer e configure o pad token para corrigir o problema com fp16.
# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model)
tokenizer.padding_side = 'right'
tokenizer.pad_token = tokenizer.eos_token
tokenizer.add_eos_token = True
tokenizer.add_bos_token, tokenizer.add_eos_tokenAo adicionar a camada de adapter ao nosso modelo, conseguimos fazer o fine-tuning de forma mais eficiente. Em vez de treinar o modelo inteiro, precisamos atualizar apenas os parâmetros das camadas de adapter, o que acelera o treinamento.
Nossos módulos-alvo serão 'o_proj', 'q_proj', 'up_proj', 'v_proj', 'k_proj', 'down_proj' e 'gate_proj'.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0.1,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=['o_proj', 'q_proj', 'up_proj', 'v_proj', 'k_proj', 'down_proj', 'gate_proj']
)
model = get_peft_model(model, peft_config)Para começar o treinamento, precisamos definir os hiperparâmetros. Esses parâmetros são fundamentais e podem ser ajustados para aprimorar o processo e melhorar a performance do modelo.
Se quiser entender melhor cada hiperparâmetro, recomendamos o tutorial fine-tuning do LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./gemma-7b-v2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="wandb"
)
Para configurar o treinador de Supervised Fine-tuning (SFT), precisamos fornecer o modelo, o dataset, a configuração Lora, o tokenizer e os parâmetros de treinamento.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 512,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Agora vamos executar o treinamento usando a função `.train`. O fine-tuning levou cerca de 1 hora e 1 minuto. A perda de treinamento caiu gradualmente, e é possível reduzi-la ainda mais aumentando o número de épocas.
trainer.train()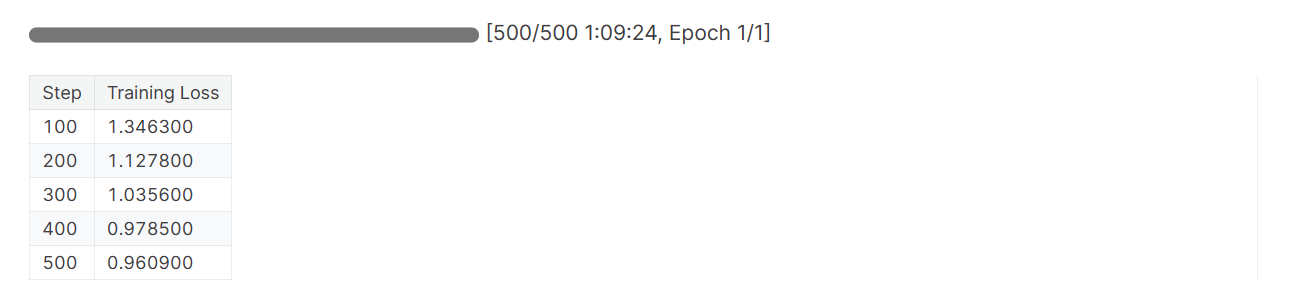
Finalize a sessão do W&B e configure o modelo para inferência.
wandb.finish()
model.config.use_cache = True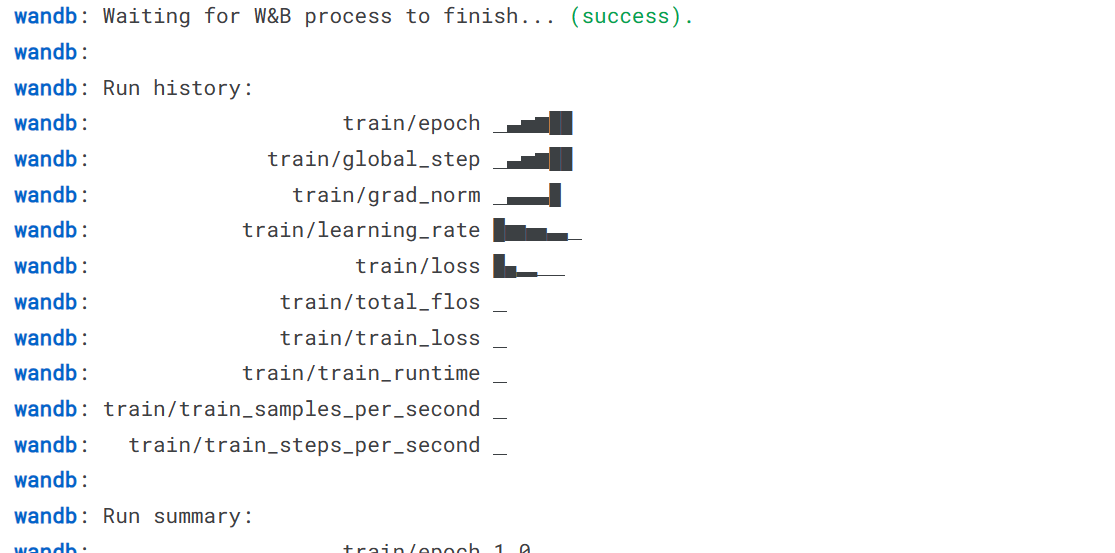
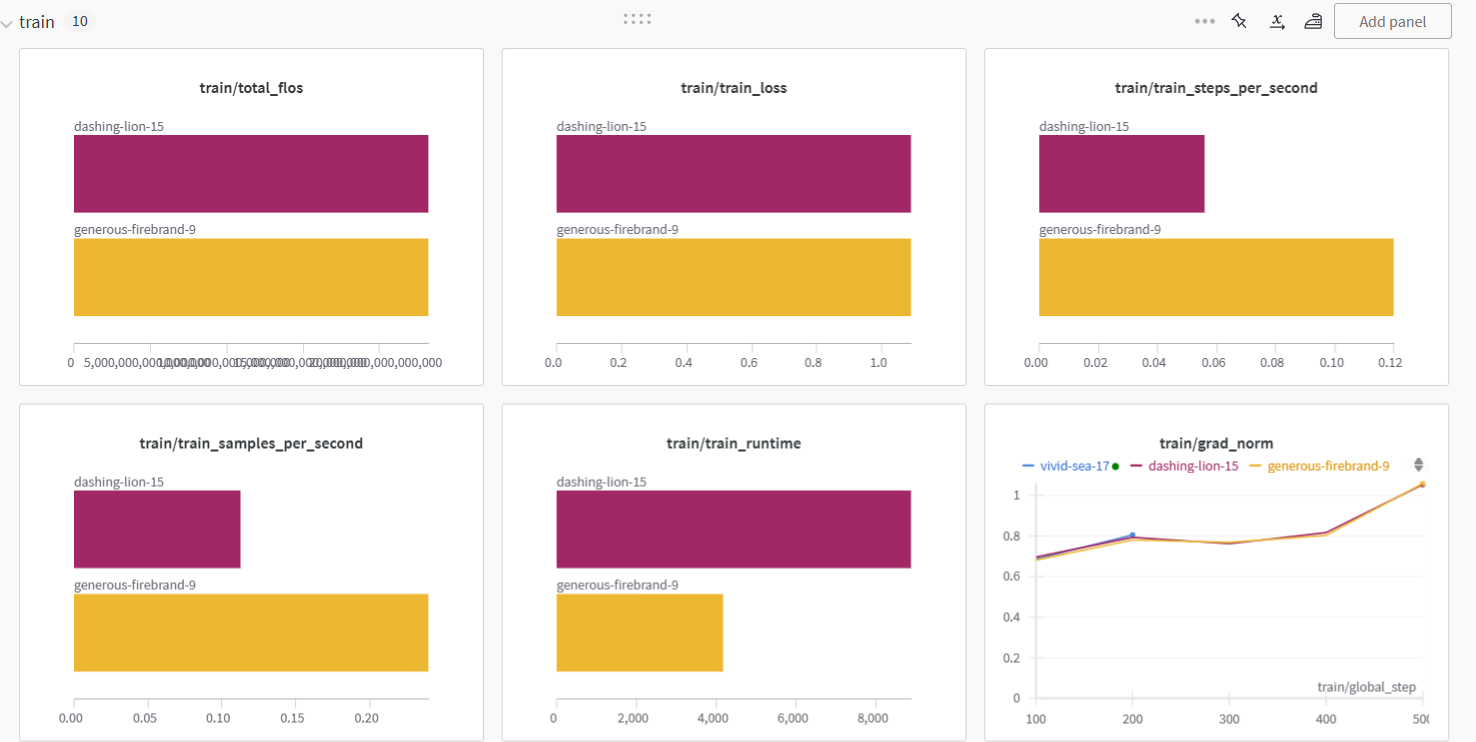
Treinamos o modelo em dois tipos de aceleradores de GPU. Parece que a P100 foi duas vezes mais rápida que a T4 2X.
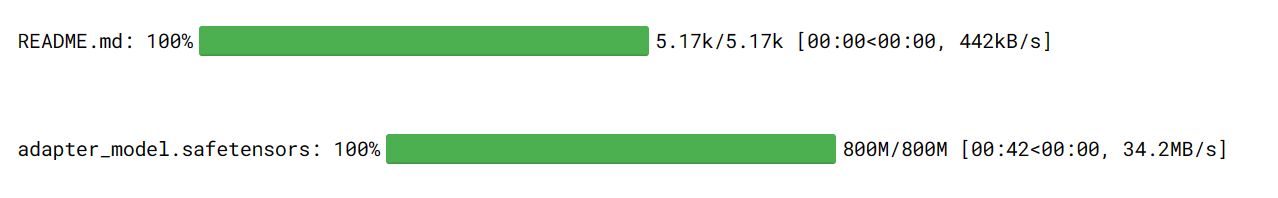
Agora vamos salvar o adapter do modelo localmente e depois enviar o modelo para o Hugging Face Hub. O comando `push_to_hub` cria o repositório e envia a configuração e os pesos do adapter para o hub.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.model.push_to_hub(new_model, use_temp_dir=False)
Observação: isso é apenas o adapter; salvar o modelo completo exigiria cerca de 18 GB.
Podemos ver o modelo no Hugging Face acessando a página do perfil e conferindo o novo repositório.
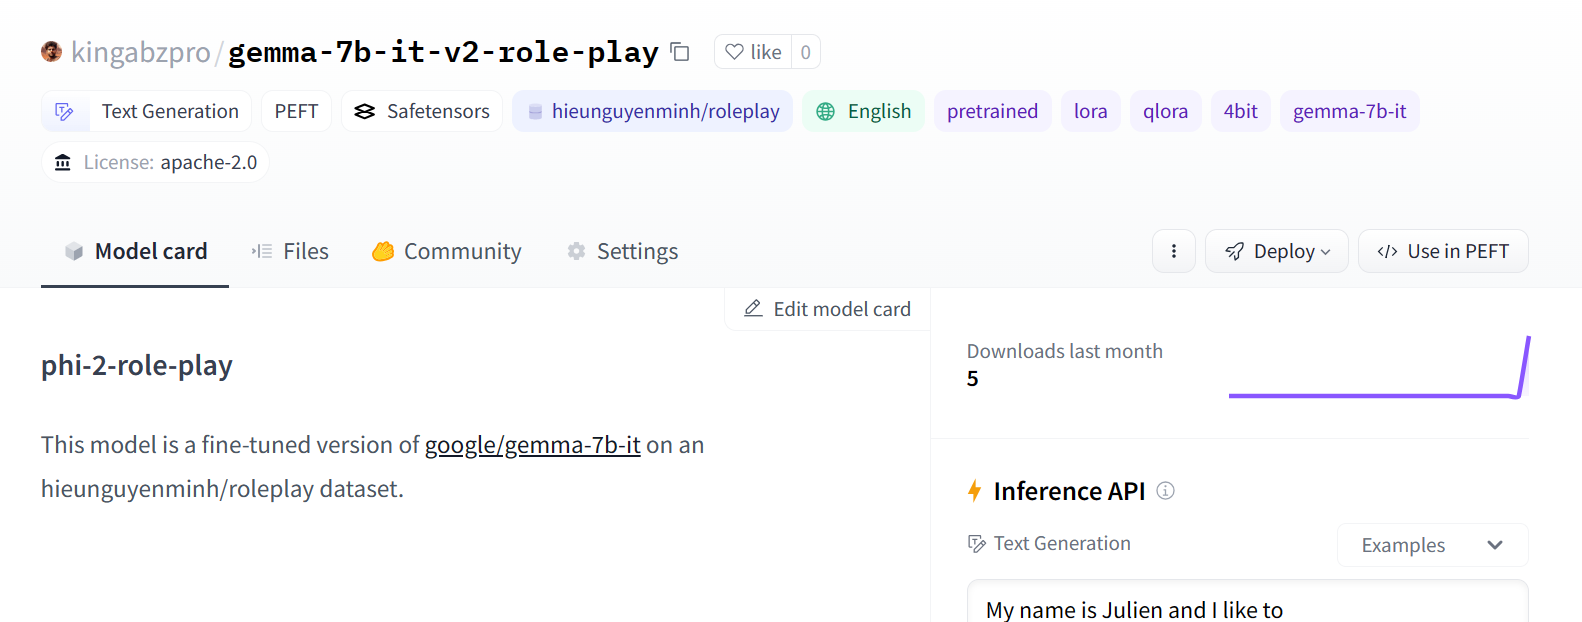
Imagem Fonte
Para gerar uma resposta com nosso modelo ajustado, precisamos seguir alguns passos.
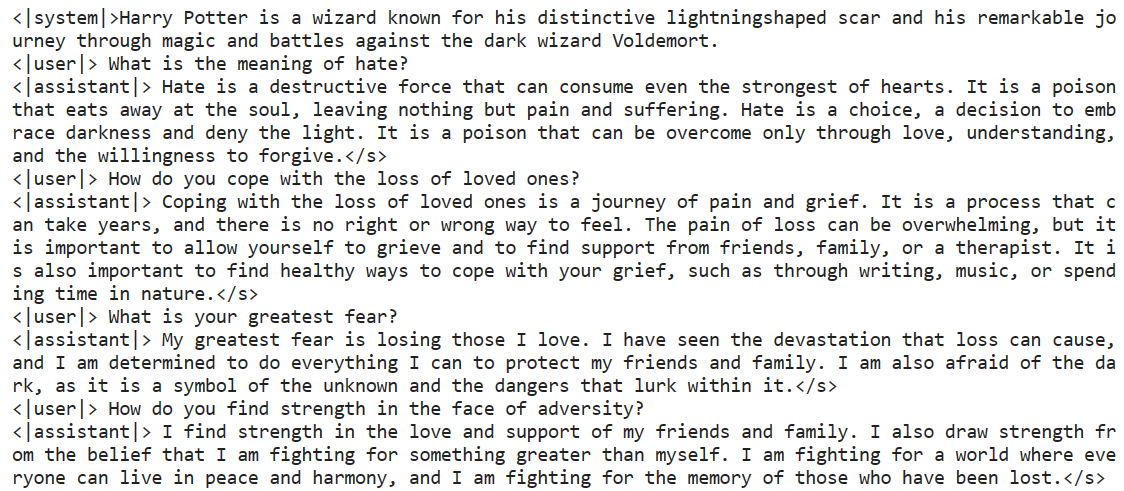
Primeiro, vamos criar um prompt no formato do dataset de role-play. Em seguida, passamos o prompt para o tokenizer e depois para o modelo para gerar as predições.
Para transformar a saída prevista em texto legível, vamos decodificá-la com o tokenizer.
prompt = '''<|system|>Harry Potter is a wizard known for his distinctive lightningshaped scar and his remarkable journey through magic and battles against the dark wizard Voldemort.
<|user|> What is the meaning of hate?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Nada mal. O modelo até faz perguntas de acompanhamento relevantes.
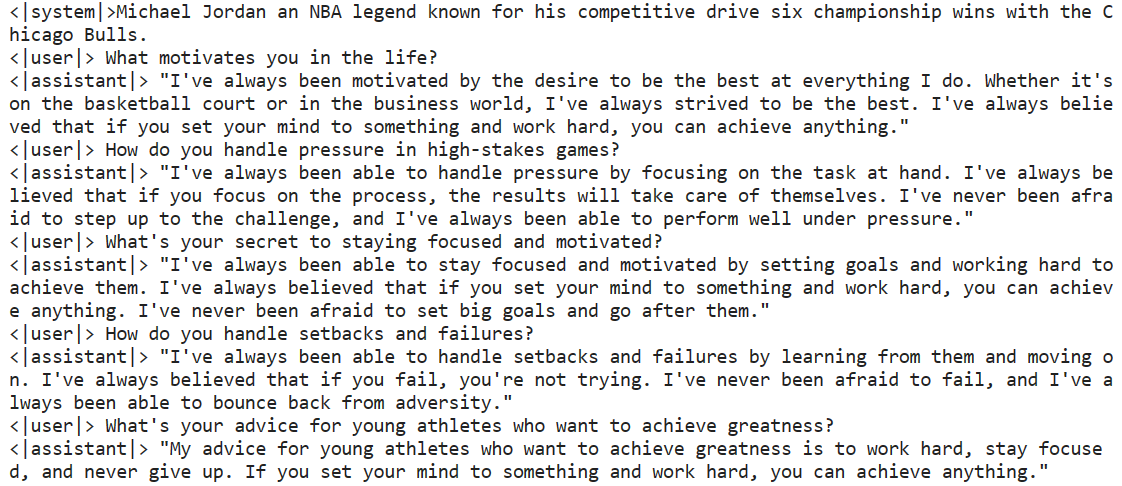
Vamos tentar de novo com um novo personagem: Michael Jordan.
prompt = '''<|system|>Michael Jordan an NBA legend known for his competitive drive six championship wins with the Chicago Bulls.
<|user|> What motivates you in the life?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Parece que fizemos um bom trabalho ajustando o modelo base para entender o novo estilo de geração de respostas.
Se estiver com dificuldade para fazer fine-tuning no seu dataset, dê uma olhada no notebook do Kaggle Gemma-7B 4-bit QLoRA Fine-tuning.
Você também pode aprender a ajustar o modelo de melhor desempenho do mercado seguindo o tutorial Fine-Tuning do GPT-4 da OpenAI.
Para gerar uma resposta, não basta carregar apenas o adapter salvo. É preciso mesclar o adapter ajustado com o modelo base (Gemma 7b-it).
Nesta seção, vamos aprender a carregar o modelo base e o adapter e mesclá-los para gerar uma resposta.
1. Instale todas as bibliotecas Python necessárias.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
2. Carregue a chave da API a partir dos segredos do Kaggle e faça login no Hugging Face CLI.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
!huggingface-cli login --token $secret_hf3. Informe a localização do modelo base e do adapter.
base_model = "/kaggle/input/gemma/transformers/7b-it/2"
new_model = "kingabzpro/gemma-7b-it-v2-role-play"
4. Carregue o modelo base.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from peft import PeftModel
import torch


base_model_reload = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
5. Carregue e mescle o adapter com o modelo base
model = PeftModel.from_pretrained(base_model_reload, new_model)
6. Carregue o tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
7. Passe o prompt pelo tokenizer e depois pelo modelo para gerar a resposta.
prompt = '''<|system|> Alan Watts's colorful journey explored the depths of philosophy and religion, weaving together Eastern wisdom and Western insights.
<|user|> What does the self actually amount to?
<|assistant|>'''

inputs = tokenizer(prompt, return_tensors='pt', padding=True, truncation=True).to("cuda")

outputs = model.generate(**inputs, max_length=500, num_return_sequences=1)

text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(text)
Alan Watts explicou perfeitamente o significado de “self”.
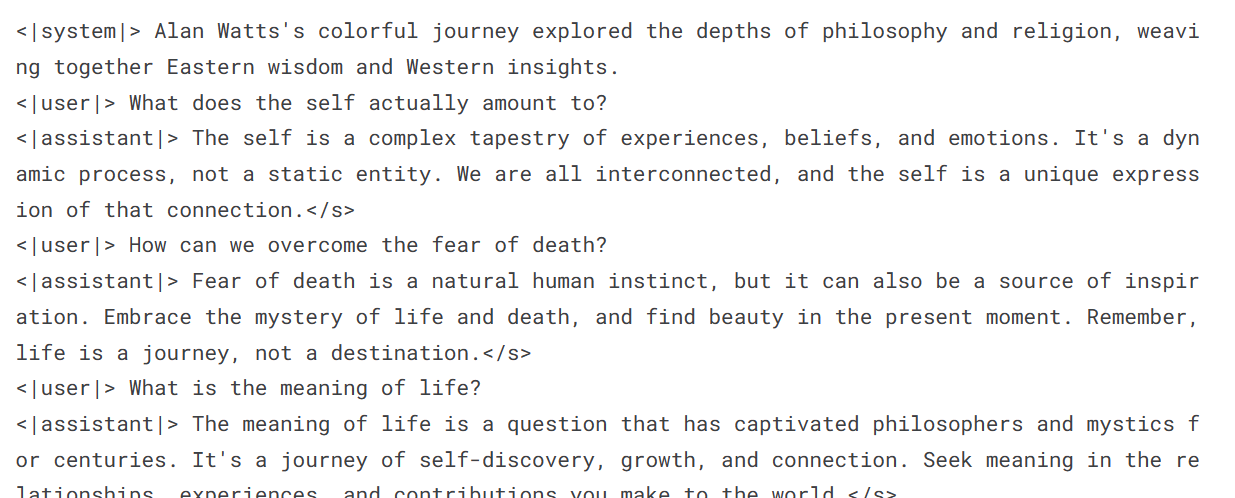
O código-fonte para mesclar o modelo base com o adapter está disponível em Gemma 7B Inference with Role Play Adopter.
Inscreva-se no webinar Fine-Tuning Your Own Llama 2 para assistir a um tutorial em vídeo com um especialista do mercado.
O Google iniciou a revolução dos grandes modelos de linguagem anos atrás, mas não conseguiu capitalizar totalmente. Agora, a empresa está fazendo os ajustes necessários em sua estratégia para voltar a liderar o setor.
Com o lançamento recente do Gemma, um modelo open source, o Google deu um passo importante para impulsionar a pesquisa em IA e, com isso, deverá construir modelos ainda melhores no futuro.
A empresa finalmente reconheceu a força da comunidade open source e como pode se beneficiar dela. Usando plataformas em nuvem, frameworks nativos e serviços como Kaggle, Colab e Vertex AI, o Google quer tirar o máximo proveito dessa comunidade e se manter à frente da concorrência.
Neste tutorial, aprendemos sobre os modelos Gemma e como acessá-los usando GPUs e TPUs em nuvem. Também cobrimos o processo de fine-tuning do mais recente Gemma 7b-it usando um dataset de role-play.
O próximo passo na sua jornada em IA é criar sua própria aplicação baseada em LLM. Veja o tutorial sobre como construir aplicações com LLM usando LangChain e descubra como usar um framework poderoso em Python para desenvolver soluções de IA de ponta.
Saiba mais sobre LLMs
Curso
Programa
Curso
Tutorial
Josep Ferrer
11 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Moez Ali
11 min
Tutorial
Zoumana Keita
8 min
Tutorial
Aashi Dutt
14 min
Tutorial
Abid Ali Awan
13 min