Curso
Conceptos de grandes modelos lingüísticos (LLM)
2 h
110K
Este artículo es un tutorial completo sobre cómo afinar grandes modelos de lenguaje empleando técnicas avanzadas. Veremos ejemplos con Tensor Processing Units, una técnica llamada LoRA y computación distribuida, todo para ganar velocidad y eficiencia. Para ilustrar las técnicas, accederemos y afinaremos los modelos Gemma, una nueva familia de LLMs ligeros y de última generación creada por Google.
Al final del tutorial, tendrás las habilidades para afinar y ejecutar inferencias en cualquier LLM usando las TPUs disponibles en Google Cloud. Para llegar ahí, cubriremos estos temas, en este orden:
Usar Gemma con TPUs: cómo configurar un entorno en Kaggle para usar TPUs.
Configuración del modelo e inferencia: ejecutaremos Gemma con la librería Keras en Python.
Ajuste fino (fine-tuning): afinaremos el modelo Gemma con la técnica LoRA.
Entrenamiento distribuido: realizaremos ajuste fino distribuido para ganar eficiencia en el entrenamiento.
Si estás empezando con IA y LLMs, te recomendamos el itinerario de habilidades AI Fundamentals para familiarizarte con los términos que usamos en este tutorial.
¡Vamos a ello!
 Logotipo de Google Gemma
El modelo Gemma de Google forma parte de una familia de LLMs abiertos y ligeros desarrollados por Google y presentados en 2024. Gemma se creó con la misma investigación y tecnología que los modelos Google Gemini y, como Gemini, es compatible con los principales frameworks de machine learning como Keras y Pytorch. Está disponible en dos tamaños, con 2B o 7B parámetros.
Mientras que Gemini está pensado principalmente para usuarios finales a través de aplicaciones y APIs, Gemma es open source para que los desarrolladores puedan modificarlo e integrarlo libremente. Además, los modelos Gemma son más pequeños, por lo que resultan más portables y rentables.
 Imágenes de CPUs, GPUs y TPUs por Freepik y Flaticon
Comparemos las distintas opciones de hardware para machine learning para poner contexto. El hardware se clasifica en tipos con funciones específicas de procesamiento y cómputo.
Unidades centrales de procesamiento: las CPUs ejecutan los sistemas operativos en casi todos los dispositivos. Procesan tareas de forma secuencial.
Unidades de procesamiento gráfico: las GPUs pueden procesar múltiples tareas a la vez, ideales para renderizado gráfico.
Unidades de procesamiento tensorial: las TPUs son procesadores especializados desarrollados por Google para machine learning. Están diseñadas para realizar rápidamente los cálculos matriciales críticos para entrenar y ejecutar redes neuronales.
La última categoría, las TPUs, es clave en este tutorial. Son más rápidas que las GPUs para entrenar e inferir con redes neuronales profundas y, además, consumen menos energía. Como contrapartida, su ecosistema es menos maduro, con menos herramientas y frameworks disponibles. Entre los frameworks compatibles están Google Cloud Platform, Colab y Kaggle.
Componente | Uso principal | Aplicaciones de ML | Ventajas | Disponibilidad |
CPUs | Tareas generales | Modelos sencillos | Más baratas, menor consumo | Muy disponibles |
GPUs | Renderizado gráfico | Deep learning, procesamiento de grandes volúmenes | Rápidas en cálculos complejos | Disponibles comercialmente |
TPUs | Machine learning | Redes profundas, operaciones matriciales de alta velocidad | Lo más rápido para ML, eficientes en energía | Solo disponibles en Google Cloud, Colab y Kaggle |
Tabla comparativa de hardware para machine learning
Los modelos Gemma están diseñados para escalar y ser eficientes con configuraciones de cómputo distribuido, lo que mejora notablemente su rendimiento y velocidad, especialmente con grandes volúmenes de datos y arquitecturas complejas.
La librería Keras encaja muy bien aquí porque admite entrenamiento distribuido de modelos Gemma, aprovechando su implementación multibackend que incluye TensorFlow y PyTorch.
En esta sección configuraremos nuestro notebook de Kaggle para usar TPUs, asegurando que todas las librerías y dependencias estén listas. Luego cargaremos el modelo Gemma 2B o 7B con el paquete keras-nlp. Por último, lo pondremos en producción para realizar tareas, aprovechando la potencia de las TPUs para procesar y generar respuestas con eficiencia.
Para preparar el entorno, integraremos la versión de Gemma para Keras y cambiaremos el acelerador de cómputo a TPU para un mejor rendimiento. Instalaremos paquetes esenciales como keras-nlp, configuraremos Keras para usar TensorFlow como backend y optimizaremos la asignación de memoria de la TPU para un entrenamiento y ejecución fluidos.
Para preparar el entorno, añadiremos la implementación en Keras del modelo Gemma. En concreto, incorporaremos la versión compatible con Keras para integrarla sin problemas con las APIs de TensorFlow.
Para añadir la implementación en Keras, sigue estos pasos:
Crea un notebook nuevo en Kaggle.
Ve a la sección "Input" en el panel derecho.
Haz clic en “+ Add Input” para añadir la implementación en Keras del modelo Gemma.
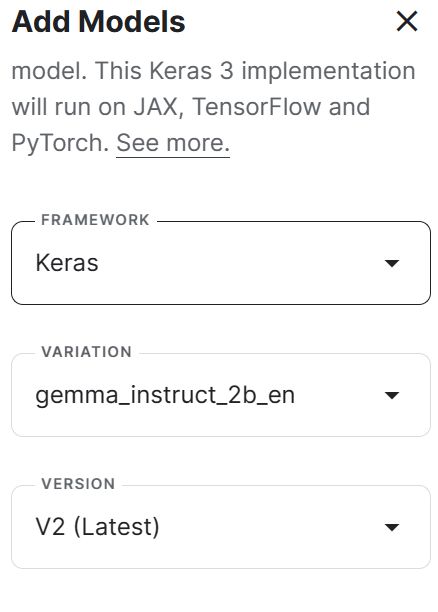 Añadir la implementación en Keras al modelo Gemma
A continuación, cambiaremos el acelerador a TPU; es decir, en los ajustes del notebook seleccionaremos TPU para aprovechar su potencia de cómputo en entrenamiento e inferencia.
Para cambiar el acelerador, sigue estos pasos. Es normal que el entorno tarde unos minutos en recargarse.
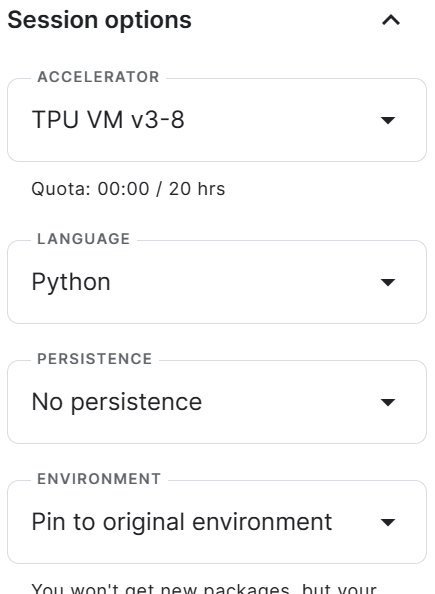 Configurar TPU como acelerador
Ahora instalamos los paquetes actualizados de Python que usaremos para el ajuste fino y la inferencia, incluidos TensorFlow y keras-nlp.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1Configuramos Keras con JAX como backend para acceder sin fricciones a las TPUs. También puedes probar con TensorFlow o PyTorch.
Por último, preasignamos la memoria de la TPU para optimizar el rendimiento y evitar problemas en tiempo de ejecución. Aquí reservamos el 100% de la memoria total de la TPU para evitar la fragmentación de memoria en el backend JAX.
import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"]="1.00"Cargamos los paquetes de Python necesarios para la inferencia del modelo.
import kerasimport keras_nlpDespués cargamos el modelo y mostramos el resumen.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_instruct_2b_en")gemma_lm.summary()Cargamos correctamente el tokenizador y el modelo con un solo comando. Es notable, porque incluso el modelo Gemma más pequeño tiene 2,5 mil millones de parámetros y un tamaño de 9,34 GB.
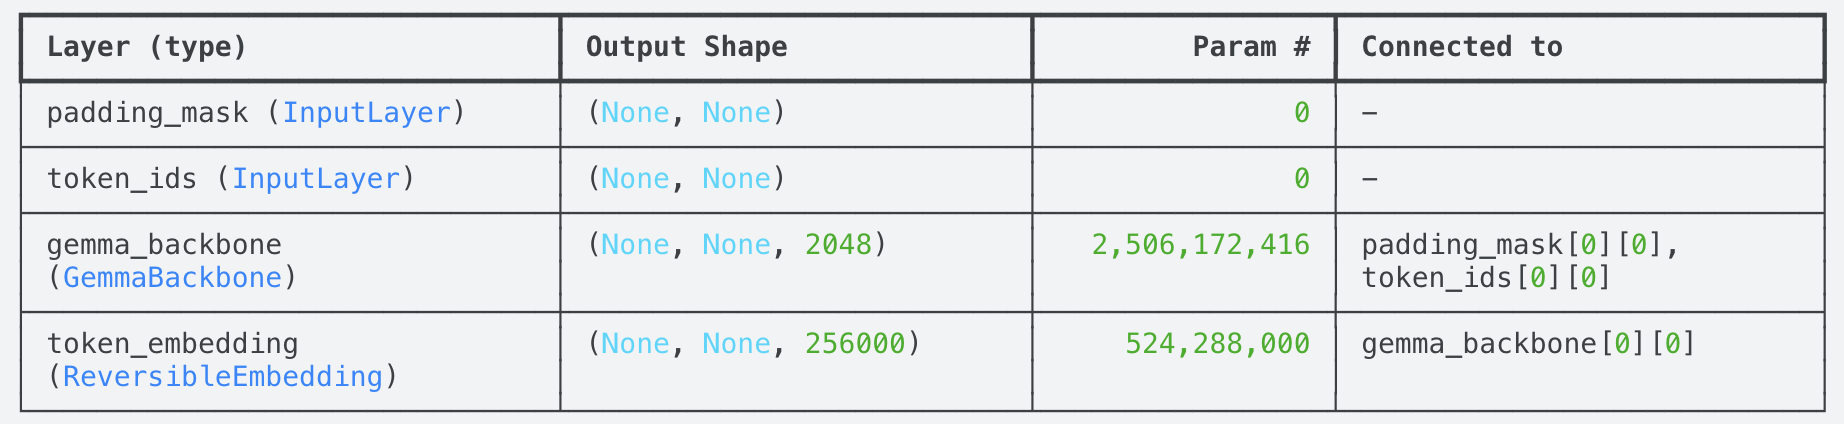 Resumen del modelo Gemma
Puede que tengas que esperar unos minutos para ejecutar el notebook y disfrutar del rendimiento ultrarrápido. Las TPUs tienen mucha demanda. Si lo ejecutas por la noche, quizá no tengas que esperar.
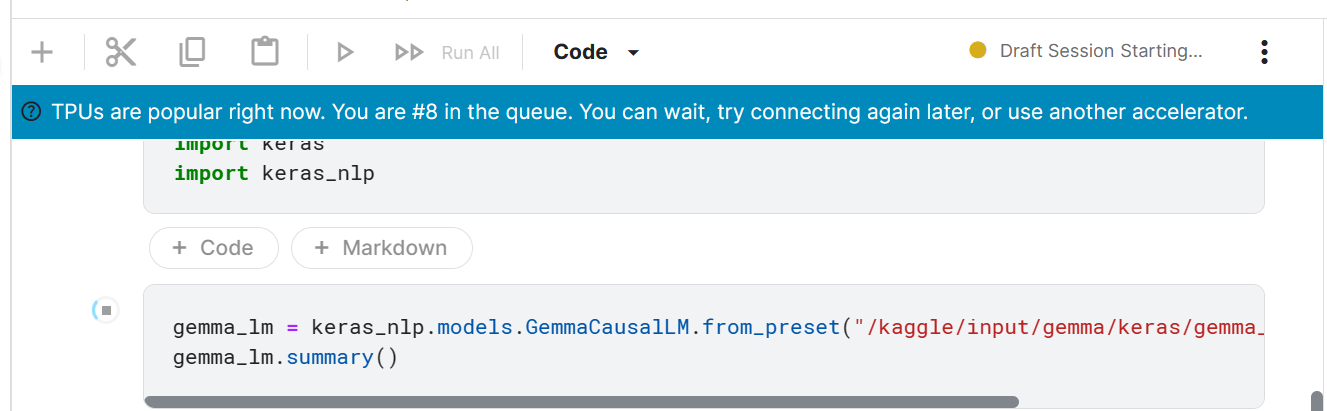 Cola de acceso a TPU
Ejecutar inferencia es usar el modelo para generar salidas a partir de entradas nuevas. En nuestro caso, daremos entradas en texto usando la función .generate(). Recibiremos la respuesta al momento.
print(gemma_lm.generate("What is DataCamp?", max_length=30))What is DataCamp?DataCamp is a leading online data science education platform that empowers individuals and organizations to build data-driven careers. TheyTambién podemos probar inferencia por lotes: daremos varios prompts para generar varias respuestas. La salida llega como una lista.
print(gemma_lm.generate(["How far is the Sun from earth", "What is the Sun made of?"], max_length=30))['How far is the Sun from earth?\n\nThe Sun is about 149.6 million kilometers (93 million miles) away from', 'What is the Sun made of?\n\nThe Sun is primarily composed of hydrogen and helium. Hydrogen makes up about 73.4% of']Ahora crearemos una plantilla con instrucciones y respuestas para guiar al modelo. Puedes añadir un system prompt o cualquier orden inicial para modificar la respuesta generada.
Usaremos la función .format() para rellenar la plantilla con los argumentos del usuario. Como resultado, obtendremos una lista de pasos para empezar con Python.
template = "Instruction:\n{instruction}\n\nResponse:\n{response}"prompt = template.format( instruction="How do I start learning Python?", response="",)print(gemma_lm.generate(prompt, max_length=250))Instruction:How do I start learning Python?Response:**Step 1: Choose a learning path*** **Online Courses:** * DataCamp * Codecademy * Coursera * edX * Udemy* **Books:** * "Automate the Boring Stuff with Python" by Al Sweigart * "Python Crash Course" by Eric Matthes * "Head First Python" by Kathy Sierra and Bert Bates* **Video Tutorials.........Si tienes problemas para cargar el modelo y generar una respuesta usando TPUs, consulta este notebook de Kaggle: Accessing Gemma-instruct-2b-en using TPUs.
Si ya te sientes cómodo con Gemma, aprende a mejorarlo con instrucciones personalizadas en nuestro tutorial Fine Tuning Google Gemma: Enhancing LLMs with Customized Instructions.
Ahora aprenderemos a afinar el modelo Gemma con un dataset público llamado OpenHermes. OpenHermes tiene 242.000 filas con dos columnas, una de instrucciones y otra de respuestas, todas generadas con GPT-4.
Como verás, afinar este dataset llevará bastante tiempo incluso con TPUs. Para agilizar, incorporaremos una técnica llamada LoRA.
LoRA (Low-Rank Adaptation) está pensada para hacer más eficiente y accesible el ajuste fino de LLMs. Resuelve los retos del ajuste tradicional, a menudo costoso en cómputo y recursos.
Técnicamente, LoRA congela los pesos preentrenados del modelo e introduce matrices de bajo rango que modifican partes concretas de la arquitectura. Al centrarse en estas matrices, reduce los recursos necesarios y hace viable afinar modelos grandes en hardware menos potente.
Como antes, definiremos el backend de Keras y la preasignación de memoria. También podemos usar la función jax. devices() para comprobar la disponibilidad de dispositivos TPU.
import osimport jaxos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"jax.devices()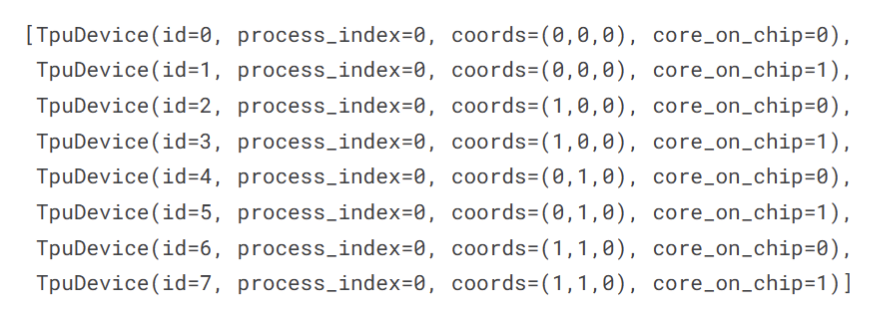
Número de dispositivos de cómputo
Cargamos el modelo y mostramos el resumen. Tenemos 2,5B parámetros entrenables.
import kerasimport keras_nlpgemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_2b_en")gemma_lm.summary()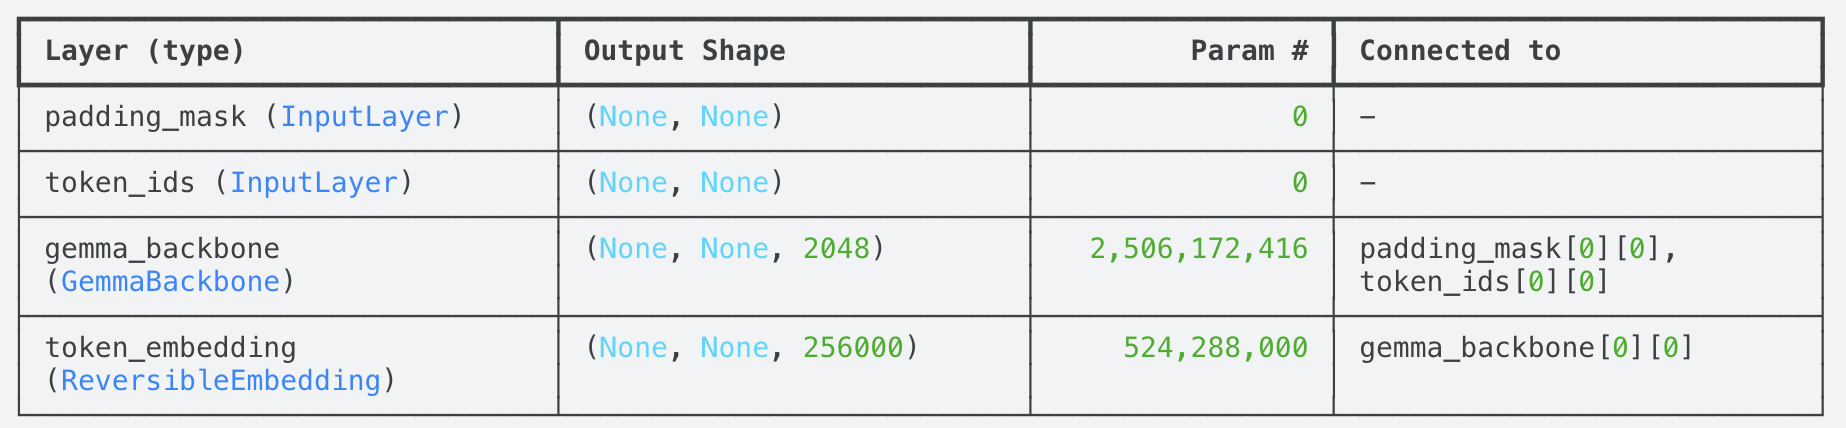 Resumen del modelo Gemma
A continuación cargamos el dataset en el notebook. El proceso es similar al de añadir el modelo. Sigue estos pasos:
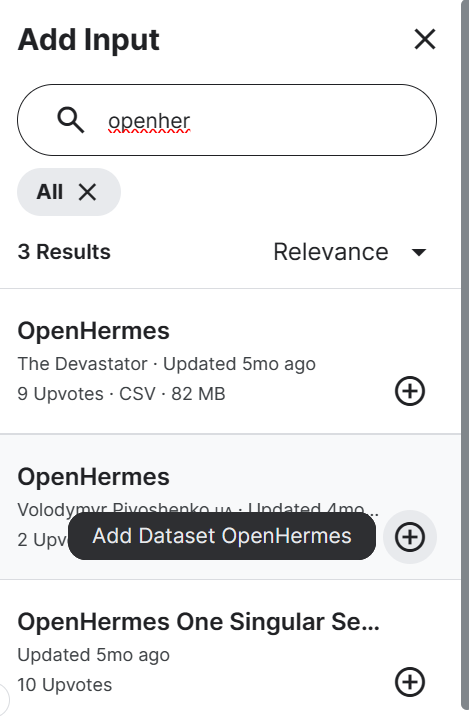
Añadir el dataset OpenHermes
Usamos la librería pandas para leer el dataset y mostrar las 5 primeras filas. Vemos dos columnas: instruction y output.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')df.head()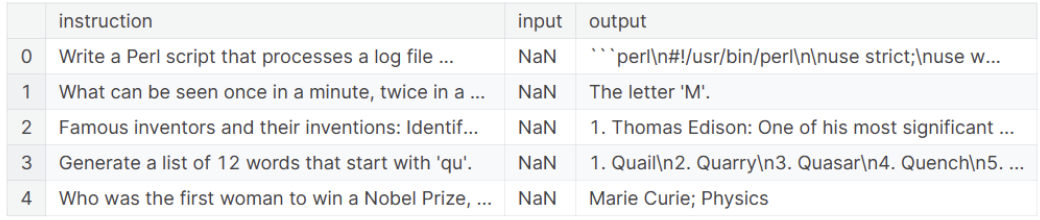
Dataset OpenHermes
Con el modelo y el dataset listos, tenemos que pasar el dataset al modelo. Para ello convertiremos el dataset en una lista de cadenas con el formato de instrucción y respuesta.
Entrenar el dataset completo llevaría casi 23 horas incluso en TPUs. Por eso, seleccionaremos solo las 1.000 primeras muestras para reducir el tiempo de entrenamiento.
template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]data = data[:1000]print(data[0])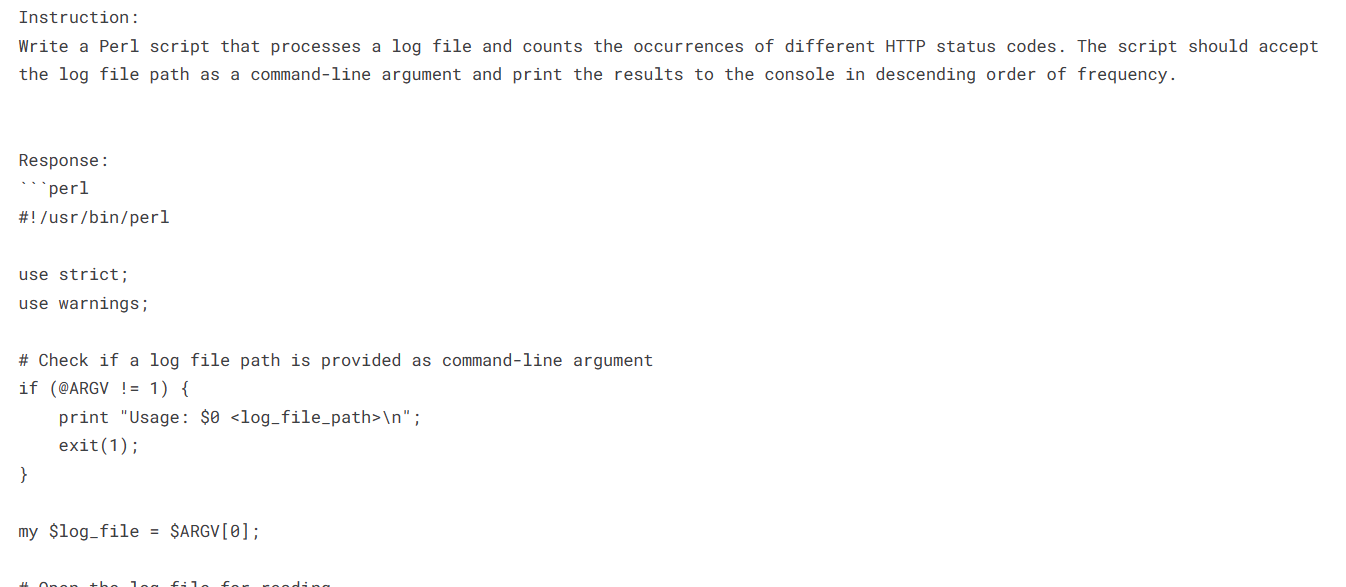
Primera muestra del dataset OpenHermes
Primero crearemos una línea base con la que comparar el éxito de LoRA. Para ello, generaremos la respuesta usando template.format().
Si lees con atención, la salida siguiente muestra que la respuesta base no es muy detallada. Gemma incluso empieza a repetirse tras el final de la primera respuesta. No es un gran resultado, pero ilustra bien la necesidad de afinar el modelo para dar mejores respuestas.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-day Bahamas trip.Response:Day 1:Fly to Nassau, Bahamas.Visit the Atlantis Resort.Day 2:Visit the Exuma Cays.Day 3:Visit the Lucayan National Park.Day 4:Visit the Great Abaco Islands.Day 5:Fly home.Instruction:Plan a 5-dayAhora mejoraremos el modelo con LoRA, que reduce el número de parámetros entrenables para tareas posteriores.
En este ejemplo afinaremos con LoRA rank 4, el rango computacionalmente más eficiente. Si quieres mejorar el rendimiento, prueba rank 8 o 16. Lee la guía Fine-Tuning LLaMA 2 para saber más sobre LoRA y cuantización.
Luego especificaremos optimizador, función de pérdida y métrica de precisión.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()Los parámetros entrenables han caído drásticamente de 2,5 mil millones a 1,3 millones. Y la capa adaptadora ocupa solo 5,2 MB.
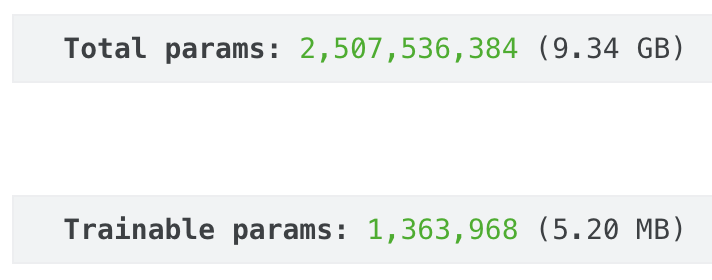
Modelo Gemma: parámetros totales vs. entrenables
Ajustaremos el modelo con nuestros datos. Aquí elegimos 1 época y un tamaño de lote de 1. Puedes mejorar el rendimiento entrenando todo el dataset con al menos 5 épocas.
gemma_lm.fit(data, epochs=1, batch_size=1)Probemos el mismo prompt que en la línea base para ver si el modelo mejora. Esta vez, en lugar de respuestas de una línea y repeticiones, ofrece un plan detallado para un viaje a Bahamas.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))Instruction:Plan a 5-day Bahamas trip.Response:Day 1: Arrive in Nassau, BahamasUpon arrival in Nassau, you will be greeted by a local guide who will take you on a tour of the city. Visit the famous Straw Market, where you can shop for souvenirs and local crafts. Enjoy lunch at a local restaurant before heading to the Atlantis Resort for a day of fun and relaxation. Spend the afternoon exploring the resort's world-class amenities, including the Aquaventure Water Park, Dolphin Cay, and the massive marine habitat, The Dig.Day 2: Explore Paradise IslandOn day 2, you will explore Paradise Island, home to the world-famous Atlantis Resort. Visit the famous Atlantis Casino and enjoy a round of blackjack or roulette. Take a stroll along the beach and enjoy the crystal-clear waters of the Atlantic Ocean. Visit the Dolphin Cay, where you can swim with dolphins and other marine animals.Day 3: Snorkel at Cabbage BeachOn day 3, you will head to Cabbage Beach, a secluded beach located on Paradise Island. Snorkel in the crystal-clear waters and explore the coral reefs. Enjoy a delicious lunch at a local restaurant before heading back to Nassau.Puedes guardar los pesos del modelo para inferencia y desplegarlo a producción.
gemma_lm.save_weights('gemma_2b_openhermes.weights.h5')El tamaño total de nuestro modelo afinado es de 10,04 GB.
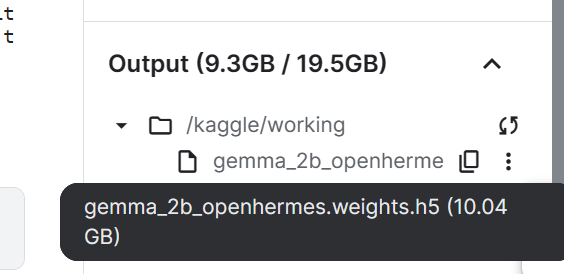 Archivo del modelo Gemma afinado y guardado
Si te cuesta afinar el modelo, consulta este notebook de Kaggle como referencia: Finetuning Gemma using TPUs
Para cerrar, veremos el ajuste fino distribuido. Se consigue mediante paralelismo de modelos, que reparte los pesos de un único modelo entre varios dispositivos, permite escalar en horizontal y acelera el entrenamiento.
En esta parte reduciremos de forma notable el tiempo de entrenamiento de un modelo grande. Usaremos Keras con backend JAX para afinar Gemma con LoRA y entrenamiento distribuido en TPUs.
Iniciamos un notebook nuevo en Kaggle e instalamos las librerías necesarias. Luego definimos el backend de Keras y preasignamos memoria.
!pip install -q tensorflow-cpu!pip install -q -U keras-nlp tensorflow-hub!pip install -q -U keras==3.1.1import osos.environ["KERAS_BACKEND"] = "jax"os.environ["XLA_PYTHON_CLIENT_MEM_FRACTION"] = "0.9"Primero crearemos un DeviceMesh para cargar los pesos y tensores del modelo repartidos entre varias TPUs. Permite paralelismo de datos y de modelo, escalando LLMs de forma eficiente en múltiples aceleradores.
Crea un DeviceMesh con forma (1, 8), para fragmentar los pesos del modelo entre las 8 TPUs.
import kerasimport keras_nlpdevice_mesh = keras.distribution.DeviceMesh( (1, 8), ["batch", "model"], devices=keras.distribution.list_devices())Luego crearemos un layout map que especifique cómo fragmentar o replicar pesos y tensores usando RegEx.
Ten en cuenta:
Los pesos que coincidan con token_embedding/embeddings se compartirán.
Usa RegEx para hacer match con las matrices query, key y value en el decoder attention, attention_output, ffw_gating y ffw_linear.
Los tensores que hagan match se fragmentan con el DeviceMesh, el resto se replica totalmente.
model_dim = "model"layout_map = keras.distribution.LayoutMap(device_mesh)layout_map["token_embedding/embeddings"] = (None, model_dim)layout_map["decoder_block.*attention.*(query|key|value).*kernel"] = ( None, model_dim, None,)layout_map["decoder_block.*attention_output.*kernel"] = (None, None, model_dim)layout_map["decoder_block.*ffw_gating.*kernel"] = (model_dim, None)layout_map["decoder_block.*ffw_linear.*kernel"] = (None, model_dim)Ahora activaremos el paralelismo de modelos con device_mesh y layout_map.
model_parallel = keras.distribution.ModelParallel( device_mesh, layout_map, batch_dim_name="batch")keras.distribution.set_distribution(model_parallel)Tras configurar el paralelismo, cargamos el modelo.
gemma_lm = keras_nlp.models.GemmaCausalLM.from_preset("gemma_7b_en")gemma_lm.summary()Esta vez, al usar Gemma 7B, vemos 8,5 mil millones de parámetros entrenables.
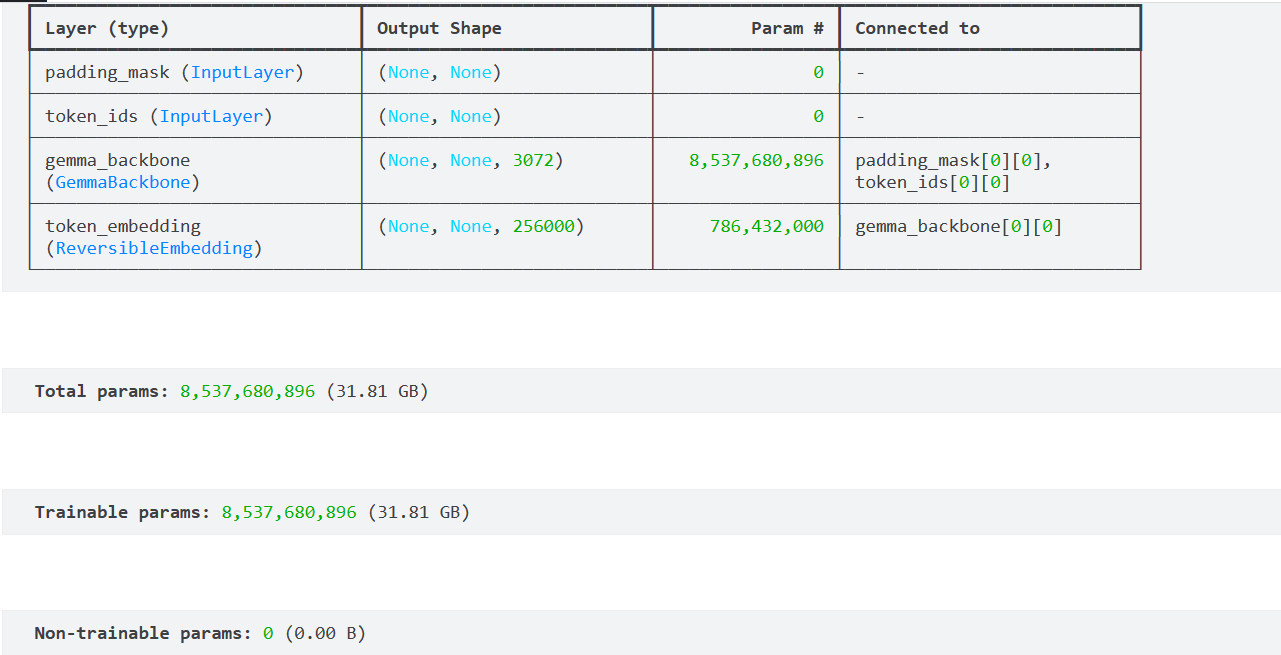 Resumen del modelo Gemma 7B
Para verificar que el modelo se ha fragmentado correctamente, imprimiremos el path, shape y spec de los pesos de la capa decoder_block_1.
decoder_block_1 = gemma_lm.backbone.get_layer('decoder_block_1')print(type(decoder_block_1))for variable in decoder_block_1.weights: print(f'{variable.path:<58} {str(variable.shape):<16} {str(variable.value.sharding.spec)}')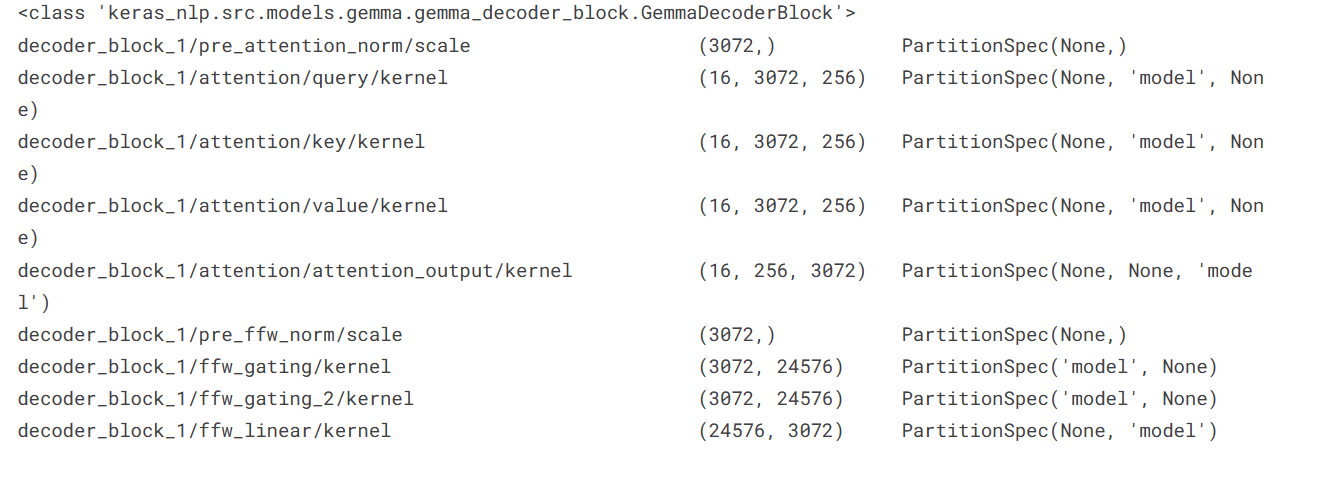
Bloque decodificador
Carguemos el dataset OpenHermes. De nuevo, convertimos el dataframe en una lista de cadenas con la plantilla de instrucción y respuesta y, para acelerar, seleccionamos solo las 1.000 primeras muestras.
import pandas as pddf = pd.read_csv('/kaggle/input/openhermes/openhermes.csv')# Format and convert the dataframe into a list of strings.template = "Instruction:\n{instruction}\n\nResponse:\n{output}"data = [template.format(**row) for index, row in df.iterrows()]# Select a subset of the dataset. data = data[:1000]Generaremos la respuesta de la línea base proporcionando el prompt formateado. Curiosamente, la respuesta es incluso peor que con el modelo pequeño, pero sigamos.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256)) 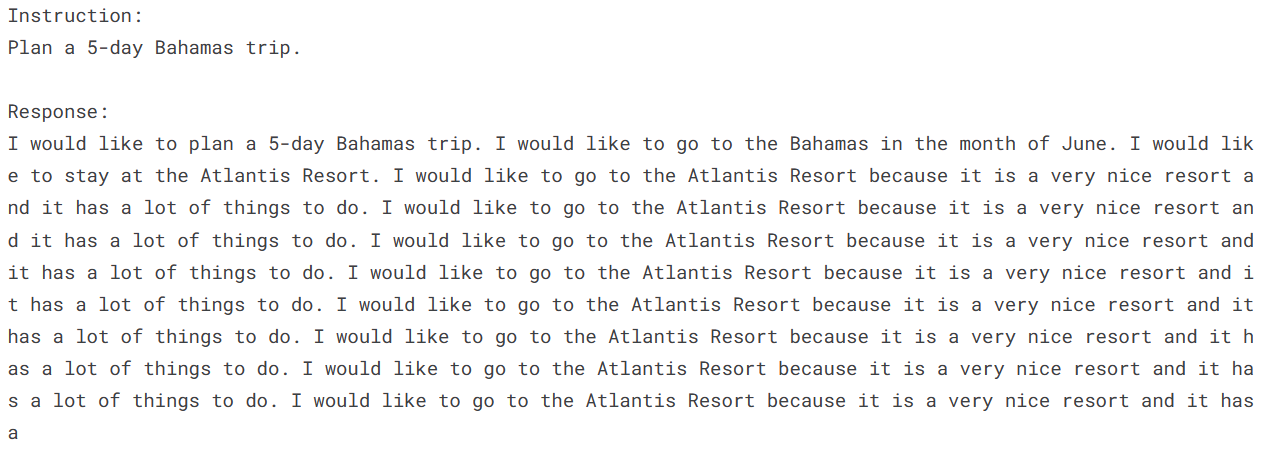 Resultado de la inferencia antes del ajuste fino
Compilaremos el modelo con las mismas configuraciones, rank de LoRA, optimizador, función de pérdida y métrica. Ahora tenemos 11 millones de parámetros entrenables con un tamaño de 42,22 MB.
gemma_lm.backbone.enable_lora(rank=4)gemma_lm.preprocessor.sequence_length = 512optimizer = keras.optimizers.AdamW( learning_rate=5e-5, weight_decay=0.01,)optimizer.exclude_from_weight_decay(var_names=["bias", "scale"])gemma_lm.compile( loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), optimizer=optimizer, weighted_metrics=[keras.metrics.SparseCategoricalAccuracy()],)gemma_lm.summary()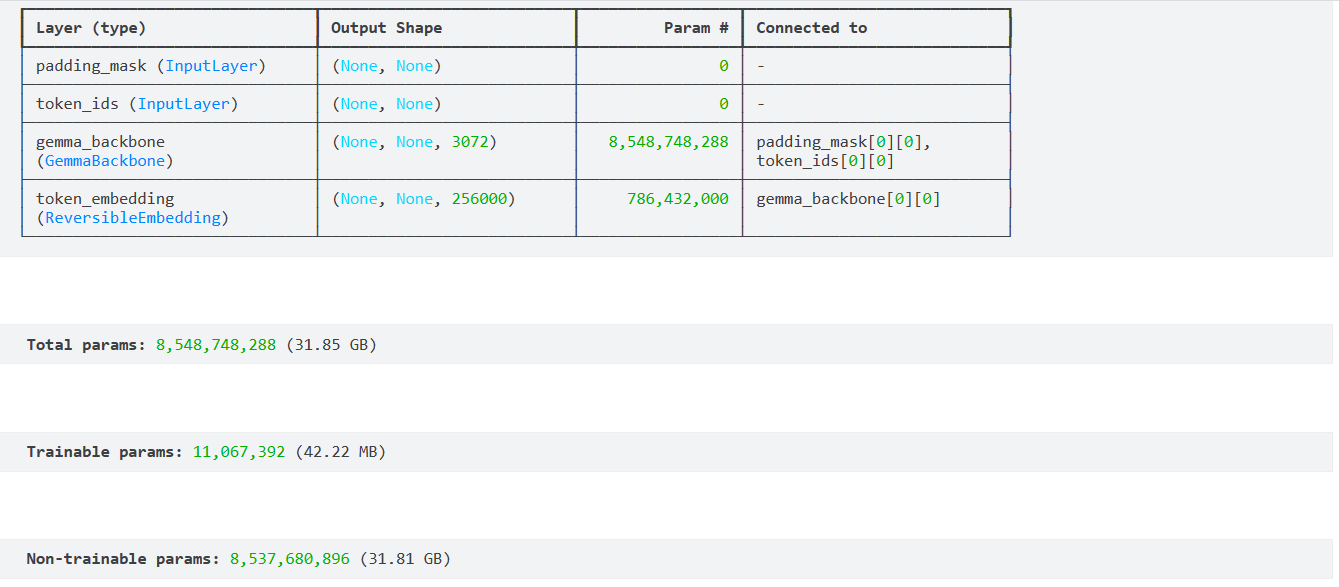 Resumen del modelo Gemma 7B con LoRA
Tardamos 305 segundos en afinar una época, muy buen tiempo dado el tamaño del modelo.
gemma_lm.fit(data, epochs=1, batch_size=1)
Si el ajuste fino te resulta complejo, puedes aprender a usar la API de OpenAI y seguir esta guía paso a paso para afinar GPT-4.
Generemos la respuesta y compárala con la línea base.
prompt = template.format( instruction="Plan a 5-day Bahamas trip.", output="",)print(gemma_lm.generate(prompt, max_length=256))El modelo afinado funciona muy bien: ha generado una lista detallada de lo que necesitas para disfrutar de un viaje de cinco días a Bahamas.
Nota: puedes desactivar LoRA para un ajuste de todos los parámetros más lento pero más preciso con paralelismo de modelo.
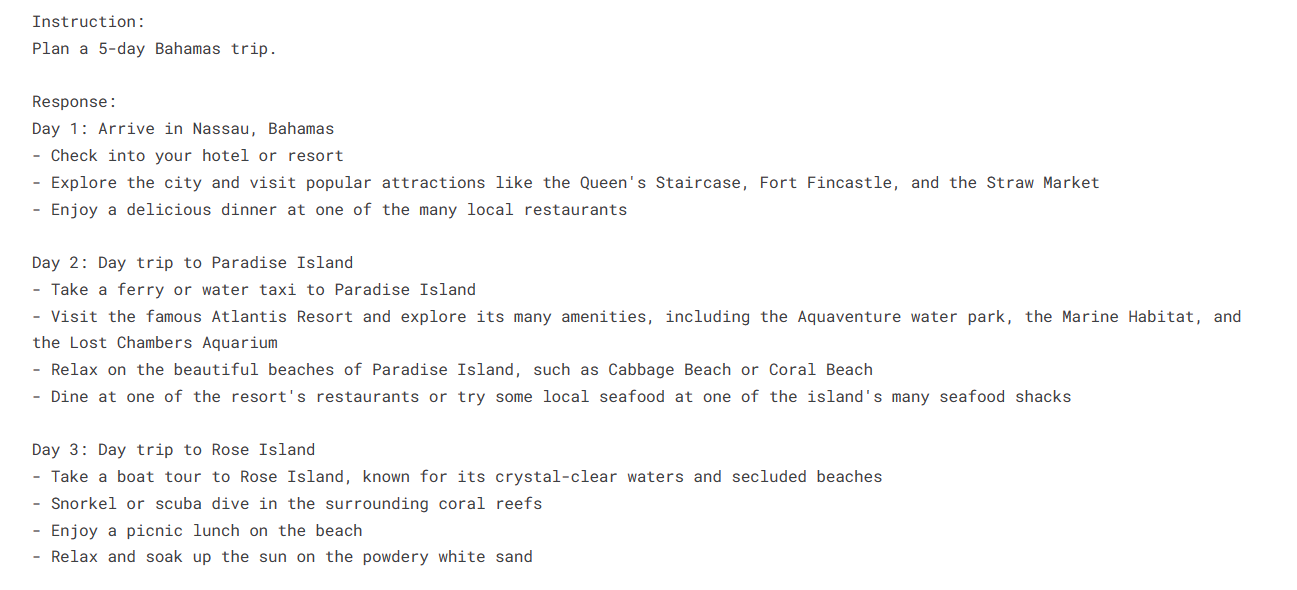 Resultado de la inferencia después del ajuste fino
gemma_lm.save_weights('gemma_7b_openhermes.weights.h5')Si vuelves a tener problemas con el ajuste fino distribuido, usa este notebook de Kaggle como recurso adicional: Accessing Gemma-instruct-2b-en using TPUs.
En este tutorial hemos visto qué son las TPUs y cómo usarlas para acelerar la generación de respuestas de los LLMs. Además, hemos aprendido a afinar modelos Gemma con el dataset OpenHermes usando TPUs y entrenamiento distribuido.
Afinar LLMs en TPUs y usar paralelismo de modelos para aprendizaje distribuido es clave para reducir los tiempos de entrenamiento. Con aprendizaje distribuido, puedes afinar incluso modelos muy grandes como Gemma 7B. Al aprovechar las TPUs, diseñadas específicamente para tareas de ML de alto rendimiento, puedes lograr aceleraciones significativas tanto en entrenamiento como en inferencia.
Si te ha gustado el tutorial y quieres profundizar en el mundo de los LLMs, haz el curso Master Large Language Models (LLMs) Concepts para descubrir su potencial, aplicaciones, metodologías de entrenamiento, consideraciones éticas y las últimas investigaciones. Si te interesan otros LLMs que compiten con Gemma, echa un vistazo a nuestro tutorial Getting Started With Mixtral 8X22B para conocer el nuevo modelo de Mistral AI y su arquitectura SMoE (sparse mixture of experts).
Aprende más sobre los grandes modelos de lenguaje
Curso
Curso
programa
Tutorial
Zoumana Keita
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
15 min
Tutorial
Zoumana Keita
8 min
Tutorial
Moez Ali
11 min
Tutorial
Abid Ali Awan
12 min