Este artículo es una valiosa contribución de nuestra comunidad y ha sido editado por DataCamp para mejorar su claridad y precisión.
¿Te gustaría compartir tu experiencia? ¡Nos encantará leerte! Envía tus artículos o ideas a través de nuestro formulario de contribución de la comunidad.
Hoy en día, muchas organizaciones dependen de los datos para tomar decisiones. A menudo se registran y recopilan desde fuentes diversas y en formatos distintos. Lo más habitual es que estos datos se almacenen y transformen en su propio silo y se utilicen para responder preguntas específicas. A medida que las organizaciones avanzan hacia un enfoque basado en datos, los equipos de datos se topan con una pregunta en apariencia sencilla: ¿podemos evaluar el rendimiento de todos los clientes de la empresa en un único lugar centralizado? (o, dicho de otro modo, ¿podemos ver todos los puntos de datos en un mismo sitio?).
En este tutorial, aprenderás a aprovechar técnicas que quizá ya conoces y combinarlas para construir una solución que ayude a responder a esta pregunta.
Aspectos clave a tener en cuenta
Aquí resumimos algunos de los conceptos clave que exploraremos en el resto del artículo.
Data lake
Un repositorio amplio y centralizado que almacena datos estructurados, semiestructurados y no estructurados a cualquier escala. Ofrece una solución flexible y rentable para guardar grandes volúmenes de datos de tipos muy diversos y de múltiples fuentes.
A diferencia de los sistemas de almacenamiento tradicionales, un data lake no requiere modelado previo ni la aplicación estricta de un esquema, permitiendo almacenar los datos tal cual. Estos datos en bruto pueden procesarse, analizarse y transformarse según sea necesario, lo que lo convierte en un recurso valioso para la toma de decisiones basada en datos y la analítica avanzada.
Puedes comparar un data lake y un data warehouse en un artículo aparte.
Data warehouse
Un data warehouse es un gran repositorio centralizado que almacena y gestiona datos estructurados. Está diseñado para apoyar la inteligencia de negocio, la generación de informes y las actividades de análisis. Los data warehouses consolidan datos de múltiples bases de datos, aplicaciones y sistemas y los transforman en un formato unificado y coherente para consultas y análisis eficientes.
Microservicios
Los microservicios son un enfoque arquitectónico y organizativo del desarrollo de software en el que las aplicaciones se componen de pequeños servicios independientes que se comunican mediante APIs bien definidas. Estos servicios están gestionados por equipos pequeños y autónomos. Las arquitecturas de microservicios facilitan la escalabilidad y aceleran el desarrollo, favoreciendo la innovación y acortando el time-to-market de nuevas funcionalidades.
Cómo construir una canalización de datos adaptativa
Este enfoque abarca desde la recogida, el almacenamiento y el procesamiento de datos, hasta la creación de vistas de staging y la generación de analítica a escala.
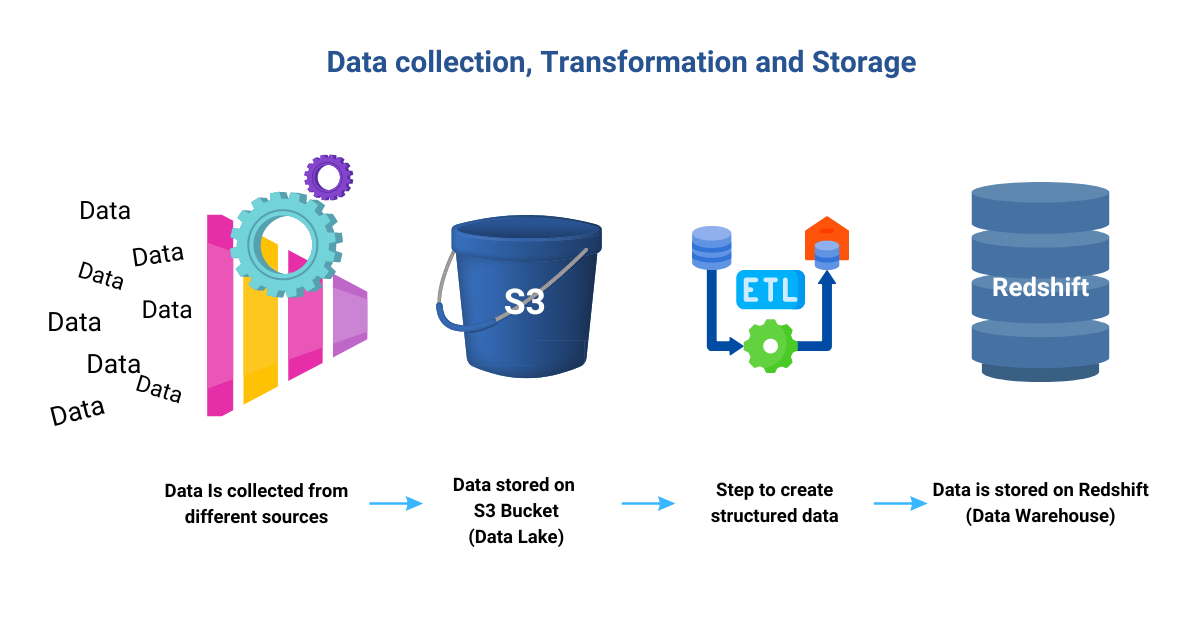 Imagen del autor
Paso 1: recogida de datos y requisitos previos
En esta fase inicial, es fundamental atender algunos requisitos previos antes de ponerte manos a la obra. Examina en detalle el origen y el almacenamiento de los datos para entender bien sus fuentes.
Define estrategias eficaces para que los datos recopilados sean útiles y estén listos para el análisis. La preparación de datos (data wrangling) es clave para garantizar que estén limpios y en un formato utilizable, dejándolos listos para su posterior procesamiento. Además, la prioridad es encontrar una solución que integre sin fricciones puntos de datos de distintos clientes manteniendo la integridad y la seguridad.
La guía de DataCamp, What is Data Analysis, profundiza en este proceso.
Paso 2: data lake y data warehouse
Se recopilan datos de varios clientes y se consolidan en S3 Buckets (una ubicación de almacenamiento en Amazon Simple Storage Service, Amazon S3), formando un data lake que conserva la información diversa en su forma bruta. El siguiente paso consiste en utilizar procesos de Extract, Transform, Load (ETL) para convertir los datos recopilados en un conjunto estructurado que encaje sin problemas en el data warehouse. Como resultado, el data warehouse se convierte en un repositorio donde los esquemas y los datos estructurados se organizan meticulosamente. Sin embargo, los datos de cada cliente permanecen separados, dentro de sus silos individuales en el data warehouse.
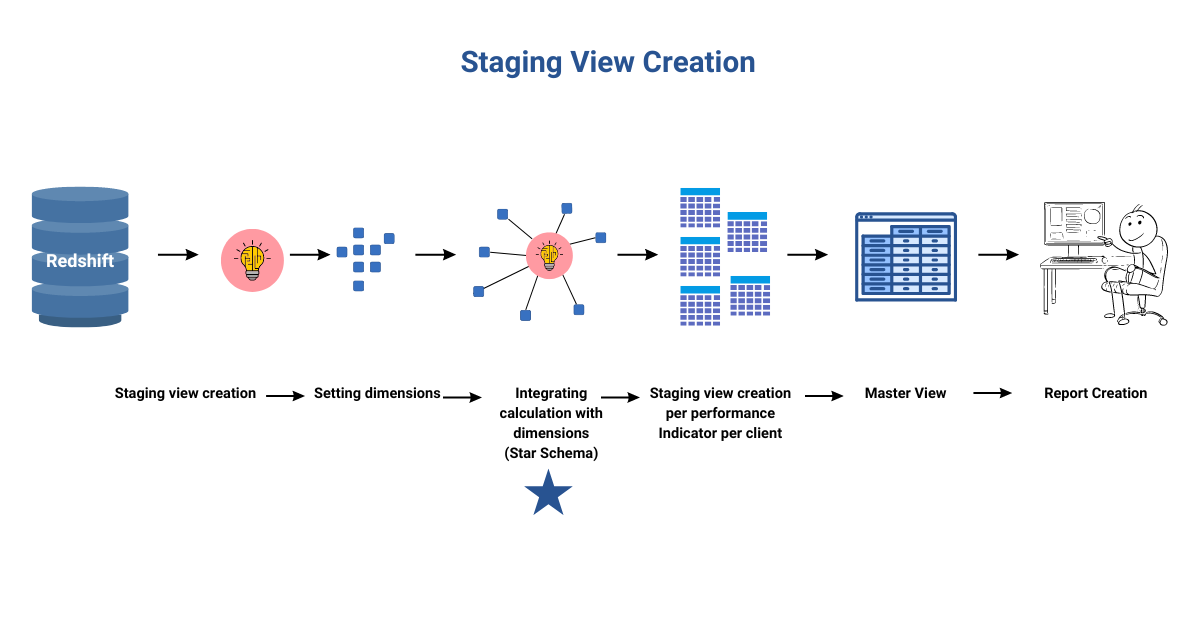 Imagen del autor
Paso 3: vista de staging (el corazón de la operación)
Las vistas de staging se construyen aprovechando las relaciones entre esquemas, tablas y columnas en un data warehouse. El resultado es una vista de negocio simplificada que oculta la complejidad y garantiza una comprensión coherente de dimensiones y hechos para el análisis. Todas las personas de la organización pueden acceder a datos precisos, gestionados de forma centralizada, lo que permite obtener información valiosa sobre el rendimiento en distintas dimensiones.
En el núcleo de este enfoque está el proceso técnico de crear vistas de staging. Estas vistas contienen los cálculos y atributos necesarios para reporting y analítica, lo que hace que todo el ecosistema sea escalable. Cualquier lógica nueva o cambio se implementa en estas vistas de staging.
Para facilitar la resolución de incidencias, se crean vistas de staging por cliente y por indicador de rendimiento, lo que permite localizar y abordar los problemas con eficacia. Este enfoque contrasta con el uso de un único procedimiento almacenado masivo, que complica y alarga la identificación de problemas.
Mediante técnicas de segmentación y agregación, se generan indicadores de rendimiento de alto nivel a partir del análisis de los datos transaccionales y su combinación adecuada. Cada vista de staging incorpora la lógica de cálculo y las dimensiones necesarias para ofrecer el valor de salida deseado. Este proceso se repite para cada cliente, obteniendo una vista de staging independiente por indicador de rendimiento y cliente, y manteniendo la seguridad de la información sensible.
Paso 4: modelado de datos
En el paso 3 del proceso, hemos consolidado todos los datos en una vista maestra. Esta vista maestra sirve de base para crear vistas específicas por cliente aplicando filtros según atributos vinculados a cada cliente. Tener todos los atributos dimensionales del cliente en un solo lugar agiliza la creación de vistas.
Además, la vista maestra puede almacenar datos de varios años, pero se puede restringir fácilmente para incluir solo unos pocos meses, adaptándose a las necesidades de cada cliente. Esta flexibilidad nos permite ofrecer exactamente los datos que necesita cada uno, mejorando la relevancia y la eficiencia de la analítica.
El modelo en estrella (un modelo de datos multidimensional para organizar la información) es el que utilizamos. Este modelo descompone los datos en dos componentes clave: la tabla de hechos y las tablas de dimensiones.
Los datos numéricos de la tabla de hechos se vinculan a las tablas de dimensiones a través de claves primarias, estableciendo relaciones fáciles de comprender. Esta configuración permite realizar consultas rápidas y sencillas filtrando y agregando datos por diversas dimensiones. El análisis resulta ágil, ya que se pueden explorar puntos de datos concretos sin lidiar con uniones complejas entre múltiples tablas.
La brillante estructura desnormalizada del modelo en estrella garantiza que las tablas de dimensiones sean independientes, lo que se traduce en un rendimiento de consulta rapidísimo. El motor de base de datos puede recuperar datos sin procesamiento intensivo, ofreciendo mejores tiempos de respuesta incluso en consultas analíticas complejas.
En pocas palabras, el modelo en estrella es un gran aliado que simplifica y hace eficiente el análisis de datos. Al organizar la información en tablas de hechos y de dimensiones, acelera las consultas, facilita la exploración y abre la puerta a ideas valiosas para una toma de decisiones informada.
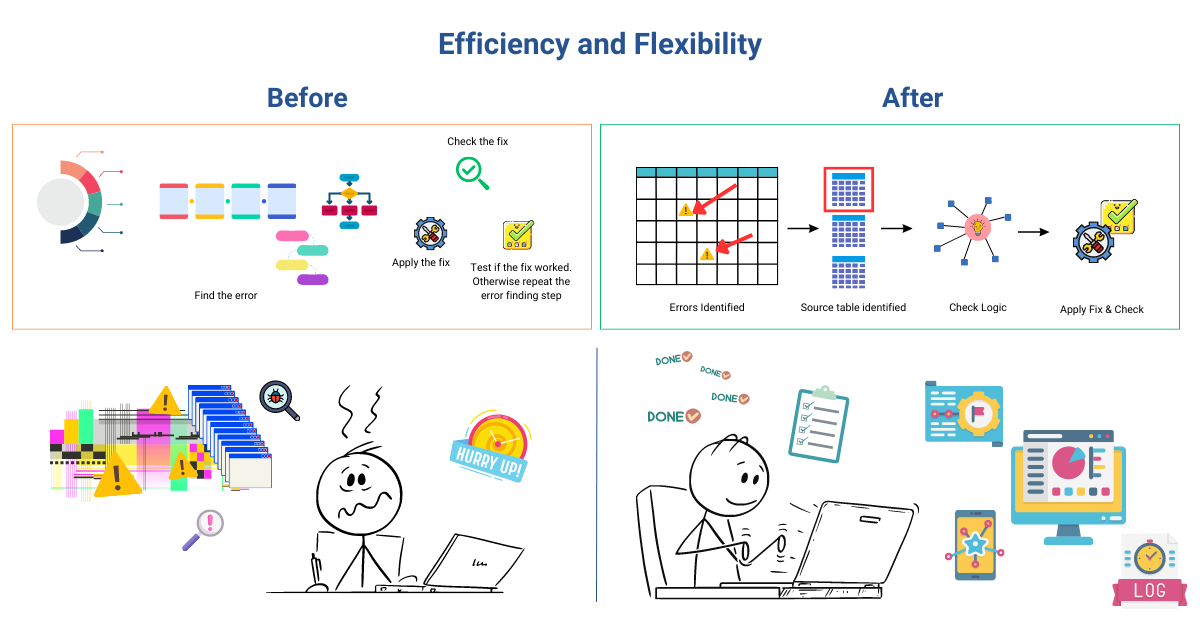
Imagen del autor
Eficiencia y flexibilidad
La auténtica fortaleza de este enfoque reside en su gran eficiencia y su flexibilidad sin igual. Aquí es donde aprovechamos el concepto de microservicios.
Cuando hay que introducir cambios, ya sea para recalcular o para corregir problemas de datos, basta con actualizar la lógica del indicador de rendimiento en el script de staging. Además, este proceso convierte la resolución de incidencias y las modificaciones en tareas fluidas y rapidísimas, reduciendo drásticamente cualquier posible interrupción.
Para entender bien la potencia de este enfoque, imagina que el indicador de rendimiento de un cliente muestra un dato que no cuadra. Con el método tradicional de resolución de problemas, habría que emprender un largo proceso para encontrar la causa raíz, con pasos como recalcular, ejecutar código y validar datos.
Con el enfoque actual, logramos un nivel de eficiencia sin precedentes y simplificamos al máximo la resolución de incidencias.
Ahora podemos localizar con rapidez el indicador de rendimiento responsable de cualquier discrepancia, revisar a fondo su lógica y validar de inmediato la tabla asociada a los cálculos. Así, identificar el origen de los errores resulta sencillo y aplicar las correcciones necesarias, cuestión de muy poco tiempo. Gracias a este enfoque, el tiempo de troubleshooting se reduce de forma drástica, porque nos centramos en resolver cuanto antes en lugar de quedar atrapados en pasos largos y tediosos.
Aplicación e informes
Para evaluar los niveles de rendimiento —si son buenos, malos o necesitan mejorar— nos basamos en objetivos. Para ello, puede desarrollarse una interfaz de aplicación conectada a la tabla maestra. Esta interfaz, fácil de usar, recoge de los usuarios objetivos a nivel de atributo y los guarda en una tabla dedicada. Al integrar la tabla maestra con una aplicación que acepta entradas directamente a partir de los datos disponibles en la tabla del data warehouse, demostramos el potencial de base de este enfoque para construir soluciones.
La tabla de objetivos se combina después con la tabla maestra de rendimiento, creando una visión holística de los indicadores junto con sus objetivos. Esta integración nos permite comprender de forma global hasta qué punto se están cumpliendo.
Crear informes con estos datos completa la solución y proporciona insights potentes para guiar la toma de decisiones.
Conclusión
El enfoque que hemos descrito reúne todos los datos y allana el camino para responder a la gran pregunta: ¿podemos evaluar el rendimiento de todos los clientes de la empresa en un único lugar centralizado?
Pero hay más. Esta solución no es un proyecto pasajero; es robusta y duradera, pensada para abrir un sinfín de posibilidades. Imagina construir múltiples informes, todos apoyados en esta solución como base sólida.
Ahora llega lo emocionante: transmitir este conocimiento valioso para formar a personas capaces de aprovechar su potencial. No basta con construir una solución; para que sea realmente escalable y sostenible, debemos capacitar a los equipos y desarrollar la competencia en datos necesaria para que este engranaje funcione a la perfección.
Al igual que con la metodología Six Sigma, que ayuda a mejorar los procesos de negocio, mejoramos continuamente los procesos, optimizamos los flujos de trabajo y tomamos medidas para mantener este enfoque excepcional.
En esencia, no solo estamos construyendo una solución; estamos impulsando una transformación que fomentará el progreso y la excelencia durante años.
En muchos casos, las preguntas más sencillas exigen una infraestructura de datos sofisticada. La ciencia de datos, en su esencia, consiste en aprovechar los datos para generar un impacto significativo en tu organización. Con esta potente solución en tus manos, podrás liberar todo el potencial de tus datos y lograr un impacto transformador.
¿Listo para profundizar en el mundo de la ingeniería y la analítica de datos? Inscríbete en el curso de DataCamp Streamlined Data Ingestion with pandas para adquirir habilidades prácticas en optimización de la recogida, la ingesta y la transformación de datos. O, si lo prefieres, explora el itinerario de aprendizaje Data Engineer in Python para desarrollar las competencias más demandadas por las empresas y, cuando estés listo, obtén la Data Engineer Certification.