Curso
Diseño de flujos de trabajo de Machine Learning en Python
4 h
12.7K
En este tutorial, profundizaremos en Prefect explorando sus funciones clave, ventajas y componentes. Veremos cómo crear tareas y flujos, gestionar despliegues y ejecutar ejecuciones de flujos. Por último, te guiaremos para desplegar tu flujo de trabajo en Prefect Cloud y ejecutarlo usando infraestructura en la nube.
Si te interesa cómo automatizar canalizaciones de machine learning usando GitHub Actions y control de versiones de datos, echa un vistazo a nuestro curso CI/CD for Machine Learning.
Prefect es una potente herramienta de orquestación de flujos de trabajo de código abierto que permite diseñar, monitorizar y reaccionar ante canalizaciones de datos y de machine learning usando código Python.
Prefect viene con un amplio abanico de funcionalidades, como reintentos automáticos, planificación y caché, entre otras. Es una herramienta potente que, en última instancia, te permite construir flujos de trabajo resilientes y dinámicos.
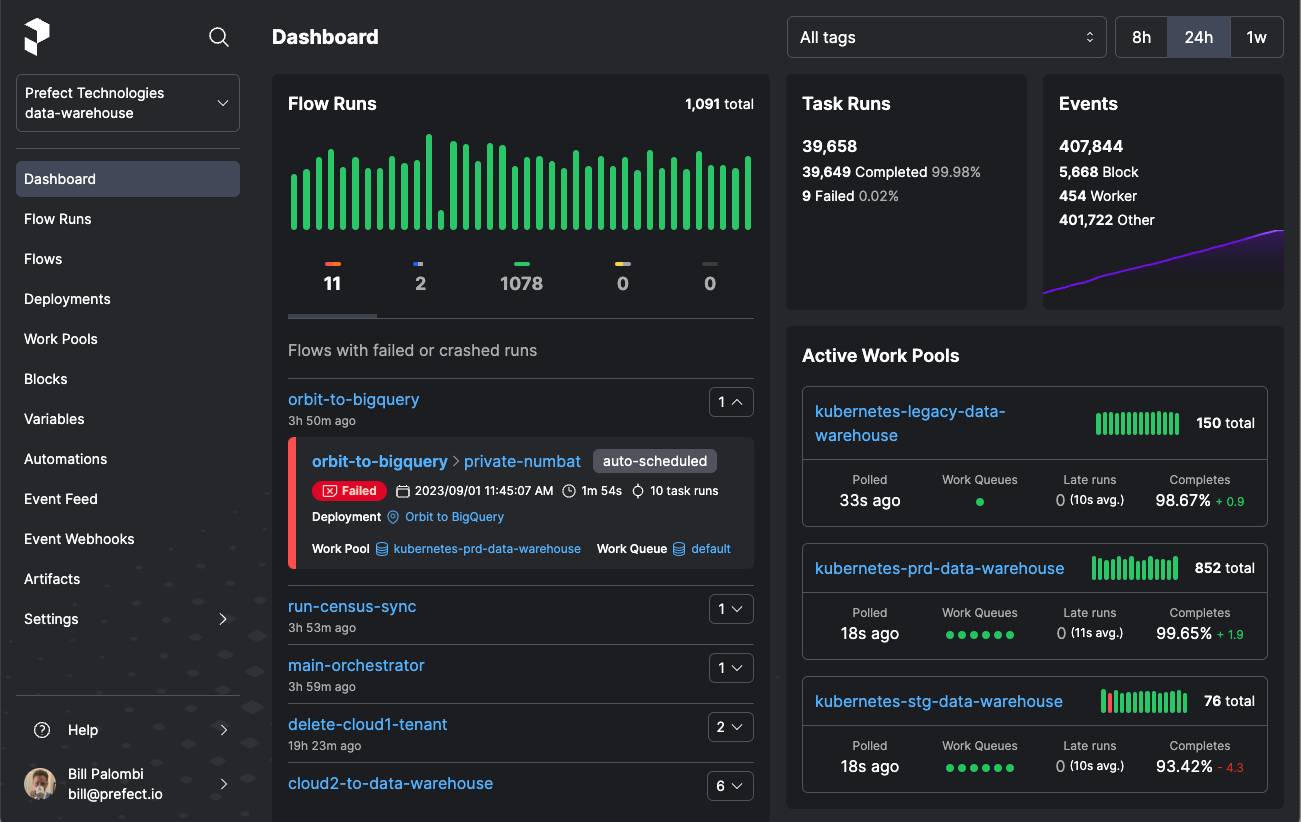
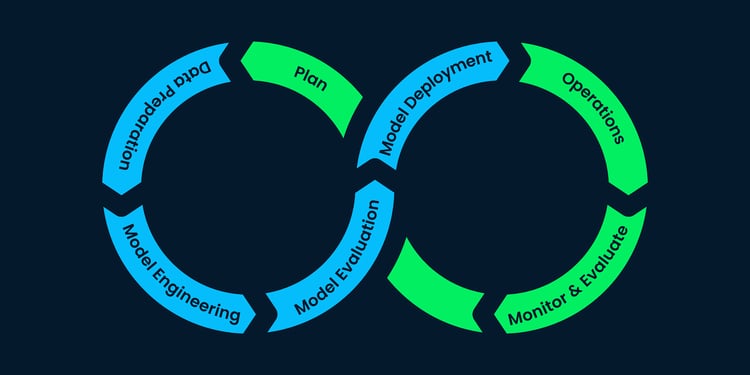
Imagen Fuente
Con Prefect, puedes convertir fácilmente cualquier función de Python en una unidad de trabajo observable y orquestable simplemente añadiendo unos pocos decoradores a tu código.
Prefect es ideal para estandarizar el desarrollo y el despliegue de flujos de trabajo en toda una organización. Ofrece observabilidad total sobre los flujos y permite gestionar el código sin necesidad de DAGs estrictos ni código repetitivo.
Con un solo comando, los usuarios pueden poner en marcha su propio servidor de orquestación para desarrollo. Este proceso agiliza el desarrollo local y facilita un despliegue fluido en producción.
Prefect ofrece una interfaz en general intuitiva, que mejora la experiencia al proporcionar una forma visual y fácil de ejecutar, monitorizar, depurar y gestionar flujos de trabajo.
Prefect incluye funcionalidades como planificación, reintentos, gestión nativa de secretos, capacidad de escalado, control de concurrencia, opciones flexibles de configuración de infraestructura y almacenamiento, y un registro de logs robusto.
Puedes autoalojar un servidor Prefect de código abierto o aprovechar funciones avanzadas, alta disponibilidad y mayor seguridad usando Prefect Cloud.
Prefect Cloud ofrece todas las capacidades del servidor Prefect de código abierto junto con funciones adicionales como automatizaciones, feeds de eventos, eventos, webhooks, espacios de trabajo, organizaciones y más, pensadas para un entorno alojado. Puedes usar Prefect Cloud gratis o pagar por funciones más avanzadas.
Prefect permite iniciar la orquestación de flujos de trabajo con un único decorador, simplificando el proceso sin abstracciones innecesarias para una gestión eficiente.
Envía información sobre flujos y canalizaciones de Prefect a varios servicios de mensajería como Slack, Discord, email, Microsoft Teams y más. También puede avisarte si el flujo falla.
En esta sección veremos los componentes clave para construir tareas y flujos, desplegarlos y ejecutarlos, y gestionarlos. Es fundamental repasarlos antes de entrar en el tutorial de Python.
Una tarea de Prefect es una función de Python decorada con el decorador @task que representa unidades de trabajo discretas dentro de un flujo de Prefect. También podemos personalizar el decorador con argumentos opcionales como nombre, descripción, etiquetas, configuración de caché, reintentos y más.
En el siguiente código, hay tres tareas de machine learning creadas con el decorador @task que pueden reutilizarse en distintos flujos.
@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    ...

    # Train the model
    ...

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    ...
	return prediction

@task
def evaluate_model(y_test, prediction: pd.DataFrame):
...Un flujo de Prefect es una función de Python decorada con @flow que encapsula la lógica del flujo de trabajo. Esto facilita definir, configurar y ejecutar canalizaciones de datos complejas con flexibilidad y facilidad.
En el siguiente código, hemos creado un flujo usando el decorador @flow. El flujo ejecutará todas las tareas de forma secuencial, pasando las entradas de una a otra.
@flow
def ml_workflow():
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)

if __name__ == "__main__":
ml_workflow()Los despliegues son flujos almacenados en el servidor local o en la nube e incluyen información importante para orquestar tu flujo de trabajo de forma remota, como la planificación y los detalles de ejecución.
Los work pools actúan como mediador entre los entornos de orquestación y ejecución, lo que permite programar y ejecutar ejecuciones de flujos de forma eficiente. Puedes configurar tus agentes (workers) para ejecutar flujos localmente o aprovechar la infraestructura en la nube para una ejecución fluida.
De forma similar a una instancia de cómputo dedicada, los work pools gestionan la asignación de trabajo y priorizan tareas con eficiencia, ofreciendo flexibilidad para elegir el entorno de ejecución y lograr el mejor rendimiento y escalabilidad.
En esta sección, vamos a crear, probar, desplegar y ejecutar un flujo de trabajo sencillo de machine learning usando Prefect. También configuraremos notificaciones para recibir avisos en nuestro servidor de Discord sobre el estado de las ejecuciones.
Instala el paquete de Python con PIP
pip install -U prefectSi quieres usar la versión más reciente de Prefect, puedes obtener el código directamente desde GitHub.
pip install -U git+https://github.com/PrefectHQ/prefectVamos a preprocesar el conjunto de datos de Bank Churn de Kaggle y después usaremos scikit-learn para entrenar y evaluar el modelo Random Forest Classifiers.
El código que usaremos es una versión modificada del de: Streamline Your Machine Learning Workflow with Scikit-learn Pipelines. Échale un vistazo si te interesa saber más sobre cómo se entrenó el modelo. Nuestro flujo de machine learning en Prefect consta de siete tareas:
Ya hemos reunido todas las tareas necesarias en una función @flow llamada ml_workflow. Además, hemos añadido argumentos extra en el decorador para habilitar un registro detallado de logs.
La función ml_workflow recibe como entrada la ubicación del archivo de datos y después encadena varias tareas. Podremos visualizar mejor este flujo cuando lo despleguemos y ejecutemos en el servidor de Prefect.
También puedes hacer el seguimiento de nuestros experimentos de machine learning con MLflow. Realiza el curso Introduction to MLflow para aprender sobre el tracking, los projects, los models y el model registry de MLflow.
import pandas as pd
import skops.io as sio
from prefect import flow, task
from sklearn.feature_selection import SelectKBest, chi2
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler, OrdinalEncoder


@task
def load_data(filename: str):
    bank_df = pd.read_csv(filename, index_col="id", nrows=1000)
    bank_df = bank_df.drop(["CustomerId", "Surname"], axis=1)
    bank_df = bank_df.sample(frac=1)
    return bank_df


@task
def preprocessing(bank_df: pd.DataFrame):
    cat_col = [1, 2]
    num_col = [0, 3, 4, 5, 6, 7, 8, 9]

    # Filling missing categorical values
    cat_impute = SimpleImputer(strategy="most_frequent")
    bank_df.iloc[:, cat_col] = cat_impute.fit_transform(bank_df.iloc[:, cat_col])

    # Filling missing numerical values
    num_impute = SimpleImputer(strategy="median")
    bank_df.iloc[:, num_col] = num_impute.fit_transform(bank_df.iloc[:, num_col])

    # Encode categorical features as an integer array.
    cat_encode = OrdinalEncoder()
    bank_df.iloc[:, cat_col] = cat_encode.fit_transform(bank_df.iloc[:, cat_col])

    # Scaling numerical values.
    scaler = MinMaxScaler()
    bank_df.iloc[:, num_col] = scaler.fit_transform(bank_df.iloc[:, num_col])
    return bank_df


@task
def data_split(bank_df: pd.DataFrame):
    # Splitting data into training and testing sets
    X = bank_df.drop(["Exited"], axis=1)
    y = bank_df.Exited

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.3, random_state=125
    )
    return X_train, X_test, y_train, y_test
    # Identify numerical and categorical columns


@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    KBest = SelectKBest(chi2, k="all")
    X_train = KBest.fit_transform(X_train, y_train)
    X_test = KBest.transform(X_test)

    # Train the model
    model = LogisticRegression(max_iter=1000, random_state=125)
    model.fit(X_train, y_train)

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    return model.predict(X_test)


@task
def evaluate_model(y_test, prediction: pd.DataFrame):
    accuracy = accuracy_score(y_test, prediction)
    f1 = f1_score(y_test, prediction, average="macro")

    print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))


@task
def save_model(model: LogisticRegression):
    sio.dump(model, "bank_model.skops")


@flow(log_prints=True)
def ml_workflow(filename: str = "train.csv"):
    data = load_data(filename)
    prep_data = preprocessing(data)
    X_train, X_test, y_train, y_test = data_split(prep_data)
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)
    save_model(model)


if __name__ == "__main__":
    ml_workflow()
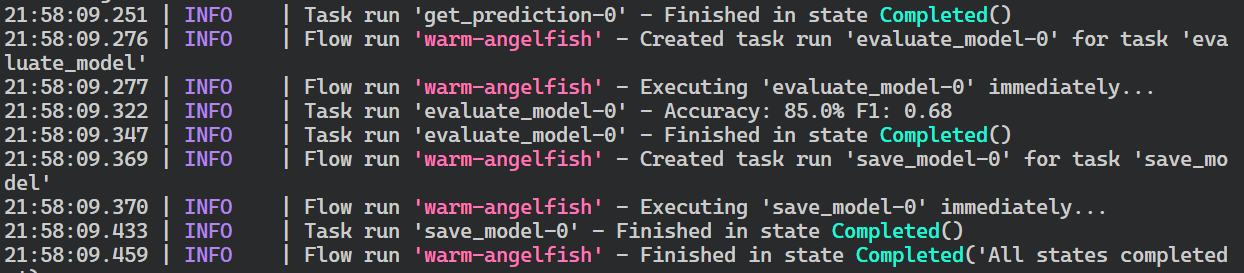
Para probar nuestro flujo de Prefect, ejecuta el archivo de Python en la terminal.
$ python main.pyEl flujo se ha completado correctamente. Ha mostrado las métricas del modelo y ha guardado los pesos.
Si estás empezando con el machine learning y quieres aprender a preprocesar tus datos, entrenar, optimizar, evaluar y guardar tu modelo, plantéate realizar el itinerario de carrera Machine Learning Scientist with Python. Te enseñará todo lo que necesitas desde cero.
Construir y ejecutar una canalización de machine learning manualmente es sencillo y puede hacerse incluso con las pipelines de scikit-learn.
Sin embargo, usar Prefect aporta múltiples beneficios. Entre ellos:
Ahora aprenderemos a automatizar nuestro flujo desplegándolo en el servidor local de Prefect.
Primero, debemos crear el «Deployment» indicando el archivo y el nombre de la función del flujo. También añadimos la etiqueta «dev» a nuestro despliegue.
Nota: las etiquetas en Prefect pueden usarse para categorizar y organizar flujos, tareas y despliegues dentro del ecosistema de Prefect.
$ prefect deployment build main.py:ml_workflow -n 'ml_workflow_bank_churn' -a --tag devEl despliegue se ha creado correctamente. Ahora nos da instrucciones para ejecutar el flujo usando el agente de Prefect.
Found flow 'ml-workflow'
Deployment YAML created at
'C:\Repository\GitHub\ML-Workflow-Orchestration-With-Prefect\ml_workflow-deployment.yaml'.
Deployment storage None does not have upload capabilities; no files uploaded.  Pass --skip-upload to
suppress this warning.
Deployment 'ml-workflow/ml_workflow_bank_churn' successfully created with id
'ce30d1c7-f454-4064-870c-429a8039c194'.

To execute flow runs from this deployment, start an agent that pulls work from the
'default-agent-pool' work pool:
$ prefect agent start -p 'default-agent-pool'Los agentes de Prefect se encargan de monitorizar los work pools para identificar ejecuciones de flujos disponibles y desplegarlas en el entorno de ejecución.
Un único work pool puede tener varios agentes, cada uno con un ID único para evitar solapamientos y facilitar el escalado.
Ahora iniciaremos los agentes de Prefect en una nueva terminal con el nombre de work pool por defecto.
$ prefect agent start -p 'default-agent-pool'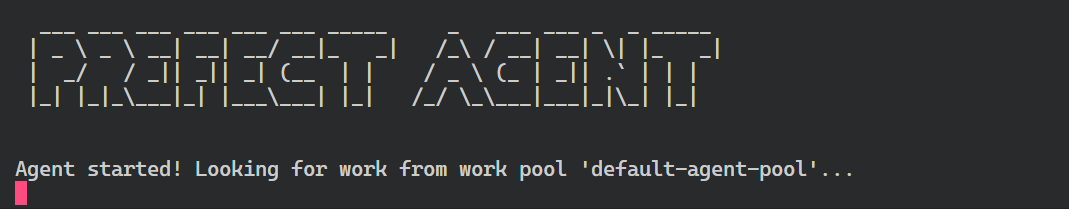
Ve a una nueva terminal y ejecuta el despliegue indicando «nombre_de_flujo/nombre_del_despliegue». También puedes usar solo el nombre del despliegue para ejecutar el flujo.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Se ha creado una ejecución de flujo para el despliegue que buscará workers y empezará a ejecutar el flujo.
Creating flow run for deployment 'ml-workflow/ml_workflow_bank_churn'...
Created flow run 'cryptic-potoo'.
└── UUID: 77833ee3-0f7e-42f9-8002-0a562c7d3ed4
└── Parameters: {}
└── Scheduled start time: 2024-03-14 21:30:40 PKT (now)
└── URL: <no dashboard available>
Cambia a la terminal donde iniciamos el agente para ver los logs de la ejecución. El agente de Prefect ha ejecutado correctamente todas las tareas del flujo.
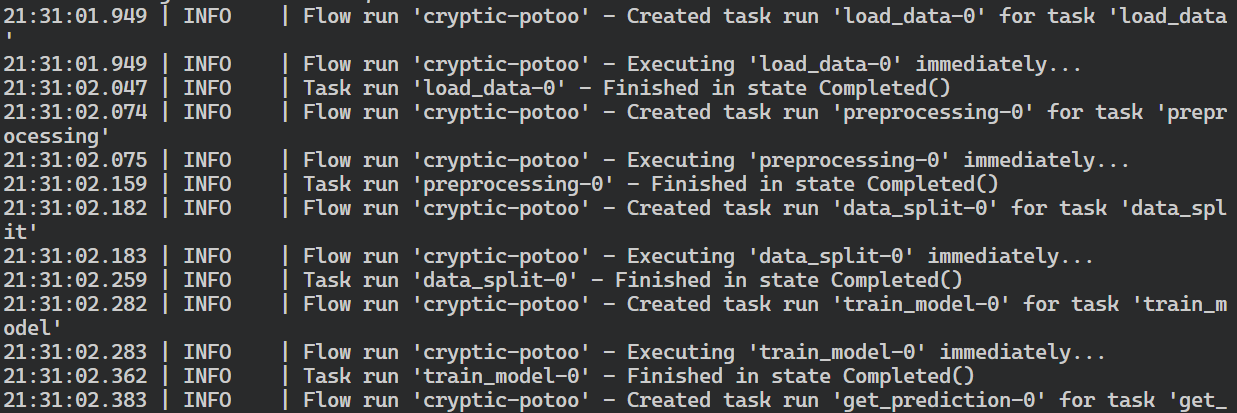
Este es un ejemplo sencillo. También podemos planificar o automatizar el flujo proporcionando argumentos adicionales al build del despliegue.
Hasta ahora hemos observado nuestro flujo en terminales. Ahora, vamos a lanzar un panel de Prefect donde podremos ver todas las ejecuciones de flujos, despliegues, work pools y notificaciones.
Inicia el servidor de Prefect en una nueva terminal y haz clic en el enlace local que aparezca para acceder al panel.
$ prefect server start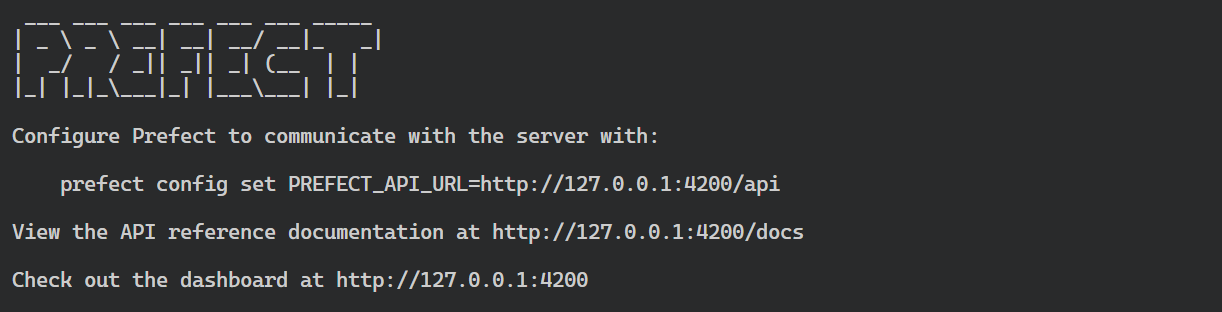
Para ver todas las ejecuciones anteriores, haz clic en la opción "Flow" en el panel izquierdo. Puede que notes que algunos flujos no se ejecutaron por falta de work pools, mientras que otros se ejecutaron sin la etiqueta "dev" durante la fase de pruebas.
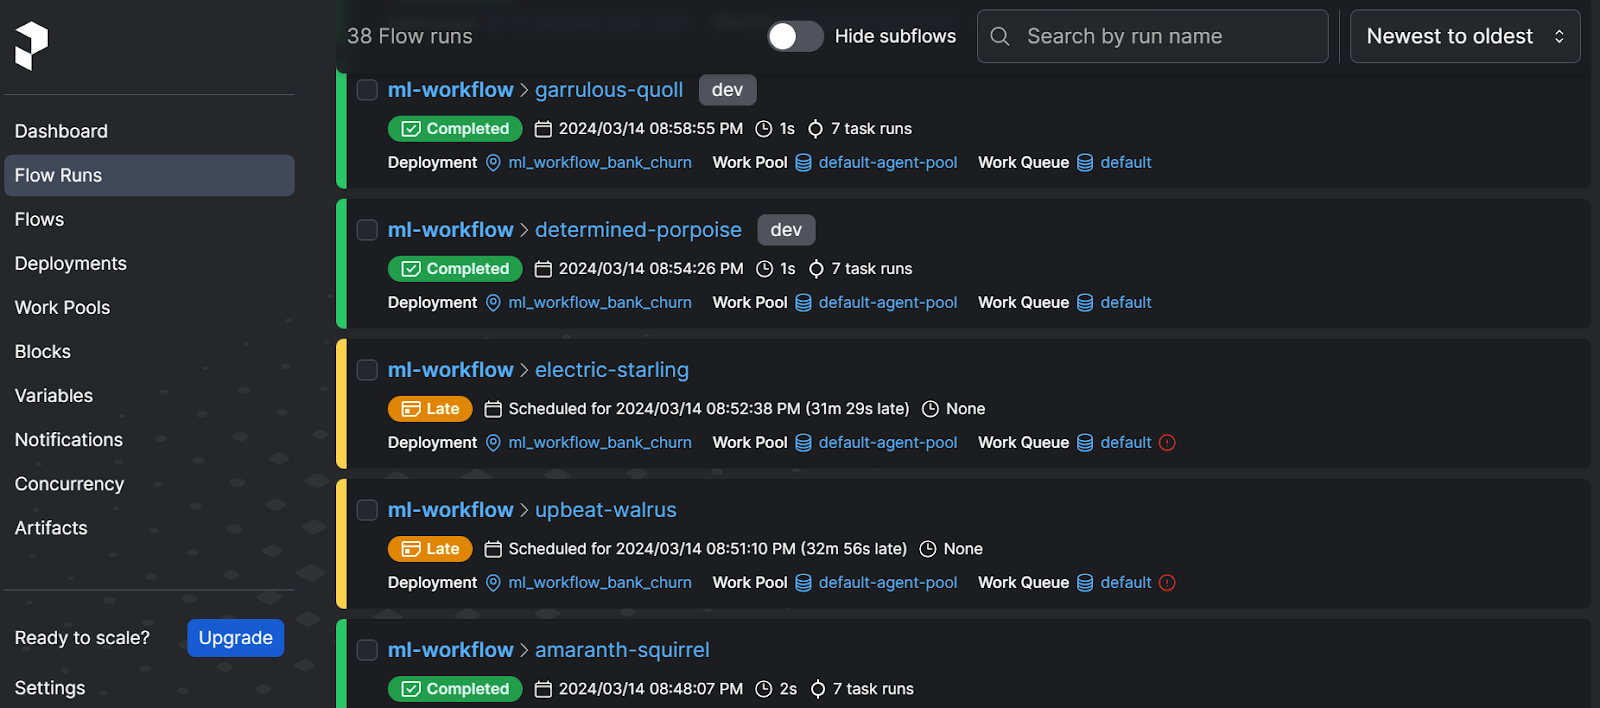
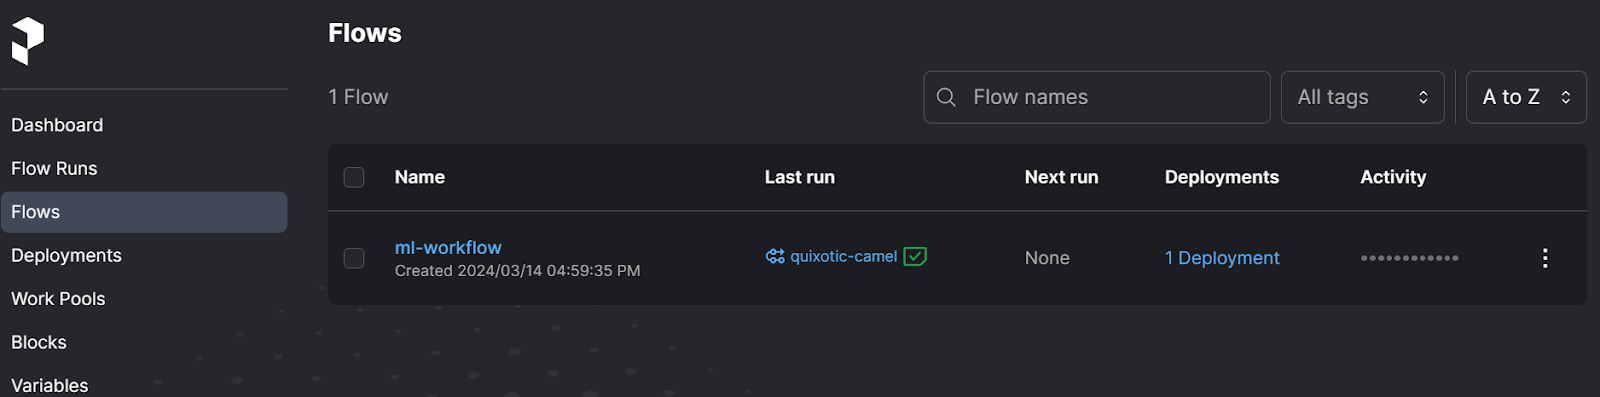
Al hacer clic en la opción Flows, se muestran todos los flujos disponibles. Puede haber varios flujos dentro de un mismo despliegue.
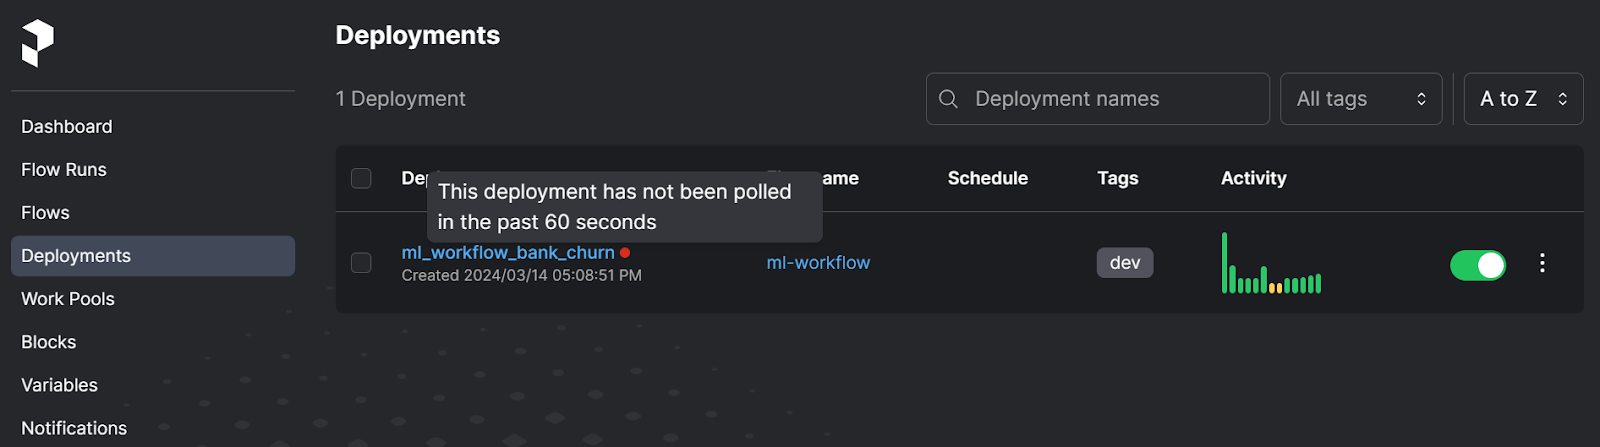
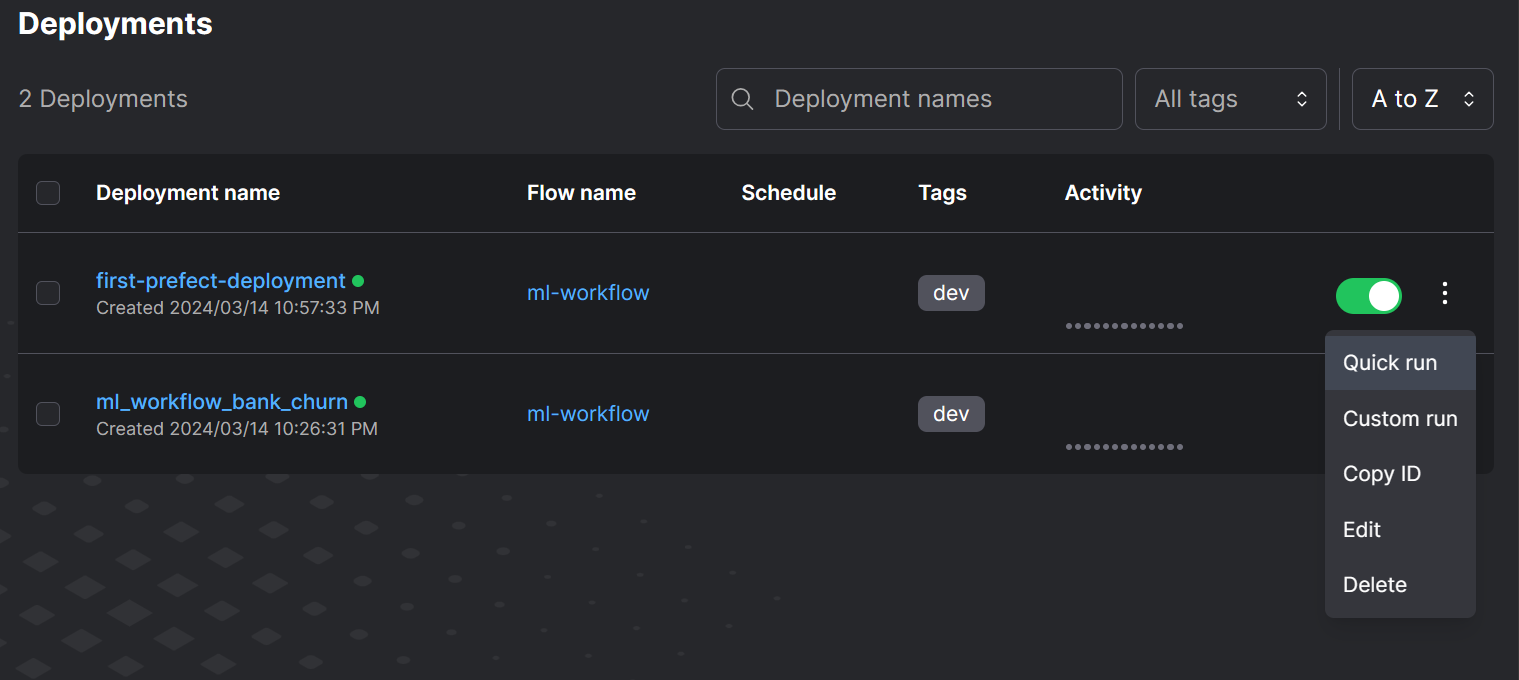
En la sección Deployment, podemos ver nuestro despliegue actual junto con su actividad y etiquetas. Desde aquí podemos ejecutar el flujo con la opción de ejecución rápida o planificarlo desde la interfaz.
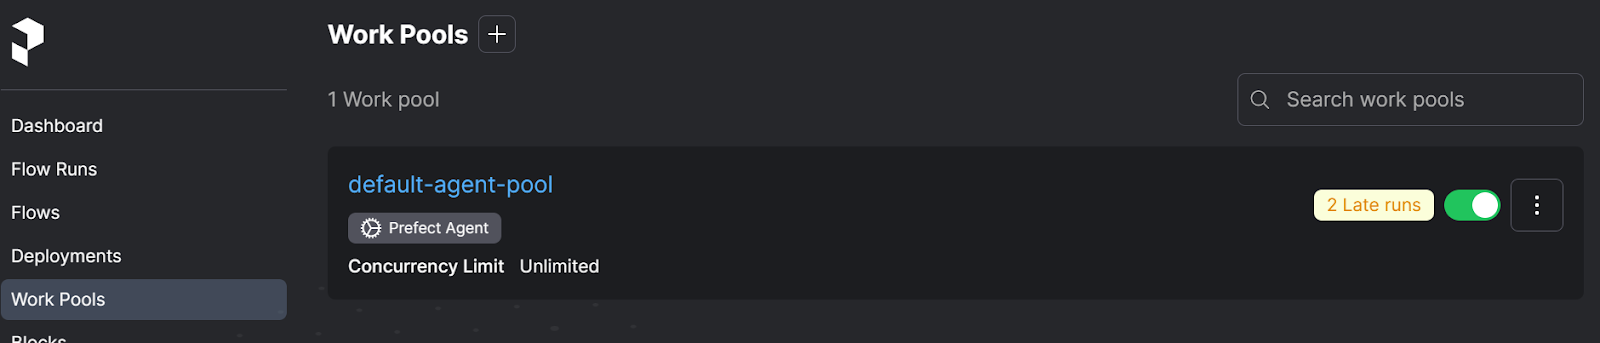
En Work Pools verás nuestro agente de Prefect por defecto. También puedes configurar un work pool en la nube usando la CLI de Prefect.
Vamos con la parte interesante.
Nadie quiere estar vigilando su flujo a todas horas. Preferimos recibir notificaciones sobre el estado del flujo en nuestra app de mensajería favorita para poder resolver cualquier incidencia rápido.
Para conseguirlo, crearemos un webhook de Discord. Con el ID y el token del webhook, configuraremos la notificación en Prefect. Enviará toda la información de los logs al servidor de Discord.
Para crear un webhook, ve a la configuración de tu servidor de Discord, haz clic en "Integrations" y selecciona "View Webhooks". Luego, pulsa "New Webhook".
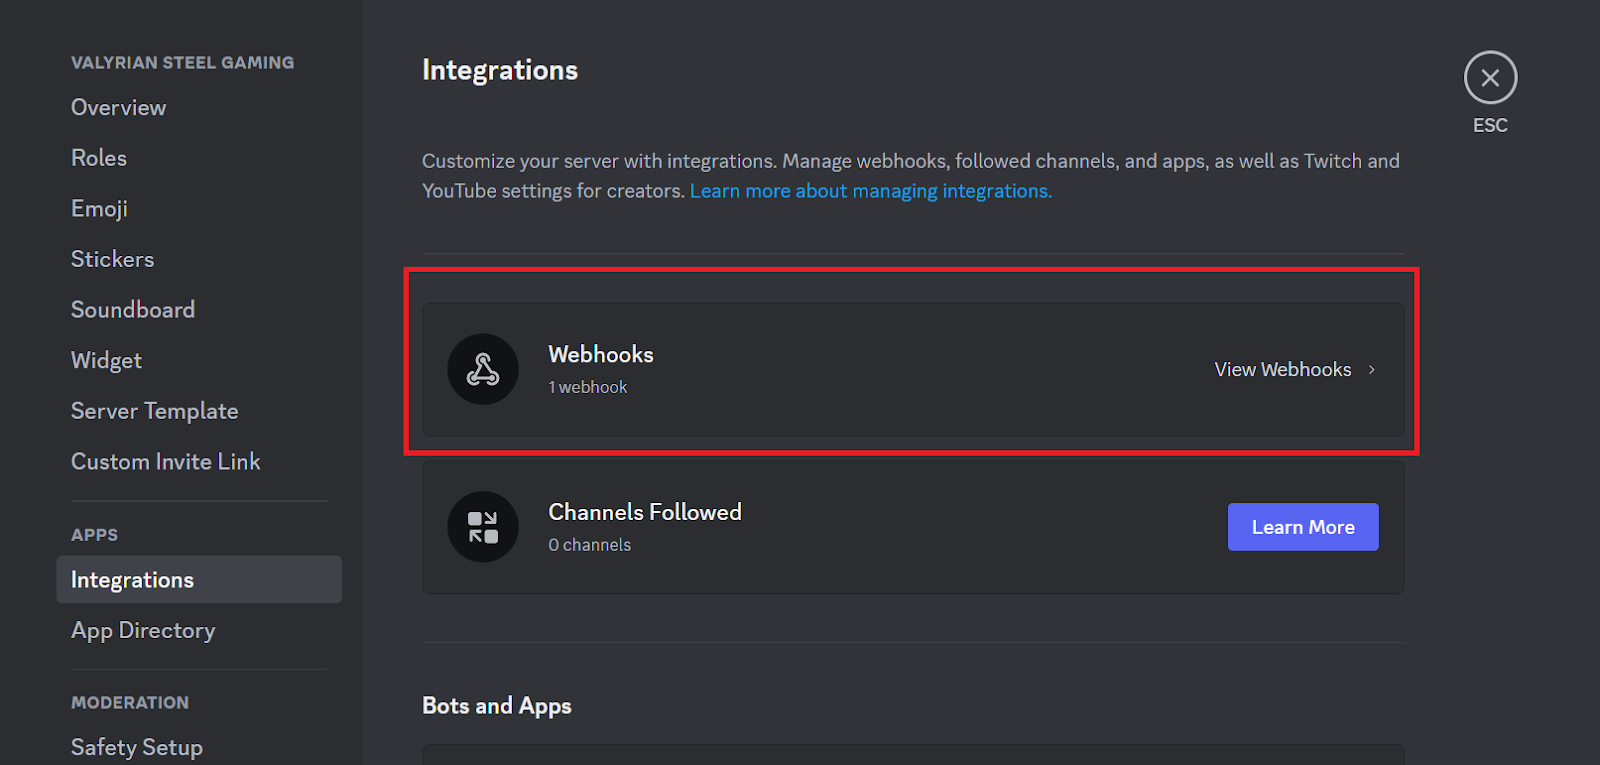
Cambia la imagen, el nombre y el canal. Luego, copia la URL del webhook.
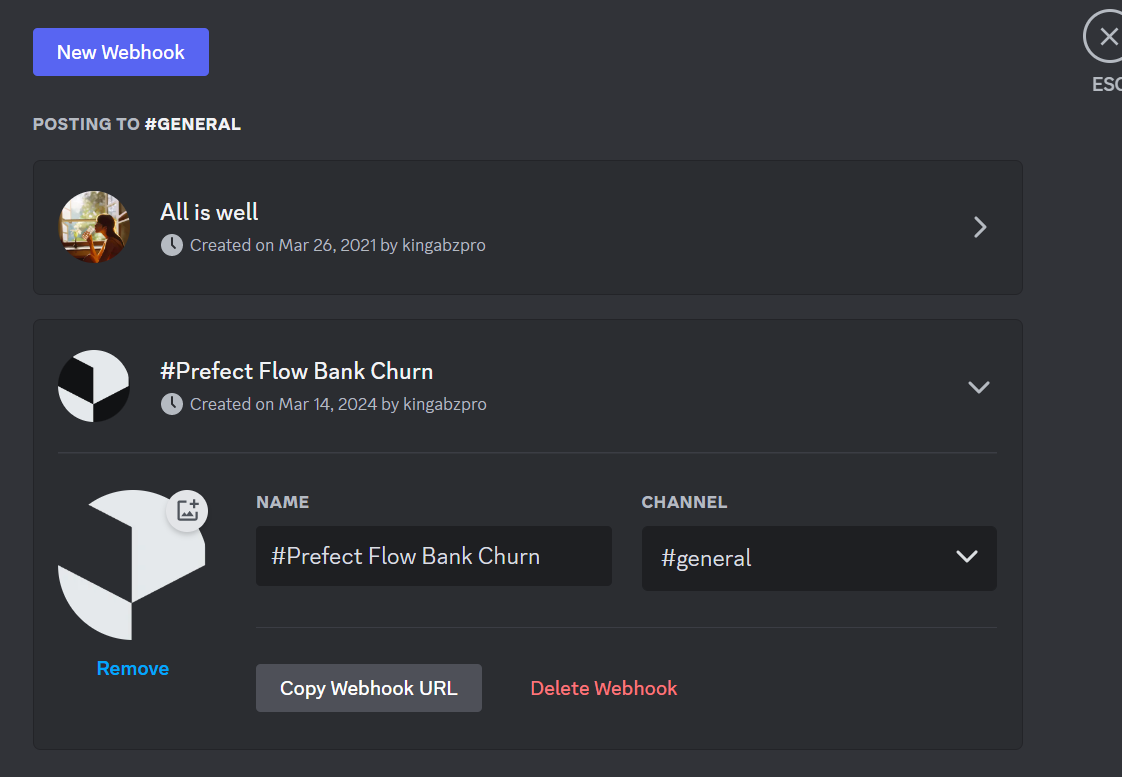
La URL del webhook tiene dos partes: el ID del webhook y el token del webhook: https://discord.com/api/webhooks/<webhook_id>/<webhook_token>. Para crear una notificación en Prefect, debemos separar manualmente estas dos partes del enlace.
Para crear una notificación de Discord en la interfaz de Prefect, ve a la opción "Notifications" y haz clic en el botón "+" de la parte superior. Después, selecciona los estados de ejecución deseados, etiquetas, el webhook de Discord y el tipo de notificación.
A continuación, introduce el Webhook ID y el Webhook token y haz clic en el botón azul "Create".
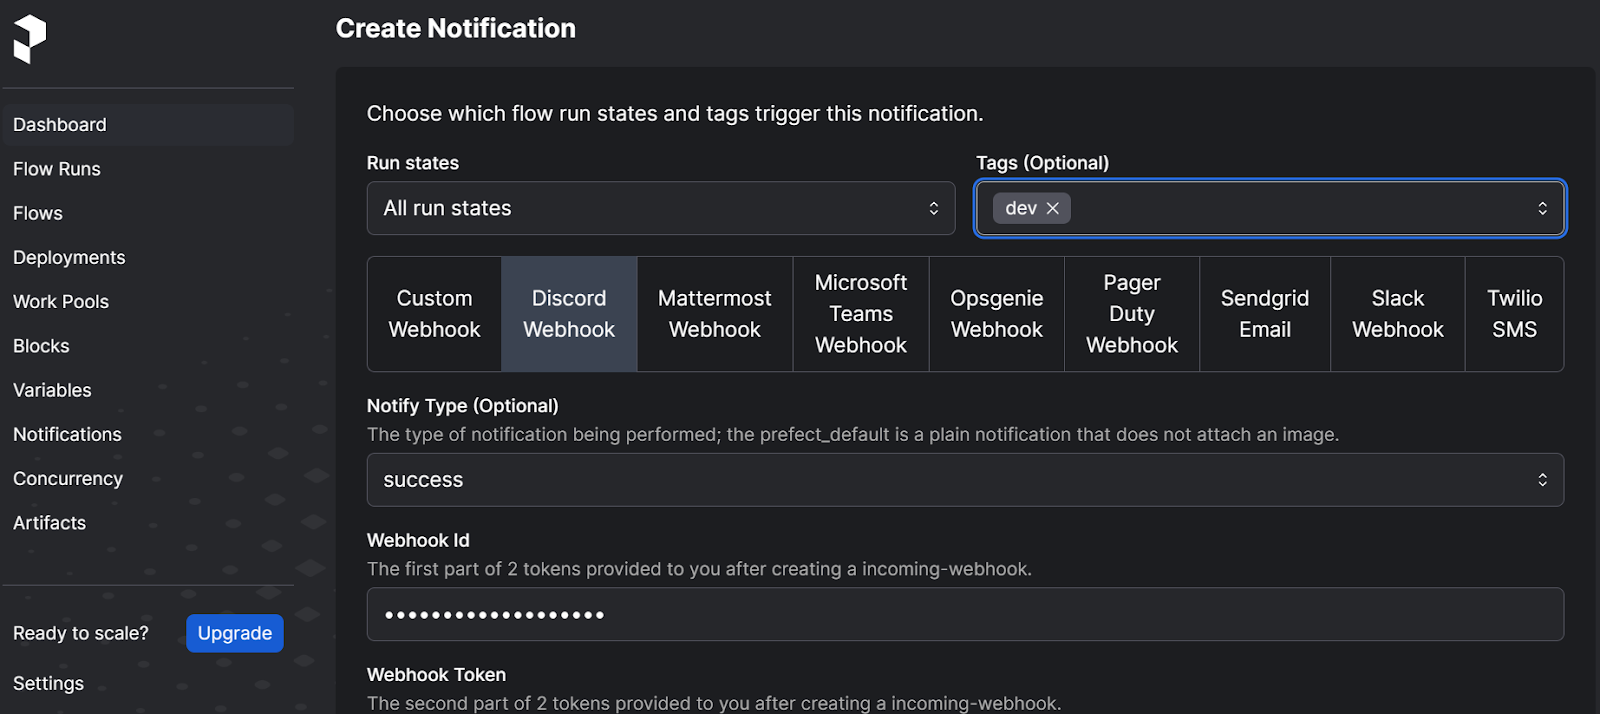
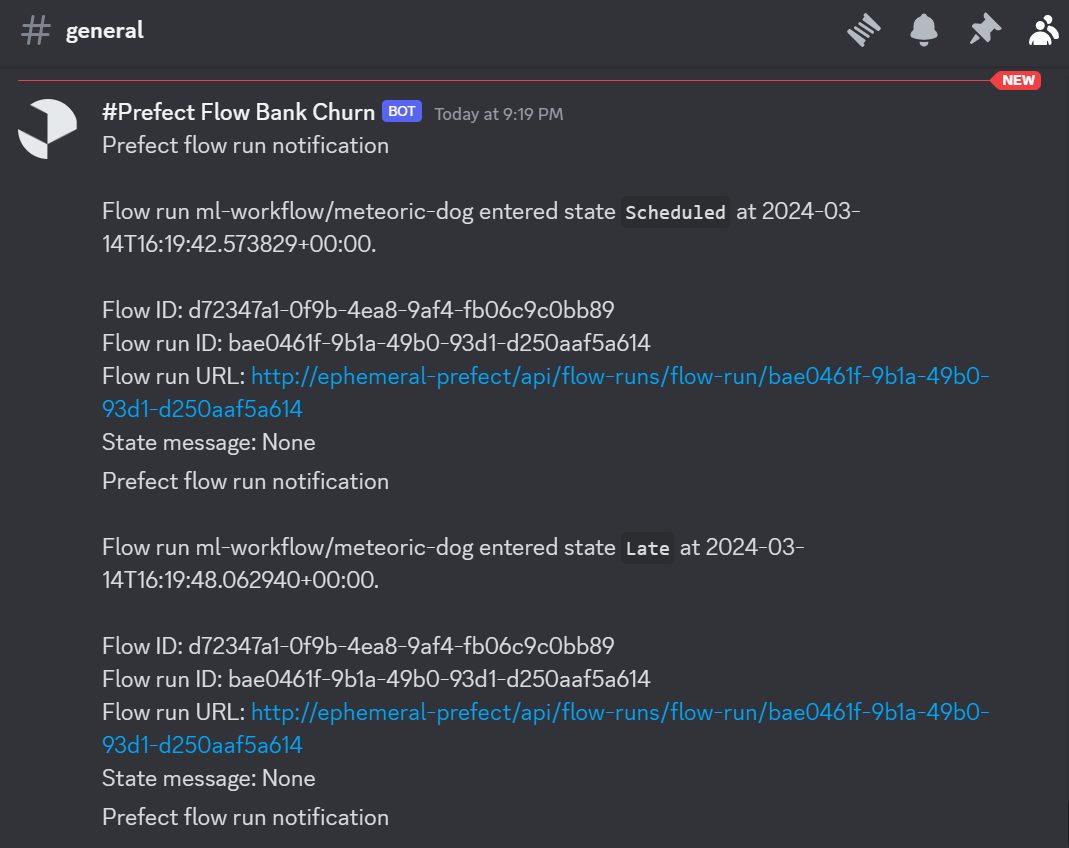
Necesitamos ejecutar el despliegue para ver las notificaciones en el canal principal de nuestro servidor de Discord.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Genial. Con el mismo método, podemos configurar servicios como Microsoft Teams, Slack, SMS y email, e incluso crear nuestro propio webhook personalizado.
Realiza el curso Designing Machine Learning Workflows in Python para aprender a construir canalizaciones que resistan el paso del tiempo.
Después de desplegar nuestro flujo de machine learning en local, toca desplegarlo en Prefect Cloud. Es un proceso mucho más sencillo que los despliegues locales, ya que no tienes que iniciar servidores ni agentes ni ejecutar las ejecuciones desde la CLI. Prefect lo gestiona todo.
Antes de desplegar el flujo actual, es importante tener en cuenta que dará un error al intentar acceder a archivos y datos de un directorio local que no es accesible desde la nube. Para que estos archivos estén disponibles en Prefect Cloud, debemos crear y subir nuestro código a un repositorio público de GitHub.
Puedes hacerlo fácilmente desde la web de GitHub o usando la extensión de Git de VSCode para crear el repositorio remoto y subir el código desde la interfaz.
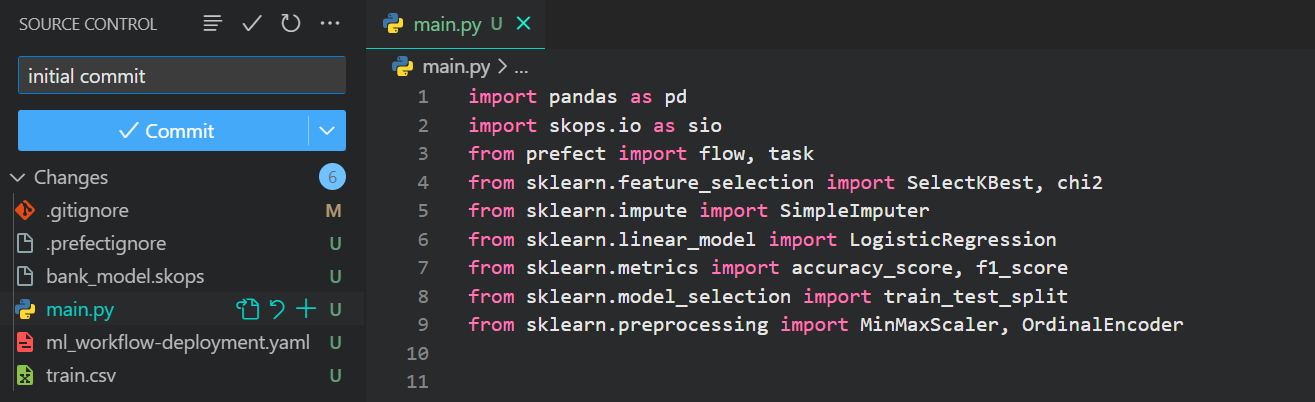
Este es el repositorio del proyecto que usaremos para los despliegues en la nube: kingabzpro/ML-Workflow-Orchestration-With-Prefect
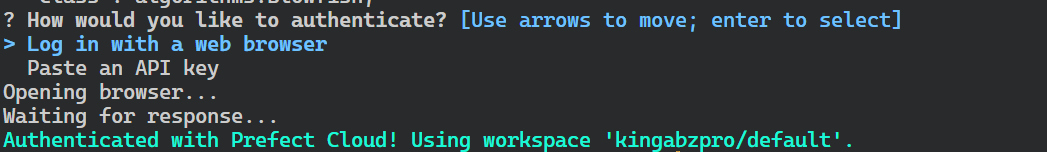
Crea tu cuenta de Prefect Cloud en https://app.prefect.cloud/auth/login y luego inicia sesión usando la herramienta CLI de Prefect.
$ prefect cloud loginElige "Log in with a web browser" y sigue los pasos para autenticar el cliente local con Prefect Cloud.
Crearemos un work pool gestionado por Prefect para aprovechar al máximo la infraestructura de Prefect Cloud en lugar de usar nuestro agente local.
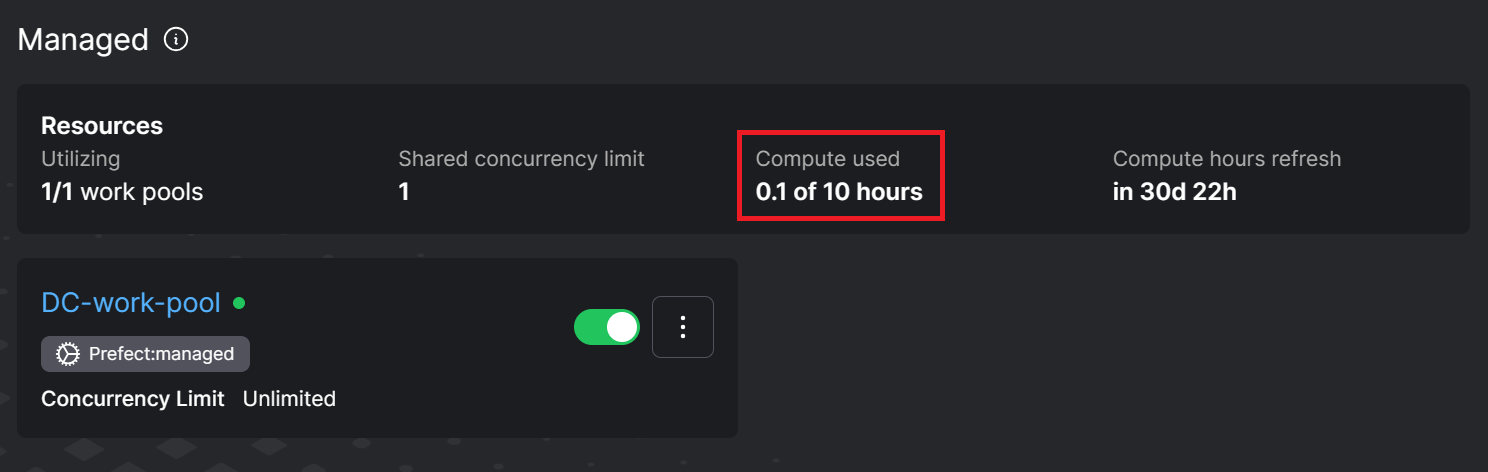
$ prefect work-pool create DC-work-pool --type prefect:managedCon una cuenta gratuita, Prefect ofrece 10 horas de cómputo al mes para que experimentes y pruebes.
Ahora vamos a desplegar nuestro flujo en Prefect Cloud de forma programática.
Crea un archivo nuevo llamado deployment.py.
Configura los argumentos para la función de flujo de Prefect:
from prefect import flow

if __name__ == "__main__":
    flow.from_source(
        source="https://github.com/kingabzpro/ML-Workflow-Orchestration-With-Prefect.git",
        entrypoint="main.py:ml_workflow",
    ).deploy(
        name="first-prefect-deployment",
        work_pool_name="DC-work-pool",
        tags=["dev"],
        job_variables={"pip_packages": ["pandas", "skops", "scikit-learn"]},
    )
Ejecuta el código de Python.
$ python deployment.pyEl flujo está desplegado en Prefect Cloud. Puede ejecutarse desde la CLI o desde el panel de Prefect Cloud.
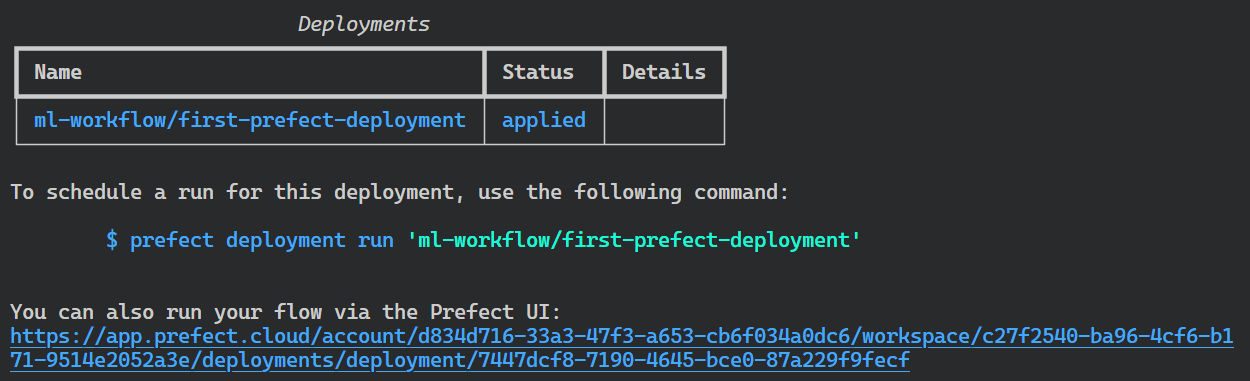
Para ejecutar el flujo, entra en https://app.prefect.cloud/. Después, ve a la sección «Deployments», haz clic en el botón vertical de tres puntos de tu despliegue y selecciona la opción «Quick run».
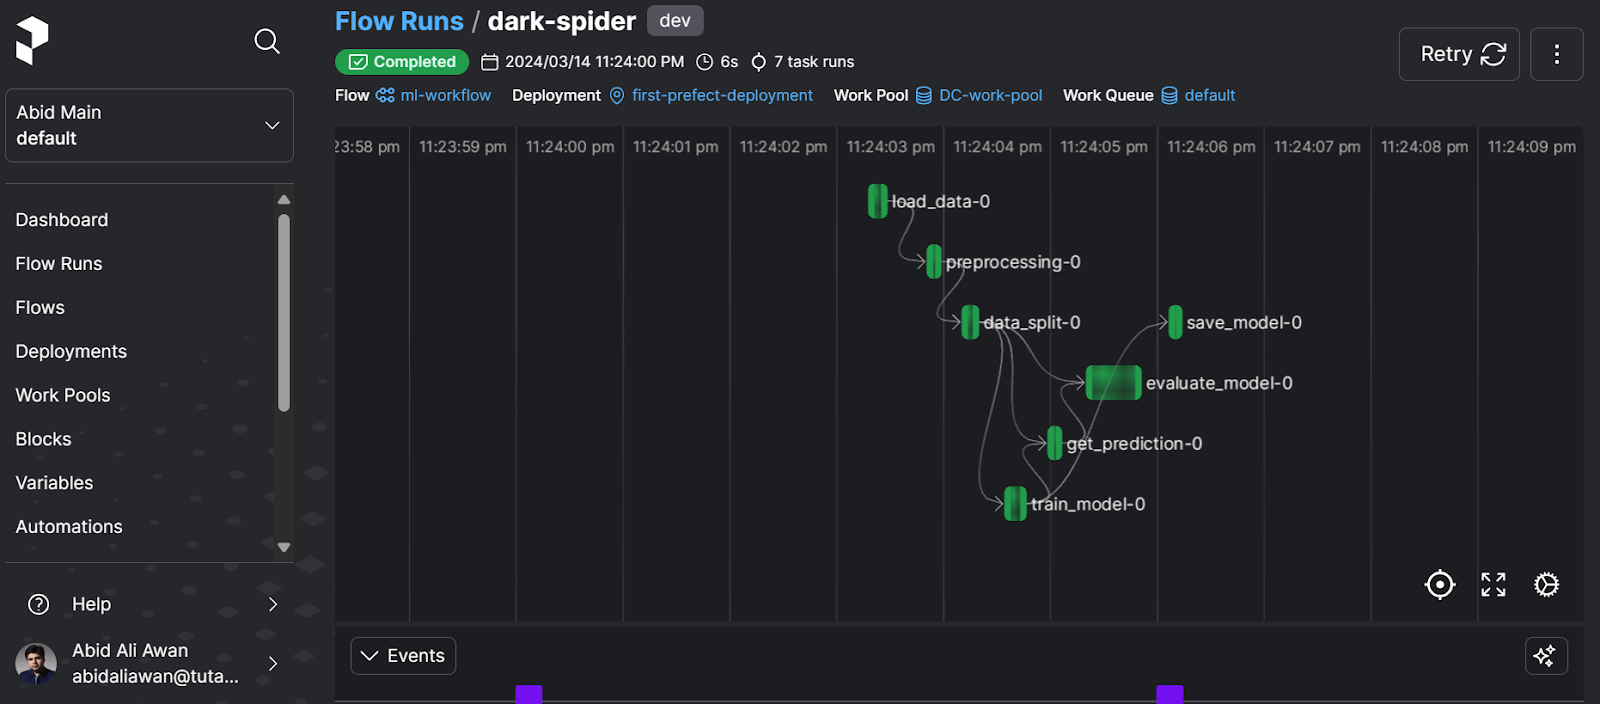
Para ver cómo progresa la ejecución, ve a la sección «Flow Run» y haz clic en la ejecución más reciente para ver el grafo del flujo.
El diagrama muestra de un vistazo cómo se interconectan las tareas y el tiempo empleado por cada proceso.
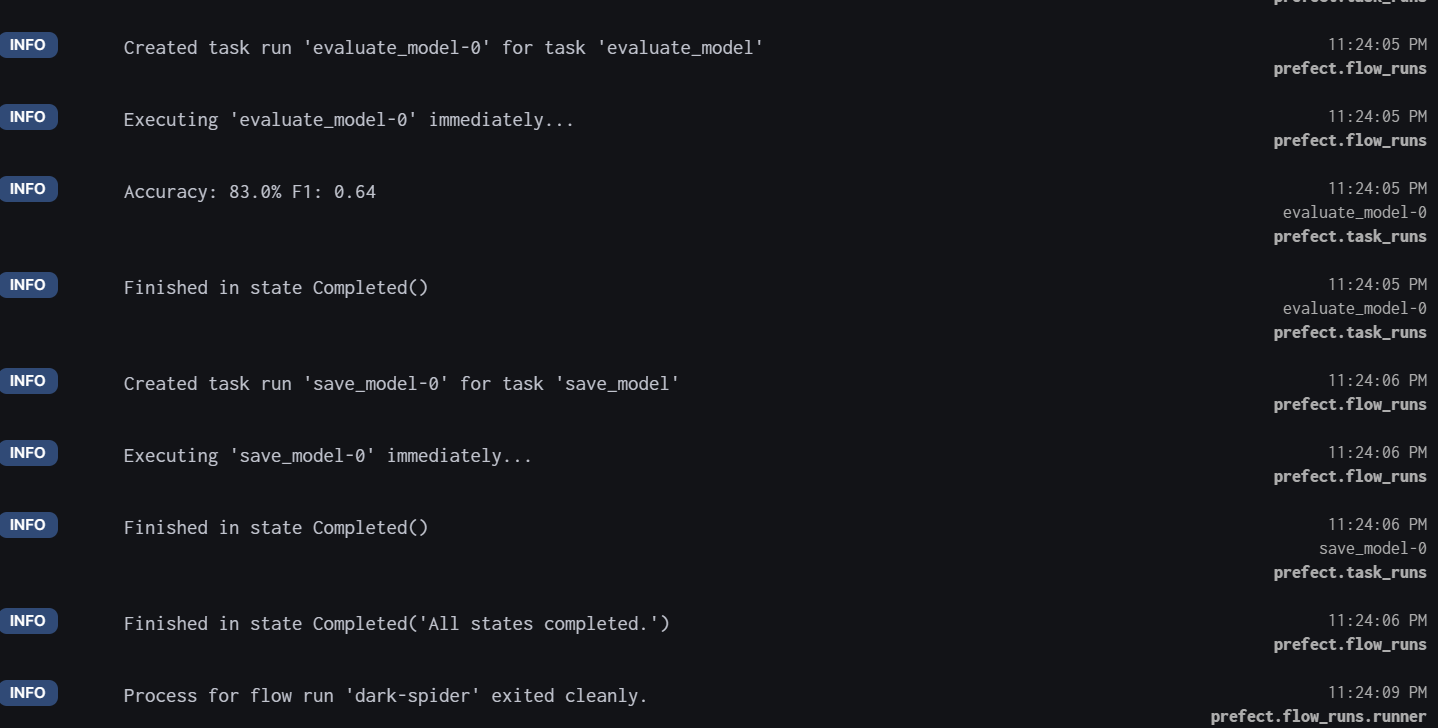
Para ver los logs en detalle, desplázate hacia abajo y consulta todas las tareas realizadas con su marca temporal.
Si vamos a la sección «Work Pools», veremos claramente que hemos usado 0,1 horas de las 10 horas disponibles para usuarios gratuitos.
Echa un vistazo a la guía Machine Learning Workflow, que incluye una infografía para ayudarte a entender las tareas de la preparación del proyecto, el tratamiento de datos, el modelado y el despliegue.
Poner en marcha un único flujo de trabajo de machine learning es sencillo. En escenarios reales, quizá necesites ejecutar varios flujos de datos y de ML a la vez. Aquí es donde Prefect destaca. Ofrece escalabilidad y flexibilidad para elegir si ejecutarlo en un entorno local o en la nube, ya sea con servidores de Prefect o work pools. Es una herramienta fantástica para planificar, automatizar y gestionar flujos de trabajo.
En este tutorial, hemos cubierto las principales funciones y capacidades del ecosistema de Prefect. También aprendimos a desplegar un flujo de ML en local y en la nube. Para continuar con tu ruta de MLOps, el siguiente paso es aprender a crear CI/CD para flujos de machine learning siguiendo "A Beginner's Guide to CI/CD for Machine Learning".
Prefect es solo una de las herramientas de orquestación de flujos de trabajo en el ámbito de MLOps. Para conocer otras herramientas clave para versionado de datos, feature stores, pruebas de modelos, despliegue y serving de modelos, monitorización, motores de ejecución y herramientas end-to-end de MLOps, lee el artículo 25 Top MLOps Tools You Need to Know in 2024. También puedes leer nuestra comparación Prefect vs Airflow para ver cómo se enfrentan ambas herramientas.
¡Continúa hoy tu camino en machine learning!
Curso
Curso
Curso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Zoumana Keita
15 min
Tutorial
Abid Ali Awan
12 min