
Curso
Projetando Workflows de Machine Learning em Python
4 h
12.7K
Neste tutorial, vamos explorar o Prefect, passando por seus principais recursos, benefícios e componentes. Você vai ver como criar tasks e flows, gerenciar deployments e executar flow runs. Por fim, vamos mostrar como publicar seu workflow no Prefect Cloud e rodá-lo usando infraestrutura em nuvem.
Se você quer saber como automatizar pipelines de machine learning usando GitHub Actions e Data Version Control, conheça nosso curso CI/CD for Machine Learning.
Prefect é uma poderosa ferramenta open source de orquestração de workflows que permite projetar, monitorar e reagir a pipelines de dados e de machine learning usando código em Python.
O Prefect vem com vários recursos, como tentativas automáticas, agendamento e cache, entre outros. É uma ferramenta robusta que permite construir workflows resilientes e dinâmicos.
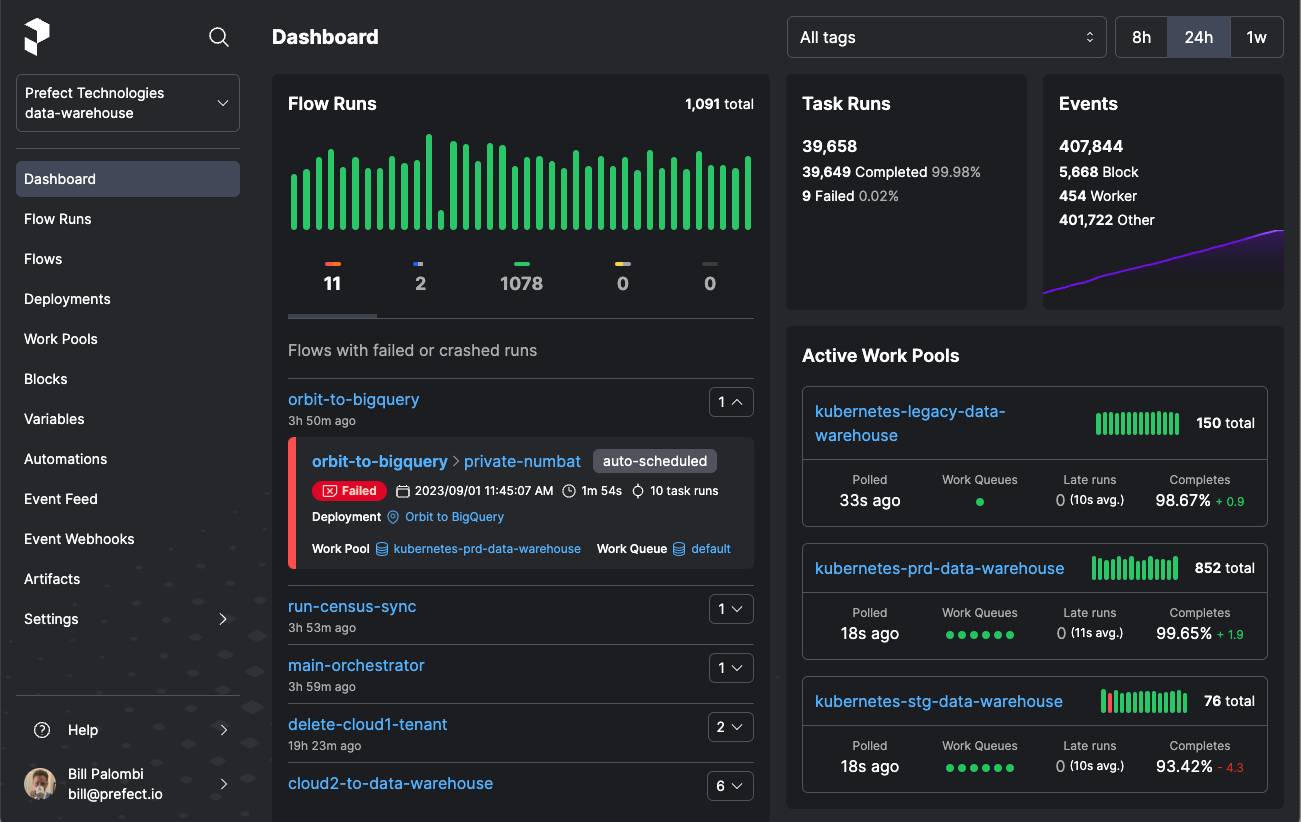
Imagem Fonte
Com o Prefect, você transforma facilmente qualquer função Python em uma unidade de trabalho que pode ser observada e orquestrada apenas adicionando alguns decoradores ao seu código.
O Prefect é ideal para padronizar o desenvolvimento e o deploy de workflows em toda a organização. Ele oferece observabilidade completa dos fluxos e permite gerenciar seu código sem depender de DAGs rígidos ou de muito boilerplate.
Com um único comando, você configura seu próprio servidor de orquestração para desenvolvimento. Esse processo simplificado facilita o desenvolvimento local e garante um deploy suave em produção.
O Prefect oferece uma interface bastante intuitiva, proporcionando uma experiência visual agradável e prática para executar, monitorar, depurar e gerenciar workflows.
O Prefect inclui recursos como agendamento, tentativas, gerenciamento nativo de segredos, capacidade de escalonamento, controle de concorrência, opções flexíveis de configuração de infraestrutura e armazenamento, além de logs robustos.
Você pode fazer o self-host de um servidor Prefect open source ou usar o Prefect Cloud para aproveitar recursos avançados, alta disponibilidade e segurança reforçada.
O Prefect Cloud oferece todas as capacidades do servidor open source, com recursos adicionais como automations, feed de eventos, webhooks, workspaces, organizações e muito mais, tudo em um ambiente hospedado. Dá para usar o Prefect Cloud gratuitamente ou assinar planos com recursos mais robustos.
O Prefect permite iniciar a orquestração de workflows com um único decorador, agilizando o processo sem abstrações desnecessárias para uma gestão eficiente do workflow.
Envie informações sobre workflows e pipelines do Prefect para diversos serviços de mensagens como Slack, Discord, e-mail, Microsoft Teams e outros. Isso também pode alertar você em caso de falha.
Nesta seção, vamos cobrir os componentes-chave usados para construir tasks e flows, fazer o deploy e executar, além de gerenciar tudo. É essencial revisar esses componentes antes de entrar no tutorial em Python.
Uma Prefect Task é uma função Python decorada com o @task que representa unidades discretas de trabalho dentro de um workflow do Prefect. Você também pode customizar o decorador com argumentos opcionais como name, description, tags, configurações de cache, retries e mais.
No código abaixo, há três tasks de machine learning criadas com o decorador @task que podem ser reutilizadas em diferentes flows.
@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    ...

    # Train the model
    ...

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    ...
	return prediction

@task
def evaluate_model(y_test, prediction: pd.DataFrame):
...Um Prefect Flow é uma função Python decorada com @flow que encapsula a lógica do workflow. Isso facilita definir, configurar e executar pipelines de dados complexos com flexibilidade e simplicidade.
No código abaixo, criamos um Flow usando o decorador @flow. O flow executa todas as tasks de forma sequencial, passando as saídas de uma para a outra.
@flow
def ml_workflow():
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)

if __name__ == "__main__":
    ml_workflow()
Deployments são flows armazenados no servidor local ou na nuvem e incluem informações importantes para orquestrar seu workflow de forma remota, como detalhes de agendamento e execução.
Work pools funcionam como mediadores entre os ambientes de orquestração e execução, possibilitando o agendamento e a execução eficientes dos flow runs. Você pode configurar seus Agents (workers) para rodar workflows localmente ou aproveitar a infraestrutura em nuvem para uma execução fluida.
Semelhante a uma instância de computação dedicada, os Work Pools gerenciam a alocação de trabalho e priorizam tarefas, oferecendo flexibilidade na escolha do ambiente de execução para desempenho e escalabilidade ideais.
Nesta seção, vamos criar, testar, fazer o deploy e executar um workflow simples de machine learning usando o Prefect. Também vamos configurar notificações para sermos avisados no nosso servidor do Discord sobre o status dos flow runs.
Instale o pacote Python com o PIP
pip install -U prefectSe quiser usar a versão mais recente do Prefect, você pode obter o código diretamente do GitHub.
pip install -U git+https://github.com/PrefectHQ/prefectVamos pré-processar o dataset de Bank Churn do Kaggle e, em seguida, usar scikit-learn para treinar e avaliar um modelo Random Forest Classifier.
O código que vamos usar é uma versão modificada deste artigo: Streamline Your Machine Learning Workflow with Scikit-learn Pipelines. Dê uma olhada nesse tutorial se quiser entender melhor como o modelo foi treinado. Nosso Prefect Flow de machine learning tem sete tasks:
Agora reunimos todas as tasks necessárias em uma função @flow chamada ml_workflow. Além disso, incluímos argumentos extras no decorador para habilitar logs detalhados.
A função ml_workflow recebe como entrada o caminho do arquivo de dados e então encadeia as diversas tasks. Vamos visualizar melhor esse workflow quando fizermos o deploy e a execução no servidor do Prefect.
Você também pode acompanhar nossos experimentos de machine learning usando MLflow. Faça o curso Introduction to MLflow para aprender sobre tracking, projects, models e model registry no MLflow.
import pandas as pd
import skops.io as sio
from prefect import flow, task
from sklearn.feature_selection import SelectKBest, chi2
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler, OrdinalEncoder


@task
def load_data(filename: str):
    bank_df = pd.read_csv(filename, index_col="id", nrows=1000)
    bank_df = bank_df.drop(["CustomerId", "Surname"], axis=1)
    bank_df = bank_df.sample(frac=1)
    return bank_df


@task
def preprocessing(bank_df: pd.DataFrame):
    cat_col = [1, 2]
    num_col = [0, 3, 4, 5, 6, 7, 8, 9]

    # Filling missing categorical values
    cat_impute = SimpleImputer(strategy="most_frequent")
    bank_df.iloc[:, cat_col] = cat_impute.fit_transform(bank_df.iloc[:, cat_col])

    # Filling missing numerical values
    num_impute = SimpleImputer(strategy="median")
    bank_df.iloc[:, num_col] = num_impute.fit_transform(bank_df.iloc[:, num_col])

    # Encode categorical features as an integer array.
    cat_encode = OrdinalEncoder()
    bank_df.iloc[:, cat_col] = cat_encode.fit_transform(bank_df.iloc[:, cat_col])

    # Scaling numerical values.
    scaler = MinMaxScaler()
    bank_df.iloc[:, num_col] = scaler.fit_transform(bank_df.iloc[:, num_col])
    return bank_df


@task
def data_split(bank_df: pd.DataFrame):
    # Splitting data into training and testing sets
    X = bank_df.drop(["Exited"], axis=1)
    y = bank_df.Exited

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.3, random_state=125
    )
    return X_train, X_test, y_train, y_test
    # Identify numerical and categorical columns


@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    KBest = SelectKBest(chi2, k="all")
    X_train = KBest.fit_transform(X_train, y_train)
    X_test = KBest.transform(X_test)

    # Train the model
    model = LogisticRegression(max_iter=1000, random_state=125)
    model.fit(X_train, y_train)

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    return model.predict(X_test)


@task
def evaluate_model(y_test, prediction: pd.DataFrame):
    accuracy = accuracy_score(y_test, prediction)
    f1 = f1_score(y_test, prediction, average="macro")

    print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))


@task
def save_model(model: LogisticRegression):
    sio.dump(model, "bank_model.skops")


@flow(log_prints=True)
def ml_workflow(filename: str = "train.csv"):
    data = load_data(filename)
    prep_data = preprocessing(data)
    X_train, X_test, y_train, y_test = data_split(prep_data)
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)
    save_model(model)


if __name__ == "__main__":
    ml_workflow()
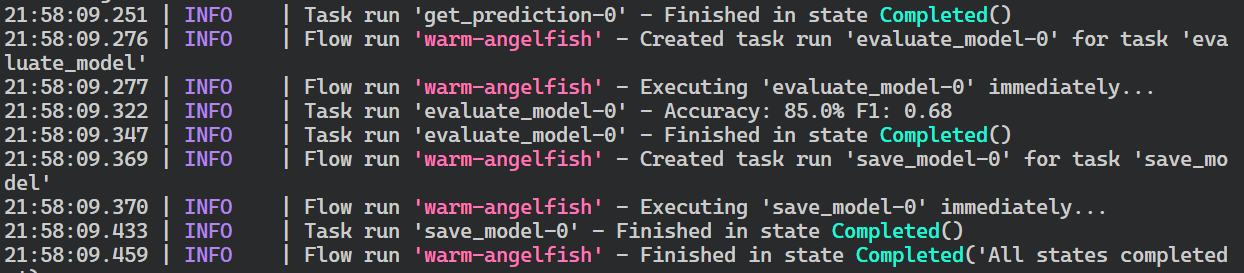
Para testar nosso Prefect Flow, execute o arquivo Python no terminal.
$ python main.pyO flow foi concluído com sucesso. Ele exibiu as métricas do modelo e salvou os pesos.
Se você está começando em machine learning e quer aprender a fazer o pré-processamento dos dados, treinar, otimizar, avaliar e salvar seu modelo, vale a pena fazer a trilha de carreira Machine Learning Scientist with Python. Ela cobre tudo o que você precisa desde o início.
Construir e rodar um pipeline de machine learning manualmente é simples e pode ser feito até com pipelines do scikit-learn.
Mas usar o Prefect traz vários benefícios, como:
Agora, vamos automatizar nosso workflow publicando-o no servidor local do Prefect.
Primeiro, precisamos criar o "Deployment" informando o arquivo e o nome da função do flow. Também vamos adicionar a tag "dev" ao nosso Deployment.
Observação: tags no Prefect ajudam a categorizar e organizar flows, tasks e deployments dentro do ecossistema.
$ prefect deployment build main.py:ml_workflow -n 'ml_workflow_bank_churn' -a --tag devO deployment foi criado com sucesso. Agora, ele fornece instruções sobre como executar o flow usando o Prefect Agent.
Found flow 'ml-workflow'
Deployment YAML created at
'C:\Repository\GitHub\ML-Workflow-Orchestration-With-Prefect\ml_workflow-deployment.yaml'.
Deployment storage None does not have upload capabilities; no files uploaded.  Pass --skip-upload to
suppress this warning.
Deployment 'ml-workflow/ml_workflow_bank_churn' successfully created with id
'ce30d1c7-f454-4064-870c-429a8039c194'.

To execute flow runs from this deployment, start an agent that pulls work from the
'default-agent-pool' work pool:
$ prefect agent start -p 'default-agent-pool'Os agentes do Prefect são responsáveis por monitorar os work pools para identificar flow runs disponíveis e enviá-los ao ambiente de execução.
Um único work pool pode ter vários agentes, cada um com um ID exclusivo para evitar sobreposição e permitir escalabilidade sem atritos.
Agora vamos iniciar os agentes do Prefect em um novo terminal com o nome padrão do work pool.
$ prefect agent start -p 'default-agent-pool'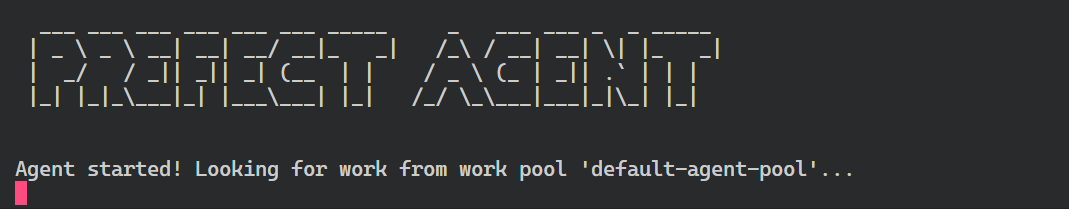
Abra um novo terminal e rode o deployment informando "nome_da_função_do_flow/nome_do_deployment". Você também pode usar apenas o nome do deployment para executar o flow.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Foi criado um flow run para o deployment, que vai procurar por workers e iniciar a execução do workflow.
Creating flow run for deployment 'ml-workflow/ml_workflow_bank_churn'...
Created flow run 'cryptic-potoo'.
└── UUID: 77833ee3-0f7e-42f9-8002-0a562c7d3ed4
└── Parameters: {}
└── Scheduled start time: 2024-03-14 21:30:40 PKT (now)
└── URL: <no dashboard available>
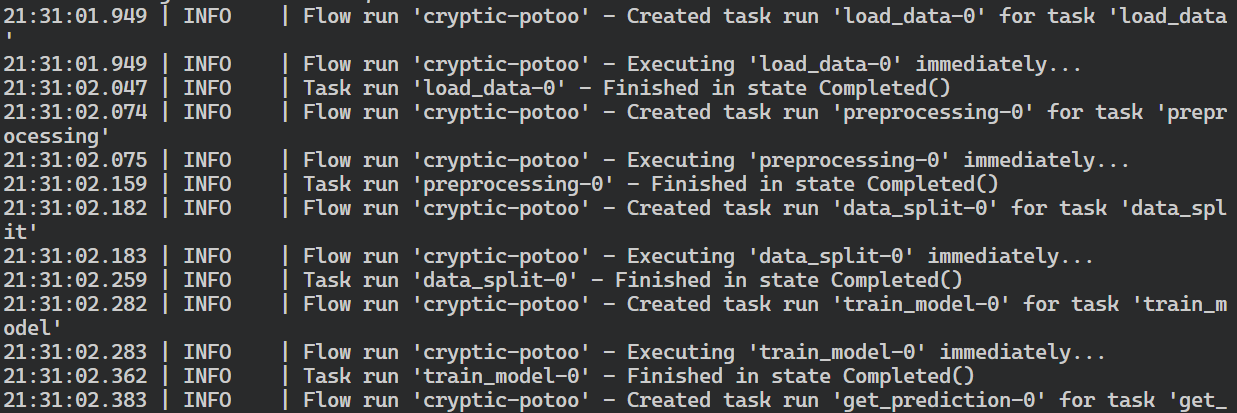
Volte ao terminal onde iniciamos o agent para ver os logs do flow run. O Prefect agent executou com sucesso todas as tasks do flow.
Este é um exemplo simples. Também podemos agendar ou automatizar o workflow passando argumentos adicionais ao build do Deployment.
Até agora, acompanhamos nosso workflow pelos terminais. Agora, vamos abrir o dashboard do Prefect para ver todos os flow runs, deployments, work pool e notificações.
Inicie o servidor do Prefect em um novo terminal e clique no link local para acessar o dashboard.
$ prefect server start
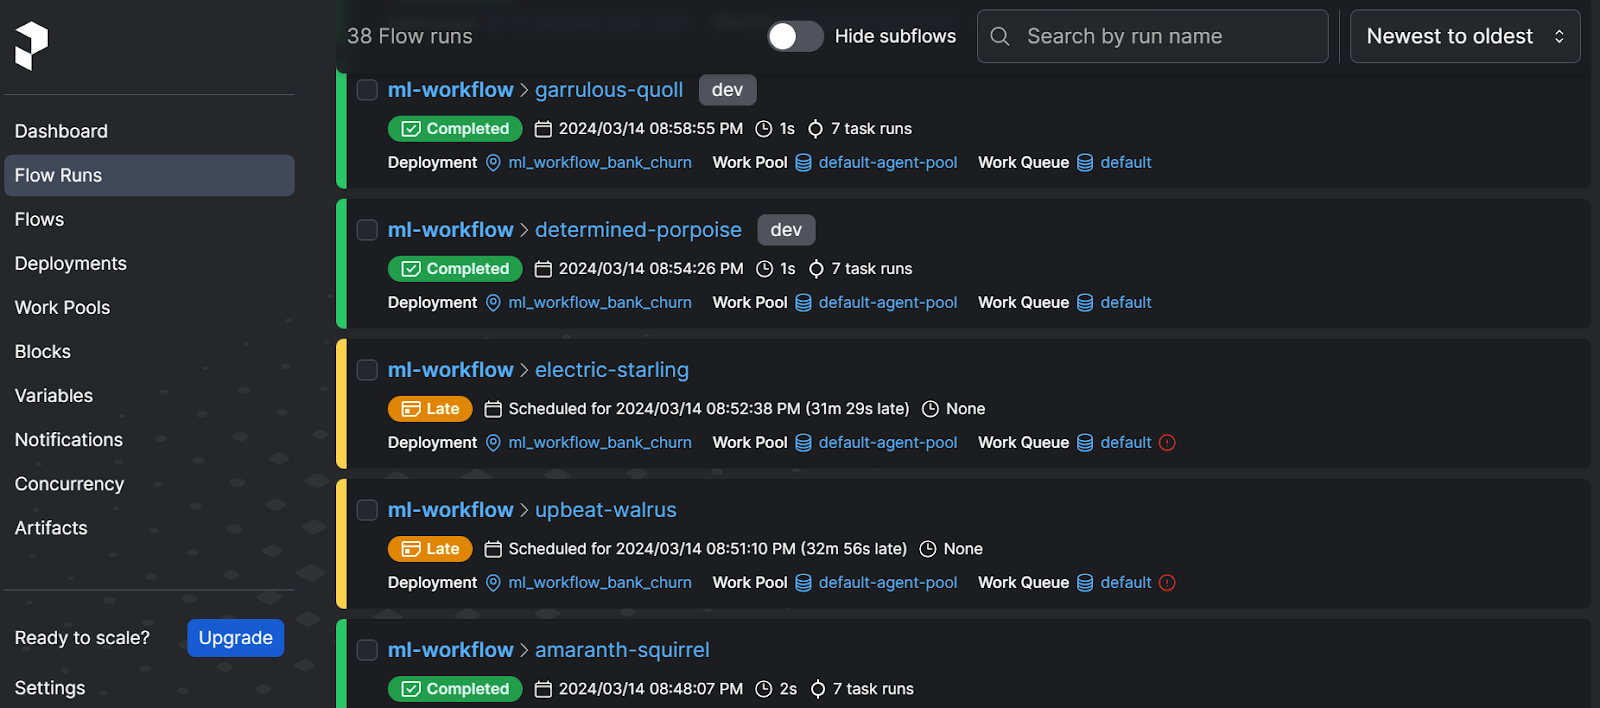
Para ver todos os flows executados anteriormente, clique em "Flow" no painel esquerdo. Você pode notar que alguns flows não foram executados por falta de work pools, enquanto outros rodaram sem a tag "dev" durante a fase de experimentação.
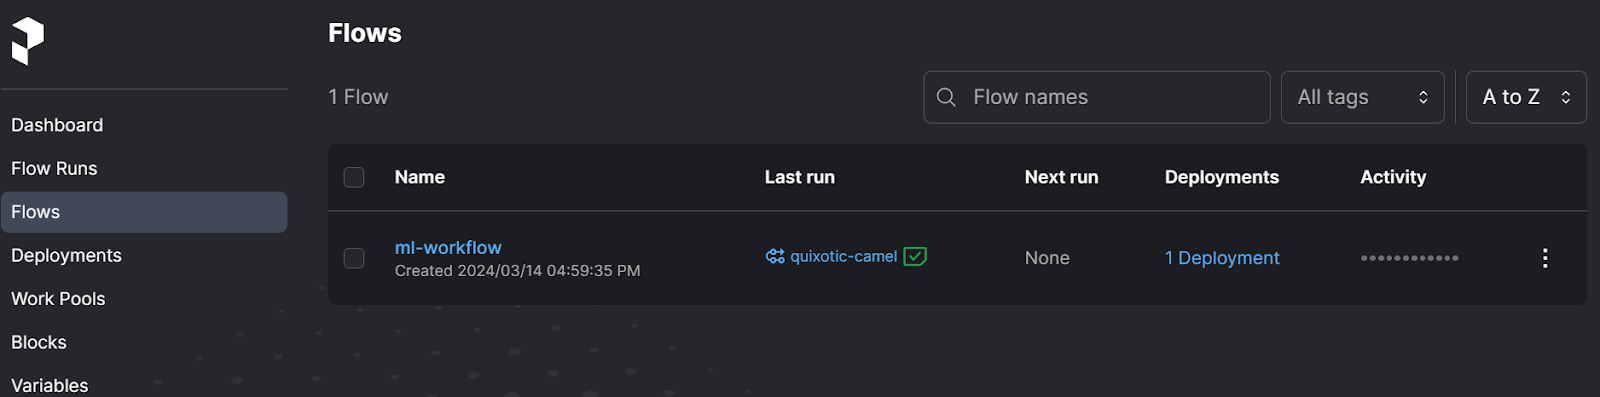
Ao clicar na opção Flows, são exibidos todos os flows disponíveis. Um único deployment pode conter vários flows.
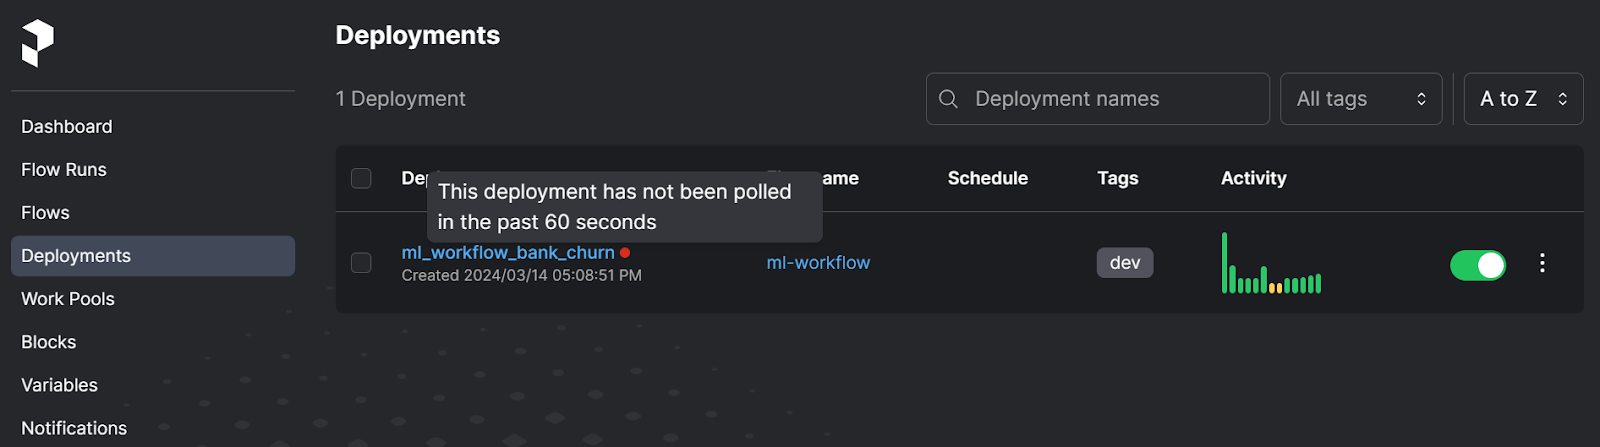
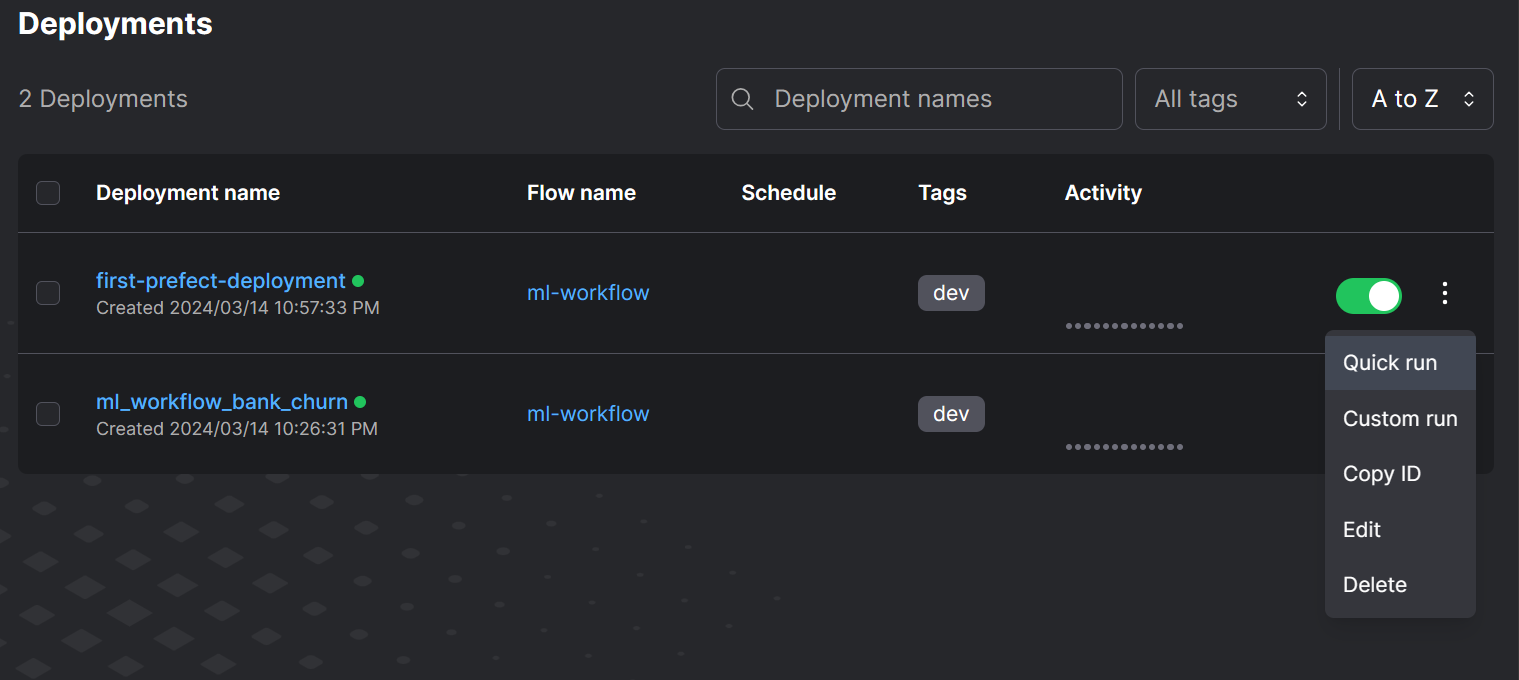
Na seção Deployment, podemos ver nosso Deployment atual com sua atividade e tags. Aqui, dá para executar o flow rapidamente ou agendar a execução pela interface.
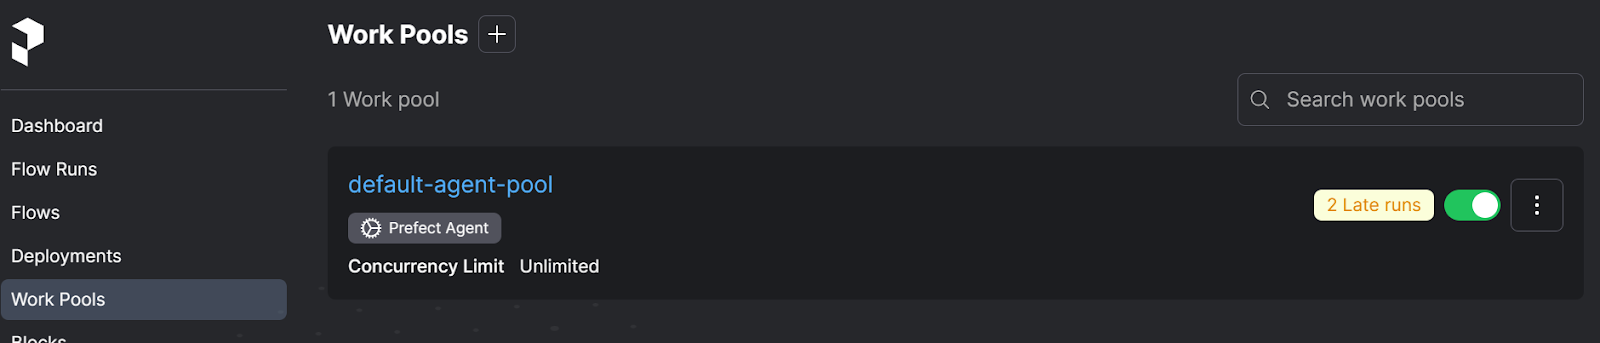
Em Work Pools, você verá nosso Prefect Agent padrão. Também é possível configurar um work pool em nuvem usando a CLI do Prefect.
Vamos à parte interessante.
Ninguém quer monitorar o workflow 24 horas por dia. É melhor receber notificações sobre o status diretamente no app de mensagens preferido. Assim, a gente resolve qualquer problema rapidamente.
Para isso, vamos criar um webhook do Discord. Com o ID e o token do webhook, vamos configurar a notificação no Prefect. Ela vai enviar todas as informações de log para o servidor do Discord.
Para criar um webhook, vá às configurações do seu servidor no Discord, clique em "Integrations" e selecione "View Webhooks". Depois, clique em "New Webhook".
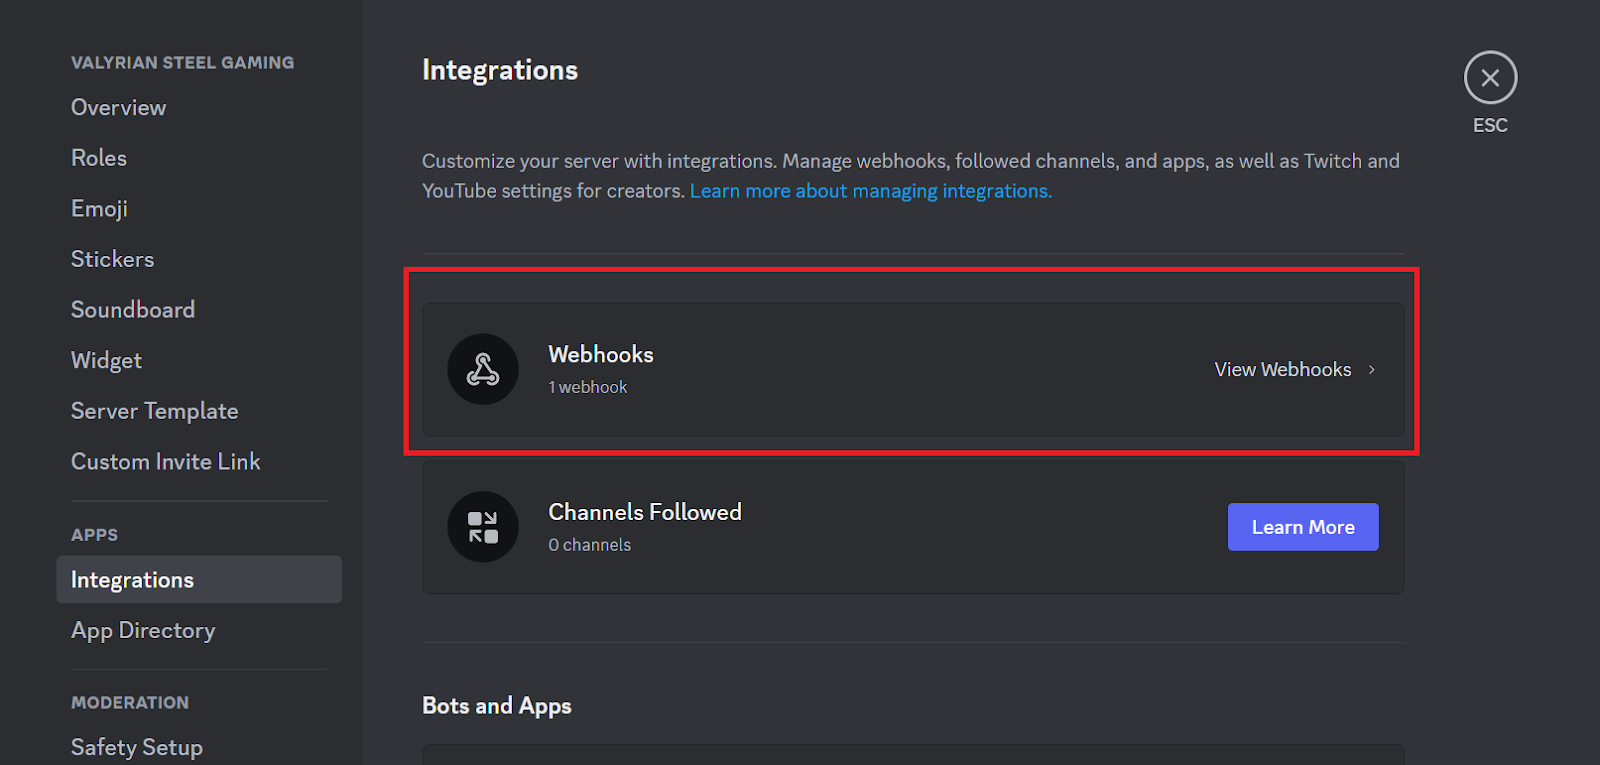
Altere a imagem, o nome e o canal. Em seguida, copie a URL do Webhook.
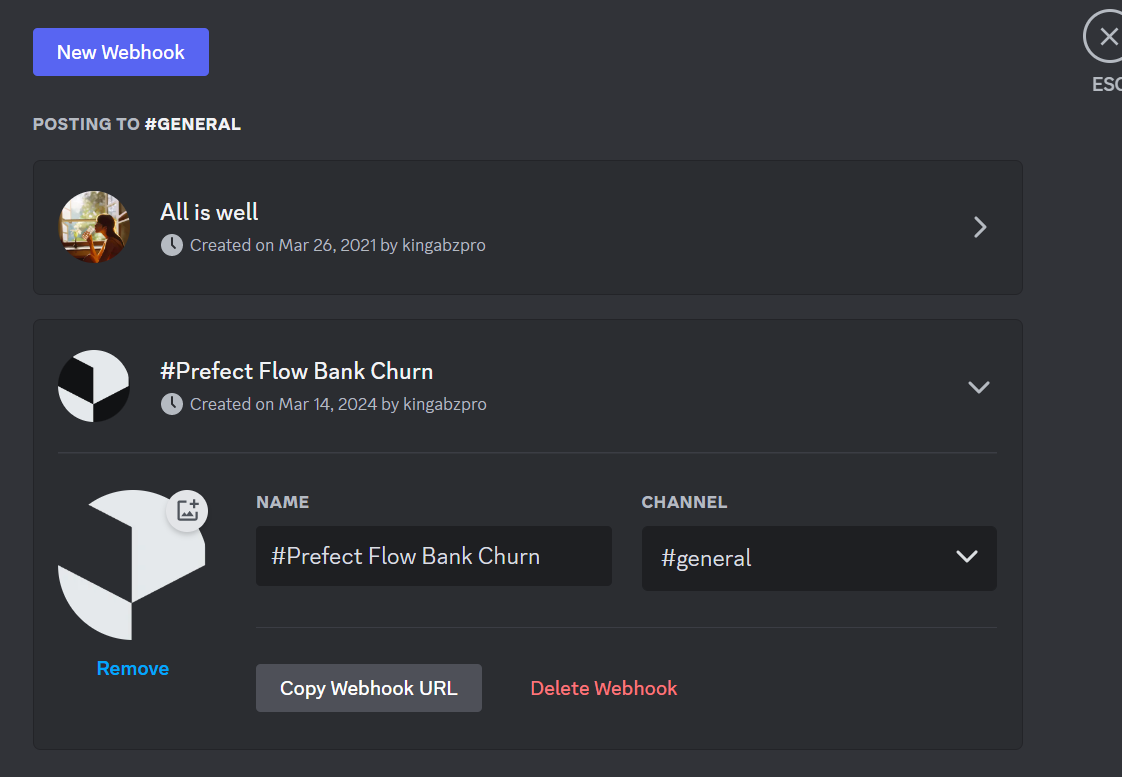
A URL do webhook tem duas partes: o Webhook Id e o Webhook token: https://discord.com/api/webhooks/<webhook_id>/<webhook_token>. Para criar a notificação no Prefect, precisamos separar manualmente essas duas partes do link.
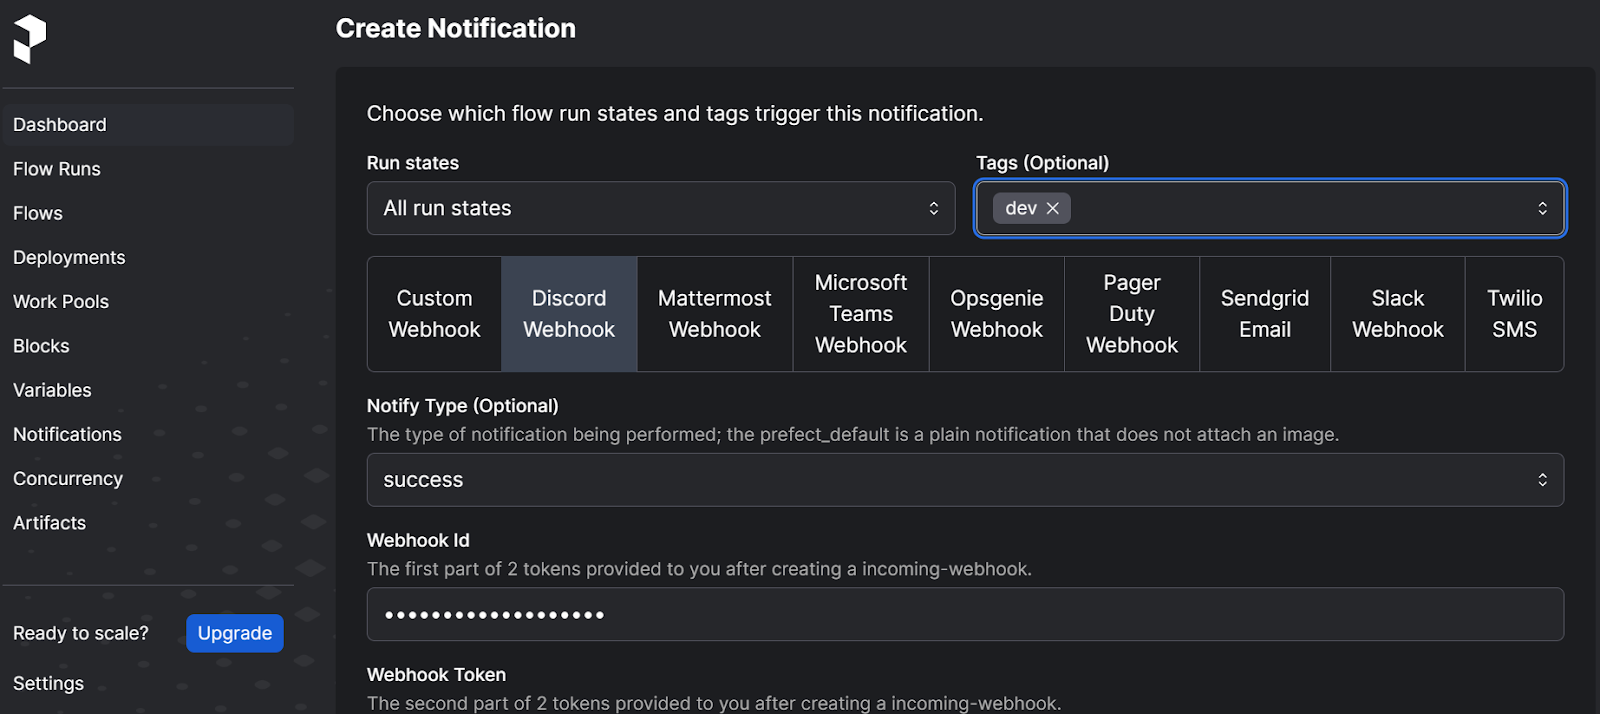
Para criar uma notificação do Discord na interface do Prefect, acesse "Notifications" e clique no botão "+" no topo. Depois, selecione os estados de execução desejados, as tags, o webhook do Discord e o tipo de notificação.
Em seguida, informe o Webhook ID e o Webhook token e clique no botão azul "Create".
Precisamos executar o deployment para ver as notificações no canal principal do nosso servidor do Discord.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Demais! Com o mesmo método, podemos configurar diversos serviços de mensagens como Microsoft Teams, Slack, SMS e e-mail, e até criar nosso próprio webhook personalizado.
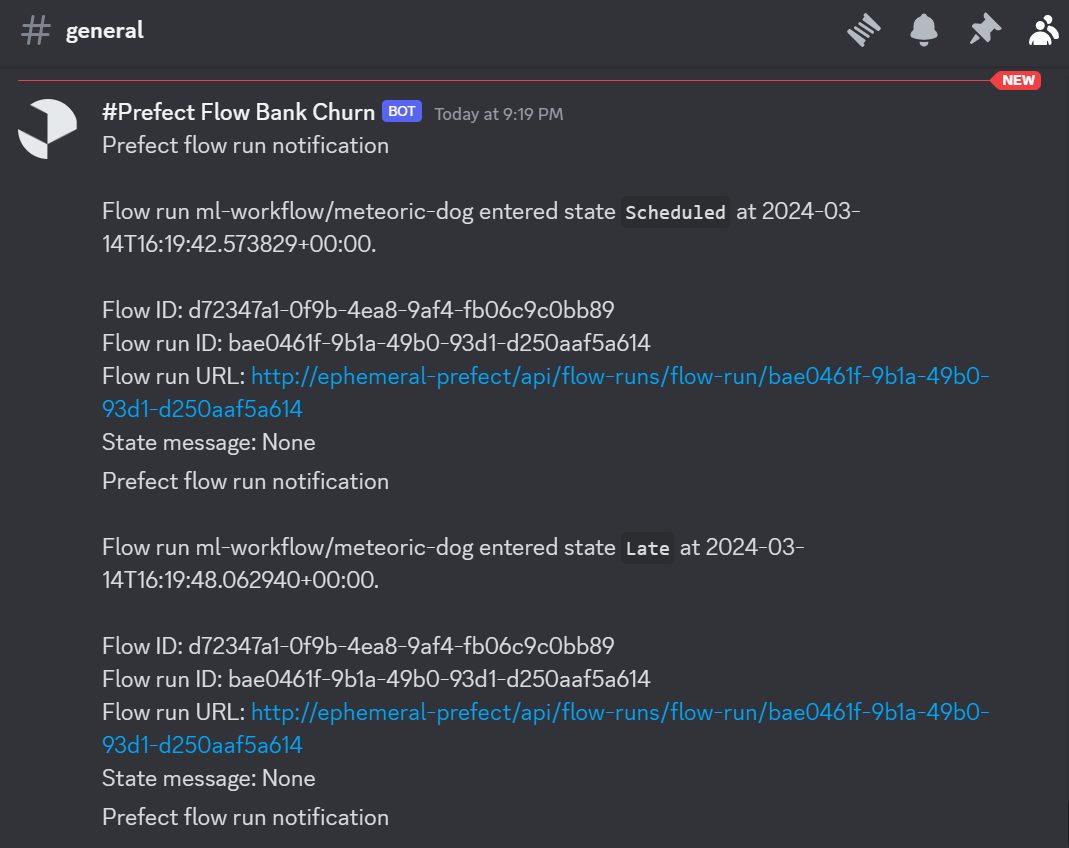
Faça o curso Designing Machine Learning Workflows in Python para aprender a construir pipelines que resistem ao tempo.
Depois de publicar nosso flow de machine learning localmente, é hora de colocá-lo no Prefect Cloud. Esse processo é ainda mais simples do que o deploy local, pois você não precisa iniciar servidores ou agents nem executar as runs via CLI. O Prefect gerencia tudo.
Antes de publicar o flow atual, vale notar que ele gerará erro ao tentar acessar arquivos e dados em um diretório local que não está acessível na nuvem. Para disponibilizar esses arquivos ao Prefect Cloud, precisamos criar e enviar nosso código para um repositório público no GitHub.
Isso pode ser feito facilmente pelo site do GitHub ou usando a extensão do Git no VSCode para criar o repositório remoto e enviar o código pela interface.
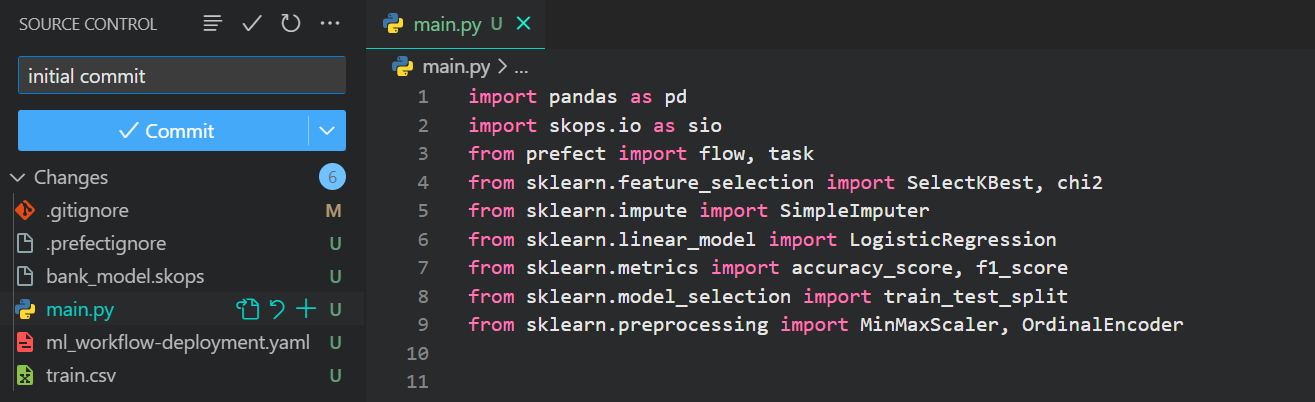
Aqui está o repositório do projeto que vamos usar nos deploys em nuvem: kingabzpro/ML-Workflow-Orchestration-With-Prefect
Crie sua conta no Prefect Cloud em https://app.prefect.cloud/auth/login e depois faça login usando a CLI do Prefect.
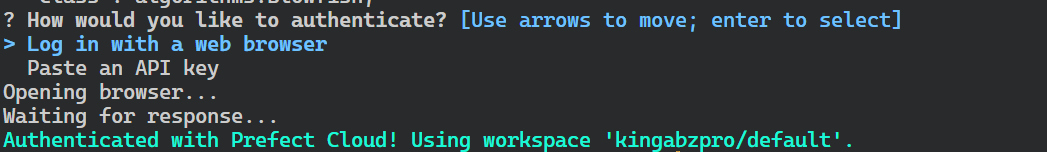
$ prefect cloud loginEscolha "Log in with a web browser" e siga os passos para autenticar o cliente local com o Prefect Cloud.
Vamos criar um work pool gerenciado pelo Prefect para usar totalmente a infraestrutura do Prefect Cloud, em vez do nosso agent local.
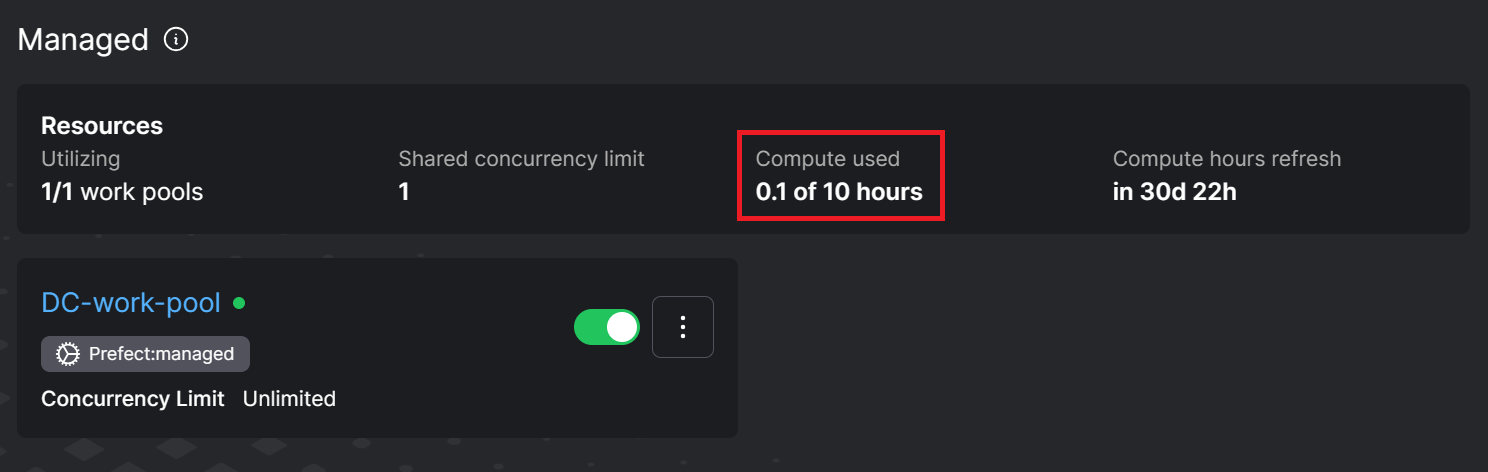
$ prefect work-pool create DC-work-pool --type prefect:managedNo plano gratuito, o Prefect oferece 10 horas de computação por mês para você testar e experimentar.
Agora vamos publicar nosso flow programaticamente no Prefect Cloud.
Crie um novo arquivo chamado deployment.py.
Defina os argumentos para a função de flow do Prefect:
from prefect import flow

if __name__ == "__main__":
    flow.from_source(
        source="https://github.com/kingabzpro/ML-Workflow-Orchestration-With-Prefect.git",
        entrypoint="main.py:ml_workflow",
    ).deploy(
        name="first-prefect-deployment",
        work_pool_name="DC-work-pool",
        tags=["dev"],
        job_variables={"pip_packages": ["pandas", "skops", "scikit-learn"]},
    )
Execute o código Python.
$ python deployment.pyO flow foi publicado no Prefect Cloud. Ele pode ser executado pela CLI ou pelo dashboard do Prefect Cloud.
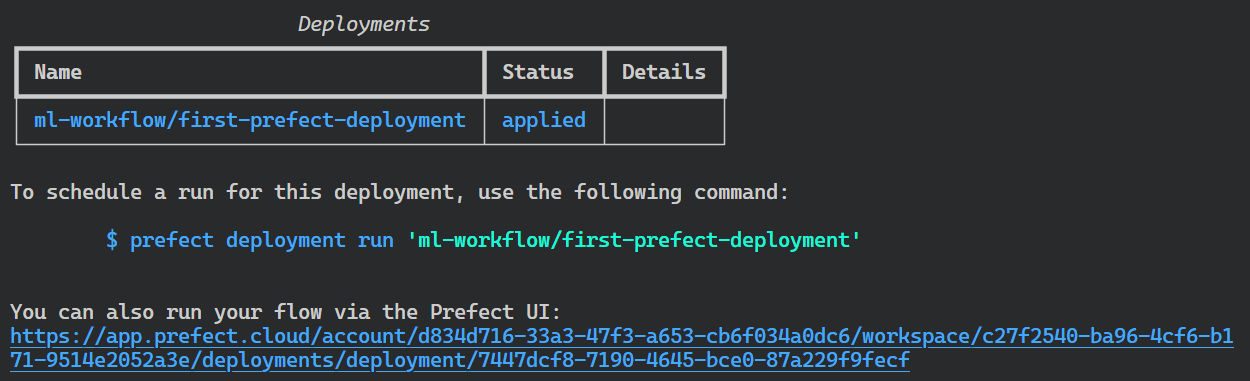
Para executar o flow, acesse: https://app.prefect.cloud/. Depois, vá até a seção "Deployments", clique no botão de três pontinhos verticais do seu deployment e selecione a opção "Quick run".
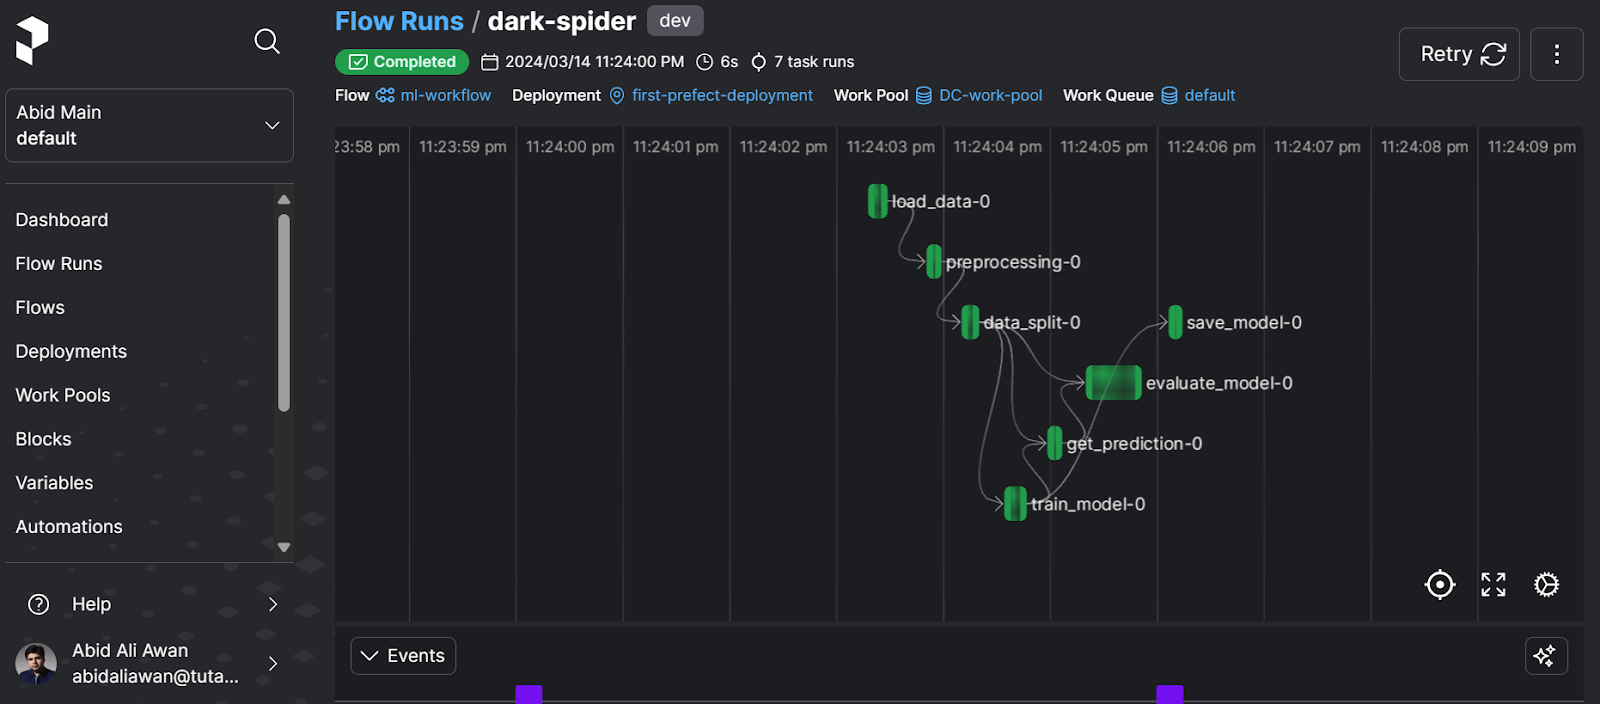
Para acompanhar a execução, vá até "Flow Run" e clique na execução mais recente para ver o grafo do workflow.
O diagrama do flow apresenta uma visão geral das conexões entre as tasks e o tempo gasto em cada etapa.
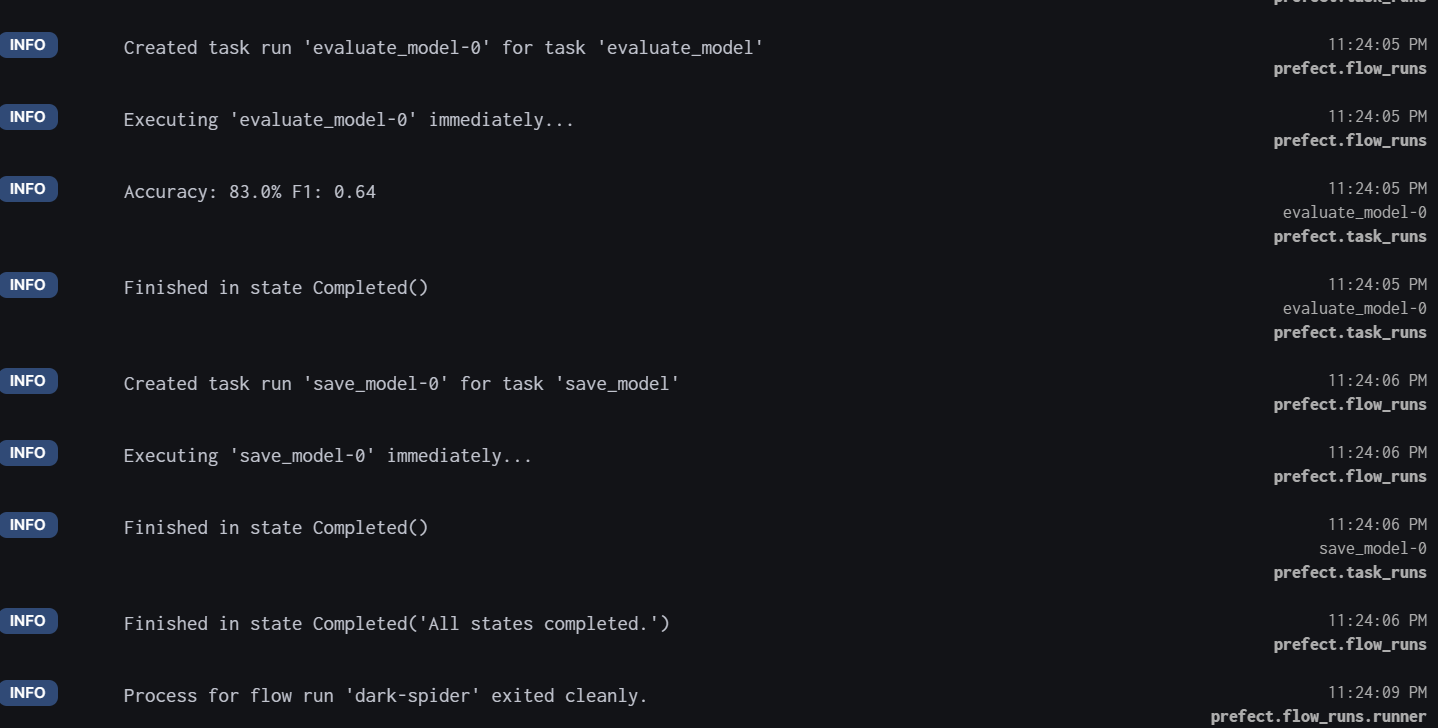
Para ver os logs detalhados, role a página e confira todas as tasks executadas com carimbo de data e hora.
Se formos em "Work Pools", dá para ver claramente que usamos 0,1 hora das 10 horas disponíveis para usuários gratuitos.
Confira o guia Machine Learning Workflow, que inclui um infográfico para ajudar você a entender as tarefas de preparação do projeto, preparação dos dados, modelagem e deploy.
Configurar um único workflow de machine learning é fácil. Em cenários do mundo real, você pode precisar rodar vários workflows de dados e ML simultaneamente. É aí que o Prefect se destaca: ele oferece escalabilidade e flexibilidade para escolher entre ambiente local ou em nuvem, seja para servidores do Prefect ou work pools. É uma ferramenta excelente para agendar, automatizar e gerenciar workflows.
Neste tutorial, cobrimos os principais recursos e funcionalidades do ecossistema Prefect. Também vimos como publicar um flow de machine learning localmente e na nuvem. Para continuar sua jornada em MLOps, o próximo passo é aprender a construir CI/CD para workflows de machine learning com o artigo "A Beginner's Guide to CI/CD for Machine Learning".
O Prefect é apenas uma das ferramentas de orquestração de workflows no universo de MLOps. Para conhecer outras ferramentas importantes para versionamento de dados, feature stores, testes de modelos, deploy e serving, monitoramento, engines de execução e ferramentas de MLOps de ponta a ponta, leia o artigo 25 Top MLOps Tools You Need to Know in 2024. Você também pode conferir nossa comparação Prefect vs Airflow para ver como as ferramentas se comparam.
Continue sua jornada em machine learning hoje mesmo!
Curso
Curso
Curso
Tutorial
Tutorial
Abid Ali Awan
11 min
Tutorial
Moez Ali
14 min
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
8 min
Tutorial
Abid Ali Awan
6 min




