Curso
Diseño de flujos de trabajo de Machine Learning en Python
4 h
12.7K
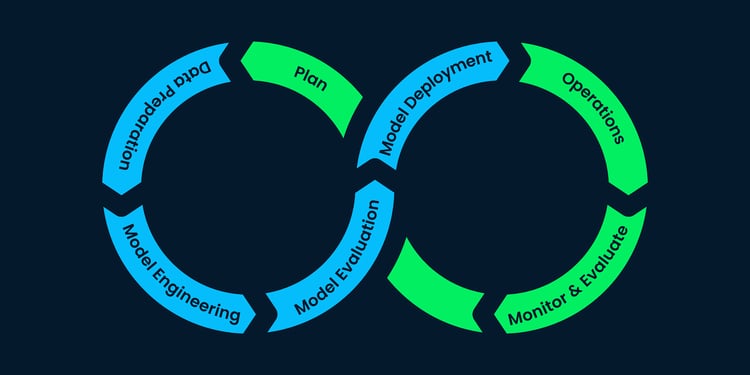
MLOps es una parte clave del machine learning porque ayuda a automatizar el entrenamiento y el despliegue de modelos. Esta automatización acelera el desarrollo y la puesta en producción y, además, garantiza que los modelos se desplieguen correctamente. MLOps también permite monitorizar el rendimiento de los modelos e identificar a tiempo posibles incidencias que deban resolverse en producción.
El panorama de MLOps en 2022 incluye diversas herramientas y servicios que ayudan a las organizaciones a automatizar la construcción, el entrenamiento y el despliegue de modelos de machine learning. Estas herramientas y servicios están diseñados para trabajar en conjunto y hacer que los flujos de MLOps sean más eficientes y sencillos de gestionar. MLflow es una de esas herramientas clave que vamos a explorar en este artículo.
MLflow es una plataforma de código abierto para gestionar todo el ciclo de vida del machine learning. Permite a los data scientists hacer seguimiento de sus experimentos, reproducir ejecuciones y servir sus modelos como endpoints. En este artículo, profundizamos en qué es MLflow y cómo puedes aprovechar esta fantástica plataforma open source para registrar y desplegar tus experimentos de machine learning.
Si quieres profundizar en MLOps, echa un vistazo a nuestro tutorial de machine learning, pipelines, despliegue y MLOps.
MLflow es una plataforma de código abierto para gestionar el ciclo de vida completo del machine learning. Proporciona un punto central para registrar experimentos, compartir código y modelos, y desplegar modelos en producción. MLflow también incluye varios algoritmos y paquetes integrados para los toolkits de ML más populares. Tiene cuatro funciones principales:

Fuente de la imagen: https://www.databricks.com/wp-content/uploads/2021/02/mlflow-components2.png
MLflow no está ligado a ninguna librería concreta. Como todas sus funciones son accesibles mediante una API REST y una interfaz de línea de comandos, puedes usarlo con cualquier librería de machine learning y en cualquier lenguaje de programación. El proyecto incorpora APIs de Python, R y Java para tu comodidad.
Cuando ejecutas código de machine learning, el componente MLflow Tracking proporciona una API y una interfaz gráfica (UI) para registrar parámetros, versiones de código, métricas y ficheros de salida. Después puedes visualizar los resultados registrados. Gracias a MLflow Tracking, también puedes registrar y consultar experimentos con las APIs de Python, REST, R y Java.
MLflow Tracking se organiza en torno al concepto de ejecuciones (runs). Cada ejecución guarda la información y los metadatos clave como hora de inicio y fin, fichero de origen, parámetros, artefactos, métricas, etiquetas, etc.
Puedes registrar ejecuciones con las APIs de Python, R o Java desde cualquier lugar, independientemente de dónde se ejecute tu código: en un programa independiente, en una máquina en la nube o en un cuaderno interactivo.
Asimismo, puedes organizar las ejecuciones en experimentos, que son conjuntos de runs agrupados con un propósito concreto. Para crear un experimento puedes usar la interfaz de línea de comandos (CLI), el método mlflow.create_experiment() o la API REST. También es posible crearlos desde la UI de MLflow.
Si lo necesitas, puedes guardar los registros de las ejecuciones de MLflow localmente en archivos, subirlos a una base de datos compatible con SQLAlchemy o alojarlos de forma remota en un servidor de tracking. La API de Python de MLflow registra por defecto en archivos locales dentro del directorio mlruns del lugar donde se ejecutó tu programa. Después puedes ver las ejecuciones registradas lanzando la aplicación mlflow ui.

Fuente de la imagen: https://mlflow.org/docs/latest/_images/scenario_1.png
MLflow Projects es una forma de estructurar tu código de machine learning para que sea reutilizable y reproducible. Puedes usar proyectos con cualquier librería y entorno de desarrollo. Cada proyecto se compone de un directorio que contiene un archivo MLproject, que describe el entorno y los parámetros del proyecto, y un conjunto de archivos con el código de machine learning.
MLflow admite actualmente los siguientes tipos de entornos de proyecto:
Si añades un archivo MLproject, que no es más que un archivo YAML, obtendrás un control más granular sobre el proyecto de MLflow. Este es un ejemplo de archivo MLproject:

Fuente: https://mlflow.org/docs/latest/projects.html#overview
Cuando el proyecto no incluye un archivo MLproject, MLflow asume algunas convenciones por defecto, como:

Un MLflow Model es un formato estandarizado para empaquetar modelos de machine learning que luego pueden utilizarse con distintas herramientas a lo largo del pipeline. Esto incluye el serving en tiempo real mediante una API REST o procesos de inferencia por lotes. MLflow Model es uno de los componentes clave de MLflow. Define un protocolo que permite guardar un modelo en varios "sabores" (flavors), cada uno de los cuales puede ser interpretado por diferentes herramientas aguas abajo.
Cada MLflow Model es en realidad un directorio que almacena archivos arbitrarios junto con un archivo MLmodel en la raíz, capaz de definir varios sabores en los que puede verse el modelo. A estos archivos, en conjunto, se les denomina MLflow Model.
La potencia de MLflow Models reside en el uso de sabores, que actúan como estándar para que las herramientas de despliegue comprendan el modelo. Esto permite a los desarrolladores crear herramientas que interactúen con modelos de cualquier librería de ML sin tener que integrar cada herramienta con cada librería. Un sabor "estándar" compatible con todas las herramientas de despliegue integradas en MLflow es "Python Function", que define cómo ejecutar el modelo como una función de Python.
Ejemplo de directorio de MLflow Models usando el sabor de Scikit-learn:

Fuente de la imagen: https://mlflow.org/docs/latest/models.html
MLflow admite de serie las siguientes librerías (como sabores de modelo):
MLflow Model Registry es un repositorio central para almacenar y versionar modelos de ML. Permite seguir el linaje de los modelos, compararlos y desplegarlos.
El componente MLflow Model Registry proporciona un conjunto de APIs y una interfaz de usuario para gestionar de forma colaborativa todo el ciclo de vida de un MLflow Model.
Para acceder al registro de modelos desde la interfaz de usuario (UI) o la API es necesario usar un backend store con base de datos si quieres utilizar Model Registry.
Registrar un modelo desde la UI de MLflow:

Fuente de la imagen: https://mlflow.org/docs/latest/model-registry.html#concepts
MLflow Pipelines es una capacidad nueva y todavía está en modo experimental.
MLflow Pipelines es un framework con opinión para estructurar flujos de trabajo de MLOps que simplifica y estandariza el desarrollo y la puesta en producción de aplicaciones de machine learning. Gracias a MLflow Pipelines, los data scientists pueden dedicar más tiempo a crear modelos de calidad, siguiendo con facilidad las buenas prácticas del sector para construir entregables listos para producción.
MLflow Pipelines también permite a los ML engineers y equipos de DevOps integrar estos modelos en aplicaciones y desplegarlos en producción sin fricciones.
MLflow Pipelines ofrece plantillas de pipelines con calidad de producción para problemas habituales de machine learning, como regresión y clasificación, y operaciones de MLOps, como el scoring por lotes. Los pipelines se estructuran como repositorios git con archivos de configuración en YAML y código Python. Esto ofrece a los desarrolladores un enfoque declarativo para construir aplicaciones de ML y reduce el código repetitivo.
Además, MLflow Pipelines implementa un ejecutor con caché consciente de los pasos del pipeline. Así, solo se ejecutan los pasos cuando hay cambios en el código o la configuración correspondiente. Gracias a esto, los data scientists, ML engineers y equipos de DevOps pueden iterar muy rápido dentro de sus áreas. También es posible ejecutar pipelines y revisar sus resultados mediante APIs y una interfaz de línea de comandos (CLI) de MLflow.
|
Desplegar modelos de machine learning en producción parece sencillo con las herramientas actuales, pero a menudo acaba en decepción cuando el modelo rinde peor en producción que en desarrollo. Si quieres aprender a diseñar flujos de trabajo de machine learning en Python que resistan el paso del tiempo, echa un vistazo a nuestro curso Designing Machine Learning Workflows in Python. |
Ahora que ya sabes qué es MLflow, resolvamos una duda muy común en el sector: ¿cuál es la diferencia entre MLflow y Kubeflow?
Primero, ¿qué es Kubeflow?
Kubeflow es un proyecto de código abierto que reúne un conjunto seleccionado de herramientas y frameworks. Su objetivo principal es facilitar el desarrollo, despliegue y gestión de flujos de trabajo de machine learning portables y escalables.
Kubeflow se construye sobre Kubernetes, una plataforma open source para ejecutar y orquestar contenedores. Kubernetes está diseñado para ejecutarse de forma consistente en distintos entornos, algo clave para el funcionamiento de Kubeflow.
Para saber más sobre Kubeflow, lee nuestro tutorial detallado sobre Kubeflow.
Al comparar MLflow y Kubeflow, la única similitud es que ambos son proyectos de código abierto, pero responden a necesidades muy distintas. Kubeflow es un sistema de orquestación de contenedores abierto para desarrollar, desplegar y gestionar aplicaciones de machine learning en Kubernetes. En cambio, MLflow es una librería de Python para el seguimiento de experimentos y el versionado/despliegue de modelos, independientemente del entorno de orquestación.
Usar MLflow es muy sencillo. Solo necesitas unas pocas líneas para integrar el logging de MLflow en tu código. Pero antes tienes que instalar MLflow con pip.
# install mlflow

pip install mlflow
Vamos a crear un script sencillo en Python para entrenar un modelo de regresión logística y registrar la métrica y el modelo con MLflow. Este es un ejemplo oficial de MLflow, reproducido desde aquí.
import numpy as np

from sklearn.linear_model import LogisticRegression

import mlflow

import mlflow.sklearn

if __name__ == "__main__":

    X = np.array([-2, -1, 0, 1, 2, 1]).reshape(-1, 1)

    y = np.array([0, 0, 1, 1, 1, 0])

    lr = LogisticRegression()

    lr.fit(X, y)

    score = lr.score(X, y)

    print("Score: %s" % score)

    mlflow.log_metric("score", score)

    mlflow.sklearn.log_model(lr, "model")

    print("Model saved in run %s" % mlflow.active_run().info.run_uuid)
SALIDA:
>>> Score: 0.6666666666666666
>>> Model saved in run 9def2bd1c55b4f0985aa5c050b8f71cd
Puedes iniciar la UI de MLflow escribiendo "mlflow ui" en la terminal, en el mismo directorio donde está tu archivo de Python.
mlflow ui
Luego navega a https://localhost:5000 y verás esta página:

Verás que solo hay un registro: el modelo que entrenamos y registramos en el script anterior. Haz clic en el nombre y accederás a una página con más detalle:

|
¡FÓRMATE AHORA! INSCRÍBETE HOY en Machine Learning Scientist with Python Domina las habilidades esenciales para conseguir un puesto como machine learning scientist. Ampliarás tu dominio de Python con las herramientas para realizar aprendizaje supervisado, no supervisado y deep learning. Aprenderás:
|
MLflow es una plataforma de código abierto y una gran herramienta para gestionar de principio a fin el ciclo de vida del machine learning. Fue creada por Databricks, la compañía detrás de la popular plataforma Apache Spark, y está diseñada para funcionar con cualquier librería, algoritmo o lenguaje.
MLflow ofrece varias ventajas para desarrolladores de machine learning y data scientists. Proporciona un lugar central para hacer seguimiento de experimentos y gestionar proyectos de machine learning. Es una herramienta valiosa para la colaboración, ya que permite que distintos miembros del equipo vean el trabajo de los demás y comparen resultados.
MLflow puede automatizar el flujo de trabajo de machine learning, desde el preprocesamiento de datos y el entrenamiento hasta el despliegue. Esto puede ahorrar tiempo y esfuerzo y facilita la reproducibilidad.
En definitiva, MLflow es una herramienta muy útil para gestionar proyectos de machine learning. Te ayuda a seguir tus experimentos, automatizar el flujo de trabajo y optimizar modelos. Si trabajas en proyectos de ML, deberías darle una oportunidad.
|
Si quieres impulsar tu formación continua y entender los fundamentos del machine learning y su aplicación en el mundo empresarial, echa un vistazo a nuestro curso Machine Learning for Business en DataCamp. |
Cursos de machine learning
Curso
Curso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Matt Crabtree
14 min
blog
Natassha Selvaraj
15 min
blog
Moez Ali
8 min
blog
Abid Ali Awan
15 min