
Kurs
Machine-Learning-Workflows in Python entwerfen
4 Std.
12.7K
In diesem Tutorial tauchen wir in Prefect ein und erkunden die wichtigsten Features, Vorteile und Bausteine. Wir schauen uns an, wie du Tasks und Flows erstellst, Deployments verwaltest und Flow-Runs ausführst. Abschließend zeigen wir dir, wie du deinen Workflow in Prefect Cloud bereitstellst und mit Cloud-Infrastruktur laufen lässt.
Wenn du erfahren möchtest, wie du Machine-Learning-Pipelines mit GitHub Actions und Data Version Control automatisierst, wirf einen Blick auf unseren Kurs CI/CD for Machine Learning.
Prefect ist ein leistungsstarkes Open-Source-Tool zur Workflow-Orchestrierung, mit dem du Daten- und Machine-Learning-Pipelines in Python entwerfen, überwachen und steuern kannst.
Prefect bringt zahlreiche Funktionen mit, darunter automatische Retries, Scheduling und Caching. Kurz: Ein mächtiges Werkzeug, mit dem du belastbare und dynamische Workflows aufbauen kannst.
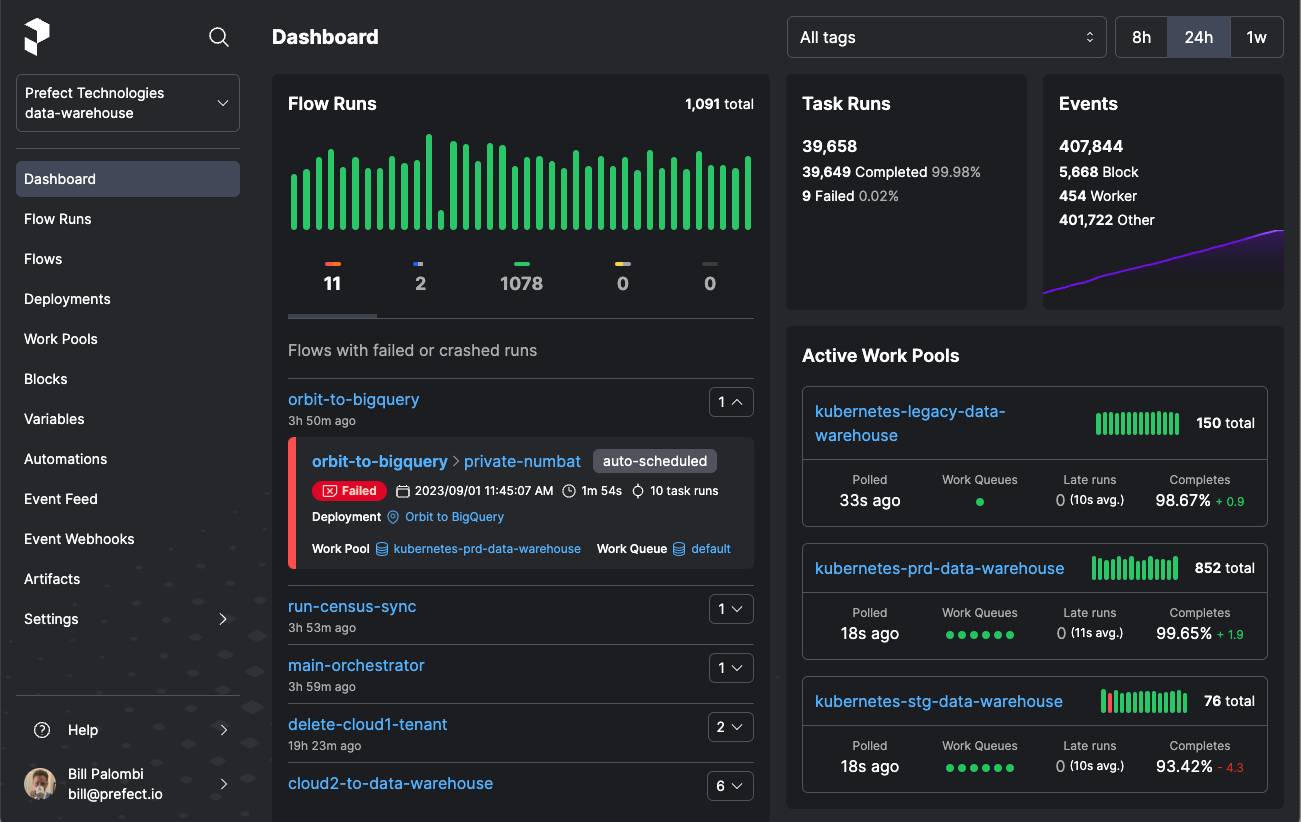
Bildquelle
Mit Prefect machst du aus jeder Python-Funktion im Handumdrehen eine beobachtbare und orchestrierbare Arbeitseinheit – einfach per Decorator.
Prefect eignet sich hervorragend, um die Workflow-Entwicklung und -Bereitstellung in Unternehmen zu standardisieren. Es bietet vollständige Observability und erlaubt dir, Code ohne strenge DAGs oder Boilerplate zu verwalten.
Mit nur einem Befehl setzt du einen eigenen Orchestrierungsserver für die Entwicklung auf. Das vereinfacht das lokale Arbeiten und sorgt für reibungslose Deployments in die Produktion.
Prefect bietet eine klar strukturierte Oberfläche, mit der sich Workflows visuell ansprechend und komfortabel ausführen, überwachen, debuggen und verwalten lassen.
Prefect liefert u. a. Scheduling, Retries, natives Secret-Management, Skalierung, Concurrency-Kontrolle, flexible Infrastruktur- und Storage-Optionen sowie leistungsfähiges Logging.
Du kannst einen Prefect-Server selbst hosten oder Prefect Cloud mit erweiterten Features, hoher Verfügbarkeit und mehr Sicherheit nutzen.
Prefect Cloud bietet alle Funktionen des Open-Source-Servers plus Extras wie Automations, Event-Feeds, Events, Webhooks, Workspaces, Organizations und mehr – optimal für gehostete Umgebungen. Prefect Cloud gibt es kostenlos oder als kostenpflichtige Variante mit stärkeren Features.
Mit nur einem Decorator startest du die Workflow-Orchestrierung – ohne unnötige Abstraktionen und mit effizientem Workflow-Management.
Sende Informationen zu Prefect-Workflows und -Pipelines an Slack, Discord, E-Mail, Microsoft Teams und weitere Dienste. So wirst du auch bei Fehlschlägen umgehend gewarnt.
In diesem Abschnitt gehen wir die Komponenten durch, mit denen du Tasks und Flows erstellst, bereitstellst, ausführst und verwaltest. Das Verständnis dieser Bausteine ist wichtig, bevor wir in das Python-Tutorial einsteigen.
Ein Prefect Task ist eine Python-Funktion mit dem Decorator @task und steht für abgeschlossene Arbeitseinheiten innerhalb eines Prefect-Workflows. Den Decorator kannst du u. a. mit Name, Beschreibung, Tags, Cache-Einstellungen, Retries und mehr konfigurieren.
Im folgenden Code wurden drei Machine-Learning-Tasks mit dem @task-Decorator erstellt, die in verschiedenen Flows wiederverwendbar sind.
@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    ...

    # Train the model
    ...

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    ...
	return prediction

@task
def evaluate_model(y_test, prediction: pd.DataFrame):
...Ein Prefect Flow ist eine Python-Funktion mit dem Decorator @flow, die die Logik des Workflows kapselt. Damit definierst, konfigurierst und ausführst du komplexe Datenpipelines flexibel und komfortabel.
Im folgenden Code haben wir mit @flow einen Flow erstellt. Der Flow führt alle Tasks nacheinander aus und übergibt die Ergebnisse jeweils weiter.
@flow
def ml_workflow():
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)

if __name__ == "__main__":
ml_workflow()Deployments sind Flows, die lokal oder in der Cloud gespeichert sind und alle Informationen enthalten, um deinen Workflow remote zu orchestrieren – etwa Zeitpläne und Ausführungsdetails.
Work Pools vermitteln zwischen Orchestrierung und Ausführungsumgebung. Sie ermöglichen effizientes Scheduling und die Ausführung von Flow-Runs. Du kannst Agents (Worker) für lokale Workflows einrichten oder Cloud-Infrastruktur nutzen.
Ähnlich wie dedizierte Compute-Instanzen verteilen Work Pools die Arbeit effizient, priorisieren Aufgaben und geben dir Flexibilität bei der Wahl der Ausführungsumgebung – für Performance und Skalierung.
In diesem Abschnitt erstellen, testen, deployen und führen wir einen einfachen Machine-Learning-Workflow mit Prefect aus. Außerdem richten wir Benachrichtigungen ein, um den Status der Flow-Runs in unserem Discord-Server zu erhalten.
Installiere das Python-Paket mit PIP
pip install -U prefectWenn du die neueste Version von Prefect nutzen willst, kannst du den Code direkt von GitHub beziehen.
pip install -U git+https://github.com/PrefectHQ/prefectWir preprocessen den Bank Churn-Datensatz von Kaggle und trainieren anschließend mit scikit-learn ein Random-Forest-Classifier-Modell, das wir auch evaluieren.
Der Code basiert auf einer angepassten Version von: Streamline Your Machine Learning Workflow with Scikit-learn Pipelines. Wenn du mehr über das Training erfahren willst, lies dieses Tutorial. Unser Machine-Learning-Prefect-Flow umfasst sieben Tasks:
Wir haben nun alle nötigen Tasks in einer @flow-Funktion namens ml_workflow zusammengeführt. Zusätzlich haben wir dem Decorator Parameter für detailliertes Logging mitgegeben.
Die Funktion ml_workflow erhält den Dateipfad als Eingabe und verknüpft die Tasks zu einer Kette. Beim Deployment und der Ausführung auf dem Prefect-Server lässt sich der Workflow noch besser visualisieren.
Du kannst unsere Machine-Learning-Experimente auch mit MLflow tracken. Im Kurs Introduction to MLflow lernst du alles zu MLflow Tracking, Projects, Models und Model Registry.
import pandas as pd
import skops.io as sio
from prefect import flow, task
from sklearn.feature_selection import SelectKBest, chi2
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler, OrdinalEncoder


@task
def load_data(filename: str):
    bank_df = pd.read_csv(filename, index_col="id", nrows=1000)
    bank_df = bank_df.drop(["CustomerId", "Surname"], axis=1)
    bank_df = bank_df.sample(frac=1)
    return bank_df


@task
def preprocessing(bank_df: pd.DataFrame):
    cat_col = [1, 2]
    num_col = [0, 3, 4, 5, 6, 7, 8, 9]

    # Filling missing categorical values
    cat_impute = SimpleImputer(strategy="most_frequent")
    bank_df.iloc[:, cat_col] = cat_impute.fit_transform(bank_df.iloc[:, cat_col])

    # Filling missing numerical values
    num_impute = SimpleImputer(strategy="median")
    bank_df.iloc[:, num_col] = num_impute.fit_transform(bank_df.iloc[:, num_col])

    # Encode categorical features as an integer array.
    cat_encode = OrdinalEncoder()
    bank_df.iloc[:, cat_col] = cat_encode.fit_transform(bank_df.iloc[:, cat_col])

    # Scaling numerical values.
    scaler = MinMaxScaler()
    bank_df.iloc[:, num_col] = scaler.fit_transform(bank_df.iloc[:, num_col])
    return bank_df


@task
def data_split(bank_df: pd.DataFrame):
    # Splitting data into training and testing sets
    X = bank_df.drop(["Exited"], axis=1)
    y = bank_df.Exited

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.3, random_state=125
    )
    return X_train, X_test, y_train, y_test
    # Identify numerical and categorical columns


@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    KBest = SelectKBest(chi2, k="all")
    X_train = KBest.fit_transform(X_train, y_train)
    X_test = KBest.transform(X_test)

    # Train the model
    model = LogisticRegression(max_iter=1000, random_state=125)
    model.fit(X_train, y_train)

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    return model.predict(X_test)


@task
def evaluate_model(y_test, prediction: pd.DataFrame):
    accuracy = accuracy_score(y_test, prediction)
    f1 = f1_score(y_test, prediction, average="macro")

    print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))


@task
def save_model(model: LogisticRegression):
    sio.dump(model, "bank_model.skops")


@flow(log_prints=True)
def ml_workflow(filename: str = "train.csv"):
    data = load_data(filename)
    prep_data = preprocessing(data)
    X_train, X_test, y_train, y_test = data_split(prep_data)
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)
    save_model(model)


if __name__ == "__main__":
    ml_workflow()
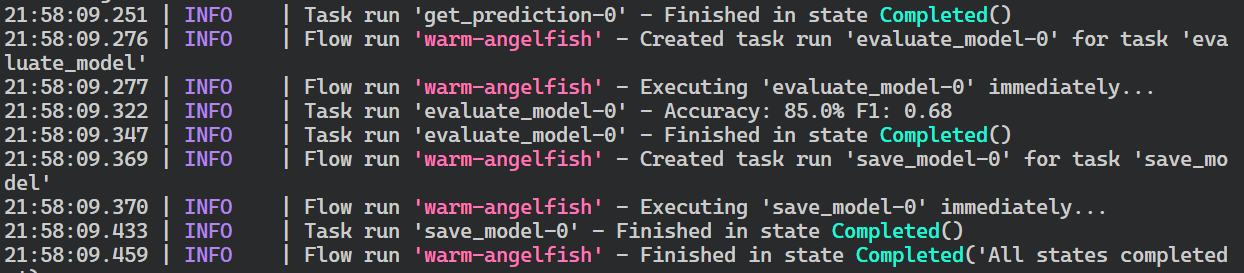
Um unseren Prefect-Flow zu testen, führe die Python-Datei im Terminal aus.
$ python main.pyDer Flow wurde erfolgreich ausgeführt. Die Metriken wurden ausgegeben und die Modellgewichte gespeichert.
Wenn du neu im Machine Learning bist und lernen möchtest, wie du Daten preprocessst, ein Modell trainierst, optimierst, evaluierst und speicherst, empfehlen wir dir den Karrierepfad Machine Learning Scientist with Python. Dort lernst du alles von Grund auf.
Eine ML-Pipeline manuell zu bauen und auszuführen ist mit modernen Tools – auch mit scikit-learn Pipelines – recht unkompliziert.
Mit Prefect profitierst du jedoch von weiteren Vorteilen:
Als Nächstes automatisieren wir unseren Workflow, indem wir ihn auf dem lokalen Prefect-Server deployen.
Zuerst bauen wir das „Deployment“, indem wir Datei- und Flownamen angeben. Außerdem fügen wir dem Deployment den Tag „dev“ hinzu.
Hinweis: Tags in Prefect helfen, Flows, Tasks und Deployments im Prefect-Ökosystem zu kategorisieren und zu organisieren.
$ prefect deployment build main.py:ml_workflow -n 'ml_workflow_bank_churn' -a --tag devDas Deployment wurde erfolgreich erstellt. Anschließend erhältst du Hinweise, wie du den Flow mit dem Prefect Agent ausführst.
Found flow 'ml-workflow'
Deployment YAML created at
'C:\Repository\GitHub\ML-Workflow-Orchestration-With-Prefect\ml_workflow-deployment.yaml'.
Deployment storage None does not have upload capabilities; no files uploaded.  Pass --skip-upload to
suppress this warning.
Deployment 'ml-workflow/ml_workflow_bank_churn' successfully created with id
'ce30d1c7-f454-4064-870c-429a8039c194'.

To execute flow runs from this deployment, start an agent that pulls work from the
'default-agent-pool' work pool:
$ prefect agent start -p 'default-agent-pool'Prefect Agents überwachen Work Pools, entdecken verfügbare Flow-Runs und starten sie in der jeweiligen Ausführungsumgebung.
Ein Work Pool kann mehrere Agents haben. Jeder Agent besitzt eine eindeutige ID, um Überschneidungen zu vermeiden und Skalierung zu ermöglichen.
Wir initialisieren nun in einem neuen Terminal die Prefect Agents mit dem Standard-Work-Pool.
$ prefect agent start -p 'default-agent-pool'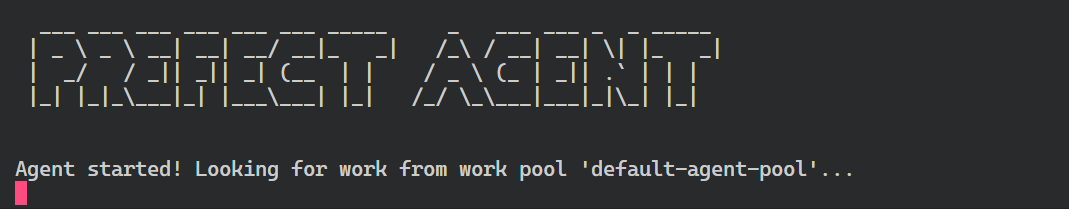
Öffne ein neues Terminal und starte das Deployment, indem du „flow_function/deployment name“ angibst. Alternativ kannst du auch nur den Deployment-Namen verwenden.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Es wurde ein Flow-Run für das Deployment angelegt, der nach Workern sucht und den Workflow startet.
Creating flow run for deployment 'ml-workflow/ml_workflow_bank_churn'...
Created flow run 'cryptic-potoo'.
└── UUID: 77833ee3-0f7e-42f9-8002-0a562c7d3ed4
└── Parameters: {}
└── Scheduled start time: 2024-03-14 21:30:40 PKT (now)
└── URL: <no dashboard available>
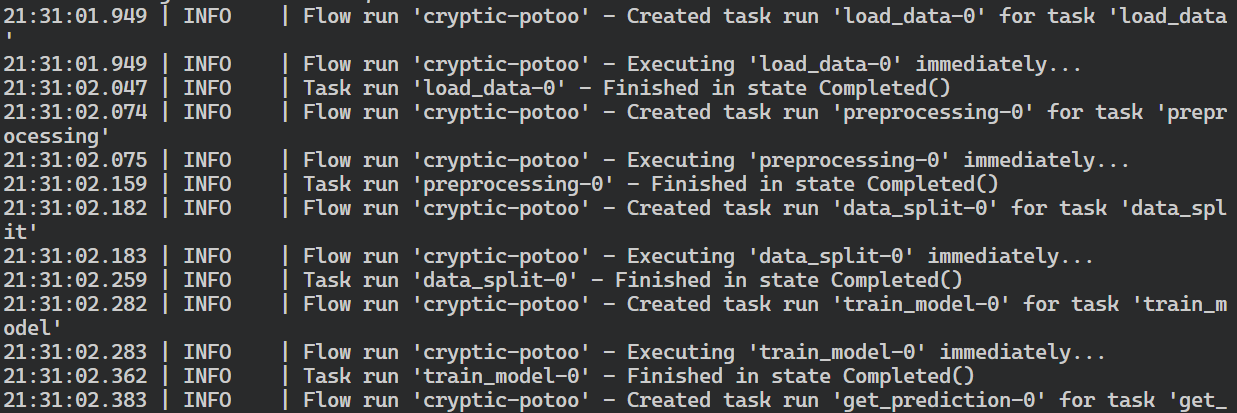
Wechsle in das Terminal mit dem Agenten, um die Logs des Flow-Runs zu sehen. Der Prefect Agent hat alle Tasks im Flow erfolgreich ausgeführt.
Das ist ein einfaches Beispiel. Du kannst den Workflow außerdem per Scheduling oder weitere Automatisierung direkt im Deployment konfigurieren.
Bisher haben wir unseren Workflow nur im Terminal beobachtet. Jetzt starten wir das Prefect-Dashboard, in dem du Flow-Runs, Deployments, Work Pools und Benachrichtigungen sehen kannst.
Starte den Prefect-Server in einem neuen Terminal und klicke auf den lokalen Link, um das Dashboard zu öffnen.
$ prefect server start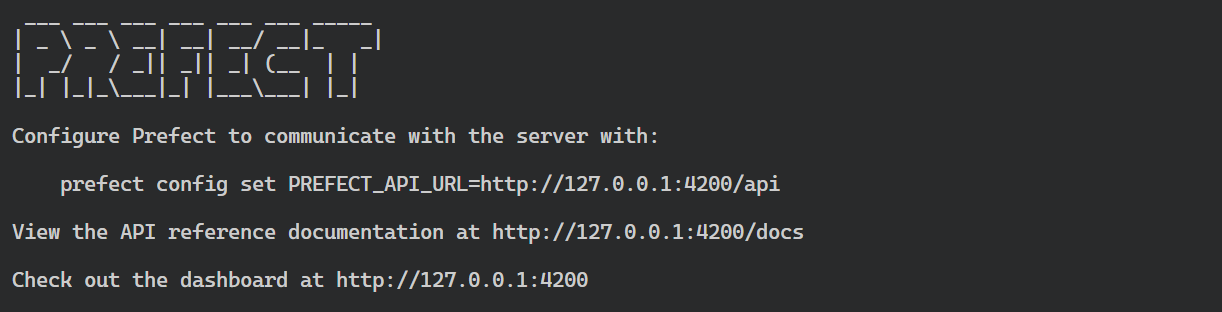
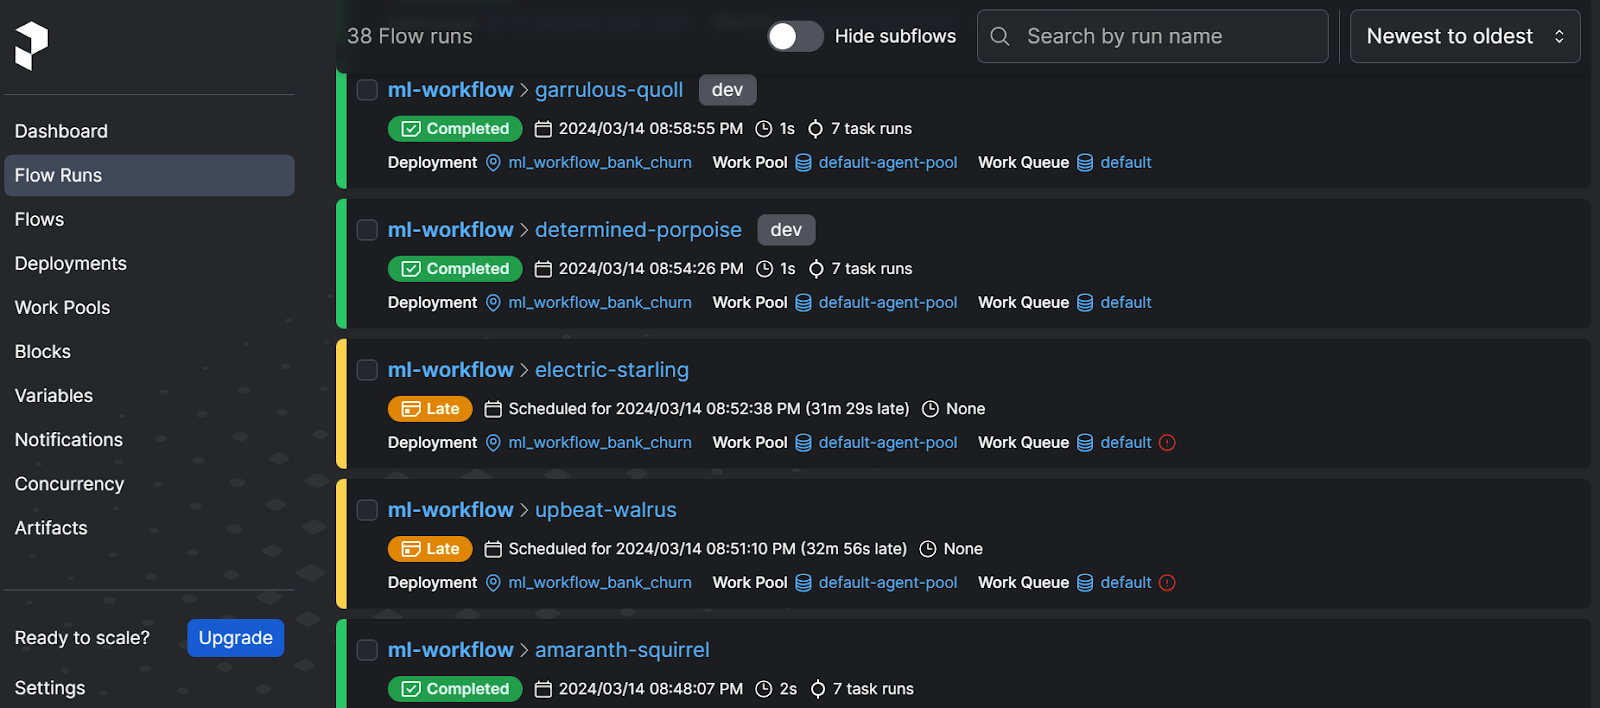
Um alle bisherigen Runs zu sehen, klicke in der linken Navigationsleiste auf „Flow“. Du wirst feststellen, dass einige Flows mangels Work Pool nicht ausgeführt wurden, andere liefen während der Experimentierphase ohne den „dev“-Tag.
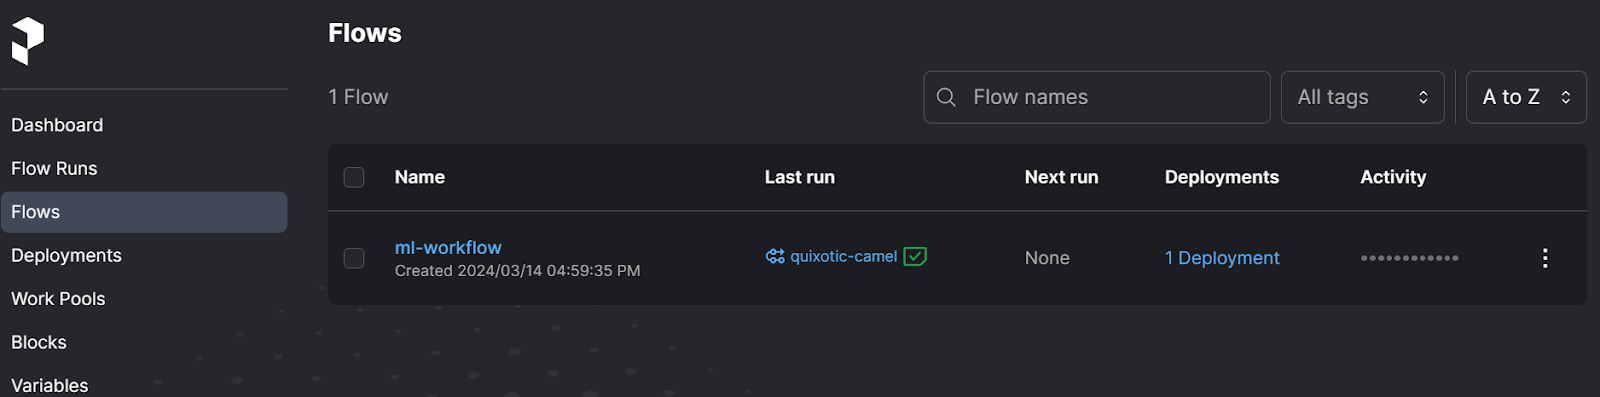
Unter „Flows“ siehst du alle verfügbaren Flows. In einem Deployment können mehrere Flows existieren.
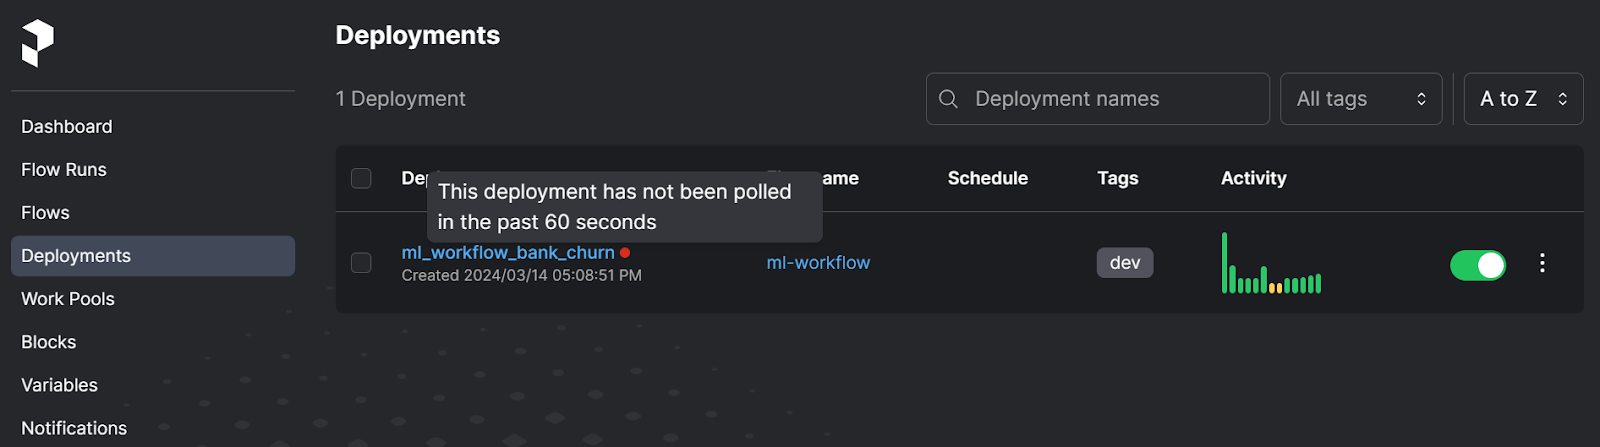
Im Bereich „Deployments“ findest du dein aktuelles Deployment samt Aktivität und Tags. Hier kannst du den Flow per „Quick Run“ starten oder per UI terminieren.
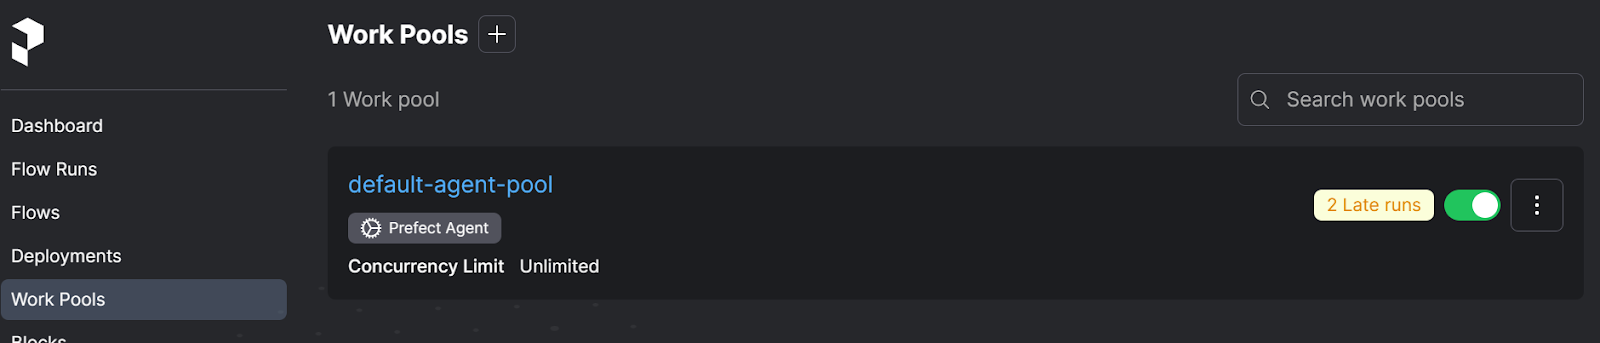
Unter „Work Pools“ siehst du unseren Standard-Prefect-Agent. Über die Prefect-CLI kannst du auch einen Cloud-Work-Pool einrichten.
Jetzt wird’s spannend.
Niemand will seinen Workflow rund um die Uhr manuell überwachen. Stattdessen möchten wir Statusmeldungen in unserer bevorzugten Messenger-App erhalten, um Probleme schnell zu lösen.
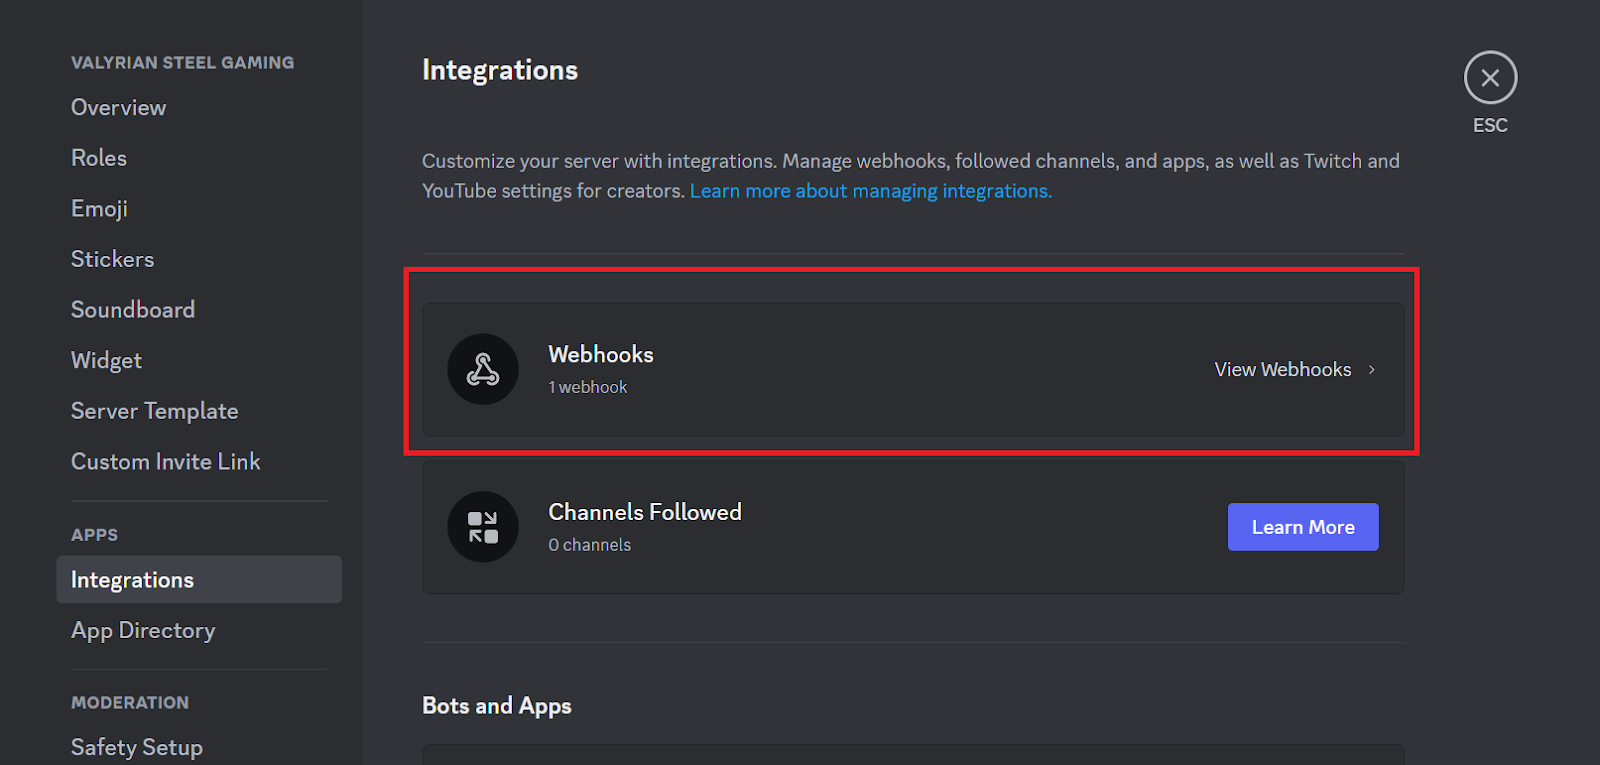
Dafür erstellen wir einen Discord-Webhook. Mit Webhook-ID und -Token richten wir die Prefect-Benachrichtigung ein. Sie sendet alle Logs an den Discord-Server.
Erstelle den Webhook in den Servereinstellungen von Discord unter „Integrations“ → „View Webhooks“ und klicke auf „New Webhook“.
Passe Bild, Namen und Kanal an. Kopiere anschließend die Webhook-URL.
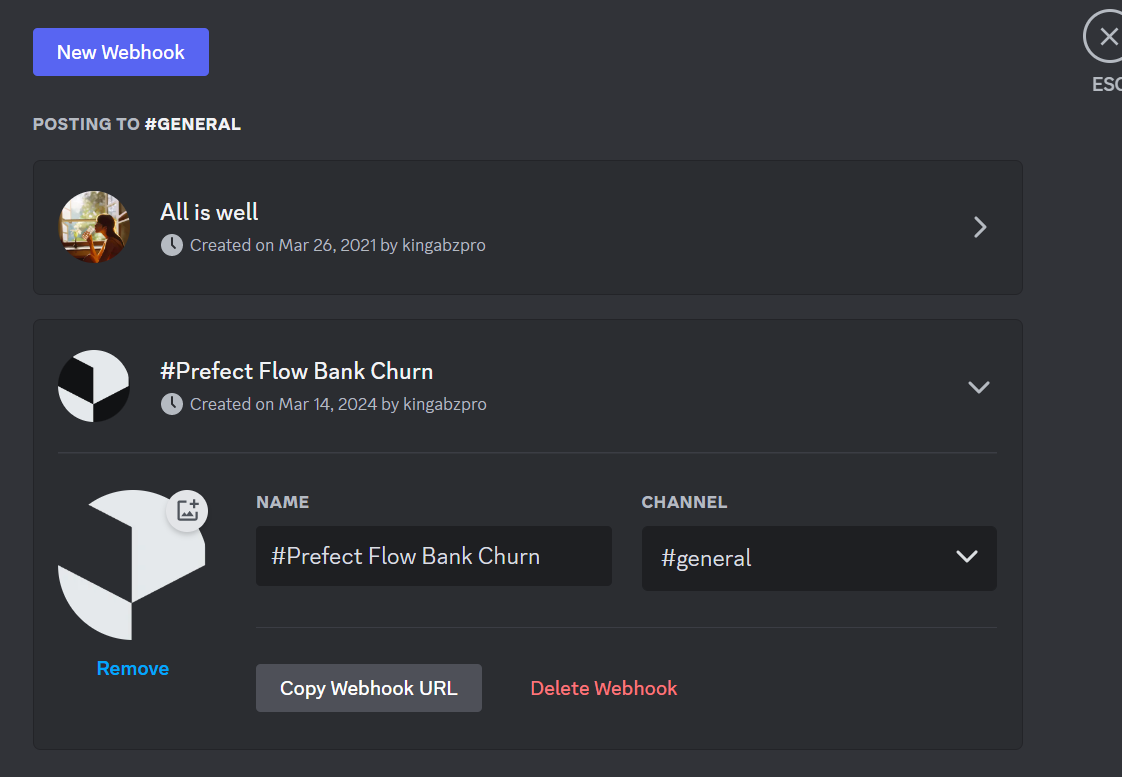
Die Webhook-URL besteht aus zwei Teilen, nämlich Webhook-ID und Webhook-Token: https://discord.com/api/webhooks/<webhook_id>/<webhook_token>. Für die Prefect-Benachrichtigung müssen wir beide Teile aus dem Link herauslösen.
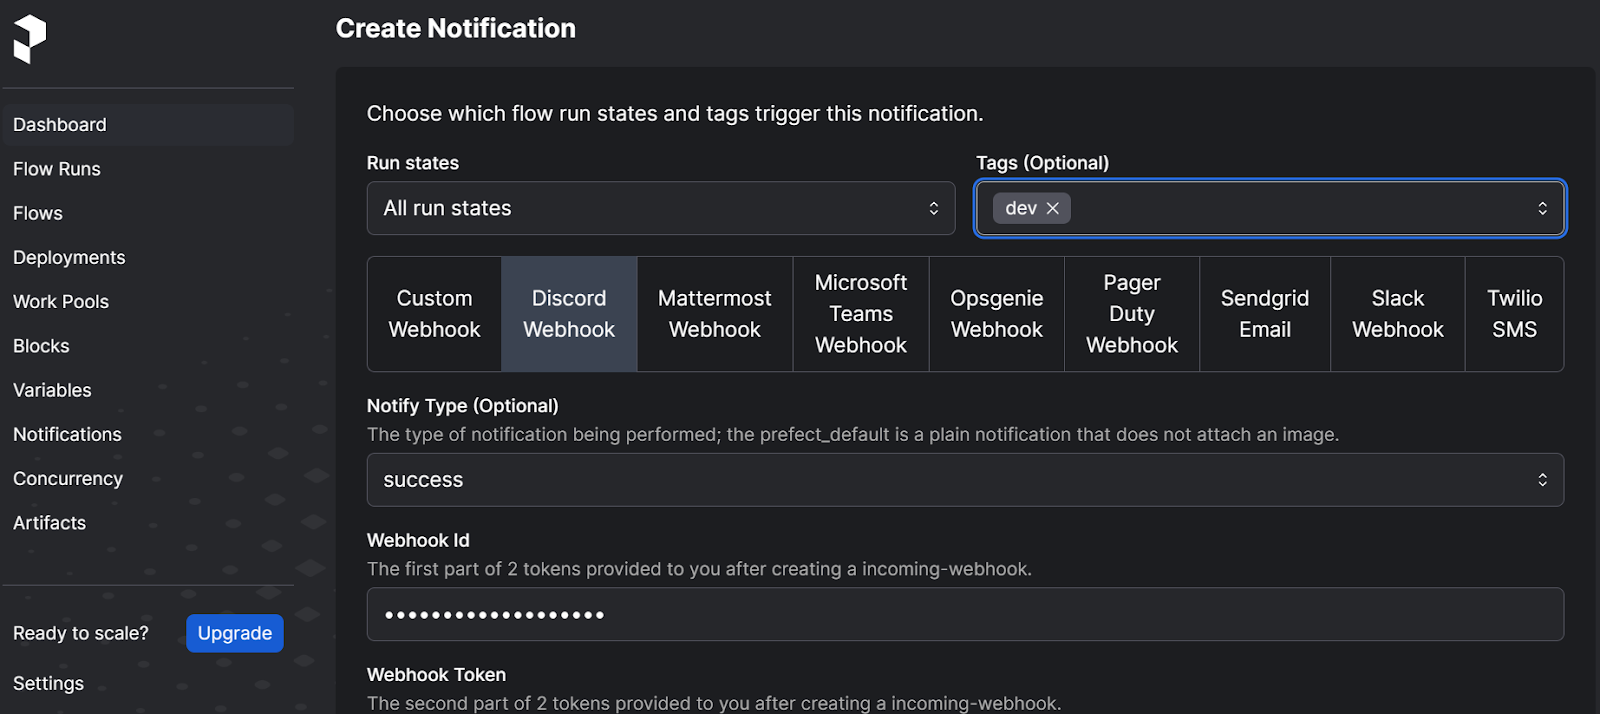
Um in der Prefect-UI eine Discord-Benachrichtigung zu erstellen, gehe zu „Notifications“, klicke oben auf „+“, wähle die gewünschten Run-States, Tags, den Discord-Webhook und den Benachrichtigungstyp.
Gib anschließend Webhook-ID und -Token ein und klicke auf den blauen „Create“-Button.
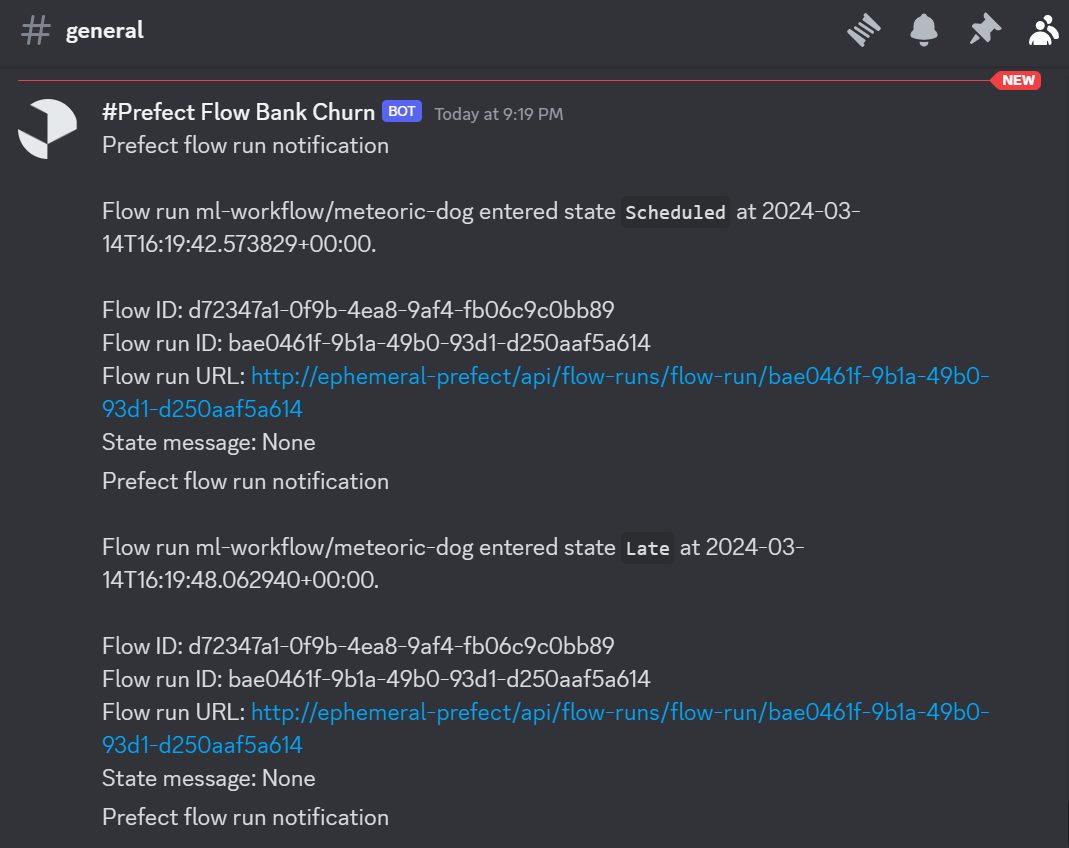
Führe das Deployment aus, um die Benachrichtigungen im Hauptkanal deines Discord-Servers zu sehen.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Großartig. Nach demselben Prinzip kannst du auch Microsoft Teams, Slack, SMS und E-Mail anbinden – oder eigene Webhooks erstellen.
Im Kurs Designing Machine Learning Workflows in Python lernst du, wie du Pipelines baust, die langfristig bestehen.
Nachdem wir unseren ML-Flow lokal bereitgestellt haben, deployen wir ihn nun in Prefect Cloud. Das geht sogar noch einfacher als lokal: Du musst keine Server oder Agents starten und keine Runs via CLI auslösen. Alles wird von Prefect verwaltet.
Bevor wir den aktuellen Flow deployen, ein wichtiger Hinweis: Er wird scheitern, wenn er auf lokale Dateien und Daten zugreifen will, die in der Cloud nicht verfügbar sind. Damit Prefect Cloud darauf zugreifen kann, erstellen wir ein öffentliches GitHub-Repository und pushen unseren Code dorthin.
Das geht einfach über die GitHub-Website oder mit der VSCode-Git-Erweiterung, um das Remote-Repository anzulegen und den Code per UI zu pushen.
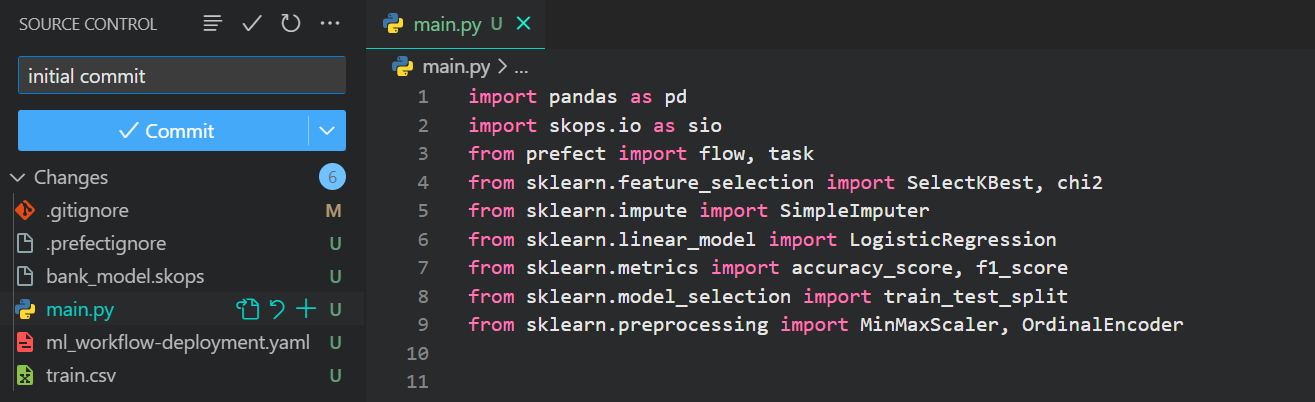
Hier ist das Projekt-Repository, das wir für die Cloud-Deployments verwenden: kingabzpro/ML-Workflow-Orchestration-With-Prefect
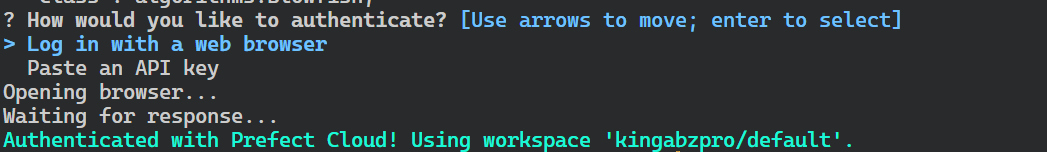
Erstelle deinen Prefect-Cloud-Account unter https://app.prefect.cloud/auth/login und melde dich anschließend über die Prefect-CLI an.
$ prefect cloud loginWähle einfach „Log in with a web browser“ und folge den Schritten, um den lokalen Client mit Prefect Cloud zu verknüpfen.
Wir erstellen einen von Prefect verwalteten Work Pool, um die Cloud-Infrastruktur vollständig zu nutzen – statt eines lokal laufenden Agents.
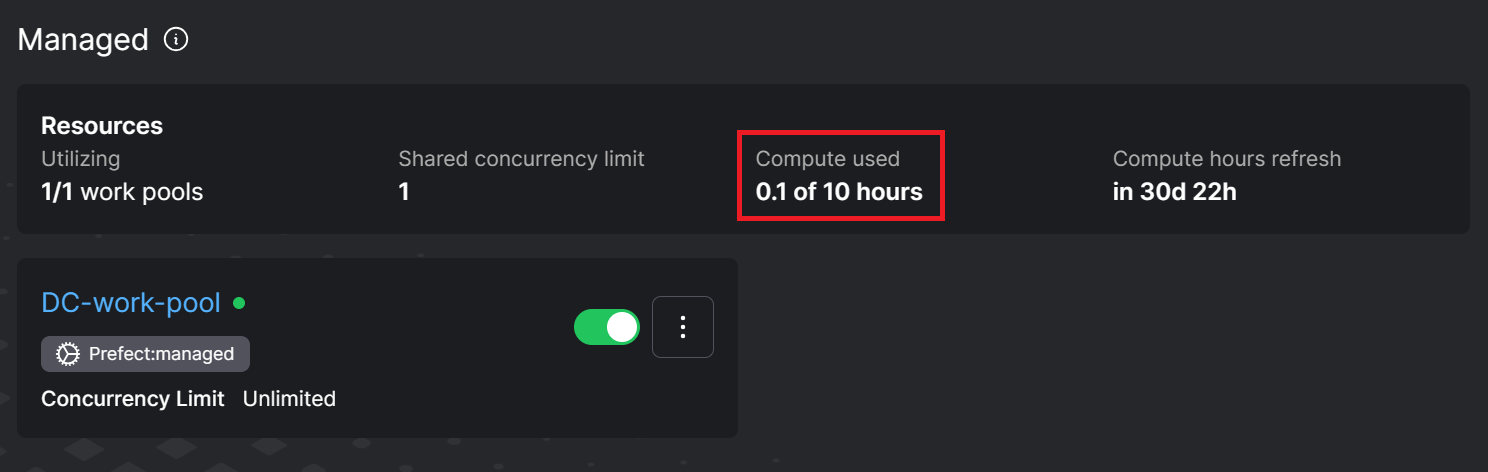
$ prefect work-pool create DC-work-pool --type prefect:managedMit dem kostenlosen Account stellt Prefect 10 Compute-Stunden pro Monat zum Ausprobieren bereit.
Jetzt deployen wir unseren Flow programmatisch in Prefect Cloud.
Erstelle eine neue Datei namens deployment.py.
Richte folgende Argumente für die Prefect-Flow-Funktion ein:
from prefect import flow

if __name__ == "__main__":
    flow.from_source(
        source="https://github.com/kingabzpro/ML-Workflow-Orchestration-With-Prefect.git",
        entrypoint="main.py:ml_workflow",
    ).deploy(
        name="first-prefect-deployment",
        work_pool_name="DC-work-pool",
        tags=["dev"],
        job_variables={"pip_packages": ["pandas", "skops", "scikit-learn"]},
    )
Führe den Python-Code aus.
$ python deployment.pyDer Flow ist in Prefect Cloud bereitgestellt. Du kannst ihn über die CLI oder das Prefect-Cloud-Dashboard starten.
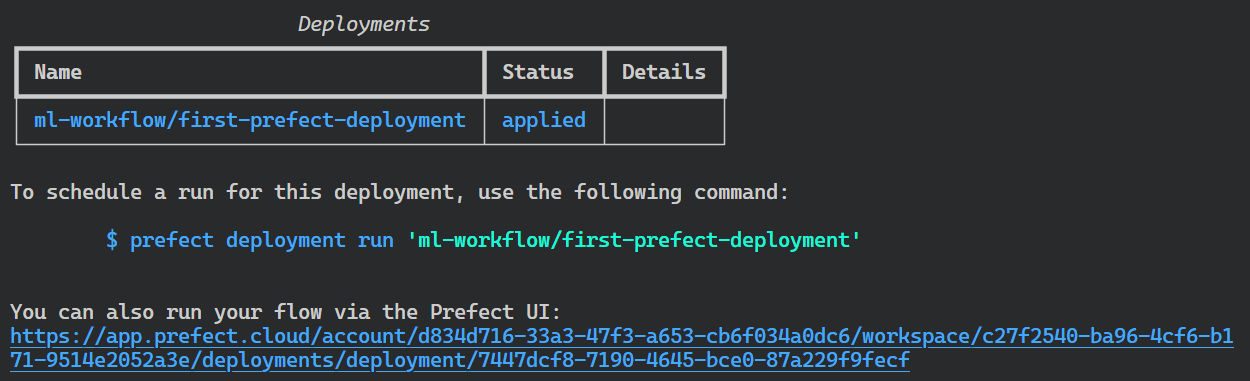
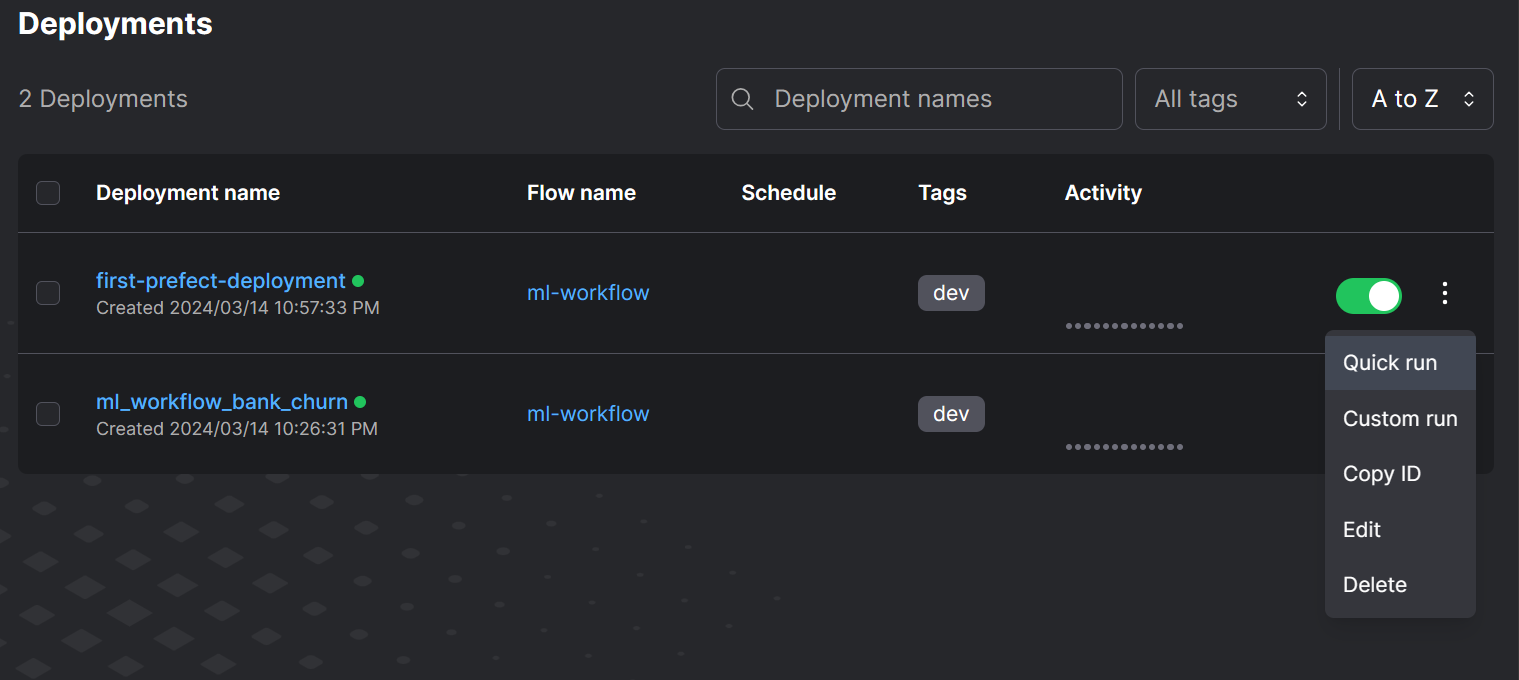
Um den Flow zu starten, gehe auf https://app.prefect.cloud/. Öffne den Bereich „Deployments“, klicke beim gewünschten Deployment auf die drei vertikalen Punkte und wähle „Quick run“.
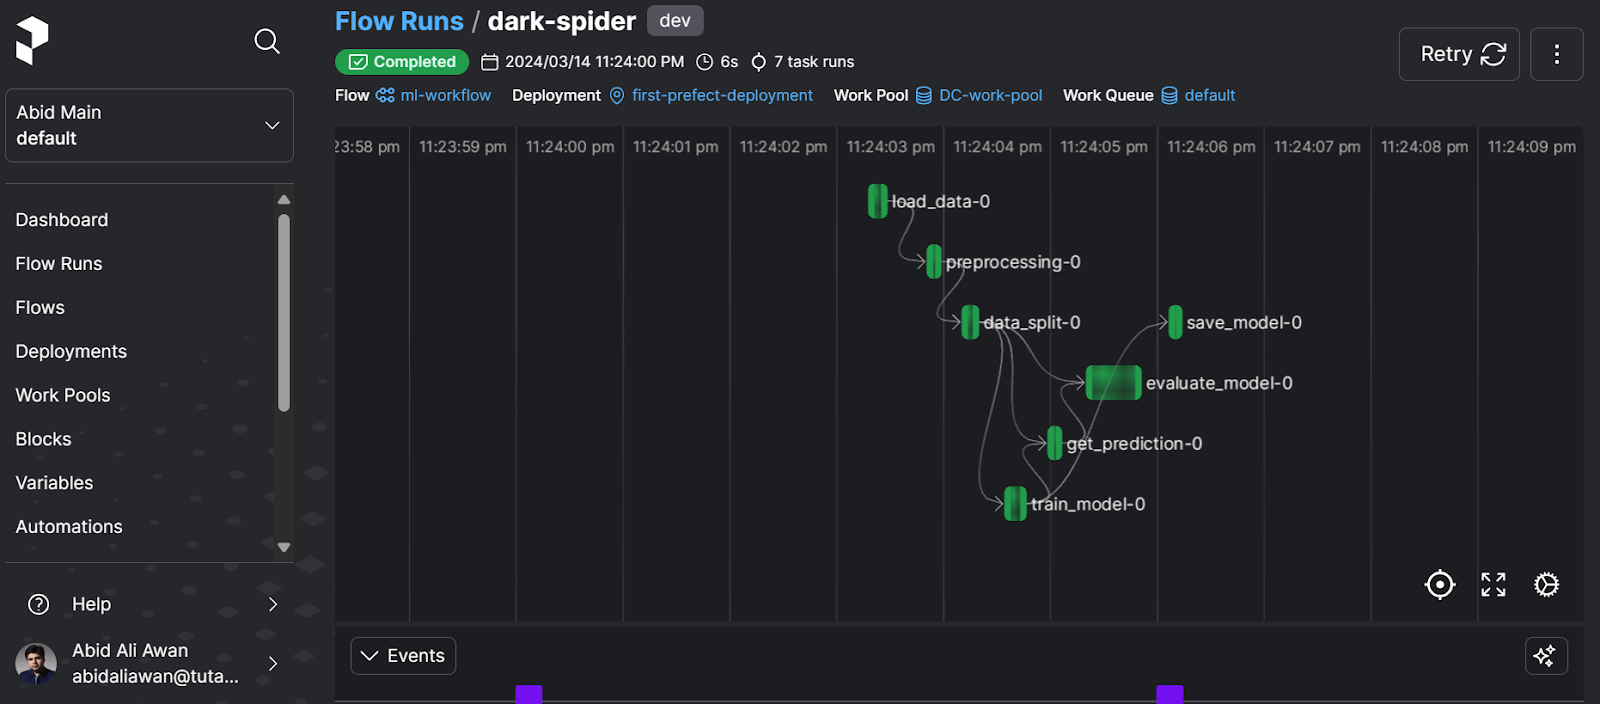
Um den Status zu verfolgen, gehe zu „Flow Run“ und öffne den neuesten Run, um den Workflow-Graphen zu sehen.
Das Flussdiagramm zeigt, wie die Tasks zusammenhängen und wie lange jeder Schritt dauert.
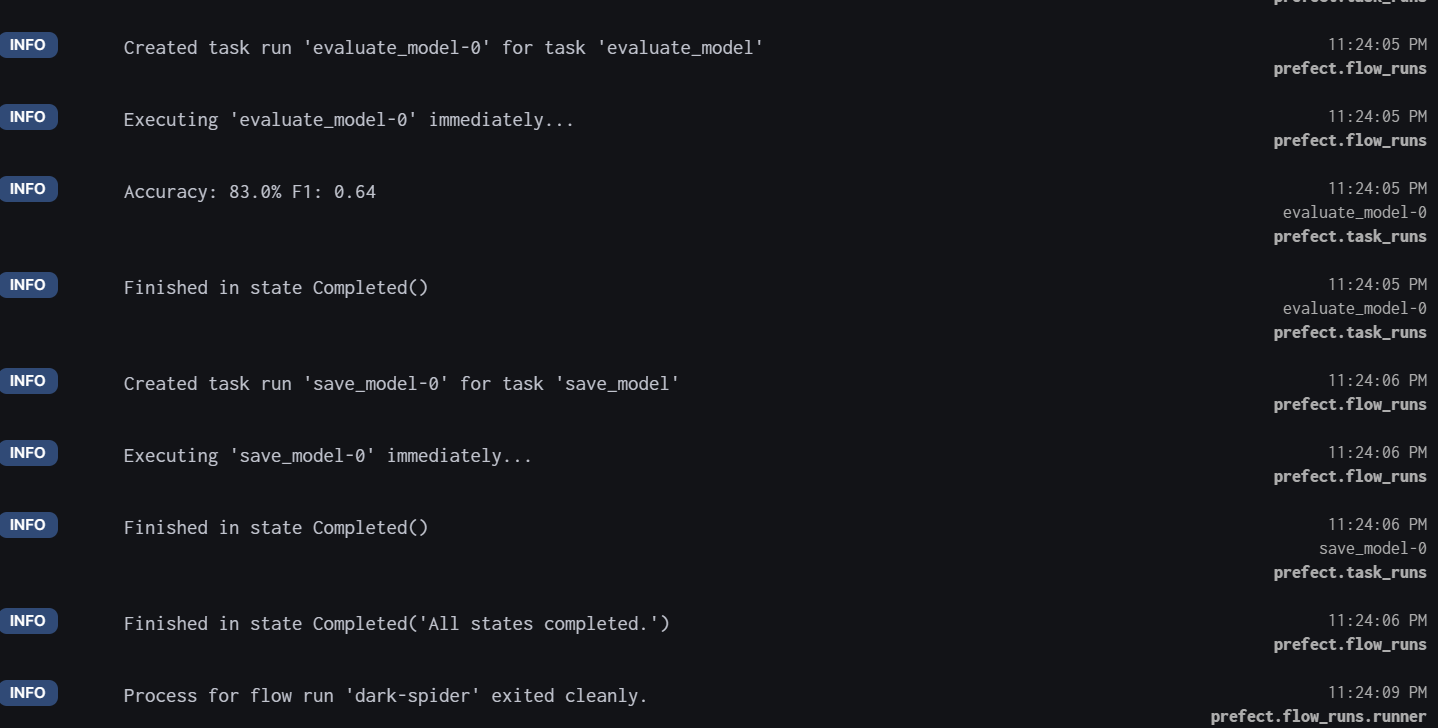
Für detaillierte Logs scrolle nach unten und sieh dir alle Tasks mit Zeitstempel an.
Unter „Work Pools“ siehst du, dass wir 0,1 Stunden von den 10 freien Stunden verbraucht haben.
Sieh dir auch den Guide zum Machine-Learning-Workflow an – inklusive Infografik zu Aufgaben in Setup, Datenaufbereitung, Modellierung und Deployment.
Einen einzelnen Machine-Learning-Workflow aufzusetzen, ist unkompliziert. In der Praxis laufen jedoch oft mehrere ML- und Daten-Workflows parallel. Hier spielt Prefect seine Stärken aus: Es skaliert, ist flexibel – lokal oder in der Cloud, ob Prefect-Server oder Work Pools – und eignet sich hervorragend zum Planen, Automatisieren und Verwalten von Workflows.
In diesem Tutorial haben wir die wichtigsten Funktionen und Bestandteile des Prefect-Ökosystems behandelt. Außerdem hast du gelernt, wie du einen ML-Flow lokal und in der Cloud deployst. Für deinen weiteren MLOps-Weg empfiehlt sich als nächster Schritt „A Beginner's Guide to CI/CD for Machine Learning“ – dort lernst du, wie du CI/CD für ML-Workflows aufbaust.
Prefect ist nur eines von vielen MLOps-Werkzeugen für die Workflow-Orchestrierung. Wenn du mehr über Tools für Datenversionierung, Feature Stores, Model-Testing, Deployment und Serving, Monitoring, Runtime-Engines und End-to-End-MLOps erfahren willst, lies den Artikel 25 Top MLOps Tools You Need to Know in 2024. Außerdem lohnt sich unser Vergleich Prefect vs Airflow.
Starte noch heute deine Machine-Learning-Reise!
Kurs
Kurs
Kurs