
Cours
Concevoir des workflows de Machine Learning en Python
4 h
12.7K
Dans ce tutoriel, nous allons explorer Prefect en détail : ses fonctionnalités clés, ses atouts et ses composants. Nous verrons comment créer des tasks et des flows, gérer des deployments et exécuter des flow runs. Enfin, nous vous guiderons pour déployer votre workflow sur Prefect Cloud et l'exécuter sur une infrastructure cloud.
Si vous souhaitez automatiser des pipelines de machine learning avec GitHub Actions et Data Version Control, suivez notre cours CI/CD for Machine Learning.
Prefect est un puissant outil open source d'orchestration de workflows qui permet de concevoir, superviser et piloter des pipelines data et machine learning en Python.
Prefect intègre de nombreuses fonctionnalités : relances automatiques, planification, mise en cache, etc. C'est un outil robuste pour construire des workflows résilients et dynamiques.
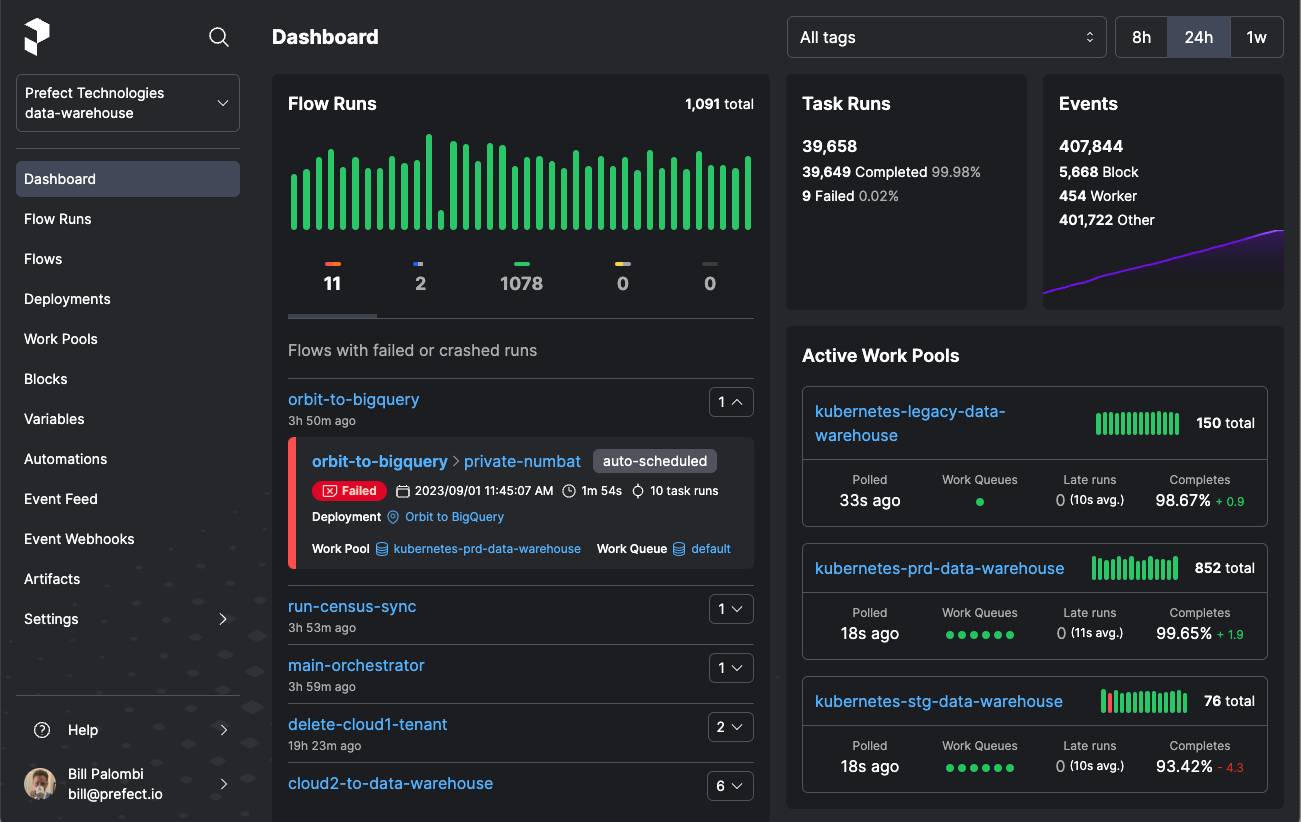
Image Source
Avec Prefect, vous pouvez transformer facilement n'importe quelle fonction Python en unité de travail observable et orchestrable en ajoutant simplement quelques décorateurs à votre code.
Prefect est idéal pour standardiser le développement et le déploiement de workflows à l'échelle de l'organisation. Il offre une observabilité complète des workflows et permet de gérer le code sans recourir à des DAG rigides ni à du code passe-partout.
Avec une seule commande, vous pouvez lancer votre propre serveur d'orchestration pour le développement. Ce processus simplifié facilite le développement local et garantit des déploiements fluides en production.
Prefect propose une interface utilisateur claire et agréable, qui facilite l'exécution, le suivi, le débogage et la gestion de vos workflows.
Prefect offre la planification, les relances, la gestion native des secrets, des capacités de montée en charge, le contrôle de la concurrence, des options flexibles de configuration d'infrastructure et de stockage, ainsi qu'une journalisation robuste.
Vous pouvez auto-héberger un serveur Prefect open source ou bénéficier de fonctionnalités avancées, de haute disponibilité et de sécurité renforcée avec Prefect Cloud.
Prefect Cloud reprend toutes les capacités du serveur open source et ajoute des fonctionnalités comme les automatisations, les flux d'événements, les webhooks, les espaces de travail, les organisations, et plus encore, adaptées à un environnement hébergé. Vous pouvez l'utiliser gratuitement ou opter pour des fonctionnalités plus avancées en version payante.
Prefect permet de démarrer l'orchestration d'un workflow avec un simple décorateur, sans abstractions inutiles, pour une gestion efficace des workflows.
Envoyez des informations sur vos workflows et pipelines Prefect vers plusieurs services de messagerie comme Slack, Discord, email, Microsoft Teams, etc. Vous pouvez aussi recevoir une alerte en cas d'échec du workflow.
Cette section présente les composants essentiels pour créer des tasks et des flows, les déployer, les exécuter et les administrer. Il est important de les passer en revue avant d'aborder le tutoriel Python.
Une Prefect Task est une fonction Python décorée avec @task qui représente des unités de travail distinctes au sein d'un workflow Prefect. Vous pouvez personnaliser le décorateur avec des arguments optionnels : nom, description, tags, paramètres de cache, relances, etc.
Dans l'exemple ci-dessous, trois tasks de machine learning sont créées avec le décorateur @task et peuvent être réutilisées dans différents flows.
@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    ...

    # Train the model
    ...

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    ...
	return prediction

@task
def evaluate_model(y_test, prediction: pd.DataFrame):
...Un Prefect Flow est une fonction Python décorée avec @flow qui encapsule la logique du workflow. Cela simplifie la définition, la configuration et l'exécution de pipelines de données complexes avec souplesse.
Dans le code ci-dessous, nous avons créé un Flow avec le décorateur @flow. Le flow exécute toutes les tasks séquentiellement, en chaînant les sorties en entrées.
@flow
def ml_workflow():
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)

if __name__ == "__main__":
ml_workflow()Les deployments sont des flows stockés en local ou dans le cloud et incluent les informations nécessaires pour orchestrer votre workflow à distance, comme la planification et les détails d'exécution.
Les work pools font le lien entre l'orchestration et les environnements d'exécution, ce qui permet de planifier et d'exécuter efficacement les flow runs. Vous pouvez configurer vos Agents (workers) pour exécuter les workflows en local ou tirer parti d'une infrastructure cloud pour une exécution fluide.
À l'image d'une instance de calcul dédiée, les work pools gèrent l'allocation du travail et priorisent les tâches, en offrant la liberté de choisir l'environnement d'exécution pour optimiser performances et montée en charge.
Dans cette section, nous allons créer, tester, déployer et exécuter un workflow de machine learning simple avec Prefect. Nous configurerons également des notifications pour être alertés sur notre serveur Discord de l'état des exécutions.
Installez le package Python avec PIP
pip install -U prefectSi vous voulez utiliser la toute dernière version de Prefect, vous pouvez récupérer le code directement depuis GitHub.
pip install -U git+https://github.com/PrefectHQ/prefectNous allons prétraiter le jeu de données Bank Churn de Kaggle, puis utiliser scikit-learn pour entraîner et évaluer un modèle Random Forest Classifier.
Le code utilisé est une version adaptée de l'article : Streamline Your Machine Learning Workflow with Scikit-learn Pipelines. Consultez ce tutoriel si vous souhaitez en savoir plus sur l'entraînement du modèle. Notre Prefect Flow de machine learning comporte sept tasks :
Nous avons assemblé toutes les tasks nécessaires dans une fonction @flow nommée ml_workflow. Nous avons également ajouté des arguments au décorateur pour activer une journalisation détaillée.
La fonction ml_workflow prend en entrée l'emplacement du fichier de données, puis enchaîne les différentes tasks. Nous visualiserons ce workflow plus clairement lors de son déploiement et de son exécution sur le serveur Prefect.
Vous pouvez aussi suivre nos expériences de machine learning avec MLflow. Suivez le cours Introduction to MLflow pour découvrir le tracking, les projects, les models et le model registry de MLflow.
import pandas as pd
import skops.io as sio
from prefect import flow, task
from sklearn.feature_selection import SelectKBest, chi2
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler, OrdinalEncoder


@task
def load_data(filename: str):
    bank_df = pd.read_csv(filename, index_col="id", nrows=1000)
    bank_df = bank_df.drop(["CustomerId", "Surname"], axis=1)
    bank_df = bank_df.sample(frac=1)
    return bank_df


@task
def preprocessing(bank_df: pd.DataFrame):
    cat_col = [1, 2]
    num_col = [0, 3, 4, 5, 6, 7, 8, 9]

    # Filling missing categorical values
    cat_impute = SimpleImputer(strategy="most_frequent")
    bank_df.iloc[:, cat_col] = cat_impute.fit_transform(bank_df.iloc[:, cat_col])

    # Filling missing numerical values
    num_impute = SimpleImputer(strategy="median")
    bank_df.iloc[:, num_col] = num_impute.fit_transform(bank_df.iloc[:, num_col])

    # Encode categorical features as an integer array.
    cat_encode = OrdinalEncoder()
    bank_df.iloc[:, cat_col] = cat_encode.fit_transform(bank_df.iloc[:, cat_col])

    # Scaling numerical values.
    scaler = MinMaxScaler()
    bank_df.iloc[:, num_col] = scaler.fit_transform(bank_df.iloc[:, num_col])
    return bank_df


@task
def data_split(bank_df: pd.DataFrame):
    # Splitting data into training and testing sets
    X = bank_df.drop(["Exited"], axis=1)
    y = bank_df.Exited

    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.3, random_state=125
    )
    return X_train, X_test, y_train, y_test
    # Identify numerical and categorical columns


@task
def train_model(X_train, X_test, y_train):
    # Selecting the best features
    KBest = SelectKBest(chi2, k="all")
    X_train = KBest.fit_transform(X_train, y_train)
    X_test = KBest.transform(X_test)

    # Train the model
    model = LogisticRegression(max_iter=1000, random_state=125)
    model.fit(X_train, y_train)

    return model


@task
def get_prediction(X_test, model: LogisticRegression):
    return model.predict(X_test)


@task
def evaluate_model(y_test, prediction: pd.DataFrame):
    accuracy = accuracy_score(y_test, prediction)
    f1 = f1_score(y_test, prediction, average="macro")

    print("Accuracy:", str(round(accuracy, 2) * 100) + "%", "F1:", round(f1, 2))


@task
def save_model(model: LogisticRegression):
    sio.dump(model, "bank_model.skops")


@flow(log_prints=True)
def ml_workflow(filename: str = "train.csv"):
    data = load_data(filename)
    prep_data = preprocessing(data)
    X_train, X_test, y_train, y_test = data_split(prep_data)
    model = train_model(X_train, X_test, y_train)
    predictions = get_prediction(X_test, model)
    evaluate_model(y_test, predictions)
    save_model(model)


if __name__ == "__main__":
    ml_workflow()
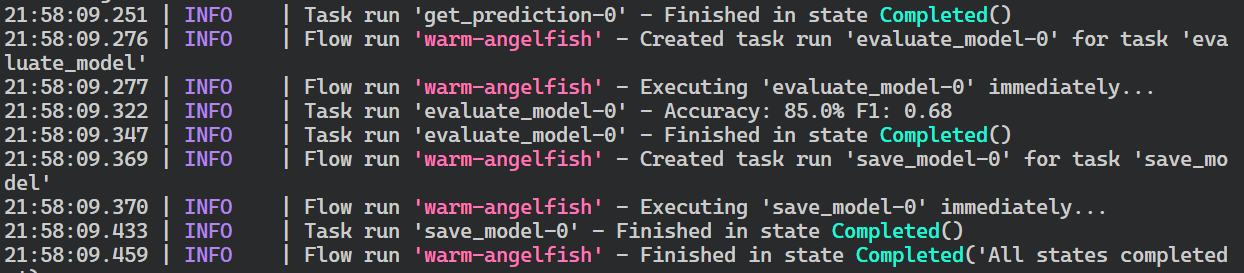
Pour tester notre Prefect Flow, exécutez le fichier Python dans le terminal.
$ python main.pyLe flow s'est terminé avec succès. Les métriques du modèle ont été affichées et les poids du modèle enregistrés.
Si vous débutez en machine learning et souhaitez apprendre à prétraiter vos données, entraîner, optimiser, évaluer et enregistrer vos modèles, suivez le parcours carrière Machine Learning Scientist with Python. Il couvre tout depuis les bases.
Construire et exécuter manuellement un pipeline de machine learning est simple, et peut même se faire avec les pipelines scikit-learn.
Cependant, Prefect apporte de nombreux avantages :
Passons maintenant à l'automatisation en le déployant sur le serveur Prefect local.
Commencez par construire le « Deployment » en indiquant le fichier et le nom de la fonction de flow. Nous ajoutons aussi le tag « dev » à notre Deployment.
Remarque : les tags dans Prefect servent à catégoriser et organiser les flows, tasks et deployments dans l'écosystème.
$ prefect deployment build main.py:ml_workflow -n 'ml_workflow_bank_churn' -a --tag devLe deployment a été créé avec succès. Des instructions sont fournies pour exécuter le flow via le Prefect Agent.
Found flow 'ml-workflow'
Deployment YAML created at
'C:\Repository\GitHub\ML-Workflow-Orchestration-With-Prefect\ml_workflow-deployment.yaml'.
Deployment storage None does not have upload capabilities; no files uploaded.  Pass --skip-upload to
suppress this warning.
Deployment 'ml-workflow/ml_workflow_bank_churn' successfully created with id
'ce30d1c7-f454-4064-870c-429a8039c194'.

To execute flow runs from this deployment, start an agent that pulls work from the
'default-agent-pool' work pool:
$ prefect agent start -p 'default-agent-pool'Les agents Prefect surveillent les work pools pour détecter les flow runs disponibles et les déployer dans l'environnement d'exécution.
Un work pool peut avoir plusieurs agents, chacun avec un identifiant unique pour éviter les chevauchements et faciliter la montée en charge.
Initialisons maintenant les agents Prefect dans un nouveau terminal avec le nom de work pool par défaut.
$ prefect agent start -p 'default-agent-pool'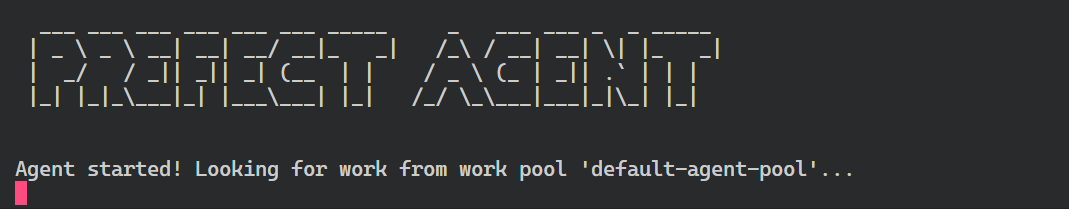
Dans un nouveau terminal, lancez le deployment en fournissant « nom_de_fonction_de_flow/nom_du_deployment ». Vous pouvez aussi n'indiquer que le nom du deployment.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Un flow run a été créé pour le deployment, il va chercher des workers et démarrer l'exécution du workflow.
Creating flow run for deployment 'ml-workflow/ml_workflow_bank_churn'...
Created flow run 'cryptic-potoo'.
└── UUID: 77833ee3-0f7e-42f9-8002-0a562c7d3ed4
└── Parameters: {}
└── Scheduled start time: 2024-03-14 21:30:40 PKT (now)
└── URL: <no dashboard available>
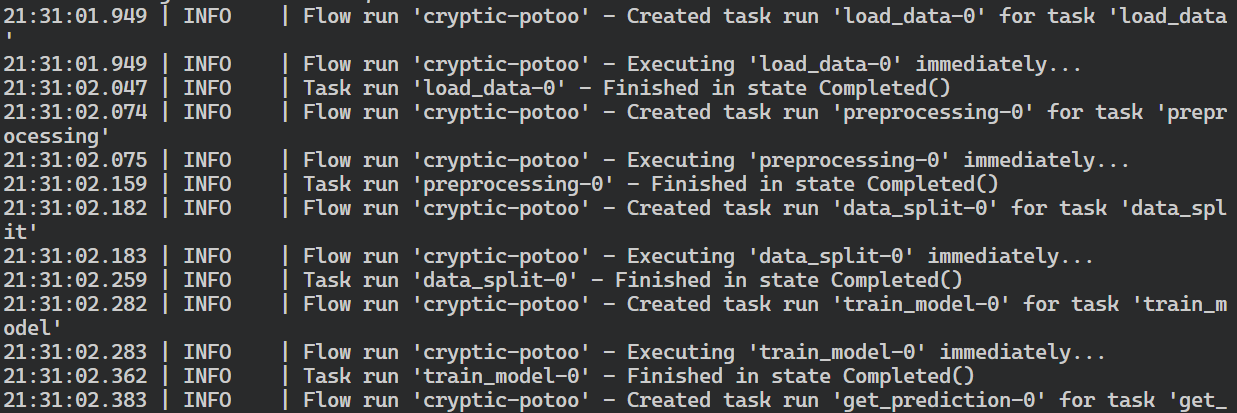
Revenez au terminal où l'agent a été lancé pour voir les logs du flow run. L'agent Prefect a exécuté toutes les tasks avec succès.
Ceci est un exemple simple. Vous pouvez aussi planifier ou automatiser le workflow en ajoutant des arguments supplémentaires lors du build du Deployment.
Jusqu'ici, nous avons suivi notre workflow dans les terminaux. Ouvrons maintenant le tableau de bord Prefect pour visualiser l'ensemble des flow runs, deployments, work pools et notifications.
Démarrez le serveur Prefect dans un nouveau terminal et cliquez sur le lien local fourni pour accéder au tableau de bord.
$ prefect server start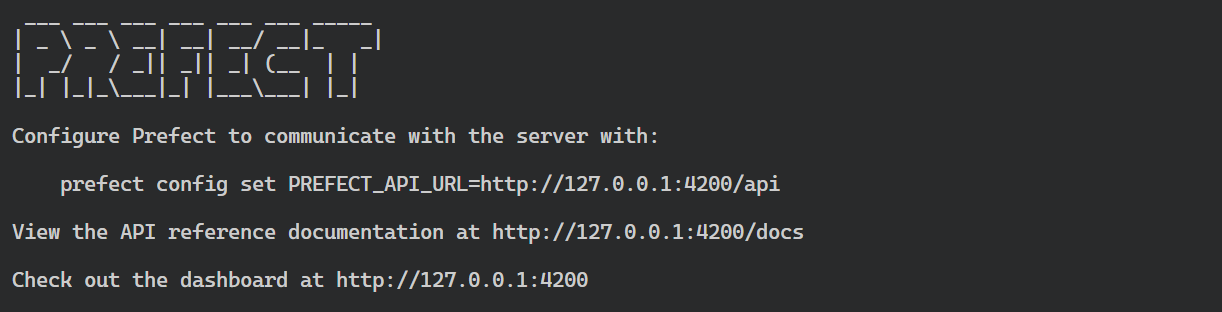
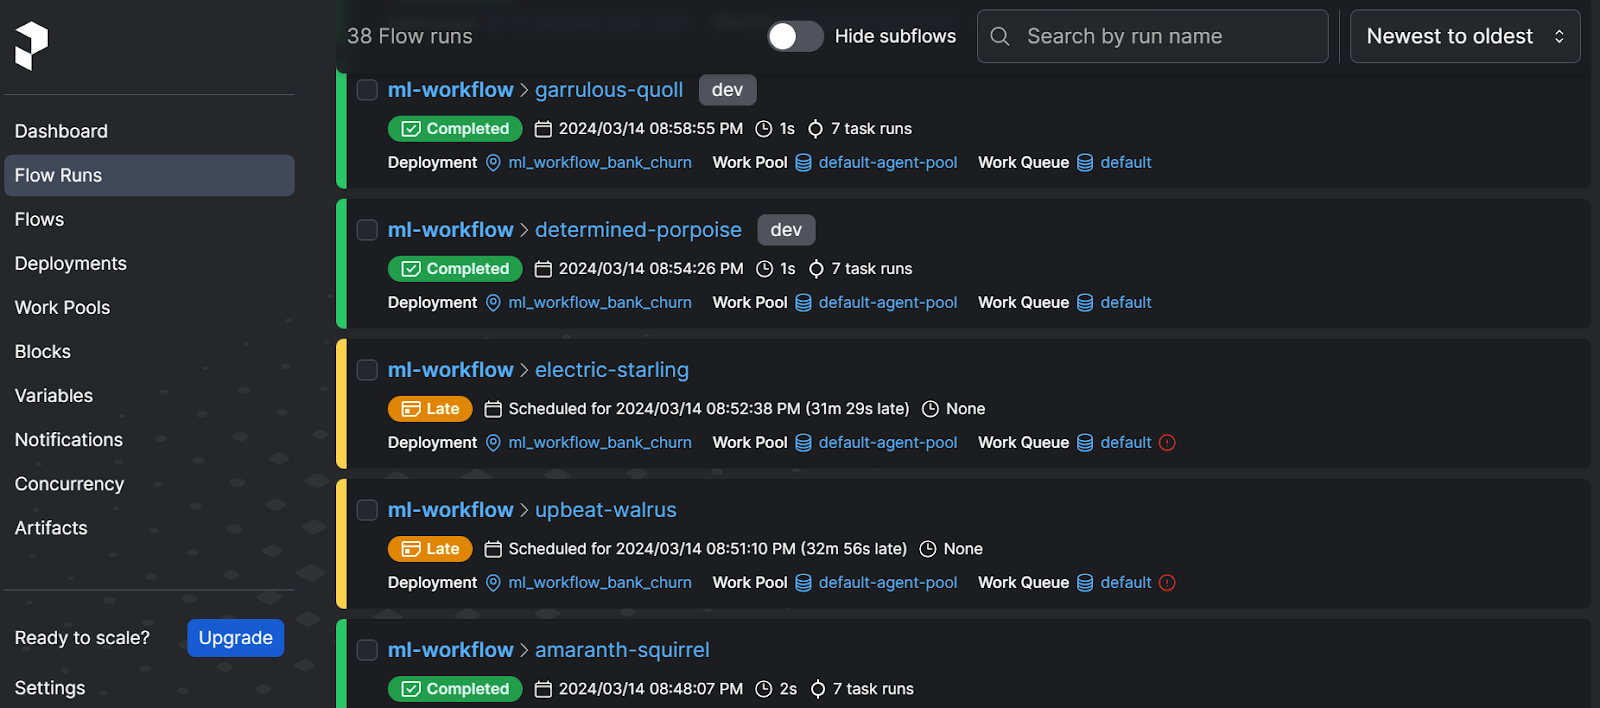
Pour afficher les exécutions précédentes, cliquez sur l'option « Flow » dans le panneau de gauche. Vous remarquerez peut-être que certains flows n'ont pas été exécutés faute de work pools, tandis que d'autres ont été exécutés sans le tag « dev » lors des tests.
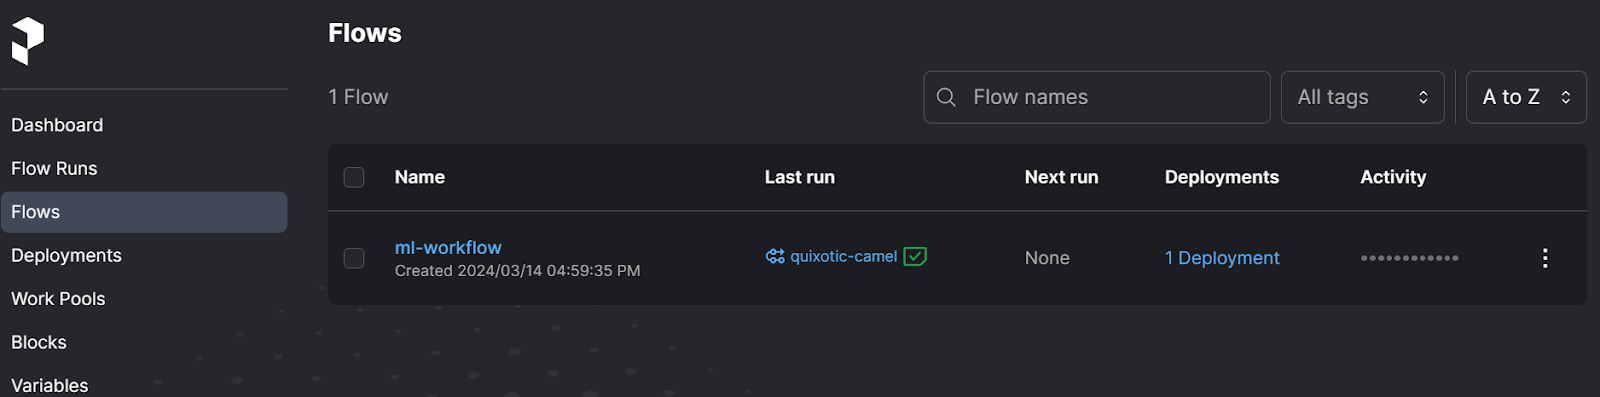
En cliquant sur « Flows », vous verrez tous les flows disponibles. Plusieurs flows peuvent exister au sein d'un même deployment.
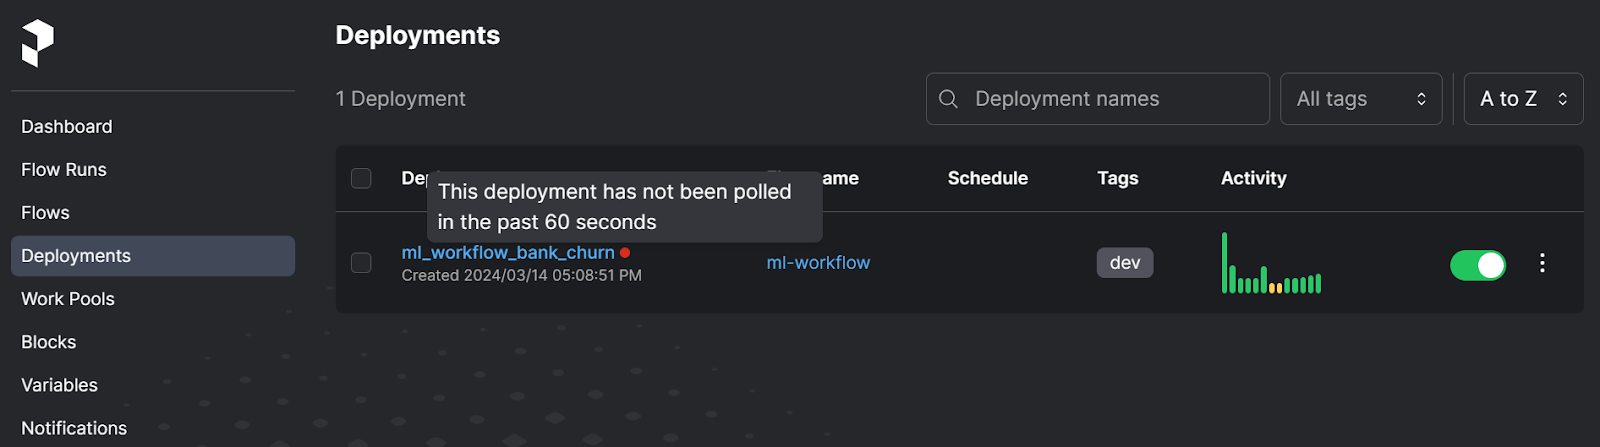
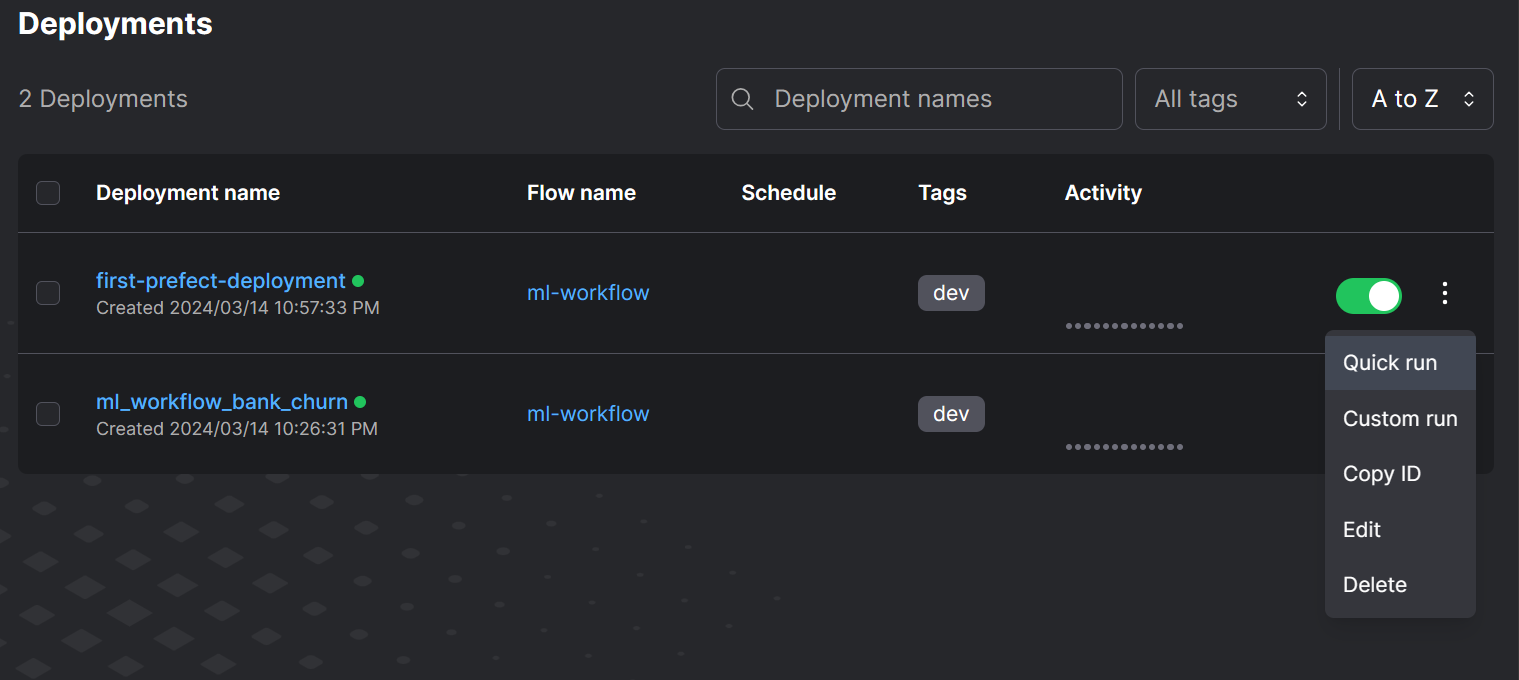
Dans la section Deployments, vous pouvez consulter le deployment actuel, son activité et ses tags. Vous pouvez y lancer le flow en exécution rapide ou planifier une exécution via l'interface.
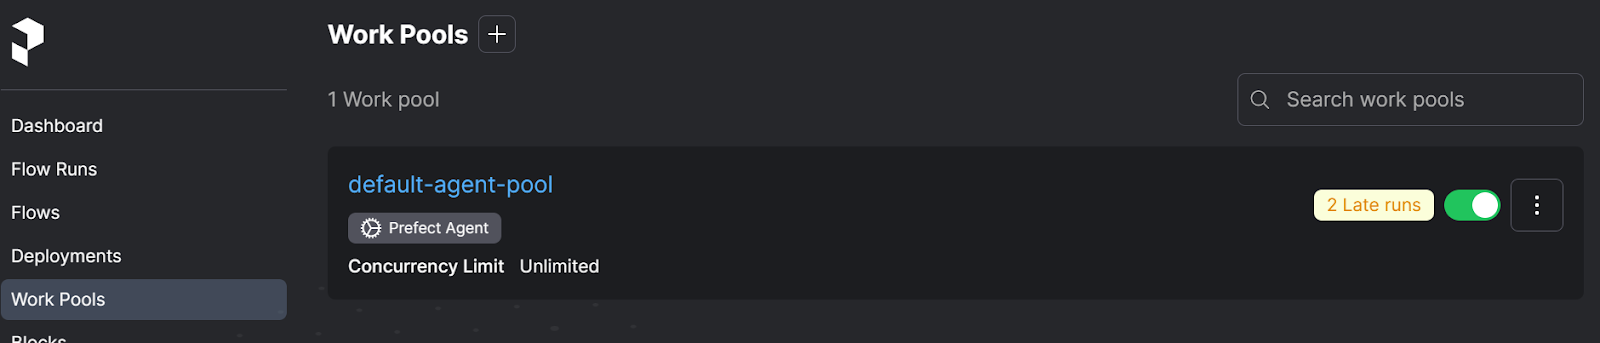
Dans Work Pools, vous verrez notre Prefect Agent par défaut. Vous pouvez aussi configurer un work pool cloud avec la CLI Prefect.
Passons à la partie la plus concrète.
Personne ne souhaite surveiller un workflow en continu. L'idéal est de recevoir des notifications sur l'application de messagerie de votre choix, afin de réagir rapidement en cas de problème.
Pour cela, nous allons créer un webhook Discord. À l'aide de l'ID et du jeton du webhook, nous configurerons une notification Prefect. Tous les logs seront envoyés sur le serveur Discord.
Pour créer un webhook, ouvrez les paramètres de votre serveur Discord, cliquez sur « Integrations », puis « View Webhooks ». Cliquez ensuite sur « New Webhook ».
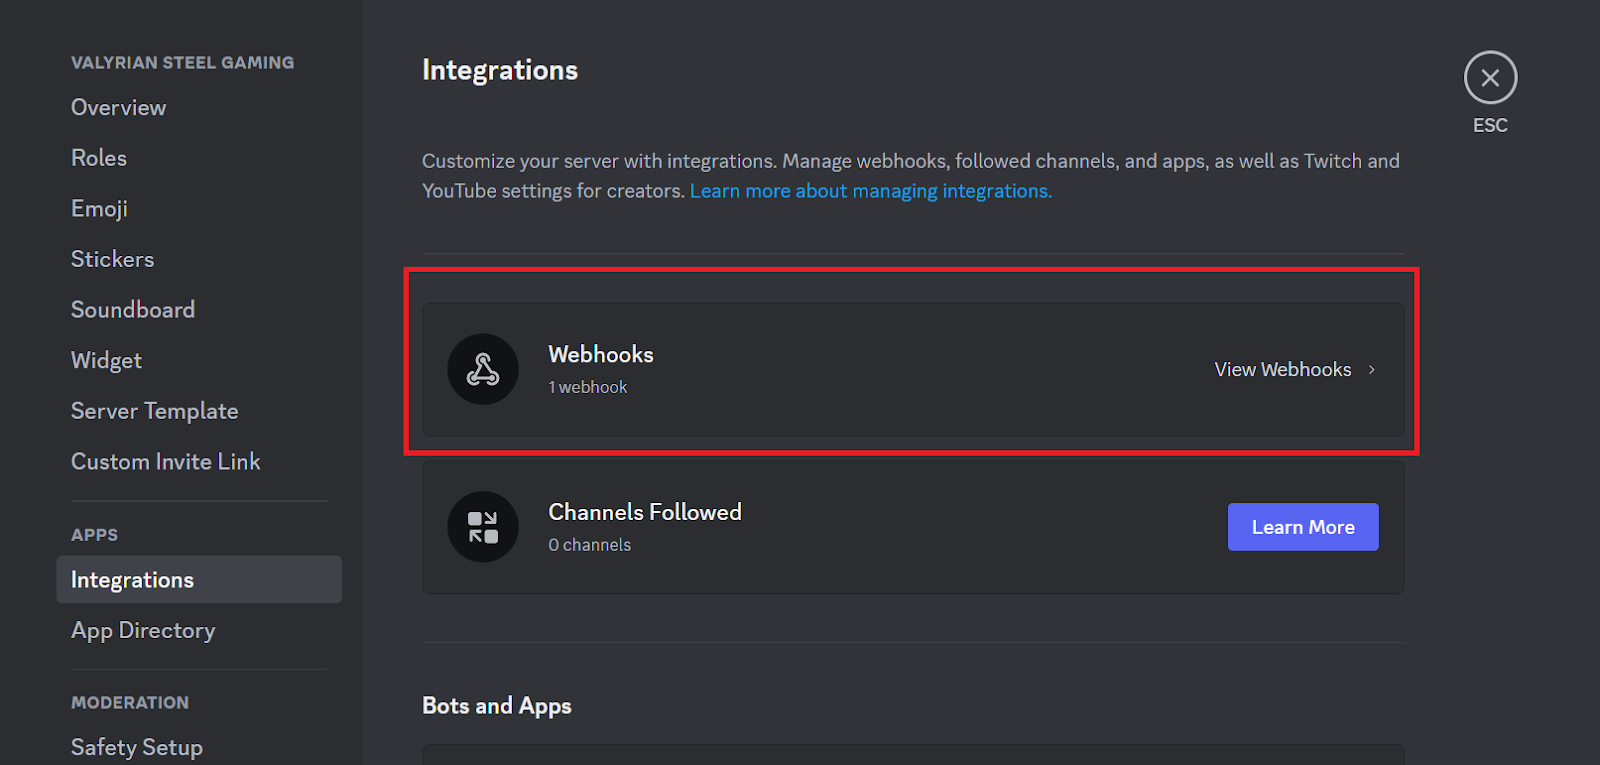
Modifiez l'image, le nom et le canal d'affichage. Puis copiez l'URL du webhook.
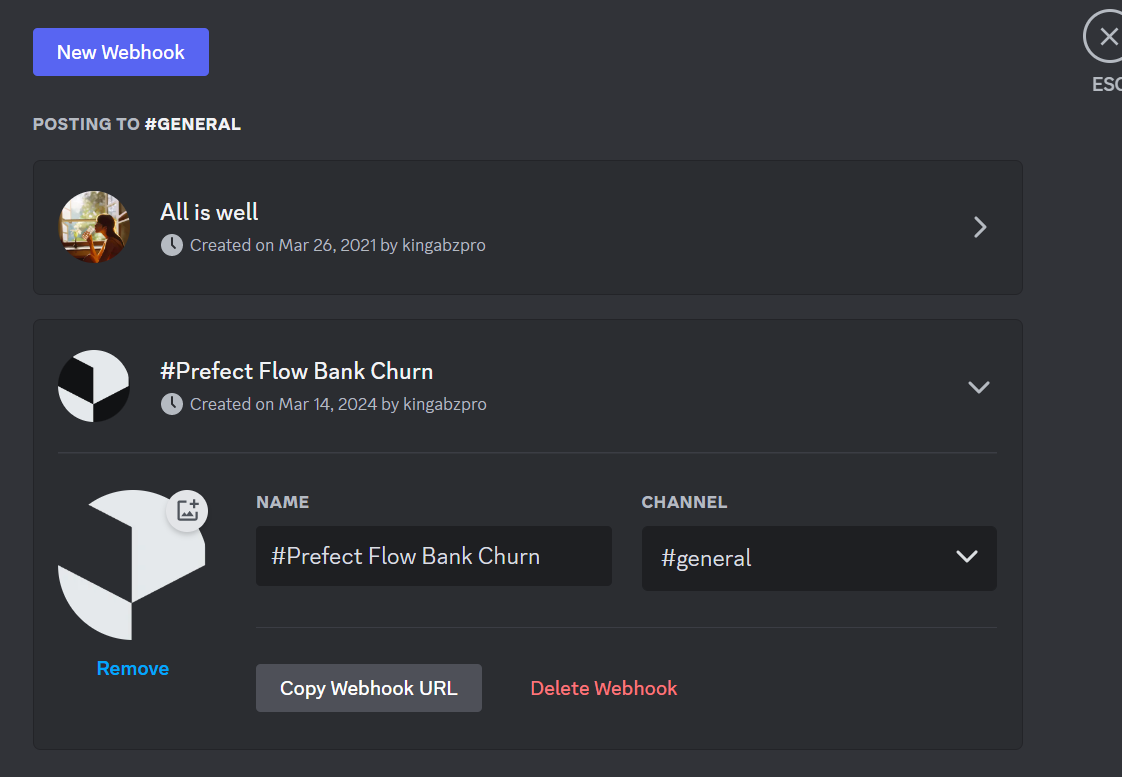
L'URL du webhook comporte deux parties : l'ID et le jeton du webhook : https://discord.com/api/webhooks/<webhook_id>/<webhook_token>. Pour créer une notification Prefect, nous devons séparer manuellement ces deux éléments.
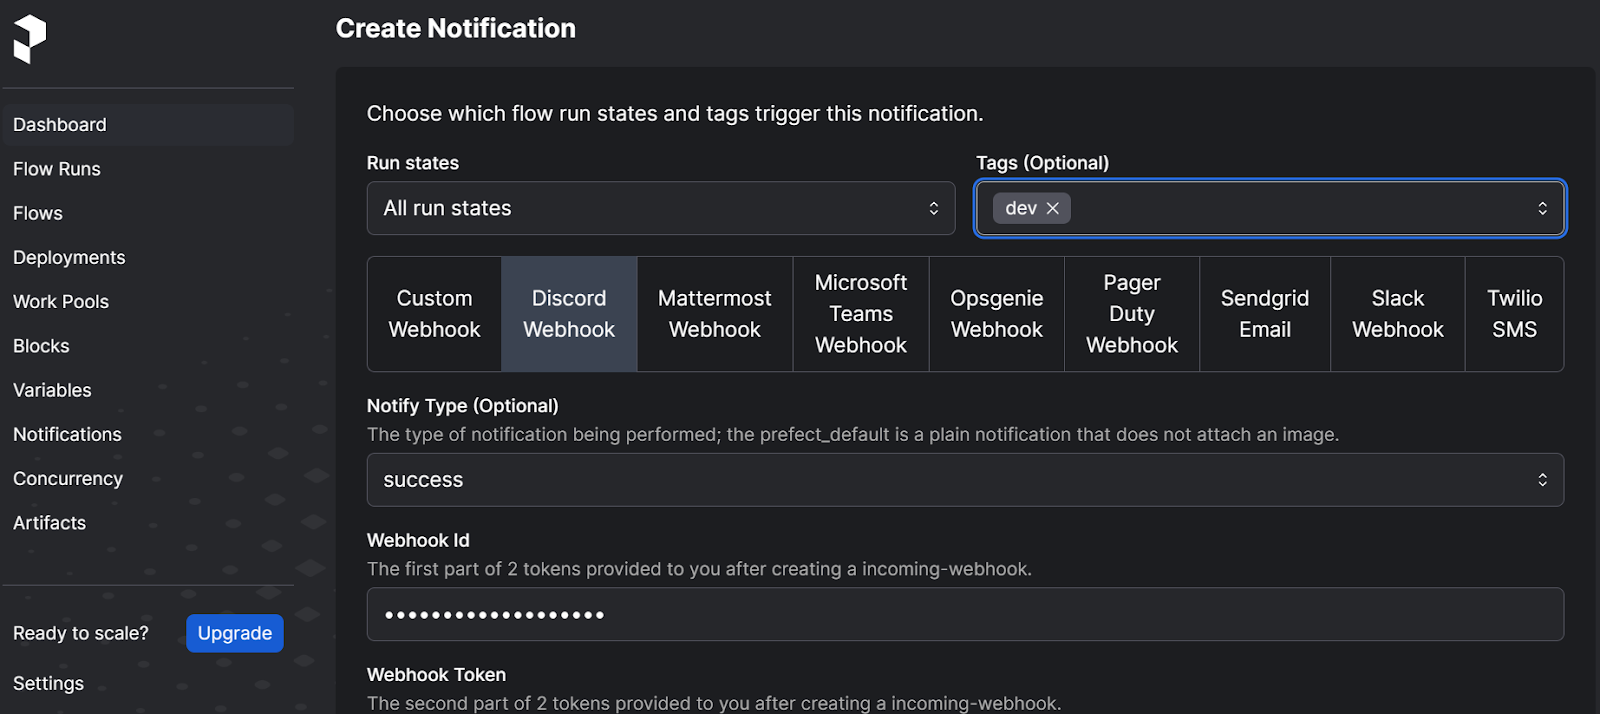
Pour créer une notification Discord dans l'interface Prefect, allez dans « Notifications », cliquez sur « + », puis choisissez les états d'exécution, les tags, le webhook Discord et le type de notification.
Indiquez ensuite l'ID et le jeton du webhook, puis cliquez sur le bouton bleu « Create ».
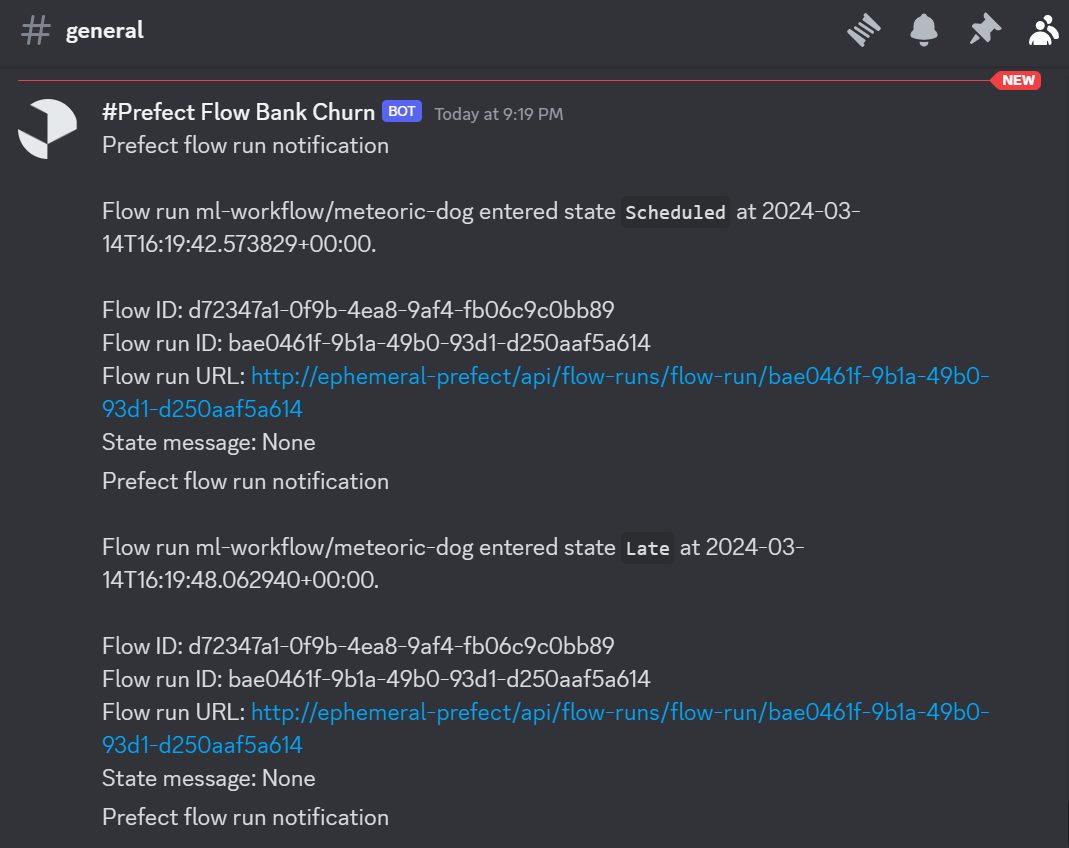
Il faut maintenant exécuter le deployment pour voir les notifications apparaître sur le canal principal de notre serveur Discord.
$ prefect deployment run 'ml-workflow/ml_workflow_bank_churn'Parfait. Avec la même méthode, vous pouvez configurer Microsoft Teams, Slack, SMS, email, ou créer votre propre webhook personnalisé.
Suivez le cours Designing Machine Learning Workflows in Python pour apprendre à construire des pipelines durables.
Après avoir déployé notre flow en local, passons à Prefect Cloud. C'est encore plus simple : pas besoin de démarrer de serveur ni d'agent, ni d'exécuter quoi que ce soit en CLI. Tout est géré par Prefect.
Avant de déployer ce flow, notez qu'une erreur surviendra s'il tente d'accéder à des fichiers locaux inaccessibles depuis le cloud. Pour rendre ces fichiers disponibles à Prefect Cloud, créez un dépôt GitHub public et poussez-y votre code.
Vous pouvez le faire facilement via le site GitHub ou l'extension Git de VSCode pour créer le dépôt distant et pousser le code via l'interface.
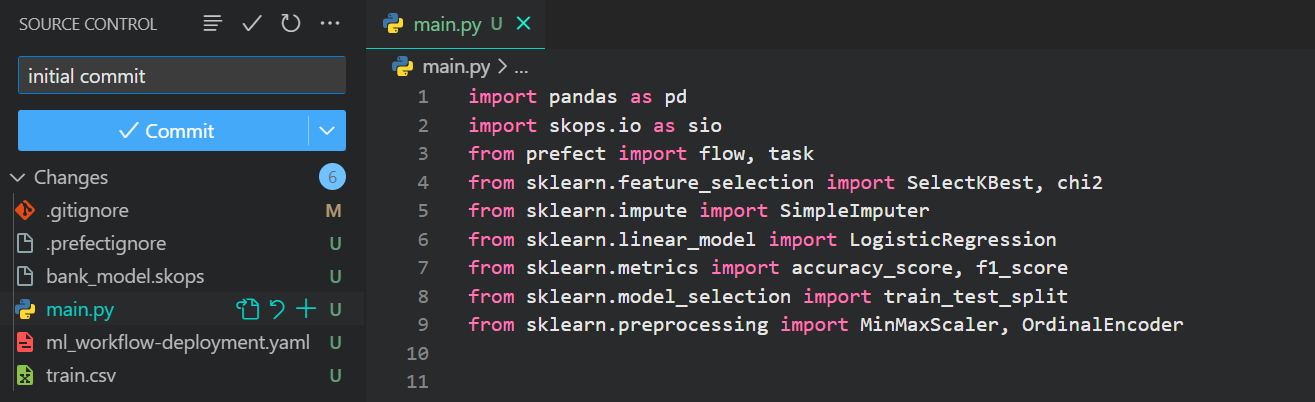
Voici le dépôt de projet que nous allons utiliser pour les déploiements cloud : kingabzpro/ML-Workflow-Orchestration-With-Prefect
Créez votre compte Prefect Cloud sur https://app.prefect.cloud/auth/login, puis connectez-vous via la CLI Prefect.
$ prefect cloud loginChoisissez « Log in with a web browser » et suivez les étapes pour authentifier le client local auprès de Prefect Cloud.
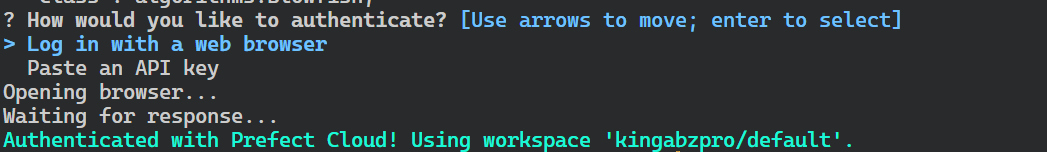
Nous allons créer un work pool géré par Prefect pour exploiter pleinement l'infrastructure de Prefect Cloud, plutôt que d'utiliser notre agent local.
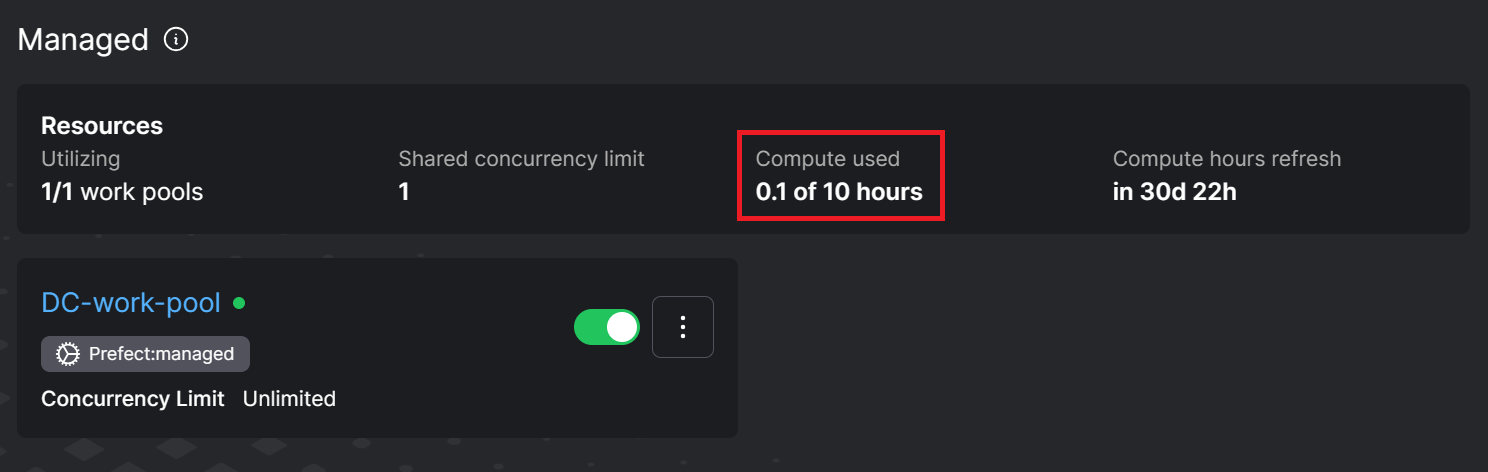
$ prefect work-pool create DC-work-pool --type prefect:managedAvec un compte gratuit, Prefect offre 10 heures de calcul par mois pour expérimenter.
Nous allons maintenant déployer notre flow sur Prefect Cloud de manière programmatique.
Créez un nouveau fichier nommé deployment.py.
Paramétrez les arguments pour la fonction de flow Prefect :
from prefect import flow

if __name__ == "__main__":
    flow.from_source(
        source="https://github.com/kingabzpro/ML-Workflow-Orchestration-With-Prefect.git",
        entrypoint="main.py:ml_workflow",
    ).deploy(
        name="first-prefect-deployment",
        work_pool_name="DC-work-pool",
        tags=["dev"],
        job_variables={"pip_packages": ["pandas", "skops", "scikit-learn"]},
    )
Exécutez le fichier Python.
$ python deployment.pyLe flow est maintenant déployé sur Prefect Cloud. Vous pouvez l'exécuter via la CLI ou depuis le tableau de bord Prefect Cloud.
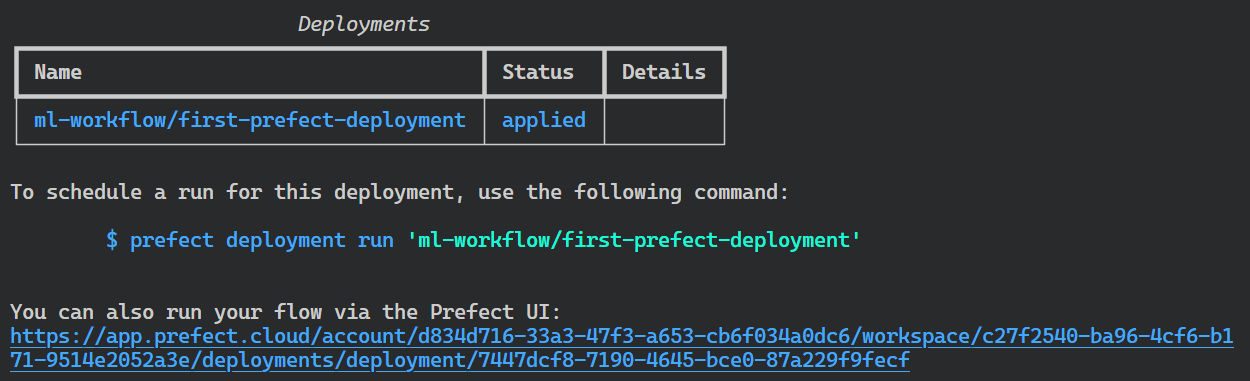
Pour lancer le flow, rendez-vous sur https://app.prefect.cloud/. Ensuite, ouvrez la section « Deployments », cliquez sur le bouton à trois points verticaux de votre deployment et choisissez « Quick run ».
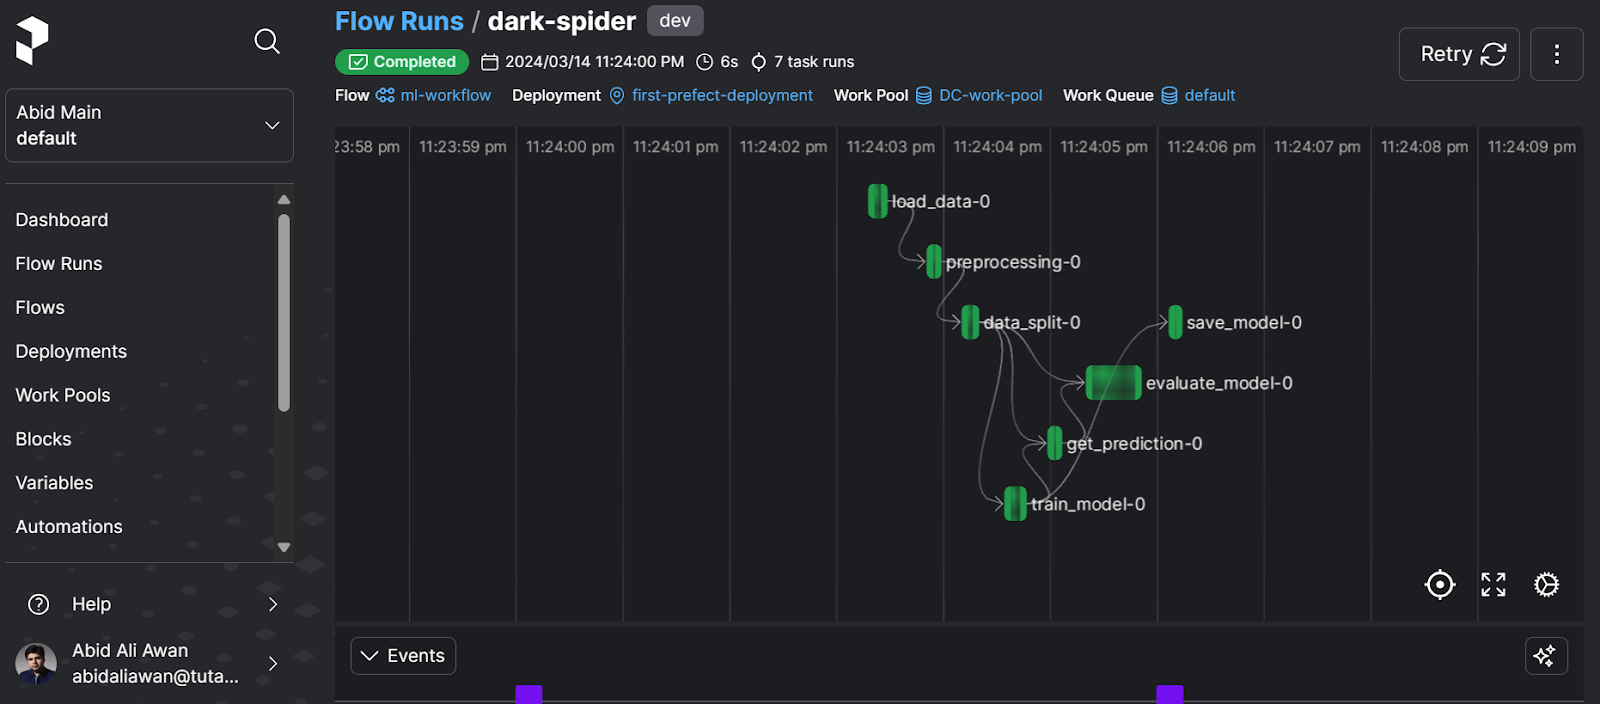
Pour suivre l'exécution, allez dans la section « Flow Run » et cliquez sur la plus récente pour afficher le graphe du workflow.
Le diagramme montre l'enchaînement des tasks et le temps pris par chaque étape.
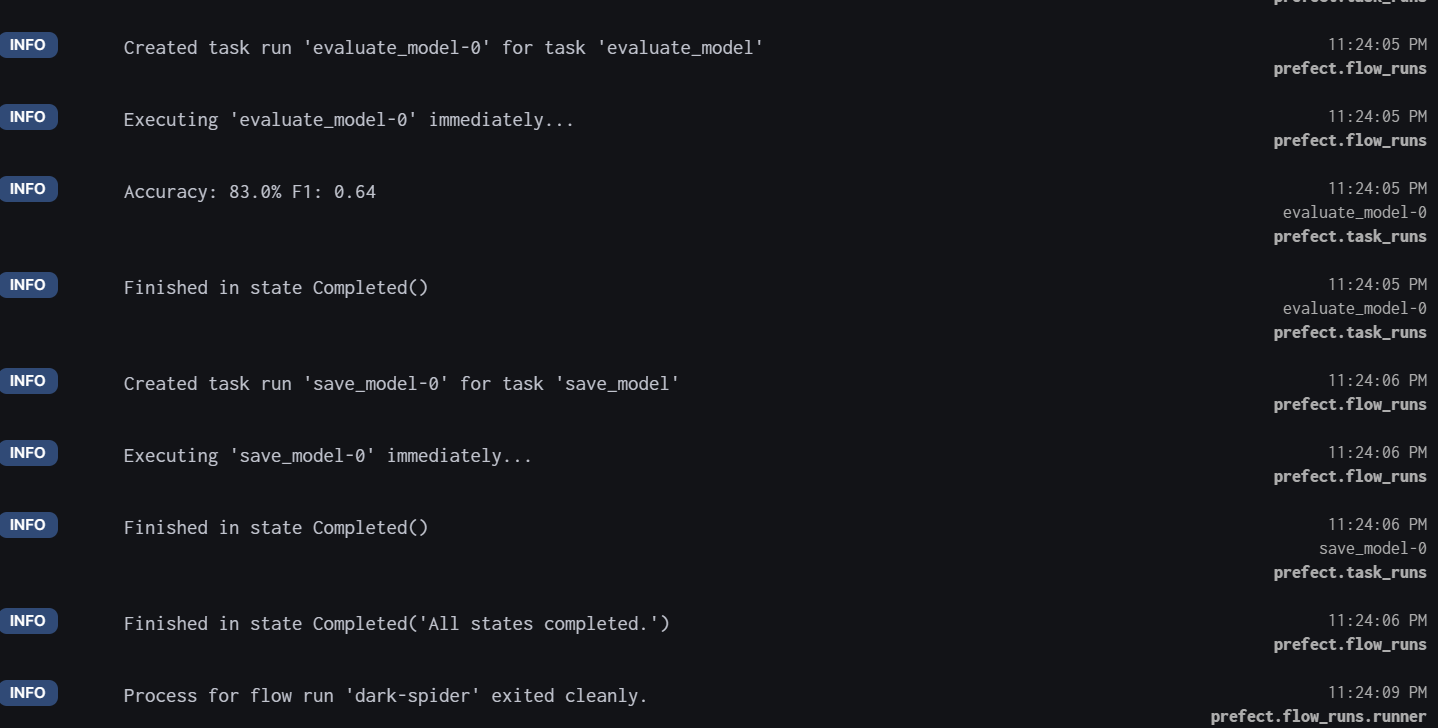
Pour des logs détaillés, faites défiler vers le bas et consultez toutes les tasks avec leur horodatage.
Dans « Work Pools », vous verrez que 0,1 heure sur les 10 heures gratuites a été consommée.
Consultez le guide Machine Learning Workflow, accompagné d'une infographie, pour visualiser les étapes de la mise en place de projet, la préparation des données, le modélisation et le déploiement.
Mettre en place un unique workflow de machine learning est simple. Dans des cas réels, vous devrez souvent exécuter simultanément plusieurs workflows data et ML. C'est là que Prefect se démarque : il offre l'évolutivité et la flexibilité nécessaires, que vous choisissiez un environnement local ou cloud pour vos serveurs Prefect ou vos work pools. C'est un excellent outil pour planifier, automatiser et piloter des workflows.
Dans ce tutoriel, nous avons passé en revue les principales fonctionnalités de l'écosystème Prefect. Nous avons aussi appris à déployer un flow de machine learning en local puis dans le cloud. Pour poursuivre votre parcours MLOps, apprenez à construire une CI/CD pour les workflows de machine learning avec « A Beginner's Guide to CI/CD for Machine Learning ».
Prefect n'est qu'un des outils MLOps dédiés à l'orchestration de workflows. Pour découvrir d'autres outils clés pour la gestion de versions des données, les feature stores, les tests de modèles, le déploiement et le serving, la surveillance des modèles, les moteurs d'exécution et les suites MLOps de bout en bout, lisez l'article 25 Top MLOps Tools You Need to Know in 2024. Vous pouvez également consulter notre comparaison Prefect vs Airflow pour voir comment ces outils se positionnent.
Poursuivez votre aventure en machine learning dès aujourd'hui !
Cours
Cours
Cours