Curso
Comprender el machine learning
2 h
308K
Con los últimos avances en modelos de visión por computador basados en deep learning, crear aplicaciones de detección de objetos es más fácil que nunca. Además de mejorar notablemente el rendimiento, estas técnicas aprovechan grandes conjuntos de imágenes para reducir la necesidad de recopilar datos propios a gran escala. Y, como los enfoques actuales tienden a cubrir todo el flujo de trabajo de extremo a extremo, el rendimiento también ha mejorado de forma significativa, haciendo posibles casos de uso en tiempo real.
Igual que en el artículo que escribí sobre diferentes arquitecturas de clasificación de imágenes, aquí repasaré dos arquitecturas de detección de objetos. Hablaré de SSD y Faster R-CNN, que actualmente están disponibles en la Tensorflow Detection API.
Primero repasaremos algunos conceptos clave de la detección de objetos y luego veremos cómo se implementan en SSD y Faster R-CNN.
A menudo se confunden los escenarios de clasificación de imágenes y de detección de objetos. En general, si quieres clasificar una imagen en una categoría, usas clasificación de imágenes. En cambio, si tu objetivo es identificar la ubicación de los objetos en una imagen y, por ejemplo, contar cuántas instancias hay, lo adecuado es la detección de objetos.
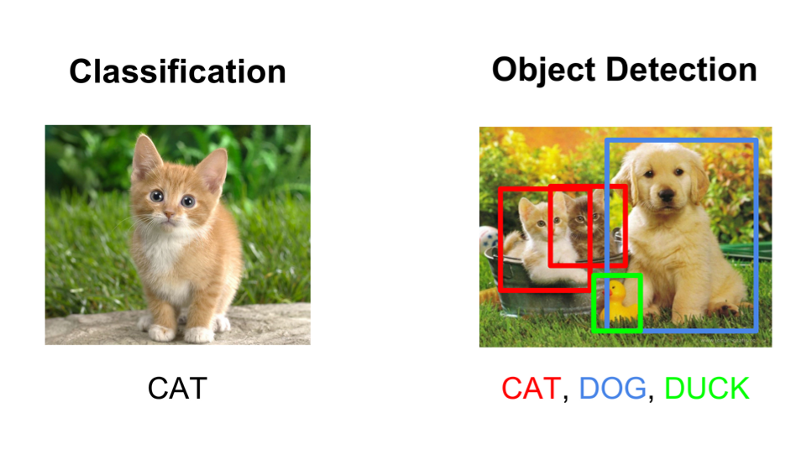
No obstante, hay cierto solapamiento entre ambos escenarios. Si quieres clasificar una imagen en una categoría concreta, puede ocurrir que el objeto o las señales necesarias para categorizar sean demasiado pequeñas respecto al tamaño total de la imagen. En ese caso, podrías obtener mejores resultados con detección de objetos en lugar de clasificación, incluso aunque no te interesen la ubicación exacta ni el recuento.
Imagina que necesitas inspeccionar placas de circuitos y clasificarlas como defectuosas o correctas. Aunque en esencia es un problema de clasificación, los defectos podrían ser demasiado sutiles para un modelo de clasificación de imágenes. Construir un conjunto de datos con anotaciones de detección llevará más tiempo, pero probablemente dará lugar a un modelo mejor.
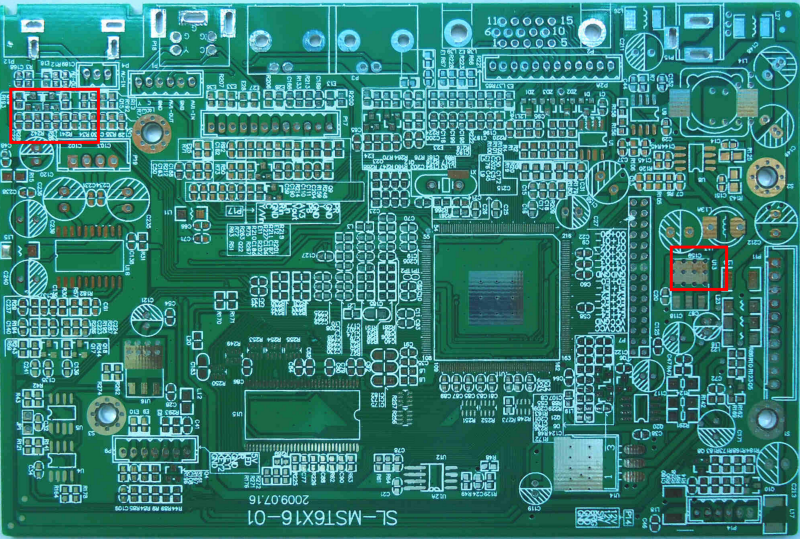
Con un modelo de clasificación de imágenes, generas características (con métodos tradicionales o de deep learning) a partir de la imagen completa. Esas características son agregados globales. Con detección de objetos, trabajas a un nivel más fino y regional. En el primer caso, podrías perder la señal de clasificación; en el segundo, la señal puede conservarse de una forma más útil para el caso de uso.
Para entrenar un modelo a medida, necesitas datos etiquetados. En detección de objetos, esto significa imágenes con sus correspondientes coordenadas de los cuadros delimitadores (bounding boxes) y etiquetas: las coordenadas (x,y) de la esquina inferior izquierda y superior derecha + la clase.
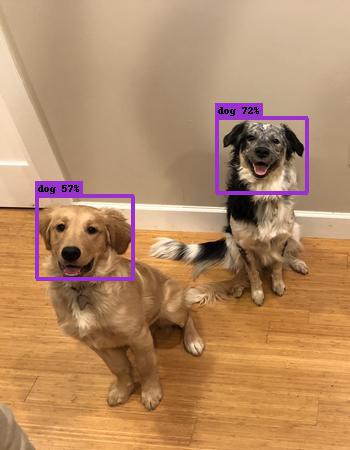
La pregunta típica es: para hacer detección de objetos en el problema X, ¿cuántas imágenes necesito? Más importante que el número es entender bien en qué escenarios se usará el modelo. Es crucial disponer de un gran número (por ejemplo, > 100 y potencialmente > 1000) de imágenes representativas por clase. Representativas significa que reflejen el abanico de situaciones en las que se usará el modelo. Si construyes un detector de señales de tráfico para un coche, usa imágenes tomadas con diferentes condiciones de clima, iluminación y cámara, y en su contexto real. Los modelos de detección no hacen magia; si no tienen suficientes datos para aprender patrones generales, no rendirán bien en producción.
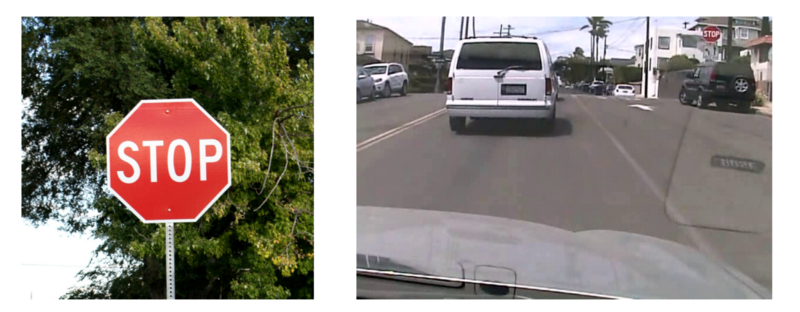
Normalmente, un sistema de detección de objetos sigue tres pasos.
Existen varios enfoques para generar propuestas de región. Originalmente se usaba el algoritmo de «selective search». Lillie Weng lo explica a fondo en su blog. En resumen, es un método de clustering que agrupa píxeles y genera propuestas a partir de esos grupos.
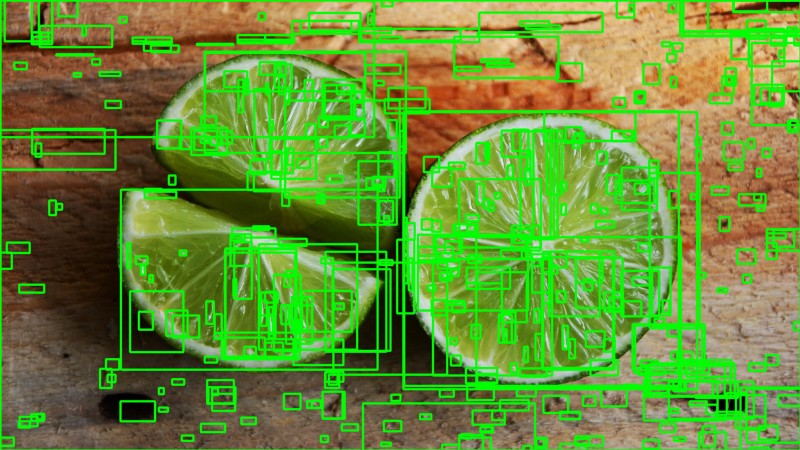
Otros métodos usan características visuales más complejas extraídas de la imagen (por ejemplo, desde un modelo de deep learning) o adoptan un enfoque de fuerza bruta similar a una ventana deslizante sobre la imagen, con varias relaciones de aspecto y escalas. Estas regiones se generan automáticamente sin tener en cuenta las características de la imagen.
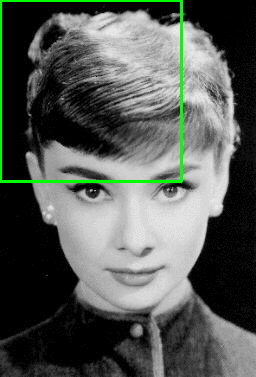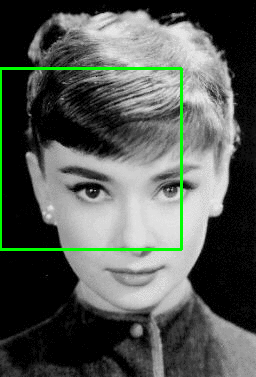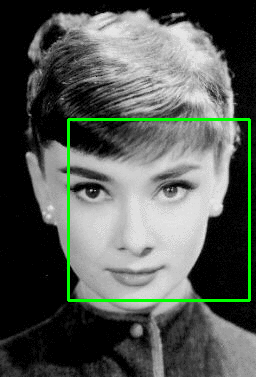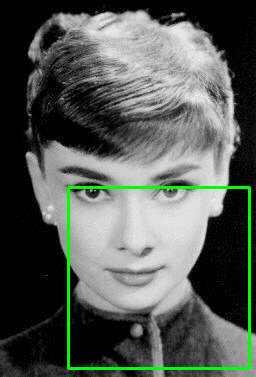
Un compromiso clave al generar propuestas es el número de regiones frente a la complejidad computacional. Cuantas más regiones generes, más probable será encontrar el objeto. Pero si generas todas las posibles, por ejemplo, no podrás ejecutar el detector en tiempo real. A veces se puede usar información específica del problema para reducir ROIs. Por ejemplo, los peatones suelen tener una relación de aspecto de ~1,5; no tiene sentido generar ROIs con ratio 0,25.
El objetivo es reducir una imagen de tamaño variable a un conjunto fijo de características visuales. Los modelos de clasificación de imágenes suelen construirse con potentes métodos de extracción de características. Ya sean enfoques tradicionales (filtros, histogramas, etc.) o de deep learning, todos buscan lo mismo: extraer rasgos representativos para la tarea y usarlos para determinar la clase de la imagen. En detección, se suelen usar modelos de clasificación preentrenados para extraer características, porque generalizan bastante bien. Por ejemplo, un modelo entrenado en MS COCO extrae rasgos bastante genéricos. Aun así, para mejorar el modelo conviene probar enfoques distintos. Mi artículo sobre transfer learning distingue claramente los tipos de transferencia y sus pros y contras.
La idea de la supresión no máxima (NMS) es reducir el número de detecciones en un fotograma hasta el número real de objetos. Si el objeto es grande y se han generado más de 2000 propuestas, es muy probable que muchas se solapen entre sí y con el objeto. Mira este vídeo en Coursera para aprender más sobre NMS. Las técnicas de NMS suelen ser estándar entre frameworks, pero es un paso importante que puede requerir ajustar hiperparámetros según el escenario.
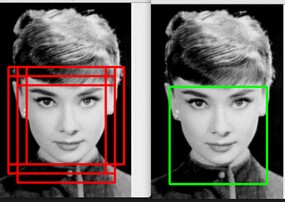
La métrica más habitual en reconocimiento de objetos es la «mAP», abreviatura de «mean average precision». Es un valor de 0 a 100; cuanto más alto, mejor, pero no equivale a la exactitud (accuracy) de clasificación.
Cada cuadro tiene una puntuación asociada (probabilidad de contener un objeto). Con las predicciones se calcula una curva precisión-recall (PR) por clase variando el umbral de la puntuación. La average precision (AP) es el área bajo esa curva. Primero se calcula la AP por clase y luego se promedian las clases: el resultado es la mAP.
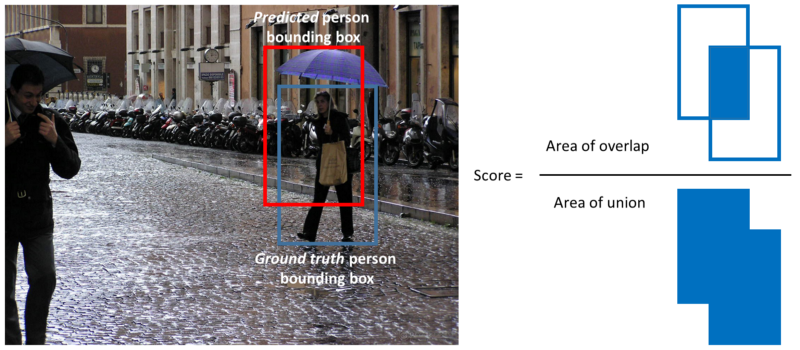
Una detección se considera verdadero positivo si su «intersection over union» (IoU o solape) con la caja de referencia supera un umbral (normalmente 0,5). En lugar de mAP a secas solemos usar mAP@0.5 o mAP@0.25 para indicar el IoU empleado.
Tensorflow Detection API reúne muchas de las ideas anteriores en un único paquete y te permite iterar rápido sobre distintas configuraciones con el backend de Tensorflow. Con la API defines el modelo de detección mediante archivos de configuración, y la propia API se encarga de orquestar todos los elementos necesarios.
Para entender mejor los componentes compatibles, echa un vistazo a la carpeta «protos», que contiene las definiciones. Para el fine-tuning, son especialmente relevantes los protos de train, eval, ssd, faster_rcnn y preprocessing.
La arquitectura SSD fue publicada en 2016 por investigadores de Google. Presenta un modelo de detección con una única red neuronal profunda que combina propuestas regionales y extracción de características.
Se utiliza un conjunto de cajas por defecto con distintas relaciones de aspecto y escalas aplicadas a los mapas de características. Como estos mapas se obtienen pasando la imagen por una red de clasificación, la extracción de rasgos para las cajas se realiza en un solo paso. Se generan puntuaciones para cada categoría en cada una de las cajas por defecto. Para ajustar mejor a las cajas «ground truth», se calculan desplazamientos de ajuste para cada cuadro.
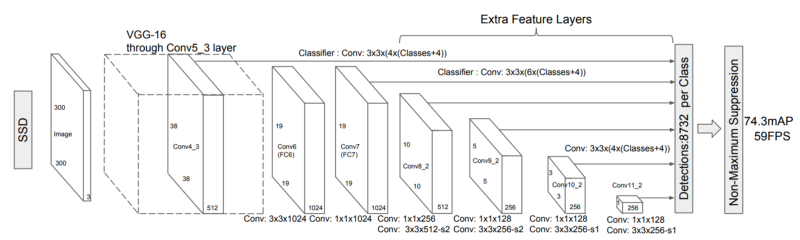
Diferentes mapas de características en la red convolucional corresponden a diferentes campos receptivos y permiten gestionar de forma natural objetos a distintas escalas. Al encapsular el cómputo en una sola red, se logran velocidades altas (por ejemplo, para entradas de 300 × 300, 59 FPS).
Para el uso, revisaremos los archivos de configuración de ejemplo de SSD. Hay varios parámetros importantes al trabajar con SSD y los repasaremos uno a uno.
Primero, distintas redes de clasificación tienen fortalezas y debilidades diferentes (consulta este artículo para una visión general). Por ejemplo, Inceptionv3 detecta bien objetos a distintas escalas; ResNet logra una precisión muy alta; y Mobilenet está optimizada para minimizar los recursos computacionales. El rendimiento del extractor de características en ImageNet, el número de parámetros y el conjunto de datos original son buenos indicadores del equilibrio rendimiento/velocidad. El extractor se define en la sección «feature_extractor».
Segundo, los parámetros de las cajas por defecto y las relaciones de aspecto. Según el problema, conviene analizar las relaciones de aspecto y escalas de las cajas en los datos etiquetados. Configurarlas evita cálculos innecesarios. Puedes ajustarlas en «ssd_anchor_generator». Ten en cuenta que añadir más escalas y relaciones suele mejorar el rendimiento, aunque con rendimientos decrecientes.
Tercero, al entrenar es importante fijar el tamaño de imagen y las opciones de aumento de datos en «data_augmentation_options» e «image_resizer». Un tamaño mayor suele rendir mejor porque los objetos pequeños son difíciles de detectar, pero tiene un coste computacional notable. El aumento de datos es especialmente importante en SSD para detectar objetos a distintas escalas (incluso si no aparecen así en el entrenamiento).
Por último, ajustar «train_config», estableciendo tasas de aprendizaje y tamaños de lote, es clave para reducir el sobreajuste y dependerá en gran medida del tamaño de tu dataset.
Faster R-CNN fue desarrollado por investigadores de Microsoft. Se basa en R-CNN, que usaba un enfoque multi-fase: Selective search para propuestas de región, una red de clasificación y un SVM para clasificar regiones.
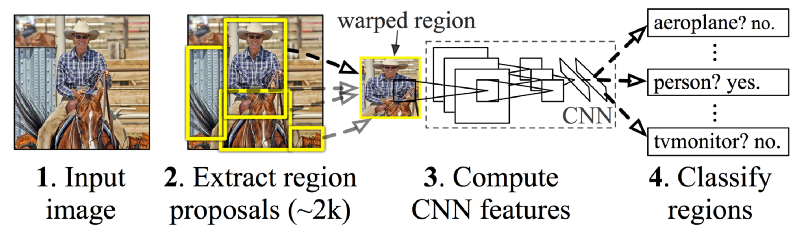
Faster R-CNN, como SSD, es un enfoque de extremo a extremo. En lugar de usar cajas por defecto, incorpora una Red de Propuestas de Región (RPN) para generar un conjunto fijo de regiones. La RPN usa las características convolucionales de la red de clasificación, lo que permite propuestas casi gratuitas en coste. Se implementa como una red totalmente convolucional que predice límites y puntuaciones de «objetidad» en cada posición.
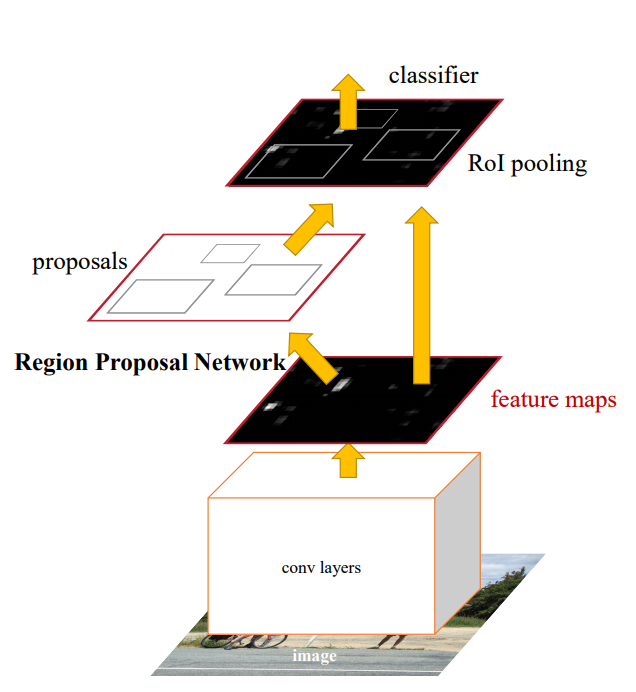
La RPN tiene un planteamiento similar al de SSD (no predice cajas «de la nada»). Funciona con ventanas deslizantes sobre los mapas de características. En cada posición o ancla, se calculan propuestas con varias escalas y relaciones de aspecto. Igual que en SSD, el resultado de la RPN son cajas «ajustadas» a partir de los anclajes.
Los distintos componentes se combinan en un único sistema y se entrenan de extremo a extremo o en varias fases (para mejorar la estabilidad). Otra forma de verlo es que la RPN dirige la «atención» de la red a regiones interesantes.
La mayoría de detalles de uso de Faster R-CNN son similares a los de SSD. En mAP bruta, Faster R-CNN suele superar a SSD, pero requiere mucha más potencia computacional.
Una sección importante del detector Fast(er)-RCNN es «first_stage_anchor_generator», que define los anclajes que genera la RPN. Los «strides» de esta sección marcan los pasos de la ventana deslizante. Ojo al detectar objetos pequeños: si el stride es demasiado grande, podrías pasarlos por alto.
Aunque los autores de Faster R-CNN no usaron un aumento de datos extensivo, sigue siendo recomendable cuando trabajes con conjuntos pequeños.
Hay más arquitecturas de detección de objetos que no he tratado. Para aplicaciones en tiempo real, Yolov2 suele mencionarse como una arquitectura importante (bastante parecida a SSD). Actualizaré este artículo cuando se añada a la Tensorflow Detection API.
Si tienes preguntas, estaré encantado de leerte en los comentarios. ¡Sígueme en Medium o en Twitter para no perderte mis próximas publicaciones!
Aprende más sobre machine learning
Curso
Curso
Curso
blog
Zoumana Keita
15 min
Tutorial
Natassha Selvaraj
8 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Zoumana Keita
14 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Moez Ali
14 min