Kurs
Machine Learning verstehen
2 Std.
308.6K
Dank der jüngsten Fortschritte bei Deep-Learning-basierten Computer-Vision-Modellen lassen sich Anwendungen zur Objekterkennung heute einfacher entwickeln als je zuvor. Neben deutlichen Leistungsgewinnen nutzen diese Verfahren große Bilddatensätze und senken damit den Bedarf an eigenen Daten. Außerdem setzen aktuelle Ansätze auf durchgängige End-to-End-Pipelines – das steigert die Performance nochmals und ermöglicht Echtzeitanwendungen.
Ähnlich wie in meinem Blogpost zu verschiedenen Bildklassifikationsarchitekturen stelle ich zwei Architekturen der Objekterkennung vor. Ich bespreche SSD und Faster R-CNN, die beide in der TensorFlow Detection API verfügbar sind.
Zuerst gehe ich auf einige Schlüsselkonzepte der Objekterkennung ein und zeige anschließend, wie sie in SSD und Faster R-CNN umgesetzt sind.
Bildklassifikation und Objekterkennung werden oft verwechselt. Grundsätzlich gilt: Willst du ein Bild einer Kategorie zuordnen, nutzt du Bildklassifikation. Möchtest du hingegen die Position von Objekten im Bild bestimmen und zum Beispiel die Anzahl der Vorkommen zählen, ist Objekterkennung das richtige Werkzeug.
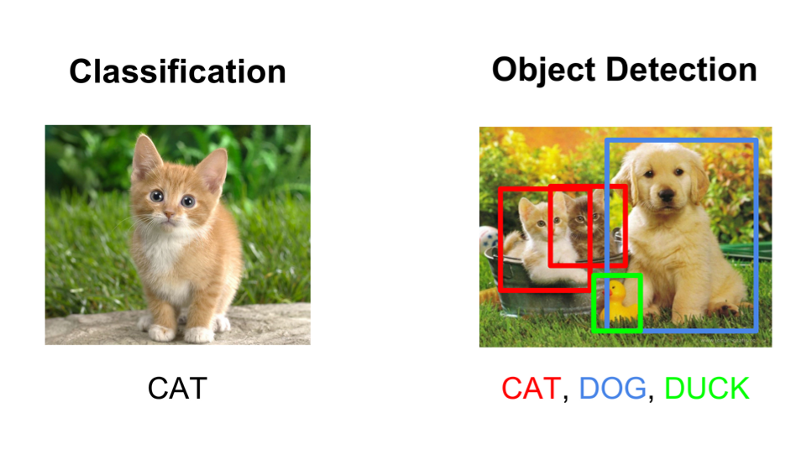
Zwischen beiden Szenarien gibt es jedoch Überschneidungen. Wenn du ein Bild klassifizieren willst, kann es sein, dass das relevante Objekt oder die entscheidenden Merkmale im Verhältnis zum gesamten Bild zu klein sind. Dann liefert Objekterkennung oft bessere Ergebnisse als reine Klassifikation – selbst wenn dich die genaue Position oder die Anzahl eigentlich nicht interessiert.
Stell dir vor, du musst Leiterplatten prüfen und sie als defekt oder in Ordnung klassifizieren. Im Kern ist das ein Klassifikationsproblem, aber die Defekte können so klein sein, dass ein Bildklassifikationsmodell sie übersieht. Der Aufbau eines Objekterkennungs-Datensatzes kostet mehr Zeit, führt aber sehr wahrscheinlich zu einem besseren Modell.
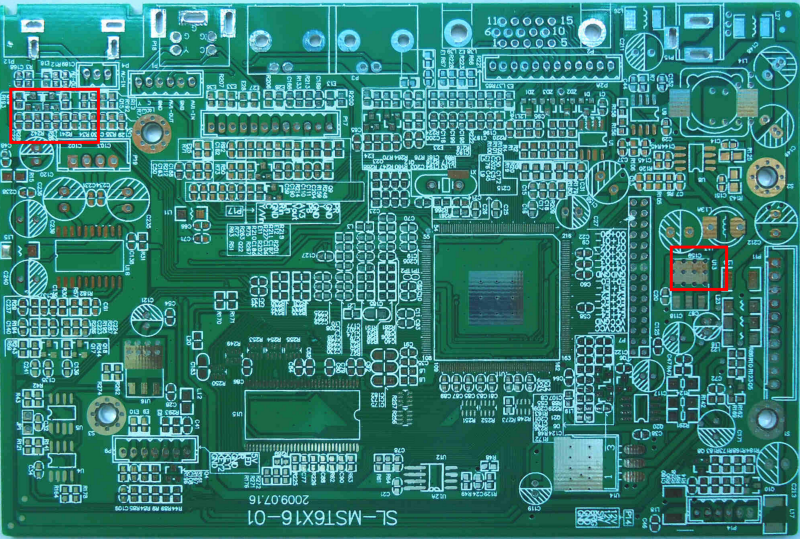
Bei einem Bildklassifikationsmodell erzeugst du Bildmerkmale (klassisch oder per Deep Learning) für das gesamte Bild. Diese Merkmale sind Aggregationen. In der Objekterkennung arbeitest du feinkörniger und extrahierst Merkmale auf regionaler Ebene. In der Klassifikation kann dabei das relevante Signal untergehen, während es bei der Objekterkennung in einer für den Anwendungsfall besseren Form erhalten bleibt.
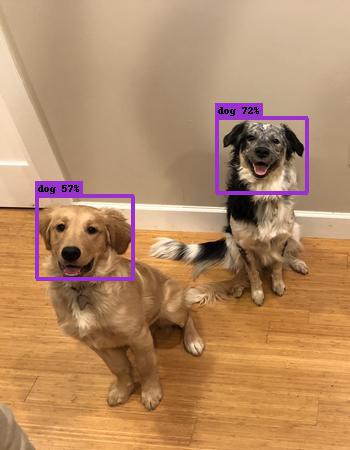
Um ein eigenes Modell zu trainieren, brauchst du gelabelte Daten. In der Objekterkennung sind das Bilder mit zugehörigen Bounding-Box-Koordinaten und Labels, also die unteren linken und oberen rechten (x,y)-Koordinaten plus die Klasse.
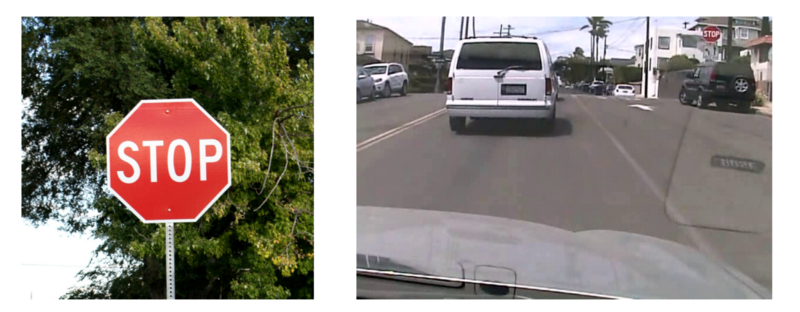
Die Standardfrage lautet: Für Problem X – wie viele Bilder brauche ich? Wichtiger ist zu verstehen, in welchen Szenarien das Modell später läuft. Entscheidend ist, dass pro Klasse eine große Zahl (zum Beispiel > 100, besser > 1000) repräsentativer Bilder vorhanden ist. Repräsentativ heißt: Sie decken die Bandbreite der späteren Einsatzszenarien ab. Wenn du ein Verkehrszeichenerkennungsmodell für Autos baust, brauchst du Bilder bei unterschiedlichem Wetter, Licht und mit verschiedenen Kameras – jeweils im passenden Kontext. Objekterkennungsmodelle sind kein Zauberwerk, sondern ziemlich dumm. Bekommt das Modell nicht genug Daten, um allgemeine Muster zu lernen, liefert es in der Praxis schlechte Ergebnisse.
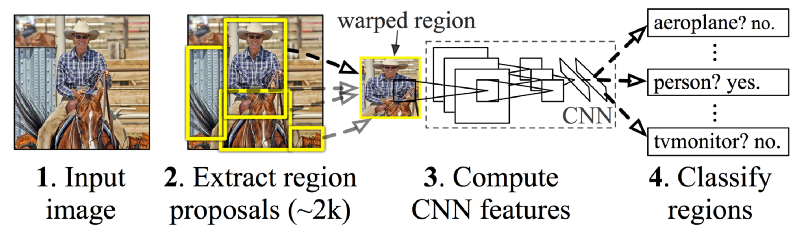
Typischerweise umfasst ein Framework zur Objekterkennung drei Schritte.
Es gibt verschiedene Ansätze zur Generierung von Region Proposals. Ursprünglich wurde der Algorithmus „Selective Search“ verwendet. Lillie Weng erklärt ihn ausführlich in ihrem Blogpost. Kurz gesagt ist Selective Search ein clusteringbasierter Ansatz, der Pixel gruppiert und daraus Vorschläge erzeugt.
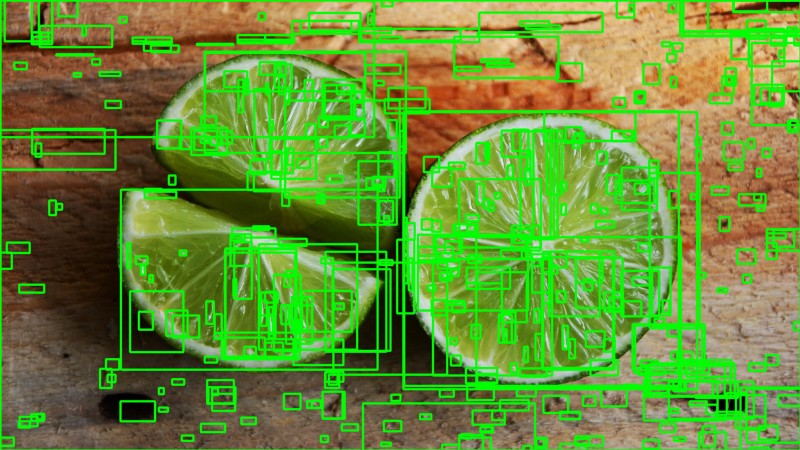
Andere Ansätze nutzen komplexere visuelle Merkmale des Bildes (z. B. aus einem Deep-Learning-Modell) oder setzen auf einen Brute-Force-Ansatz – ähnlich einem Sliding Window in verschiedenen Seitenverhältnissen und Skalen. Diese Regionen werden automatisch erzeugt, ohne Bildmerkmale zu berücksichtigen.
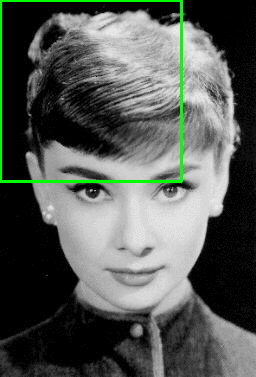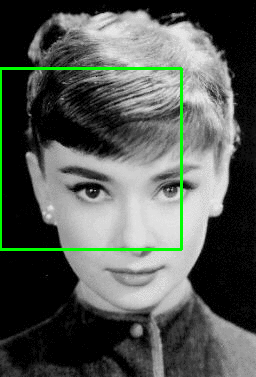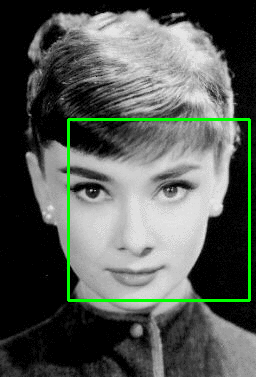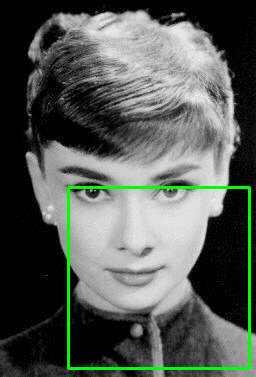
Ein zentraler Trade-off bei Region Proposals ist die Anzahl der Regionen vs. Rechenaufwand. Je mehr Regionen du erzeugst, desto eher findest du das Objekt. Wenn du jedoch alle möglichen Vorschläge erschöpfend generierst, ist ein Einsatz in Echtzeit nicht mehr möglich. In manchen Fällen lässt sich die Anzahl der ROIs durch problemspezifisches Wissen reduzieren. Fußgänger haben zum Beispiel typischerweise ein Seitenverhältnis von etwa 1,5 – ROIs mit 0,25 lohnen sich dann nicht.
Ziel der Feature-Extraktion ist es, ein Bild variabler Größe auf einen festen Satz visueller Merkmale zu reduzieren. Bildklassifikationsmodelle setzen dabei auf starke Verfahren zur Merkmalsextraktion – ob klassische Computer-Vision-Ansätze (z. B. Filter, Histogramme) oder Deep Learning. Das Ziel ist identisch: repräsentative Merkmale für die Aufgabe aus dem Eingabebild extrahieren und daraus die Klasse bestimmen. In Objekterkennungsframeworks nutzt man häufig vortrainierte Bildklassifikationsmodelle zur Merkmalsextraktion, da sie gut generalisieren. Ein auf MS COCO trainiertes Modell liefert beispielsweise recht generische Merkmale. Um das Modell zu verbessern, lohnt es sich, verschiedene Ansätze zu testen. Mein Blogpost zu Transfer Learning erklärt die Typen, Vor- und Nachteile im Detail.
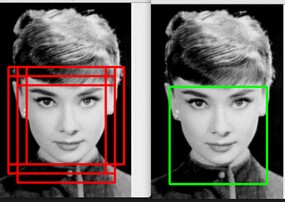
Die Idee hinter Non-Maximum Suppression (NMS) ist, die Anzahl der erkannten Boxen im Bild auf die tatsächliche Objektanzahl zu reduzieren. Ist ein Objekt groß und wurden mehr als 2000 Vorschläge generiert, überlappen sich einige stark untereinander und mit dem Objekt. Schau dir dieses Video auf Coursera an, um mehr über NMS zu lernen. NMS ist in den verschiedenen Frameworks meist ähnlich implementiert, aber der Schritt ist wichtig und erfordert je nach Szenario Feintuning der Hyperparameter.
Die gängigste Metrik für Objekterkennung ist „mAP“ – die „mean average precision“. Sie liegt zwischen 0 und 100. Höher ist besser, aber sie ist nicht mit der Accuracy der Klassifikation gleichzusetzen.
Jede Bounding Box erhält einen Score (Wahrscheinlichkeit, dass sie ein Objekt enthält). Aus den Vorhersagen wird für jede Klasse durch Variation des Schwellwerts eine Precision-Recall-Kurve (PR-Kurve) gebildet. Die Average Precision (AP) ist die Fläche unter der PR-Kurve. Zuerst berechnet man die AP pro Klasse, anschließend mittelt man über alle Klassen – das ergibt die mAP.
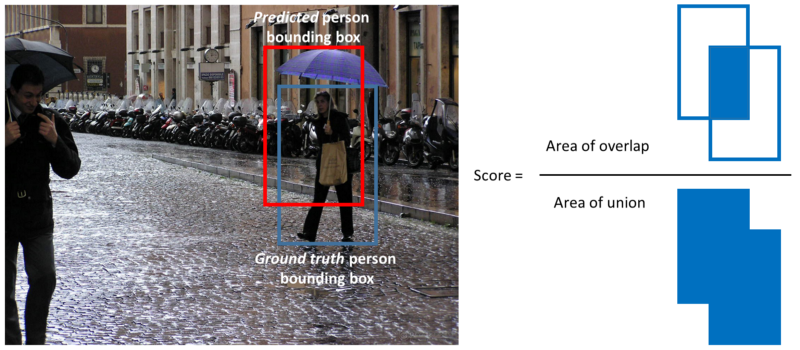
Eine Detektion gilt als True Positive, wenn ihre „Intersection over Union“ (IoU, Überlappung) mit der Ground-Truth-Box größer als ein Schwellwert ist (meist 0,5). Statt einfach mAP geben wir daher oft mAP@0.5 oder mAP@0.25 an – entsprechend dem verwendeten IoU.
Die TensorFlow Detection API bündelt viele der oben genannten Ideen in einem Paket. So kannst du mit dem TensorFlow-Backend schnell verschiedene Konfigurationen testen. Du definierst das Objekterkennungsmodell über Konfigurationsdateien, und die TensorFlow Detection API setzt die nötigen Bausteine zusammen.
Um besser zu verstehen, welche Komponenten unterstützt werden, schau dir den protos-Ordner mit den Funktionsdefinitionen an. Besonders wichtig fürs Finetuning sind die Protos für train, eval, ssd, faster_rcnn und preprocessing.
Die SSD-Architektur wurde 2016 von Google-Forschenden veröffentlicht. Sie kombiniert Region Proposals und Feature-Extraktion in einem einzigen tiefen neuronalen Netz.
Ein Satz vordefinierter Boxen über verschiedene Seitenverhältnisse und Skalen wird auf die Feature Maps angewendet. Da diese Feature Maps aus einem Bildklassifikationsnetz stammen, lassen sich die Merkmale für die Bounding Boxes in einem Schritt extrahieren. Für jede Objektkategorie wird in jeder Default-Box ein Score berechnet. Um die Ground-Truth-Boxen besser zu treffen, werden pro Box Korrekturoffsets gelernt.
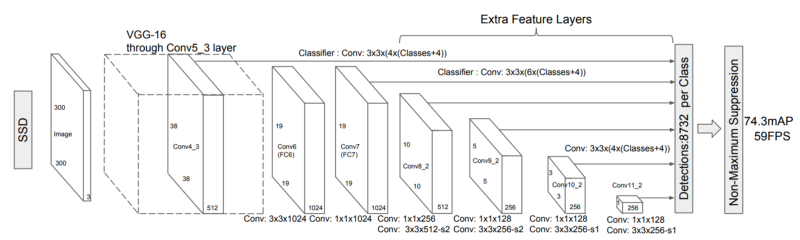
Unterschiedliche Feature Maps im Convolutional Network haben verschiedene rezeptive Felder und eignen sich daher natürlich für Objekte in unterschiedlichen Skalen. Da die gesamte Berechnung in einem einzigen Netz gekapselt ist, werden hohe Geschwindigkeiten erreicht (z. B. 59 FPS bei 300 × 300 Input).
Für den praktischen Einsatz betrachten wir die Beispiel-Konfigurationsdateien für SSD. Mehrere Parameter sind entscheidend – gehen wir sie durch.
Erstens haben verschiedene Klassifikationsnetze unterschiedliche Stärken und Schwächen (einen Überblick gibt dieser Blogpost). Inceptionv3 erkennt Objekte gut in verschiedenen Skalen, ResNet erzielt insgesamt sehr hohe Genauigkeit. Mobilenet hingegen minimiert den Rechenbedarf. Die Performance des Feature-Extractors auf ImageNet, die Anzahl der Parameter und der ursprüngliche Trainingsdatensatz sind gute Indikatoren für den Trade-off zwischen Leistung und Geschwindigkeit. Der Feature-Extractor wird im Abschnitt „feature_extractor“ definiert.
Zweitens sind die Einstellungen für Default-Boxen und Seitenverhältnisse zentral. Je nach Problem lohnt es sich, die Verteilung der Seitenverhältnisse und Skalen in den gelabelten Daten zu analysieren. So vermeidest du unnötige Berechnungen. Anpassen kannst du das im Abschnitt „ssd_anchor_generator“. Mehr Skalen und Seitenverhältnisse verbessern meist die Leistung, jedoch mit abnehmendem Grenznutzen.
Drittens solltest du beim Training die Bildgröße und Datenaugmentation in den Abschnitten „data_augmentation_options“ und „image_resizer“ setzen. Größere Bilder liefern oft bessere Ergebnisse, da kleine Objekte schwer zu erkennen sind – kosten aber deutlich mehr Rechenzeit. Datenaugmentation ist bei SSD besonders wichtig, um Objekte in unterschiedlichen Skalen zu erkennen (auch in Skalen, die im Training nicht vorkommen).
Schließlich ist das Finetuning der „train_config“ – Lernraten und Batchgrößen – wichtig, um Overfitting zu reduzieren. Die optimalen Werte hängen stark von der Datensatzgröße ab.
Faster R-CNN wurde von Forschenden bei Microsoft entwickelt. Es basiert auf R-CNN, das einen mehrstufigen Ansatz nutzte: Selective Search zur Regionenvorschlagserzeugung, dann ein Klassifikationsnetz und anschließend ein SVM zur Klassifikation der Regionen.
Faster R-CNN ist – ähnlich wie SSD – ein End-to-End-Ansatz. Statt Default-Boxen nutzt Faster R-CNN ein Region Proposal Network (RPN), das eine feste Menge Regionen erzeugt. Das RPN greift auf die Convolutional Features des Bildklassifikationsnetzes zu und generiert damit nahezu ohne Zusatzkosten Regionenvorschläge. Es ist als vollständig konvolutionelles Netz implementiert und sagt an jeder Position Objektgrenzen und „Objectness“-Scores vorher.
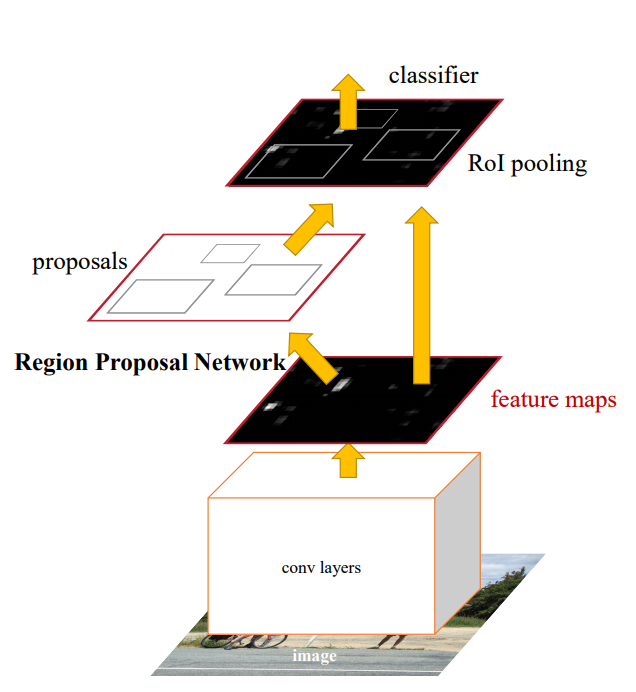
Das RPN ähnelt in seinem Aufbau dem SSD-Netz (es sagt also nicht „aus dem Nichts“ Boxen vorher). Es arbeitet mit Sliding Windows über den Feature Maps. An jeder Sliding-Window-Position – dem Anker – werden Vorschläge mit verschiedenen Skalen und Seitenverhältnissen berechnet. Wie bei SSD entstehen so „angepasste“ Bounding Boxes auf Basis der Anker.
Die einzelnen Komponenten werden in einem System kombiniert und entweder End-to-End oder in mehreren Phasen trainiert (zur Stabilisierung). Man kann das RPN auch als Mechanismus verstehen, der die „Aufmerksamkeit“ des Netzes auf interessante Regionen lenkt.
Viele praktische Details sind analog zu SSD. Hinsichtlich mAP liegt Faster R-CNN meist vor SSD, benötigt aber deutlich mehr Rechenleistung.
Wichtig für den Faster-R-CNN-Detektor ist der Abschnitt „first_stage_anchor_generator“, der die vom RPN erzeugten Anker definiert. Die Strides legen die Schritte des Sliding Windows fest. Achte besonders bei kleinen Objekten darauf – ist der Stride zu groß, verpasst du sie womöglich.
Auch wenn die Autorinnen und Autoren des Faster-R-CNN-Papers keine umfangreiche Datenaugmentation nutzten, empfiehlt sie sich für kleinere Datensätze dennoch.
Es gibt noch einige weitere Architekturen zur Objekterkennung, auf die ich hier nicht eingegangen bin. Für Echtzeitanwendungen wird Yolov2 häufig genannt (recht ähnlich zu SSD). Ich aktualisiere diesen Blogpost, sobald es zur TensorFlow Detection API hinzugefügt wird.
Wenn du Fragen hast, schreib sie gern in die Kommentare. Folge mir auf Medium oder Twitter, um Updates zu meinen Blogposts zu erhalten!
Mehr über Machine Learning
Kurs
Kurs
Kurs
Blog
Tutorial
Matt Crabtree
5 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Derrick Mwiti
10 Min.
Tutorial
Laiba Siddiqui
6 Min.



