Cours
Comprendre le Machine Learning
2 h
308.2K
Avec les récents progrès des modèles de vision par ordinateur basés sur l’apprentissage profond, développer des applications de détection d’objets n’a jamais été aussi simple. Au-delà des gains de performance notables, ces techniques tirent parti de jeux de données d’images massifs pour réduire le besoin de données d’entraînement étendues. De plus, les approches actuelles misent sur des pipelines entièrement de bout en bout, ce qui améliore encore les performances et permet des cas d’usage en temps réel.
À l’instar du billet que j’ai écrit sur les différentes architectures de classification d’images, je vais passer en revue deux architectures de détection d’objets. Je présenterai SSD et Faster R-CNN, toutes deux disponibles aujourd’hui dans la TensorFlow Detection API.
Je commencerai par quelques notions clés en détection d’objets, puis j’illustrerai leur mise en œuvre dans SSD et Faster R-CNN.
On confond souvent classification d’images et détection d’objets. En règle générale, si vous souhaitez classer une image dans une catégorie, vous utilisez la classification. À l’inverse, si votre objectif est d’identifier la position d’objets dans une image et, par exemple, de compter le nombre d’instances d’un objet, vous recourez à la détection d’objets.
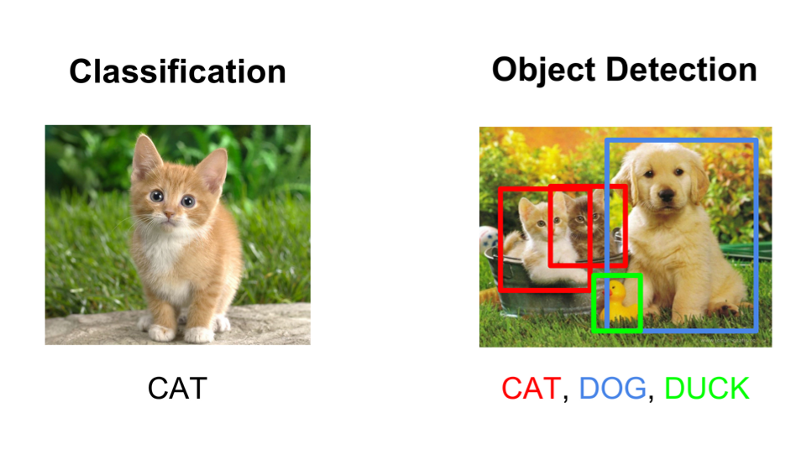
Il existe toutefois un chevauchement entre ces deux scénarios. Si vous voulez classer une image dans une catégorie, il se peut que l’objet ou les caractéristiques nécessaires à la catégorisation soient trop petits par rapport à l’image entière. Dans ce cas, vous obtiendrez souvent de meilleurs résultats avec la détection d’objets plutôt qu’avec la classification, même si l’emplacement exact ou le comptage ne vous intéresse pas.
Imaginez que vous deviez inspecter des circuits imprimés et les classer comme défectueux ou conformes. Bien qu’il s’agisse essentiellement d’un problème de classification, les défauts peuvent être trop petits pour être détectés par un modèle de classification d’images. Construire un jeu de données de détection d’objets demandera plus de temps, mais mènera très probablement à un meilleur modèle.
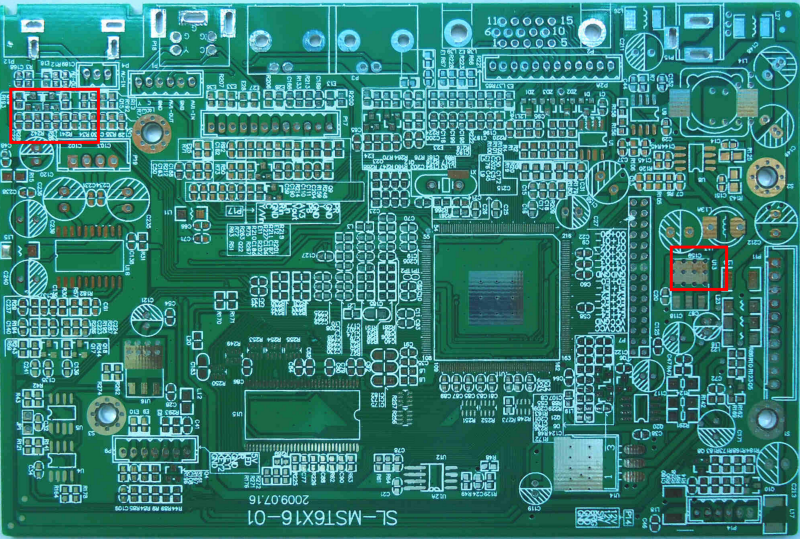
Avec un modèle de classification d’images, vous extrayez des caractéristiques (par des méthodes classiques ou profondes) sur l’image entière. Ces caractéristiques sont des agrégats globaux. En détection d’objets, vous travaillez de façon plus fine, au niveau régional et granulaire de l’image. Dans le premier cas, le signal de classification peut se diluer, alors que dans le second il est préservé d’une manière plus adaptée au besoin.
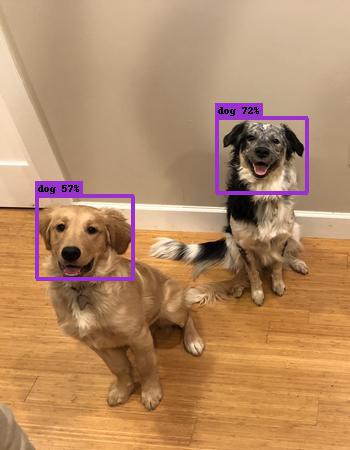
Pour entraîner un modèle sur mesure, vous avez besoin de données annotées. En détection d’objets, il s’agit d’images accompagnées des coordonnées des boîtes englobantes et des labels associés. Concrètement, les coordonnées (x,y) en bas à gauche et en haut à droite + la classe.
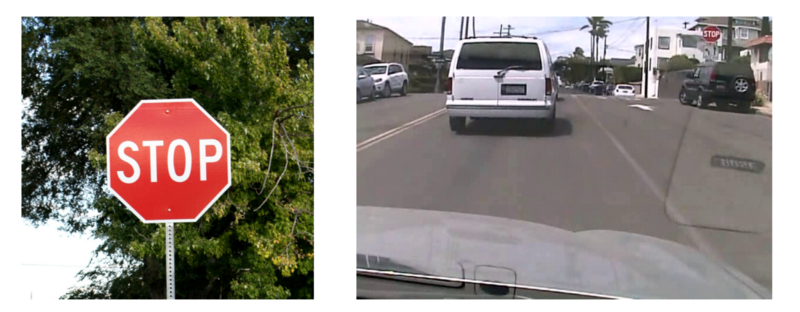
La question récurrente est la suivante : pour faire de la détection d’objets sur le problème X, combien d’images me faut-il ? Il est plus pertinent de bien comprendre dans quels scénarios le modèle sera déployé. Il est crucial de disposer d’un grand nombre (par exemple, > 100 et potentiellement > 1000) d’images représentatives par classe. Représentatives signifie ici qu’elles couvrent l’éventail des situations d’usage du modèle. Si vous concevez un détecteur de panneaux routiers destiné à fonctionner dans une voiture, vous devez utiliser des images prises sous différentes conditions météo, d’éclairage et de caméra, et dans leur contexte. Les modèles de détection d’objets ne font pas de miracles et restent assez « bêtes ». S’ils ne voient pas assez de données pour apprendre des motifs généraux, ils ne performeront pas en production.
En général, un framework de détection d’objets suit trois étapes.
Plusieurs approches existent pour générer des propositions de régions. À l’origine, l’algorithme « selective search » était utilisé. Lillie Weng en propose une excellente explication dans son billet de blog. En bref, selective search est une approche de regroupement qui tente d’agréger des pixels et de générer des propositions à partir des clusters obtenus.
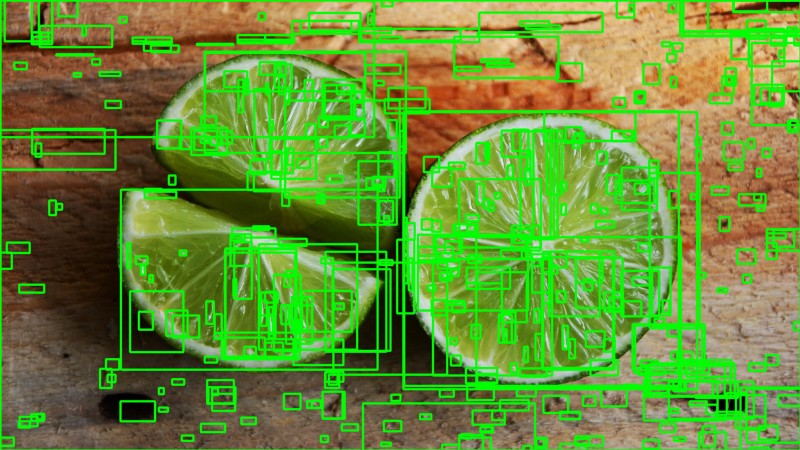
D’autres approches exploitent des caractéristiques visuelles plus complexes extraites de l’image (par exemple, issues d’un modèle d’apprentissage profond) ou adoptent une stratégie de force brute. Ces méthodes rappellent une fenêtre glissante appliquée à l’image, selon plusieurs ratios et échelles. Ces régions sont générées automatiquement, sans tenir compte des caractéristiques visuelles.
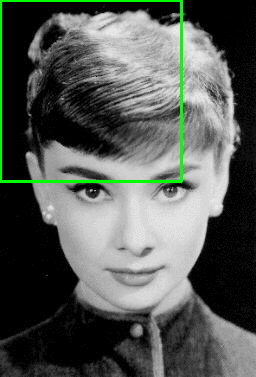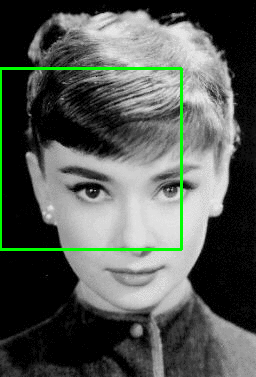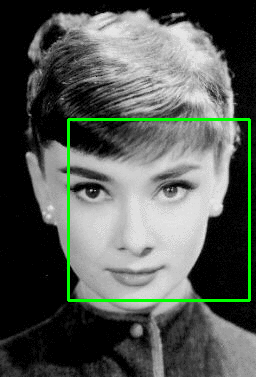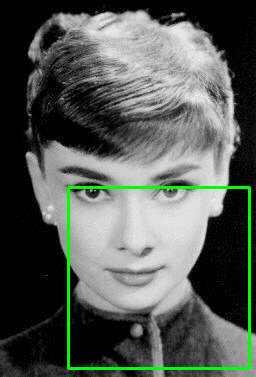
Un compromis essentiel dans la génération de propositions concerne le nombre de régions vs la complexité de calcul. Plus vous générez de régions, plus vous avez de chances de trouver l’objet. En contrepartie, si vous générez toutes les propositions possibles, il sera impossible d’exécuter le détecteur en temps réel. Dans certains cas, on peut utiliser des informations spécifiques au problème pour réduire le nombre de ROI. Par exemple, les piétons ont généralement un ratio d’environ 1,5 : inutile donc de générer des ROI avec un ratio de 0,25.
L’objectif de l’extraction de caractéristiques est de réduire une image de taille variable à un ensemble fixe de descripteurs visuels. Les modèles de classification d’images s’appuient sur des méthodes d’extraction très performantes. Qu’elles soient fondées sur des approches classiques de vision (filtres, histogrammes, etc.) ou sur l’apprentissage profond, toutes visent le même but : extraire des caractéristiques représentatives de la tâche et les utiliser pour déterminer la classe de l’image. En détection d’objets, on réutilise souvent des modèles de classification préentraînés pour extraire les caractéristiques, car ils généralisent bien. Par exemple, un modèle entraîné sur le jeu de données MS COCO sait extraire des descripteurs assez génériques. Pour améliorer le modèle, il reste conseillé d’expérimenter différentes approches. Mon billet sur le transfert d’apprentissage distingue clairement les variantes et leurs avantages/inconvénients.
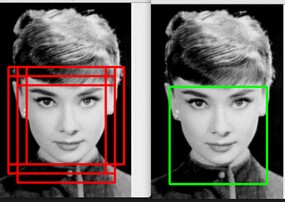
L’idée générale de la suppression des non-maxima (NMS) est de ramener le nombre de détections dans une image au nombre réel d’objets présents. Si l’objet est assez grand et que plus de 2000 propositions ont été générées, il est très probable que certaines se recouvrent fortement entre elles et avec l’objet. Regardez cette vidéo sur Coursera pour en savoir plus sur la NMS. Les techniques de NMS sont généralement standard d’un framework à l’autre, mais c’est une étape importante qui peut nécessiter un réglage d’hyperparamètres selon le scénario.
La métrique d’évaluation la plus courante en reconnaissance d’objets est le « mAP » pour « mean average precision ». Il s’agit d’un score de 0 à 100 : plus il est élevé, mieux c’est, mais il ne se confond pas avec la précision (accuracy) en classification.
Chaque boîte englobante reçoit un score (probabilité de contenir un objet). À partir des prédictions, on calcule une courbe précision–rappel (PR) pour chaque classe en faisant varier le seuil du score. L’average precision (AP) correspond à l’aire sous la courbe PR. On calcule d’abord l’AP pour chaque classe, puis on moyenne sur l’ensemble des classes : on obtient le mAP.
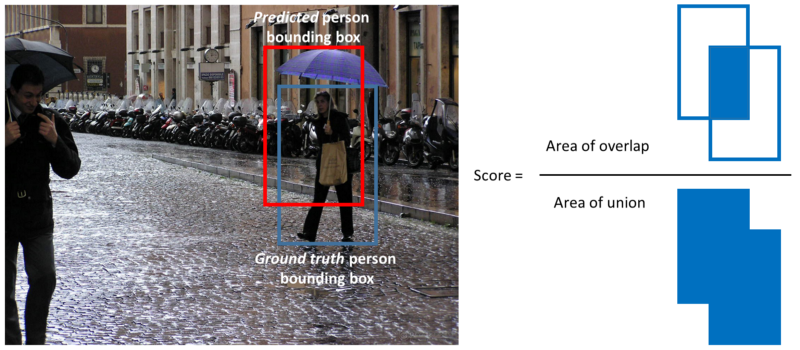
Notez qu’une détection est un vrai positif si son « intersection over union » (IoU ou chevauchement) avec la boîte de vérité terrain dépasse un certain seuil (souvent 0,5). Au lieu d’employer mAP seul, on utilise généralement mAP@0.5 ou mAP@0.25 pour préciser l’IoU retenu.
La TensorFlow Detection API rassemble nombre des idées évoquées dans un seul package, ce qui permet d’itérer rapidement sur différentes configurations avec le backend TensorFlow. Avec l’API, vous définissez le modèle de détection via des fichiers de configuration, et la TensorFlow Detection API se charge d’assembler tous les éléments nécessaires.
Pour mieux comprendre les composants pris en charge, consultez le « dossier protos », qui contient les définitions de fonctions. Les protos train, eval, ssd, faster_rcnn et preprocessing sont particulièrement importants lors d’un affinement de modèle.
L’architecture SSD, publiée en 2016 par des chercheurs de Google, propose un modèle de détection d’objets fondé sur un réseau de neurones profond unique combinant propositions régionales et extraction de caractéristiques.
Un jeu de boîtes par défaut, couvrant différents ratios et échelles, est appliqué aux cartes de caractéristiques. Comme ces cartes sont obtenues en faisant passer l’image dans un réseau de classification, l’extraction des descripteurs pour les boîtes s’effectue en une seule étape. Des scores sont générés pour chaque catégorie d’objet dans chacune des boîtes par défaut. Pour mieux ajuster les boîtes à la vérité terrain, des décalages (offsets) sont calculés pour chaque boîte.
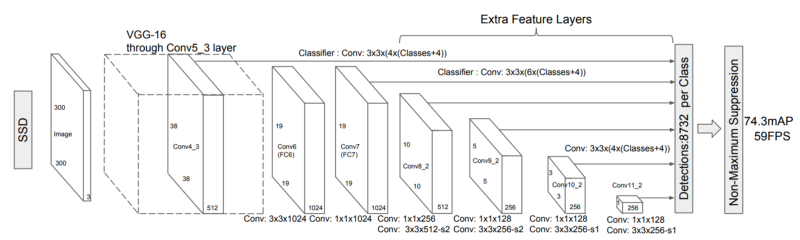
Différentes cartes de caractéristiques dans le réseau convolutionnel correspondent à des champs récepteurs variés et gèrent naturellement des objets à différentes échelles. Comme tous les calculs sont encapsulés dans un réseau unique, on atteint des vitesses élevées (par exemple, 59 FPS pour une entrée 300 × 300).
Pour l’utilisation, examinons les fichiers de configuration d’exemple de SSD. Plusieurs paramètres sont essentiels avec SSD ; passons-les en revue.
Premièrement, les réseaux de classification ont des forces et faiblesses différentes (voir ce billet pour un aperçu). Par exemple, Inceptionv3 est entraîné pour bien détecter des objets à différentes échelles, alors que l’architecture ResNet offre une très grande précision globale. De son côté, MobileNet vise à minimiser les ressources de calcul. Les performances du réseau extracteur sur ImageNet, le nombre de paramètres et le jeu de données d’origine constituent de bons indicateurs du compromis performance/vitesse. L’extracteur de caractéristiques se définit dans la section « feature_extractor ».
Deuxièmement, les réglages des boîtes par défaut et des ratios d’aspect sont cruciaux. Selon le type de problème, il vaut la peine d’analyser les ratios et échelles des boîtes annotées. Les définir correctement évitera des calculs inutiles. Vous pouvez les ajuster dans la section « ssd_anchor_generator ». Notez qu’ajouter des échelles et ratios supplémentaires peut améliorer les performances, mais avec des rendements décroissants.
Troisièmement, à l’entraînement, il est important de fixer la taille d’image et les options d’augmentation de données dans les sections « data_augmentation_options » et « image_resizer ». Une image plus grande détectera mieux les petits objets, au prix d’un coût de calcul notable. L’augmentation de données est particulièrement importante avec SSD pour détecter des objets à différentes échelles (y compris celles absentes des données d’entraînement).
Enfin, affiner « train_config », régler les taux d’apprentissage et les tailles de lot est essentiel pour réduire le surapprentissage, et dépend fortement de la taille de votre jeu de données.
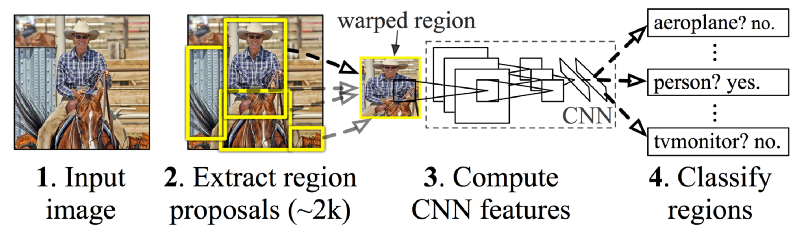
Faster R-CNN a été développé par des chercheurs de Microsoft. Il s’appuie sur R-CNN, qui abordait la détection d’objets en plusieurs phases. R-CNN utilisait Selective search pour produire des propositions de régions, les passait dans un réseau de classification puis recourait à un SVM pour classer les différentes régions.
Faster R-CNN, à l’instar de SSD, adopte une approche de bout en bout. Au lieu d’utiliser des boîtes par défaut, Faster R-CNN intègre un réseau de propositions de régions (RPN) pour générer un ensemble fixe de régions. Le RPN réutilise les caractéristiques convolutionnelles du réseau de classification d’images, ce qui permet des propositions quasi gratuites en coût. Il s’agit d’un réseau entièrement convolutionnel qui prédit, à chaque position, les limites des objets et un score de présence.
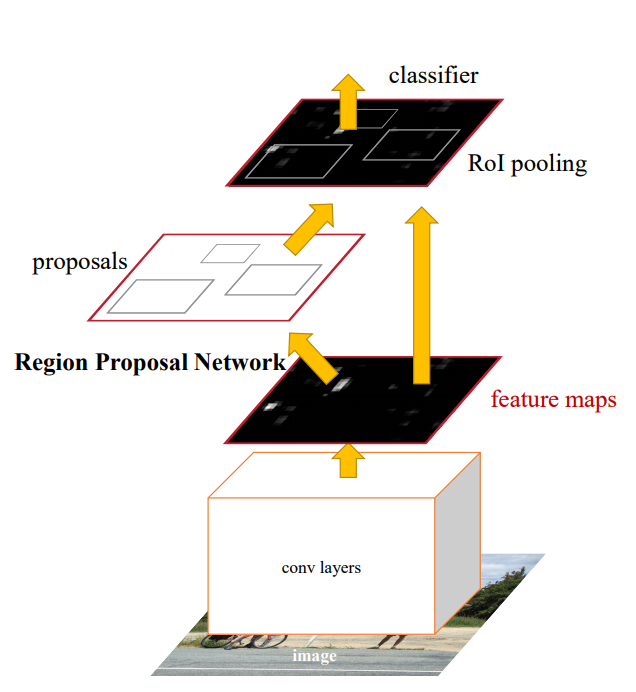
Notez que le RPN adopte une configuration similaire à SSD (il ne prédit pas des boîtes « sorties de nulle part »). Il applique des fenêtres glissantes sur les cartes de caractéristiques. À chaque position d’ancre, un ensemble de propositions est calculé, avec différentes échelles et ratios d’aspect. Comme dans SSD, la sortie du RPN consiste en des boîtes « ajustées » à partir des ancres.
Les différents composants sont combinés dans un même ensemble et entraînés soit de bout en bout, soit en plusieurs phases (pour plus de stabilité). On peut aussi voir le RPN comme un mécanisme qui guide « l’attention » du réseau vers des régions pertinentes.
La plupart des aspects pratiques de Faster R-CNN ressemblent à ceux de SSD. En mAP brut, Faster R-CNN surpasse généralement SSD, mais il requiert nettement plus de puissance de calcul.
Une section importante pour le détecteur Fast R-CNN est « first_stage_anchor_generator », qui définit les ancres générées par le RPN. Les strides de cette section définissent les pas de la fenêtre glissante. Attention en particulier à la détection de petits objets : si le stride est trop grand, vous risquez de les manquer.
Même si les auteurs de Faster R-CNN n’ont pas utilisé d’augmentation de données exhaustive, il reste conseillé d’y recourir avec de petits jeux de données.
Il existe d’autres architectures de détection d’objets que je n’ai pas abordées. Pour les applications en temps réel, YOLOv2 est souvent citée comme une architecture importante (assez proche de SSD). Je mettrai à jour ce billet lorsqu’elle sera ajoutée à la TensorFlow Detection API.
Si vous avez des questions, écrivez-les en commentaires, je serai ravi d’échanger. Suivez-moi sur Medium ou Twitter pour être averti de mes prochains articles !
En savoir plus sur le machine learning
Cours
Cours
Cours