Curso
Entendendo Machine Learning
2 h
308.6K
Com os avanços recentes em modelos de visão computacional baseados em deep learning, criar aplicações de detecção de objetos ficou mais fácil do que nunca. Além de ganhos expressivos de desempenho, essas técnicas vêm aproveitando grandes bases de imagens para reduzir a necessidade de conjuntos de dados enormes. E, com abordagens atuais focadas em pipelines ponta a ponta, o desempenho também melhorou significativamente, viabilizando casos de uso em tempo real.
Assim como no post que escrevi sobre diferentes arquiteturas de classificação de imagens, vou apresentar duas arquiteturas de detecção de objetos. Vou falar sobre SSD e Faster R-CNN, que atualmente estão disponíveis na TensorFlow Detection API.
Primeiro, vou abordar alguns conceitos-chave em detecção de objetos e, em seguida, mostrar como eles são implementados em SSD e Faster R-CNN.
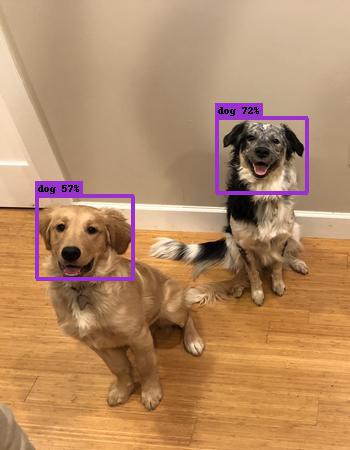
Muita gente confunde cenários de classificação de imagens com detecção de objetos. De forma geral, se você quer classificar uma imagem em uma determinada categoria, use classificação de imagens. Já se o objetivo é identificar a localização de objetos em uma imagem e, por exemplo, contar quantas instâncias existem, use detecção de objetos.
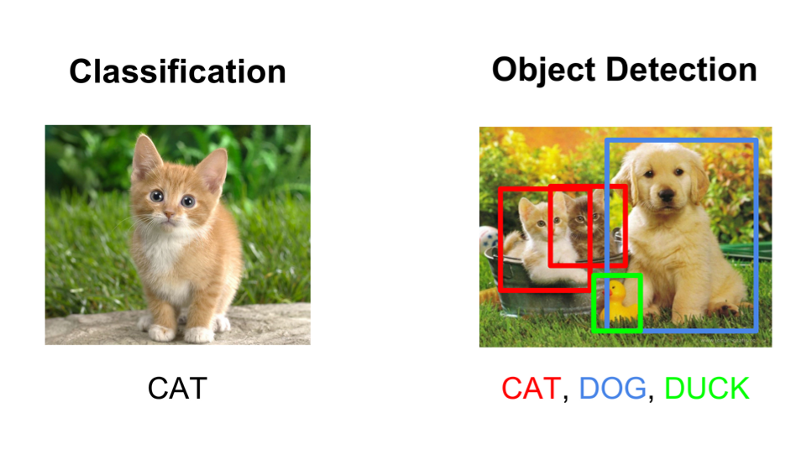
Existe, porém, alguma sobreposição entre esses dois cenários. Se você quer classificar uma imagem em uma categoria, pode acontecer de o objeto ou as características necessárias para a categorização serem muito pequenas em relação à imagem inteira. Nessa situação, você tende a obter melhor desempenho com detecção de objetos em vez de classificação de imagens, mesmo que não esteja interessado exatamente na localização ou na contagem do objeto.
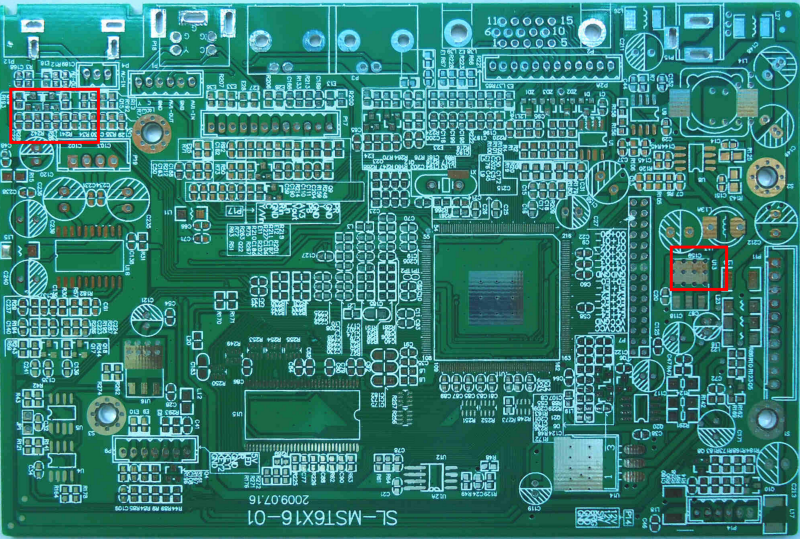
Imagine que você precise inspecionar placas de circuito e classificá-las como defeituosas ou corretas. Embora seja essencialmente um problema de classificação, os defeitos podem ser pequenos demais para um modelo de classificação perceber. Construir um conjunto de dados para detecção de objetos vai demandar mais tempo, mas provavelmente resultará em um modelo melhor.
Com um modelo de classificação de imagens, você gera recursos visuais (por métodos tradicionais ou de deep learning) da imagem inteira. Esses recursos são agregados. Na detecção de objetos, isso é feito em nível mais fino e regional. No primeiro caso, é possível perder o sinal de classificação; no segundo, o sinal tende a ser preservado de um jeito mais adequado ao uso.
Para treinar um modelo próprio, você precisa de dados rotulados. No contexto de detecção de objetos, são imagens com as coordenadas das bounding boxes e seus rótulos. Ou seja, as coordenadas (x,y) do canto inferior esquerdo e superior direito + a classe.
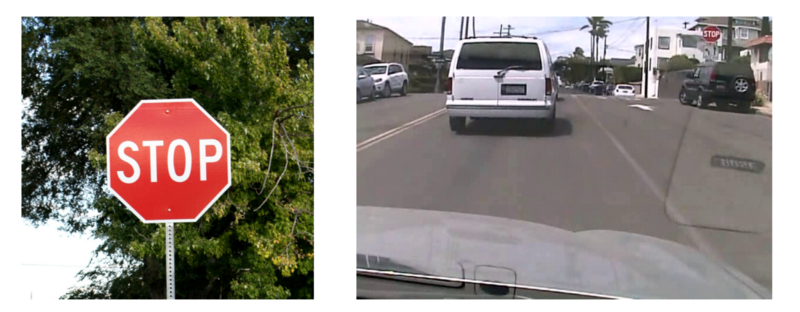
Uma pergunta recorrente é: para fazer detecção de objetos no problema X, quantas imagens eu preciso? Mais importante do que isso é entender bem em quais cenários o modelo será usado. É crucial ter um grande número (por exemplo, > 100 e potencialmente > 1000) de imagens representativas por classe. Representativas, aqui, significa que devem corresponder ao leque de situações em que o modelo será aplicado. Se você está criando um modelo para detectar placas de trânsito em um carro, use imagens sob diferentes condições de clima, iluminação e câmera, no contexto adequado. Modelos de detecção não são mágicos e, na prática, são bem limitados: se não houver dados suficientes para aprender padrões gerais, o desempenho em produção será ruim.
Normalmente, um framework de detecção de objetos tem três etapas.
Existem várias abordagens para gerar propostas de região. Originalmente, o algoritmo de "selective search" era usado para gerar propostas. Lillie Weng fornece uma explicação detalhada desse algoritmo em seu blog. Em resumo, selective search é uma abordagem baseada em clustering que tenta agrupar pixels e gerar propostas a partir desses clusters.
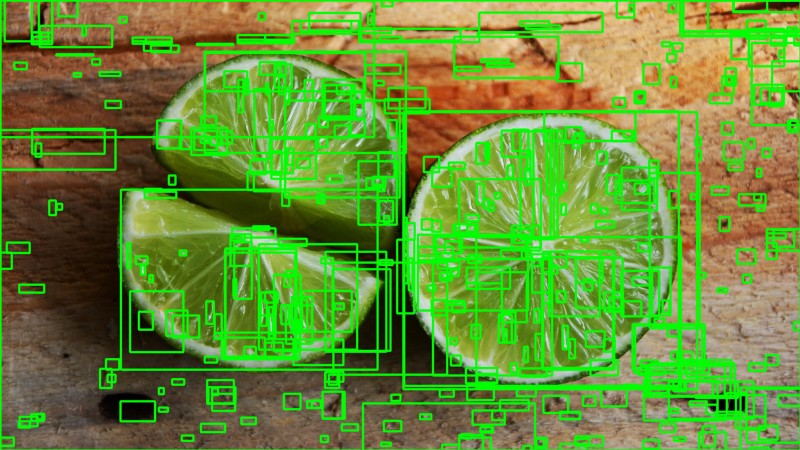
Outras abordagens usam recursos visuais mais complexos extraídos da imagem para gerar regiões (por exemplo, com base em recursos de um modelo de deep learning) ou adotam uma estratégia de força bruta. Essas abordagens de força bruta se assemelham a uma janela deslizante aplicada à imagem, em várias proporções e escalas. As regiões são geradas automaticamente, sem considerar os recursos da imagem.
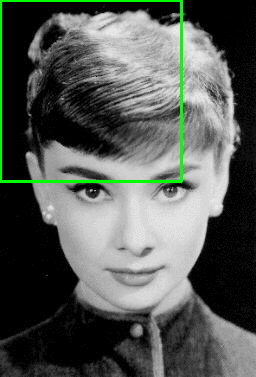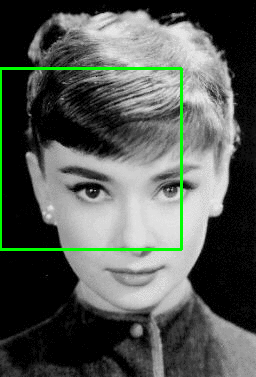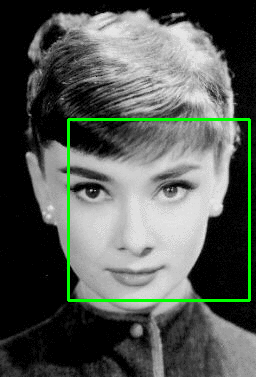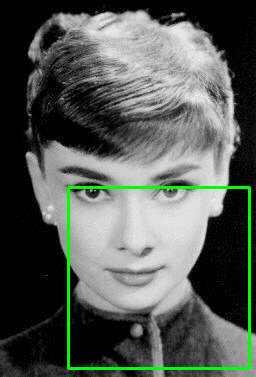
Um trade-off importante na geração de propostas é a quantidade de regiões versus a complexidade computacional. Quanto mais regiões você gera, maior a chance de encontrar o objeto. Por outro lado, se gerar exaustivamente todas as propostas possíveis, pode ser inviável executar o detector em tempo real. Em alguns casos, dá para usar informações específicas do problema para reduzir o número de ROIs. Por exemplo, pedestres costumam ter proporção de aproximadamente 1,5; portanto, não faz sentido gerar ROIs com proporção 0,25.
O objetivo da extração de recursos é reduzir uma imagem de tamanho variável a um conjunto fixo de recursos visuais. Modelos de classificação de imagens geralmente são construídos com métodos fortes de extração de recursos. Seja por abordagens tradicionais de visão computacional, como filtros, histogramas etc., seja por deep learning, todos têm o mesmo objetivo: extrair da imagem recursos representativos para a tarefa e usá-los para determinar a classe. Em frameworks de detecção de objetos, costuma-se usar modelos de classificação pré-treinados para extrair recursos visuais, pois eles tendem a generalizar bem. Por exemplo, um modelo treinado no conjunto MS COCO consegue extrair recursos bastante genéricos. Para melhorar o modelo, porém, vale experimentar diferentes abordagens. Meu post sobre transfer learning explica claramente os tipos de transferência de aprendizado e seus prós e contras.
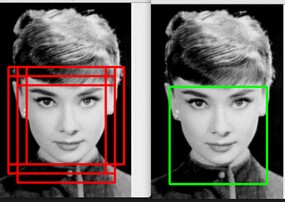
A ideia do non-maximum suppression (NMS) é reduzir o número de detecções em um quadro ao número real de objetos presentes. Se o objeto na cena for grande e forem geradas mais de 2000 propostas, é bem provável que algumas tenham sobreposição significativa entre si e com o objeto. Assista a este vídeo no Coursera para saber mais sobre NMS. Técnicas de NMS costumam ser padrão entre diferentes frameworks de detecção, mas é uma etapa importante que pode exigir ajuste de hiperparâmetros conforme o cenário.
A métrica de avaliação mais comum em tarefas de detecção é o "mAP", de "mean average precision". É um número de 0 a 100; quanto maior, melhor, mas seu significado é diferente da acurácia em classificação.
Cada bounding box recebe uma pontuação (probabilidade de conter um objeto). Com base nas previsões, calcula-se uma curva precisão-revocação (PR) para cada classe, variando o limiar da pontuação. A average precision (AP) é a área sob a curva PR. Primeiro calcula-se a AP de cada classe e, depois, a média entre as classes. O resultado final é o mAP.
Observe que uma detecção é verdadeiro positivo se tiver "intersection over union" (IoU ou sobreposição) com a caixa do ground truth maior que um certo limiar (geralmente 0,5). Em vez de usar apenas mAP, costuma-se referir a mAP@0.5 ou mAP@0.25 para indicar o IoU adotado.
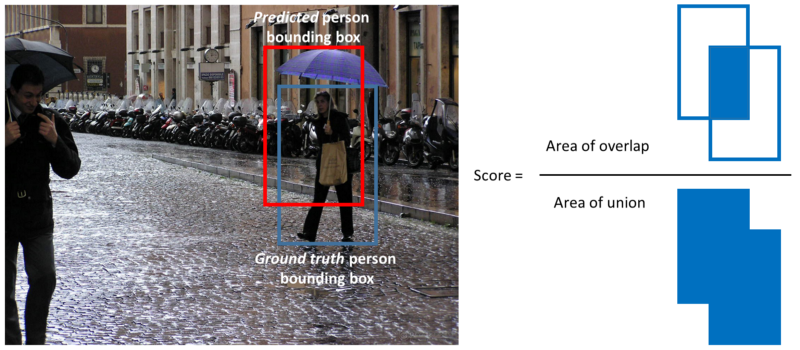
A TensorFlow Detection API reúne muitas das ideias acima em um único pacote, permitindo iterar rapidamente por diferentes configurações usando o backend do TensorFlow. Com a API, você define o modelo de detecção por meio de arquivos de configuração, e a TensorFlow Detection API se encarrega de estruturar todos os elementos necessários.
Para entender melhor os diferentes componentes suportados, veja a pasta "protos", que contém as definições. Especialmente os protos de train, eval, ssd, faster_rcnn e preprocessing são importantes ao fazer fine-tuning de um modelo.
A arquitetura SSD foi publicada em 2016 por pesquisadores do Google. Ela apresenta um modelo de detecção de objetos com uma única rede neural profunda que combina propostas de região e extração de recursos.
Um conjunto de caixas padrão (default boxes), com diferentes proporções e escalas, é aplicado aos feature maps. Como esses mapas são obtidos ao passar a imagem por uma rede de classificação, a extração de recursos para as bounding boxes acontece em uma única etapa. Gera-se uma pontuação para cada categoria de objeto em cada uma das default boxes. Para ajustar melhor às caixas de ground truth, são calculados deslocamentos (offsets) para cada box.
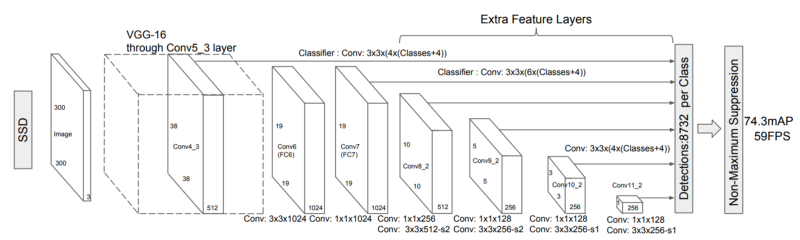
Diferentes feature maps na rede convolucional correspondem a campos receptivos distintos e são usados para lidar naturalmente com objetos em diferentes escalas. Como todo o cálculo está encapsulado em uma única rede, velocidades computacionais altas são alcançadas (por exemplo, para entrada 300 × 300, 59 FPS).
Para o uso, vamos analisar os arquivos de configuração de exemplo do SSD. Alguns parâmetros são importantes ao adotar a arquitetura SSD, e vamos passar por eles um a um.
Primeiro, diferentes redes de classificação têm pontos fortes e fracos distintos (veja este post para uma visão geral). A Inceptionv3, por exemplo, é treinada para detectar objetos bem em diferentes escalas, enquanto a ResNet atinge acurácia muito alta no geral. Já a MobileNet é uma rede treinada para minimizar recursos computacionais. O desempenho do extrator de recursos no ImageNet, o número de parâmetros e o dataset original em que foi treinado são um bom indicativo do equilíbrio desempenho/velocidade. O extrator é definido na seção "feature_extractor".
Um segundo conjunto de parâmetros óbvios são as configurações das default boxes e das proporções. Dependendo do tipo de problema, vale analisar as proporções e escalas das bounding boxes dos dados rotulados. Definir proporções e escalas adequadas evita cálculos desnecessários pela rede. Você pode ajustar isso na seção "ssd_anchor_generator". Observe que adicionar mais escalas e proporções pode melhorar o desempenho, mas com retornos decrescentes.
Em terceiro lugar, ao treinar o modelo, é importante definir o tamanho da imagem e as opções de aumento de dados (data augmentation) nas seções "data_augmentation_options" e "image_resizer". Imagens maiores costumam performar melhor, já que objetos pequenos são difíceis de detectar, mas o custo computacional aumenta bastante. Data augmentation é especialmente importante no contexto do SSD para detectar objetos em diferentes escalas (até em escalas que podem não estar presentes nos dados de treino).
Por fim, ajustar a "train_config", definindo taxas de aprendizado e tamanhos de batch, é essencial para reduzir overfitting e depende muito do tamanho do seu dataset.
O Faster R-CNN foi desenvolvido por pesquisadores da Microsoft. Ele é baseado no R-CNN, que usava uma abordagem em múltiplas fases para detecção de objetos. O R-CNN utilizava Selective search para determinar propostas de região, passava essas regiões por uma rede de classificação e então usava um SVM para classificá-las.
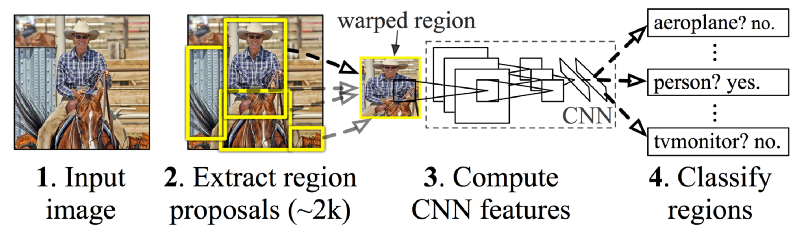
O Faster R-CNN, assim como o SSD, é uma abordagem ponta a ponta. Em vez de usar bounding boxes padrão, o Faster R-CNN tem uma Rede de Propostas de Região (RPN) para gerar um conjunto fixo de regiões. A RPN usa os recursos convolucionais da rede de classificação de imagens, permitindo propostas quase sem custo adicional. Ela é implementada como uma rede totalmente convolucional que prevê limites e escores de "objetabilidade" em cada posição.
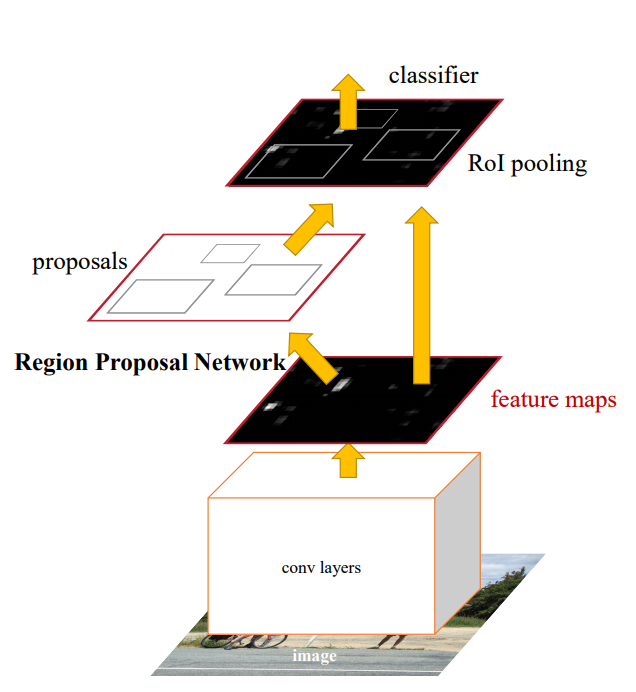
Note que a RPN tem configuração semelhante à rede SSD (ou seja, ela não prevê bounding boxes do nada). A RPN atua com janelas deslizantes sobre os feature maps. Em cada posição (anchor), calcula-se um conjunto de propostas com várias escalas e proporções. Assim como no SSD, o resultado da RPN são bounding boxes "ajustadas" com base nos anchors.
Os diferentes componentes são combinados em uma única estrutura e podem ser treinados ponta a ponta ou em múltiplas fases (para melhorar a estabilidade). Outra forma de ver a RPN é como um mecanismo que direciona a "atenção" da rede para regiões interessantes.
Grande parte dos detalhes de uso do Faster R-CNN é semelhante aos do SSD. Em termos de mAP bruto, o Faster R-CNN normalmente supera o SSD, mas requer bem mais poder computacional.
Uma seção importante para o detector Fast R-CNN é a "first_stage_anchor_generator", que define os anchors gerados pela RPN. Os strides nessa seção definem os passos da janela deslizante. Observe que, especialmente ao tentar detectar objetos pequenos, strides muito grandes podem fazer você perdê-los.
Embora os autores do paper do Faster R-CNN não tenham usado aumento de dados extensivo, ainda é recomendável aplicá-lo quando se trabalha com conjuntos menores.
Existem várias outras arquiteturas de detecção de objetos que não abordei aqui. Especialmente para aplicações em tempo real, o YOLOv2 costuma ser citado como uma arquitetura importante (bastante similar ao SSD). Vou atualizar este post quando ela for adicionada à TensorFlow Detection API.
Se tiver dúvidas, vou adorar ler nos comentários. Siga-me no Medium ou no Twitter para receber atualizações dos meus posts!
Saiba mais sobre machine learning
Curso
Curso
Curso
blog
Zoumana Keita
15 min
blog
Abid Ali Awan
15 min
Tutorial
Natassha Selvaraj
8 min
Tutorial
Zoumana Keita
14 min
Tutorial
Amberle McKee
15 min
Tutorial
Zoumana Keita
14 min