Curso
Manipulación de datos con pandas
4 h
563.9K
Cuando necesitas realizar operaciones en un DataFrame de pandas fila a fila, debes recurrir a la iteración por filas. Aunque pandas está optimizado para operaciones vectorizadas, la iteración es esencial al aplicar lógica no vectorizable, especialmente en manipulaciones complejas o procesamiento condicional de filas.
Hay varios métodos que puedes aplicar a un DataFrame de pandas para iterar por filas.
.iterrows(): Úsalo para operaciones sencillas por fila, cuando necesitas el índice y los datos de la fila. Devuelve pares índice–Series, puede ser lento en dataframes grandes y no es adecuado para cálculos pesados.
.itertuples(): Úsalo como alternativa más rápida a .iterrows(), sobre todo si no necesitas una Series de pandas. Devuelve un namedtuple con los valores de la fila y es más eficiente en memoria que .iterrows().
.apply(axis=1): Aplica una función a cada fila, normalmente con el argumento axis = 1. Es más lento que los métodos vectorizados, pero a menudo más rápido que los bucles explícitos.
Aunque pandas está diseñado para rendir al máximo con operaciones basadas en columnas, existen varios métodos en Python que facilitan la iteración por filas, especialmente al trabajar con filas individuales.
pandas trabaja con DataFrames en formato columnar, lo que lo hace eficiente para aplicar transformaciones a columnas completas de forma simultánea.
Esta es también una de las razones por las que las operaciones vectorizadas son eficientes en pandas y suelen recomendarse frente a la iteración por filas, que puede volverse lenta con DataFrames grandes.
Estos son los principales métodos de iteración por filas:
.iterrows(): Devuelve cada fila como una tupla (index, Series).
.itertuples(): Más rápido que .iterrows() y devuelve cada fila como un namedtuple.
.items(): No itera por filas, sino por columnas de un DataFrame de pandas; devuelve la etiqueta de la columna y una Series, y se usa normalmente para operaciones por columna.
Según benchmarks con DataFrames de tamaño medio (100.000 filas), .itertuples() es entre 5 y 10 veces más rápido que .iterrows() en velocidad y eficiencia de memoria. Esto se debe a que .itertuples() evita crear objetos Series por fila y en su lugar genera namedtuples ligeros.
Las operaciones vectorizadas son más rápidas que cualquier forma de iteración porque están implementadas en código C optimizado. Eliminan los bucles a nivel de Python y reducen la sobrecarga. Por ejemplo, sumar dos columnas con datacamp_rows[“A”] + es más rápido que usar un bucle datacamp_rows[“B”]for con .iterrows().
.iterrows() tiene una gran huella de memoria porque devuelve un objeto Series completo de pandas, y estas Series pueden sufrir incoherencias de dtype ya que se derivan de columnas con tipos distintos.
Para un dataset pequeño, se recomienda usar .iterrows(); para datasets grandes, usa .itertuples().
Puede que te encuentres en situaciones en las que no puedas aplicar operaciones vectorizadas y tengas que recurrir a la iteración por filas. En esta sección verás cuándo conviene —y cuándo no— usarla.
Escenarios típicos para iterar por filas incluyen:
A pesar de los casos de uso, debes evitar la iteración por filas en situaciones como:
En lugar de iterar, plantéate estas alternativas:
Usa operaciones vectorizadas siempre que sea posible.
Apóyate en .apply() con funciones optimizadas para tareas complejas pero aún vectorizables.
Considera el procesamiento por lotes o la paralelización si debes iterar pero tienes restricciones de rendimiento.
Evita estos errores comunes de los bucles por filas:
.iterrows() devuelve una copia, no una referencia a la fila original; por tanto, modificarla no cambia el DataFrame original.
El código es más difícil de leer y mantener en comparación con las operaciones vectorizadas.
Puedes implementar la iteración por filas en DataFrames de pandas mediante distintos métodos, según tu caso de uso o la naturaleza del DataFrame. Estos son los métodos principales.
El método .iterrows() implica iterar sobre filas individuales de un DataFrame. La sintaxis es la siguiente:
for index, row in datacamp_rows.iterrows():
	# código para procesar cada fila
Donde datacamp_rows es el dataframe iterado, index es el índice de la fila y row es la Series de pandas que contiene los datos de la fila.
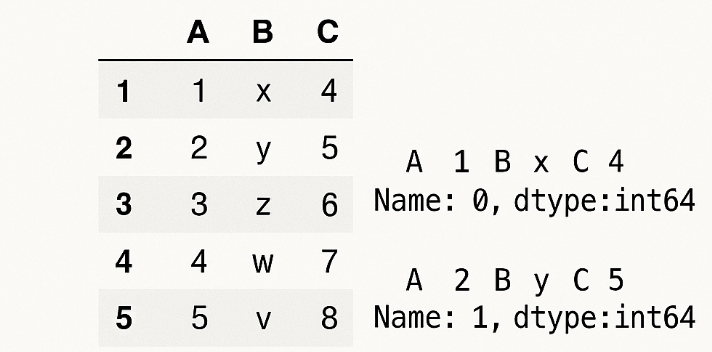
Ejemplo básico de uso:
import pandas as pd

students = {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for index, row in students.iterrows():
    print(f"Index: {index}, Name: {row['Name']}, Age: {row['Age']}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30El método .iterrows() devuelve un generador que produce el índice de una fila junto con un objeto Series que representa la fila. Las claves de esta Series son los nombres de columna y los valores son los datos correspondientes en cada fila.
Internamente, esto es lo que devuelve .iterrows():
(index_0, Series_0)
(index_1, Series_1).itertuples() es más rápido y eficiente en memoria que .iterrows(), y devuelve cada fila como un namedtuple, lo que permite acceder a las columnas con notación de punto. La sintaxis es la siguiente:
for row in datacamp_rows.itertuples(index=True, name="Pandas"):
    # procesar cada fila
Donde index=True incluye el índice del DataFrame como primer elemento de cada tupla, y name="Pandas" establece el nombre de la clase namedtuple devuelta. Si name=None, el bucle for devuelve una tupla normal sin acceso por atributos.
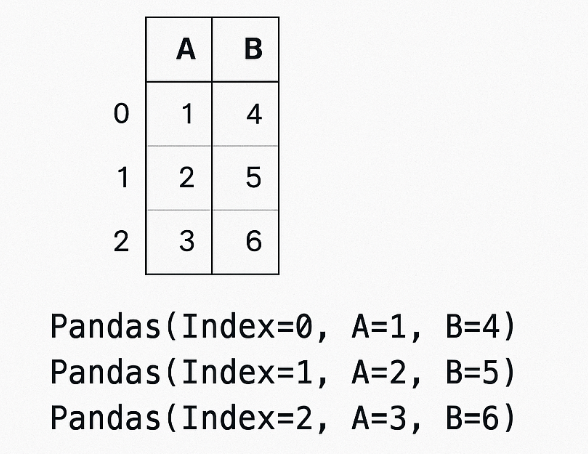
Aquí tienes un ejemplo práctico de cómo funciona .itertuples():
import pandas as pd

students= {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for row in students.itertuples():
    print(f"Index: {row.Index}, Name: {row.Name}, Age: {row.age}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30.itertuples() devuelve un generador que produce namedtuples, donde cada fila se representa como un objeto ligero.
Puedes acceder a cada campo de la fila con notación de punto, como row.Name y row.age, precedidos por el índice.
Internamente, devuelve lo siguiente:
Pandas(Index=0, Name='Mary', Age=25)
Pandas(Index=1, Name='Joseph', Age=30)El método .apply() en pandas es útil para aplicar funciones a las filas y realizar iteraciones por fila, como cuando se usa el argumento axis=1. La sintaxis es la siguiente:
df.apply(func, axis=1)Donde func es la función a aplicar a cada fila y el argumento axis=1 está establecido.
Aquí tienes un ejemplo práctico que ilustra su uso.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Math": [85, 90], "Science": [95, 88]})

# Añadir una columna con la nota media
students["Average"] = students.apply(lambda row: (row["Math"] + row["Science"]) / 2, axis=1)
students.head()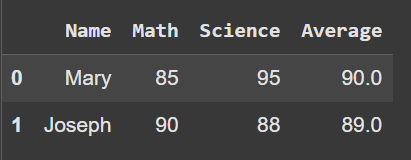
Usa .apply() al crear columnas nuevas a partir de otras existentes o al aplicar cálculos o transformaciones personalizadas.
En términos de iteración por filas, puedes usarlo para crear lógica condicional por fila, como sentencias if-else. Cuando estableces axis=1, la función recibe una Series con los nombres de columna como índices. Esta función procesa las filas y devuelve un escalar en una columna nueva o una Series en varias columnas.
Aunque .apply(axis=1) es más lento que las operaciones vectorizadas, suele ser más rápido y limpio que .iterrows().
Otra alternativa para iterar por filas es usar .loc[] o .iloc[] manualmente con bucles for para recorrer un DataFrame de pandas.
Esto funciona de forma similar a .iterrows() o .itertuples(). La ventaja es que ganas control total sobre las filas. La sintaxis es la siguiente:
# indexación posicional
for i in range(len(df)):
    row = df.iloc[i]
    # procesar fila

# indexación por etiqueta
for idx in df.index:
    row = df.loc[idx]
    # procesar fila
Aquí tienes un ejemplo práctico de cómo se implementa.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Age": [25, 30]})

# Con iloc
for i in range(len(students)):
    print(f"Name: {students.iloc[i]['Name']}, Age: {students.iloc[i]['Age']}")

# Con loc
for idx in students.index:
    print(f"Name: {students.loc[idx, 'Name']}, Age: {students.loc[idx, 'Age']}")
Name: Mary, Age: 25
Name: Joseph, Age: 30Uno de los casos de uso de este método es cuando necesitas control preciso del orden de las filas, o al escribir lógica paso a paso para depurar. Aunque se vuelve ineficiente con dataframes grandes, también es más lento que las operaciones vectorizadas.
Es clave usar .loc[] cuando necesites búsquedas por etiqueta o .iloc[] para acceso por posición, especialmente con bucles basados en rangos.
Aquí tienes una tabla que resume las diferencias entre los tres métodos.
|
Características |
iterrows() |
itertuples() |
apply(axis=1) |
|
Sintaxis |
for idx, row in df.iterrows: |
for row in df.itertuples(): |
df.apply(func, axis=1) |
|
Salida |
(index, Series) |
namedtuple |
Devuelve el valor de la función (escalar o Series) |
|
Velocidad |
Lenta |
Más rápida |
Media |
|
Uso de memoria |
Medio |
Bajo |
Medio |
|
Legibilidad |
Moderada |
Alta |
Alta |
|
Mejores usos |
Prototipado rápido o depuración |
Datasets grandes |
Derivar columnas |
|
Limitaciones |
Más lenta |
No maneja lógica compleja por fila |
Más lenta que la vectorización completa |
Aunque .iterrows() es una forma directa de iterar por las filas de un DataFrame de pandas, tiene limitaciones que pueden afectar al rendimiento.
Iterar con .iterrows() produce cada fila como una tupla que contiene el índice de la fila y un objeto Series con los datos de la fila.
Pese a su sencillez, tiene la desventaja de la conversión de dtypes; por ejemplo, puede convertir enteros en floats si la Series debe alojar tipos mixtos, lo que puede provocar sutiles errores en cálculos o comparaciones.
Además, como .iterrows() devuelve una Series por fila, esto implica sobrecarga de memoria y ralentiza frente a las operaciones vectorizadas.
No se recomienda modificar datos dentro de un bucle con .iterrows(), ya que los cambios en la Series no se propagan al DataFrame.
A pesar de estas limitaciones, .iterrows() sigue siendo útil en escenarios como:
.iterrows().Para mantener la consistencia de dtypes, plantéate cambiar a .itertuples(), ya que devuelve namedtuples sin conversiones de tipo.
.itertuples() es más rápido y eficiente en memoria que .iterrows() porque devuelve un namedtuple. Veamos cómo algunas de sus características lo hacen superior a .iterrows().
Algunas ventajas de .itertuples() incluyen:
Mejor rendimiento: En lugar de crear objetos Series como .iterrows(), que consumen memoria y reducen el rendimiento, .itertuples() evita esa sobrecarga y mejora la velocidad generando namedtuples.
Personalización: El argumento index=False omite el índice de la tupla, y establecer name= 'Custom' permite fijar un nombre personalizado para la clase namedtuple, mejorando la legibilidad o la integración con otros sistemas.
Al usar .itertuples(), conviene tener presentes estas limitaciones.
Restricciones en nombres de columnas: Los nombres con caracteres especiales o espacios pueden resultar en identificadores de Python no válidos. Se modifican a nombres válidos o se accede a ellos por índice en la tupla.
Inmutabilidad: Los namedtuples son inmutables, por lo que no puedes modificar sus valores in situ. Cualquier transformación requiere construir una nueva estructura o recopilar los valores en una lista o dataframe aparte.
Buenas prácticas con .itertuples():
Aunque los métodos principales para iterar por filas son .iterrows() y .itertuples(), pandas ofrece alternativas más eficientes para manipulación a gran escala, como la vectorización, que es más rápida y eficiente en memoria.
Las operaciones vectorizadas aplican operaciones a matrices completas o a columnas de un DataFrame de una vez, aprovechando optimizaciones de bajo nivel en NumPy y pandas. Son más limpias, legibles y reducen drásticamente el tiempo de ejecución.
A continuación, algunas técnicas y ejemplos de vectorización:
Operaciones aritméticas: datacamp_rows[‘total’] = datacamp_rows[‘price’] * datacamp_rows[quantity’]
Lógica condicional: datacamp_rows[‘flag’] = np.where(datacamp_rows[‘value’] > 10, ‘high’, ‘low’)
Métodos de texto: datacamp_rows[‘cleaned’] = datacamp_rows[‘text’].str.lower().str.strip()
Manipulación de fechas: datacamp_rows[‘year’] =datacamp_rows[‘date’].dt.year
Las operaciones vectorizadas se apoyan en código C compilado y gestión de memoria optimizada, superando con creces a los bucles de Python, especialmente en DataFrames grandes.
Si necesitas lógica por fila, se recomienda usar .apply(axis=1). Aunque no es tan rápido como la vectorización, es más eficiente y expresivo que iterar por filas. .apply() puede ser lento en DataFrames muy grandes porque sigue iterando internamente en C, pero es viable para lógica moderadamente compleja.
Herramientas para optimizar .apply():
Swifter: Decide automáticamente la forma más rápida de ejecutar .apply().
Pandarallel: Permite paralelizar .apply() fácilmente en varios núcleos con una sola línea.
Numba: Compilador JIT que acelera funciones numéricas en Python. Al usarlo dentro de .apply(), puede reducir drásticamente el tiempo de cómputo en operaciones intensivas.
Una estrategia potente en pandas es crear columnas temporales para descomponer operaciones complejas en pasos vectorizados manejables, evitando la iteración explícita fila a fila.
Existen diversas estrategias de optimización y comparativas que merece la pena explorar para garantizar un manejo escalable y eficiente en memoria, especialmente con datasets grandes.
Los distintos métodos de iteración en Python muestran rendimientos dispares. Por ejemplo, los bucles for y while, combinados con métodos de pandas como .itertuples() y .iterrows(), son significativamente más lentos que las operaciones vectorizadas.
Los benchmarks suelen mostrar que .itertuples() es más rápido y eficiente en memoria que .iterrows() porque devuelve namedtuples en lugar de Series. Las operaciones vectorizadas superan a cualquier forma de iteración gracias a sus implementaciones en C.
A medida que los datos escalan a millones de filas, estas diferencias se vuelven críticas: los métodos ineficientes generan cuellos de botella y mayor consumo de memoria.
Para datasets grandes, considera estas técnicas:
Procesamiento por bloques: Usa el parámetro chunksize en .read_csv() para procesar datos en bloques manejables en lugar de cargarlos todos a memoria a la vez.
Optimización de dtypes: Prueba tipos de datos más ligeros, como float32 en lugar de float64, para reducir memoria.
Gestión de memoria: Elimina columnas sin uso cuanto antes, filtra antes de fusionar y libera memoria periódicamente con gc.collect().
Cómputo out-of-core: Usa herramientas como Dask y Vaex para habilitar cálculos paralelos y out-of-core en datasets que superan la memoria disponible.
Hay muchos escenarios en los que iterar es útil. Estos ejemplos prácticos muestran patrones habituales y buenas prácticas al trabajar con pandas.
Ejemplo básico con .iterrows(), .itertuples() y .apply(axis=1).
import pandas as pd

students = pd.DataFrame({"name": ["Mary", "Joseph"], "age": [25, 30]})

# Con iterrows()
for index, row in students.iterrows():
    print(f"{row['name']} is {row['age']} years old")

# Con itertuples()
for row in students.itertuples(index=False):
    print(f"{row.name} is {row.age} years old")

# Con apply()
students.apply(lambda row: print(f"{row['name']} is {row['age']} years old"), axis=1)
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years oldPuedes usar métodos de iteración por filas para modificar valores del DataFrame en un bucle; sin embargo, este enfoque no es eficiente con datasets grandes.
Los siguientes ejemplos muestran cómo implementarlo.
for index, row in students.iterrows():
    students.at[index, 'age'] = row['age'] + 1

students.head()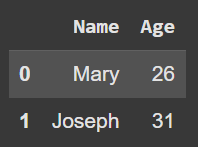
Con dataframes grandes, usa una operación vectorizada para mejorar el rendimiento, como en el ejemplo siguiente.
# Enfoque mejor con vectorización
students["age"] = students["age"] + 1Para procesar solo filas específicas, incluye una comprobación condicional dentro del bucle, como en este ejemplo, donde se imprimen filas con age mayor que 25.
for row in students.itertuples(index=False):
    if row.age > 25:
        print(f"{row.Name} is older than 25")
Joseph is older than 25Aunque la opción vectorizada siguiente es mejor y más rápida.
students_greater_than_5 = students[students["age"] > 25]También es posible calcular estadísticas resumen durante el procesamiento por filas; sin embargo, pandas ofrece métodos integrados como .sum() y .mean(), que son más rápidos.
# Agregación manual
total_age = 0
for row in students.itertuples(index=False):
    total_age += row.age
average_age = total_age / len(students)
print(f"Average age: {average_age}")

# Método vectorizado preferido
average_age =students["age"].mean()
Average age: 27.5Al iterar por filas en pandas, es clave entender las compensaciones entre los distintos métodos disponibles.
Usa .iterrows() cuando necesites una solución simple y no trabajes con un dataset grande, y .itertuples() cuando requieras una alternativa más rápida y con mejor rendimiento.
Prioriza siempre las operaciones vectorizadas cuando apliquen, especialmente con datasets grandes, ya que son más rápidas y eficientes gracias a sus implementaciones en C.
Usa .apply() como vía intermedia cuando necesites una operación por fila o por columna que no sea fácil de vectorizar.
Recursos para aprender más sobre pandas:
También puedes consultar estos cursos para acelerar tu aprendizaje:
Aprende Python con DataCamp
Curso
Curso
Curso
Tutorial
Aditya Sharma
5 min
Tutorial
Karlijn Willems
15 min
Tutorial
DataCamp Team
13 min
Tutorial
DataCamp Team
7 min
Tutorial
Kurtis Pykes
10 min
Tutorial
Kurtis Pykes
10 min




