Kurs
Datenbearbeitung mit pandas
4 Std.
563.9K
Wenn du Operationen in einem Pandas DataFrame Zeile für Zeile ausführen musst, kommst du um eine Zeileniteration nicht herum. Zwar ist Pandas für vektorisierte Operationen optimiert, aber Iterationen sind unverzichtbar, wenn du nicht-vektorisierte Logik anwenden willst – insbesondere bei komplexen Datenmanipulationen oder bedingter Verarbeitung einzelner Zeilen.
Es gibt verschiedene Methoden, mit denen du in einem Pandas DataFrame über Zeilen iterieren kannst.
.iterrows(): Für einfache zeilenweise Operationen, bei denen Index und Zeilendaten gebraucht werden. Gibt Index–Series-Paare zurück, ist bei großen DataFrames langsam und für rechenintensive Aufgaben ungeeignet.
.itertuples(): Schneller als .iterrows(), besonders wenn du keine Pandas Series brauchst. Gibt namedtuples mit Zeilenwerten zurück und ist speichereffizienter als .iterrows().
.apply(axis=1): Wendet eine Funktion auf jede Zeile an, üblicherweise mit dem Argument axis = 1. Langsamer als vektorisierte Methoden, aber oft schneller als explizite Schleifen.
Obwohl Pandas optimal mit spaltenbasierten Operationen arbeitet, erleichtern verschiedene Python-Methoden die zeilenweise Iteration – vor allem, wenn du mit einzelnen Zeilen arbeitest.
Pandas verarbeitet DataFrames spaltenorientiert und kann so Transformationen effizient gleichzeitig auf ganze Spalten anwenden.
Das ist auch ein Grund, warum vektorisierte Operationen in Pandas so performant sind und in der Regel Zeileniteration vorgezogen wird – letztere kann bei großen DataFrames schnell langsam werden.
Die wichtigsten Methoden zur Zeileniteration sind:
.iterrows(): Gibt jede Zeile als Tupel (index, Series) zurück.
.itertuples(): Schneller als .iterrows() und liefert jede Zeile als namedtuple.
.items(): Keine Zeileniteration, sondern Iteration über Spalten eines DataFrames; gibt Spaltenlabel und Series zurück und wird üblicherweise für spaltenweise Operationen genutzt.
In Benchmarks mit mittelgroßen DataFrames (100.000 Zeilen) ist .itertuples() 5–10 Mal schneller als .iterrows() – sowohl bei Laufzeit als auch Speicherverbrauch. Grund: .itertuples() erzeugt keine Series für jede Zeile, sondern liefert leichtere namedtuples.
Vektorisierte Operationen sind schneller als jede Form der Iteration, da sie in optimiertem C-Code implementiert sind. Sie eliminieren Python-Schleifen und deren Overhead. So ist z. B. das Addieren zweier Spalten via datacamp_rows[“A”] + deutlich schneller als eine datacamp_rows[“B”]for-Schleife mit .iterrows().
.iterrows() hat einen großen Speicher-Footprint, da für jede Zeile eine vollständige Pandas Series zurückgegeben wird. Zudem können dabei dtype-Unstimmigkeiten auftreten, weil die Series aus Spalten mit unterschiedlichen Datentypen zusammengesetzt ist.
Für kleinere Datensätze kannst du .iterrows() nutzen; bei größeren ist .itertuples() die bessere Wahl.
Manchmal lassen sich vektorisierte Operationen nicht anwenden, dann brauchst du Zeileniteration. In diesem Abschnitt lernst du, wann sie sinnvoll ist – und wann nicht.
Häufige Szenarien für Zeileniteration sind:
Trotz valider Anwendungsfälle solltest du in manchen Situationen auf Iteration verzichten, zum Beispiel wenn:
Stattdessen bieten sich an:
Wo immer möglich vektorisierte Operationen.
.apply() mit optimierten Funktionen für komplexe, aber noch vektorisierbare Aufgaben.
Batch-Verarbeitung oder Parallelisierung, wenn Iteration unvermeidlich ist und Performance zählt.
Vermeide diese typischen Stolpersteine bei zeilenweisen Schleifen:
.iterrows() liefert eine Kopie, keinen Verweis auf die Originalzeile; Änderungen wirken sich daher nicht auf den ursprünglichen DataFrame aus.
Im Vergleich zu vektorisierten Ausdrücken ist der Code schwerer zu lesen und zu warten.
Du kannst Zeileniteration in Pandas auf verschiedene Arten umsetzen – je nach Anwendungsfall oder Datenstruktur. Hier sind die Methoden zum Iterieren über DataFrame-Zeilen.
Die Methode .iterrows() iteriert über einzelne Zeilen eines DataFrames. Die Syntax lautet:
for index, row in datacamp_rows.iterrows():
	# code to process each row
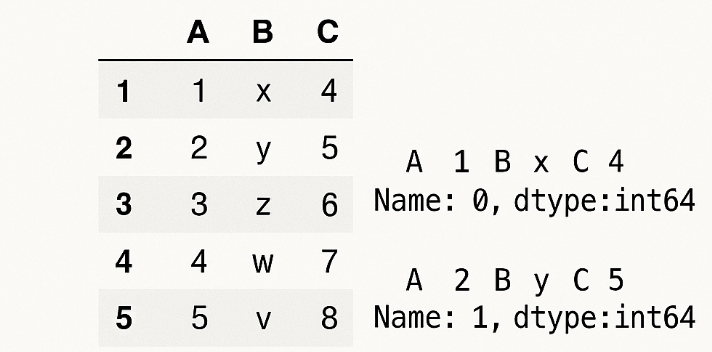
Dabei ist datacamp_rows der iterierte DataFrame, index der Zeilenindex und row eine Pandas Series mit den Zeilendaten.
Ein einfaches Beispiel:
import pandas as pd

students = {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for index, row in students.iterrows():
    print(f"Index: {index}, Name: {row['Name']}, Age: {row['Age']}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30.iterows() liefert einen Generator, der den Index einer Zeile zusammen mit einem Series-Objekt für die Zeile zurückgibt. Die Keys dieser Series sind die Spaltennamen, die Werte sind die jeweiligen Zeilendaten.
Intern sieht die Rückgabe so aus:
(index_0, Series_0)
(index_1, Series_1).itertuples() ist schneller und speichersparender als .iterrows() und gibt jede Zeile als namedtuple zurück, sodass du auf Spaltenwerte per Punktnotation zugreifen kannst. Die Syntax:
for row in datacamp_rows.itertuples(index=True, name="Pandas'):
    # process each row
Mit index=True wird der DataFrame-Index als erstes Element jedes Tupels aufgenommen, und name="Pandas" setzt den Namen der zurückgegebenen namedtuple-Klasse. Wenn name=None ist, liefert die for-Schleife einfache Tupel ohne Attributzugriff.
Ein praktisches Beispiel für .itertuples():
import pandas as pd

students= {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for row in students.itertuples():
    print(f"Index: {row.Index}, Name: {row.Name}, Age: {row.age}")
Index: 0, Name: Mary, Age: 25
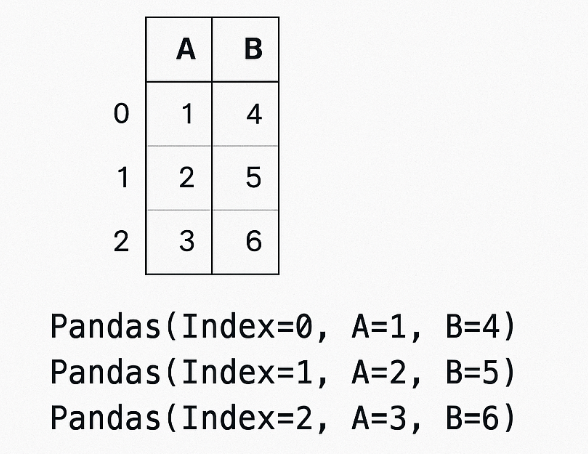
Index: 1, Name: Joseph, Age: 30.itertuples() liefert einen Generator von namedtuples, wobei jede Zeile als leichtgewichtiges Objekt repräsentiert ist.
Du kannst auf jedes Feld per Punktnotation zugreifen, z. B. row.Name und row.age; der Index steht voran.
Intern sieht die Rückgabe so aus:
Pandas(Index=0, Name='Mary', Age=25)
Pandas(Index=1, Name='Joseph', Age=30)Die .apply()-Methode in Pandas ist hilfreich, wenn du Funktionen auf Zeilen anwenden willst, also bei axis=1. Die Syntax lautet:
df.apply(func, axis=1)Dabei ist func die Funktion, die auf jede Zeile angewendet wird, und axis=1 aktiviert die Zeilenverarbeitung.
Ein Praxisbeispiel:
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Math": [85, 90], "Science": [95, 88]})

# Add a new column with average score
students["Average"] = students.apply(lambda row: (row["Math"] + row["Science"]) / 2, axis=1)
students.head()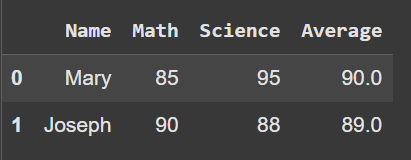
Nutze .apply(), wenn du neue Spalten aus bestehenden ableitest oder eigene Berechnungen/Transformationen anwendest.
Für Zeilenlogik kannst du damit if-else-Bedingungen pro Zeile umsetzen. Bei axis=1 wird der Funktion die Zeile als Series mit Spaltennamen als Indizes übergeben. Die Funktion liefert einen Skalar (für eine neue Spalte) oder eine Series (für mehrere Spalten) zurück.
Obwohl .apply(axis=1) langsamer als Vektorisierung ist, ist es oft schneller und sauberer als .iterrows().
Eine weitere Möglichkeit ist, mit .loc[] oder .iloc[] und for-Schleifen manuell über einen DataFrame zu iterieren.
Das ähnelt .iterrows() oder .itertuples(). Vorteil: Du behältst die volle Kontrolle über die Reihenfolge. Die Syntax:
# positional indexing
for i in range(len(df)):
    row = df.iloc[i]
    # process row

# label indexing
for idx in df.index:
    row = df.loc[idx]
    # process row
Ein praktisches Beispiel:
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Age": [25, 30]})

# Using iloc
for i in range(len(students)):
    print(f"Name: {students.iloc[i]['Name']}, Age: {students.iloc[i]['Age']}")

# Using loc
for idx in students.index:
    print(f"Name: {students.loc[idx, 'Name']}, Age: {students.loc[idx, 'Age']}")
Name: Mary, Age: 25
Name: Joseph, Age: 30Das eignet sich, wenn du die Reihenfolge exakt steuern willst oder schrittweise Logik fürs Debugging brauchst. Für große DataFrames ist es ineffizient und langsamer als Vektorisierung.
Wichtig: Nutze .loc[] für labelbasierten Zugriff und .iloc[] für positionsbasierten Zugriff – insbesondere in range-basierten Schleifen.
Die folgende Tabelle fasst die Unterschiede der drei Methoden zusammen.
|
Features |
iterows() |
itertuples() |
apply(axis=1) |
|
Syntax |
for idx, row in df.iterrows: |
for row in df.itertuples(): |
df.apply(func, axis=1) |
|
Output |
(index, Series) |
namedtuple |
Rückgabewert der Funktion (Skalar oder Series) |
|
Speed |
Langsam |
Am schnellsten |
Mittel |
|
Memory Usage |
Mittel |
Niedrig |
Mittel |
|
Readability |
Mittel |
Hoch |
Hoch |
|
Best use cases |
Schnelles Prototyping oder Debugging |
Große Datensätze |
Spalten ableiten |
|
Limitations |
Langsamer |
Komplexe Zeilenlogik schwierig |
Langsamer als volle Vektorisierung |
.iterrows() ist ein unkomplizierter Weg, um über DataFrame-Zeilen zu iterieren – hat aber Einschränkungen, die sich auf die Performance auswirken.
Bei .iterrows() wird jede Zeile als Tupel aus dem Zeilenindex und einer Series mit den Zeilendaten zurückgegeben.
Trotz der Einfachheit gibt es Nachteile bei der dtype-Konvertierung; so können z. B. Integer zu Floats werden, wenn die Series gemischte Typen aufnehmen muss. Das kann zu subtilen Fehlern in Berechnungen oder Vergleichen führen.
Außerdem verursacht die Rückgabe einer Series pro Zeile Speicher-Overhead und ist langsamer als vektorisierte Operationen.
Daten innerhalb einer .iterrows()-Schleife zu ändern, ist nicht ratsam, da Änderungen an der Series nicht in den DataFrame zurückgeschrieben werden.
Trotz der Limitierungen ist .iterrows() in manchen Fällen nützlich, z. B.:
Um dtypes konsistent zu halten, wechsle nach Möglichkeit zu .itertuples(), da namedtuples keine Typkonvertierung erzwingen.
.itertuples() ist schneller und speichereffizienter als .iterrows(), weil namedtuples zurückgegeben werden. Schauen wir uns an, warum diese Methode oft überlegen ist.
Vorteile von .itertuples():
Performancegewinne: Statt wie .iterrows() Series-Objekte zu erstellen (teuer in Speicher und Laufzeit), liefert .itertuples() per Generator leichte namedtuples.
Anpassbarkeit: Mit index=False lässt du den Index weg; mit name='Custom' vergibst du einen eigenen Klassennamen für bessere Lesbarkeit oder Integration in andere Systeme.
Beachte bei .itertuples() folgende Einschränkungen:
Einschränkungen bei Spaltennamen: Spaltennamen mit Sonderzeichen oder Leerzeichen sind keine gültigen Python-Bezeichner. Sie werden angepasst oder du greifst indexbasiert auf die Tupelwerte zu.
Unveränderlichkeit: Namedtuples sind immutable, du kannst Werte nicht in-place ändern. Transformationen erfordern daher neue Strukturen oder das Sammeln der Ergebnisse in einer separaten Liste oder einem neuen DataFrame.
Best Practices für .itertuples():
Neben .iterrows() und .itertuples() bietet pandas weitere, oft effizientere Alternativen für große Datenmengen – insbesondere Vektorisierung, die schneller und speichereffizient ist.
Vektorisierung wendet Operationen auf ganze Arrays bzw. Spalten gleichzeitig an und nutzt Low-Level-Optimierungen in NumPy und Pandas. Das ist sauberer, lesbarer und drastisch schneller.
Gängige Techniken und Beispiele:
Arithmetische Operationen: datacamp_rows[‘total’] = datacamp_rows[‘price’] * datacamp_rows[quantity’]
Bedingte Logik: datacamp_rows[‘flag’] = np.where(datacamp_rows[‘value’] > 10, ‘high’, ‘low’)
String-Methoden: datacamp_rows[‘cleaned’] = datacamp_rows[‘text’].str.lower().str.strip()
Datum/Zeit-Manipulationen: datacamp_rows[‘year’] =datacamp_rows[‘date’].dt.year
Vektorisierte Operationen profitieren von kompiliertem C-Code und optimiertem Speichermanagement und schlagen Python-Schleifen um Größenordnungen – besonders bei großen DataFrames.
Wenn du Zeilenlogik brauchst, setze bevorzugt .apply(axis=1) ein. Es ist nicht so schnell wie Vektorisierung, aber effizienter und ausdrucksstärker als Zeileniteration. .apply() kann bei sehr großen DataFrames dennoch langsam sein, da intern weiterhin gelaufen wird. Für moderat komplexe Logik ist es gut handhabbar.
Für die Optimierung von .apply() kannst du folgende Tools einsetzen:
Swifter: Wählt automatisch die schnellste Ausführung für .apply().
Pandarallel: Ermöglicht parallele Ausführung von .apply() über mehrere CPU-Kerne mit nur einer Codezeile.
Numba: JIT-Compiler, der numerische Python-Funktionen beschleunigt. In Kombination mit .apply() können numerisch intensive Aufgaben drastisch schneller werden.
Eine starke Strategie in Pandas ist es, temporäre Spalten anzulegen, um komplexe Operationen in handhabbare vektorisierte Schritte zu zerlegen – so vermeidest du explizite Zeileniteration.
Es gibt diverse Optimierungsstrategien und Vergleichsbenchmarks, um skalierbar und speicherschonend zu arbeiten – besonders bei großen Datensätzen.
Unterschiedliche Iterationsmethoden in Python liefern stark abweichende Performance. for- und while-Schleifen sind zusammen mit .itertuples() oder .iterrows() deutlich langsamer als Vektorisierung.
Benchmarks zeigen typischerweise: .itertuples() ist schneller und speichereffizienter als .iterrows(), da namedtuples statt Series zurückgegeben werden. Vektorisierte Operationen schlagen beide dank C-basierter Implementierung.
Skalieren die Daten auf Millionen Zeilen, werden diese Unterschiede kritisch – ineffiziente Methoden verursachen Flaschenhälse und höheren Speicherverbrauch.
Für große Datensätze empfiehlt sich u. a.:
Chunk Processing: Mit dem Parameter chunksize in .read_csv() Daten in handlichen Blöcken statt auf einmal laden.
Dtype-Optimierung: Datentypen wie float32 statt float64 nutzen, um Speicher zu sparen.
Speichermanagement: Unnötige Spalten früh droppen, vor dem Mergen filtern und periodisch Speicher mit gc.collect() freigeben.
Out-of-Core Computing: Tools wie Dask und Vaex erlauben parallele Out-of-Core-Berechnungen für Datensätze, die nicht in den Speicher passen.
Es gibt viele Situationen, in denen Iteration praktisch ist. Hier sind Beispiele mit gängigen Patterns und Best Practices in Pandas.
Ein Beispiel für .iterrows(), .itertuples() und .apply(axis=1):
import pandas as pd

students = pd.DataFrame({"name": ["Mary", "Joseph"], "age": [25, 30]})

# Using iterrows()
for index, row in students.iterrows():
    print(f"{row['name']} is {row['age']} years old")

# Using itertuples()
for row in students.itertuples(index=False):
    print(f"{row.name} is {row.age} years old")

# Using apply()
students.apply(lambda row: print(f"{row['name']} is {row['age']} years old"), axis=1)
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years oldDu kannst DataFrame-Werte per Zeileniteration verändern; bei großen Datensätzen ist das aber ineffizient.
So geht’s:
for index, row in students.iterrows():
    students.at[index, 'age'] = row['age'] + 1

students.head()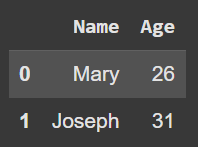
Bei großen DataFrames ist die vektorisierte Variante vorzuziehen:
# Better approach using a vectorized method
students["age"] = students["age"] + 1Wenn du nur bestimmte Zeilen verarbeiten willst, nutze Bedingungen in der Schleife – hier werden nur Zeilen mit age größer 25 ausgegeben.
for row in students.itertuples(index=False):
    if row.age > 25:
        print(f"{row.Name} is older than 25")
Joseph is older than 25Die vektorisierte Lösung ist jedoch sauberer und schneller:
students_greater_than_5 = students[students["age"] > 25]Zusammenfassende Statistiken lassen sich auch zeilenweise berechnen – schneller geht es meist mit eingebauten Methoden wie .sum() und .mean().
# Manual aggregation
total_age = 0
for row in students.itertuples(index=False):
    total_age += row.age
average_age = total_age / len(students)
print(f"Average age: {average_age}")

# Preferred vectorized method
average_age =students["age"].mean()
Average age: 27.5Bei der Zeileniteration in Pandas solltest du die jeweiligen Trade-offs der Methoden kennen.
Nutze .iterrows() für einfache Lösungen bei kleineren Datensätzen und .itertuples() als schnellere, performantere Alternative.
Setze, wo möglich, zuerst auf vektorisierte Operationen – besonders bei großen Daten –, da sie dank C-basierter Implementierung deutlich effizienter sind.
.apply() ist die sinnvolle Zwischenlösung, wenn eine Zeilen- oder Spaltenlogik nötig ist, die sich nicht leicht vektorisieren lässt.
Mehr zu Pandas findest du hier:
Oder beschleunige dein Lernen mit diesen Kursen:
Lerne Python mit DataCamp
Kurs
Kurs
Kurs