Curso
Manipulação de dados com pandas
4 h
563.9K
Quando você precisa executar operações em um DataFrame do pandas linha a linha, é necessário usar iteração por linhas. Embora o pandas seja otimizado para operações vetorizadas, a iteração por linhas é essencial ao aplicar lógicas não vetorizadas, especialmente em manipulações complexas de dados ou processamento condicional de linhas.
Há vários métodos que você pode aplicar a um DataFrame do pandas para iterar por linhas.
.iterrows(): use para operações simples linha a linha, quando são necessários o índice e os dados da linha. Ele retorna pares de índice e Series, pode ser lento em dataframes grandes e não é indicado para computações pesadas.
.itertuples(): use como alternativa mais rápida ao .iterrows(), especialmente quando você não precisa de uma Series do pandas. Retorna um namedtuple com os valores da linha e é mais eficiente em memória do que o .iterrows().
.apply(axis=1): aplica uma função a cada linha, normalmente com o argumento axis = 1. É mais lento que métodos vetorizados, mas muitas vezes mais rápido do que laços explícitos.
Embora o pandas seja projetado para rodar de forma ideal com operações baseadas em colunas, diversos métodos em Python facilitam a iteração linha a linha, especialmente ao trabalhar com linhas individuais.
O pandas trabalha com DataFrames em formato colunar, o que o torna eficiente para aplicar transformações simultaneamente às colunas.
Esse também é um dos motivos pelos quais operações vetorizadas são eficientes no pandas e normalmente são preferidas à iteração por linhas, que pode ficar lenta em DataFrames grandes.
A seguir, os principais métodos de iteração por linhas:
.iterrows(): retorna cada linha como uma tupla (index, Series).
.itertuples(): mais rápido que .iterrows() e retorna cada linha como um namedtuple.
.items(): não é iteração por linhas; itera sobre as colunas de um DataFrame, retornando o rótulo da coluna e a Series, e é geralmente usado para operações por coluna.
Com base em benchmarks de DataFrames de porte médio com 100.000 linhas, .itertuples() é de 5 a 10 vezes mais rápido do que .iterrows() em velocidade e eficiência de memória. Isso acontece porque .itertuples() evita criar objetos Series para cada linha e, em vez disso, gera namedtuples leves.
Operações vetorizadas são mais rápidas do que qualquer forma de iteração porque são implementadas em código C otimizado. Elas eliminam laços em nível Python, reduzindo o overhead. Por exemplo, somar duas colunas usando datacamp_rows[“A”] + é mais rápido do que usar um laço datacamp_rows[“B”]for com .iterrows().
.iterrows() tem um grande consumo de memória, pois retorna um objeto Series completo do pandas, e essas Series podem sofrer com inconsistências de dtype, já que são derivadas de colunas diferentes com tipos variados.
Para conjuntos de dados menores, é recomendável usar .iterrows(); para conjuntos maiores, prefira .itertuples().
Você pode se deparar com situações em que não dá para aplicar operações vetorizadas e precisa recorrer à iteração por linhas. Nesta seção, você verá quando usar e quando evitar esse tipo de iteração.
Cenários comuns incluem:
Apesar dos casos de uso, você deve evitar iteração linha a linha quando:
Em vez de iterar, considere as seguintes alternativas:
Use operações vetorizadas sempre que possível.
Aproveite .apply() com funções otimizadas para tarefas complexas, mas ainda vetorizáveis.
Considere processamento em lote ou paralelização se precisar iterar, mas tiver restrições de desempenho.
Evite estas armadilhas comuns de laços por linha:
.iterrows() retorna uma cópia, não uma referência à linha original; portanto, modificações não alteram o DataFrame original.
O código fica mais difícil de ler e manter quando comparado às operações vetorizadas.
Você pode implementar iteração por linhas em DataFrames do pandas de várias formas, dependendo do seu caso de uso ou da natureza do DataFrame. Aqui estão os métodos para iterar sobre as linhas.
O método .iterrows() envolve iterar sobre linhas individuais de um DataFrame. A sintaxe é a seguinte:
for index, row in datacamp_rows.iterrows():
	# código para processar cada linha
Onde datacamp_rows é o dataframe iterado, index é o índice da linha e row é a Series do pandas contendo os dados da linha.
Veja um exemplo básico:
import pandas as pd

students = {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for index, row in students.iterrows():
    print(f"Index: {index}, Name: {row['Name']}, Age: {row['Age']}")
Index: 0, Name: Mary, Age: 25
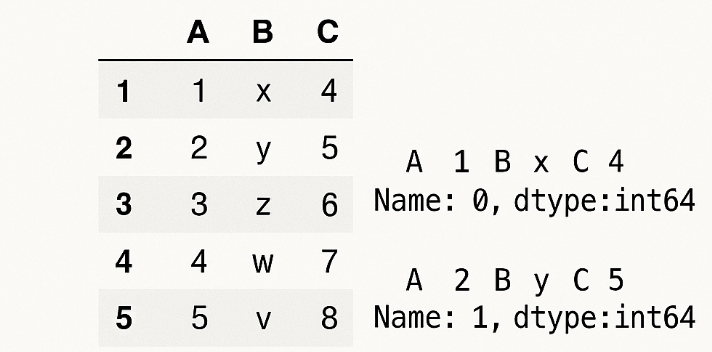
Index: 1, Name: Joseph, Age: 30O método .iterrows() retorna um gerador que produz o índice de uma linha junto com um objeto Series representando a linha. As chaves dessa Series são os nomes das colunas, e os valores são os dados correspondentes em cada linha.
Internamente, é isso que o .iterrows() retorna.
(index_0, Series_0)
(index_1, Series_1).itertuples() é mais rápido e mais eficiente em memória do que .iterrows() e retorna cada linha como um namedtuple, permitindo acessar valores das colunas por notação de ponto. A sintaxe é a seguinte:
for row in datacamp_rows.itertuples(index=True, name="Pandas"):
    # processa cada linha
Em que index=True inclui o índice do DataFrame como o primeiro elemento de cada tupla, e name="Pandas" define o nome da classe namedtuple retornada. Se name=None, o laço for retorna uma tupla comum, sem acesso por atributos.
Veja um exemplo prático de como .itertuples() funciona:
import pandas as pd

students= {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for row in students.itertuples():
    print(f"Index: {row.Index}, Name: {row.Name}, Age: {row.age}")
Index: 0, Name: Mary, Age: 25
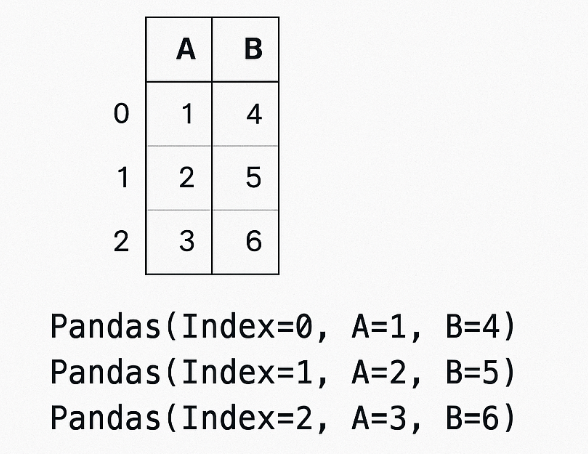
Index: 1, Name: Joseph, Age: 30.itertuples() retorna um gerador que produz namedtuples, em que cada linha é representada como um objeto leve.
Você pode acessar cada campo da linha usando notação de ponto, como row.Name e row.age, precedidos pelo índice.
Internamente, ele retorna:
Pandas(Index=0, Name='Mary', Age=25)
Pandas(Index=1, Name='Joseph', Age=30)O método .apply() no pandas é útil para aplicar funções às linhas e executar iteração linha a linha, como ao usar o argumento axis=1. A sintaxe é:
df.apply(func, axis=1)Em que a função aplicada à linha é func, com o argumento axis=1 definido.
Veja um exemplo prático ilustrando seu uso.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Math": [85, 90], "Science": [95, 88]})

# Adiciona uma nova coluna com a média
students["Average"] = students.apply(lambda row: (row["Math"] + row["Science"]) / 2, axis=1)
students.head()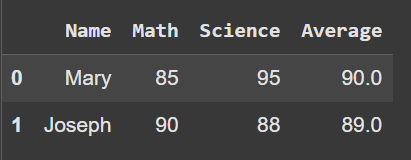
Use .apply() ao criar novas colunas com base nas existentes ou ao aplicar cálculos e transformações personalizadas.
No contexto de iteração por linhas, você pode usá-lo para criar lógica condicional por linha, como estruturas if-else. Quando axis=1 está definido, a função recebe a linha como uma Series com os nomes das colunas como índices. Essa função processa as linhas e retorna um valor escalar (em uma nova coluna) ou uma Series (em múltiplas colunas).
Embora .apply(axis=1) seja mais lento do que operações vetorizadas, costuma ser mais rápido e mais limpo do que .iterrows().
Outra alternativa para iteração por linhas é usar .loc[] ou .iloc[] manualmente com laços for para iterar sobre um DataFrame do pandas.
Isso funciona de forma semelhante aos métodos .iterrows() ou .itertuples(). Uma vantagem dessa abordagem é o controle total sobre as linhas. A sintaxe é:
# indexação posicional
for i in range(len(df)):
    row = df.iloc[i]
    # processa a linha

# indexação por rótulo
for idx in df.index:
    row = df.loc[idx]
    # processa a linha
Veja um exemplo prático de implementação.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Age": [25, 30]})

# Usando iloc
for i in range(len(students)):
    print(f"Name: {students.iloc[i]['Name']}, Age: {students.iloc[i]['Age']}")

# Usando loc
for idx in students.index:
    print(f"Name: {students.loc[idx, 'Name']}, Age: {students.loc[idx, 'Age']}")
Name: Mary, Age: 25
Name: Joseph, Age: 30Um caso de uso dessa abordagem é quando você precisa de controle preciso sobre a ordem das linhas ou ao escrever uma lógica passo a passo para depuração. Embora fique ineficiente em dataframes grandes, também é mais lento do que operações vetorizadas.
É essencial usar .loc[] quando precisar de busca por rótulo e .iloc[] quando precisar de acesso por posição, especialmente com laços baseados em intervalos.
Aqui está uma tabela que resume as diferenças entre os três métodos.
|
Recursos |
iterrows() |
itertuples() |
apply(axis=1) |
|
Sintaxe |
for idx, row in df.iterrows: |
for row in df.itertuples(): |
df.apply(func, axis=1) |
|
Saída |
(index, Series) |
namedtuple |
Retorna o valor da função (escalar ou Series) |
|
Velocidade |
Lento |
Mais rápido |
Moderada |
|
Uso de memória |
Médio |
Baixo |
Médio |
|
Legibilidade |
Moderada |
Alta |
Alta |
|
Melhores usos |
Protótipos rápidos ou depuração |
Conjuntos de dados grandes |
Derivação de colunas |
|
Limitações |
Mais lento |
Não lida bem com lógica de linha complexa |
Mais lento que vetorizar totalmente |
Embora .iterrows() seja uma forma direta de iterar pelas linhas de um DataFrame do pandas, ele tem limitações que podem afetar o desempenho.
A iteração com .iterrows() produz cada linha de um DataFrame como uma tupla contendo o índice da linha e um objeto Series com os dados da linha.
Apesar da simplicidade, há um inconveniente quanto à conversão de dtypes; por exemplo, inteiros podem virar floats se a Series precisar acomodar tipos mistos, o que pode gerar bugs sutis em cálculos ou comparações.
Além disso, como .iterrows() retorna uma Series por linha, há overhead de memória, o que o torna mais lento que operações vetorizadas.
Modificar dados dentro de um laço usando .iterrows() não é recomendado, pois alterações na Series não são propagadas de volta ao DataFrame.
Apesar das limitações, .iterrows() é útil em alguns cenários, como:
.iterrows() para operações não vetorizáveis, como chamadas de API, escrita em arquivos ou interação com bancos de dados linha a linha..iterrows() pode ajudar.Para manter a consistência de dtypes, considere trocar para .itertuples(), que retorna namedtuples sem conversão de tipos.
O método .itertuples() é mais rápido e mais eficiente em memória do que .iterrows() porque retorna um namedtuple. Vamos ver como alguns recursos o tornam superior ao .iterrows().
Algumas vantagens do .itertuples() incluem:
Ganhos de performance: em vez de criar objetos Series como o .iterrows(), que consomem memória e reduzem o desempenho, .itertuples() evita esse overhead usando um gerador que produz namedtuples.
Personalização: o argumento index=False em .itertuples() omite o índice da tupla, e definir name='Custom' permite nomear a classe namedtuple, melhorando legibilidade ou integração com outros sistemas.
Ao usar .itertuples(), atente-se às limitações:
Restrições de nomes de colunas: nomes com caracteres especiais ou espaços podem gerar identificadores Python inválidos. Eles são modificados para nomes válidos ou acessados por desempacotamento posicional.
Imutabilidade: namedtuples são imutáveis, ou seja, você não consegue alterar valores in-place. Qualquer transformação exige construir uma nova estrutura ou acumular os valores desejados em uma lista ou DataFrame separado.
Boas práticas ao usar .itertuples():
Embora os principais métodos de iteração por linhas sejam .iterrows() e .itertuples(), o pandas oferece alternativas mais eficientes para manipulação de dados em larga escala, como a vetorização, que é mais rápida e econômica em memória.
Operações vetorizadas aplicam operações em arrays inteiros ou colunas do DataFrame de uma só vez, aproveitando otimizações de baixo nível no NumPy e no pandas. São mais limpas e legíveis, além de reduzirem drasticamente o tempo de execução.
Abaixo, algumas técnicas e exemplos comuns de vetorização:
Operações aritméticas: datacamp_rows[‘total’] = datacamp_rows[‘price’] * datacamp_rows[quantity’]
Lógica condicional: datacamp_rows[‘flag’] = np.where(datacamp_rows[‘value’] > 10, ‘high’, ‘low’)
Métodos de string: datacamp_rows[‘cleaned’] = datacamp_rows[‘text’].str.lower().str.strip()
Manipulações de datas: datacamp_rows[‘year’] =datacamp_rows[‘date’].dt.year
Operações vetorizadas são apoiadas por código C compilado e gerenciamento de memória otimizado, superando laços em Python em ordens de grandeza, especialmente em DataFrames grandes.
Ao implementar lógica por linha, recomenda-se usar .apply(axis=1). Embora não seja tão rápido quanto vetorização, é mais eficiente e expressivo do que iteração por linhas. .apply() pode ser lento em DataFrames muito grandes porque ainda itera internamente em C; mesmo assim, é adequado para lógicas moderadamente complexas.
Ferramentas para otimizar .apply() incluem:
Swifter: decide automaticamente a forma mais rápida de executar .apply().
Pandarallel: permite executar .apply() em paralelo em vários núcleos de CPU com uma única linha de código.
Numba: compilador JIT que acelera funções numéricas em Python. Usado dentro de .apply(), pode reduzir drasticamente o tempo de computação em operações numéricas intensivas.
Uma estratégia poderosa no pandas é criar colunas temporárias para decompor operações complexas em etapas vetorizadas menores, evitando a necessidade de iteração explícita linha a linha.
Há diversas estratégias de otimização e comparativos para garantir escalabilidade e eficiência de memória, especialmente ao trabalhar com grandes volumes de dados.
Diferentes métodos de iteração em Python têm desempenhos variados. Por exemplo, laços for e while, quando usados com métodos do pandas como .itertuples() e .iterrows(), são significativamente mais lentos do que operações vetorizadas.
Benchmarks costumam mostrar que .itertuples() é mais rápido e mais eficiente em memória do que .iterrows() porque retorna namedtuples em vez de Series. Operações vetorizadas superam todas as outras formas de iteração devido às implementações em C por baixo dos panos.
À medida que os dados escalam para milhões de linhas, essas diferenças se tornam críticas, pois métodos ineficientes levam a gargalos e maior consumo de memória.
Para conjuntos de dados maiores, considere técnicas como:
Processamento em chunks: use o parâmetro chunksize em .read_csv() para processar dados em blocos gerenciáveis em vez de carregar tudo na memória de uma vez.
Otimização de dtypes: teste tipos de dados mais econômicos, como float32 em vez de float64, para reduzir o uso de memória.
Gerenciamento de memória: descarte colunas não usadas o quanto antes, filtre dados antes de mesclar e libere memória periodicamente com gc.collect().
Computação out-of-core: use ferramentas como Dask e Vaex para permitir computações paralelas e out-of-core em dados que excedem a memória.
Há vários cenários em que a iteração é útil. Veja alguns exemplos práticos que demonstram padrões comuns e boas práticas ao trabalhar com pandas.
Exemplo de uso básico de .iterrows(), .itertuples() e .apply(axis=1).
import pandas as pd

students = pd.DataFrame({"name": ["Mary", "Joseph"], "age": [25, 30]})

# Usando iterrows()
for index, row in students.iterrows():
    print(f"{row['name']} is {row['age']} years old")

# Usando itertuples()
for row in students.itertuples(index=False):
    print(f"{row.name} is {row.age} years old")

# Usando apply()
students.apply(lambda row: print(f"{row['name']} is {row['age']} years old"), axis=1)
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years oldVocê pode usar métodos de iteração por linhas para alterar valores de um DataFrame em um laço; porém, isso não é eficiente com conjuntos de dados grandes.
Os exemplos a seguir mostram como implementar.
for index, row in students.iterrows():
    students.at[index, 'age'] = row['age'] + 1

students.head()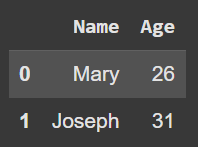
Em dataframes grandes, considere usar uma operação vetorizada para ganhar desempenho, como no exemplo abaixo.
# Abordagem melhor usando método vetorizado
students["age"] = students["age"] + 1Para processar apenas linhas específicas, use uma checagem condicional dentro do laço. No exemplo a seguir, são impressas as linhas com age maior que 25.
for row in students.itertuples(index=False):
    if row.age > 25:
        print(f"{row.Name} is older than 25")
Joseph is older than 25Ainda assim, a opção vetorizada abaixo é melhor e mais performática.
students_greater_than_5 = students[students["age"] > 25]Também é possível calcular estatísticas de resumo durante o processamento linha a linha; porém, o pandas oferece métodos como .sum() e .mean(), que são mais rápidos.
# Agregação manual
total_age = 0
for row in students.itertuples(index=False):
    total_age += row.age
average_age = total_age / len(students)
print(f"Average age: {average_age}")

# Método vetorizado preferido
average_age =students["age"].mean()
Average age: 27.5Ao iterar por linhas no pandas, é essencial entender os trade-offs entre os métodos disponíveis.
Use .iterrows() quando precisar de uma solução simples e não estiver trabalhando com um conjunto de dados grande, e .itertuples() quando precisar de uma alternativa mais rápida e com melhor desempenho.
Dê preferência a operações vetorizadas sempre que possível, especialmente com conjuntos maiores, pois são mais rápidas e eficientes graças às implementações em C por baixo.
Use .apply() como meio-termo quando for preciso uma operação por linha ou por coluna que não seja facilmente vetorizável.
Confira também estes recursos para aprender mais sobre pandas:
Você também pode conferir estes cursos para acelerar sua aprendizagem:
Aprenda Python com a DataCamp
Curso
Curso
Curso
Tutorial
Aditya Sharma
5 min
Tutorial
Karlijn Willems
15 min
Tutorial
DataCamp Team
7 min
Tutorial
DataCamp Team
13 min
Tutorial
Vidhi Chugh
15 min
Tutorial
Kurtis Pykes
9 min




