Cours
Manipulation de données avec pandas
4 h
564.1K
Lorsque vous devez effectuer des opérations dans un DataFrame pandas ligne par ligne, vous avez besoin d’une itération sur les lignes. Bien que pandas soit optimisé pour les opérations vectorisées, l’itération par ligne reste indispensable pour appliquer une logique non vectorisable, notamment lors de manipulations complexes ou de traitements conditionnels par ligne.
Plusieurs méthodes permettent d’itérer sur les lignes d’un DataFrame pandas.
.iterrows() : à utiliser pour des opérations simples ligne à ligne, lorsque vous avez besoin de l’index et des données de la ligne. Elle renvoie des paires index–Series, ce qui peut être lent sur de grands DataFrames et n’est pas idéal pour des calculs lourds.
.itertuples() : à privilégier comme alternative plus rapide à .iterrows(), surtout si vous n’avez pas besoin d’une Series pandas. Elle renvoie un namedtuple des valeurs de la ligne et consomme moins de mémoire que .iterrows().
.apply(axis=1) : applique une fonction à chaque ligne, généralement avec l’argument axis = 1. Plus lente que les méthodes vectorisées, mais souvent plus rapide que les boucles explicites.
Même si pandas est conçu pour fonctionner de manière optimale avec des opérations par colonnes, plusieurs approches Python facilitent l’itération ligne par ligne, en particulier lorsque vous traitez des lignes individuellement.
Pandas manipule les DataFrames en format colonnaire, ce qui le rend très efficace pour appliquer des transformations en parallèle sur des colonnes entières.
C’est aussi l’une des raisons pour lesquelles les opérations vectorisées sont performantes avec pandas et sont préférées aux itérations par ligne, qui deviennent lentes sur de grands DataFrames.
Voici les principales méthodes d’itération par ligne :
.iterrows() : renvoie chaque ligne sous la forme d’un tuple (index, Series).
.itertuples() : plus rapide que .iterrows(), elle renvoie chaque ligne sous forme de namedtuple.
.items() : ce n’est pas une itération par ligne, mais par colonnes ; elle renvoie le libellé de colonne et la Series correspondante, et s’utilise pour des opérations par colonnes.
D’après des benchmarks sur des DataFrames d’environ 100 000 lignes, .itertuples() est 5 à 10 fois plus rapide que .iterrows(), en vitesse comme en efficacité mémoire. En effet, .itertuples() évite de créer une Series pour chaque ligne et renvoie à la place des namedtuples légers.
Les opérations vectorisées sont plus rapides que toute forme d’itération car elles sont implémentées en C optimisé. Elles suppriment les boucles au niveau Python et réduisent les surcoûts. Par exemple, additionner deux colonnes avec datacamp_rows[“A”] + est plus rapide que d’utiliser une boucle datacamp_rows[“B”]for avec .iterrows().
.iterrows() a une empreinte mémoire importante car elle renvoie un objet Series complet ; ces Series peuvent aussi présenter des incohérences de types (dtype) puisqu’elles agrègent des colonnes aux types différents.
Pour un petit jeu de données, vous pouvez utiliser .iterrows() ; pour des volumes plus importants, préférez .itertuples().
Vous pouvez rencontrer des situations où les opérations vectorisées ne sont pas applicables et où il faut revenir à l’itération par ligne. Cette section explique quand l’utiliser—et quand l’éviter.
Les scénarios fréquents incluent :
Malgré ces cas d’usage, évitez l’itération par ligne lorsque :
Au lieu d’itérer, envisagez les alternatives suivantes :
Utilisez les opérations vectorisées dès que possible.
Tirez parti de .apply() avec des fonctions optimisées pour une logique complexe mais encore vectorisable.
Recourez au traitement par lots ou à la parallélisation si vous devez absolument itérer avec des contraintes de performance.
Évitez également ces pièges classiques des boucles par ligne :
.iterrows() renvoie une copie, pas une référence à la ligne d’origine ; la modifier ne change donc pas le DataFrame initial.
Le code est plus difficile à lire et à maintenir que des opérations vectorisées.
Vous pouvez mettre en œuvre l’itération par ligne dans pandas de différentes manières selon votre cas d’usage ou la nature du DataFrame. Voici les principales méthodes.
La méthode .iterrows() consiste à itérer sur chaque ligne d’un DataFrame. Sa syntaxe est la suivante :
for index, row in datacamp_rows.iterrows():
	# code to process each row
Où datacamp_rows est le DataFrame itéré, index l’index de la ligne, et row la Series pandas contenant les données de la ligne.
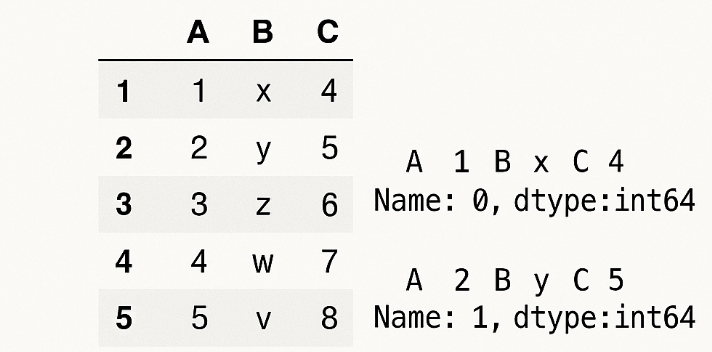
Exemple d’utilisation basique :
import pandas as pd

students = {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for index, row in students.iterrows():
    print(f"Index: {index}, Name: {row['Name']}, Age: {row['Age']}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30La méthode .iterrows() renvoie un générateur qui produit l’index de la ligne et un objet Series représentant la ligne. Les clés de cette Series sont les noms de colonnes, et les valeurs sont les données correspondantes de la ligne.
En interne, voici ce que renvoie .iterrows() :
(index_0, Series_0)
(index_1, Series_1).itertuples() est plus rapide et plus économe en mémoire que .iterrows(). Elle renvoie chaque ligne sous forme de namedtuple, permettant d’accéder aux valeurs par notation pointée. La syntaxe est la suivante :
for row in datacamp_rows.itertuples(index=True, name="Pandas"):
    # process each row
Avec index=True, l’index du DataFrame est inclus comme premier élément du tuple, et name="Pandas" définit le nom de la classe de namedtuple retournée. Si name=None, la boucle for renvoie un tuple standard sans accès par attributs.
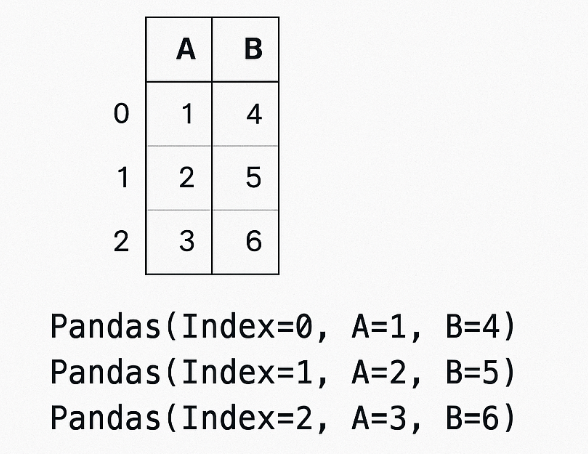
Exemple pratique de .itertuples() :
import pandas as pd

students= {"Name": ["Mary", "Joseph"], "Age": [25, 30]}
students = pd.DataFrame(students)

for row in students.itertuples():
    print(f"Index: {row.Index}, Name: {row.Name}, Age: {row.age}")
Index: 0, Name: Mary, Age: 25
Index: 1, Name: Joseph, Age: 30.itertuples() renvoie un générateur de namedtuples, chaque ligne étant un objet léger.
Vous pouvez accéder à chaque champ par notation pointée, comme row.Name et row.age, avec l’index en premier.
En interne, cela renvoie :
Pandas(Index=0, Name='Mary', Age=25)
Pandas(Index=1, Name='Joseph', Age=30)La méthode .apply() de pandas est utile pour appliquer des fonctions aux lignes, en particulier avec l’argument axis=1. La syntaxe est :
df.apply(func, axis=1)Où func est la fonction à appliquer et axis=1 indique un traitement par ligne.
Voici un exemple concret.
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Math": [85, 90], "Science": [95, 88]})

# Add a new column with average score
students["Average"] = students.apply(lambda row: (row["Math"] + row["Science"]) / 2, axis=1)
students.head()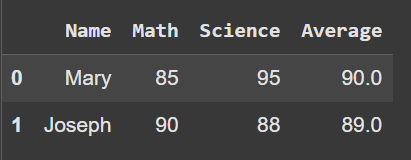
Utilisez .apply() pour créer de nouvelles colonnes à partir de colonnes existantes ou appliquer des calculs/transformations personnalisés.
Dans une logique d’itération, vous pouvez l’utiliser pour des conditions par ligne (if/else). Avec axis=1, la fonction reçoit une Series dont les index sont les noms de colonnes. Elle renvoie une valeur scalaire (nouvelle colonne) ou une Series (plusieurs colonnes).
Même si .apply(axis=1) est plus lent que la vectorisation, il est souvent plus rapide et plus propre que .iterrows().
Autre approche : utiliser .loc[] ou .iloc[] manuellement avec des boucles for pour parcourir un DataFrame pandas.
Cela fonctionne de manière similaire à .iterrows() ou .itertuples(). L’avantage est un contrôle total sur les lignes. Syntaxe :
# positional indexing
for i in range(len(df)):
    row = df.iloc[i]
    # process row

# label indexing
for idx in df.index:
    row = df.loc[idx]
    # process row
Exemple pratique :
import pandas as pd

students = pd.DataFrame({"Name": ["Mary", "Joseph"], "Age": [25, 30]})

# Using iloc
for i in range(len(students)):
    print(f"Name: {students.iloc[i]['Name']}, Age: {students.iloc[i]['Age']}")

# Using loc
for idx in students.index:
    print(f"Name: {students.loc[idx, 'Name']}, Age: {students.loc[idx, 'Age']}")
Name: Mary, Age: 25
Name: Joseph, Age: 30Cette méthode convient quand vous avez besoin d’un contrôle fin de l’ordre des lignes, ou pour un débogage pas à pas. Elle devient toutefois inefficace sur de grands DataFrames et reste plus lente que la vectorisation.
Utilisez .loc[] pour un accès par étiquettes et .iloc[] pour un accès par position, notamment avec des boucles basées sur des plages d’index.
Voici un tableau récapitulatif des différences entre ces trois méthodes.
|
Fonctionnalités |
iterrows() |
itertuples() |
apply(axis=1) |
|
Syntaxe |
for idx, row in df.iterrows: |
for row in df.itertuples(): |
df.apply(func, axis=1) |
|
Sortie |
(index, Series) |
namedtuple |
Valeur de retour de la fonction (scalaire ou Series) |
|
Vitesse |
Lente |
La plus rapide |
Intermédiaire |
|
Consommation mémoire |
Moyenne |
Faible |
Moyenne |
|
Lisibilité |
Modérée |
Elevée |
Elevée |
|
Meilleurs cas d’usage |
Prototypage rapide ou débogage |
Grands jeux de données |
Création de colonnes |
|
Limites |
Plus lent |
Ne gère pas une logique de ligne complexe |
Plus lent que la vectorisation complète |
Si .iterrows() est une façon simple d’itérer sur les lignes d’un DataFrame pandas, elle comporte des limites qui peuvent impacter les performances.
L’itération avec .iterrows() renvoie chaque ligne comme un tuple contenant l’index et une Series avec les données de la ligne.
Malgré sa simplicité, elle présente un inconvénient de conversion de types (dtype) : par exemple, des entiers peuvent être convertis en flottants si la Series doit mélanger les types, ce qui peut générer des bogues subtils.
En outre, .iterrows() renvoyant une Series par ligne, cela entraîne une surcharge mémoire et des performances inférieures à la vectorisation.
La modification des données dans une boucle .iterrows() est déconseillée, car les changements apportés à la Series ne sont pas répercutés dans le DataFrame.
Malgré ces limites, .iterrows() reste utile dans certains cas :
Pour conserver des dtypes cohérents, passez à .itertuples(), qui renvoie des namedtuples sans conversion de types.
.itertuples() est plus rapide et plus économe en mémoire que .iterrows() car elle renvoie un namedtuple. Voyons en quoi ses caractéristiques la rendent supérieure à .iterrows().
Parmi les avantages de .itertuples() :
Gains de performance : à la différence de .iterrows(), qui crée des Series coûteuses en mémoire, .itertuples() évite cette surcharge en renvoyant des namedtuples via un générateur.
Personnalisation : l’argument index=False omet l’index du tuple, et name='Custom' permet de nommer la classe de namedtuple pour améliorer la lisibilité ou l’intégration.
Points d’attention lors de l’usage de .itertuples() :
Contraintes de nommage des colonnes : des noms avec caractères spéciaux ou espaces peuvent produire des identifiants Python invalides. Ils sont alors modifiés, ou l’accès se fait par indices du tuple.
Immutabilité : les namedtuples sont immuables ; vous ne pouvez pas modifier leurs valeurs en place. Toute transformation doit construire une nouvelle structure ou accumuler les résultats dans une liste/DataFrame séparée.
Bonnes pratiques avec .itertuples() :
Outre .iterrows() et .itertuples(), pandas offre des alternatives plus efficaces pour les manipulations à grande échelle, notamment la vectorisation, plus rapide et économe en mémoire.
La vectorisation applique des opérations sur des tableaux entiers ou des colonnes du DataFrame d’un seul coup, en s’appuyant sur les optimisations bas niveau de NumPy et pandas. C’est plus lisible et réduit drastiquement les temps d’exécution.
Voici quelques techniques courantes de vectorisation :
Opérations arithmétiques : datacamp_rows[‘total’] = datacamp_rows[‘price’] * datacamp_rows[quantity’]
Logique conditionnelle : datacamp_rows[‘flag’] = np.where(datacamp_rows[‘value’] > 10, ‘high’, ‘low’)
Méthodes de chaînes : datacamp_rows[‘cleaned’] = datacamp_rows[‘text’].str.lower().str.strip()
Manipulations de dates : datacamp_rows[‘year’] =datacamp_rows[‘date’].dt.year
Portées par du code C compilé et une gestion mémoire optimisée, les opérations vectorisées surpassent de loin les boucles Python, surtout sur de grands DataFrames.
Pour une logique par ligne, préférez .apply(axis=1). Ce n’est pas aussi rapide que la vectorisation, mais plus efficace et expressif que l’itération. .apply() peut rester lent sur de très grands DataFrames car il boucle en C en interne, mais il gère bien une logique modérément complexe.
Pour optimiser .apply(), vous pouvez utiliser :
Swifter : choisit automatiquement la façon la plus rapide d’exécuter .apply().
Pandarallel : exécute facilement .apply() en parallèle sur plusieurs cœurs CPU en une ligne.
Numba : JIT compiler qui accélère les fonctions numériques Python. Intégré à .apply(), il peut réduire drastiquement le temps de calcul pour des opérations intensives.
Une stratégie puissante consiste à créer des colonnes temporaires afin de décomposer une logique complexe en étapes vectorisées plus simples, évitant les itérations explicites.
Plusieurs stratégies d’optimisation et comparatifs existent pour garantir une gestion scalable et économe en mémoire, notamment sur de grands volumes.
Les méthodes d’itération en Python offrent des performances variables. Les boucles for/while, associées à .itertuples() et .iterrows(), sont nettement plus lentes que la vectorisation.
Les benchmarks montrent généralement que .itertuples() est plus rapide et plus économe que .iterrows() car elle renvoie des namedtuples plutôt que des Series. Les opérations vectorisées surpassent toutes les formes d’itération grâce à leur implémentation en C.
Lorsque les données atteignent des millions de lignes, ces écarts deviennent critiques : des méthodes inefficaces créent des goulots d’étranglement et augmentent la consommation mémoire.
Pour des volumes importants, envisagez ces techniques :
Traitement par blocs (chunking) : utilisez chunksize dans .read_csv() pour traiter des blocs gérables au lieu de tout charger en mémoire.
Optimisation des dtypes : testez des types plus légers, par exemple float32 au lieu de float64, pour réduire la mémoire.
Gestion de la mémoire : supprimez tôt les colonnes inutiles, filtrez avant les jointures, et libérez périodiquement la mémoire avec gc.collect().
Calcul hors mémoire (out-of-core) : utilisez Dask et Vaex pour des calculs parallèles hors mémoire sur des volumes supérieurs à la RAM.
Voici quelques scénarios où l’itération est utile. Exemples pratiques illustrant des schémas fréquents et de bonnes pratiques avec pandas.
Exemple de base avec .iterrows(), .itertuples() et .apply(axis=1).
import pandas as pd

students = pd.DataFrame({"name": ["Mary", "Joseph"], "age": [25, 30]})

# Using iterrows()
for index, row in students.iterrows():
    print(f"{row['name']} is {row['age']} years old")

# Using itertuples()
for row in students.itertuples(index=False):
    print(f"{row.name} is {row.age} years old")

# Using apply()
students.apply(lambda row: print(f"{row['name']} is {row['age']} years old"), axis=1)
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years old
Mary is 25 years old
Joseph is 30 years oldVous pouvez modifier des valeurs d’un DataFrame dans une boucle ; cependant, cette approche n’est pas efficace sur de grands volumes.
Exemples :
for index, row in students.iterrows():
    students.at[index, 'age'] = row['age'] + 1

students.head()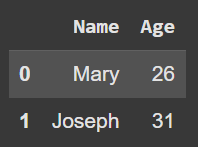
Sur de grands DataFrames, préférez une approche vectorisée, plus performante :
# Better approach using a vectorized method
students["age"] = students["age"] + 1Pour ne traiter que certaines lignes, ajoutez un test conditionnel dans la boucle, comme ci-dessous où seules les lignes avec age supérieur à 25 sont affichées.
for row in students.itertuples(index=False):
    if row.age > 25:
        print(f"{row.Name} is older than 25")
Joseph is older than 25La version vectorisée ci-dessous est toutefois plus performante.
students_greater_than_5 = students[students["age"] > 25]Il est possible de calculer des statistiques résumées pendant une itération, mais pandas propose des méthodes intégrées comme .sum() et .mean(), plus rapides.
# Manual aggregation
total_age = 0
for row in students.itertuples(index=False):
    total_age += row.age
average_age = total_age / len(students)
print(f"Average age: {average_age}")

# Preferred vectorized method
average_age =students["age"].mean()
Average age: 27.5Pour itérer sur les lignes avec pandas, il est essentiel de comprendre les compromis entre les différentes méthodes disponibles.
Utilisez .iterrows() pour une solution simple sur de petits jeux de données, et .itertuples() lorsque vous cherchez une alternative plus rapide et performante.
Privilégiez toujours les opérations vectorisées dès qu’elles s’appliquent, surtout sur de grands volumes, car elles sont plus rapides et efficaces grâce à leurs implémentations en C.
.apply() constitue un juste milieu quand vous avez besoin d’une opération par ligne ou par colonne difficilement vectorisable.
Pour aller plus loin avec pandas :
Découvrez aussi nos pages de cours pour accélérer votre apprentissage :
Apprenez Python avec DataCamp
Cours
Cours
Cours