Curso
Trabajar con la API de OpenAI
3 h
172.6K
Desde el lanzamiento de ChatGPT en noviembre de 2022, los chatbots con LLM se han convertido en protagonistas en multitud de casos de uso.
La idea de un chatbot no es nueva. Todos hemos visto chatbots ineficaces que hay que configurar hasta el extremo, casi como si fueran guiones de reglas if-else. Mantenerlos es un dolor de cabeza y no ayudan al usuario final; de hecho, logran lo contrario: frustrarlo.
Pero ahora, en 2024, los chatbots han vuelto, gracias a los modelos de lenguaje de gran tamaño (LLM).
En este blog aprenderás:
También puedes echar un vistazo a nuestro curso Vector Databases for Embeddings with Pinecone y al code-along sobre crear chatbots con la API de OpenAI y Pinecone para profundizar más.
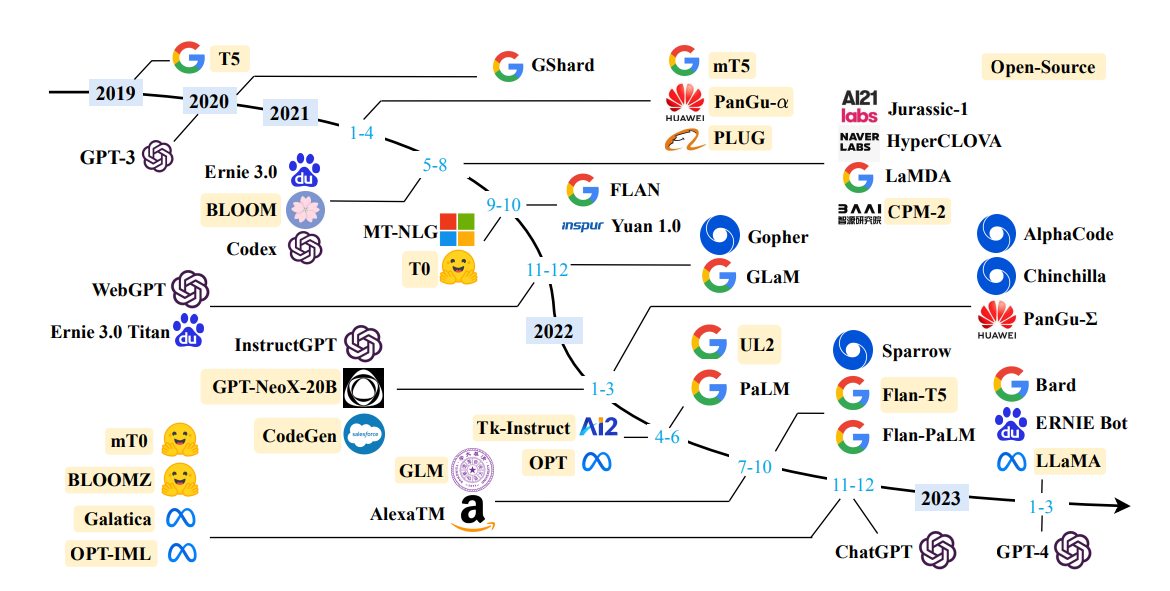
Los modelos de lenguaje de gran tamaño (LLM) como GPT-4 son algoritmos de machine learning avanzados que emplean técnicas de deep learning, en particular la arquitectura transformer, para comprender y generar lenguaje natural.
Se entrenan con conjuntos de datos masivos que contienen billones de palabras procedentes de todo tipo de textos disponibles en internet, como libros, artículos, sitios web y repositorios de código. Esta formación a gran escala les permite realizar una amplia variedad de tareas complejas de procesamiento del lenguaje.
Una de las características clave de los LLM es su capacidad para generar texto sobre prácticamente cualquier tema. Esta habilidad abarca múltiples estilos y formatos, desde escritura creativa hasta documentación técnica.
Los LLM dominan tareas como la resumización, condensando documentos extensos en resúmenes precisos, y la conversación, permitiendo diálogos naturales y fluidos con las personas usuarias. También son muy buenos traduciendo entre idiomas, incluso capturando matices como el argot y las variantes regionales.
Sin embargo, los LLM no están exentos de retos. Un problema importante es que pueden «alucinar», es decir, generar información verosímil pero incorrecta o sin sentido, especialmente ante consultas fuera de su entrenamiento o con instrucciones ambiguas.
Otro problema clave es el posible sesgo en las respuestas, ya sea heredado de los datos de entrenamiento o introducido durante el desarrollo del modelo.
Los LLM suponen un gran avance en IA y ofrecen un enorme potencial de innovación y eficiencia en muchos ámbitos, pero requieren una gestión cuidadosa para mitigar riesgos como el sesgo y la desinformación.
Aunque los LLM son potentes, tienen limitaciones. Pueden devolver información desactualizada, genérica o incluso falsa si la consulta va más allá del alcance de sus datos de entrenamiento.
También pueden generar información incorrecta o absurda que el modelo presenta como cierta o lógica. Este fenómeno es conocido como alucinación.
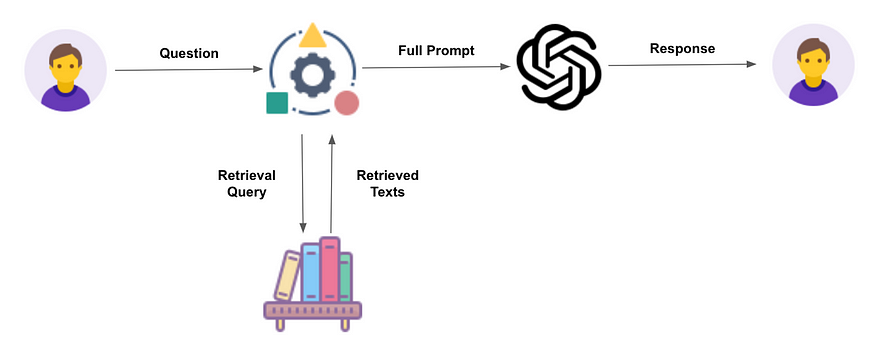
RAG busca mitigar estos problemas dirigiendo a los LLM a recuperar información relevante de fuentes predefinidas. Este enfoque aumenta la confianza del usuario, ya que las respuestas del modelo son más precisas y atribuibles a fuentes fiables.
Además, ofrece a los desarrolladores más control sobre las respuestas generadas por el LLM, mejorando la calidad y la aplicabilidad del sistema.
Puedes aprender más sobre retrieval augmented generation en nuestro tutorial dedicado. Aun así, a continuación resumimos los pasos principales del proceso.
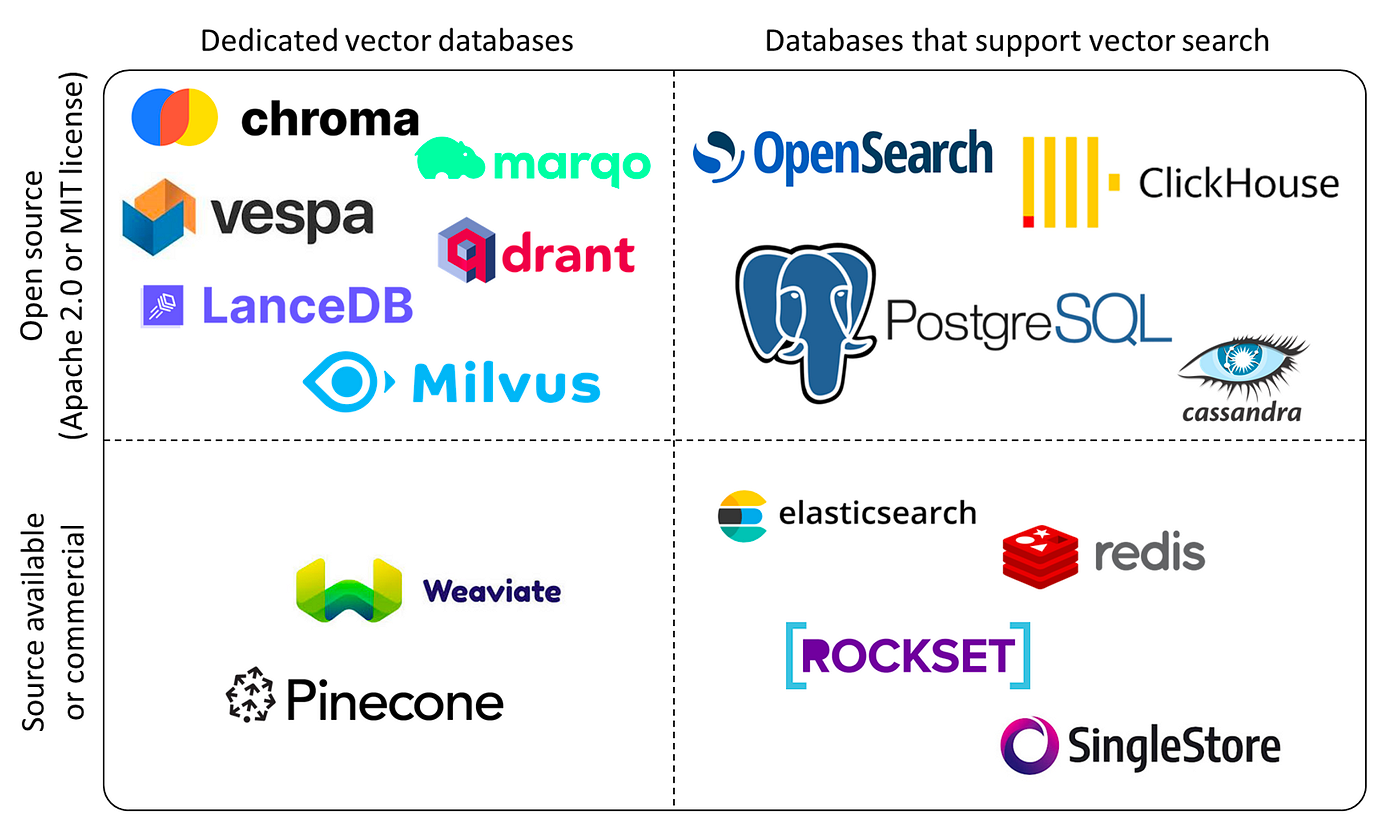
Las bases de datos vectoriales son tipos de bases de datos especializadas en gestionar vectores de alta dimensión, que son representaciones matemáticas de atributos o características de los datos. Estos vectores pueden tener desde decenas hasta miles de dimensiones, según la complejidad y granularidad de los datos.
Este tipo de base de datos destaca por realizar búsquedas y recuperaciones por similitud de forma rápida y precisa basadas en la distancia o similitud entre vectores, lo que permite consultas más semánticas o contextuales, en lugar de depender de coincidencias exactas o criterios predefinidos.
En la práctica, las bases vectoriales tienen múltiples usos. Por ejemplo, pueden encontrar imágenes similares a otra según su contenido y estilo visual, localizar documentos parecidos a un documento dado según tema y sentimiento, o identificar productos similares a otro en función de sus características y valoraciones.
La consulta en una base vectorial consiste en usar un vector de consulta que representa la información o los criterios deseados y aplicar una medida de similitud para determinar la cercanía de los vectores en el espacio vectorial. El resultado es una lista ordenada de vectores con alta similitud respecto a la consulta, lo que permite acceder a los datos originales asociados a cada vector.
Las bases vectoriales se apoyan en varios algoritmos, como los índices k-nearest neighbors (k-NN), y se construyen con métodos como HNSW (Hierarchical Navigable Small World) e IVF (Inverted File Index).
Son piezas clave en aplicaciones de retrieval augmented generation (RAG). Ofrecen búsqueda por similitud eficiente, expansión de contenido, diversidad y recuperación dinámica de datos multimodales. Esto es crucial en la IA generativa, donde el acceso a conjuntos masivos y diversos de datos ayuda a reducir sesgos y alucinaciones en los modelos.
Pinecone es una base vectorial muy popular que destaca por su eficiencia y facilidad de uso, especialmente al manejar datos a gran escala. Está pensada para desarrolladores y data scientists que quieran incorporar búsqueda vectorial en diferentes aplicaciones.
Pinecone emplea técnicas avanzadas de indexación como product quantization y locality-sensitive hashing, lo que permite búsquedas por similitud eficientes y precisas en espacios vectoriales de alta dimensión. Esto la hace especialmente útil para aplicaciones RAG. Puedes aprender más sobre dominar las bases de datos vectoriales con Pinecone en nuestro tutorial aparte.
En este tutorial, usaremos Pinecone como base de datos vectorial.
La plataforma de API de OpenAI da acceso a todos los modelos entrenados por OpenAI disponibles públicamente. Incluye GPT, DALL-E, Whisper y otros modelos.
Se accede a la API mediante peticiones HTTP, así que puedes integrarla con cualquier lenguaje que las soporte. No obstante, para Python existe una librería llamada openai que puedes instalar con pip install openai y que simplifica aún más trabajar con estas API.
Trabajar con la API de OpenAI en Python usando la librería openai lleva solo unas pocas líneas.
Ejemplo en Python:
import os
os.environ["OPENAI_API_KEY"] = " "


from openai import OpenAI
client = OpenAI()


completion = client.chat.completions.create(
  model="gpt-4",
  messages=[
    {"role": "system", "content": "You are expert in Machine Learning."},
    {"role": "user", "content": "Explain how does random forest works?."}
  ]
)


print(completion.choices[0].message)
LangChain es un framework para desarrollar aplicaciones impulsadas por modelos de lenguaje. Proporciona un nivel de abstracción que facilita y acelera la creación de prototipos y el paso de prototipo a producción. Su crecimiento y popularidad se reflejan en el número de estrellas de su página en Github.
Es un framework fantástico. Sin embargo, una advertencia: aún no es estable. La API cambia con frecuencia y es posible que, cuando leas el código de la siguiente sección, ya no funcione. Es normal porque la librería sigue en pre-release. En el momento de escribir este blog, la última versión de LangChain es la 0.1.4.
Para implementar un back-end RAG, necesitamos embeddings de datos externos. Si partimos de datos en bruto, tendremos que generarlos con la API de embeddings de OpenAI u otros embeddings de código abierto.
Crear embeddings a partir de datos en bruto es directo. Sin embargo, si usas las API de OpenAI, se te cobrará por token.
Para este tutorial, he reproducido la mayor parte del código de esta sección de la guía oficial de Pinecone sobre LangChain. La documentación de Pinecone es excelente y siempre está actualizada.
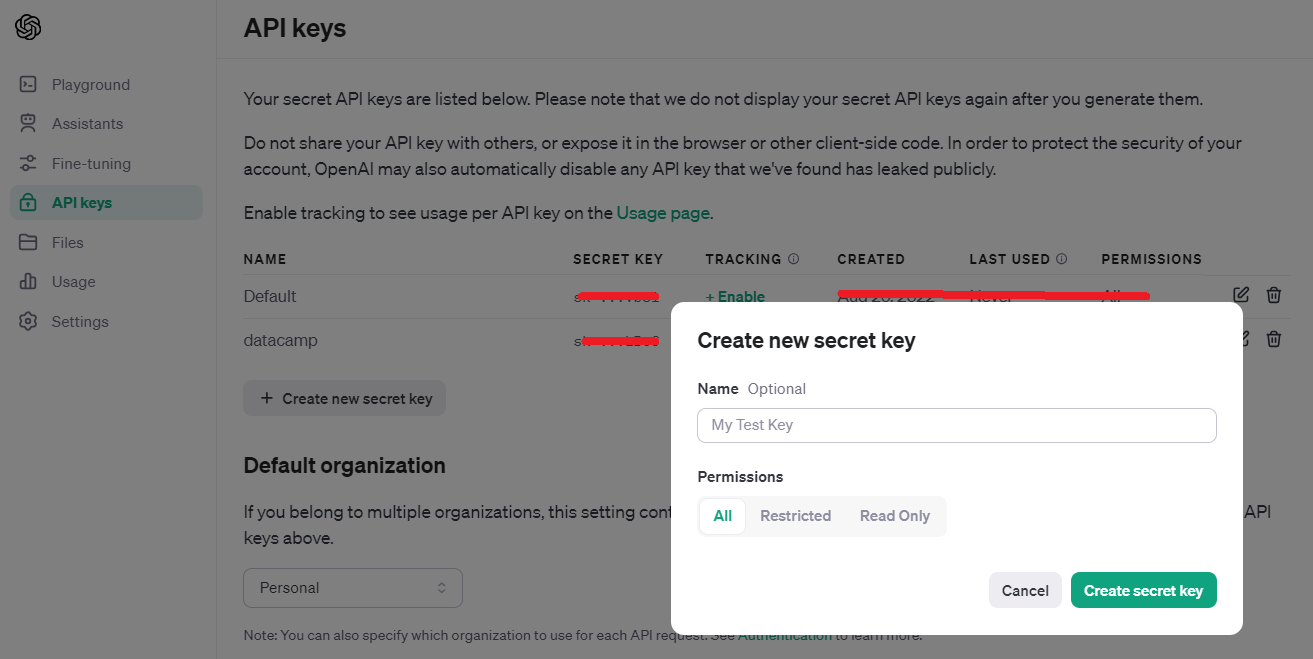
Tras crear tu cuenta de OpenAI, ve a https://platform.openai.com/api-keys
Debes copiar la clave en el momento de generarla porque después no tendrás opción de verla ni copiarla.
En Pinecone, inicia sesión y haz clic en API Keys. Puedes pulsar el botón `Click API Key` en la esquina derecha.
A diferencia de OpenAI, en Pinecone no es imprescindible copiar la clave al generarla porque hay un icono de copiado en la columna Actions que puedes usar cuando quieras.
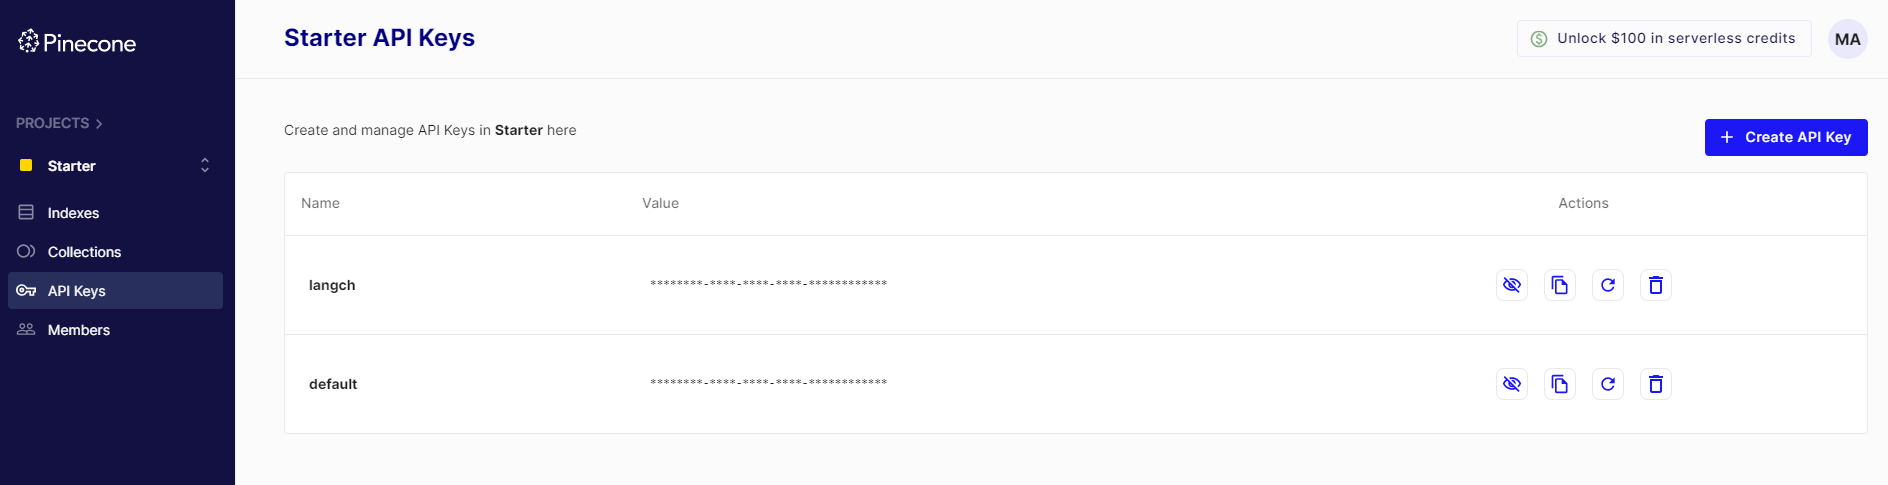
Cuando tengas las API keys de OpenAI y Pinecone, asígnalas a variables en tu Notebook. Alternativamente, puedes usar el módulo `os` de Python para configurarlas como variables de entorno. Si eliges esta opción, ajusta el código de abajo en consecuencia.
OPENAI_API_KEY = '...'
PINECONE_API_KEY = '...'Para seguir este tutorial, instala las siguientes librerías con pip.
!pip install -qU \
  langchain==0.1.1 \
  langchain-community==0.0.13 \
  openai==0.27.7 \
  tiktoken==0.4.0 \
  pinecone-client==3.0.0 \
pinecone-datasets==0.7.0La librería pinecone-datasets ofrece varios datasets de ejemplo ya embebidos con el modelo embedding-ada-002 de OpenAI. Usaremos uno llamado wikipedia-simple-text-embedding-ada-002-100K.
Como su nombre indica, contiene 100.000 documentos. No obstante, en este tutorial muestrearemos solo los primeros 30.000 registros. Aunque no hay impacto en costes porque ya existen embeddings para los 100.000, hacemos el muestreo para acelerar el proceso.
import pinecone_datasets
dataset = pinecone_datasets.load_dataset('wikipedia-simple-text-embedding-ada-002-100K')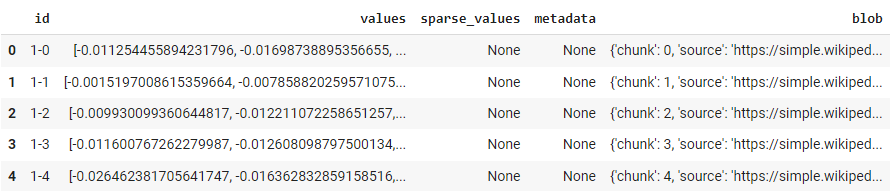
# eliminar la columna metadata y renombrar blob a metadata
dataset.documents.drop(['metadata'], axis=1, inplace=True)
dataset.documents.rename(columns={'blob': 'metadata'}, inplace=True)


# muestrear 30k documentos
dataset.documents.drop(dataset.documents.index[30_000:], inplace=True)from pinecone import Pinecone, ServerlessSpec
# configurar el cliente
pc = Pinecone(api_key=PINECONE_API_KEY)
# configurar especificación serverless
spec = ServerlessSpec(cloud='aws', region='us-west-2')
# comprobar y eliminar el índice si ya existe
index_name = 'langchain-retrieval-augmentation-fast'
if index_name in pc.list_indexes().names():
pc.delete_index(index_name)
# crear un índice nuevo
pc.create_index(
index_name,
dimension=1536, # dimensionalidad de text-embedding-ada-002
metric='dotproduct',
spec=spec
)
Para conectarte al índice y consultar sus estadísticas:
index = pc.Index(index_name)
index.describe_index_stats()
La salida será:
{'dimension': 1536,
 'index_fullness': 0.0,
 'namespaces': {},
 'total_vector_count': 0}
1536 es la dimensión de los embeddings del modelo ada-002. Observa que el recuento de vectores es cero porque aún no hemos insertado datos (vectores).
Insertar datos en el índice langchain-retrieval-augmentation-fast es muy sencillo:
for batch in dataset.iter_documents(batch_size=100):
    index.upsert(batch)
Este comando tardará unos minutos en completarse.
Tras la inserción, también podrás verlo en la interfaz de Pinecone:
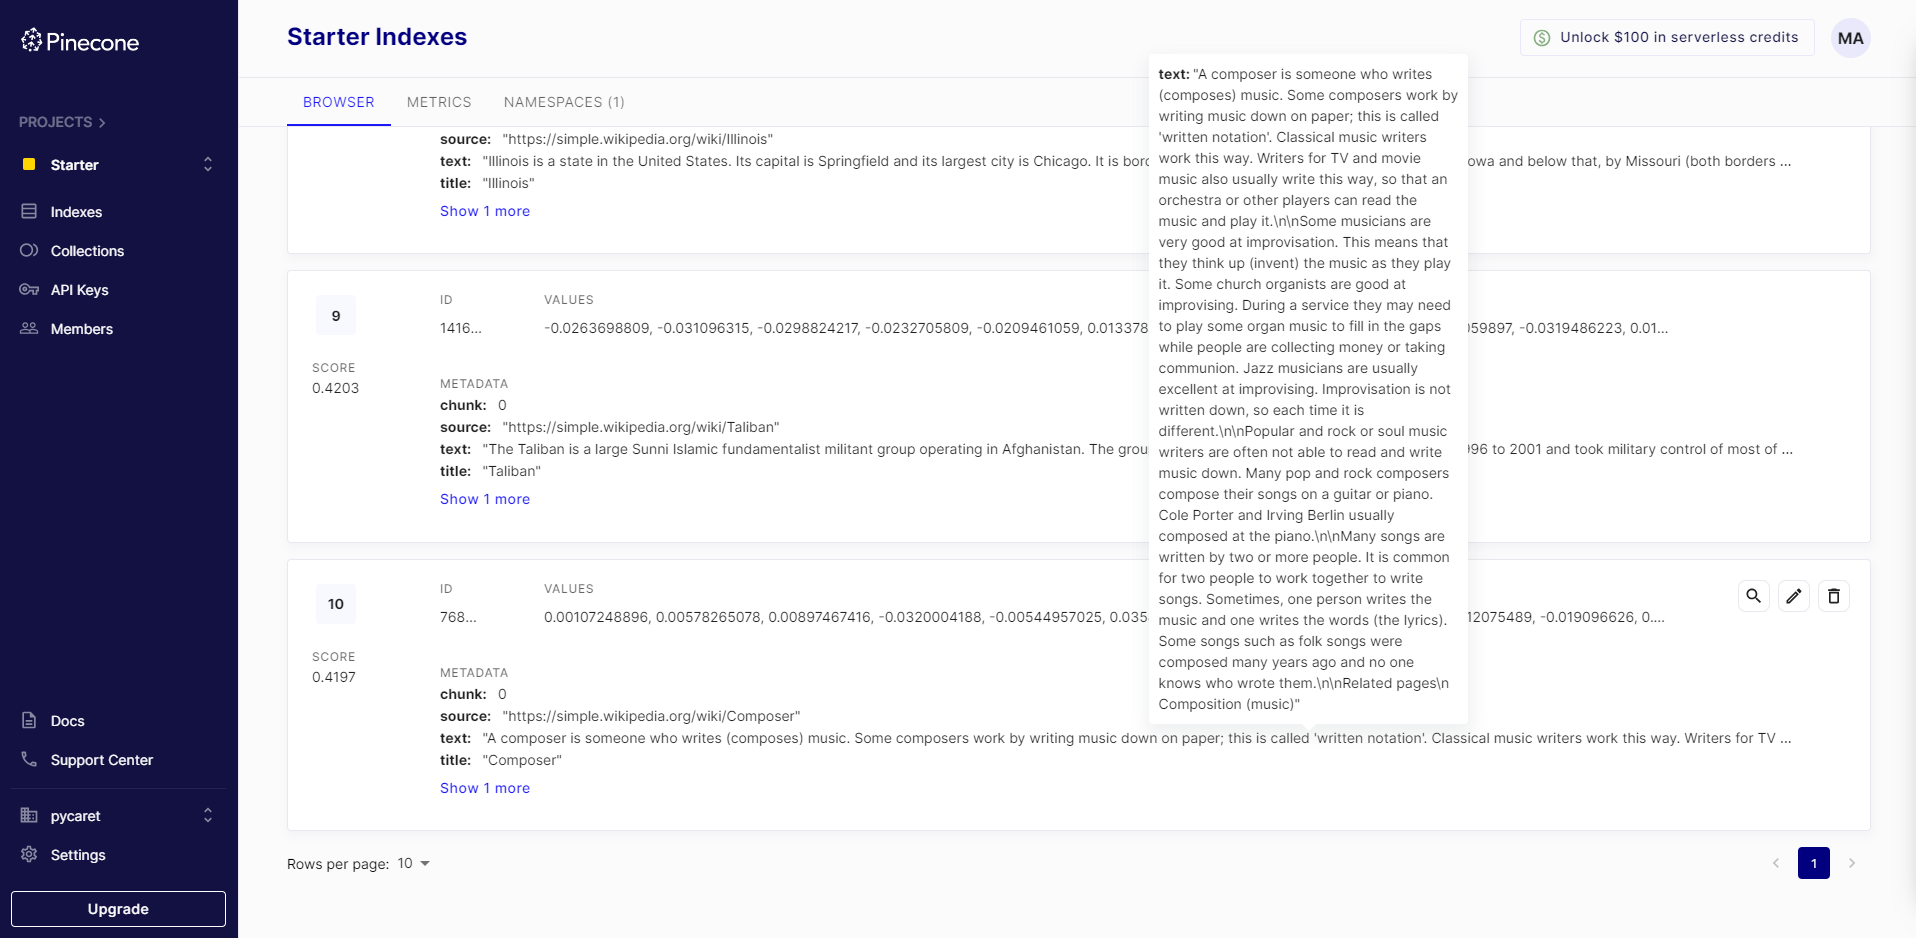
Ahora que hemos creado un índice e insertado datos con la API de Pinecone, pasamos a LangChain. El siguiente paso es inicializar un almacén vectorial de LangChain usando LangChain y el mismo índice que hemos creado.
from langchain.embeddings.openai import OpenAIEmbeddings
model_name = 'text-embedding-ada-002'
embed = OpenAIEmbeddings(model=model_name, openai_api_key=OPENAI_API_KEY)
Para inicializar el vector store:
from langchain.vectorstores import Pinecone
vectorstore = Pinecone(index, embed.embed_query, "text")
Ahora puedes usar el objeto vectorstore para consultar los datos y ver los N mejores resultados:
query = "What is Schizophrenia?"


vectorstore.similarity_search(query, k=3)
La salida es un objeto documento del que puedes extraer fácilmente cadenas, pero en esencia muestra los 3 documentos con mayor coincidencia según la métrica elegida en el paso 4, que en este caso es dotmatrix.
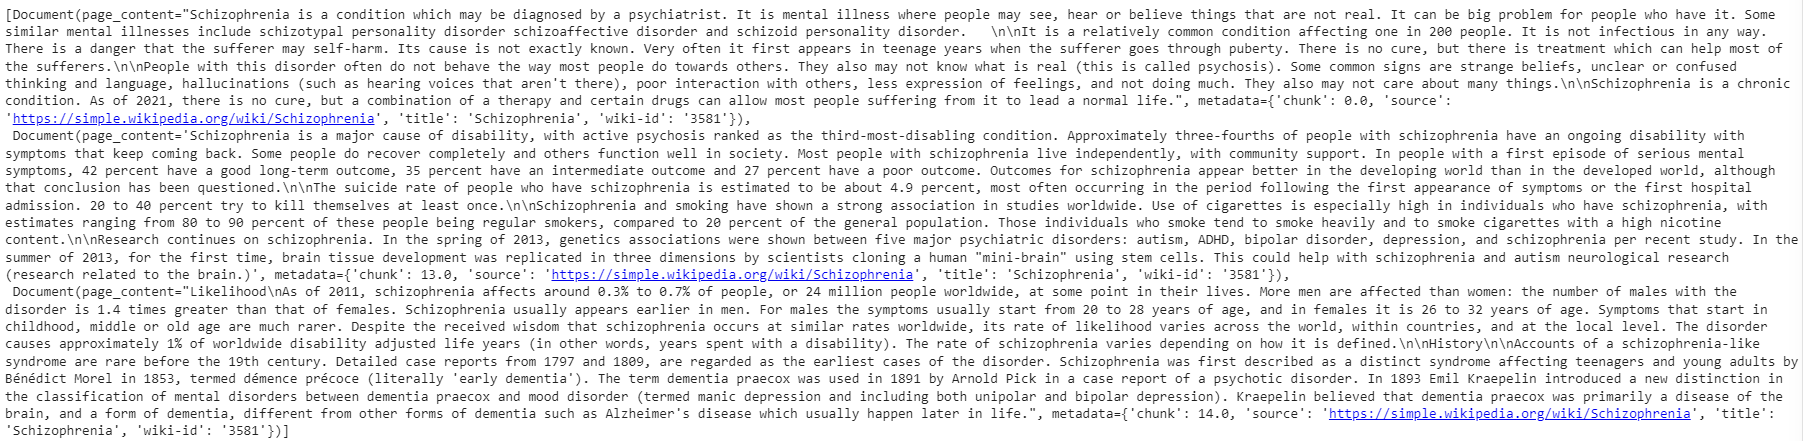
Este es el último paso de nuestra aplicación. Ahora queremos envolverlo con un LLM. Para ello, importa las clases ChatOpenAI y RetrievalQA de LangChain.
from langchain.chat_models import ChatOpenAI
from langchain.chains import RetrievalQA


# modelo de completado
llm = ChatOpenAI(
    openai_api_key=OPENAI_API_KEY,
    model_name='gpt-4',
    temperature=0.0
)


qa = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa.run(query)
La salida de qa.run(query) es la respuesta del modelo de lenguaje.
Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It often first appears in teenage years and is a chronic condition....Esta respuesta procede de uno de los documentos del `dataset`. Si también quieres obtener la fuente (algo habitual en aplicaciones RAG), debes hacer un pequeño cambio en el código anterior.
from langchain.chains import RetrievalQAWithSourcesChain


qa_with_sources = RetrievalQAWithSourcesChain.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=vectorstore.as_retriever()
)


qa_with_sources(query)
Salida:
{'question': 'What is Schizophrenia?',
 'answer': 'Schizophrenia is a mental illness where people may see, hear or believe things that are not real. It is a relatively common condition ...',
 'sources': 'https://simple.wikipedia.org/wiki/Schizophrenia'}
Observa que ahora la salida es un diccionario en el que puedes encontrar la `source`.
En este blog hemos explorado una de las aplicaciones más populares de los LLM, la técnica Retrieval Augmented Generation (RAG), y cómo mejora la fiabilidad y la relevancia de las respuestas de los chatbots basados en modelos como GPT-4.
La evolución de los chatbots desde sistemas sencillos basados en reglas hasta agentes conversacionales avanzados impulsados por IA supone un salto tecnológico notable. Los LLM aportan un nuevo nivel de versatilidad e inteligencia, capaces de mantener conversaciones más naturales y con mayor contexto.
También hemos visto el papel de las bases de datos vectoriales, con foco en Pinecone, para almacenar y recuperar vectores de alta dimensión. Son fundamentales para implementar RAG.
La implementación práctica se ha mostrado con ejemplos de código, aprovechando las API de OpenAI y Pinecone y el framework LangChain en Python. Estas herramientas simplifican el desarrollo y permiten a los equipos crear chatbots con IA, adaptados a múltiples aplicaciones, de forma rápida y eficiente.
Si quieres aprender más sobre Vector Databases for Embeddings with Pinecone o sobre trabajar con la API de OpenAI, echa un vistazo a nuestros cursos para ampliar tus conocimientos.
¡Empieza hoy tu camino en IA!
Curso
Curso
Tutorial
Moez Ali
11 min
Tutorial
Richie Cotton
14 min
Tutorial
Arunn Thevapalan
13 min
Tutorial
Tutorial
Moez Ali
9 min
Tutorial
Zoumana Keita
7 min