programa
Fundamentos de la IA
10 h
Edo Liberty fue director de investigación en AWS y Yahoo. No tardó en darse cuenta del enorme potencial de combinar modelos de inteligencia artificial (IA) con la búsqueda vectorial para mejorar notablemente aplicaciones como los sistemas de recomendación y los detectores de spam.
A medida que profundizaba en su trabajo con sistemas de búsqueda vectorial personalizados a gran escala, observó que no había una solución empaquetada para quienes no contaban con los mismos recursos de ingeniería y ciencia de datos que AWS y Yahoo. Así que, en 2019, fundó Pinecone y nació la base de datos vectorial.
El objetivo de Pinecone era ofrecer la infraestructura crítica de almacenamiento y recuperación necesaria para desarrollar y ejecutar aplicaciones de IA de vanguardia. Según Pinecone, su principio fundacional fue «hacer que la solución sea accesible para equipos de ingeniería de todos los tamaños y con cualquier nivel de experiencia en IA».
El resultado es el servicio totalmente gestionado y fácil de usar que es hoy Pinecone. Cuatro años después, llega Pinecone Canopy, un framework que utiliza Retrieval Augmented Generation (RAG) para que los desarrolladores creen aplicaciones de IA generativa sin complicaciones.
En el resto de este tutorial, profundizaremos en:
La documentación de Canopy lo describe como «un framework open source de Retrieval Augmented Generation (RAG) y contexto, construido sobre la base de datos vectorial de Pinecone.»
Ten en cuenta que RAG es un framework de IA avanzado presentado por Meta (entonces Facebook) AI Research en 2020. Utilizando datos dinámicos y específicos del dominio, RAG ayuda a optimizar la salida de los modelos de lenguaje grandes (LLM) sin necesidad de reentrenarlos.
Canopy se encarga de todas las tareas más laboriosas a la hora de desarrollar aplicaciones RAG. Esto incluye gestionar historiales de chat, fragmentar y crear embeddings de texto, optimizar consultas, recuperar contexto (incluido el prompt engineering) y generar respuestas aumentadas.
Así, los desarrolladores pueden experimentar y crear aplicaciones RAG con Canopy de forma rápida y sencilla. Según la entrada del blog de lanzamiento en noviembre de 2023, «con Canopy, puedes tener una aplicación con RAG lista para producción funcionando en menos de una hora. Y, como está construida y respaldada por Pinecone, disfrutarás de la misma gran experiencia para desarrolladores y el rendimiento de nuestra base de datos vectorial totalmente gestionada.»
Para los desarrolladores que quieran experimentar con RAG, Canopy ofrece una solución:
Puedes almacenar hasta 100.000 embeddings en Pinecone sin coste. Esto equivale aproximadamente a 15 millones de palabras o 30.000 páginas de texto. Además, la entrada de lanzamiento indica que «pronto habrá opciones gratuitas para modelos de embedding y LLMs».
Los datos de texto pueden estar en JSONL, Parquet o texto plano, y Canopy se encarga del resto. Próximamente se añadirá compatibilidad con PDF. Cualquier LLM de OpenAI, incluido GPT-4 Turbo, es compatible con Canopy. Muy pronto se añadirán otros LLMs y modelos de embeddings, incluidos conocidos modelos open source desde Anyscale Endpoints. Si quieres convertir tus datos de texto a formato JSONL, puedes usar el notebook de Pinecone.
Puedes crear con rapidez, precisión y fiabilidad aplicaciones de IA generativa listas para producción, respaldadas por la base de datos vectorial de Pinecone.
La librería de Canopy puede usarse para crear aplicaciones a medida. También puedes ejecutar Canopy como servicio web o aplicación a través de una sencilla API REST. Además, se puede añadir a aplicaciones existentes de OpenAI sustituyendo la Chat Completions API por el endpoint del servidor de Canopy.
La CLI de Canopy permite interactuar con datos de texto mediante comandos sencillos. Esto facilita comparar flujos de trabajo con y sin RAG para evaluar de forma interactiva los resultados aumentados antes de pasar a producción.
Empezar con Pinecone Canopy es bastante directo. Antes de nada, debes registrarte en Standard o Enterprise. A los usuarios nuevos se les conceden 100 $ en créditos serverless para trastear y familiarizarse con la herramienta.
Si no quieres facilitar una tarjeta de crédito, puedes crear un índice gratuito basado en pods.
Una vez tengas la cuenta, ya puedes empezar…
Instala el paquete de Canopy con:
pip install canopy-sdkSi prefieres hacerlo en un entorno virtual, ejecuta este comando antes de instalar el paquete:
python3 -m venv canopy-env
source canopy-env/bin/activate
Esto crea un entorno virtual y lo activa. Consulta nuestro tutorial Virtual Environment in Python para saber más sobre cómo funcionan.
A continuación, debes configurar tus variables de entorno. Para ello, necesitarás varias claves de API.
Para encontrar tu PINECONE_API_KEY, simplemente:
Otras variables de entorno obligatorias son:
OPENAI_API_KEY → se usa para autenticarte en los servicios de OpenAI para la API de embeddings y chat. Encuéntrala aquí. Es posible que debas iniciar sesión o registrarte en OpenAI antes.INDEX_NAME → nombre del índice de Pinecone con el que trabajará Canopy (hablaremos de ello más adelante).CANOPY_CONFIG_FILE → ruta al archivo de configuración yaml que usará el servidor de Canopy. Si no se indica, se utilizará la configuración por defecto.Así configuras tus variables de entorno: ejecuta este comando en tu terminal:
export PINECONE_API_KEY="<PINECONE_API_KEY>"
export OPENAI_API_KEY="<OPENAI_API_KEY>"
export CANOPY_CONFIG_FILE="<CANOPY_CONFIG_FILE >"
export INDEX_NAME="<INDEX_NAME>"Si has seguido los pasos hasta aquí, Canopy debería estar instalado en tu sistema.
Para confirmarlo, ejecuta:
canopy Deberías ver algo como:
Canopy: Ready

Usage: canopy [OPTIONS] COMMAND [ARGS]...
# rest of the help message
Ya estás listo para empezar tu primer proyecto con Pinecone Canopy.
En Pinecone, los embeddings vectoriales se almacenan en los índices, la unidad organizativa de mayor nivel para datos vectoriales en la plataforma. Aceptan y almacenan vectores, atienden consultas sobre los vectores que contienen y realizan otras operaciones vectoriales sobre su contenido.
Cuando usas Canopy, debes crear un nuevo índice de Pinecone configurado para funcionar con Canopy. Hazlo ejecutando:
canopy newDespués, sigue las instrucciones de la CLI.
El índice creado tendrá el prefijo canopy--<INDEX_NAME>.
Solo tienes que hacer este proceso una vez por cada índice de Canopy que quieras crear.
Con el índice creado, ya puedes cargar datos en tu índice de Canopy.
Estas son algunas formas de hacerlo, según tus datos:
canopy upsert /path/to/data_directory
# o
canopy upsert /path/to/data_directory/file.parquet
# o
canopy upsert /path/to/data_directory/file.jsonl
# o
canopy upsert /path/to/directory_of_txt_files/
# ...
Según la documentación, «Canopy es compatible con archivos en formatos jsonl, parquet y csv. Además, puedes cargar archivos de texto plano en formato .txt. En ese caso, cada archivo se tratará como un único documento. El ID del documento será el nombre de archivo y la fuente será la ruta completa del archivo.»
Fíjate en el uso del comando upsert. La operación upsert escribe registros en un namespace del índice. Si un ID de registro ya existe, la operación upsert sobrescribe el registro completo.
Si quieres hacer cambios parciales, utiliza la operación update para modificar parte de un registro.
El servidor de Canopy expone sus funcionalidades mediante una API REST. En concreto, te permite conversar con tus datos, subir documentos y obtener documentos relevantes para una consulta concreta. Cualquier aplicación de chat puede conectarse fácilmente al endpoint /chat.completion del servidor.
Para iniciar el servidor, ejecuta:
canopy startVerás el mensaje estándar de Uvicorn:
...

INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
Cuando aparezca ese mensaje, ya puedes empezar a usar el servidor de Canopy con cualquier aplicación de chat que admita un endpoint /chat.completion.
Canopy se distribuye como servicio web (a través del servidor de Canopy) y como librería para crear aplicaciones personalizadas. La librería consta de tres componentes, o clases, que pueden usarse por separado o como un paquete completo. Cada componente se encarga de una parte concreta del flujo de trabajo RAG:
La Knowledge Base prepara los datos para el flujo de trabajo RAG. El texto de entrada se fragmenta automáticamente y se transforma en embeddings antes de hacerse upsert en la base de datos vectorial de Pinecone.
El Context Engine se ocupa de la parte de «recuperación» de RAG. Con la Knowledge Base, localiza los documentos más pertinentes en Pinecone y los organiza en un contexto para usarlos como prompt de un LLM.
El Canopy Chat Engine implementa todo el flujo de trabajo RAG. Entiende el historial de chat, reconoce preguntas con varias partes, genera varias consultas relevantes a partir de un único prompt y las convierte en embeddings. Con ello, el usuario recibe una respuesta altamente pertinente gracias al contexto generado para el LLM mediante el Context Engine.
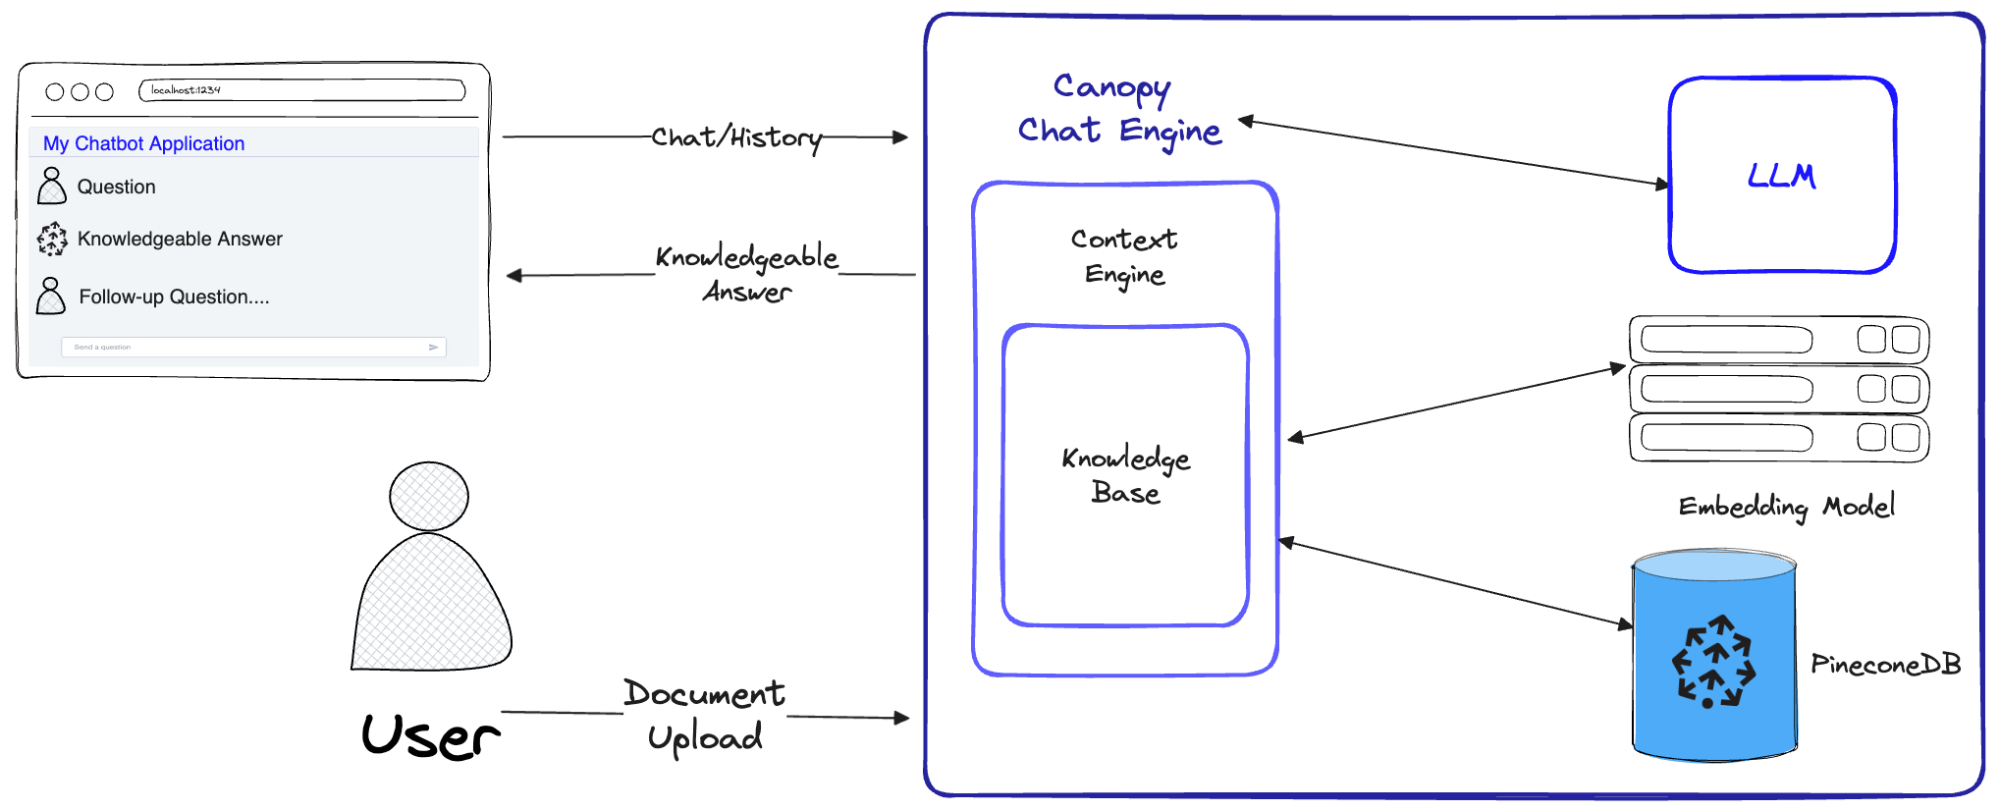
Diagrama que muestra cómo el Canopy Chat Engine implementa todo el flujo de trabajo RAG. Fuente: Introducing Canopy: An easy, free, and flexible RAG framework powered by Pinecone
Los usuarios de Canopy pueden aprovechar Pinecone para escalar sus índices en vertical u horizontal. El escalado vertical (scale up) aporta más recursos de cómputo, y el escalado horizontal (scale out) añade más máquinas para distribuir la carga.
Otra función avanzada es la partición de registros de un índice en namespaces. Esto limita las consultas y otras operaciones a un namespace, de modo que distintas peticiones pueden buscar en subconjuntos diferentes de tu índice.
Por ejemplo, puedes definir un namespace para indexar canciones por género y otro para indexarlas por año de lanzamiento. Aquí tienes un tutorial detallado de cómo hacerlo.
Por último, está el upsert por lotes. La operación upsert permite escribir un registro en un namespace. Sin embargo, cuando subes grandes volúmenes de datos, la documentación indica que «realices upsert de los registros en lotes de 100 o menos en varias solicitudes de upsert.»
Un ejemplo:
# Source: https://docs.pinecone.io/docs/upsert-data
import random
import itertools
from pinecone import Pinecone

pc = Pinecone(api_key="YOUR_API_KEY")
index = pc.Index("pinecone-index")

def chunks(iterable, batch_size=100):
    """A helper function to break an iterable into chunks of size batch_size."""
    it = iter(iterable)
    chunk = tuple(itertools.islice(it, batch_size))
    while chunk:
        yield chunk
        chunk = tuple(itertools.islice(it, batch_size))

vector_dim = 128
vector_count = 10000

# Example generator that generates many (id, vector) pairs
example_data_generator = map(lambda i: (f'id-{i}', [random.random() for _ in range(vector_dim)]), range(vector_count))

# Upsert data with 100 vectors per upsert request
for ids_vectors_chunk in chunks(example_data_generator, batch_size=100):
index.upsert(vectors=ids_vectors_chunk) Aunque los LLMs son un gran avance, tienen un defecto importante: pueden inventarse información. RAG permite aumentar su utilidad proporcionándoles contexto veraz que utilizar al responder.
Una técnica que puedes probar es el chunking para optimizar los flujos RAG en rendimiento y precisión. Es un componente fundamental al desarrollar sistemas RAG, pero frameworks como Canopy suelen abstraer este proceso para que no tengas que preocuparte. Aun así, el tamaño de los fragmentos importa y conviene ajustarlo para mejorar el rendimiento de tu RAG. Consulta esta entrada del blog de Pinecone para conocer métodos de chunking.
Canopy de Pinecone simplifica la creación de aplicaciones RAG al encargarse de las tareas más pesadas del desarrollo: gestionar historiales de chat, fragmentar y crear embeddings de texto, optimizar consultas, recuperar contexto (incluido el prompt engineering) y generar respuestas aumentadas. Así, cualquiera que quiera crear y experimentar con RAG lo tiene mucho más fácil para empezar.
En este tutorial, hemos repasado todo lo necesario para empezar a experimentar y crear aplicaciones RAG. Los desarrolladores de Canopy prometen que puedes tener una aplicación con RAG lista para producción en menos de una hora. Pruébalo tú mismo.
Para seguir aprendiendo, echa un vistazo a:
¡Empieza hoy tu camino en IA!
programa
Curso
blog
Abid Ali Awan
10 min
Tutorial
Ryan Ong
12 min
Tutorial
Zoumana Keita
7 min
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
15 min
Tutorial
Arunn Thevapalan
15 min