Curso
Introdução ao R
4 h
3.1M
Execute e edite o código deste tutorial online
Executar códigoNeste guia, vamos abordar tanto as propriedades matemáticas dos métodos quanto exemplos práticos em R, além de alguns macetes extras. Sem enrolação, vamos começar!
Vamos pelo começo: o modelo de regressão linear simples, em que você quer prever n observações da variável resposta, Y, com uma combinação linear de m variáveis preditoras, X, e um termo de erro normalmente distribuído com variância σ2:
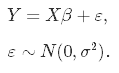
Como não conhecemos os parâmetros verdadeiros, β, precisamos estimá-los a partir da amostra. No método de Mínimos Quadrados Ordinários (OLS), estimamos $\hat\beta$ de modo que a soma dos quadrados dos resíduos seja a menor possível. Em outras palavras, minimizamos a seguinte função de perda:
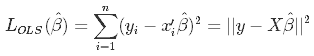
para obter as estimativas OLS, $\hat\beta_{OLS} = (X'X)^{-1}(X'Y)$.
Em estatística, duas características dos estimadores são cruciais: viés e variância. O viés é a diferença entre o parâmetro populacional verdadeiro e o valor esperado do estimador:
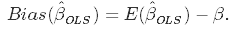
Ele mede a acurácia das estimativas. Já a variância mede a dispersão, ou incerteza, dessas estimativas. É dada por
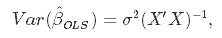
em que a variância do erro desconhecida σ2 pode ser estimada a partir dos resíduos como
Este gráfico ilustra o que são viés e variância. Imagine que o alvo é o parâmetro populacional verdadeiro que estamos estimando, β, e os tiros são os valores das nossas estimativas resultantes de quatro estimadores diferentes — baixo viés e variância, alto viés e variância e suas combinações.
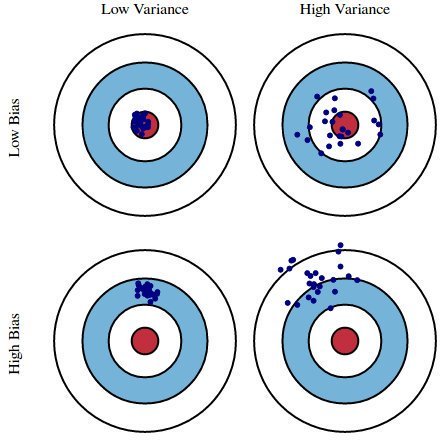
Fonte: kdnuggets.com
Queremos tanto o viés quanto a variância baixos, pois valores altos resultam em previsões ruins. Na prática, o erro do modelo pode ser decomposto em três partes: erro decorrente da variância, erro decorrente do viés e o restante — a parcela não explicável.
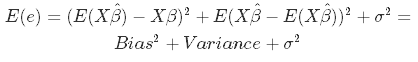
O estimador OLS é não viesado, o que é desejável. Porém, ele pode ter variância enorme. Isso acontece, em especial, quando:
A solução geral é: reduzir a variância ao custo de introduzir algum viés. Essa estratégia é chamada de regularização e quase sempre melhora o desempenho preditivo do modelo. Para fixar a ideia, veja o gráfico a seguir.
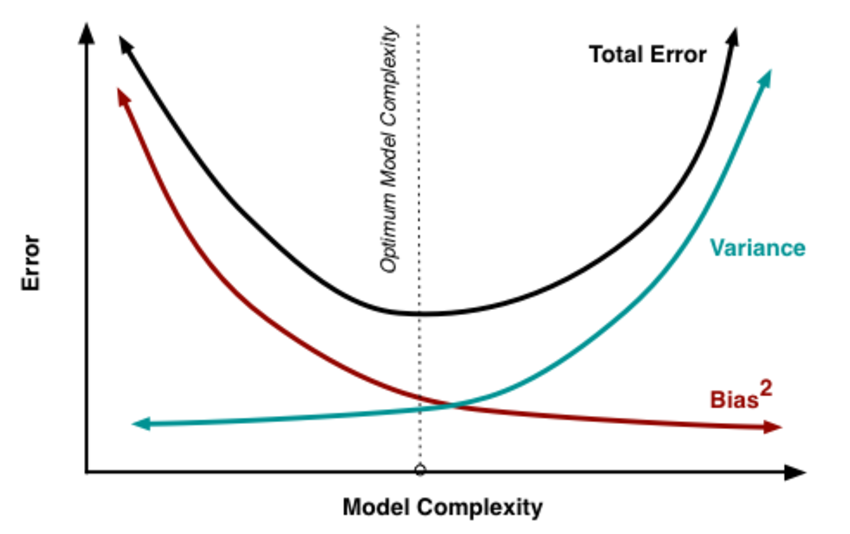
Fonte: researchgate.net
À medida que a complexidade do modelo — que na regressão linear pode ser vista como o número de preditores — aumenta, a variância das estimativas também cresce, enquanto o viés diminui. O OLS não viesado nos colocaria no lado direito da figura, longe do ideal. Por isso regularizamos: para reduzir a variância ao custo de um pouco de viés, movendo-nos para a esquerda, em direção ao ótimo.
Pelo que vimos, queremos diminuir a complexidade do modelo, isto é, o número de preditores. Poderíamos usar seleção forward ou backward, mas assim perderíamos a noção do efeito das variáveis removidas. Remover preditores equivale a zerar seus coeficientes. Em vez de forçar exatamente zero, vamos penalizar quando eles se afastam de zero, encolhendo-os de forma contínua. Assim, reduzimos a complexidade mantendo todas as variáveis no modelo. Basicamente, é isso que a regressão Ridge faz.
Na regressão Ridge, ampliamos a função de perda do OLS para não só minimizar a soma dos resíduos ao quadrado, mas também penalizar o tamanho das estimativas dos parâmetros, encolhendo-os em direção a zero:
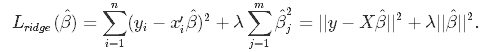
Resolvendo para $\hat\beta$, obtemos as estimativas ridge $\hat\beta_{ridge} = (X'X+\lambda I)^{-1}(X'Y)$, em que I é a matriz identidade.
O parâmetro λ é a penalidade de regularização. Vamos ver como escolher seu valor nas próximas seções, mas por ora note que:
Ou seja, definir λ como 0 é o mesmo que usar OLS; quanto maior λ, mais forte é a penalização do tamanho dos coeficientes.
Ao incluir o coeficiente de regularização nas fórmulas de viés e variância, temos:
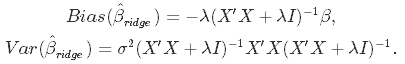
Daí vemos que à medida que λ aumenta, a variância diminui e o viés aumenta. Surge a questão: quanto viés aceitamos para reduzir a variância? Ou: qual é o valor ótimo de λ?
Há duas formas de lidar com isso. A mais tradicional é escolher λ que minimize algum critério de informação, como AIC ou BIC. Uma abordagem mais de machine learning é fazer validação cruzada e selecionar o λ que minimiza a soma dos quadrados dos resíduos validados (ou outra métrica). A primeira enfatiza o ajuste do modelo aos dados; a segunda, o desempenho preditivo. Vamos ver ambas.
Minimizando critérios de informação
Nesse caminho, estimamos o modelo para vários valores de λ e escolhemos aquele que minimiza o AIC ou o BIC:
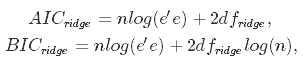
em que dfridge é o número de graus de liberdade. Atenção aqui! Os graus de liberdade na regressão ridge são diferentes do OLS comum! Isso costuma ser ignorado e leva a inferências erradas. Em OLS e em ridge, os graus de liberdade são o traço da chamada matriz chapéu (hat matrix), que mapeia o vetor de respostas para o vetor de ajustados: $\hat y = H y$.
Em OLS, HOLS = X(X′X)−1X, o que dá dfOLS = trHOLS = m, sendo m o número de preditores. Já na ridge, a matriz chapéu inclui a penalização: Hridge = X(X′X + λI)−1X, o que dá dfridge = trHridge, que não é mais igual a m. Alguns softwares de ridge calculam os critérios de informação usando a fórmula do OLS. Para garantir, é mais seguro computá-los manualmente, como faremos adiante.
Minimizando resíduos via validação cruzada
Para escolher λ por validação cruzada, selecione um conjunto de P valores de λ, divida o conjunto em K folds e siga este algoritmo:
Claro, você não precisa programar isso do zero — o R já traz funções prontas.
No R, o pacote glmnet tem tudo para implementar ridge. Vamos usar o famoso conjunto mtcars como exemplo, prevendo milhas por galão a partir de outras características do carro. Um detalhe importante: a regressão ridge assume preditores padronizados e resposta centralizada! Já já você verá por quê. Por enquanto, vamos padronizar antes de modelar.
# Load libraries, get data & set seed for reproducibility ---------------------
set.seed(123)    # seef for reproducibility
library(glmnet)  # for ridge regression
library(dplyr)   # for data cleaning
library(psych)   # for function tr() to compute trace of a matrix

data("mtcars")
# Center y, X will be standardized in the modelling function
y <- mtcars %>% select(mpg) %>% scale(center = TRUE, scale = FALSE) %>% as.matrix()
X <- mtcars %>% select(-mpg) %>% as.matrix()


# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 0 implements ridge regression
ridge_cv <- cv.glmnet(X, y, alpha = 0, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(ridge_cv)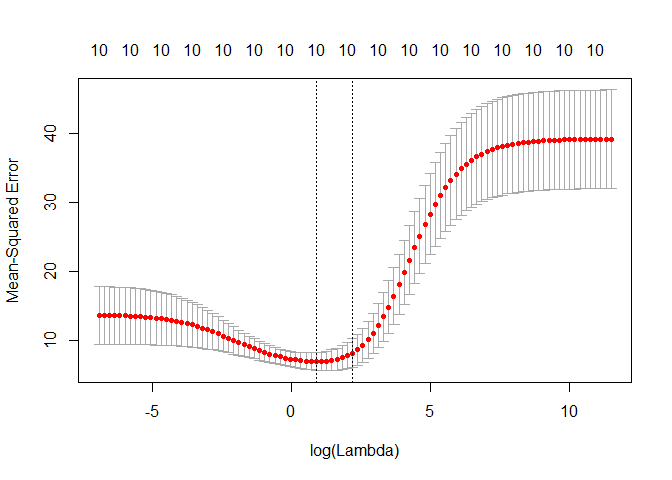
# Best cross-validated lambda
lambda_cv <- ridge_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 0, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_ridge_cv <- cor(y, y_hat_cv)^2


# Use information criteria to select lambda -----------------------------------
X_scaled <- scale(X)
aic <- c()
bic <- c()
for (lambda in seq(lambdas_to_try)) {
  # Run model
  model <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try[lambda], standardize = TRUE)
  # Extract coefficients and residuals (remove first row for the intercept)
  betas <- as.vector((as.matrix(coef(model))[-1, ]))
  resid <- y - (X_scaled %*% betas)
  # Compute hat-matrix and degrees of freedom
  ld <- lambdas_to_try[lambda] * diag(ncol(X_scaled))
  H <- X_scaled %*% solve(t(X_scaled) %*% X_scaled + ld) %*% t(X_scaled)
  df <- tr(H)
  # Compute information criteria
  aic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df
  bic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df * log(nrow(X_scaled))
}

# Plot information criteria against tried values of lambdas
plot(log(lambdas_to_try), aic, col = "orange", type = "l",
     ylim = c(190, 260), ylab = "Information Criterion")
lines(log(lambdas_to_try), bic, col = "skyblue3")
legend("bottomright", lwd = 1, col = c("orange", "skyblue3"), legend = c("AIC", "BIC"))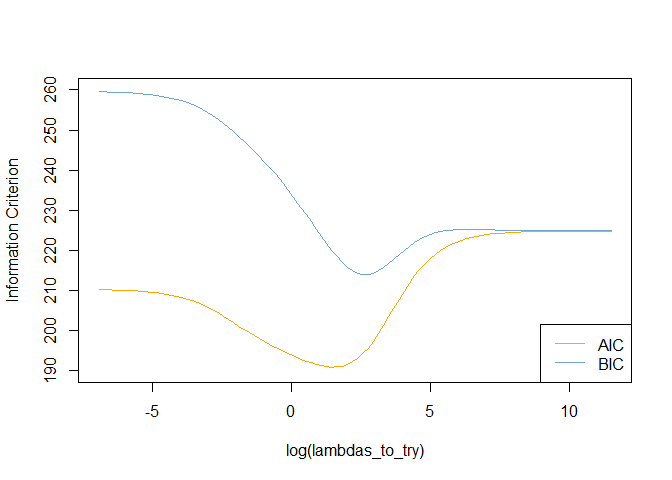
# Optimal lambdas according to both criteria
lambda_aic <- lambdas_to_try[which.min(aic)]
lambda_bic <- lambdas_to_try[which.min(bic)]

# Fit final models, get their sum of squared residuals and multiple R-squared
model_aic <- glmnet(X, y, alpha = 0, lambda = lambda_aic, standardize = TRUE)
y_hat_aic <- predict(model_aic, X)
ssr_aic <- t(y - y_hat_aic) %*% (y - y_hat_aic)
rsq_ridge_aic <- cor(y, y_hat_aic)^2

model_bic <- glmnet(X, y, alpha = 0, lambda = lambda_bic, standardize = TRUE)
y_hat_bic <- predict(model_bic, X)
ssr_bic <- t(y - y_hat_bic) %*% (y - y_hat_bic)
rsq_ridge_bic <- cor(y, y_hat_bic)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)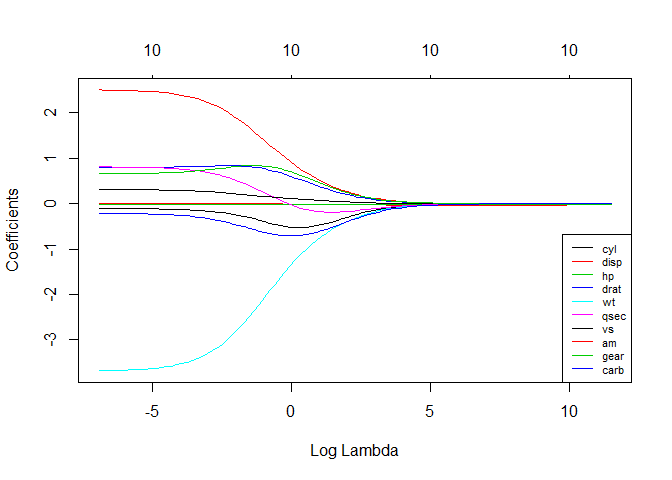
Mencionei que a ridge assume preditores escalados para z-scores. Por quê? Essa padronização garante que a penalidade trate todos os coeficientes igualmente, tomando a forma $\lambda \sum_{j=1}^m\hat\beta_j^2$. Se os preditores não estiverem padronizados, seus desvios-padrão não serão 1 e, com alguma álgebra, isso resulta numa penalidade $\lambda \sum_{j=1}^m\hat\beta_j^2/std(x_j)$. Ou seja, os coeficientes não padronizados ficam ponderados pelo inverso do desvio-padrão de cada preditor. Para evitar isso, escalamos a matriz X, mas... Em vez de corrigir a heterocedasticidade igualando as variâncias via escala, poderíamos usá-las como pesos no processo de estimação! Essa é a ideia por trás da Regressão Ridge diferentemente ponderada ou heterocedástica.
A proposta é penalizar coeficientes com forças diferentes, introduzindo pesos na função de perda:
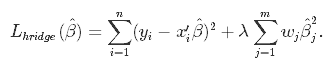
Como escolher os pesos wj? Rode regressões univariadas (resposta vs. um preditor) para todos os preditores, extraia a estimativa da variância do coeficiente, $\hat\sigma_{j}$, e use-a como peso! Assim:
Veja como fazer isso em R. Como esse método não está no glmnet, precisamos programar um pouco.
# Calculate the weights from univariate regressions
weights <- sapply(seq(ncol(X)), function(predictor) {
  uni_model <- lm(y ~ X[, predictor])
  coeff_variance <- summary(uni_model)$coefficients[2, 2]^2
})


# Heteroskedastic Ridge Regression loss function - to be minimized
hridge_loss <- function(betas) {
  sum((y - X %*% betas)^2) + lambda * sum(weights * betas^2)
}


# Heteroskedastic Ridge Regression function
hridge <- function(y, X, lambda, weights) {
  # Use regular ridge regression coefficient as initial values for optimization
  model_init <- glmnet(X, y, alpha = 0, lambda = lambda, standardize = FALSE)
  betas_init <- as.vector(model_init$beta)
  # Solve optimization problem to get coefficients
  coef <- optim(betas_init, hridge_loss)$par
  # Compute fitted values and multiple R-squared
  fitted <- X %*% coef
  rsq <- cor(y, fitted)^2
  names(coef) <- colnames(X)
  output <- list("coef" = coef,
                 "fitted" = fitted,
                 "rsq" = rsq)
  return(output)
}


# Fit model to the data for lambda = 0.001
hridge_model <- hridge(y, X, lambda = 0.001, weights = weights)
rsq_hridge_0001 <- hridge_model$rsq

# Cross-validation or AIC/BIC can be employed to select some better lambda!
# You can find some useful functions for this at https://github.com/MichalOleszak/momisc/blob/master/R/hridge.RLasso, ou Least Absolute Shrinkage and Selection Operator, é conceitualmente parecida com ridge. Também adiciona uma penalidade para coeficientes diferentes de zero, mas, ao contrário da ridge — que penaliza a soma dos quadrados dos coeficientes (penalidade L2) —, a lasso penaliza a soma dos valores absolutos (penalidade L1). Como resultado, para valores altos de λ, muitos coeficientes viram exatamente zero na lasso — o que não ocorre na ridge.
A única diferença entre as funções de perda de ridge e lasso está no termo de penalidade. Em lasso, a perda é definida como:
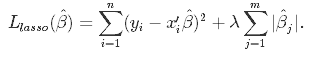
Para rodar Lasso, você pode reutilizar a função glmnet(), mas com o parâmetro alpha igual a 1.
# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 1 implements lasso regression
lasso_cv <- cv.glmnet(X, y, alpha = 1, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(lasso_cv)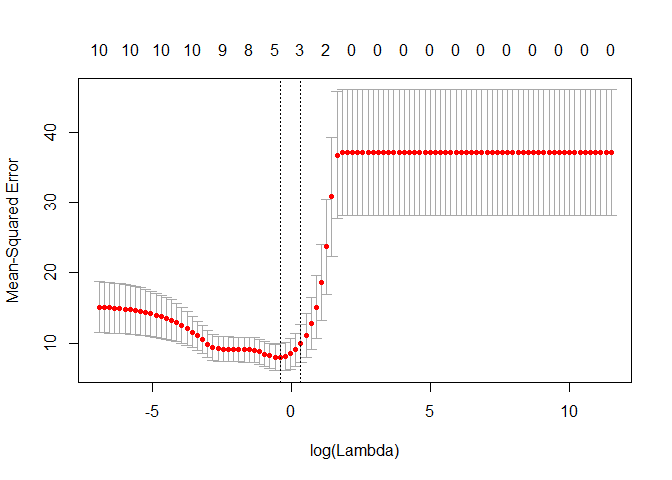
# Best cross-validated lambda
lambda_cv <- lasso_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 1, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_lasso_cv <- cor(y, y_hat_cv)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 1, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)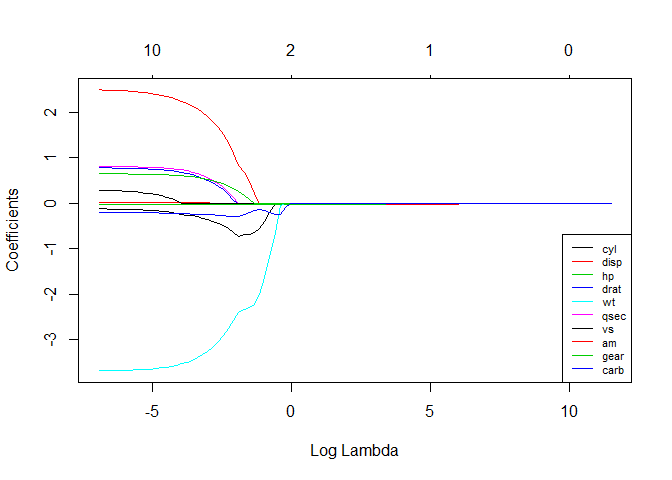
Vamos comparar o R-quadrado múltiplo dos modelos que estimamos!
rsq <- cbind("R-squared" = c(rsq_ridge_cv, rsq_ridge_aic, rsq_ridge_bic, rsq_hridge_0001, rsq_lasso_cv))
rownames(rsq) <- c("ridge cross-validated", "ridge AIC", "ridge BIC", "hridge 0.001", "lasso cross_validated")
print(rsq)

##                       R-squared
## ridge cross-validated 0.8536968
## ridge AIC             0.8496310
## ridge BIC             0.8412011
## hridge 0.001          0.7278277
## lasso cross_validated 0.8426777
Parecem ter desempenho semelhante neste conjunto. Lembre que o modelo heterocedástico não foi ajustado (lambda não ótimo)! Algumas considerações gerais sobre ridge e lasso:
Elastic Net surgiu como crítica à lasso, cuja seleção de variáveis pode depender demais dos dados e ser instável. A solução é combinar as penalidades de ridge e lasso para ter o melhor dos dois mundos. Elastic Net minimiza a seguinte função de perda:
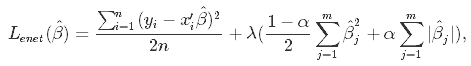
em que α é o parâmetro de mistura entre ridge (α = 0) e lasso (α = 1).
Agora temos dois parâmetros para ajustar: λ e α. O pacote glmnet permite ajustar λ por validação cruzada para um &alpha fixo, mas não ajusta α; para isso usamos o caret.
library(caret)

# Set training control
train_control <- trainControl(method = "repeatedcv",
                              number = 5,
                              repeats = 5,
                              search = "random",
                              verboseIter = TRUE)

# Train the model
elastic_net_model <- train(mpg ~ .,
                           data = cbind(y, X),
                           method = "glmnet",
                           preProcess = c("center", "scale"),
                           tuneLength = 25,
                           trControl = train_control)

# Check multiple R-squared
y_hat_enet <- predict(elastic_net_model, X)
rsq_enet <- cor(y, y_hat_enet)^2Parabéns! Se você chegou até aqui, já sabe que:
Quer aprender mais sobre regressão em R? Faça o curso Supervised Learning in R: Regression da DataCamp. Confira também nossos tutoriais de Linear Regression in R e Logistic Regression in R.
Cursos de R
Curso
Curso
Curso
Tutorial
DataCamp Team
10 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Zoumana Keita
12 min
Tutorial
Vidhi Chugh
14 min
Tutorial
Avinash Navlani
10 min
Tutorial
Elena Kosourova
12 min




