Kurs
Einführung in R
4 Std.
3.1M
Code aus diesem Tutorial online ausführen und bearbeiten
Code ausführenWir behandeln sowohl die mathematischen Grundlagen der Methoden als auch praktische R-Beispiele – plus ein paar nützliche Kniffe. Legen wir los!
Starten wir mit den Basics: dem einfachen linearen Regressionsmodell. Ziel ist es, n Beobachtungen der Zielvariablen Y mit einer Linearkombination aus m Prädiktorvariablen X und einem normalverteilten Fehlerterm mit Varianz σ2 vorherzusagen:
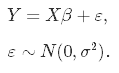
Da wir die wahren Parameter β nicht kennen, schätzen wir sie aus der Stichprobe. Beim Verfahren der kleinsten Quadrate (Ordinary Least Squares, OLS) erhalten wir $\hat\beta$, indem wir die Summe der quadrierten Residuen minimieren. Anders gesagt, wir minimieren folgende Verlustfunktion:
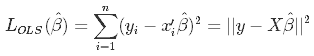
und erhalten so die bekannten OLS-Schätzer $\hat\beta_{OLS} = (X'X)^{-1}(X'Y)$.
In der Statistik werden bei Schätzern zwei Eigenschaften besonders beachtet: Bias und Varianz. Der Bias ist die Differenz zwischen dem wahren Populationsparameter und dem Erwartungswert des Schätzers:
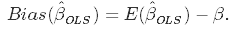
Er misst die Genauigkeit der Schätzung. Die Varianz hingegen beschreibt die Streuung bzw. Unsicherheit der Schätzwerte. Sie ist gegeben durch
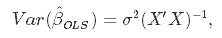
wobei die unbekannte Fehlervarianz σ2 aus den Residuen geschätzt werden kann als
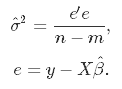
Diese Grafik veranschaulicht Bias und Varianz. Stell dir vor, die Zielscheibenmitte ist der wahre Populationsparameter β, den wir schätzen. Die Schüsse stehen für die Schätzergebnisse von vier verschiedenen Schätzern – mit jeweils niedrigem bzw. hohem Bias und Varianz sowie deren Kombinationen.
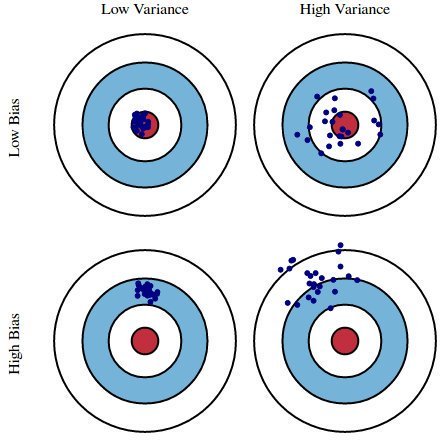
Quelle: kdnuggets.com
Sowohl Bias als auch Varianz sollten möglichst klein sein, da große Werte zu schlechten Vorhersagen führen. Der Modellfehler lässt sich in drei Teile zerlegen: Fehler durch hohe Varianz, Fehler durch hohen Bias und den Rest – den nicht erklärbaren Anteil.
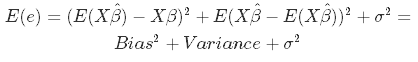
Der OLS-Schätzer ist erwartungstreu (unbiased), kann jedoch eine sehr große Varianz aufweisen. Das passiert vor allem dann, wenn:
Die allgemeine Lösung lautet: Wir verringern die Varianz und akzeptieren dafür etwas Bias. Dieser Ansatz heißt Regularisierung und bringt für die Prognosegüte fast immer Vorteile. Zur Veranschaulichung schau dir den folgenden Plot an.
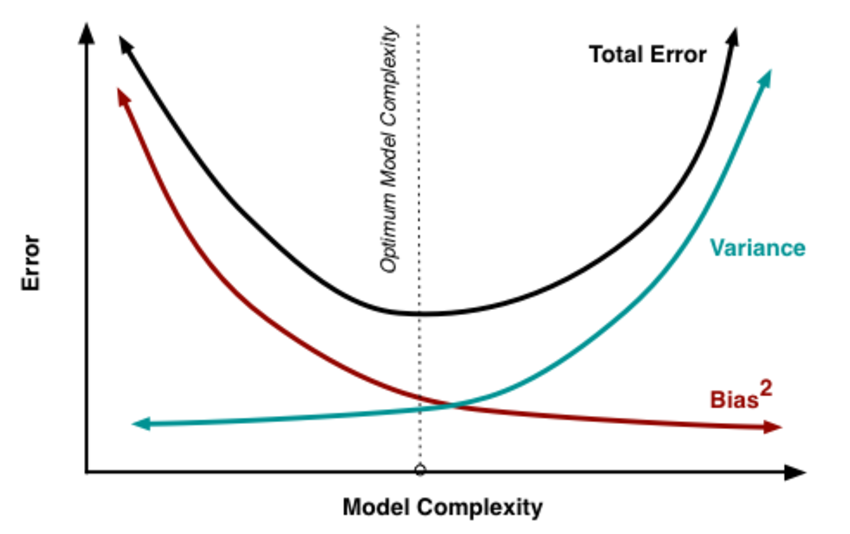
Quelle: researchgate.net
Mit steigender Modellkomplexität – im Fall der linearen Regression also mit der Anzahl der Prädiktoren – nimmt die Varianz der Schätzer zu, während der Bias sinkt. Der unverzerrte OLS-Ansatz liegt damit rechts im Diagramm und ist weit vom Optimum entfernt. Deshalb regularisieren wir: Wir senken die Varianz auf Kosten eines kleinen Bias und bewegen uns nach links in Richtung Optimum.
Wir haben gesehen, dass wir die Modellkomplexität, also die Anzahl der Prädiktoren, verringern möchten. Forward- oder Backward-Selection wären möglich, aber dann verlieren wir jede Aussage über die Wirkung der entfernten Variablen. Prädiktoren aus dem Modell zu werfen entspricht dem Setzen ihrer Koeffizienten auf null. Statt sie hart auf null zu zwingen, bestrafen wir große Koeffizienten kontinuierlich, indem wir sie um null herum schrumpfen. So reduzieren wir die Komplexität und behalten alle Variablen im Modell. Genau das macht die Ridge-Regression.
Bei der Ridge-Regression erweitern wir die OLS-Verlustfunktion: Wir minimieren nicht nur die Summe der quadrierten Residuen, sondern bestrafen zusätzlich die Größe der Parameterschätzer, um sie gegen null zu ziehen:
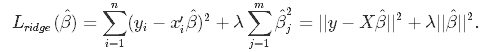
Die Lösung für $\hat\beta$ liefert die Ridge-Schätzer $\hat\beta_{ridge} = (X'X+\lambda I)^{-1}(X'Y)$, wobei I die Einheitsmatrix ist.
Der Parameter λ ist die Regularisierungsstrafe. Wie man ihn wählt, sehen wir später. Zunächst gilt:
λ gleich 0 entspricht also OLS; je größer λ, desto stärker werden die Koeffizienten bestraft.
Beziehen wir die Regularisierung in die Formeln für Bias und Varianz ein, erhalten wir
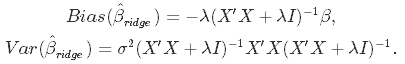
Daran siehst du: Je größer λ, desto kleiner die Varianz und desto größer der Bias. Die Frage ist also: Wie viel Bias nehmen wir in Kauf, um die Varianz zu senken? Oder: Welcher Wert für λ ist optimal?
Es gibt zwei gängige Wege. Klassisch wählt man λ so, dass ein Informationskriterium (z. B. AIC oder BIC) minimal ist. Maschinelles Lernen setzt eher auf Cross-Validation und nimmt das λ, das die kreuzvalidierte Fehlerkenngröße (z. B. quadrierte Residuen) minimiert. Ersteres betont die Anpassung an die Daten, letzteres die Vorhersageleistung. Schauen wir uns beides an.
Informationskriterien minimieren
Dazu schätzt du das Modell für viele λ-Werte und wählst den, der Akaike- oder Bayes-Informationskriterium minimiert:
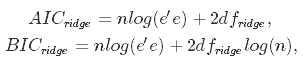
wobei dfridge die Anzahl Freiheitsgrade ist. Vorsicht: Die Freiheitsgrade der Ridge-Regression unterscheiden sich von OLS! Das wird oft übersehen und führt zu falschen Schlüssen. In OLS wie in Ridge sind die Freiheitsgrade die Spur der sogenannten Hat-Matrix, die die Zielwerte auf die Vorhersagen abbildet: $\hat y = H y$.
In OLS ist HOLS = X(X′X)−1X, woraus dfOLS = trHOLS = m folgt. In Ridge muss die Regularisierung in die Hat-Matrix: Hridge = X(X′X + λI)−1X, woraus dfridge = trHridge resultiert – nicht mehr gleich m. Manche Software nutzt fälschlich die OLS-Formel. Rechne die Kriterien im Zweifel selbst – so machen wir es weiter unten.
Kreuzvalidierte Residuen minimieren
Für die Wahl von λ per Cross-Validation legst du P Kandidaten fest, teilst die Daten in K Folds und folgst diesem Ablauf:
Natürlich musst du das nicht selbst implementieren – R bringt fertige Funktionen mit.
In R findest du alles Nötige im Paket glmnet. Wir nutzen als Beispiel den bekannten Datensatz mtcars und sagen die Meilen pro Gallone auf Basis weiterer Fahrzeugmerkmale voraus. Wichtig: Ridge-Regression setzt standardisierte Prädiktoren und zentrierte Zielvariable voraus! Gleich siehst du, warum. Fürs Erste standardisieren wir vor dem Modellieren.
# Load libraries, get data & set seed for reproducibility ---------------------
set.seed(123)    # seef for reproducibility
library(glmnet)  # for ridge regression
library(dplyr)   # for data cleaning
library(psych)   # for function tr() to compute trace of a matrix

data("mtcars")
# Center y, X will be standardized in the modelling function
y <- mtcars %>% select(mpg) %>% scale(center = TRUE, scale = FALSE) %>% as.matrix()
X <- mtcars %>% select(-mpg) %>% as.matrix()


# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 0 implements ridge regression
ridge_cv <- cv.glmnet(X, y, alpha = 0, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(ridge_cv)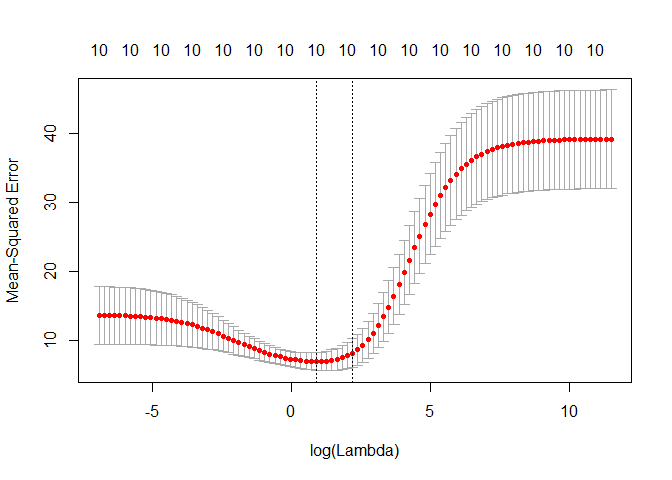
# Best cross-validated lambda
lambda_cv <- ridge_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 0, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_ridge_cv <- cor(y, y_hat_cv)^2


# Use information criteria to select lambda -----------------------------------
X_scaled <- scale(X)
aic <- c()
bic <- c()
for (lambda in seq(lambdas_to_try)) {
  # Run model
  model <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try[lambda], standardize = TRUE)
  # Extract coefficients and residuals (remove first row for the intercept)
  betas <- as.vector((as.matrix(coef(model))[-1, ]))
  resid <- y - (X_scaled %*% betas)
  # Compute hat-matrix and degrees of freedom
  ld <- lambdas_to_try[lambda] * diag(ncol(X_scaled))
  H <- X_scaled %*% solve(t(X_scaled) %*% X_scaled + ld) %*% t(X_scaled)
  df <- tr(H)
  # Compute information criteria
  aic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df
  bic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df * log(nrow(X_scaled))
}

# Plot information criteria against tried values of lambdas
plot(log(lambdas_to_try), aic, col = "orange", type = "l",
     ylim = c(190, 260), ylab = "Information Criterion")
lines(log(lambdas_to_try), bic, col = "skyblue3")
legend("bottomright", lwd = 1, col = c("orange", "skyblue3"), legend = c("AIC", "BIC"))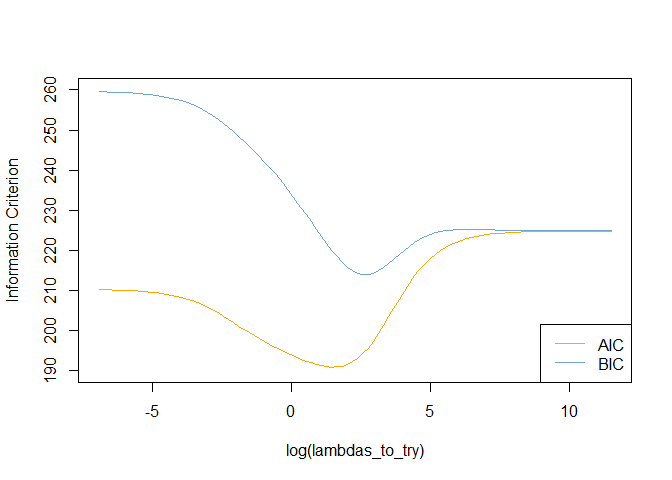
# Optimal lambdas according to both criteria
lambda_aic <- lambdas_to_try[which.min(aic)]
lambda_bic <- lambdas_to_try[which.min(bic)]

# Fit final models, get their sum of squared residuals and multiple R-squared
model_aic <- glmnet(X, y, alpha = 0, lambda = lambda_aic, standardize = TRUE)
y_hat_aic <- predict(model_aic, X)
ssr_aic <- t(y - y_hat_aic) %*% (y - y_hat_aic)
rsq_ridge_aic <- cor(y, y_hat_aic)^2

model_bic <- glmnet(X, y, alpha = 0, lambda = lambda_bic, standardize = TRUE)
y_hat_bic <- predict(model_bic, X)
ssr_bic <- t(y - y_hat_bic) %*% (y - y_hat_bic)
rsq_ridge_bic <- cor(y, y_hat_bic)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)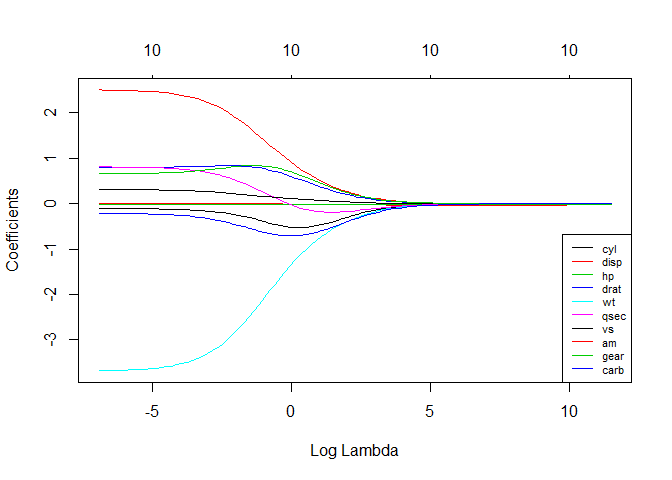
Ich habe erwähnt, dass Ridge standardisierte Prädiktoren (z-Scores) annimmt. Warum? Die Skalierung stellt sicher, dass der Strafterm alle Koeffizienten gleich behandelt, also die Form $\lambda \sum_{j=1}^m\hat\beta_j^2$ hat. Ohne Standardisierung sind die Standardabweichungen der Prädiktoren ungleich eins, woraus sich mit etwas Mathe ein Strafterm der Form $\lambda \sum_{j=1}^m\hat\beta_j^2/std(x_j)$ ergibt. Unstandardisierte Koeffizienten werden also invers zur Standardabweichung ihres Prädiktors gewichtet. Wir skalieren X, um das zu vermeiden – aber: Statt die Heteroskedastizität durch Angleichung der Varianzen zu beheben, könnten wir sie auch bewusst als Gewichte in der Schätzung nutzen! Das ist die Idee der differenziell gewichteten bzw. heteroskedastischen Ridge-Regression.
Die Idee ist, verschiedene Koeffizienten unterschiedlich stark zu bestrafen, indem wir Gewichte in die Verlustfunktion einführen:
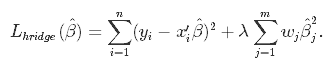
Wie wählt man die Gewichte wj? Führe für jeden Prädiktor eine univariate Regression (Ziel gegen einen Prädiktor) durch, extrahiere die Varianzschätzung des Koeffizienten $\hat\sigma_{j}$ und nutze sie als Gewicht! So gilt:
So setzt du das in R um. Da diese Methode nicht in glmnet implementiert ist, brauchen wir etwas eigenen Code.
# Calculate the weights from univariate regressions
weights <- sapply(seq(ncol(X)), function(predictor) {
  uni_model <- lm(y ~ X[, predictor])
  coeff_variance <- summary(uni_model)$coefficients[2, 2]^2
})


# Heteroskedastic Ridge Regression loss function - to be minimized
hridge_loss <- function(betas) {
  sum((y - X %*% betas)^2) + lambda * sum(weights * betas^2)
}


# Heteroskedastic Ridge Regression function
hridge <- function(y, X, lambda, weights) {
  # Use regular ridge regression coefficient as initial values for optimization
  model_init <- glmnet(X, y, alpha = 0, lambda = lambda, standardize = FALSE)
  betas_init <- as.vector(model_init$beta)
  # Solve optimization problem to get coefficients
  coef <- optim(betas_init, hridge_loss)$par
  # Compute fitted values and multiple R-squared
  fitted <- X %*% coef
  rsq <- cor(y, fitted)^2
  names(coef) <- colnames(X)
  output <- list("coef" = coef,
                 "fitted" = fitted,
                 "rsq" = rsq)
  return(output)
}


# Fit model to the data for lambda = 0.001
hridge_model <- hridge(y, X, lambda = 0.001, weights = weights)
rsq_hridge_0001 <- hridge_model$rsq

# Cross-validation or AIC/BIC can be employed to select some better lambda!
# You can find some useful functions for this at https://github.com/MichalOleszak/momisc/blob/master/R/hridge.RLasso (Least Absolute Shrinkage and Selection Operator) ist konzeptionell der Ridge-Regression sehr ähnlich. Auch hier gibt es eine Strafe für von null abweichende Koeffizienten. Im Unterschied zu Ridge, das die Summe der quadrierten Koeffizienten bestraft (L2-Strafe), bestraft Lasso die Summe ihrer absoluten Beträge (L1-Strafe). Dadurch werden bei großen λ-Werten viele Koeffizienten exakt auf null gesetzt – bei Ridge passiert das nie.
Der einzige Unterschied der Verlustfunktionen von Ridge und Lasso liegt im Strafterm. Bei Lasso ist der Verlust definiert als:
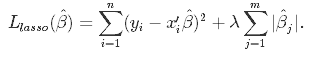
Für Lasso kannst du ebenfalls glmnet() verwenden, aber mit dem Parameter alpha auf 1 gesetzt.
# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 1 implements lasso regression
lasso_cv <- cv.glmnet(X, y, alpha = 1, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(lasso_cv)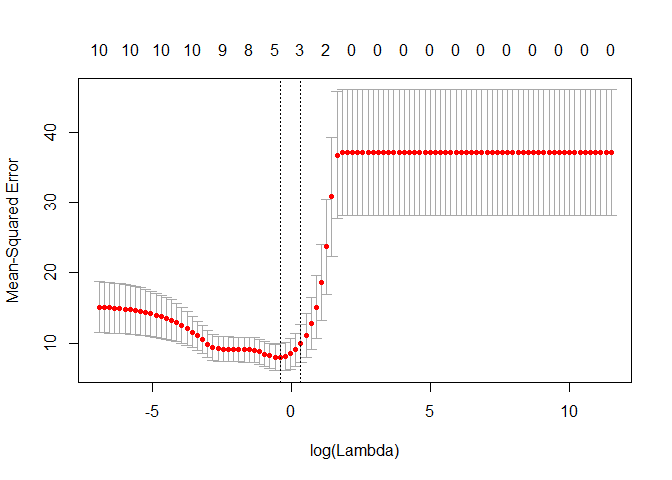
# Best cross-validated lambda
lambda_cv <- lasso_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 1, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_lasso_cv <- cor(y, y_hat_cv)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 1, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)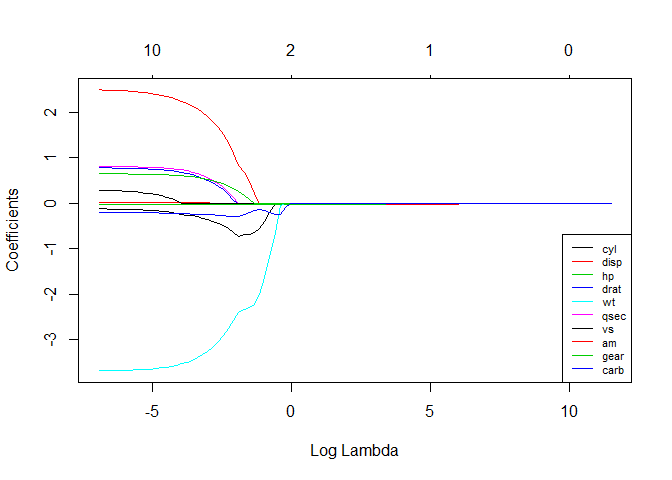
Vergleichen wir die R-Quadrat-Werte der geschätzten Modelle!
rsq <- cbind("R-squared" = c(rsq_ridge_cv, rsq_ridge_aic, rsq_ridge_bic, rsq_hridge_0001, rsq_lasso_cv))
rownames(rsq) <- c("ridge cross-validated", "ridge AIC", "ridge BIC", "hridge 0.001", "lasso cross_validated")
print(rsq)

##                       R-squared
## ridge cross-validated 0.8536968
## ridge AIC             0.8496310
## ridge BIC             0.8412011
## hridge 0.001          0.7278277
## lasso cross_validated 0.8426777
In diesen Daten schneiden sie ähnlich ab. Beachte: Das heteroskedastische Modell ist ungetuned, lambda also nicht optimal! Ein paar generelle Hinweise zum Vergleich Ridge vs. Lasso:
Elastic Net entstand als Antwort auf Kritik am Lasso: Dessen Variablenselektion kann datenabhängig und damit instabil sein. Die Lösung ist, die Strafen von Ridge und Lasso zu kombinieren – das Beste aus beiden Welten. Elastic Net minimiert folgende Verlustfunktion:
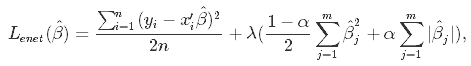
wobei α der Mischparameter zwischen Ridge (α = 0) und Lasso (α = 1) ist.
Jetzt sind zwei Parameter zu tunen: λ und α. Das Paket glmnet erlaubt die λ-Suche via Cross-Validation bei festem α, aber kein α-Tuning. Dafür nutzen wir caret.
library(caret)

# Set training control
train_control <- trainControl(method = "repeatedcv",
                              number = 5,
                              repeats = 5,
                              search = "random",
                              verboseIter = TRUE)

# Train the model
elastic_net_model <- train(mpg ~ .,
                           data = cbind(y, X),
                           method = "glmnet",
                           preProcess = c("center", "scale"),
                           tuneLength = 25,
                           trControl = train_control)

# Check multiple R-squared
y_hat_enet <- predict(elastic_net_model, X)
rsq_enet <- cor(y, y_hat_enet)^2Glückwunsch! Wenn du bis hierhin gelesen hast, weißt du bereits:
Wenn du mehr über Regression in R lernen willst, besuche DataCamps Kurs Supervised Learning in R: Regression. Sieh dir außerdem unsere Tutorials zu Linearer Regression in R und Logistischer Regression in R an.
R-Kurse
Kurs
Kurs
Kurs