Cours
Introduction à R
4 h
3.1M
Exécutez et modifiez le code de ce tutoriel en ligne
Exécuter le codeNous allons couvrir à la fois les aspects mathématiques de ces méthodes et des exemples pratiques en R, avec quelques astuces supplémentaires. Sans plus attendre, commençons !
Partons des bases : le modèle de régression linéaire simple, dans lequel vous cherchez à prédire n observations de la variable réponse, Y, à l’aide d’une combinaison linéaire de m variables prédictives, X, et d’un terme d’erreur normalement distribué de variance σ2 :
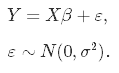
Comme nous ne connaissons pas les vrais paramètres, β, nous devons les estimer à partir de l’échantillon. En moindres carrés ordinaires (OLS), on les estime par $\hat\beta$ de manière à minimiser la somme des carrés des résidus. Autrement dit, on minimise la fonction de perte suivante :
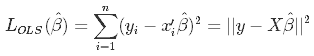
afin d’obtenir les fameux estimateurs OLS, $\hat\beta_{OLS} = (X'X)^{-1}(X'Y)$.
En statistique, deux caractéristiques clés des estimateurs sont à considérer : le biais et la variance. Le biais est la différence entre le vrai paramètre de population et l’espérance de l’estimateur :
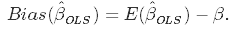
Il mesure la justesse des estimations. La variance, elle, mesure leur dispersion, donc l’incertitude associée. Elle est donnée par
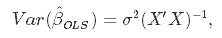
où la variance d’erreur inconnue σ2 peut être estimée à partir des résidus comme
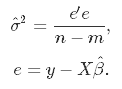
Ce schéma illustre le biais et la variance. Imaginez que le centre de la cible représente le vrai paramètre de population que nous estimons, β, et que les tirs correspondent aux valeurs de nos estimateurs issus de quatre estimateurs différents : faible biais/faible variance, fort biais/forte variance, et les combinaisons intermédiaires.
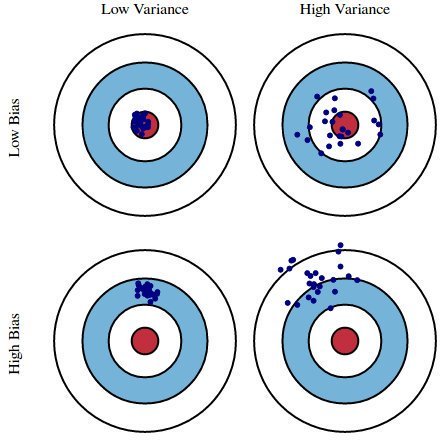
Source : kdnuggets.com
On souhaite à la fois un biais et une variance faibles, car des valeurs élevées nuisent aux performances prédictives. En fait, l’erreur du modèle se décompose en trois parties : l’erreur due à une variance élevée, celle due à un biais important, et le reste — la part inexpliquée.
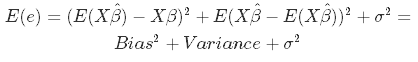
L’estimateur OLS a l’avantage d’être sans biais. Cependant, sa variance peut être très élevée. Plus précisément, cela se produit lorsque :
La solution générale consiste à réduire la variance au prix d’un certain biais. Cette approche, la régularisation, améliore presque toujours la performance prédictive du modèle. Pour bien le voir, regardons le graphique suivant.
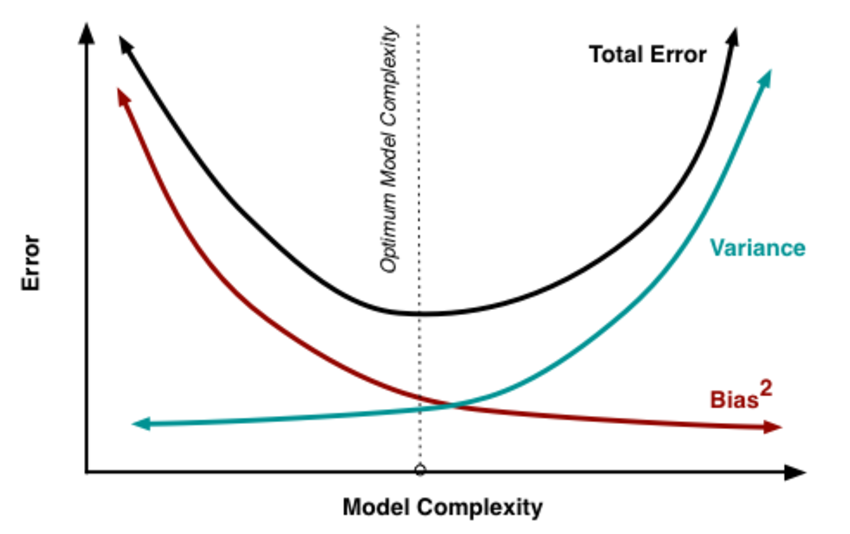
Source : researchgate.net
À mesure que la complexité du modèle augmente — pour une régression linéaire, pensez au nombre de prédicteurs — la variance des estimations augmente, mais le biais diminue. L’OLS non régularisé nous place à droite du graphique, loin de l’optimum. D’où l’intérêt de régulariser : diminuer la variance au prix d’un peu de biais, et ainsi se déplacer vers la gauche, vers la zone optimale.
Nous avons conclu qu’il fallait réduire la complexité du modèle, c’est-à-dire le nombre de prédicteurs. On pourrait utiliser une sélection pas à pas (forward/backward), mais on perdrait toute information sur l’effet des variables retirées. Supprimer un prédicteur revient à fixer son coefficient à zéro. Plutôt que de les forcer à être exactement nuls, pénalisons leur éloignement de zéro pour les contraindre en continu à être petits. Ainsi, on réduit la complexité tout en conservant toutes les variables. C’est précisément ce que fait la régression Ridge.
En régression Ridge, on modifie la fonction de perte OLS pour non seulement minimiser la somme des carrés des résidus, mais aussi pénaliser la taille des coefficients afin de les rapprocher de zéro :
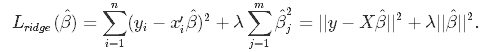
La résolution pour $\hat\beta$ donne les estimateurs ridge $\hat\beta_{ridge} = (X'X+\lambda I)^{-1}(X'Y)$, où I est la matrice identité.
Le paramètre λ est la pénalité de régularisation. Nous verrons comment le choisir dans la suite, mais notez déjà :
Ainsi, fixer λ à 0 revient à utiliser l’OLS, tandis que des valeurs plus grandes renforcent la pénalisation de la taille des coefficients.
En incorporant le coefficient de régularisation dans les formules du biais et de la variance, on obtient
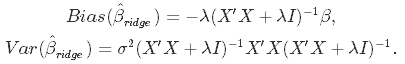
On voit donc que plus λ est grand, plus la variance diminue, et plus le biais augmente. La question est : quel niveau de biais accepter pour réduire la variance ? Ou autrement : quelle est la valeur optimale de λ ?
Deux approches sont possibles. La plus classique consiste à choisir λ de sorte qu’un critère d’information (AIC, BIC, etc.) soit minimal. Une approche plus « machine learning » est d’effectuer une validation croisée et de sélectionner la valeur de λ qui minimise la somme des carrés des résidus validée croisée (ou une autre métrique). La première met l’accent sur l’ajustement aux données, la seconde sur la performance prédictive. Voyons les deux.
Minimisation des critères d’information
Cette approche revient à estimer le modèle pour différentes valeurs de λ et à choisir celle qui minimise l’AIC ou le BIC :
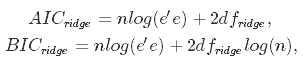
où dfridge est le nombre de degrés de liberté. Attention ! Les degrés de liberté en régression ridge diffèrent de ceux en OLS classique ! Cet oubli conduit souvent à des inférences erronées. En OLS comme en ridge, les degrés de liberté correspondent à la trace de la « matrice chapeau » (hat matrix), qui projette le vecteur des réponses vers le vecteur des valeurs ajustées : $\hat y = H y$.
En OLS, on a HOLS = X(X′X)−1X, d’où dfOLS = trHOLS = m, où m est le nombre de prédicteurs. En ridge, la matrice chapeau inclut la pénalité : Hridge = X(X′X + λI)−1X, d’où dfridge = trHridge, qui n’est plus égal à m. Certains logiciels de ridge produisent des critères d’information basés sur la formule OLS. Pour éviter toute erreur, mieux vaut les calculer manuellement — ce que nous ferons plus loin.
Minimisation des résidus en validation croisée
Pour choisir λ via validation croisée, sélectionnez un ensemble de P valeurs à tester, découpez le jeu de données en K plis, puis suivez cet algorithme :
Évidemment, pas besoin de tout coder à la main : R fournit les fonctions dédiées.
En R, le package glmnet contient tout le nécessaire pour implémenter la régression ridge. Nous utiliserons le célèbre jeu de données mtcars pour illustrer, avec pour objectif de prédire les miles per gallon à partir d’autres caractéristiques du véhicule. Une précision importante : la régression ridge suppose que les prédicteurs sont standardisés et la réponse centrée ! Vous verrez bientôt pourquoi. Pour l’instant, standardisons avant la modélisation.
# Load libraries, get data & set seed for reproducibility ---------------------
set.seed(123)    # seef for reproducibility
library(glmnet)  # for ridge regression
library(dplyr)   # for data cleaning
library(psych)   # for function tr() to compute trace of a matrix

data("mtcars")
# Center y, X will be standardized in the modelling function
y <- mtcars %>% select(mpg) %>% scale(center = TRUE, scale = FALSE) %>% as.matrix()
X <- mtcars %>% select(-mpg) %>% as.matrix()


# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 0 implements ridge regression
ridge_cv <- cv.glmnet(X, y, alpha = 0, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(ridge_cv)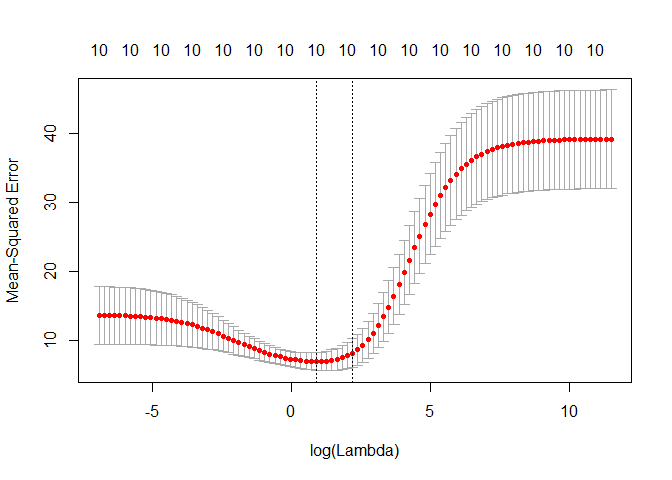
# Best cross-validated lambda
lambda_cv <- ridge_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 0, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_ridge_cv <- cor(y, y_hat_cv)^2


# Use information criteria to select lambda -----------------------------------
X_scaled <- scale(X)
aic <- c()
bic <- c()
for (lambda in seq(lambdas_to_try)) {
  # Run model
  model <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try[lambda], standardize = TRUE)
  # Extract coefficients and residuals (remove first row for the intercept)
  betas <- as.vector((as.matrix(coef(model))[-1, ]))
  resid <- y - (X_scaled %*% betas)
  # Compute hat-matrix and degrees of freedom
  ld <- lambdas_to_try[lambda] * diag(ncol(X_scaled))
  H <- X_scaled %*% solve(t(X_scaled) %*% X_scaled + ld) %*% t(X_scaled)
  df <- tr(H)
  # Compute information criteria
  aic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df
  bic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df * log(nrow(X_scaled))
}

# Plot information criteria against tried values of lambdas
plot(log(lambdas_to_try), aic, col = "orange", type = "l",
     ylim = c(190, 260), ylab = "Information Criterion")
lines(log(lambdas_to_try), bic, col = "skyblue3")
legend("bottomright", lwd = 1, col = c("orange", "skyblue3"), legend = c("AIC", "BIC"))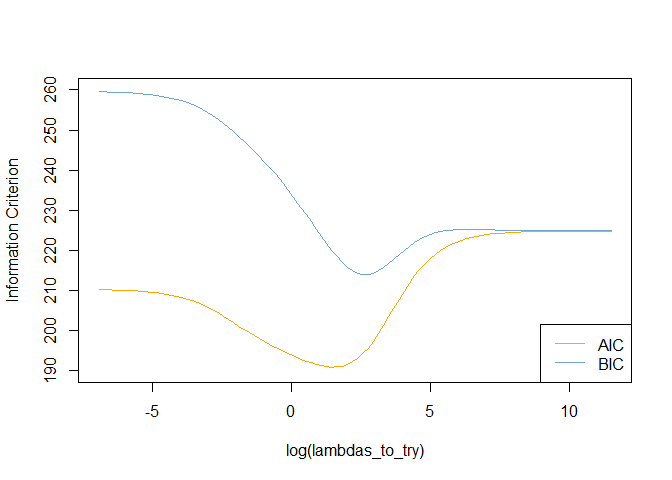
# Optimal lambdas according to both criteria
lambda_aic <- lambdas_to_try[which.min(aic)]
lambda_bic <- lambdas_to_try[which.min(bic)]

# Fit final models, get their sum of squared residuals and multiple R-squared
model_aic <- glmnet(X, y, alpha = 0, lambda = lambda_aic, standardize = TRUE)
y_hat_aic <- predict(model_aic, X)
ssr_aic <- t(y - y_hat_aic) %*% (y - y_hat_aic)
rsq_ridge_aic <- cor(y, y_hat_aic)^2

model_bic <- glmnet(X, y, alpha = 0, lambda = lambda_bic, standardize = TRUE)
y_hat_bic <- predict(model_bic, X)
ssr_bic <- t(y - y_hat_bic) %*% (y - y_hat_bic)
rsq_ridge_bic <- cor(y, y_hat_bic)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)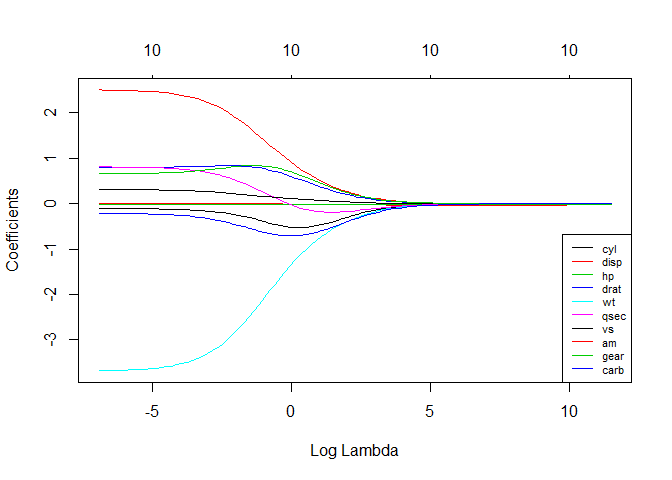
J’ai mentionné que la régression ridge suppose des prédicteurs mis à l’échelle en scores-z. Pourquoi ? Cette mise à l’échelle garantit que le terme de pénalité traite tous les coefficients équitablement et prend la forme $\lambda \sum_{j=1}^m\hat\beta_j^2$. Si les prédicteurs ne sont pas standardisés, leurs écarts types diffèrent de 1, et l’on montre que la pénalité devient $\lambda \sum_{j=1}^m\hat\beta_j^2/std(x_j)$. Les coefficients non standardisés sont alors pondérés par l’inverse des écarts types des prédicteurs correspondants. Nous mettons X à l’échelle pour éviter cela, mais… Plutôt que d’égaliser artificiellement les variances, on peut les utiliser comme poids dans l’estimation ! C’est l’idée de la régression ridge à poids différentiels, ou hétéroscédastique.
Le principe est de pénaliser différemment chaque coefficient en introduisant des poids dans la fonction de perte :
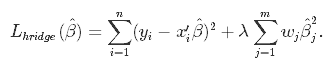
Comment choisir les poids wj ? Lancez une série de régressions univariées (réponse vs. un prédicteur) pour tous les prédicteurs, extrayez l’estimation de la variance du coefficient, $\hat\sigma_{j}$, et utilisez-la comme poids ! Ainsi :
Voici comment procéder en R. Comme cette méthode n’est pas implémentée dans glmnet, il faut un peu de code.
# Calculate the weights from univariate regressions
weights <- sapply(seq(ncol(X)), function(predictor) {
  uni_model <- lm(y ~ X[, predictor])
  coeff_variance <- summary(uni_model)$coefficients[2, 2]^2
})


# Heteroskedastic Ridge Regression loss function - to be minimized
hridge_loss <- function(betas) {
  sum((y - X %*% betas)^2) + lambda * sum(weights * betas^2)
}


# Heteroskedastic Ridge Regression function
hridge <- function(y, X, lambda, weights) {
  # Use regular ridge regression coefficient as initial values for optimization
  model_init <- glmnet(X, y, alpha = 0, lambda = lambda, standardize = FALSE)
  betas_init <- as.vector(model_init$beta)
  # Solve optimization problem to get coefficients
  coef <- optim(betas_init, hridge_loss)$par
  # Compute fitted values and multiple R-squared
  fitted <- X %*% coef
  rsq <- cor(y, fitted)^2
  names(coef) <- colnames(X)
  output <- list("coef" = coef,
                 "fitted" = fitted,
                 "rsq" = rsq)
  return(output)
}


# Fit model to the data for lambda = 0.001
hridge_model <- hridge(y, X, lambda = 0.001, weights = weights)
rsq_hridge_0001 <- hridge_model$rsq

# Cross-validation or AIC/BIC can be employed to select some better lambda!
# You can find some useful functions for this at https://github.com/MichalOleszak/momisc/blob/master/R/hridge.RLasso, pour Least Absolute Shrinkage and Selection Operator, est conceptuellement proche de ridge. Elle ajoute également une pénalité sur les coefficients non nuls, mais contrairement à ridge qui pénalise la somme des carrés des coefficients (pénalité L2), Lasso pénalise la somme de leurs valeurs absolues (pénalité L1). Résultat : pour des valeurs élevées de λ, de nombreux coefficients deviennent exactement nuls avec Lasso, ce qui n’arrive jamais avec ridge.
La seule différence entre les fonctions de perte ridge et lasso réside dans le terme de pénalité. Sous Lasso, la perte est définie comme suit :
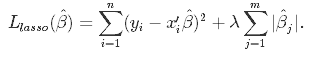
Pour exécuter une régression Lasso, vous pouvez réutiliser la fonction glmnet(), mais avec le paramètre alpha fixé à 1.
# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 1 implements lasso regression
lasso_cv <- cv.glmnet(X, y, alpha = 1, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(lasso_cv)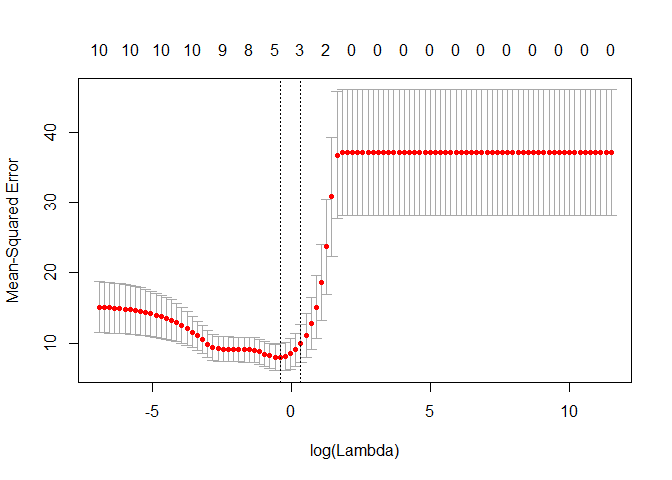
# Best cross-validated lambda
lambda_cv <- lasso_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 1, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_lasso_cv <- cor(y, y_hat_cv)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 1, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)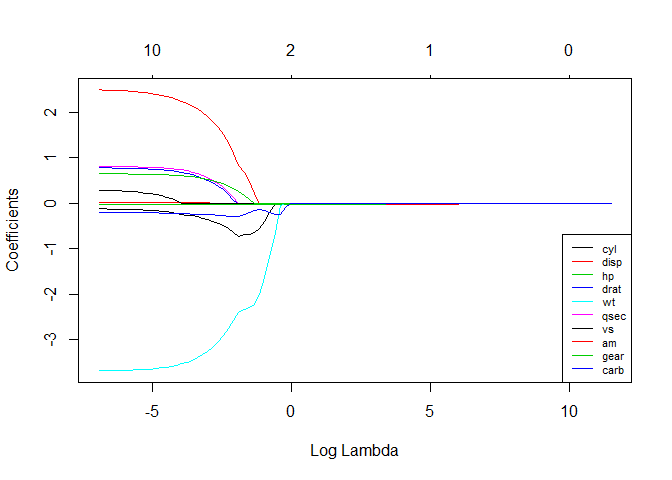
Comparons les R2 multiples des différents modèles estimés !
rsq <- cbind("R-squared" = c(rsq_ridge_cv, rsq_ridge_aic, rsq_ridge_bic, rsq_hridge_0001, rsq_lasso_cv))
rownames(rsq) <- c("ridge cross-validated", "ridge AIC", "ridge BIC", "hridge 0.001", "lasso cross_validated")
print(rsq)

##                       R-squared
## ridge cross-validated 0.8536968
## ridge AIC             0.8496310
## ridge BIC             0.8412011
## hridge 0.001          0.7278277
## lasso cross_validated 0.8426777
Ils semblent offrir des performances proches sur ces données. Gardez à l’esprit que le modèle hétéroscédastique n’est pas optimisé et que le lambda n’est pas optimal ! Quelques points généraux sur la comparaison entre ridge et lasso :
Elastic Net est né des critiques sur Lasso, dont la sélection de variables peut être trop sensible aux données et instable. La solution consiste à combiner les pénalités de ridge et lasso pour tirer le meilleur des deux mondes. Elastic Net cherche à minimiser la fonction de perte suivante :
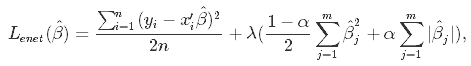
où α est le paramètre de mélange entre ridge (α = 0) et lasso (α = 1).
Il y a donc deux paramètres à ajuster : λ et α. Le package glmnet permet d’ajuster λ par validation croisée pour un α fixé, mais ne gère pas l’optimisation de &alpha, d’où l’utilisation de caret.
library(caret)

# Set training control
train_control <- trainControl(method = "repeatedcv",
                              number = 5,
                              repeats = 5,
                              search = "random",
                              verboseIter = TRUE)

# Train the model
elastic_net_model <- train(mpg ~ .,
                           data = cbind(y, X),
                           method = "glmnet",
                           preProcess = c("center", "scale"),
                           tuneLength = 25,
                           trControl = train_control)

# Check multiple R-squared
y_hat_enet <- predict(elastic_net_model, X)
rsq_enet <- cor(y, y_hat_enet)^2Félicitations ! Si vous êtes arrivé jusqu’ici, vous savez déjà que :
Pour aller plus loin sur la régression en R, suivez le cours Supervised Learning in R: Regression sur DataCamp. Consultez aussi nos tutoriels Linear Regression in R et Logistic Regression in R.
Cours R
Cours
Cours
Cours