
Cours
Introduction aux statistiques en Python
4 h
197.2K
La courbe ROC illustre le compromis entre le taux de vrais positifs (TPR) et le taux de faux positifs (FPR) pour différents seuils. Elle montre dans quelle mesure le modèle parvient à équilibrer la détection des instances positives et la limitation des faux positifs selon les seuils. AUC, pour « Area Under the Curve », est une valeur scalaire unique comprise entre 0 et 1 qui offre une vue d’ensemble des performances du modèle. On calcule l’AUC après avoir généré la courbe ROC, car elle représente l’aire située sous la courbe.
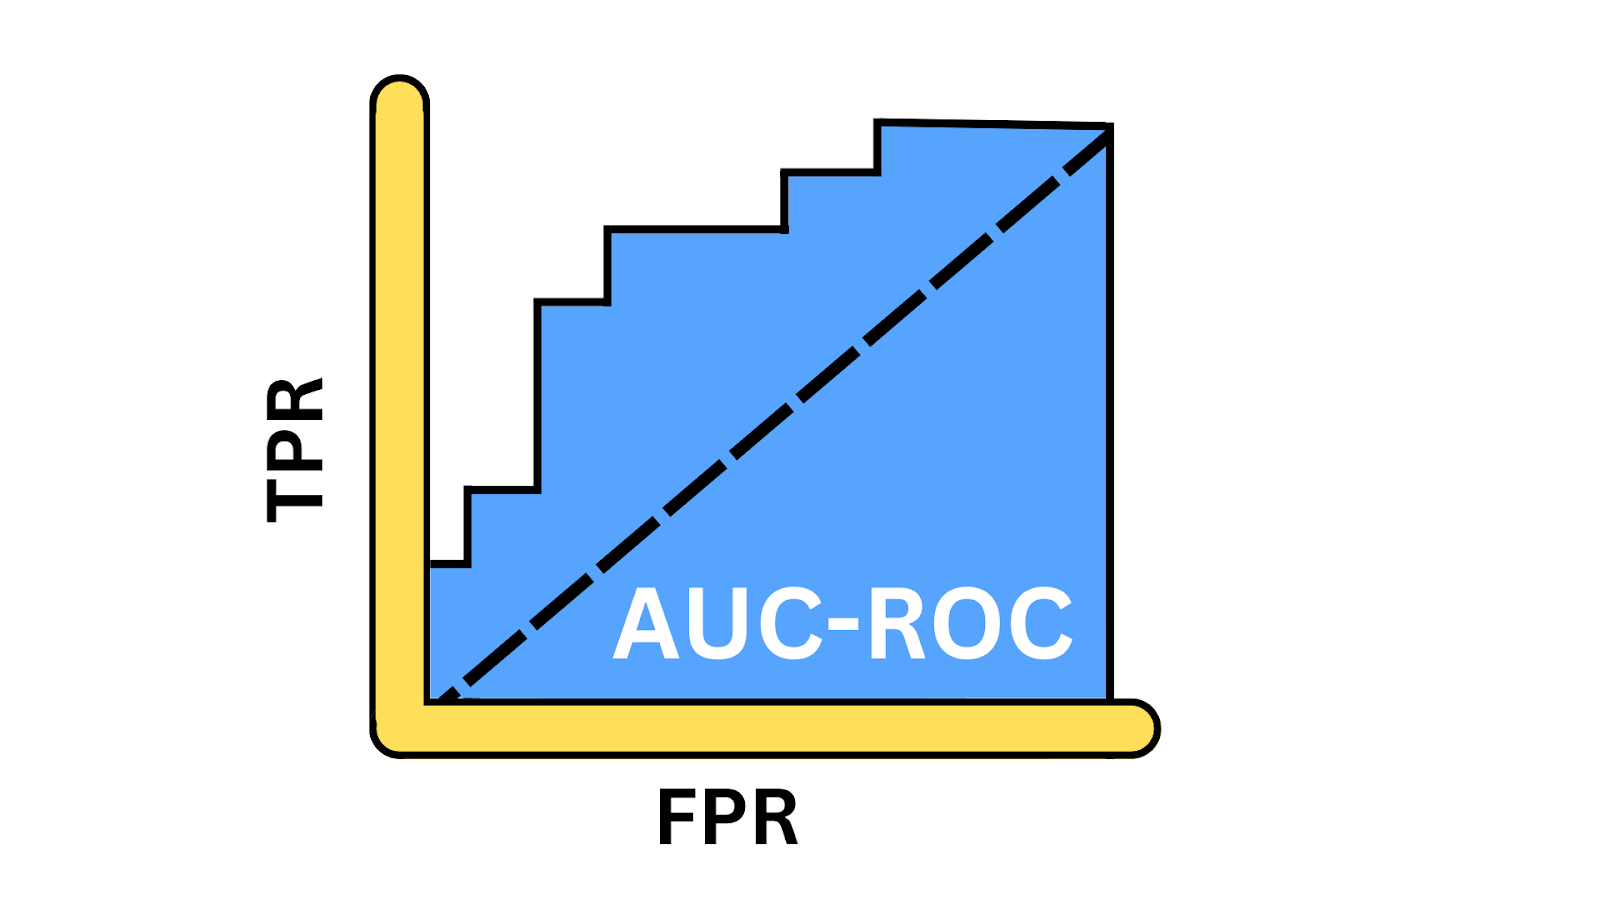
Illustration de la courbe AUC‑ROC. Image de l’auteur
Le taux de vrais positifs, aussi appelé sensibilité ou rappel (recall), reflète la capacité du modèle à identifier correctement les instances positives. Il mesure la proportion des cas réellement positifs que le modèle parvient à détecter. Mathématiquement, on l’exprime par l’équation suivante :
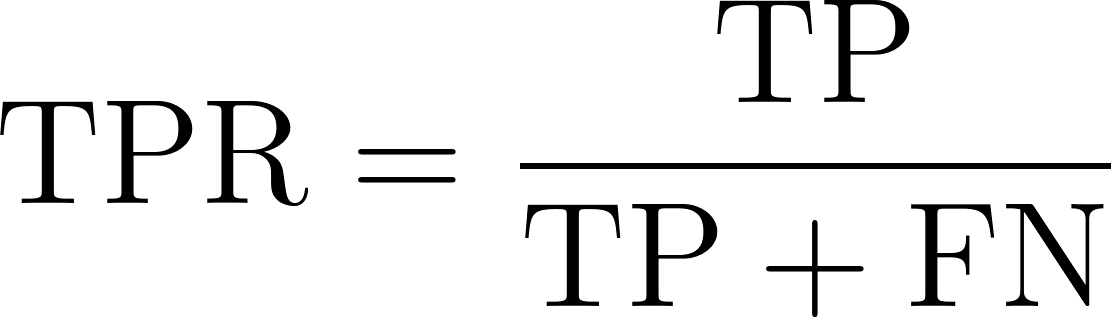
Où :
Le FPR indique la fréquence à laquelle le modèle classe à tort des instances négatives comme positives. Il mesure la proportion d’instances réellement négatives que le modèle identifie incorrectement comme positives, autrement dit le taux de fausses alertes. Mathématiquement, on l’exprime ainsi.
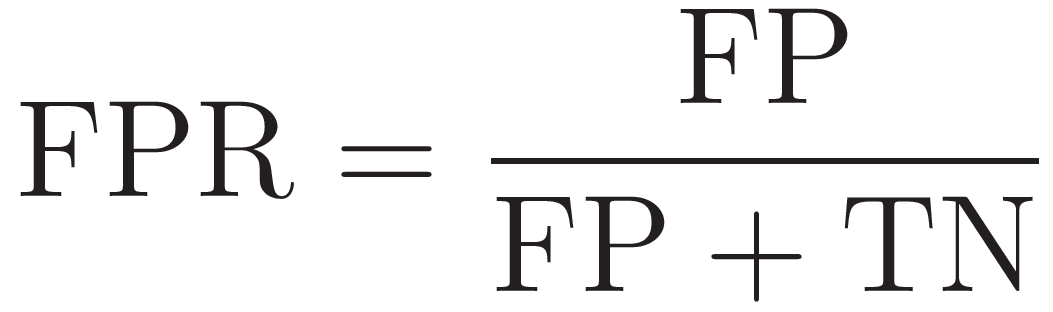
Où :
Voyons dans quels cas l’AUC‑ROC est un indicateur particulièrement pertinent.
L’AUC‑ROC fournit une mesure agrégée de la performance sur tous les seuils de classification possibles. Contrairement à l’accuracy, la précision ou le F1‑score, qui dépendent d’un seuil précis, elle tient compte des performances du modèle à différents points de fonctionnement.
L’AUC‑ROC est une valeur scalaire unique qui facilite la comparaison de plusieurs modèles, indépendamment de leurs seuils de classification. Son indépendance vis‑à‑vis du seuil en fait un excellent choix pour comparer équitablement des modèles ayant des seuils optimaux différents.
La plupart des jeux de données réels sont déséquilibrés, avec une classe nettement plus fréquente que l’autre : analyse de sentiments, détection de fraude, détection de cancers, etc. Dans ces situations, des métriques comme l’accuracy peuvent induire en erreur, car elles favorisent la classe majoritaire. L’AUC‑ROC est alors plus fiable.
Passons en revue quelques idées essentielles.
Pour construire la courbe ROC, nous calculerons TPR et FPR à différents seuils. Commençons par importer les bibliothèques nécessaires à cette démonstration.
from sklearn.model_selection import train_test_split
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score, accuracy_score, precision_score, recall_score, f1_score, confusion_matrix, roc_curve, auc
import matplotlib.pyplot as plt
Ensuite, nous générons un jeu de données pour classification binaire avec la fonction make-classification(), contenant 1 000 échantillons et 20 variables.
# Generate a binary classification dataset
X, y = make_classification(n_samples=1000, n_features=20, n_classes=2, random_state=0)
Séparons ensuite le jeu de données en apprentissage et test : nous entraînerons le modèle sur l’ensemble d’entraînement et évaluerons ses performances sur les données de test non vues.
# Split the dataset into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
Nous définissons ensuite l’objet modèle en appelant la classe LogisticRegression(), puis nous l’entraînons avec la méthode fit sur les données d’apprentissage, où X_train contient les variables et y_train les étiquettes.
# Train a Logistic Regression model
model = LogisticRegression()
model.fit(X_train, y_train)
Le modèle est maintenant entraîné et prêt à générer des prédictions. Nous appelons predict_proba() pour obtenir la probabilité de la classe positive. Nous utilisons predict() pour calculer des métriques comme l’accuracy, la précision, le rappel et le F1‑score.
# Predict the probabilities for the test set
y_probs = model.predict_proba(X_test)[:, 1]

# Predict the classes for the test set
y_pred = model.predict(X_test)
Nous calculons ensuite ces métriques avec leurs fonctions dédiées et les affichons.
# Calculate the AUC - ROC score
roc_auc = roc_auc_score(y_test, y_probs)

# Calculate other metrics
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)

# Print the metrics
print(f"AUC - ROC Score: {roc_auc:.2f}")
print(f"Accuracy: {accuracy:.2f}")
print(f"Precision: {precision:.2f}")
print(f"Recall: {recall:.2f}")
print(f"F1 Score: {f1:.2f}")
AUC-ROC Score: 0.93
Accuracy: 0.87
Precision: 0.87
Recall: 0.87
F1 Score: 0.87Visualisons maintenant la courbe ROC avec la diagonale représentant un modèle au hasard. Pour ce faire, nous avons besoin de FPR et TPR pour chaque seuil discret entre 0 et 1. Sur le graphique ci‑dessous, la courbe orange représente la ROC et l’aire sous la courbe est de 0,93.
# Plotting the ROC Curve
fpr, tpr, thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)

plt.figure()
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC curve (area = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('Receiver Operating Characteristic')
plt.legend(loc="lower right")
plt.show()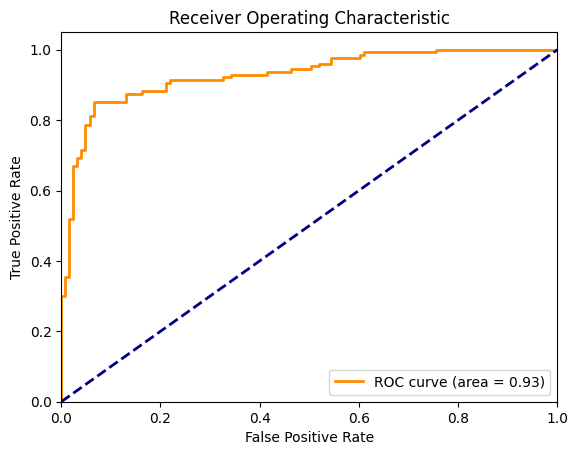
Courbe ROC pour la régression logistique. Image de l’auteur
Utilisons maintenant le même jeu de données pour comparer les performances de quatre algorithmes de classification avec la ROC. Nous allons importer RandomForestClassifier, KNeighborsClassifier et SVC, puis les comparer à LogisticRegression.
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC

# Define the models
models = {
    "Logistic Regression": LogisticRegression(),
    "Random Forest": RandomForestClassifier(),
    "SVM": SVC(probability=True),
    "K-Nearest Neighbors": KNeighborsClassifier()
}

# Initialize a dictionary to store AUC - ROC scores
roc_auc_scores = {}

# Plot the ROC curves
plt.figure(figsize=(10, 8))

for name, model in models.items():
    # Train the model
    model.fit(X_train, y_train)

    # Predict the probabilities
    y_probs = model.predict_proba(X_test)[:, 1]

    # Calculate the AUC - ROC score
    roc_auc = roc_auc_score(y_test, y_probs)
    roc_auc_scores[name] = roc_auc

    # Compute ROC curve
    fpr, tpr, _ = roc_curve(y_test, y_probs)

    # Plot ROC curve
    plt.plot(fpr, tpr, lw=2, label=f'{name} (AUC = {roc_auc:.2f})')

# Plot the diagonal 50% line
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')

# Customize the plot
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve Comparison')
plt.legend(loc="lower right")
plt.show()

# Print the AUC - ROC scores for each model
for name, score in roc_auc_scores.items():
    print(f'{name}: AUC - ROC = {score:.2f}')
Pour chaque modèle, nous répétons fit() et predict_proba(), calculons les FPR et TPR correspondants, puis traçons les courbes associées.
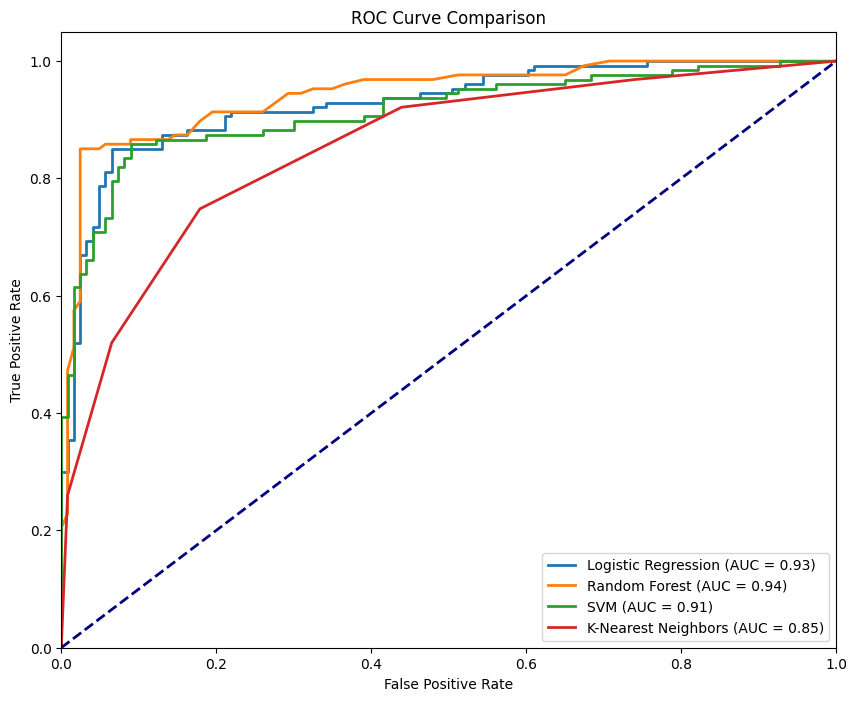
Courbe ROC pour différents modèles. Image de l’auteur
La figure ci‑dessus affiche les quatre courbes correspondant aux quatre classifieurs. RandomForestClassifier est le plus performant avec une AUC‑ROC de 0,94, tandis que KNeighborsClassifier obtient la plus faible performance avec une AUC‑ROC de 0,85. Un modèle idéal épouserait l’angle supérieur gauche du graphique : TPR maximal et FPR minimal. Plus la courbe s’en approche, meilleures sont les performances.
Décomposons les métriques fournies par la courbe AUC‑ROC et leur signification.
L’AUC offre un repère rapide pour juger la performance du modèle. Proche de 1, le modèle est au meilleur de sa forme : il distingue très bien les classes. Autour de 0,5, c’est problématique : le modèle ne fait guère mieux qu’un tirage au sort et n’a pas de pouvoir discriminant. Une AUC proche de 0 est alarmante : le modèle se trompe systématiquement, pire qu’un pile ou face.
Le TPR, ou sensibilité, indique dans quelle mesure le modèle capture les instances positives. Il correspond à la proportion de positifs réellement identifiés. C’est un indicateur clé de l’aptitude du modèle à détecter les « vrais signaux ». Un TPR élevé signifie que le modèle repère efficacement ce qui compte.
À l’inverse, le FPR nous renseigne sur le bruit : à quelle fréquence le modèle classe‑t‑il à tort des négatifs comme positifs ? Le FPR est la proportion de négatifs mal étiquetés comme positifs. C’est essentiel pour évaluer les compromis du modèle. Un FPR élevé révèle une propension aux fausses alertes, potentiellement coûteuses selon le cas d’usage.
Tout l’enjeu de la classification binaire réside dans le réglage du seuil, qui module la sensibilité (TPR) et la spécificité (1 - FPR). En ajustant le seuil, nous pouvons accroître la détection des positifs tout en limitant les faux positifs. Dans la plupart des cas réels, le coût d’un faux négatif (rater un positif) et celui d’un faux positif (fausse alerte) diffèrent fortement.
L’AUC‑ROC n’est pas qu’un concept théorique : voici comment cette métrique pratique est utilisée dans les secteurs pour guider des décisions critiques :
L’AUC‑ROC sert à comparer différents tests de diagnostic. Elle est particulièrement utile lorsque le coût d’un faux négatif (par exemple, passer à côté d’une maladie) est bien supérieur à celui d’un faux positif (par exemple, un examen supplémentaire). Un exemple marquant est le dépistage du cancer, où le seuil déclenchant des examens peut être ajusté selon les facteurs de risque et les ressources disponibles.
Les modèles d’apprentissage automatique sont de plus en plus utilisés pour détecter les fraudes dans la finance. Les transactions frauduleuses étant rares, les jeux de données sont très déséquilibrés. L’AUC‑ROC est donc un indicateur pertinent, et il permet d’ajuster le seuil en fonction de divers facteurs : niveau de risque de la transaction, coût de la vérification manuelle, impact sur l’expérience client, etc.
Comme pour la fraude, les cyberattaques sont des événements relativement rares. L’AUC‑ROC s’applique donc aussi en cybersécurité, afin d’équilibrer détection des menaces et fatigue d’alerte due aux faux positifs.
L’AUC‑ROC est un indicateur phare pour les modèles binaires, mais certaines situations appellent d’autres mesures. Voici des alternatives et quand les utiliser :
La courbe précision‑rappel (PRC) est adaptée aux jeux de données déséquilibrés, surtout lorsque les coûts de faux positifs et faux négatifs diffèrent. Contrairement à l’AUC‑ROC, parfois trop optimiste en contexte déséquilibré, la PRC se concentre sur la performance liée à la classe positive.
Le F1‑score est la moyenne harmonique de la précision et du rappel. Il fournit un indicateur unique équilibrant les deux, utile pour résumer la performance, notamment sur des données déséquilibrées. L’AUC‑ROC donne une vue globale, tandis que le F1 correspond à un point particulier sur la courbe PRC.
L’AUC‑ROC fait référence en classification binaire, car elle offre une vision équilibrée des performances du modèle selon les seuils, en particulier en présence de déséquilibre de classes.
Nous sommes convaincus que la meilleure façon d’ancrer ses apprentissages est la pratique. La polyvalence de Python nous permet d’assimiler efficacement les concepts clés. Que vous révisiez vos fondamentaux ou exploriez des sujets avancés, c’est le moment idéal pour vous lancer. Replongez dans les bases de Python et challengez‑vous en travaillant l’AUC‑ROC sur des jeux de données complexes.
Apprenez Python et les statistiques avec DataCamp
Cours
Cours
Cursus