

Qu’est-ce que PySpark ?
PySpark est l’API Python d’Apache Spark. Votre code Python décrit les transformations souhaitées, et le moteur de Spark, qui s’exécute sur la JVM (Java Virtual Machine), planifie et exécute ces opérations sur le cluster. Vous bénéficiez de l’exécution distribuée de Spark sans écrire de Scala ni de Java.
Les data scientists utilisent PySpark pour nettoyer et agréger de grands jeux de données, les data engineers s’en servent pour des pipelines ETL, et les deux utilisent pyspark.ml pour entraîner des modèles sur des données qui ne tiennent pas sur une seule machine. Si vous travaillez surtout avec pandas aujourd’hui, l’API DataFrame vous paraîtra familière.
Quand utiliser PySpark plutôt que pandas
PySpark s’impose lorsque les données dépassent une machine unique ; en dessous, pandas est généralement plus rapide car il n’a ni démarrage de JVM ni surcoût d’ordonnancement des tâches.
| Fonctionnalité | pandas | PySpark |
|---|---|---|
| Taille des données | Limitée par la RAM d’une machine | Limitée par la mémoire et le disque combinés du cluster |
| Exécution | Éager, majoritairement monocœur | Paresseuse, en parallèle sur des cœurs ou des machines |
| Surcoût au démarrage | Aucun | Quelques secondes pour lancer la JVM et la SparkSession |
| Données en streaming | Non pris en charge | Structured Streaming |
| Apprentissage automatique | Écosystème scikit-learn | pyspark.ml (distribué) |
| Tolérance aux pannes | Aucune ; un crash fait perdre le travail | Les partitions perdues sont recalculées à partir de leur lignée |
Ma règle pratique : si les données tiennent en mémoire avec de la marge et que le job tourne sur un seul ordinateur, restez sur pandas. Passez à PySpark quand vous luttez contre des erreurs mémoire, ou quand le job devra tourner sur un cluster ou une plateforme comme Databricks.
Comment installer PySpark
PySpark s’installe depuis PyPI avec une seule commande pip, qui embarque le runtime Spark : vous n’avez pas besoin d’un téléchargement séparé de Spark ou Hadoop pour travailler en local. Avant de lancer l’installation, vérifiez deux prérequis.
Prérequis
Selon le guide d’installation officiel, PySpark 4.3 requiert :
- Python 3.11 ou version ultérieure. PySpark 4.3 a abandonné Python 3.10 ; consultez notre guide de configuration Python si vous avez besoin d’une version plus récente.
- Java 17 ou version ultérieure (Spark 4.3 fonctionne avec Java 17, 21 et 25) avec la variable d’environnement
JAVA_HOMEpointant vers cette installation. Notre guide installer Java détaille chaque système d’exploitation.
Vous pouvez vérifier les deux depuis un terminal :
python3 --version # Python 3.11 ou ultérieur
java -version # openjdk version "17" ou ultérieureSi vous travaillez dans DataLab ou Databricks, PySpark est déjà installé : vous pouvez passer directement au jeu de données.
Installer PySpark avec pip
Je recommande un environnement virtuel pour éviter que les dépendances de PySpark n’entrent en conflit avec d’autres projets :
python3 -m venv pyspark-env
source pyspark-env/bin/activate
pip install "pyspark[sql]" "pandas<3"
python3 -c "import pyspark; print(pyspark.__version__)"4.3.0Sous Windows, utilisez python au lieu de python3, et activez l’environnement avec pyspark-env\Scripts\activate. L’extra [sql] ajoute pandas, PyArrow et NumPy, utilisés par PySpark pour toPandas() et les UDF pandas. Je fixe pandas<3 car PySpark 4.3 affiche un avertissement indiquant qu’il ne prend pas encore totalement en charge pandas 3.0.
Deux erreurs expliquent la plupart des échecs au premier lancement :
JAVA_GATEWAY_EXITEDou « Unable to locate a Java Runtime » : Java est manquant ouJAVA_HOMEn’est pas défini.PYTHON_VERSION_MISMATCH: les processus workers de Spark ont pris un Python différent de celui de votre script. DéfinissezPYSPARK_PYTHONvers l’interpréteur de votre environnement, par exempleexport PYSPARK_PYTHON=$(which python).
Pour les étapes spécifiques à votre système (y compris Windows), consultez notre guide d’installation de PySpark.
Récupérer le jeu de données
Les exemples utilisent un jeu de données e-commerce de 541 909 transactions d’un détaillant en ligne basé au Royaume-Uni, de décembre 2010 à décembre 2011. Chaque ligne correspond à un produit sur une facture, avec 8 colonnes :
InvoiceNo: numéro de facture (les numéros commençant par « C » sont des annulations)StockCodeetDescription: code et nom du produitQuantityetUnitPrice: unités achetées et prix unitaire, en livres sterlingInvoiceDate: date et heure de l’achatCustomerID: identifiant client (manquant sur certaines lignes)Country: pays du client
Vous pouvez le télécharger en datacamp_ecommerce.csv depuis la page du jeu de données DataLab. Il s’agit de l’Online Retail dataset du UCI Machine Learning Repository, vous pouvez donc aussi recréer le même fichier depuis la source publique (nécessite pip install openpyxl) :
import io
import urllib.request
import zipfile
import pandas as pd
url = "https://archive.ics.uci.edu/static/public/352/online+retail.zip"
with urllib.request.urlopen(url) as response:
archive = zipfile.ZipFile(io.BytesIO(response.read()))
retail = pd.read_excel(
archive.open("Online Retail.xlsx"),
dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": "Int64"},
)
# Faire correspondre le format de date du fichier DataLab, ex. 12/1/10 8:26
retail["InvoiceDate"] = retail["InvoiceDate"].map(
lambda ts: f"{ts.month}/{ts.day}/{ts:%y} {ts.hour}:{ts:%M}"
)
retail.to_csv("datacamp_ecommerce.csv", index=False)Lire le fichier Excel de 23 Mo prend environ une minute. Enregistrez le CSV dans le dossier depuis lequel vous exécuterez le reste du code.
Créer une SparkSession
Une SparkSession est le point d’entrée de tout programme PySpark : elle connecte votre code Python au moteur Spark et crée des DataFrames. On en crée une par application via le pattern builder :
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySparkTutorial").getOrCreate()
print(spark.version)4.3.0getOrCreate() renvoie la session en cours si elle existe, ce qui est sans risque à appeler deux fois dans un notebook. Lancé depuis un processus Python simple, Spark s’exécute en mode local (local[*]), utilise tous les cœurs CPU de votre machine comme workers et sert l’UI Spark sur http://localhost:4040 pour suivre les jobs. Quand vous avez terminé, spark.stop() libère les ressources.
Charger le jeu de données e-commerce
Avec la session démarrée, on peut lire le CSV dans un DataFrame. Je passe un schéma explicite plutôt que inferSchema=True, qui oblige Spark à rescanner tout le fichier une fois de plus juste pour deviner les types de colonnes :
import pyspark.sql.functions as F
schema = """
InvoiceNo STRING, StockCode STRING, Description STRING, Quantity INT,
InvoiceDate STRING, UnitPrice DOUBLE, CustomerID INT, Country STRING
"""
orders = spark.read.csv(
"datacamp_ecommerce.csv", header=True, schema=schema, escape='"'
)
orders = orders.withColumn("InvoiceDate", F.to_timestamp("InvoiceDate", "M/d/yy H:mm"))
orders.printSchema()root
|-- InvoiceNo: string (nullable = true)
|-- StockCode: string (nullable = true)
|-- Description: string (nullable = true)
|-- Quantity: integer (nullable = true)
|-- InvoiceDate: timestamp (nullable = true)
|-- UnitPrice: double (nullable = true)
|-- CustomerID: integer (nullable = true)
|-- Country: string (nullable = true)Deux détails importants dans cet extrait :
escape='"'gère les noms de produits qui contiennent des guillemets doublés, tels queRECORD FRAME 7"" SINGLE SIZE. Le caractère d’échappement par défaut de Spark est la barre oblique inversée.- Le motif de date
M/d/yy H:mmcorrespond à des valeurs comme12/1/10 8:26. Depuis Spark 4.0, le mode SQL ANSI est activé par défaut, doncto_timestamp()lève une erreurCANNOT_PARSE_TIMESTAMPsi une valeur ne correspond pas au motif. UtilisezF.try_to_timestamp()si vous préférez obtenirNULLpour les lignes invalides.
Pour afficher les premières lignes et les compter :
orders.show(5, truncate=False)
print(orders.count())+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|InvoiceNo|StockCode|Description |Quantity|InvoiceDate |UnitPrice|CustomerID|Country |
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|536365 |85123A |WHITE HANGING HEART T-LIGHT HOLDER |6 |2010-12-01 08:26:00|2.55 |17850 |United Kingdom|
|536365 |71053 |WHITE METAL LANTERN |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84406B |CREAM CUPID HEARTS COAT HANGER |8 |2010-12-01 08:26:00|2.75 |17850 |United Kingdom|
|536365 |84029G |KNITTED UNION FLAG HOT WATER BOTTLE|6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84029E |RED WOOLLY HOTTIE WHITE HEART. |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
only showing top 5 rows
541909Pour plus d’options de lecture, comme les fichiers multiples, les délimiteurs et les enregistrements corrompus, consultez notre tutoriel PySpark read CSV.
RDD vs DataFrames
Les RDD et les DataFrames sont les deux manières de représenter des données distribuées en PySpark, et pour presque tout nouveau code, les DataFrames sont le meilleur choix.
| Abstraction | Ce que c’est | Quand l’utiliser |
|---|---|---|
| RDD (Resilient Distributed Dataset) | Niveau bas, collection immuable d’objets Python arbitraires, découpée en partitions | Données non structurées, ou besoin d’un contrôle fin du partitionnement |
| DataFrame | Table distribuée avec des colonnes nommées et typées, similaire à un DataFrame pandas | Analyse, requêtes SQL, ETL et apprentissage automatique |
Voici la même agrégation, quantité totale par pays, écrite des deux façons :
sales = [("United Kingdom", 6), ("France", 24), ("United Kingdom", 8)]
# RDD : vous écrivez la logique avec des fonctions Python
rdd = spark.sparkContext.parallelize(sales)
print(rdd.reduceByKey(lambda a, b: a + b).collect())
# DataFrame : vous déclarez le résultat, et Spark planifie comment le calculer
sales_df = spark.createDataFrame(sales, ["country", "quantity"])
sales_df.groupBy("country").sum("quantity").show()[('France', 24), ('United Kingdom', 14)]
+--------------+-------------+
| country|sum(quantity)|
+--------------+-------------+
|United Kingdom| 14|
| France| 24|
+--------------+-------------+La version RDD exécute votre lambda dans des processus workers Python. La version DataFrame passe par l’optimiseur Catalyst de Spark, qui réécrit la requête en un plan efficace exécuté dans la JVM ; le code DataFrame est donc généralement plus rapide sans réglage particulier. Le reste de ce tutoriel utilise des DataFrames.
Évaluation paresseuse : transformations vs actions
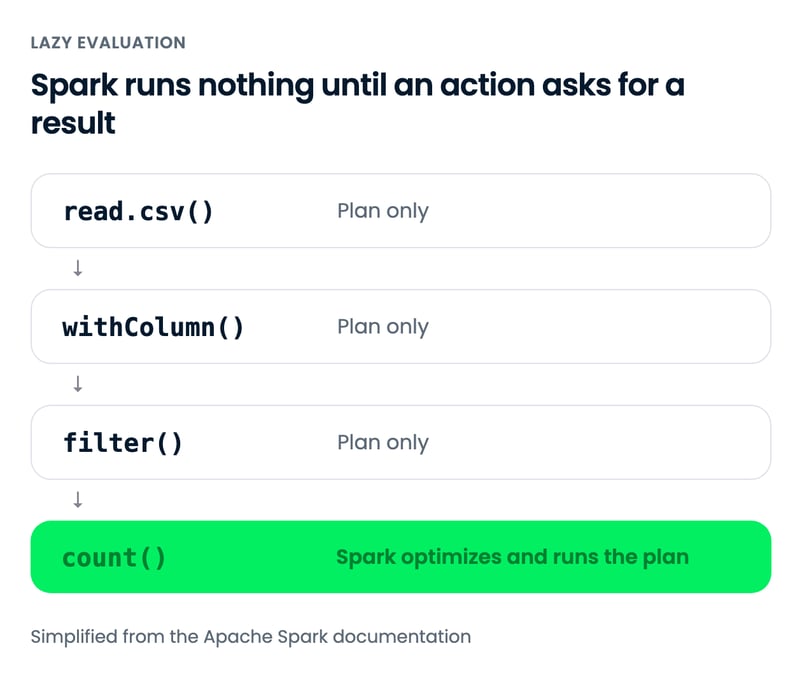
L’évaluation paresseuse signifie que Spark n’exécute pas une transformation au moment où vous l’appelez ; il enregistre l’étape dans un plan et exécute l’ensemble du plan uniquement quand une action demande un résultat.
| Transformations | Actions | |
|---|---|---|
| Ce qu’elles font | Décrivent un nouveau DataFrame | Renvoyent un résultat ou écrivent des données |
| Quand elles s’exécutent | Jamais seules | Immédiatement, en déclenchant toutes les transformations en attente |
| Exemples | select(), filter(), withColumn(), groupBy(), join() | show(), count(), collect(), toPandas(), write |
Le filtre ci-dessous renvoie instantanément, même si le jeu de données dépasse le demi-million de lignes, car rien n’est encore lu. L’appel à count() est ce qui lance un job :
uk_orders = orders.filter(F.col("Country") == "United Kingdom") # transformation : aucun job pour l’instant
print(uk_orders.count()) # action : Spark lit le fichier maintenant495478Attendre une action permet à Spark d’optimiser toute la chaîne d’un coup. explain() affiche le plan physique choisi (extrait ici) :
uk_orders.explain()== Physical Plan ==
*(1) Project [InvoiceNo#0, StockCode#1, ...]
+- *(1) Filter (isnotnull(Country#7) AND (Country#7 = United Kingdom))
+- FileScan csv [...] PushedFilters: [IsNotNull(Country), EqualTo(Country,United Kingdom)], ...L’entrée PushedFilters montre que Spark pousse le filtre de pays jusque dans la lecture du fichier, de sorte que les lignes des autres pays sont écartées à l’ingestion du CSV. Conséquence pratique : une erreur de données à l’intérieur d’une transformation, comme une date qui échoue au parsing en mode ANSI, n’apparaît qu’au prochain déclenchement d’action, quelques lignes plus loin.
Opérations DataFrame courantes
La plupart du code PySpark est une chaîne de cinq opérations DataFrame : select(), filter(), withColumn(), groupBy() et join(). Chacune renvoie un nouveau DataFrame, vous pouvez donc les enchaîner librement.
Sélectionner des colonnes avec select()
select() renvoie un DataFrame avec uniquement les colonnes nommées :
orders.select("InvoiceNo", "Description", "Quantity", "UnitPrice").show(3, truncate=False)+---------+----------------------------------+--------+---------+
|InvoiceNo|Description |Quantity|UnitPrice|
+---------+----------------------------------+--------+---------+
|536365 |WHITE HANGING HEART T-LIGHT HOLDER|6 |2.55 |
|536365 |WHITE METAL LANTERN |6 |3.39 |
|536365 |CREAM CUPID HEARTS COAT HANGER |8 |2.75 |
+---------+----------------------------------+--------+---------+
only showing top 3 rowsFiltrer des lignes avec filter()
filter() conserve les lignes qui satisfont une condition. Ce jeu de données mélange ventes et annulations (numéros de facture commençant par « C »), quantités négatives et lignes sans client ; je ne garde donc que les ventes valides :
sales_only = orders.filter(
(F.col("Quantity") > 0)
& (F.col("UnitPrice") > 0)
& F.col("CustomerID").isNotNull()
& ~F.col("InvoiceNo").startswith("C")
)
print(sales_only.count())397884Combinez les conditions avec & (et), | (ou) et ~ (non), et entourez chaque condition de parenthèses, car en Python, la priorité des opérateurs ferait sinon évaluer & avant >. Notre tutoriel PySpark filter couvre plus de schémas.
Ajouter des colonnes avec withColumn()
withColumn() ajoute une colonne, ou remplace une colonne du même nom. Ici, on calcule la valeur de chaque ligne :
sales_only = sales_only.withColumn("TotalAmount", F.round(F.col("Quantity") * F.col("UnitPrice"), 2))
sales_only.select("InvoiceNo", "Quantity", "UnitPrice", "TotalAmount").show(3)+---------+--------+---------+-----------+
|InvoiceNo|Quantity|UnitPrice|TotalAmount|
+---------+--------+---------+-----------+
| 536365| 6| 2.55| 15.3|
| 536365| 6| 3.39| 20.34|
| 536365| 8| 2.75| 22.0|
+---------+--------+---------+-----------+
only showing top 3 rowsVoir notre tutoriel PySpark withColumn() pour des colonnes conditionnelles avec F.when().
Agréger avec groupBy() et agg()
groupBy() regroupe les lignes par une ou plusieurs colonnes, et agg() calcule une ou plusieurs synthèses par groupe. Quels pays génèrent le plus de chiffre d’affaires ?
country_revenue = (
sales_only.groupBy("Country")
.agg(
F.count_distinct("CustomerID").alias("customers"),
F.round(F.sum("TotalAmount"), 2).alias("revenue"),
)
.orderBy(F.desc("revenue"))
)
country_revenue.show(5)+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+
only showing top 5 rowsLe Royaume-Uni domine, comme attendu pour un détaillant britannique. Les lignes les plus intéressantes sont les Pays-Bas et l’Irlande (indiquée EIRE) : 9 et 3 clients dépensent plus que les 94 d’Allemagne, ce qui suggère des acheteurs en gros.
Notez que j’importe le module functions sous le nom F plutôt que from pyspark.sql.functions import *, qui masque les fonctions natives Python sum(), min() et max(). Depuis PySpark 4.0, cet import générique n’expose plus non plus l’ancien nom en camelCase countDistinct.
Notre tutoriel PySpark groupBy va plus loin sur les agrégations.
Joindre des DataFrames avec join()
join() combine deux DataFrames sur une clé commune. Pour étiqueter chaque pays avec une région, je joins une petite table de correspondance qui omet volontairement l’Australie :
regions = spark.createDataFrame(
[("United Kingdom", "UK"), ("Netherlands", "EU"), ("EIRE", "EU"),
("Germany", "EU"), ("France", "EU")],
["Country", "region"],
)
country_revenue.join(regions, on="Country", how="left").orderBy(F.desc("revenue")).show(6)+--------------+---------+----------+------+
| Country|customers| revenue|region|
+--------------+---------+----------+------+
|United Kingdom| 3920|7308391.55| UK|
| Netherlands| 9| 285446.34| EU|
| EIRE| 3| 265545.9| EU|
| Germany| 94| 228867.14| EU|
| France| 87| 209024.05| EU|
| Australia| 9| 138521.31| NULL|
+--------------+---------+----------+------+
only showing top 6 rowsUne left join conserve toutes les lignes du DataFrame de gauche et remplit les correspondances manquantes avec NULL, c’est pourquoi l’Australie reste dans le résultat. Une inner join (how="inner", par défaut) l’aurait supprimée. Notre tutoriel sur les jointures PySpark compare tous les types de jointures et leurs performances.
Spark SQL dans PySpark
Spark SQL permet d’interroger un DataFrame avec du SQL standard en l’enregistrant comme vue temporaire. Cette requête reproduit le tableau de chiffre d’affaires par pays de la section groupBy :
sales_only.createOrReplaceTempView("sales")
spark.sql("""
SELECT Country,
COUNT(DISTINCT CustomerID) AS customers,
ROUND(SUM(TotalAmount), 2) AS revenue
FROM sales
GROUP BY Country
ORDER BY revenue DESC
LIMIT 5
""").show()+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+Les deux versions compilent vers le même plan optimisé, donc aucune n’est plus rapide. J’utilise le SQL pour les longues agrégations destinées à être lues par des analystes, et l’API DataFrame quand j’ai besoin de logique Python autour de la requête, par exemple pour construire des filtres dans une boucle. spark.sql() renvoie un DataFrame, vous pouvez donc mélanger librement les deux.
La vue temporaire dure jusqu’à l’arrêt de la SparkSession.
Machine learning avec PySpark : un exemple K-Means
Le module pyspark.ml de PySpark entraîne des modèles sur des DataFrames, et un Pipeline enchaîne la préparation des variables et le modèle en un seul objet réutilisable. Pour l’illustrer, je segmente les clients du détaillant avec un clustering K-Means sur la récence, la fréquence et la valeur monétaire (RFM), une segmentation marketing standard :
- Récence : nombre de jours depuis le dernier achat du client
- Fréquence : nombre de factures distinctes
- Monétaire : montant total dépensé
Construire les variables RFM avec groupBy()
Un groupBy() sur le DataFrame nettoyé sales_only produit les 3 variables. La récence est mesurée à partir du lendemain de la dernière facture du jeu :
snapshot = sales_only.agg(F.date_add(F.max("InvoiceDate"), 1)).first()[0]
rfm = sales_only.groupBy("CustomerID").agg(
F.datediff(F.lit(snapshot), F.max("InvoiceDate")).alias("recency"),
F.count_distinct("InvoiceNo").alias("frequency"),
F.round(F.sum("TotalAmount"), 2).alias("monetary"),
)
rfm.describe("recency", "frequency", "monetary").show()+-------+------------------+-----------------+------------------+
|summary| recency| frequency| monetary|
+-------+------------------+-----------------+------------------+
| count| 4338| 4338| 4338|
| mean| 93.05947441217151|4.272014753342554|2054.2664591977896|
| stddev|100.01226424171826|7.697997826095038| 8989.230441421178|
| min| 1| 1| 3.75|
| max| 374| 209| 280206.02|
+-------+------------------+-----------------+------------------+Regardez la colonne monétaire : une moyenne d’environ 2 054 £, un écart type plus de quatre fois supérieur, et un maximum au-delà de 280 000 £. K-Means mesure la distance euclidienne, donc quelques très gros clients domineraient les clusters. Prendre le log de chaque variable comprime d’abord cette longue traîne.
Normalisation et clustering dans un Pipeline
Le Pipeline comporte 3 étapes : VectorAssembler regroupe les variables en l’unique colonne vecteur attendue par les modèles pyspark.ml, StandardScaler les met sur la même échelle, et KMeans réalise le clustering. Je l’ajuste pour k = 2 à 6 et j’évalue chaque modèle avec le score de silhouette, compris entre -1 et 1, plus haut signifiant des clusters mieux séparés :
from pyspark.ml import Pipeline
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.feature import StandardScaler, VectorAssembler
rfm_log = rfm.select(
"CustomerID",
"recency", "frequency", "monetary",
F.log1p("recency").alias("log_recency"),
F.log1p("frequency").alias("log_frequency"),
F.log1p("monetary").alias("log_monetary"),
).cache()
assembler = VectorAssembler(
inputCols=["log_recency", "log_frequency", "log_monetary"], outputCol="features_raw"
)
scaler = StandardScaler(
inputCol="features_raw", outputCol="features", withMean=True, withStd=True
)
evaluator = ClusteringEvaluator(featuresCol="features", metricName="silhouette")
for k in range(2, 7):
kmeans = KMeans(featuresCol="features", k=k, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
score = evaluator.evaluate(model.transform(rfm_log))
print(f"k={k} silhouette={score:.3f}")k=2 silhouette=0.624
k=3 silhouette=0.502
k=4 silhouette=0.502
k=5 silhouette=0.478
k=6 silhouette=0.470.cache() conserve rfm_log en mémoire, car chaque fit et chaque évaluation de la boucle le relisent ; sans cela, Spark recalculerait la table RFM depuis le CSV à chaque entraînement.
Choisir k et interpréter les segments
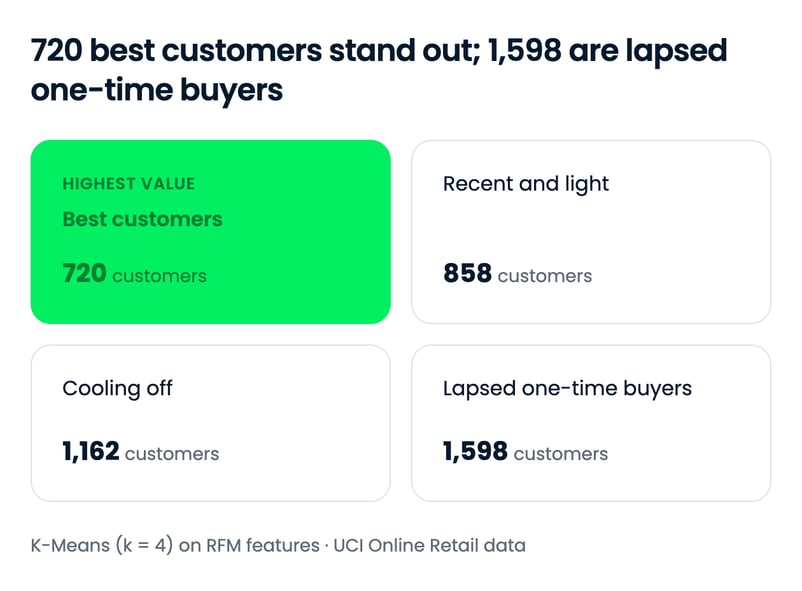
Le score de silhouette culmine à k = 2, mais 2 segments séparent surtout les clients actifs des clients perdus, ce qui est peu actionnable pour une équipe marketing. k = 4 obtient le même score que k = 3 et sépare les clients actifs en gros dépensiers et nouveaux venus, je l’utilise donc et je dresse le profil de chaque cluster :
kmeans = KMeans(featuresCol="features", k=4, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
segments = model.transform(rfm_log)
(segments.groupBy("prediction")
.agg(
F.count("*").alias("customers"),
F.round(F.avg("recency"), 1).alias("avg_recency"),
F.round(F.avg("frequency"), 1).alias("avg_frequency"),
F.round(F.avg("monetary"), 1).alias("avg_monetary"),
)
.orderBy("prediction")
.show())+----------+---------+-----------+-------------+------------+
|prediction|customers|avg_recency|avg_frequency|avg_monetary|
+----------+---------+-----------+-------------+------------+
| 0| 1598| 181.2| 1.3| 326.2|
| 1| 720| 13.2| 13.7| 8072.7|
| 2| 1162| 77.1| 3.9| 1765.2|
| 3| 858| 17.4| 2.3| 613.7|
+----------+---------+-----------+-------------+------------+Les quatre segments sont parlants :
- Cluster 1, meilleurs clients (720) : achat moyen dans les 2 dernières semaines, environ 14 commandes et plus de 8 000 £ dépensés chacun. À cibler avec des offres de rétention et de fidélité.
- Cluster 3, récents et légers (858) : actifs dans les 3 dernières semaines mais seulement ~2 commandes. Beaucoup sont sans doute de nouveaux clients à accompagner vers une 2e puis 3e commande.
- Cluster 2, en refroidissement (1 162) : dépense intermédiaire, mais ~11 semaines depuis le dernier achat. Une campagne de réactivation a les meilleures chances ici.
- Cluster 0, acheteurs uniques perdus (1 598) : majoritairement une seule commande, autour de 326 £, il y a environ 6 mois. Le groupe le plus grand et le moins rentable.
Les numéros de cluster sont des étiquettes arbitraires, et une autre graine peut les réordonner ; dressez toujours le profil des clusters avant de les nommer. Pour comprendre comment K-Means choisit ses centroïdes, voyez notre introduction au clustering k-means, et la référence de l’API pyspark.ml répertorie tous les modèles et transformateurs. Notre cours Machine Learning with PySpark couvre classification, régression et réglage de modèles avec des Pipelines.
Dernières réflexions
PySpark tient en quelques idées : une SparkSession pour démarrer, des DataFrames pour presque tout, des transformations paresseuses qui ne s’exécutent que lorsqu’une action a besoin d’un résultat, et la liberté d’écrire chaque requête en Python ou en SQL. Tout ce tutoriel a tourné en mode local sur un ordinateur portable, et le même code s’exécute tel quel sur un cluster.
Un fichier de 541 909 lignes ne nécessite pas un cluster, et pandas aurait suffi. C’était volontaire, car les bonnes habitudes sur de gros volumes (schémas explicites, filtrer tôt, mettre en cache ce que vous réutilisez, et vérifier explain()) se prennent plus facilement sur des données que vous pouvez inspecter.
À partir d’ici, les meilleures prochaines étapes selon votre objectif :
- Pratiquer l’API DataFrame avec des exercices : Introduction to PySpark
- Préparer des données réelles et imparfaites : Cleaning Data with PySpark
- Garder la syntaxe sous la main : notre aide-mémoire PySpark
- Préparer un entretien : Top PySpark interview questions
Pour aller plus loin, je recommande notre parcours Big Data with PySpark, qui enchaîne gestion des données, ingénierie des variables, pipelines de machine learning et moteurs de recommandation. Pour les équipes, DataCamp for Business propose des parcours d’apprentissage pour les rôles en data engineering.
FAQ PySpark
Quels sont les prérequis pour apprendre PySpark ?
PySpark 4.3 nécessite Python 3.11 ou version ultérieure et Java 17 ou ultérieure (Spark 4.3 fonctionne avec Java 17, 21 et 25), avec JAVA_HOME pointant vers votre installation Java. Vous devez être à l’aise avec les bases de Python ; une expérience des DataFrames pandas aide, car l’API DataFrame de PySpark s’appuie sur des concepts similaires. Aucune expérience préalable des systèmes distribués n’est requise.
PySpark est-il plus rapide que pandas ?
Pas sur de petits volumes. pandas s’exécute dans le processus sans coût de démarrage, tandis que PySpark prend quelques secondes pour lancer la JVM et planifier les tâches ; pandas l’emporte donc généralement lorsque les données tiennent confortablement en mémoire. PySpark devient plus rapide quand la charge dépasse la mémoire ou le CPU d’une machine, car il traite les partitions en parallèle sur des cœurs ou des nœuds du cluster.
Quelle est la différence entre les RDD et les DataFrames dans PySpark ?
Un RDD (Resilient Distributed Dataset) est la structure de bas niveau de PySpark : une collection distribuée et immuable d’objets Python arbitraires que vous traitez avec vos propres fonctions. Un DataFrame organise les données en colonnes nommées et typées, comme un DataFrame pandas, et l’optimiseur Catalyst de Spark transforme les requêtes DataFrame en plans d’exécution efficaces. Utilisez les DataFrames pour presque tout nouveau code, et les RDD uniquement pour des données non structurées ou un contrôle fin du partitionnement.
Comment exécuter PySpark dans un notebook Jupyter ?
Installez Java 17 ou version ultérieure, puis exécutez pip install "pyspark[sql]" dans l’environnement utilisé par votre notebook. Créez une SparkSession dans la première cellule :
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("MyNotebook").getOrCreate()Si vous préférez éviter la configuration locale, les notebooks DataLab et Databricks sont fournis avec PySpark préinstallé.
Quand dois-je utiliser PySpark plutôt que pandas ?
Utilisez PySpark lorsque vos données ne tiennent pas dans la mémoire d’une seule machine, quand un job doit tourner sur un cluster ou une plateforme comme Databricks, ou quand vous construisez des pipelines appelés à dépasser l’échelle d’un ordinateur portable. Pour l’exploration de données qui tiennent en mémoire, pandas est plus simple et démarre instantanément. Le code PySpark écrit en local s’exécute tel quel sur un cluster, donc commencer avec PySpark a du sens si la montée en charge est probable.
Qu’est-ce que l’évaluation paresseuse dans PySpark ?
L’évaluation paresseuse signifie que PySpark n’exécute pas les transformations comme filter() ou withColumn() quand vous les appelez. Il les enregistre dans un plan et n’exécute ce plan que lorsqu’une action, comme count(), show() ou write, a besoin d’un résultat. Ce délai permet à Spark d’optimiser l’ensemble de la chaîne, par exemple en poussant les filtres jusqu’à la lecture du fichier.
Comment exécuter des requêtes SQL dans PySpark ?
Enregistrez un DataFrame comme vue temporaire avec df.createOrReplaceTempView("sales"), puis interrogez-le avec spark.sql("SELECT ... FROM sales"). Le résultat est un DataFrame classique, vous pouvez donc mêler SQL et API DataFrame librement. Les deux compilent vers le même plan optimisé, aucune approche n’est plus rapide.
Ai-je besoin d’Hadoop pour exécuter PySpark ?
Non. pip install pyspark embarque le runtime Spark, qui fonctionne en mode local sur votre machine sans Hadoop. Vous n’avez besoin de composants Hadoop que si vous lisez depuis HDFS ou exécutez Spark sur un cluster YARN.
Natassha est une consultante en données qui travaille à l'intersection de la science des données et du marketing. Elle est convaincue que les données, lorsqu'elles sont utilisées à bon escient, peuvent être à l'origine d'une croissance considérable pour les individus et les organisations. En tant que professionnelle autodidacte des données, Natassha aime écrire des articles qui aident d'autres aspirants à la science des données à percer dans l'industrie. Les articles qu'elle publie sur son blog personnel, ainsi que dans des publications externes, sont consultés en moyenne 200 000 fois par mois.





PySpark est l’API Python d’Apache Spark. Vous écrivez du code DataFrame ou du SQL en Python, et Spark répartit la charge sur tous les cœurs CPU de votre ordinateur portable ou sur chaque machine d’un cluster. Je l’utilise quand un jeu de données ne tient plus confortablement dans pandas, ou quand le même traitement devra plus tard tourner sur un cluster sans réécriture.
Dans ce tutoriel PySpark, j’installe PySpark 4.3, je crée une SparkSession et j’explique les deux notions qui déconcertent le plus souvent les débutants : RDD vs DataFrames, et l’évaluation paresseuse. Nous enchaînerons ensuite les opérations du quotidien (select, filter, groupBy, join et Spark SQL) sur un jeu de données e-commerce de 541 909 lignes, puis nous terminerons par un modèle de segmentation client K-Means construit avec l’API Pipeline de
pyspark.ml.Si vous souhaitez des exercices guidés en complément, notre cours Introduction to PySpark couvre les mêmes points. Pour une feuille de route plus longue, consultez notre guide How to Learn PySpark From Scratch.
À retenir
pip install "pyspark[sql]"; PySpark 4.3 nécessite Python 3.11+ et Java 17+.SparkSession, et les DataFrames (pas les RDD) sont l’API par défaut.count()oushow().pyspark.mlenchaînent préparation des variables et modèles comme K-Means en un seul objet.Qu’est-ce qu’Apache Spark ?
Apache Spark est un moteur open source pour le traitement distribué des données. Il découpe un jeu de données en partitions, les traite en parallèle sur un cluster et conserve les résultats intermédiaires en mémoire au lieu de les écrire sur disque entre les étapes.
Cette conception « en mémoire » est la principale raison pour laquelle Spark a remplacé Hadoop MapReduce pour la plupart des traitements batch (nous comparons les deux dans Hadoop vs Spark). Spark a démarré à l’AMPLab de l’UC Berkeley en 2009, est devenu un projet Apache de premier plan en 2014 et a atteint la version 4.3 le 30 octobre 2026.
Un seul moteur couvre plusieurs charges de travail via ses bibliothèques intégrées :
pyspark.ml) pour l’apprentissage automatique distribuéPour comprendre comment le driver, le gestionnaire de cluster et les exécutants se partagent le travail, consultez notre guide de l’architecture Apache Spark.